| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Selecionar e usar tipos de dados adequados para uma solução de problema | incluindo inteiro, real, char, string, Booleano, data (pseudocódigo usará os seguintes tipos de dados: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) |
| Demonstrar compreensão do propósito de uma estrutura de registro para armazenar um conjunto de dados de diferentes tipos de dados sob um único identificador | Escrever pseudocódigo para definir uma estrutura de registro |
| Escrever pseudocódigo para ler dados de uma estrutura de registro e salvar dados em uma estrutura de registro |
Tipos e Estruturas de Dados
Ciência da Computação do A-Level · Tópico 10
 17:40
Tipos de Dados & Estruturas
Todo valor armazenado pelo seu programa precisa de um tipo de dado — e escolher o correto é importante. Digamos que você armazene se um item está em estoque. Você poderia escrever a palavra yes…
Narração em inglês · Legendas em inglês + 中文 gravadas
10.1
Escolhendo tipos de dados
Programa
Fonte: Programa Cambridge International
Toda variável precisa de um tipo de dado 数据类型 — o tipo de valor que ela armazena e as operações permitidas:
INTEGER— um número inteiro (42,-7). Para contagens, índices, IDs.REAL— um número com parte fracionária (3.14). Para dinheiro, medições.STRING— caracteres entre aspas ("Hello"). Para texto.CHAR— um único caractere ('A').BOOLEAN—TRUEouFALSE. Para flags.DATE— uma data do calendário.
Escolha o tipo preciso menor que se encaixe: INTEGER para contagens inteiras, BOOLEAN para flags (não as strings "yes"/"no").
As tabelas "dê o tipo de dado apropriado" são decididas por como o valor é usado: a média das notas de uma turma é REAL (tem parte fracionária); um endereço de e-mail é STRING; o número de alunos é INTEGER; se um aluno pagou é BOOLEAN; uma data de nascimento é DATE; um índice de array é sempre INTEGER; uma letra de nota única é CHAR; um número de telefone é um STRING, porque começa com 0 e nunca é usado em aritmética. Um BOOLEAN é usado para uma flag com apenas dois estados: se uma busca encontrou seu alvo, se um membro pagou, se um assento está reservado. Para a tabela de identificadores, o nome da variável também deve ser significativo: NumberOfPeople, não n.
10.1
Registros

Um registro 记录 (uma estrutura de registro 记录结构) armazena vários campos de tipos diferentes sob um único nome — útil quando vários valores descrevem uma coisa.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Isso define o tipo TStockItem; declare variáveis dele:
DECLARE Item1 : TStockItem
DECLARE Items : ARRAY[1:100] OF TStockItem
Use notação de ponto para acessar cada campo 字段:
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
Use um registro quando valores sempre pertencerem juntos (um cliente, um item de estoque); use variáveis separadas para valores não relacionados.
Exemplo resolvido. Um clube armazena, para cada aluno, um ID de aluno (uma string), um nome, uma data de nascimento e até três números de clube (inteiros). Escreva pseudocódigo para declarar o tipo de registro, um array para armazenar $3000$ alunos, e uma instrução que armazena um nome no primeiro elemento.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Os pontos: TYPE com o identificador e ENDTYPE; cada campo declarado com um tipo adequado; o array declarado com seus limites e OF Student; o campo acessado com o índice e um ponto. Uma questão "affe o erro na declaração do registro" geralmente aponta para um ENDTYPE faltante, um campo sem tipo, ou um campo declarado como um STRING que deve conter aritmética. Duas convenções pontuam por si só: um elemento não utilizado é marcado com um valor que não pode ser dados reais (uma string vazia, -1, um ID de 0), e é boa prática usar o mesmo marcador em todos os lugares para que todo módulo possa reconhecer um slot não utilizado; um campo de clube não utilizado é 0. Os benefícios de um array de registros, para "affe três benefícios": todos os dados de uma entidade são mantidos sob um único identificador; os campos podem ter diferentes tipos de dados; um array substitui vários arrays paralelos que precisariam ser mantidos em sincronia; o conjunto inteiro pode ser processado por um único laço ou passado como um único parâmetro; e adicionar um campo altera apenas a definição do tipo. Para um único cliente, a estrutura adequada é um registro (campos de diferentes tipos sob um nome); para todos os clientes, é um array de registros.
Explorar
Um registro agrupa campos sob um único nome
Um registro agrupa campos relacionados juntos. Cada campo é um rótulo nomeado que você acessa com notação de ponto — Item1.Categoria — não por índice numérico.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| record/ˈrekɔːd/ | 记录 | jì lù |
| record structure/ˈrekɔːd ˈstrʌktʃə/ | 记录结构 | jì lù jié gòu |
| field/fiːld/ | 字段 | zì duàn |
10.2
Matrizes

Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Usar os termos técnicos associados a arrays | Incluindo índice, limite superior e limite inferior |
| Selecionar uma estrutura de dados adequada (array 1D ou array 2D) para usar em uma tarefa dada | |
| Escrever pseudocódigo para arrays 1D e 2D | |
| Escrever pseudocódigo para processar dados de array | Ordenar usando uma ordenação bubble Pesquisar usando uma busca linear |
Fonte: Programa Cambridge International
Um array 数组 é uma coleção ordenada de itens do mesmo tipo, sob um único nome, acessado por um índice 索引.
- elemento 元素 — um item no array.
- limites 边界 — os índices válidos mais baixos e mais altos.
- dimensão 维度 — 1-D (uma lista), 2-D (uma tabela), etc.
- limite inferior 下界 e limite superior 上界 — o primeiro e o último índice válido; o número de elementos é limite superior menos limite inferior mais um, e para um array 2-D o produto das duas contagens.
Então em ThisArray[n] ← 42 o array tem uma dimensão, o índice é a variável n (um INTEGER), e o elemento nesse índice recebe 42. Antes que um array possa ser declarado, você precisa de seu tipo de dado bem como seus limites. Para declarar $120$ valores que podem incluir um ponto decimal: DECLARE Data : ARRAY[1:120] OF REAL; uma tabela de strings de $150$ linhas, duas colunas: DECLARE Data : ARRAY[1:150, 1:2] OF STRING, que tem $300$ elementos. Os benefícios de um array sobre variáveis separadas, para uma explicação de dois pontos: um identificador em vez de trinta; os elementos podem ser processados por um loop com o índice como contador; o tamanho é fácil de alterar; e todo o conjunto pode ser passado para um módulo como um único parâmetro. Um array também pode substituir uma cadeia de declarações de seleção: DaysInMonth[Month] procura a resposta diretamente em vez de doze cláusulas IF, o que é mais curto, mais rápido de escrever e mais fácil de manter.
Arrays 1-D
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
Processar cada elemento com um laço FOR:
FOR i ← 1 TO 5
    OUTPUT Names[i]
NEXT i
Arrays 2-D (array 2D)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
O primeiro índice representa a linha, o segundo a coluna. Use laços aninhados para visitar cada célula. Use 1-D para uma sequência única, 2-D para duas dimensões naturais (uma grade, linhas × colunas).

Operações comuns
Uma busca linear 线性查找 verifica cada elemento até encontrá-lo:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Para encontrar uma soma, contagem, máximo ou mínimo, defina uma variável acumuladora e percorra:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Uma ordenação por bolha 冒泡排序 coloca um array em ordem: percorre-o comparando cada par adjacente e trocando qualquer um fora de ordem; repita as passagens até que uma passagem não realize nenhuma troca.
A Prova 2 pede esses algoritmos tanto em pseudocódigo quanto em passos em palavras, e às vezes em sua forma "eficiente":
- Maior valor: defina
Largestpara o primeiro elemento; para cada elemento restante, se for maior queLargest, armazene-o emLargest; após o laço, imprimaLargest. Para a posição do maior, mantenha uma segunda variável que armazene o índice sempre queLargestmudar. - Busca linear retornando uma posição: defina
FoundAt ← -1antes do laço (um valor que nunca será um índice válido, indicando "não encontrado"); percorra o array; quando o elemento corresponder, armazene o índice e saia do laço; após o laço testeFoundAt. - Contar ou imprimir os elementos não em branco: compare cada elemento com o marcador de elemento vazio (
""ou-1) e conte ou imprima apenas aqueles que diferirem. - Remover um item: encontre seu índice por busca linear; mova todos os elementos subsequentes uma posição para a frente, fechando o espaço; marque o último elemento como vazio (ou diminua a contagem).
- Inserir em um array ordenado: encontre o primeiro índice cujo elemento seja maior; mova esse elemento e todos os seguintes uma posição para trás; armazene o novo valor no espaço vazio.
- Ordenação por bolha eficiente: uma bandeira
Swappedpara que as passagens parem assim que uma não realizar troca, e um limite superior que diminui em uma unidade a cada passagem porque o maior valor já atingiu o final.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Os pontos são pelo laço externo que se repete até não haver trocas, pela bandeira definida dentro do IF, pela troca de três linhas com uma variável temporária e pelo limite decrescente. Uma ordenação em "passos" (refinamento passo a passo) é: repetir até ordenar; em cada passagem, comparar pares adjacentes; trocar um par fora de ordem; após cada passagem, o maior valor não ordenado fica no final. Dois arrays 1-D de registros ou de dados paralelos são processados com um laço e um índice; um array 2-D precisa de um laço aninhado, o externo sobre linhas e o interno sobre colunas, e uma busca em uma linha fixa o índice da linha e percorre a coluna.

Explorar
Uma matriz 2-D
Escolha uma linha e uma coluna para ler um elemento — como uma grade de dados é armazenada e indexada.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| index/ˈɪndeks/ | 索引 | suǒ yǐn |
| array/əˈreɪ/ | 数组 | shù zǔ |
| element/ˈelɪmənt/ | 元素 | yuán sù |
| bounds/baʊndz/ | 边界 | biān jiè |
| bubble sort/ˈbʌbl sɔːt/ | 冒泡排序 | mào pào pái xù |
| file/faɪl/ | 文件 | wén jiàn |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | 辅助存储器 | fǔ zhù cún chǔ qì |
10.3
Arquivos

Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão do motivo pelo qual arquivos são necessários | |
| Escrever pseudocódigo para manipular arquivos de texto que consistem em uma ou mais linhas |
Fonte: Programa Cambridge International
Um arquivo 文件 é dados armazenados em armazenamento secundário 辅助存储器, mantidos entre execuções de programa. Variáveis na RAM desaparecem quando o programa termina, então para salvar dados permanentemente (pontuações altas, registros, configurações) o programa escreve em um arquivo. Arquivos também permitem que programas compartilhem dados e reiniciem a partir de um estado salvo.
Um arquivo de texto 文本文件 contém uma ou mais linhas de caracteres legíveis; programas leem e escrevem arquivos de texto linha por linha. Abra um arquivo antes de usá-lo e arquivo depois:
OPENFILE "data.txt" FOR READ      // or FOR WRITE, FOR APPEND
WHILE NOT EOF("data.txt") DO
    READFILE "data.txt", LineString
    OUTPUT LineString
ENDWHILE
CLOSEFILE "data.txt"
EOF testa o fim de arquivo 文件结束 antes de ler. Para escrever:
OPENFILE "log.txt" FOR WRITE
FOR i ← 1 TO 100
    WRITEFILE "log.txt", "Event " & i
NEXT i
CLOSEFILE "log.txt"
Sempre arquivo todos os arquivos — caso contrário, as escritas em buffer podem ser perdidas e outros programas podem ficar bloqueados.
Por que arquivos (dois pontos): os dados são mantidos após o término do programa, tornando-os disponíveis na próxima execução; podem ser compartilhados com outros programas; e podem conter mais dados do que cabem na memória. A característica de um arquivo de texto que permite ao programa processá-lo é ser uma sequência de linhas, lidas uma após outra do início. Os três modos: READ para ler do início; WRITE para criar um novo arquivo, o que exclui qualquer conteúdo existente, logo não pode ser usado para adicionar a um arquivo; APPEND para adicionar linhas no final de um arquivo existente. Teste EOF antes de cada leitura, e abra o arquivo apenas uma vez, mesmo quando vários módulos o utilizarem.
Exemplo resolvido. Escreva pseudocódigo para um procedimento LastLines(FileName : STRING) que imprime as últimas três linhas de um arquivo de texto, na ordem.
PROCEDURE LastLines(BYVAL FileName : STRING)
    DECLARE LineX, LineY, LineZ : STRING
    LineX ← ""
    LineY ← ""
    LineZ ← ""
    OPENFILE FileName FOR READ
    WHILE NOT EOF(FileName) DO
        LineX ← LineY
        LineY ← LineZ
        READFILE FileName, LineZ
    ENDWHILE
    CLOSEFILE FileName
    OUTPUT LineX
    OUTPUT LineY
    OUTPUT LineZ
ENDPROCEDURE
Cada nova linha empurra as três anteriores, então quando o arquivo termina as três variáveis contêm suas últimas três linhas; um arquivo com menos linhas imprime cadeias vazias. Para imprimir as cinco primeiras linhas, conte as linhas lidas e pare o laço em cinco ou em EOF, o que vier primeiro; um arquivo vazio é detectado por EOF ser TRUE imediatamente após a abertura.
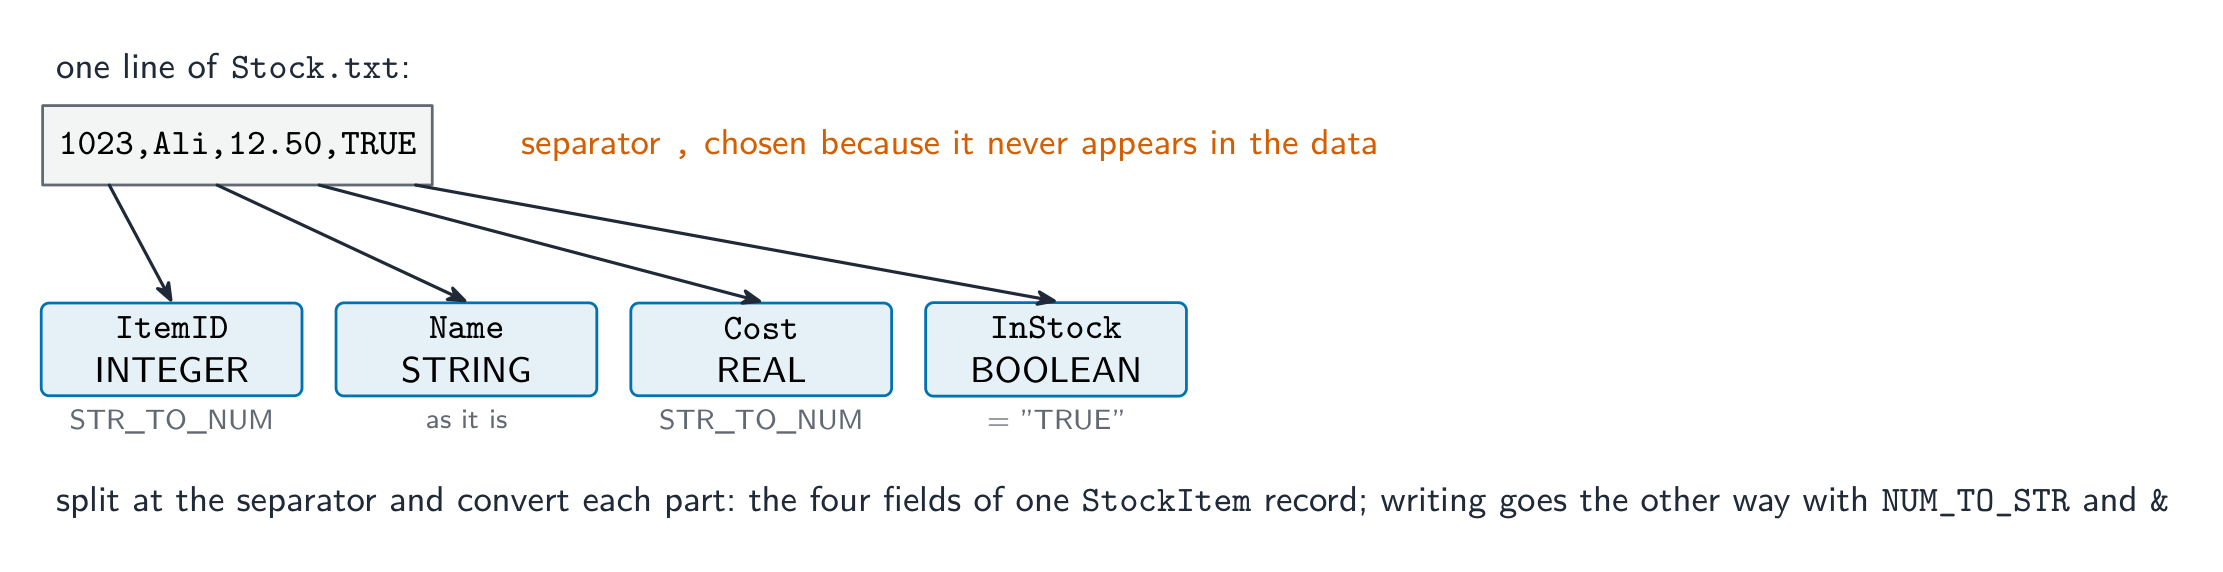
Campos em uma linha. Um arquivo de texto contém strings, então um registro é escrito como uma linha cujos campos estão ligados por um caractere separador 分隔符, e cada número ou Booleano é convertido com NUM_TO_STR (e lido novamente com STR_TO_NUM, ou comparando com "TRUE"). Escolha um separador que nunca apareça nos dados: vírgula ou | para nomes e números, nunca um espaço quando um nome pode conter um. Se um campo puder conter qualquer caractere, o separador pode ser confundido com os dados; a solução é colocar cada campo em sua própria linha, ou escrever o comprimento do campo antes dele. Um item por linha é simples de ler novamente, mas usa mais linhas e torna o registro menos visível como uma unidade. Ler um arquivo cujas linhas estão em uma ordem conhecida (ascendente por ID) permite que a busca pare assim que um ID maior for lido, em vez de ler até o final. Um arquivo de salvamento criado a cada vez que o jogo é salvo precisa de um nome de arquivo significativo, por exemplo, o nome do jogador e a data e hora, para que qualquer salvamento anterior possa ser restaurado.
Explorar
Gerenciamento de arquivo: abrir → usar → fechar
Passe pelo ciclo de vida que todo arquivo segue. As duas partes fáceis de esquecer são testar EOF ao ler em um laço e sempre fechar no final.
10.4
Tipos de Dados Abstratos (ADTs)

Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão de que um ADT é uma coleção de dados e um conjunto de operações sobre esses dados | |
| Demonstrar compreensão de que uma pilha, fila e lista ligada são exemplos de ADTs | Descrever as características principais de uma pilha, fila e lista ligada e justificar seu uso para uma situação dada |
| Usar uma pilha, fila e lista ligada para armazenar dados | Os candidatos não serão exigidos a escrever pseudocódigo para essas estruturas, mas devem ser capazes de adicionar, editar e excluir dados dessas estruturas |
| Descrever como uma fila, pilha e lista ligada podem ser implementadas usando arrays |
Fonte: Programa Cambridge International
Um Tipo de Dado Abstrato 抽象数据类型 (ADT) é uma coleção de dados mais operações sobre eles, definido pelo o que faz, não como é armazenado. O usuário interage apenas pelas operações; a implementação é oculta, permitindo alterações sem afetar o código que usa o ADT. Conheça três: pilha, fila, lista ligada.
A definição de um ponto: um ADT é uma coleção de dados junto com um conjunto de operações sobre esses dados. Uma pilha, uma fila, uma lista ligada, uma árvore binária e um array são todos ADTs. Para justificar uma escolha: uma fila quando os itens devem ser tratados na ordem de chegada (trabalhos de impressão, pressionamentos de tecla, clientes em uma loja), pois é primeira a entrar, primeira a sair; uma pilha quando o item mais recente deve ser tratado primeiro (desfazer, navegar pelas páginas web, inverter uma ordem, endereços de retorno de chamadas aninhadas), pois é última a entrar, primeira a sair; uma lista ligada quando os itens são inseridos e removidos frequentemente no meio de uma sequência ordenada, pois apenas ponteiros mudam e nada precisa ser transferido. Para comparar uma pilha e uma fila: ambas são estruturas lineares de itens com uma ordem, ambas são implementadas com um array e ponteiros, e ambas precisam verificar se estão cheias antes de adicionar e se estão vazias antes de remover; uma pilha tem um ponteiro e adiciona/remove na mesma extremidade, uma fila tem dois ponteiros e adiciona em uma extremidade e remove na outra.
Pilha
Uma pilha 栈 opera em ordem LIFO 后进先出 (Last In, First Out). Operações: empurrão 入栈 (adicionar no topo), pop 出栈 (remover do topo), peek (verificar o topo) e testes de vazio/cheio. Usos: histórico de desfazer, endereços de retorno de chamada de função, análise de expressões, retrocesso.
Exemplo resolvido. Uma pilha de caracteres contém, de baixo para cima, 'P', 'N', 'Z', 'X', 'Y', 'W', com o ponteiro de topo da pilha em 'W' (localização de memória 202 de 200–207). As operações POP, POP, PUSH 'A', PUSH 'B', POP são realizadas. O que está na pilha e onde o ponteiro aponta?
Os dois pops removem 'W' então 'Y'; os pushes adicionam 'A' então 'B' em seus lugares; o último pop remove 'B'. A pilha agora contém 'P', 'N', 'Z', 'X', 'A' e o ponteiro está em 'A', localização 203. O valor que esteve na pilha por mais tempo é o item inferior, 'P'; no máximo cinco pops adicionais são possíveis antes que a pilha esteja vazia, e um pop em uma pilha vazia é um erro, razão pela qual Pop() testa se está vazio primeiro. Uma função Push() que retorna TRUE com sucesso testa primeiro se o ponteiro está no topo do array (cheio) e retorna FALSE se for esse o caso. Os elementos do array não precisam ser inicializados antes do uso, porque o ponteiro sozinho diz quais elementos estão em uso.

Fila
Uma fila 队列 funciona em ordem FIFO 先进先出 (First In, First Out). Operações: enqueue 入队 (adicionar na traseira), dequeue 出队 (remover da frente) e testes para vazio/cheio. Usos: spooling de impressão, agendamento, busca em largura, buffering.

Para descrever a adição de um item: verifique se a fila não está cheia; armazene o item na posição indicada pelo ponteiro final da fila; incremente o ponteiro final (e a contagem). Para descrever a remoção: verifique se a fila não está vazia; leia o item no ponteiro frontal; incremente o ponteiro frontal (e decremente a contagem). Enuncie a convenção que você usa: se o ponteiro final marca o próximo espaço livre, ponteiros frontais e finais iguais significam que a fila está vazia; se marca o último item, ponteiros iguais significam um item. Em uma fila linear, o ponteiro frontal só se move para frente, então células atrás dele são desperdiçadas; é isso que a fila circular abaixo corrige. As duas características de uma fila a enunciar: os itens são adicionados na traseira e removidos da frente, então o primeiro item adicionado é o primeiro removido.

Lista encadeada
Uma lista encadeada 链表 armazena dados como uma sequência de nós 节点. Cada nó contém um valor e um ponteiro 指针 para o próximo nó; um ponteiro de início marca o começo, e o ponteiro do último nó é um sentinela (por exemplo, NULL). Operações: inserir, excluir, pesquisar e percorrer 遍历 (visitar cada nó em ordem). Sua vantagem sobre um array é a inserção/exclusão barata (basta ajustar os ponteiros); sua desvantagem é o acesso aleatório lento (você deve seguir os ponteiros desde o início).

Adicionar um nó em ordem (quatro pontos): percorra a lista a partir do início, seguindo os ponteiros, até encontrar o nó antes da posição desejada (o último nó cujo valor seja menor); pegue um nó livre e armazene o novo valor nele; defina o ponteiro do novo nó para o endereço para o qual o nó anterior apontava; defina o ponteiro do nó anterior para o novo nó. Se o novo valor pertencer ao início, o ponteiro de início é alterado em vez disso. Excluir um nó: encontre o nó antes dele e defina o ponteiro desse nó para o endereço para o qual o nó excluído apontava, contornando-o na lista; o nó liberado retorna à lista de nós livres. Comparado com um array 1D, a inserção ou exclusão em uma lista encadeada não requer deslocamento dos outros itens, e a lista pode crescer até que a memória acabe; o custo é o ponteiro extra armazenado com cada item, e alcançar o item $n$ significa seguir $n$ ponteiros, já que não há índice direto.
Explorar
Uma lista encadeada: nós unidos por ponteiros
Cada nó armazena um valor e um ponteiro para o próximo nó. Inserir ou deletar apenas religa ponteiros — nenhum item se move, diferentemente de uma matriz.
Explorar
Pilhas e filas
Empurrar e retirar. Uma pilha (stack) é último a entrar, primeiro a sair; uma fila (queue) é primeiro a entrar, primeiro a sair — dois TADs principais.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| stack/stæk/ | 栈 | zhàn |
| dimension/daɪˈmenʃn/ | 维度 | wéi dù |
| push/pʊʃ/ | 入栈 | rù zhàn |
| separator/ˈsepəreɪtə/ | 分隔符 | fēn gé fú |
| linked list/lɪŋkt lɪst/ | 链表 | liàn biǎo |
| queue/kjuː/ | 队列 | duì liè |
| LIFO/ˈlaɪfəʊ/ | 后进先出 | hòu jìn xiān chū |
| FIFO/ˈfaɪfəʊ/ | 先进先出 | xiān jìn xiān chū |
| pop/pɒp/ | 出栈 | chū zhàn |
| enqueue/enˈkjuː/ | 入队 | rù duì |
| dequeue/diːˈkjuː/ | 出队 | chū duì |
10.4
Implementando ADTs usando arrays

Pilha usando um array
Mantenha os itens em Stack[1:MaxSize] com um inteiro Top (0 quando vazio).
Push(x): seTop = MaxSizea pilha estiver cheia (transbordamento 溢出); caso contrário,Top ← Top + 1;Stack[Top] ← x.Pop(): seTop = 0a pilha estiver vazia (underflow 下溢); caso contrário, retorneStack[Top]eTop ← Top - 1.
Fila usando um array circular
Uma fila simples permite que Front e Rear avancem até o final, desperdiçando o início. A correção é um array circular 循环数组 — quando um ponteiro atinge MaxSize, ele volta para 1:
Enqueue(x): verificar se está cheio; caso contrário,Rear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): verificar se está vazio; caso contrário, retorneQueue[Front]eFront ← (Front MOD MaxSize) + 1.
Rastreie uma contagem separada para distinguir vazio de cheio.
O algoritmo para o ponteiro de fim, em palavras: se a contagem for igual ao tamanho, informe que a fila está cheia e pare; caso contrário, adicione um ao ponteiro de fim; se agora ele ultrapassar o último índice, defina-o como o primeiro índice; armazene o item lá e adicione um à contagem. As declarações que uma resposta de "descreva a declaração e inicialização" de cinco pontos lista: o array com seu tamanho e tipo de elemento; um ponteiro de frente e um ponteiro de fim, ambos inicializados para o primeiro índice (ou a frente para o primeiro índice e o fim para o próximo espaço livre); e uma contagem de itens, inicializada para $0$.
Por exemplo, com MaxSize = 6: se Rear = 5, então (5 MOD 6) + 1 = 6, portanto o próximo item vai na célula 6; se Rear = 6, então (6 MOD 6) + 1 = 1, portanto o ponteiro volta para a célula 1.
Lista encadeada usando um array
Use um array de registros, cada um com um índice Next:
TYPE TNode
    DECLARE Value : INTEGER
    DECLARE Next : INTEGER     // index of the next node, or -1 for end
ENDTYPE

DECLARE Nodes : ARRAY[1:MaxSize] OF TNode
DECLARE Head : INTEGER         // index of first node, -1 if empty
DECLARE FreeListHead : INTEGER // first available free node
Uma lista de nós livres 空闲列表 encadeia as posições não utilizadas, assim como a lista de dados encadeia as utilizadas. Para inserir: pegue uma posição de FreeListHead, defina o valor do novo nó e Next, e atualize o Next do nó anterior (ou Head). Para excluir: desvincule o nó e devolva sua posição à lista de nós livres. Isso dá a flexibilidade de uma estrutura encadeada com a alocação estática de um array.

Exemplo resolvido. Uma lista encadeada é mantida em um array Data e um array Pointer, com Start apontando para o índice 1. A lista é 1 → 3 → 4 (o índice 1 contém D40, o índice 3 contém D32, o índice 4 contém D11, cujo ponteiro é $\emptyset$); a lista de nós livres começa no índice 2 e continua 2 → 5. Insira D6 entre D32 e D11.
Pegue o primeiro nó livre, índice 2, e defina FreeStart para seu ponteiro, 5; armazene D6 em Data[2]; defina Pointer[2] para o valor Pointer[3] mantido, que é 4; defina Pointer[3] para 2. A lista lê 1 → 3 → 2 → 4 e a lista de nós livres é 5 → $\emptyset$. A resposta para "como a lista encadeada pode ser implementada" são exatamente estas partes: um array (ou array de registros) para os dados, um array paralelo para os ponteiros contendo índices, um ponteiro de início, um ponteiro de lista de nós livres e um valor nulo como $-1$ para o fim.
Exemplo resolvido. Uma fila circular é mantida em um array de tamanho 5 (índices 0 a 4) com Front = 3, Rear = 3 e um item armazenado. Dois itens são adicionados, depois dois são removidos. Onde estão os ponteiros e por que usar uma fila circular? Cada movimento usa (pointer + 1) MOD size, então os ponteiros voltam. Adicionando duas vezes move Rear: $3 \rightarrow 4$, depois $4 \rightarrow 0$ (porque $(4+1) \bmod 5 = 0$), então Rear = 0 e três itens são armazenados. Removendo duas vezes move Front da mesma maneira: $3 \rightarrow 4$, depois $4 \rightarrow 0$, deixando Front = 0 e um item. O retorno é o ponto principal: em uma fila de array linear, os ponteiros avançam até o final e o espaço liberado no início é desperdiçado mesmo quando a fila está vazia. Lembre-se de que uma fila remove na Frente e adiciona na Traseira - uma pilha usa um ponteiro para ambos.
Explorar
Implementando ADTs com matrizes
FIFO
Uma fila é primeira-a-entrar-primeiro-a-sair — enfileirar na parte traseira, desenfileirar pela frente.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| pointer/ˈpɔɪntə/ | 指针 | zhǐ zhēn |
| node/nəʊd/ | 节点 | jié diǎn |
| traverse/trəˈvɜːs/ | 遍历 | biàn lì |
| free list/friː lɪst/ | 空闲列表 | kòng xián liè biǎo |
| overflow/ˌəʊvəˈfləʊ/ | 溢出 | yì chū |
| underflow/ˌʌndəˈfləʊ/ | 下溢 | xià yì |
| circular array/ˈsɜːkjʊlə əˈreɪ/ | 循环数组 | xún huán shù zǔ |
10.4
Definições aceitas pelo examinador
Uma questão de definição é marcada contra texto fixo. Aprenda estes exatamente.
| Termo | Definição |
|---|---|
| record | uma estrutura de dados que mantém um conjunto de itens de dados (campos) de diferentes tipos de dados sob um único identificador |
| array | uma estrutura de dados que mantém um número fixo de elementos do mesmo tipo de dados sob um único identificador, cada um acessado por um índice |
| index | o número que identifica um elemento de um array |
| upper bound, lower bound | o maior e o menor índice válido de um array |
| text file | um arquivo que armazena dados como linhas de caracteres, que um programa lê e escreve uma linha de cada vez |
| abstract data type | uma coleção de dados junto com um conjunto de operações sobre esses dados |
| pilha | uma lista na qual os itens são adicionados e removidos da mesma extremidade, o topo, então o último item adicionado é o primeiro removido (LIFO) |
| fila | uma lista na qual os itens são adicionados na traseira e removidos da frente, então o primeiro item adicionado é o primeiro removido (FIFO) |
| linked list | uma lista na qual cada nó contém um item de dados e um ponteiro para o próximo nó, com um ponteiro de início para o primeiro nó |
| pointer | uma variável que contém o endereço (ou índice) de um nó ou de uma posição em uma estrutura |
| busca linear | verificar cada elemento sequencialmente a partir do primeiro até que o alvo seja encontrado ou o fim seja atingido |
| bubble sort | passadas repetidas pelo array comparando pares adjacentes e trocando aqueles fora de ordem, até que uma passada não faça trocas |
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| data type/ˈdeɪtə taɪp/ | 数据类型 | shù jù lèi xíng |
| lower bound/ˈləʊə baʊnd/ | 下界 | xià jiè |
| upper bound/ˈʌpə baʊnd/ | 上界 | shàng jiè |
| linear search/ˈlɪnɪə sɜːtʃ/ | 线性查找 | xiàn xìng chá zhǎo |
| text file/tekst faɪl/ | 文本文件 | wén běn wén jiàn |
| end of file/end ɒv faɪl/ | 文件结束 | wén jiàn jié shù |
| Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ | 抽象数据类型 | chōu xiàng shù jù lèi xíng |
10.4
Dicas de prova
- Escolha a estrutura de dados certa e justifique-a (um record para campos mistos, um array 2-D para uma grade).
- Saiba como implementar uma pilha, fila e lista encadeada com um array e ponteiros (topo; frente/traseira; next).
- Distinga um ADT (seu comportamento) de sua implementação (array mais ponteiros).
Erros comuns
- Uma declaração de registro sem
ENDTYPE, ou campos sem tipos. Cada campo é uma linhaDECLAREcom um tipo. - Ler além do fim de um arquivo, ou escrever com
WRITEquando o arquivo deve manter seu conteúdo. TesteEOFantes de cada leitura; useAPPENDpara adicionar. - Escrever um número em um arquivo de texto sem convertê-lo. Um arquivo mantém strings:
NUM_TO_STRpara fora,STR_TO_NUMde volta. - Esquecer as verificações.
Pushe enqueue testam se está cheio primeiro;Pope dequeue testam se está vazio primeiro, e a resposta diz isso. - Perder o resto da lista ao inserir um nó. Defina o ponteiro do novo nó para o nó next antigo antes de alterar o ponteiro do nó anterior.
- Uma busca linear que nunca diz "não encontrado". Inicialize a posição em $-1$ e teste-a após o loop.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.