| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 추상화에 대한 이해 | 추상화 사용의 필요성 및 혜택 추상화의 목적 설명 필수 정보만 포함하여 시스템의 추상 모델 작성 |
| 분해 설명 및 활용 | 문제를 하위 문제로 분해하여 프로그램 모듈(절차/함수) 개념 유도 |
알고리즘 설계와 문제 해결
A-Level 컴퓨터 과학 · 주제 9
 14:52
계산적 사고
여기에 과제가 있습니다: 한 상점의 재고 전체를 관리하는 시스템을 구축하세요—모든 제품, 모든 판매, 모든 배송, 모든 보고서. 하나의 거대한 문제로 볼 때, 그것은…에 너무 큽니다.
영어 내레이션 · 영어 + 중국어 자막 burned-in
9.1
컴퓨팅 사고력

Syllabus
출처: Cambridge International syllabus
컴퓨팅 사고력은 문제를 분석하고 컴퓨터가 실행할 수 있는 해결책을 설계하기 위한 mentale 도구들의 집합입니다. 핵심적인 두 가지로 추상화와 분해가 있습니다.
추상화
추상화란 문제의 필수적인 특성을 유지하고 불필요한 디테일은 무시하여 더 단순한 모델을 제공함을 의미합니다.
예시:
- 철도망 지도는 역과 노선을 유지하지만 지리학적 정보는 제거합니다.
- 클래스는 객체 지향 프로그래밍에서 시스템이 필요한 속성과 메소드만을 유지합니다.
- 함수는 특정 작업을 이름 뒤에 숨깁니다.
실제 문제에 대한 완전한 모델은 추상화 없이는 reasoning하기 너무 크므로, 추상화는 필수적입니다.
심사관은 추상의 목적과 그 장점을 묻습니다. 목적: 해결에 필요한 세부 사항만 포함하여 문제의 더 단순한 모델을 생성하는 것. 장점: 문제를 이해하고 프로그래밍하기 쉬워집니다; 프로그램 크기가 작아지고 작성 및 테스트가 빠릅니다; 동일한 모델을 유사한 문제에 재사용할 수 있습니다. 시스템에 대한 추상적 모델을 생성하라는 요청이 있을 때, 작업에 필요한 데이터와 행동만 나열하십시오. 학교 시간표의 경우 이는 수업, 교실, 교사, 기간을 의미하며, 교실 색상이나 교사 나이를 의미하지는 않습니다.

분해
분해란 큰 문제를 더 작은 하위 문제로 나누는 것을 의미하며, 각 하위 문제는 더 쉽게 해결되며 하나씩 접근됩니다.
- 작업의 주요 부분을 찾으십시오.
- 각각을 더 작은 하위 작업으로 나누십시오.
- 각 작업이 직접 설계될 만큼 작아질 때까지 계속하십시오.
- 작은 작업을 해결하고 이를 결합하십시오.
재고 관리의 경우: "재고 관리" → "판매 기록", "배송 기록", "보고서 생성" → ("판매 기록") "제품 조회", "재고 수량 감소", "거래 저장". 분해는 큰 문제를 관리 가능하게 만들고, 팀이 업무를 분배할 수 있게 하며, 모듈화된 코드를 제공합니다 — 각 모듈은 절차 또는 함수가 됩니다.
"분해가 사용되는 이유를 설명하시오"는 3점 만점 문제이며 고정된 형식을 가집니다. 세 가지 별개의 장점을 제시하십시오: 각 하위 문제는 독립적으로 설계, 코드 작성 및 테스트하기에 충분히 작습니다; 다른 프로그래머들이 동시에 서로 다른 모듈에 작업할 수 있습니다; 이미 존재하는 모듈(또는 라이브러리routine)을 재사용할 수 있으며, 오류가 한 모듈 내부에 있으므로 찾기 쉽습니다. 구조도(주제 12)는 분해의 도형입니다: 상단에 프로그램, 그 아래에 모듈, 그리고 그들 사이를 전달되는 데이터가 있습니다.

탐색하기
컴퓨팅 방식으로 문제를 해결
네 가지 기둥을 사용할 순서에 따라 단계별로 진행하십시오 — 문제를 분해하고, 반복되는 부분을 찾아내며, 필수 요소만 남기고, سپس 단계를 작성하십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ | The set of mental tools for analysing a problem and designing a solution a computer can run. |
| abstraction/əbˈstrækʃn/ | Representing essential features while leaving out unnecessary detail. |
| decomposition/ˌdiːkɒmpəˈzɪʃn/ | The breakdown of a substance or system into simpler components. |
| sub-problem/sʌb ˈprɒbləm/ | sub-problem |
| procedure/prəˈsiːdʒə/ | A named sequence of instructions that performs a task when called. |
| modules/ˈmɒdjuːlz/ | modules |
| algorithm/ˈælɡərɪθəm/ | A finite sequence of precise steps for solving a problem or carrying out a task. |
| sequence/ˈsiːkwəns/ | Statements executed one after another in the order written. |
| unambiguous/ʌnæmˈbɪɡjuːəs/ | unambiguous |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | deterministic |
9.2
알고리즘
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 알고리즘이 정의된 단계의 순서로 표현된 문제 해결책임을 이해 | |
| 문제가 사용하는 데이터를 표현하기 위한 적절한 식별자 이름 사용 및 식별자 표를 통해 표시 | |
| 입력, 처리, 출력을 포함하는 가상의 코드 작성 | |
| 순서, 선택, 반복이라는 세 가지 기본 구성 요소를 사용하는 가상의 코드 작성 | |
| 단순한 알고리즘을 구조화된 영어 설명, 플로우 차트 또는 가상의 코드로 문서화 | |
| 다음으로부터 가상의 코드 작성: • 구조화된 영어 설명 • 플로우 차트 | |
| 다음으로부터 플로우 차트 그리기: • 구조화된 영어 설명 • 가상의 코드 | |
| 단계적 정교화 과정을 설명하고 사용하여 작업이 프로그래밍 가능한 수준의 디테일로 알고리즘 표현 | |
| 논리 문을 사용하여 알고리즘 해법의 일부 정의 |
출처: Cambridge International syllabus
알고리즘은 정의된 단계들의 순서로 표현된 해결책입니다. 각 단계는 모호하지 않으며(단일 의미), 결정론적이며(동일한 입력 → 동일 출력), 유한하며(단계가 종료됨), 실행 가능하며(각 단계 수행 가능)입니다. 알고리즘은 구현에 사용된 프로그래밍 언어와 무관하게 무엇을 해야 하는지를 명시합니다.
탐색하기
선택: IF / ELSE 분기를 따르십시오.
점수를 드래그하여 어떤 분기가 실행되는지 확인하십시오. 선택 구조는 각 조건을 순서대로 테스트하며, 첫 번째로 참인 조건을 선택합니다 — 이것이 IF … ELSE IF … ELSE가 작동하는 방식입니다.
9.2
식별자 표

알고리즘을 시작할 때 모든 데이터 항목을 식별자 표에 나열하십시오 — 식별자(변수명), 데이터 유형, 및 설명. 시험의 표에는 정확히 이 세 가지 열이 있습니다:
| 식별자 | 데이터 유형 | 설명 |
|---|---|---|
Category |
STRING |
제품 카테고리 |
SaleDate |
DATE |
품목이 판매된 시점 |
ItemCost |
REAL |
품목의 비용 |
⦿ InStock |
⦿ BOOLEAN |
재고가 있을 때만 ⦿ TRUE |
Sales |
ARRAY[1:30] OF REAL |
최근 30일 일일 판매 총계 |
기술적 이름(ItemCost, x 아님)을 사용: 식별자는 문자로 시작하고, 공백을 포함하지 않으며, 매번 동일한 방식으로 표기해야 합니다. 일반적인 유형은 INTEGER, REAL, STRING, CHAR, BOOLEAN, DATE 및 배열입니다. 테이블은 코드 작성 전에 모든 데이터에 이름을 부여하도록 강제하며, "식별자 표 완성" 문제에서는 올바른 데이터 유형이나 설명마다 1점을 제공하므로 가설코드 가이드에 따라 유형을 정확히 적어야 합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| identifier table/aɪˈdentɪfaɪə ˈteɪbl/ | A table listing each identifier used in an algorithm with its data type and a description of its purpose. |
| identifier/aɪˈdentɪfaɪə/ | identifier |
| Boolean/ˈbuːlɪən/ | Relating to logic with the two values true and false. |
9.2
가설어 — 세 가지 기본 구성 요소

가설어는 알고리즘을 설명하는 구조화되고 언어 중립적인 방식입니다.
1. 순서
단계가 하나씩 연속으로 실행됩니다 (순서):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. 선택
조건에 따라 실행할 단계를 선택합니다 (선택):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
더 많은 옵션을 위해 CASE OF ... ENDCASE를 사용하십시오.
3. 반복
블록을 반복执行 (반복, 루프):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
WHILE 루프는 각 반복 전(처음부터 실행되지 않을 수도 있음)에 조건을 테스트합니다. REPEAT...UNTIL 루프는 각 반복 후(최소 한 번은 반드시 실행됨)에 조건을 테스트합니다.
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
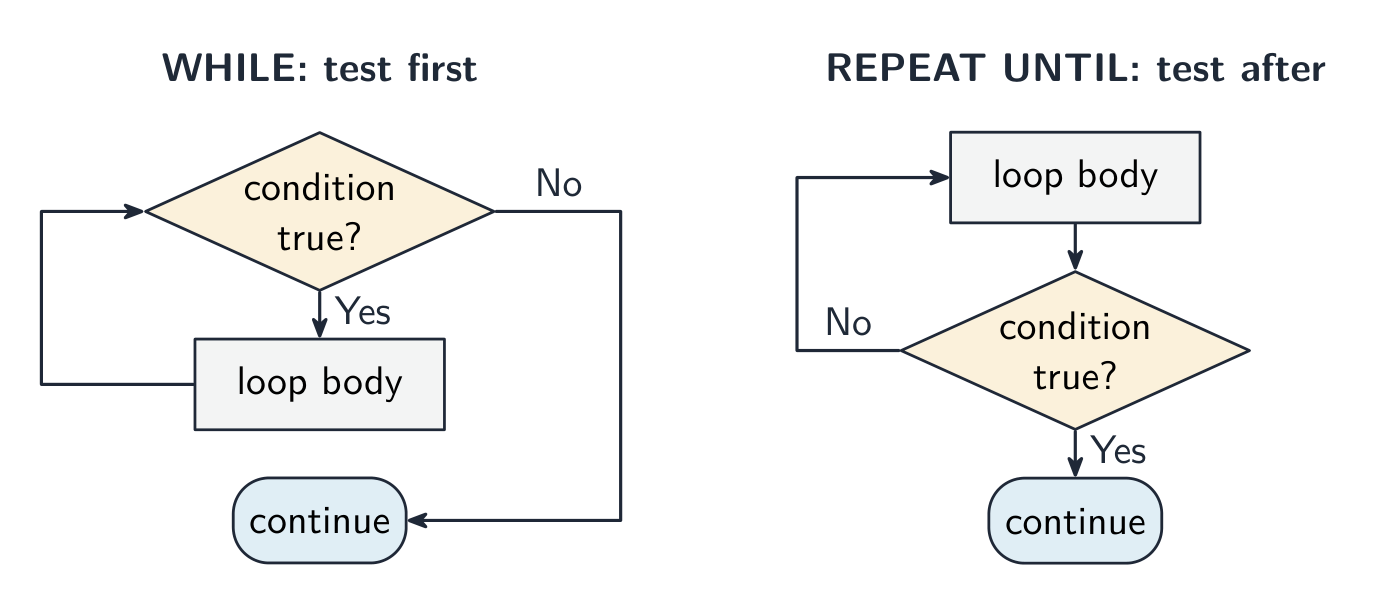
루프를 선택하는 것 자체가 점수입니다: FOR 반복 횟수가 확실할 때(카운트 제어 루프) ; WHILE 루프가 아예 실행되지 않을 수 있을 때(전조건 루프) ; REPEAT ... UNTIL 입력 검증과 같이 최소 한 번은 반드시 실행되어야 할 때(후조건 루프). "반복 구조를 설명하시오"라는 답안은 구조의 이름을 명시하고, 조건이 어디에서 테스트되는지, 그리고 그 결과(영회 또는 최소一回)를 제시해야 합니다.
일반적인 연산
- 대입:
x ← 5(화살표;=는 비교용). - 입출력:
INPUT variable,OUTPUT expression. - 비교
=,<>,<,>,<=,>=; 논리AND,OR,NOT. - 산술 연산
+ - * /, 더하기DIV(정수 나눈 값) 및MOD(나머지). - 문자열:
LENGTH,LEFT,RIGHT,MID, 그리고&를 사용하여 연결 (합치기).
시험에서 요구하는 가명어
모든 가명어 답안은 캠브리지의 공식 가명어 가이드에 따라 채점됩니다. 아래 형식을 정확히 쓰십시오:
| 구성 요소 | 가명어 |
|---|---|
| 변수 | DECLARE Total : INTEGER |
| 배열 | DECLARE Marks : ARRAY[1:30] OF REAL |
| 상수 | CONSTANT MaxTries = 3 |
| 할당 | Total ← Total + Value |
| 입력 / 출력 | INPUT NameOUTPUT "Hello ", Name |
| 선택 구조 | CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASE |
| FOR 루프 | FOR i ← 1 TO 10 STEP 2 ... NEXT i |
| WHILE 루프 | WHILE Total < 100 DO ... ENDWHILE |
| REPEAT 루프 | REPEAT ... UNTIL Mark >= 0 |
| 정수 산술 | 17 DIV 5 = 317 MOD 5 = 2 |
| 문자열 | LENGTH(S), LEFT(S, 3), RIGHT(S, 2)MID(S, 2, 4), TO_UPPER(S), TO_LOWER(S) |
| 변환 | INT(3.7) = 3, NUM_TO_STR(12)STR_TO_NUM("4.5"), ASC('A') = 65, CHR(66) = 'B' |
| 무작위 | RAND(100)INT(RAND(100)) + 1 |
RAND(100)는 0 이상 100 미만의 실수를 반환합니다. INT(RAND(100)) + 1은 1 이상 100 이하의 정수를 반환합니다.
모든 문제에서 두 가지 습관이 점수를 받습니다: 식별자 표에서 type을 명시하여 사용하는 모든 변수를 선언하고, 루프가 시작되기 전에 그 루프 내에서 변경되는 모든 카운터와 합계(Count ← 0, Total ← 0)를 초기화하십시오.
입력 → 처리 → 출력
모든 프로그램은 이 형태를 따릅니다:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
입력값과 출력값을 먼저 나열하면 알고리즘이 더 명확해집니다.
해설 예제. 100개의 정수를 입력받아, 그중 10 이상 20 이하인 수의 개수와 총합을 출력하는 가명어를 쓰십시오.
식별자 표: Count : INTEGER (루프 카운터), Value : INTEGER (방금 입력된 정수), InRange : INTEGER (범위에 속한 수의 개수), Total : INTEGER (그들의 합).
DECLARE Count, Value, InRange, Total : INTEGER
InRange ← 0
Total ← 0
FOR Count ← 1 TO 100
    INPUT Value
    IF Value >= 10 AND Value <= 20 THEN
        InRange ← InRange + 1
        Total ← Total + Value
    ENDIF
NEXT Count
OUTPUT InRange, Total
질문에서 이후로 "두 가지 구성 요소를 식별하고 각각 어떻게 사용되었는지 설명하시오"라고 묻는다면, 동일한 형태로 답하십시오: 반복, FOR 루프는 입력을 100번 반복함; 선택, IF 문장은 오직 범위에 있을 때만 값을 추가함.
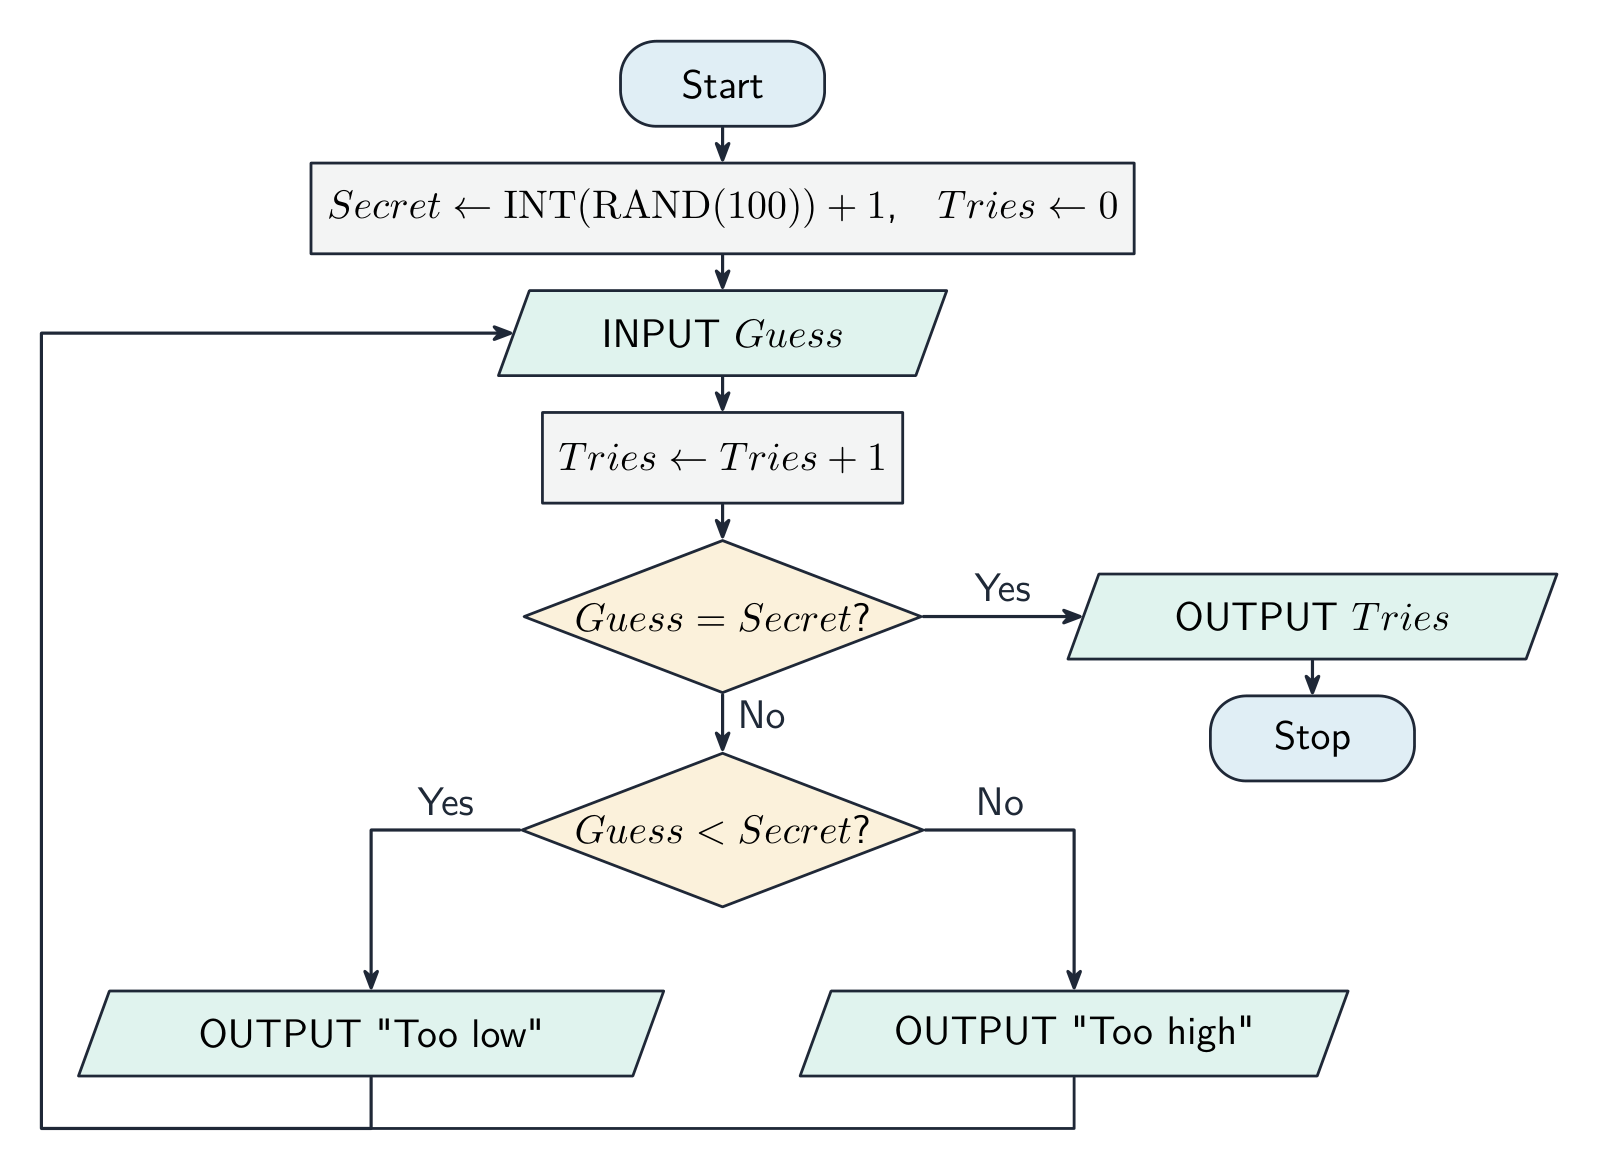
해설 예제. 1부터 100 사이의 비밀 정수를 한 개 선택합니다. 사용자가 맞출 때까지 추측하며, 틀린 추측마다 프로그램은 "너무 낮음" 또는 "너무 높음"이라고 표시하고, 마지막에는 총 추측 횟수를 출력합니다.
식별자 표: Secret : INTEGER (추측할 숫자), Guess : INTEGER (사용자의 입력), Tries : INTEGER (지금까지의 추측 횟수).
DECLARE Secret, Guess, Tries : INTEGER
Secret ← INT(RAND(100)) + 1
Tries ← 0
REPEAT
    INPUT Guess
    Tries ← Tries + 1
    IF Guess < Secret THEN
        OUTPUT "Too low"
    ELSE
        IF Guess > Secret THEN
            OUTPUT "Too high"
        ENDIF
    ENDIF
UNTIL Guess = Secret
OUTPUT "You took ", Tries, " guesses"
사용자는 최소 한 번은 추측해야 하므로 REPEAT ... UNTIL 루프가 적절한 선택입니다. 채점 포인트는 다음과 같습니다: 올바른 범위 내의 무작위 번호, 올바른 추측 시 종료되는 루프, 0으로 시작하여 루프 내부에서 증가하는 카운터, 올바른 조건 하에서 표시되는 두 가지 메시지, 그리고 최종 출력.
해설 예제. $-10$부터 $10$까지의 두 서로 다른 무작위 정수를 출력합니다.
21가지 가능한 값이 있으므로, INT(RAND(21))은 0부터 20까지를 반환하며 10을 빼면 범위가 $-10$부터 $10$까지로 조정됩니다. 두 번째 숫자는 첫 번째 숫자와 다르도록 다시 생성되어야 합니다:
DECLARE First, Second : INTEGER
First ← INT(RAND(21)) - 10
REPEAT
    Second ← INT(RAND(21)) - 10
UNTIL Second <> First
OUTPUT First, Second

탐색하기
IF … ELSE 선택
값을 변경하면 어떤 분기가 실되는지 보십시오—프로그램이 결정을 내리는 방법입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| variable/ˈveərɪəbl/ | A quantity or named value that can change or take different values. |
| data type/ˈdeɪtə taɪp/ | A classification of values that determines their representation and permitted operations. |
| pseudocode/ˈsuːdəʊkəʊd/ | A language-independent description of an algorithm using structured, programming-like statements. |
| flowchart/ˈfləʊtʃɑːt/ | A diagram showing the sequence of steps and decisions in a process or algorithm. |
| selection/sɪˈlekʃn/ | Choosing which branch of instructions to execute according to a condition. |
| iteration/ˌɪtəˈreɪʃn/ | Repeating a sequence of instructions or calculations. |
| loop/luːp/ | A structure that repeats a sequence of instructions. |
| count-controlled loop/kaʊnt kənˈtrəʊld luːp/ | A loop that repeats according to a counter, usually for a specified number of iterations. |
| pre-condition loop/priː kənˈdɪʃn luːp/ | A loop that tests its continuation condition before executing its body, so the body may run zero times. |
| post-condition loop/pəʊst kənˈdɪʃn luːp/ | A loop that tests its continuation or termination condition after executing its body, so it runs at least once. |
| assignment/əˈsaɪnmənt/ | Storing a value in a variable or other named location. |
| concatenation/kənˌkætəˈneɪʃn/ | Joining sequences, such as strings, end to end. |
| initialise/ɪˈnɪʃəlaɪz/ | initialise |
| counter/ˈkaʊntə/ | counter |
| structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ | Natural language with indentation and fixed keywords. |
| stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ | Breaking each step of an outline into smaller steps, repeatedly, until each step can be coded directly. |
| logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ | A skill the papers test directly. |
| precedence/ˈpresɪdəns/ | The rules determining which operators or actions are applied before others. |
| De Morgan's law/də ˈmɔːɡənz lɔː/ | De Morgan's law |
9.2
세 가지 표기법

동일한 알고리즘을 세 가지 방식으로 작성할 수 있습니다.
- 구조화 영어 —suitable for a high-level description. indentation와 고정된 키워드를 사용한 자연어; 고수준 설명에 적합합니다.
- 흐름도 — 표준 도형으로 구성된 도식:
| 도형 | 의미 |
|---|---|
| 둥근 직사각형 | 시작 / 멈춤 |
| 평행사각형 | 입력 / 출력 |
| 직사각형 | 처리 |
| 다이아몬드 | 결정 |
| 화살표 | 제어 흐름 |
- 가명어 — 위 키워드 표기법; 코드와 가장 유사합니다.
어떤 쌍 사이에서도 변환할 수 있어야 합니다: 각 IF은 결정 다이아몬드이며, 각 루프는 뒤로 가는 화살표이고, 일련의 과정은 쌓인 직사각형입니다.
IF ... THEN ... ELSE ... ENDIF
9.2
단계적 세분화

단계적 세분化는 고수준 개요에서 시작하여 각 단계를 확장하여 코딩할 수 있는 수준이 될 때까지 진행합니다. $n$개 숫자의 평균을 구하는 경우:
Level 1:
Read in the numbers
Compute the average
Output the average
Level 2:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
각 세분화는 이전 구조를 유지하며 디테일을 추가합니다.
6점 만점의 "단계적 세분화 적용" 문제는 고수준 개요를 제시하고 각 단계를 프로그래머가 실제로 코딩할 수 있는 구체적인 명칭으로 확장하기를 원합니다. 단계는 같은 순서로 유지하고, 각 단계가 읽거나 생성하는 데이터를 명시하며, 모든 줄이 단일 입력, 할당, 출력, 루프 또는 조건文장인 지점까지 확장하지 않습니다. 예를 들어, "비밀번호를 검증하다"는 다음과 같이 변형됩니다: 비밀번호 입력; 길이가 최소 8자리인지 확인; 최소 한 자릿수 숫자가 포함되어 있는지 확인; 두 조건 모두 통과 시 "accepted" 출력, 그렇지 않으면 "rejected" 출력.
탐색하기
단계적 세분화: 초안부터 코드까지
수준을 내려갑니다. 전체 작업을 한 줄로 시작하여 각 단계를 작은 부분으로 계속 확장합니다 — 모든 단계가 직접 코딩할 만큼 단순해질 때까지.
9.2
논리 문장

논리 문장은 분기( branching )를 제어하는 부울리안(Boolean) 조건으로, 비교 연산자(x > 10), 논리 연산자(AND, OR, NOT) 및 괄호로 구성됩니다. 이를 IF, WHILE 또는 REPEAT...UNTIL의 조건으로 사용합니다:
WHILE attempts < 3 AND NOT loggedIn DO
    INPUT password
    IF password = correctPassword THEN
        loggedIn ← TRUE
    ELSE
        attempts ← attempts + 1
    ENDIF
ENDWHILE
우선순위(최상위부터 최하위): NOT, 이후 AND, 이후 OR. 불확실할 때는 괄호를 사용하십시오. 흔한 오류:
a = 1 OR 2는 틀린 표기입니다 —a = 1 OR a = 2을 쓰십시오.NOT a > 5는NOT (a > 5)을 의미하며, 즉a <= 5입니다.NOT (A AND B)는(NOT A) OR (NOT B)과 동일합니다(데摩根 법칙) — 조건을 간소화하는 데 유용합니다.
문장을 논리 문장으로 변환하는 것은 시험에서 직접적으로 테스트하는 기술입니다. "5세 미만이거나 65세 이상인 모든 사람에게 티켓은 무료"는 Age < 5 OR Age > 65가 됩니다. "점수가 유효하려면 0부터 100 사이의 정수여야 한다"는 Mark >= 0 AND Mark <= 100이 됩니다. "파일이 완료되거나 열 개 기록을 읽었을 때 루프가 멈춘다"는 UNTIL EOF(File) OR Count = 10이 됩니다. 각 비교를 완전히 기저하여 기서십시오: Age > 65과 Age < 5, 절대 Age > 65 OR < 5은 사용하지 마십시오.
*우선순위: NOT가先に loggedIn에 바인딩되고, 이후 AND가 양측을 결합함
풀이 예제. 10개의 수를 입력받아 가장 큰 값을 출력하기 위한 식별자 표와 가상 코드를 작성하십시오. 식별자 표는 각 변수에 데이터 타입과 용도를 명시하여 이름 붙여줍니다: Count : INTEGER(루프 카운터), Num : REAL(방금 입력된 수), Max : REAL(현재까지의 최대값).
Max ← -999999
FOR Count ← 1 TO 10
    INPUT Num
    IF Num > Max THEN
        Max ← Num
    ENDIF
NEXT Count
OUTPUT Max
채점이 결정되는 설계적 판단은 Max 초기화입니다. 이는 가능한 모든 입력 값보다 낮게 시작해야 하며, 더 안전하게는 처음 입력된 첫 번째 수로 설정하는 것이 좋습니다. 이를 0로 초기화하면 알고리즘은 음수 목록에 대해 0을 잘못 반환하는데, 이는 테스트 데이터에 음수가 포함되어 있을 때만 추적을 통해 발각되는 버그입니다.
알고리즘 문제용 프로그래밍 전제 지식
알고리즘을 작성하거나 추적하기 전에, 시트 11.1.1–11.1.2의 표현식 및 내장 함수 방법을 사용하십시오. TO_UPPER와 TO_LOWER는 전체 문자열을 처리하며, UCASE와 LCASE는 가이드에 따라 단일 문자를 조작합니다. 문제의 지시사항을 따르십시오.
문자열을 &로 결합하십시오; 숫자를 결합하기 전에 NUM_TO_STR로 변환하십시오. 프로시저를 호출할 때는 CALL Name(arguments)를 사용하고, 함수는 표현식으로 활용하십시오. SETDATE(day, month, year)는 DATE 값을 생성합니다. 평가 전에 타입을 확인하십시오: 유효하지 않은 표현식은 ERROR이며, 추측된 변환이 아닙니다.
여러 합계를处理的 플로우차트의 경우, 루프 시작 전에 모든 accumulator를 초기화하십시오. 올바른 분기에서 업데이트하고 카운트를 증가시킨 후 종료를 테스트하십시오. 평균은 루프 후에 계산하며, 실제로 포함된 값의 개수를 사용하십시오.
9.2
출제자가 인정하는 정의
정의 문제는 고정된 문구로 채점합니다. 이 내용들을 정확히 외우고, 답은 하나만 제시하십시오.
| 용어 | 정의 |
|---|---|
| 추상화 | 문제의 핵심적인 세부 사항만을 유지하고 필요 없는 세부 사항은 제외함 |
| 분해 | 문제를 더 작은 하위 문제로 나누어, 각각을 독립적으로 해결 가능하게 함 |
| 알고리즘 | 정의된 단계들의 순서열로 표현된 문제 해결 방법 |
| 식별자 표 | 알고리즘에서 사용되는 각 식별자의 데이터 타입과 용도 설명을 나열한 표 |
| 가상 코드 | 언어에 종속되지 않고 구조화된 방식으로 알고리즘의 단계를 작성하는 방법 |
| 흐름도 | 표준 기호와 화살표로 연결하여 알고리즘의 단계와 결정을 나타내는 도식 |
| 순차 | 작성된 순서에 따라 Statements가 하나씩 실행됨 |
| 선택 | 조건에 따라 실행할 Statements를 선택함 |
| 반복 | 조건이 성립하거나 끝날 때까지 Statements 그룹을 반복함 |
| 단계별 정교화 | 초안의 각 단계를 다시 작은 단계로 나누어, 각 단계가 바로 코딩될 수 있을 때까지 반복함 |
| 논리 문장 | 비교 연산자와 AND, OR, NOT 연산자를 사용하여 TRUE 또는 FALSE를 평가하는 조건 |
9.2
시험 팁
- 알고리즘을 언어와 무관한 모호하지 않고 유한하며 결정론적인 단계의 순서열로 정의하십시오.
- 세 가지 구성 요소인 순차, 선택, 반복을 올바르게 사용하고, 데이터 타입이 포함된 식별자표를 유지하십시오.
- 문제를 분해와 추상화로 나누어 단계별 정교화를 수행하십시오.
- 실제로 실행 가능한 가상 코드를 작성하십시오: 변수를 선언하고 시험의 가상 코드 스타일을 따르십시오.
흔한 실수
=를 사용하여 값을 할당하는 것. 할당은←이며,=은 비교입니다.ENDIF,ENDWHILE,ENDCASE또는NEXT을 잊어버림. 모든 구성 요소는 닫혀야 하며, 닫는 단어 위치가 해당 구성 요소의 채점 기준입니다.- 루프 전에 합계나 카운터를 초기화하지 않아, 존재하지 않는 값에 추가하게 됨.
- 반복 횟수가 알 수 없을 때
FOR루프를 사용함. sentinel value 또는 정확한 추측이 들어올 때까지 읽을 때는WHILE또는REPEAT ... UNTIL이 필요합니다. Age > 65 OR < 5를 작성함.OR과AND의 양측은 모두 완전한 비교여야 합니다.- "분해가 사용되는 이유를 설명하라"에 대해 한 장점을 세 가지 다른 방식으로 적음. 3점 문제는 세 가지 서로 다른 장점을 요구함.
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.