| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 컴퓨터 시스템에 대한 기본 폰 노이만(Von Neumann) 모델 및 **저장 프로그램(concept)**에 대한 이해 | |
| **레지스터(registers)**의 목적과 역할에 대한 이해, 일반 목적 register와 전용 register의 차이 포함 | 전용 register 포함: • 프로그램 카운터(PC) • 메모리 데이터 레지스터(MDR) • 메모리 주소 레지스터(MAR) • 누적기(ACC) • 인덱스 레지스터(IX) • 현재_instruction 레지스터(CIR) • 상태 register |
| 산술 논리 단위(ALU), 제어 단위(CU), 시스템 클록, **즉시 접근 저장(IAS)**의 목적과 역할에 대한 이해 | |
| 주소 버스, 데이터 버스, 제어 버스를 사용하여 컴퓨터 시스템의 다양한 구성 요소 간 데이터가 전송되는 방식을 이해하기 | |
| 요인이 컴퓨터 시스템 성능에 기여하는 방식을 이해하기 | 포함: • 프로세서 유형 및 코어 수 • 버스 폭 • 클럭 속도 • 캐시 메모리 |
| 다양한 **포트(port)**가 주변 장치에 연결되는 방식 이해 | 유니버설 직렬 버스(USB), 고해상도 멀티미디어 인터페이스(HDMI), **비디오 그래픽 어레이(VGA)**와의 연결 포함 |
| Fetch-Execute(F-E) 주기의 단계를 설명하기 | F-E 주기를 설명하고 '레지스터 전송' 표기법을 사용하여 서술하기 |
| **인터럽트(interrupts)**의 목적에 대한 이해 | 인터럽트의 가능한 원인, 인터럽트의 응용, **인터럽트 서비스 routine(ISR)**의 사용, Fetch-execute 주기 중 인터럽트가 감지되는 시기, 인터럽트가 처리되는 방식 포함 |
프로세서 기초
A-Level 컴퓨터 과학 · 주제 4
 21:23
폰 노이만 아키텍처
역사 대부분 동안 기계는 하나의 작업만 수행했습니다. 직조기는 천을 짜고, 계산기는 더했습니다. 새로운 작업을 하게 하려면 재설계해야 했습니다. 그러다 기만적으로 간단한…이 등장했습니다.
영어 내레이션 · 영어와 중국어 자막 전환 가능
4.1
본 맨 아키텍처
Syllabus
출처: Cambridge International syllabus
Von Neumann 아키텍처는 거의 모든 범용 컴퓨터의 근간이 됩니다:
- 단일 메모리인 **즉시 접근 저장소(IAS)**가 프로그램 명령어와 데이터(저장된 프로그램 개념)를 모두 보관합니다.
- 프로세서(CPU)는 메모리에서 명령어를 가져와 순차적으로 실행합니다.
- 명령어는 분기가 흐름을 변경하지 않는 한 순서대로 실행됩니다.
저장 프로그램 개념은 컴퓨터의 유연성을 제공합니다. 프로그램을 변경하면 배선을 변경하지 않고도 기능을 바꿀 수 있습니다.
탐색하기
폰 노이만 컴퓨터의 구성 요소 클릭하기
각 블록을 탐색하십시오. CPU(제어 장치, ALU, 레지스터)는 버스를 통해 단일 메인 메모리와 통신하며, 명령어와 데이터를 공유하는 이 하나의 메모리가 바로 폰 노이만의 핵심 개념입니다.
4.1
CPU의 주요 구성 요소
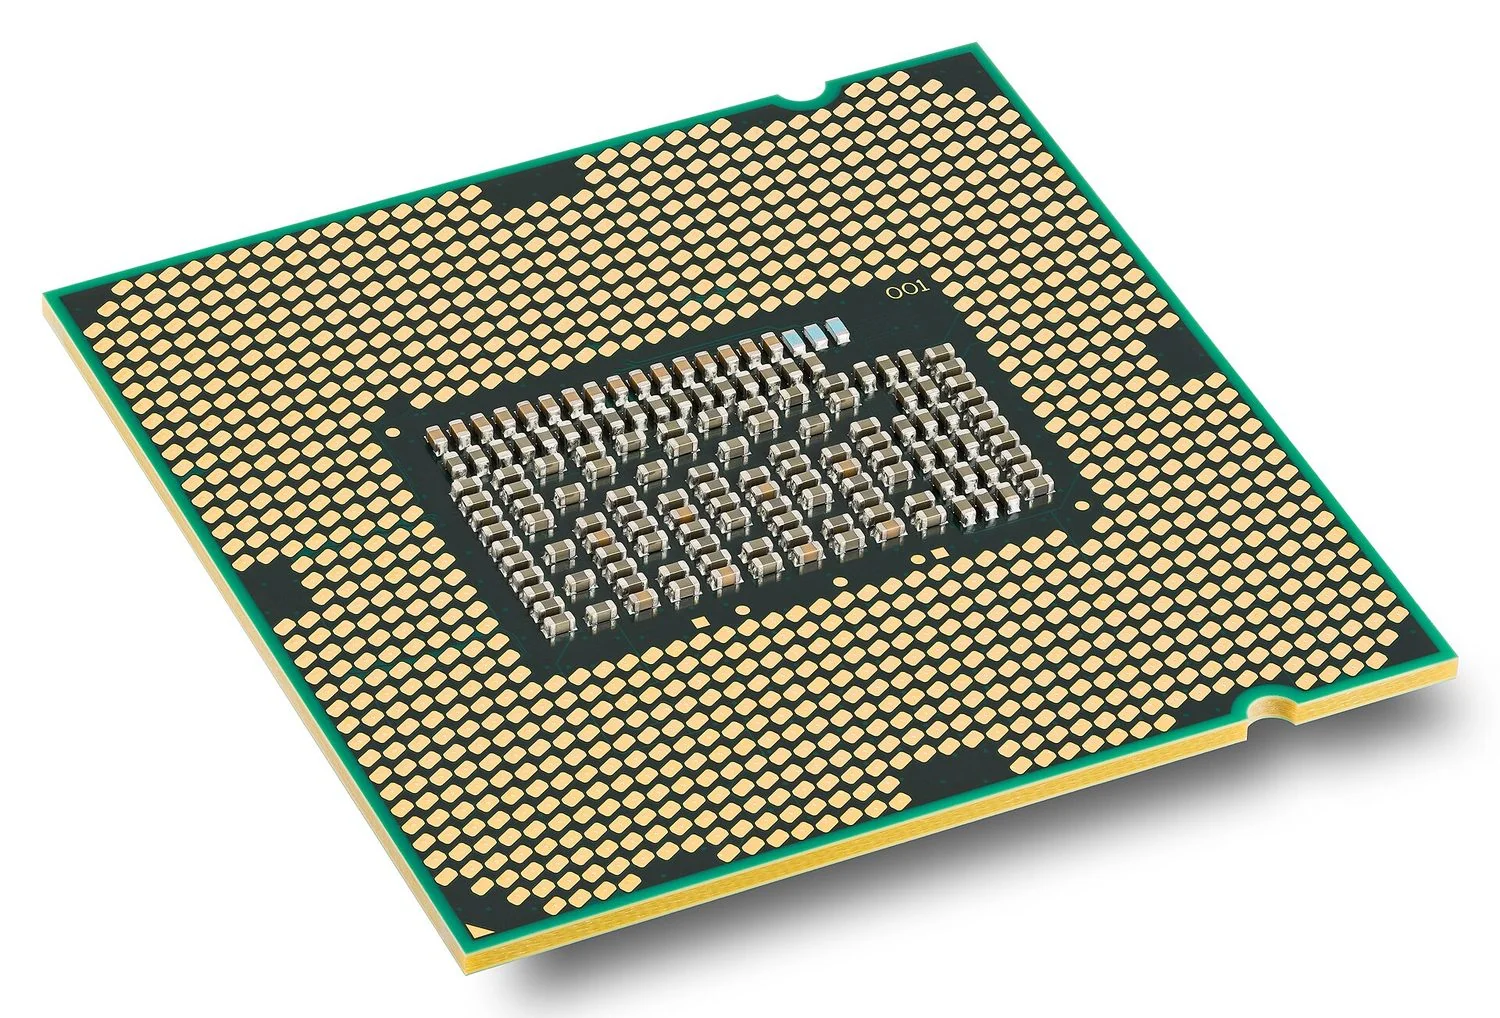
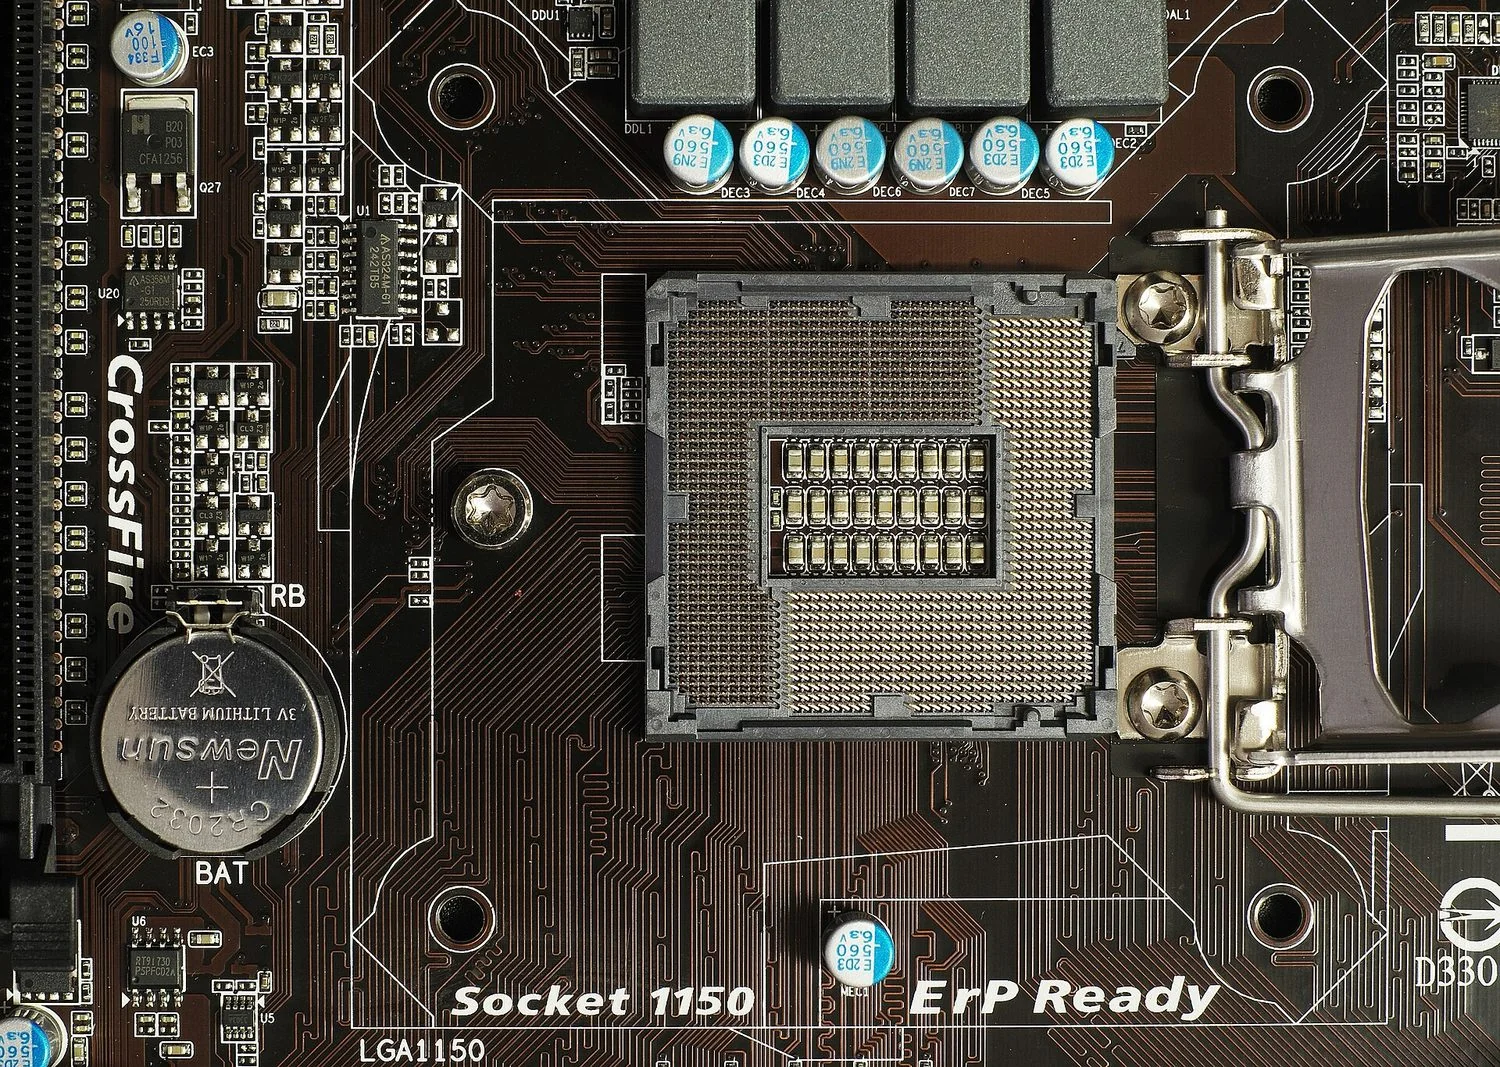
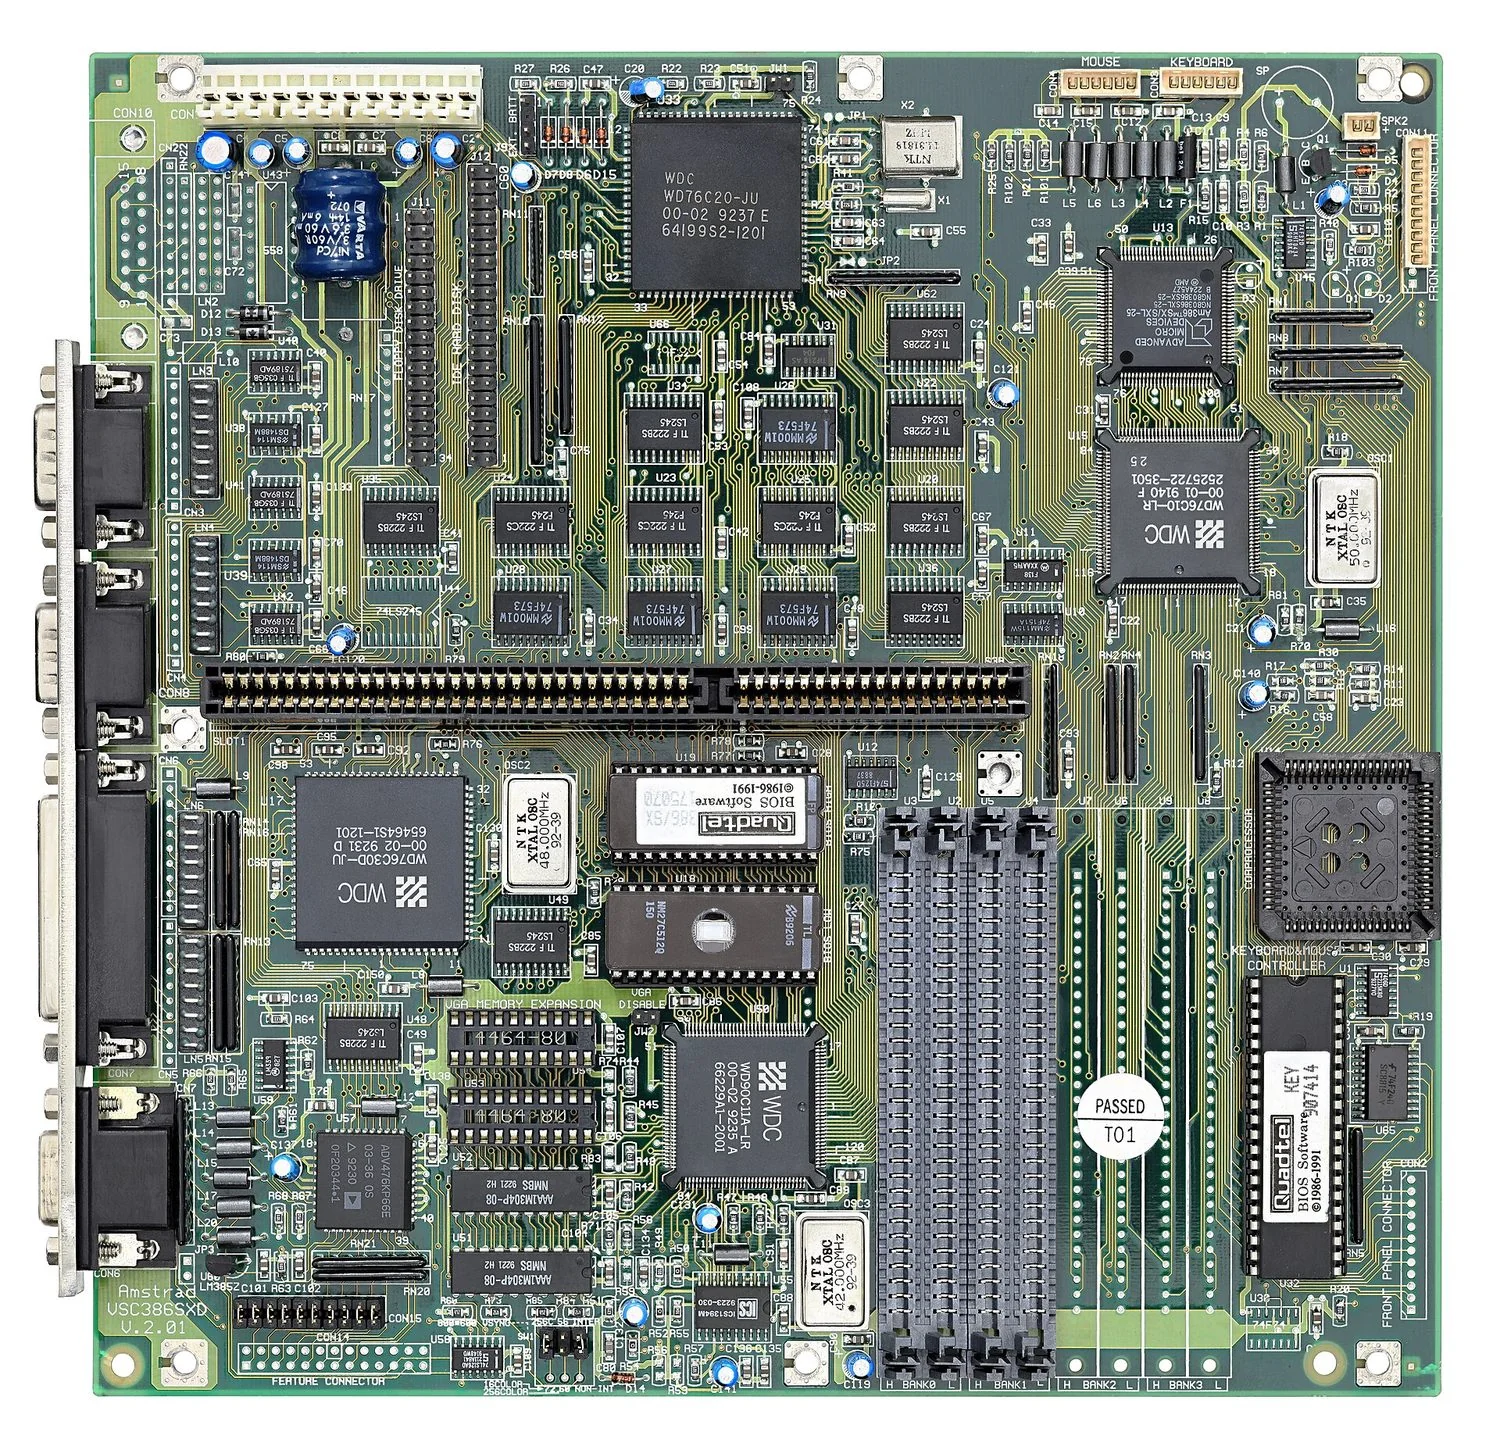
이 모든 구성 요소는 하나의 작은 칩 안에 위치합니다. 이 섹션의 후속 도표는 이들이 어떻게 연결되는지를 보여주고, 아래 사진은 실제 제품을 보여줍니다.
산술 논리 장치(ALU)
ALU는 산술 연산(덧셈, 뺄셈 등)과 논리 연산(AND, OR, 비교)을 수행합니다. 피연산자를 레지스터에서 받아 결과를 다시 레지스터에 저장합니다.
제어 장치(CU)
제어 장치는 각 명령어를 복호화하여 이를 실행하기 위한 제어 신호를 전송합니다. 데이터 경로를 열고, ALU에게 작업을 지시하며, 메모리의 읽기/쓰기를 제어합니다.
시스템 클럭
클럭은 CPU를 동기화시키는 일정한 펄스 흐름을 보냅니다. 각 명령어는 고정된 수의 사이클을 소요하며, 클럭 속도(예: 3.8 GHz)는 성능에 영향을 미치는 요인 중 하나입니다.
"CU와 시스템 클럭이 함께 작동하는 방식 설명": 클럭은 고정된 주파수로 펄스를 방출하며, 제어 장치는 각 펄스를 사용하여 fetch-execute 사이클을 한 단계씩 진행시키고, 스에 맞춰 제어 신호를 보내므로 프로세서의 모든 부분이 동시에 상태 변경을 합니다. 더 빠른 클럭은 회로가 펄스 사이에 안정화될 수 있는 한계점에 도달하기 전까지 초당 더 많은 단계를 처리할 수 있게 합니다.
레지스터
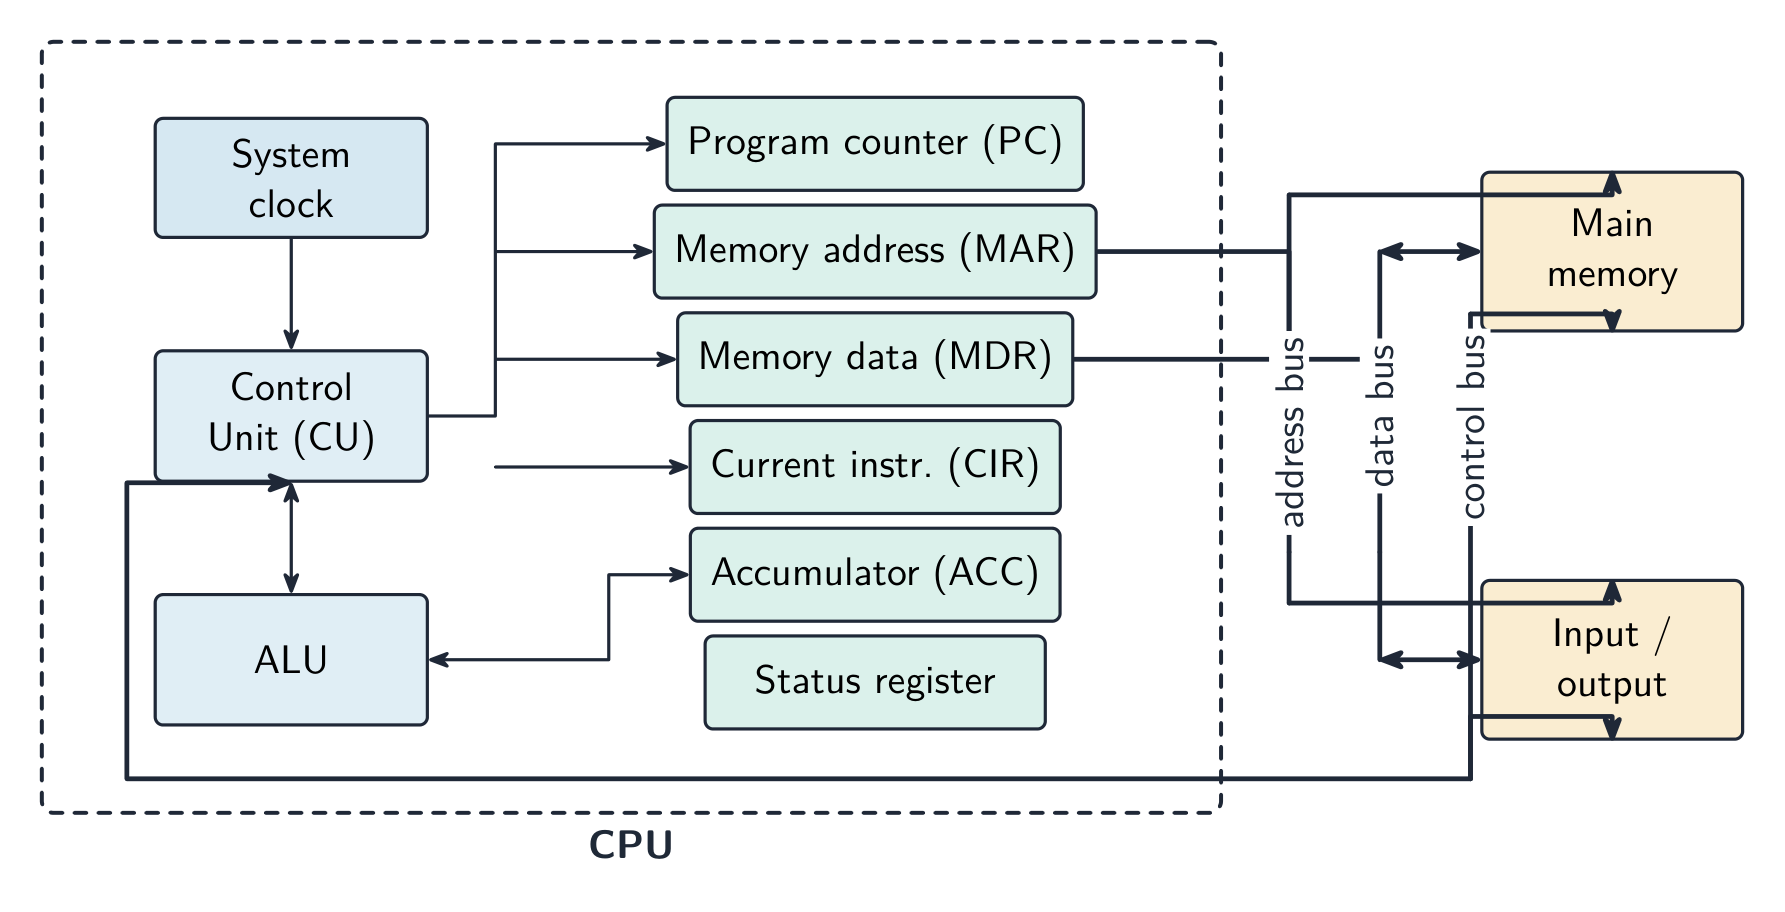
레지스터는 CPU 내부에 위치한 작고 매우 빠른 저장 장치입니다. 특수 목적 레지스터는 각기 순환 내의 고정된 역할을 수행합니다:
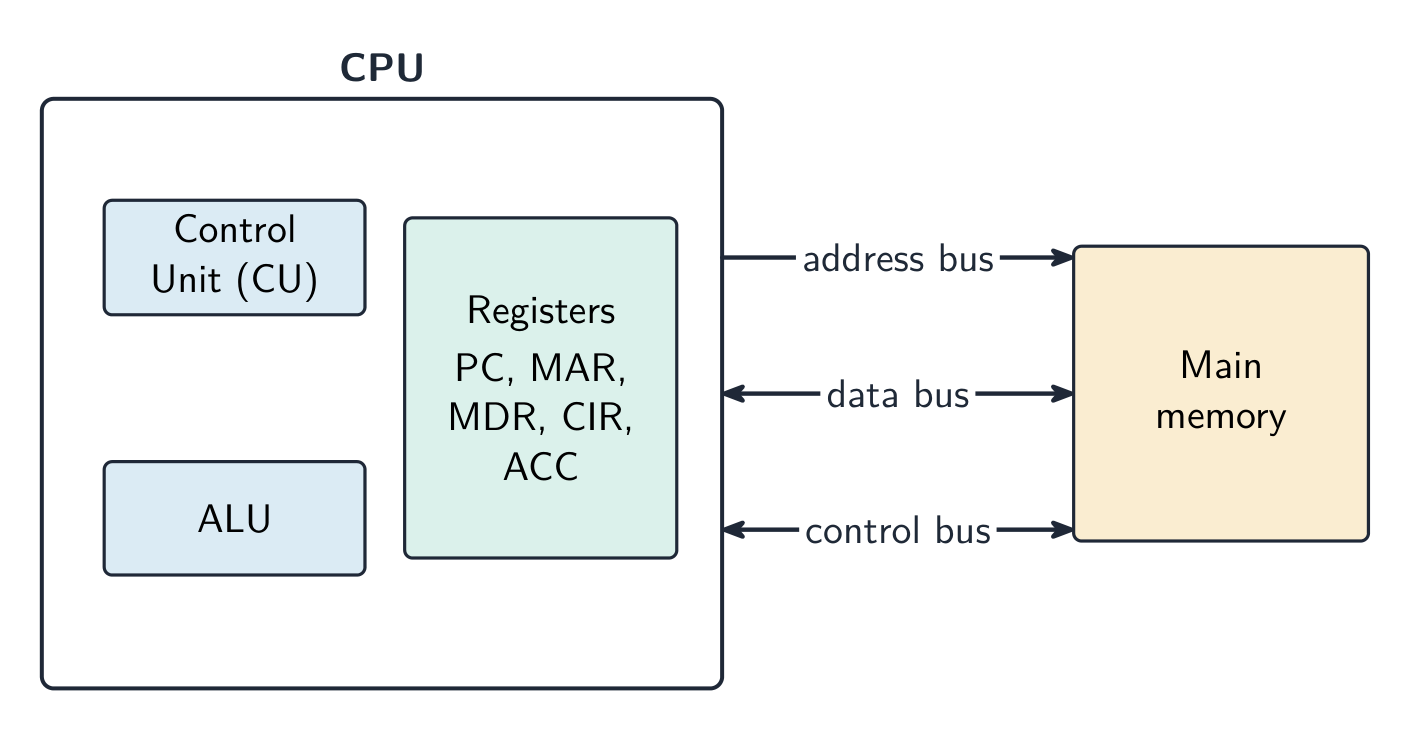
- 프로그래머 카운터(PC) — 다음 명령어의 주소입니다.
- 메모리 주소 레지스터(MAR) — 읽거나 쓰는 중인 주소입니다.
- 메모리 데이터 레지스터(MDR) — 메모리와 오가며 전송되는 데이터입니다.
- 현재 명령어 레지스터(CIR) — 디코딩 중인 명령어입니다.
- accumulator(ACC) — ALU가 연산 중인 값입니다.
- 상태 레지스터 — 분기에서 사용되는 플래그(카리, 제로, 음수, 오버플로우)를 보관합니다. 각 플래그는 1비트이며, 연산 후 ALU에 의해 설정되거나 초기화됩니다: 비교 시 일치하면 제로 플래그, 더하기 연산이 레지스터를 넘으면 카리 플래그, 결과가 음수이면 음수 플래그. 조건부 점프는 플래그를 읽어 분기 여부를 결정하며, 오버플로우 플래그는 인터럽트를 발생시킬 수 있습니다.
- 인덱스 레지스터 — 인덱스 주소를 계산할 때 주소에 추가되는 오프셋; 이를 증가시키면 배열을 한 번에 한 요소씩 순회할 수 있습니다.
각 레지스터의 역할을 설명하는 표 완성 문제에서는 다음 용어로 레지스터마다 정확한 문장 하나씩을 작성해야 합니다: PC는 가져올 다음 명령어의 주소를 보유합니다; MAR는 읽거나 쓰는 위치의 주소를 보유합니다; MDR은 그 위치에서 방금 읽었거나 곧 쓸 데이터 또는 명령어를 보유합니다; CIR는 현재 디코딩 및 실행 중인 명령어를 보유합니다; ACC는 마지막 산술 또는 논리 연산의 결과를 보유합니다.
일반 용도 레지스터는 프로그래머가 계산 중 임시 값을 저장하기 위해 사용합니다. 레지스터와 메모리 간 데이터 이동은 레지스터 전이 표기법으로 적습니다—예: MAR ← [PC] ("PC의 내용을 MAR에 복사").
어휘
연습하기
| English | 한국어 |
|---|---|
| Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ | 폰 노이만 구조 |
| Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ | 즉시 접근 저장소 |
| stored program/stɔːd ˈprəʊɡræm/ | 저장된 프로그램 |
| processor/ˈprəʊsesə/ | 프로세서 |
| arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ | 산술 논리 장치 |
| ALU/ˌeɪ el ˈjuː/ | 산술 논리 유닛(ALU) |
| accumulator/əˈkjuːmjʊleɪtə/ | 누산기 |
| Status Register/ˈsteɪtəs ˈredʒɪstə/ | 상태 레지스터 |
| flags/flæɡz/ | 표지자 |
4.1
버스
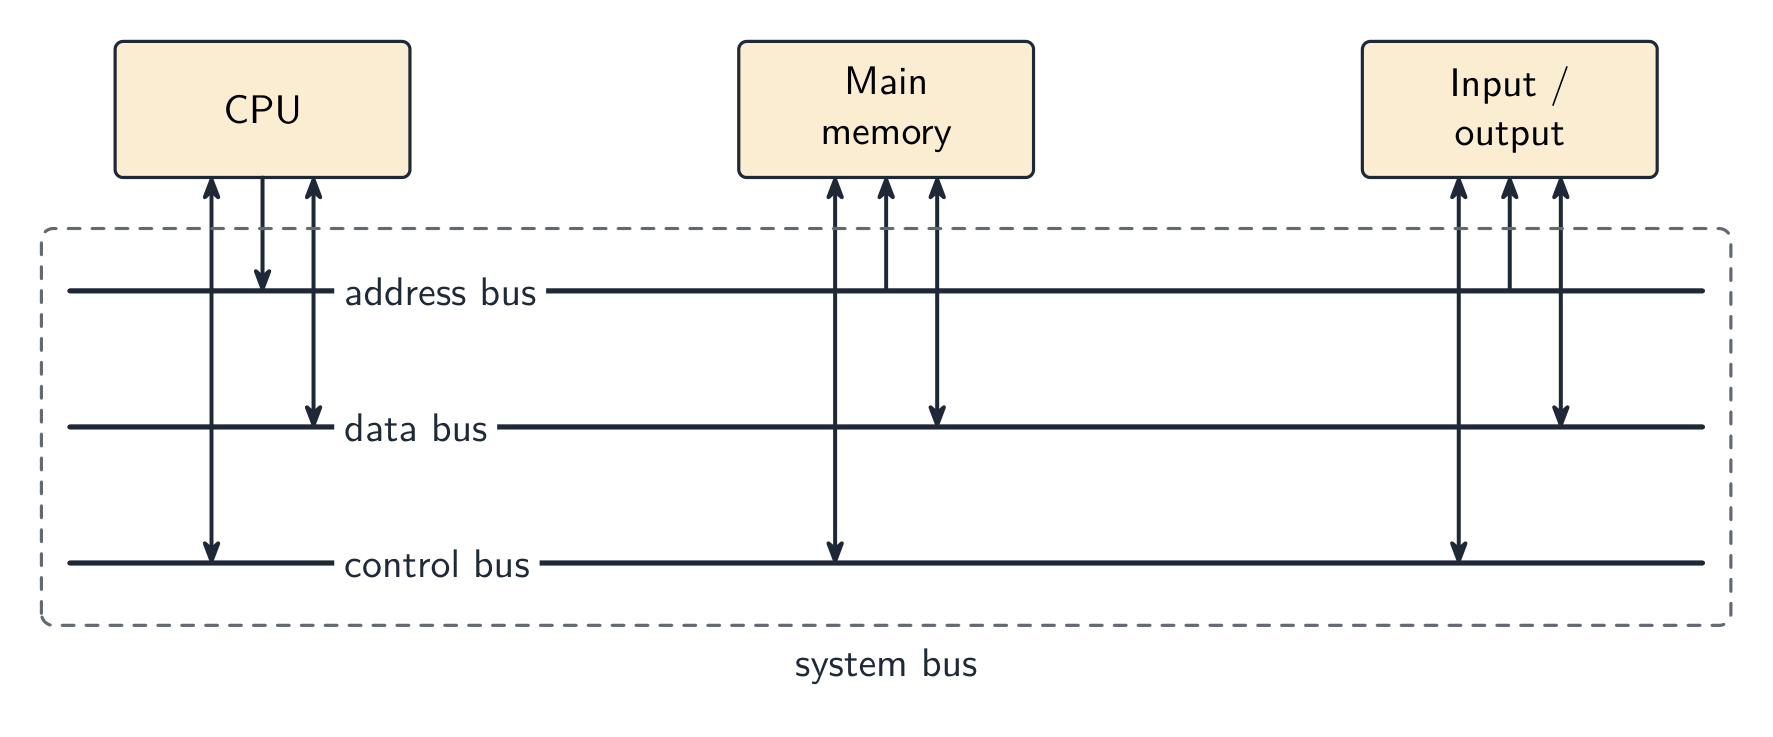
세 가지 내부 버스(병렬 선의 집합)가 각 부품을 연결합니다:
- 주소 버스 — 메모리 주소를 전송합니다. 단방향 (CPU → 메모리).
- 데이터 버스 — 데이터를 전송합니다. 양방향.
- 제어 버스 — 제어 신호(읽기, 쓰기, 인터럽트)를 전송합니다. 양방향.
An $n$-bit address bus can reach $2^{n}$ memory locations. The data-bus width sets how many bits move per access (often the word size).
어휘
연습하기
| English | 한국어 |
|---|---|
| bit/bɪt/ | 비트 |
| buses/ˈbʌsɪz/ | 버스 |
| address bus/əˈdres bʌs/ | 주소 버스 |
| data bus/ˈdeɪtə bʌs/ | 데이터 버스 |
| word size/wɜːd saɪz/ | 워드 크기 |
| number of cores/ˈnʌmbə ɒv kɔːz/ | 코어 수 |
| cores/kɔːz/ | 코어 |
| amount of RAM/əˈmaʊnt ɒv ræm/ | RAM 용량 |
4.1
성능에 영향을 미치는 요소
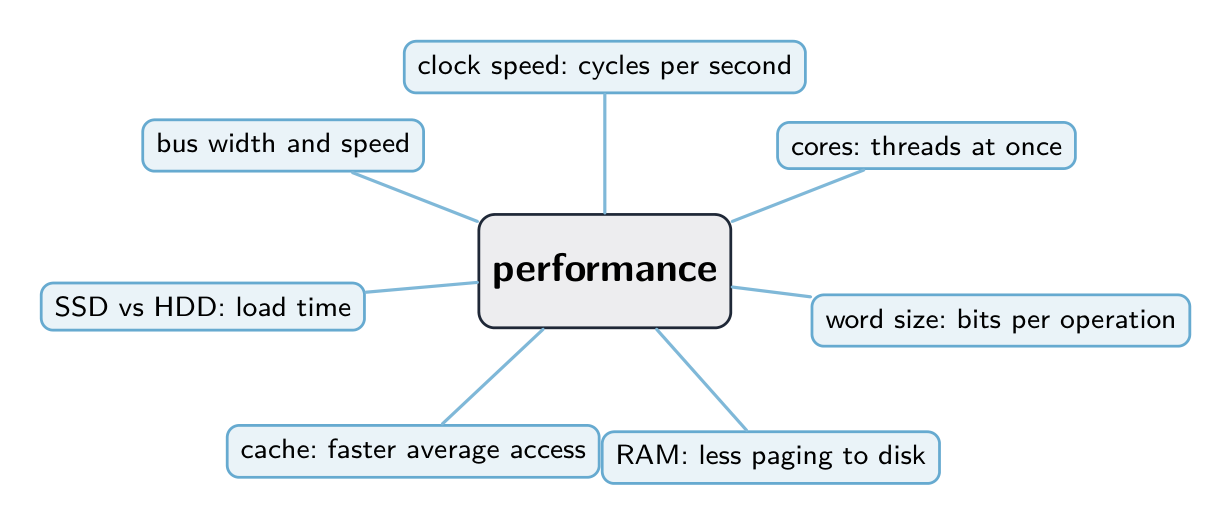
- 클럭 속도 — 초당 더 많은 사이클.
- 코어 수 — 멀티 코어 CPU는 여러 스레드를 동시에 실행합니다.
- Wort 크기 — 64비트 CPU는 한 사이클당 64비트 단위로 처리하며, 32비트 CPU보다 훨씬 더 많은 메모리를 주소 지정할 수 있습니다.
- RAM 용량—더 많은 RAM은 더 많은 작업 세트를 보유하며, 부족할 경우 OS가 페이지하여 디스크에 저장하게 됩니다.
- 캐시 메모리 크기 — 캐시가 크면 평균 메모리 접근 시간이 줄어듭니다.
- 보조 저장 장치 유형 — SSD는 HDD보다 프로그램을 훨씬 빠르게 로드합니다.
- 버스 폭과 속도 — 더 넓고 빠른 버스는 데이터를 더 빠르게 전송합니다.
사양을 작업 부하에 매칭하세요: 병렬 작업에서는 쿼드 코어가 듀얼 코어보다 우월하지만, 단일 스레드 작업에서는 코어당 속도가 높은 것이 이점을 가집니다.
각 요인은 이유를 포함하는 2점 만점 답안입니다:
- 코어 증가: 각 코어가 동시에 자신의 명령어를 가져오고 실행할 수 있으므로, 여러 프로그램 또는 하나의 프로그램 스레드가 병렬로 실행됩니다. 하지만 program이 여러 코어를 사용하도록 작성되어야 하므로, 코어 수를 두 배로 늘려도 속도는 두 배가 되지 않습니다.
- 클럭 속도 상승: 초당 더 많은fetch-execute 사이클이 발생하므로 초당 더 많은 명령어를 처리할 수 있습니다. 단, 발열이 제한 요소가 됩니다.
- 버스 폭 확대: 더 넓은 데이터 버스는 한 전송당 더 많은 비트를 이동하므로 동일한 데이터에 필요한 전송 횟수가 줄어듭니다. 더 넓은 주소 버스는 더 많은 메모리 위치를 주소 지정할 수 있습니다.
- 캐시 메모리: 프로세서 내부 또는 옆에 있는 작고 빠른 메모리로, 가장 최근에 혹은 가장 자주 사용되는 명령어와 데이터를 유지합니다. 캐시에서 읽는 것은 RAM에서 읽는 것보다 훨씬 빠르므로 프로세서가 기다리는 시간을 줄일 수 있습니다.
"새로운 컴퓨터가 왜 성능이 좋은지 설명하라"는 질문에는 두 사양을 줄 단위로 비교하여 답해야 합니다: 높은 클럭 속도는 초당 더 많은 명령어를 실행하고, 더 많은 코어는 더 많은 작업을 동시에 처리하며, 더 큰 캐시는 RAM에 대한 느린 접근을 줄이고, 더 많은 RAM은 디스크와의 전송을 줄입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| RAM/ræm/ | RAM |
| page/peɪdʒ/ | 페이지 |
| cache memory/kæʃ ˈmeməri/ | 캐시 메모리 |
| cache/kæʃ/ | 캐시 |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | 보조 저장장치 |
| port/pɔːt/ | 포트 |
| peripheral/pəˈrɪfərəl/ | 주변기기 |
| register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ | 寄存器 전송 기법 |
| interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ | 중단 서비스 routine |
| interrupt register/ˈɪntərʌpt ˈredʒɪstə/ | 중단 레지스터 |
| stack/stæk/ | 스택 |
| assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ | 어셈블리 언어 |
4.1
포트
포트는 주변 기기를 연결하기 위한 물리적 소켓입니다:
- USB(Universal Serial Bus) — 범용(키보드, 드라이브, 휴대폰).
- HDMI(High Definition Multimedia Interface) — 화면으로 가는 디지털 영상 및 오디오.
- VGA(Video Graphics Array) — 모니터로 가는 구아날로그 영상 출력.
- 이더넷(RJ-45) — 유선 LAN. 오디오 잭 — 헤드폰/마이크.
다른 포트는 서로 다른 신호를 사용하므로 HDMI 케이블은 USB 소켓에 맞지 않습니다. USB-C는 영상, 데이터, 전력을 동시에 전달하는 점이 특이합니다.
"컴퓨터가 HDMI를 통해 모니터에 연결되는 방법을 설명하라": HDMI 포트는 영상과 오디오를 하나의 디지털 신호로 단일 케이블을 통해 전송하므로 아날로그 변환이 필요하지 않으며 화질이 저하되지 않습니다. 케이블은 고해상도를 지원하며, 모니터 자체의 포트가 신호를 디코딩합니다. USB 기기는 플러그 앤 플레이입니다: 연결되면 컴퓨터가 감지하여 식별하고 필요한 드라이버를 로드하거나 설치하며, 재부팅 없이도 전원을 공급할 수 있습니다.
4.1
Fetch-Execute 사이클
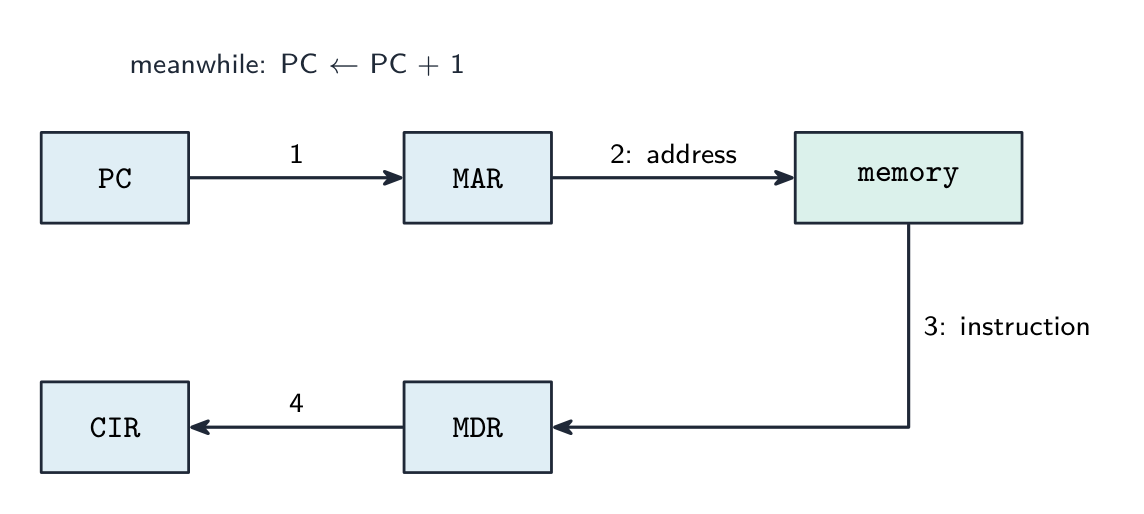
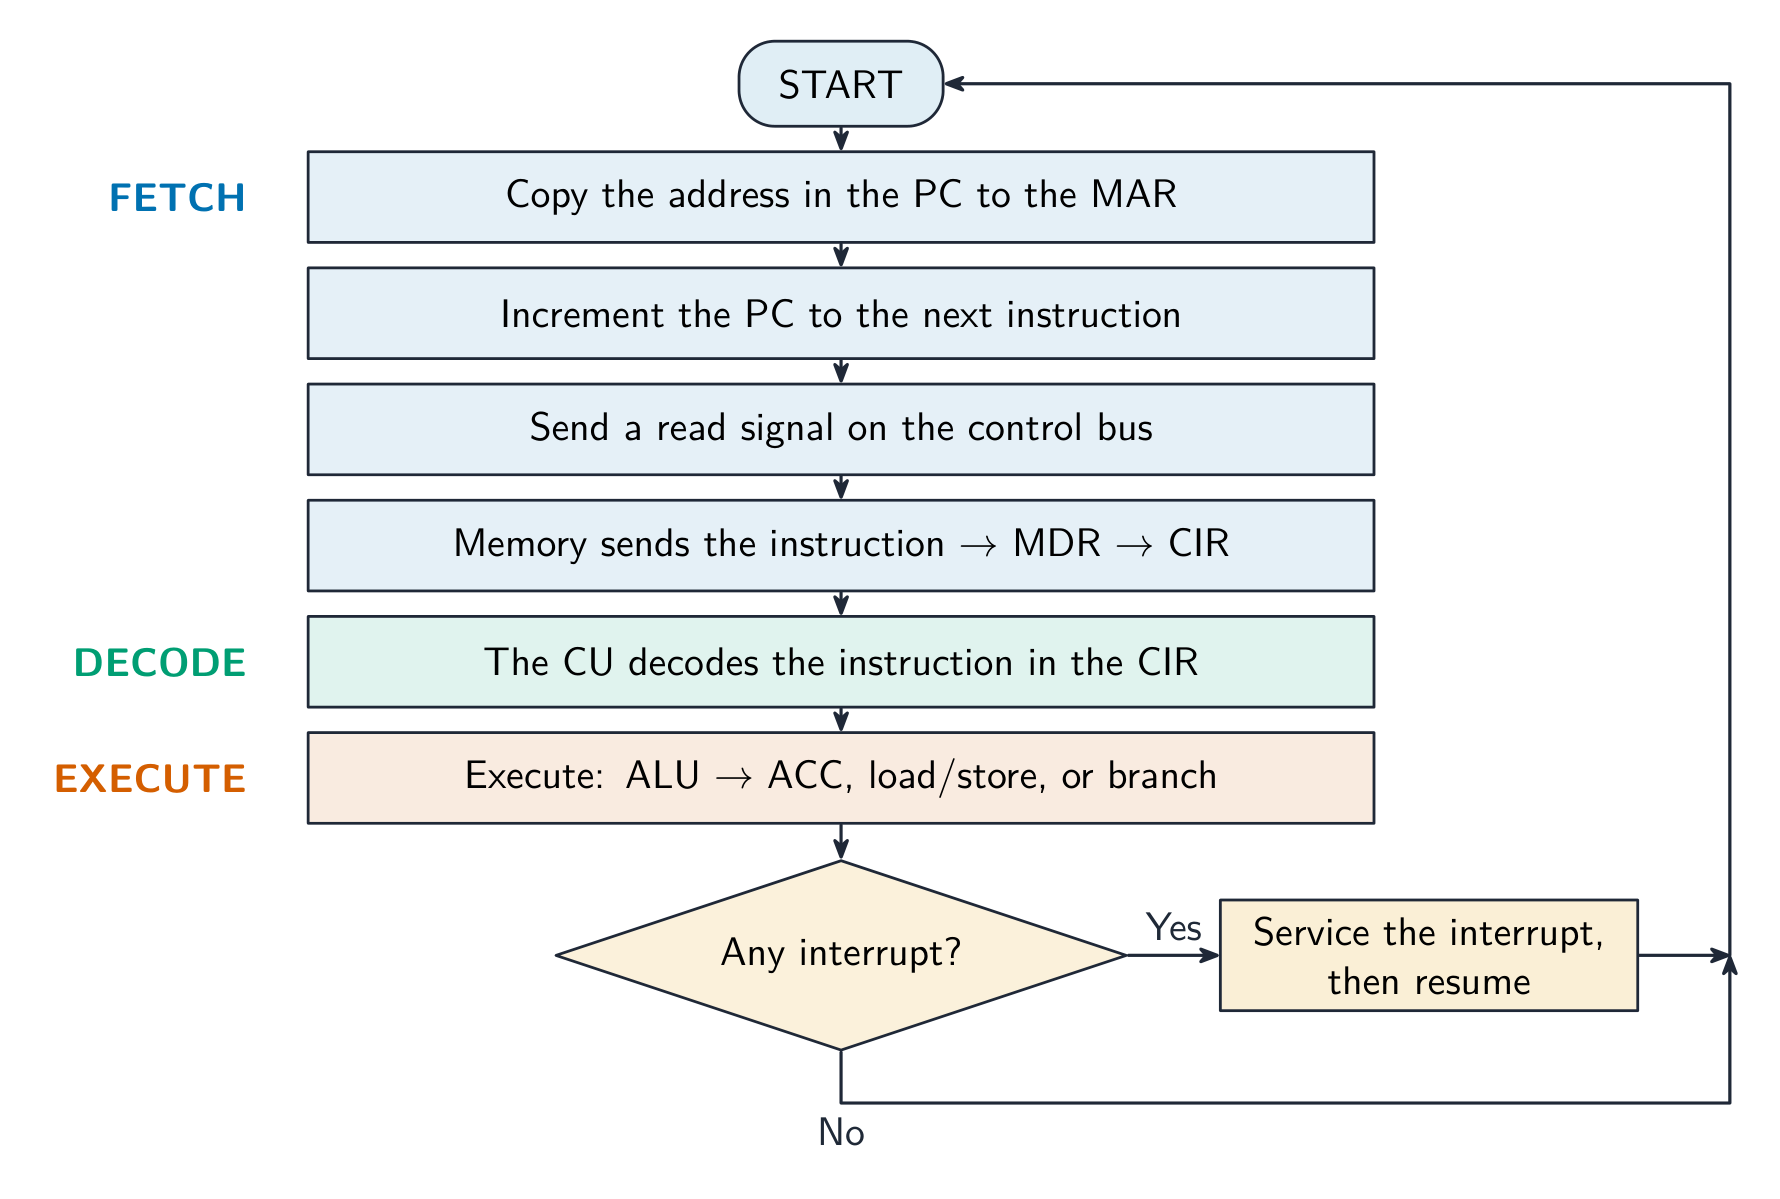
CPU는 기계 명령어마다 한 번씩 fetch-execute 사이클을 반복합니다.
Fetch
- PC의 주소가 MAR에 복사됩니다.
- PC가 증가되어 다음 명령어를 가리킵니다.
- read 신호가 제어 버스를 통해 전송됩니다.
- 메모리가 명령어를 데이터 버스에 올립니다.
- MDR에 복사된 후 CIR에 들어갑니다.
시험에서는 이 단계를 레지스터 전사 표기법으로 답해야 하며, [X]는 레지스터 X의 내용물을 의미하고 [[MAR]]은 MAR에 주소가 저장된 메모리 위치의 내용물을 의미합니다:
MAR ← [PC]          the address of the next instruction goes to the MAR
PC  ← [PC] + 1      the PC now points to the following instruction
MDR ← [[MAR]]       the instruction at that address is read into the MDR
CIR ← [MDR]         the instruction is copied into the CIR for decoding
순서는 중요합니다: 점프 명령이 나중에 실행되더라도 PC를 상쇄할 수 있도록, PC는 주소가 복사된 직후 바로 증가됩니다. 실행 중에도 같은 표기법이 각 명령어에 적용되며, 예를 들어 LDD 200에 대해 MAR ← 200, MDR ← [[MAR]], ACC ← [MDR] 등이 있습니다.
Decode
CU는 CIR에 있는 명령어를 복호화한다—어떤 연산이며, 어떤 피연산자나 주소인가.
실행
The CU carries it out: arithmetic/logic goes to the ALU (result to the ACC); a load/store moves data between memory and a register; a branch changes the PC. Then the cycle repeats.
탐색하기
Fetch-execute 사이클
CPU는 초당 수십억 번 루프를 반복합니다. PC/MAR/MDR/CIR 레지스터를 사용하여 포치하는 과정과, 포치된 데이터를 기반으로 디코드 및 실행이 어떻게 이루어지는지 관찰하십시오.
탐색하기
-fetch-execute 사이클
CPU가 명령어 하나를 실행하는 과정을 단계별로 보십시오: 메모리에서 fetch하여 디코딩한 뒤 실행을 반복합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| register/ˈredʒɪstə/ | 레지스터 |
| control unit/kənˈtrəʊl ˈjuːnɪt/ | 제어 유닛 |
| clock speed/klɒk spiːd/ | 클럭 속도 |
| fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ | 取指-执行周期 |
| special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ | 전용 레지스터 |
| Program Counter/ˈprəʊɡræm ˈkaʊntə/ | 프로그램 카운터 |
| Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ | 메모리 주소 레지스터 |
| Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ | 메모리 데이터 레지스터 |
| Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ | 현재 명령어 레지스터 |
4.1
인터럽트
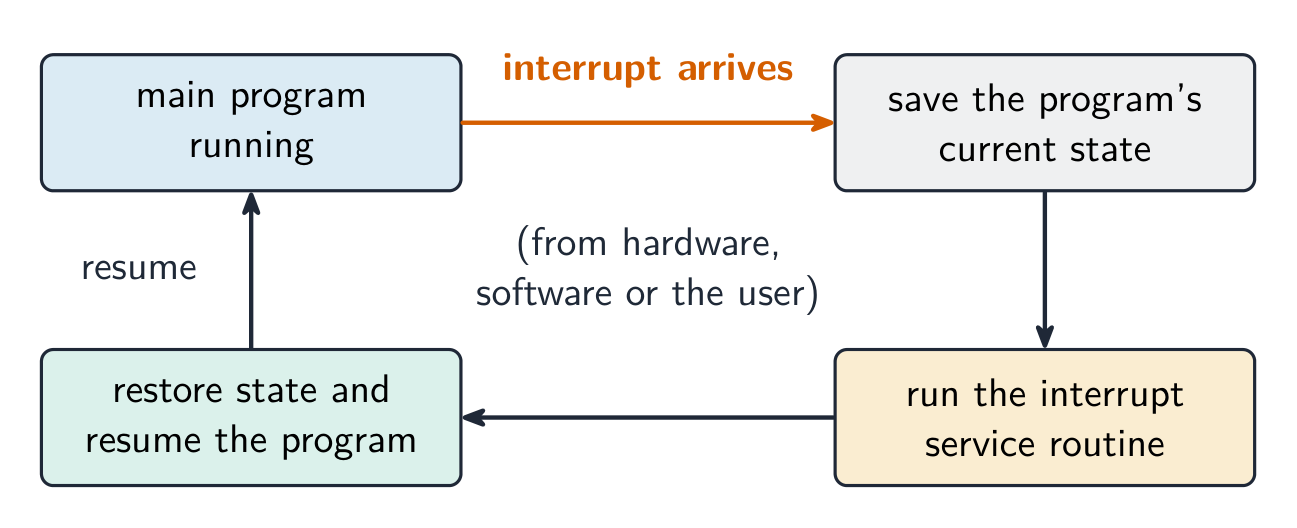
인터럽트란 정지시키는 신호로, CPU가 긴급한 이벤트를 처리할 수 있도록 정상적인 사이클을 일시적으로 멈춘다(키 입력, 패킷 도착, 하드웨어 결함, 0으로 나누기, OS 타이머 등).
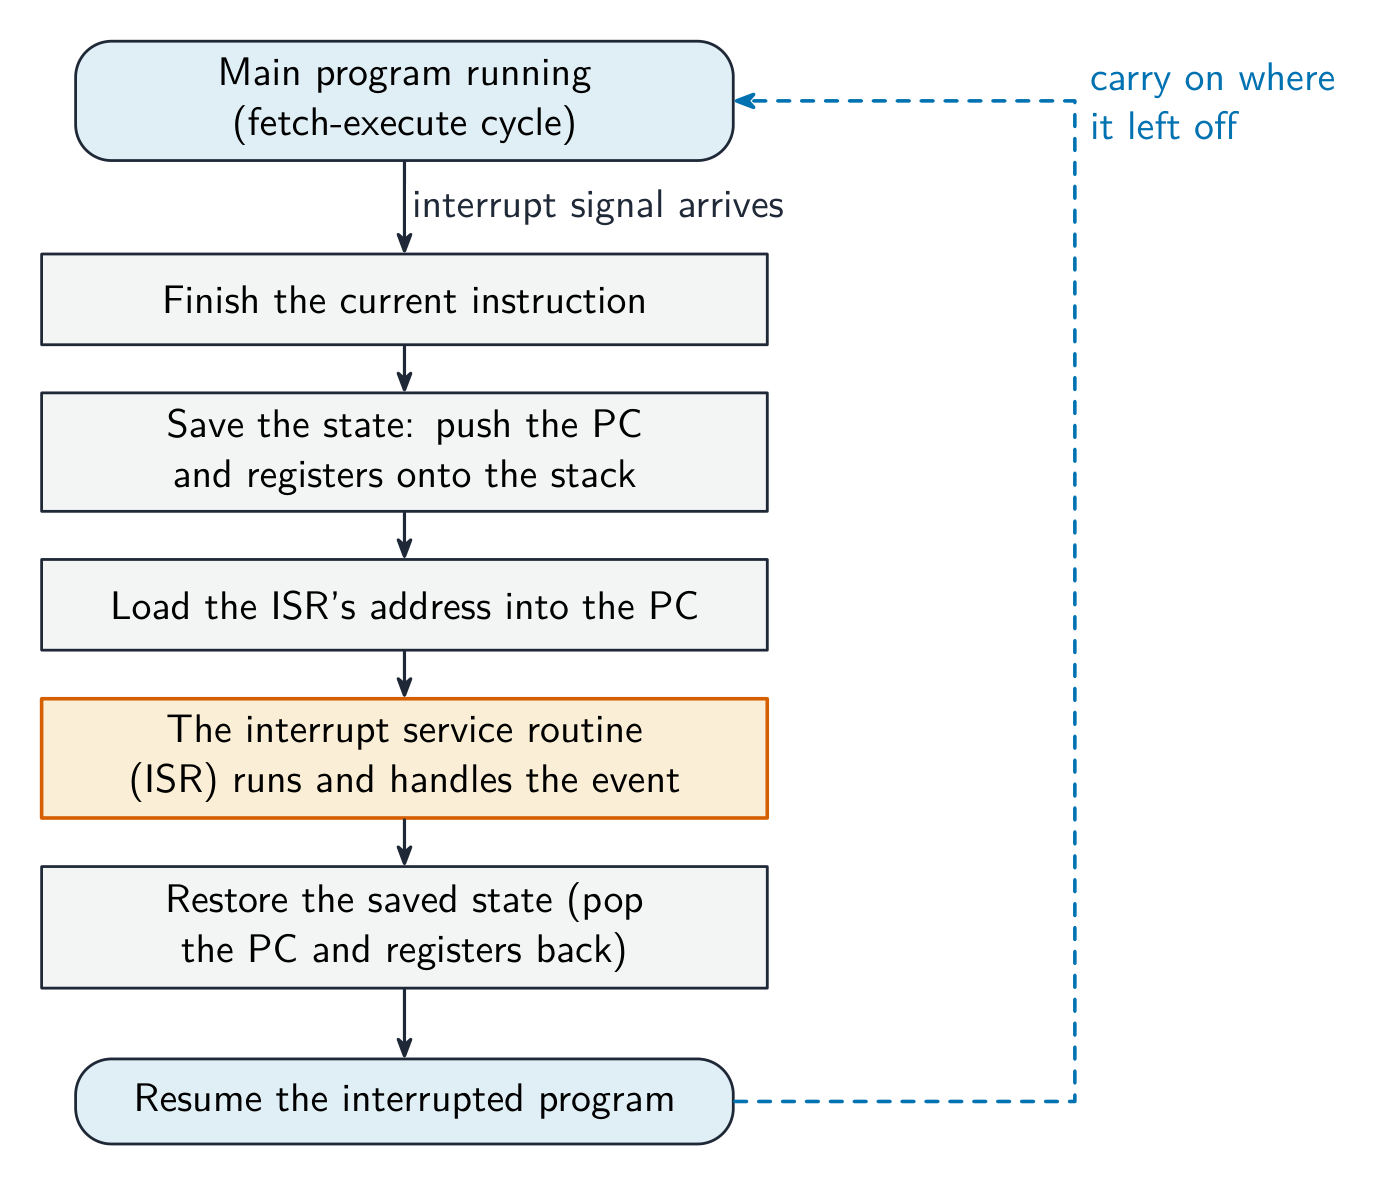
처리 방법:
- 현재 명령어를 완료한다.
- 상태 저장(PC 및 레지스터).
- **인터럽트 서비스 루틴(ISR)**의 주소를 PC에 로드하고 실행한다.
- ISR이 이벤트를 처리한다.
- 저장된 상태를 복원하고 계속 진행한다.
인터럽트는 CPU가 장치를 지속적으로 점검하지 않아도 시스템이 즉시 대응할 수 있게 하며, OS의 멀티태스킹 방식이다.
"입력 장치로부터의 인터럽트가 F-E 사이클에서 감지되고 처리되는 과정을 설명하라"는 4점 만점 답안은 다음 포인트를 포함해야 한다: 장치가 인터럽트 신호를 보내어 인터럽트 레지스터의 인터럽트 플래그를 설정합니다; 프로세서는 페치-실행 사이클의 매 회차 말, 현재 명령어의 실행이 끝난 후 해당 레지스터를 확인합니다; 플래그가 설정되어 있고 해당 인터럽트의 우선순위가 현재 작업보다 높으면, PC와 다른 레지스터의 내용을 스택에 저장합니다; 인터럽트 서비스 루틴의 주소를 PC에 로드하여 루틴을 실행합니다; 루틴이 완료되면 스택에서 저장된 값을 복원하고, 중단되었던 프로그램이 중단되던 지점에서 다시 실행됩니다.
명시할 만한 원인: 장치로부터의 하드웨어 인터럽트(키 누름, 프린터 버퍼 비우기, 네트워크 패킷 도착), 결함으로부터의 소프트웨어 인터럽트(0으로 나누기, 불법 명령어, 산술 오버플로우), OS로부터의 타이머 인터럽트(타임 슬라이스 종료 표시), 전원 차단 경고 등이 있다.
어휘
연습하기
| English | 한국어 |
|---|---|
| interrupt/ˈɪntərʌpt/ | 인터럽트 |
4.2
어셈블리 언어 및 기계어
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 어셈블리 언어와 .mail code 간의 관계에 대한 이해 | |
| 2-pass 어셈블러의 어셈블리 과정에 대한 각 단계를 설명하시오 | 주어진 간단한 어셈블리 언어 프로그램을 적용하여 2-pass 어셈블러 과정을 수행하시오 |
| 주어진 간단한 어셈블리 언어 프로그램의 흐름을 추적하시오 | |
| 일련의 명령어들이 그룹으로 묶여 있다는 점에 대한 이해 표시 | 다음 그룹 포함: • 데이터 이동 • 입력 및 출력 데이터 • 산술 연산 • 무조건 및 조건부 명령어 • 명령어 비교 |
| 다양한 주소 지정 방식을 이해하고 이를 활용할 수 있음을 보여주시오 | 즉시수, 직접, 간접, 인덱스, 상대 포함 |
출처: Cambridge International syllabus
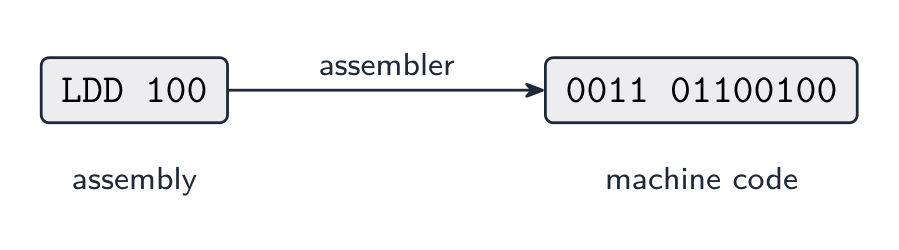
CPU는 실제로 기계어—특정 아키텍처에 특화된 비트 패턴—을 실행합니다. 어셈블리 언어는 가독성 있는 형태로, 각 기계 명령어마다 하나의 명령어를 가지며 LDD, ADD, JMP과 같은 미네모닉을 사용하여 작성됩니다. 어셈블러가 이를 기계어로 변환합니다.
투패스 어셈블러
투패스 어셈블러는 소스를 두 번 읽습니다:
- 패스 1: 심볼 테이블을 구축합니다: 라벨(
LOOP:등)이 나타날 때마다 그 주소를 기록합니다; 아직 코드는 생성되지 않습니다. - 패스 2: 코드 생성: 각 명령어를 번역하고, 라벨(
JMP LOOP등)을 참조하는 경우 심볼 테이블에서 주소를 검색합니다.
두 패스는 전방 참조(후에 정의된 라벨로 점프)를 처리합니다.
작업 예제. 첫 명령어가 주소 100에 저장된 이 프로그램에 투패스 과정을 적용합니다.
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
Pass 1 reads each line, counts the address it will occupy, and records every label in the symbol table: LOOP = 101 (the DEC line) and COUNT = 105 (the data line). No code is produced. Pass 2 reads the program again and translates each line into machine code, replacing each mnemonic by its opcode and each symbolic address by the number from the symbol table: LDD COUNT becomes the opcode for LDD with operand 105, and JPN LOOP becomes the opcode for JPN with operand 101. The jump back to LOOP could have been resolved in one pass, but a jump forward to a label not yet seen could not, which is why the assembler makes two.
예제 명령어 세트
Cambridge uses a small generic set, printed in the paper's reference table, with one general-purpose register, the accumulator (ACC), and an index register (IX). An operand written #n is a denary number, Bn a binary number and &n a hexadecimal number; <address> is a location number or a label.
| 그룹 | 명령어 | 기능 |
|---|---|---|
| 데이터 이동 | LDM #n |
즉각 방식(number n)으로 ACC에 로딩 |
LDD <address> |
직접 방식으로 주소의 내용을 ACC에 로딩 | |
LDI <address> |
주소에 다른 주소를 저장; 해당 주소의 내용을 ACC로 로드(간접) | |
LDX <address> |
IX를 주소에 더하고 결과의 내용을 ACC로 로드(색인) | |
LDR #n |
수 n을 IX에 로드 | |
MOV <register> |
ACC의 내용을 지정된 레지스터(IX)에 복사 | |
STO <address> |
ACC의 내용을 주소에 저장 | |
| 입력 및 출력 | IN |
키 누름을 읽고 그 ASCII 코드를 ACC에 넣음 |
OUT |
ACC에 있는 ASCII 코드에 해당하는 문자를 출력 | |
| 산술 | ADD <address> / ADD #n |
주소의 내용 또는 수를 ACC에 더함 |
SUB <address> / SUB #n |
ACC에서 빼기 | |
INC <register> / DEC <register> |
ACC 또는 IX에 1을 더하거나 1을 빼기 | |
| 비교 | CMP <address> / CMP #n |
ACC과 주소의 내용 또는 n을 비교하여 플래그 설정 |
CMI <address> |
주소에 저장된 주소(간접)의 내용을 가진 주소와 ACC를 비교 | |
| 점프 | JMP <address> |
주소로 무조건 점프 |
JPE <address> / JPN <address> |
마지막 비교가 같았을 때 / 다를 때 점프 | |
| 비트 조작 | AND, OR, XOR with #n, Bn, &n or <address> |
ACC에 대한 비트 연산 |
LSL #n / LSR #n |
ACC 논리적으로 n자리 왼쪽 또는 오른쪽 이동 | |
END |
프로그램 종료 |
"어셈블리 언어 명령어가 그룹화됨" 질문은 각 그룹의 이름과 데이터 이동, 입력 및 출력, 산술, 무조건 및 조건부 점프, 비교, 비트 조작에서 각 하나씩의 명령어를 요구합니다.
탐색하기
투 패스 어셈블러의 작동 원리
단계별로 확인하십시오. 어셈블러는 코드를 두 번 읽습니다: 1차 pass는 각 라벨의 위치만 찾아내므로 2차 pass에서 주소를 채울 수 있으며, 이것이 나중에 정의된 라벨로 점프하는Still 작동하는 방법입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| operand/ˈɒpərænd/ | 연산자 |
| Index Register/ˈɪndeks ˈredʒɪstə/ | 인덱스 레지스터 |
| indexed addressing/ˈɪndekst əˈdresɪŋ/ | 인덱드 주소 지정 |
| general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ | 일반 레지스터 |
| machine code/məˈʃiːn kəʊd/ | 머신 코드 |
| mnemonics/nɪˈmɒnɪks/ | 요약기호 |
| assembler/əˈsemblə/ | 어셈블러 |
| symbol table/ˈsɪmbl ˈteɪbl/ | 기호표 |
| label/ˈleɪbl/ | 라벨 |
| forward references/ˈfɔːwəd ˈrefrənsɪz/ | 전방 참조 |
| opcode/ˈɒpkəʊd/ | opcodes |
4.2
주소 지정 방식
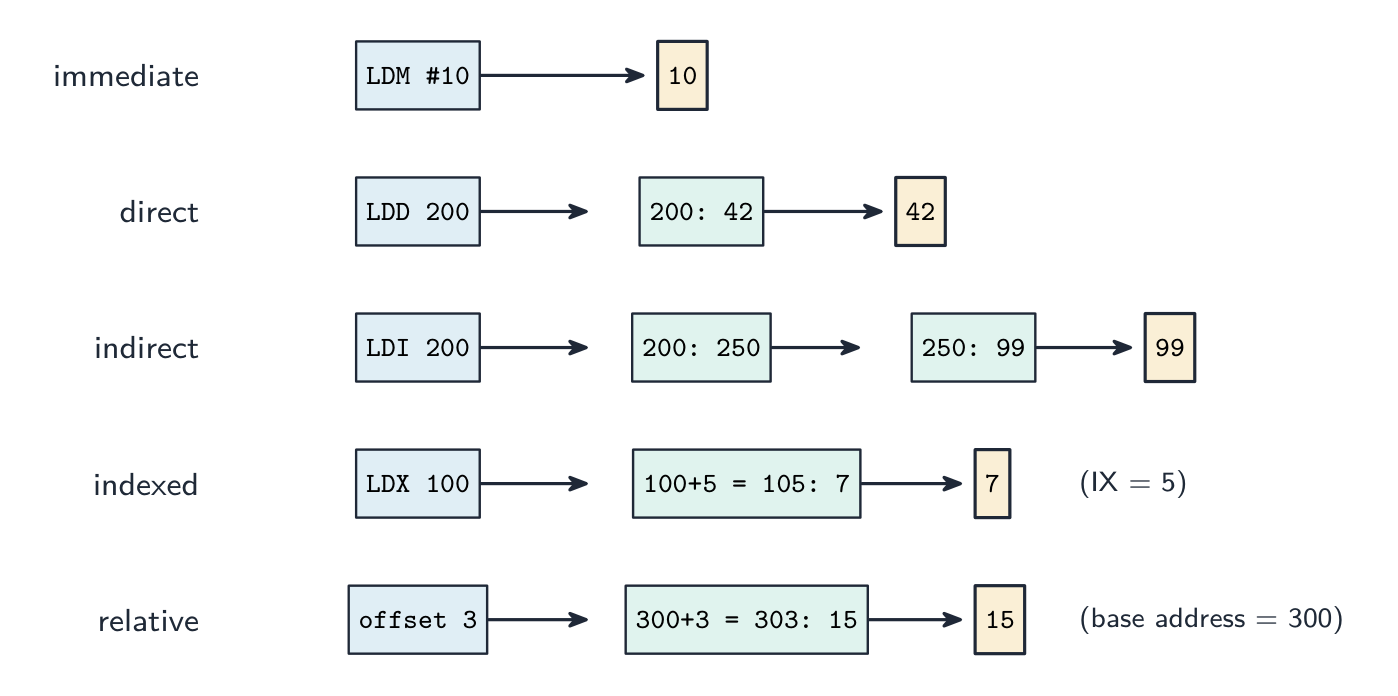
주소 지정 방식(주소 지정 모드)이 CPU가 피연산자를 찾는 방법을 설명합니다:
- 즉시 주소 지정 — 피연산자는 명령어에 있는 값입니다.
LDM #10이 10을 로드합니다. - 직접 주소 지정 — 명령어에 주소를 포함하며, 피연산자는 그 주소에 있는 값입니다.
LDD 200. - 간접 주소 지정 — 명령어에는 또 다른 주소를 포함하는 주소가 있으며, 이것이 데이터입니다.
LDI 200. - 인덱스 주소 지정 — 유효 주소는
address + index register이며 배열에 사용한다. IX = 5일 때LDX 100은 주소 105을 읽는다.
(상대 주소 지정은 PC로부터 오프셋으로 주소를 제공합니다 — 점프에 사용됨.)
Worked example. Memory holds: location 200 = 250, location 250 = 99, location 105 = 7. The index register holds 5. What is in the accumulator after each of LDM #200, LDD 200, LDI 200 and LDX 100? Follow how far each mode has to look. LDM #200 is immediate - the operand is the number written in the instruction, so the accumulator holds 200. LDD 200 is direct - go to location 200 and take what is there: 250. LDI 200 is indirect - location 200 holds 250, which is another address, so go on to location 250: 99. LDX 100 is indexed - add the index register to the address, $100 + 5 = 105$, and read location 105: 7. Count the hops to keep them apart: immediate 0, direct 1, indirect 2, indexed 1 (once the index has been added).
어휘
연습하기
| English | 한국어 |
|---|---|
| addressing mode/əˈdresɪŋ məʊd/ | 주소 지정 방식 |
| immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ | 즉각 주소 지정 |
| direct addressing/daɪˈrekt əˈdresɪŋ/ | 직접 주소 지정 |
| indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ | 간접 주소 지정 |
| relative addressing/ˈrelətɪv əˈdresɪŋ/ | 상대 주소 지정 |
4.2
어셈블리 프로그램 추적
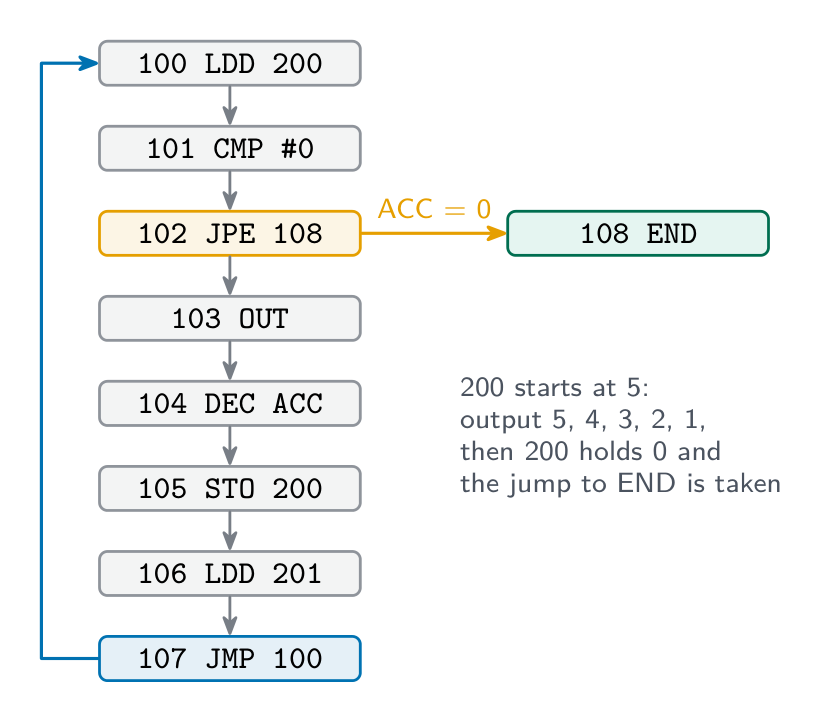
이를 추적하려면 PC, ACC, 인덱스 레지스터, 각 변수 및 모든 플래그에 대한 열이 있는 표를 만듭니다. 명령어를 단계별로 진행하며 매번 표를 업데이트하고, PC를 변경할 때 분기를 따릅니다. END에서 멈춥니다. 일반적인 패턴은 인덱스 주소 지정을 사용하여 배열을 순환하는 것입니다.
해설 예제. 이 프로그램을 추적하십시오. 주소 200에는 5가, 주소 201에는 0이 들어 있습니다.
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
실행되는 각 명령어마다 한 줄을 작성하고, 변경된 열만 채우십시오:
| 명령어 | ACC | 200 | 201 | 출력 |
|---|---|---|---|---|
| 시작 | 5 | 0 | ||
LDD 200 |
5 | |||
CMP #0 |
||||
JPE 108 |
취하지 않음 | |||
OUT |
코드 5의 문자 | |||
DEC ACC |
4 | |||
STO 200 |
4 | |||
LDD 201 |
0 | |||
JMP 100 |
||||
LDD 200 |
4 |
and so on, until LDD 200 loads 0, the compare sets the equal flag, JPE 108 is taken and the program ends. Three things the examiner checks: a CMP changes no register, only a flag; a jump not taken still counts as executed; and OUT outputs a character, so it goes in the output column, not the ACC column. "State the effect of changing LDD 10 to LDM #10": the ACC would hold the number 10 instead of the contents of address 10.
4.3
이진 시프트
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 비트 시프트를 이해하고 수행할 수 있음을 보여주시오 | 논리적, 산술적 및 순환 좌우 시프트, 우회 시프트 |
| 비트 조작이 기기의 모니터링/제어에 어떻게 사용되는지 이해하고 있음을 보여주시오 | 비트 조작 연산을 수행하시오. 비트 테스트 및 설정 (비트 매스킹 사용) |
| 명령어 레이블 | 오퍼코드 | 피연산자 | 설명 |
| AND #n / Bn / &n | ACC의 내용과 피연산자의 비트-wise AND 연산 |
| AND | ACC의 내용과 의 내용의 비트-wise AND 연산 |
| XOR #n / Bn / &n | ACC의 내용과 피연산자의 비트-wise XOR 연산 |
| XOR | ACC의 내용과 의 내용의 비트-wise XOR 연산 |
| OR #n / Bn / &n | ACC의 내용과 피연산자의 비트-wise OR 연산 |
| OR | ACC의 내용과 의 내용의 비트-wise OR 연산 |
| LSL #n | ACC의 비트를 논리적으로 n자리 왼쪽으로 이동. 오른쪽 끝에 영수가 삽입됨 |
| LSR #n | ACC의 비트를 논리적으로 n자리 오른쪽으로 이동. 왼쪽 끝에 영수가 삽입됨 |
| 명령어를 레이블링함 | |
| 내용물이 인 메모리 위치에게 기호 주소 | |
| All questions will assume there is only one general purpose register available (Accumulator) ACC denotes Accumulator IX denotes Index Register can be an absolute or symbolic address # denotes a denary number, e.g. #123 B denotes a binary number, e.g. B01001010 & denotes a hexadecimal number, e.g. &4A |
출처: Cambridge International syllabus
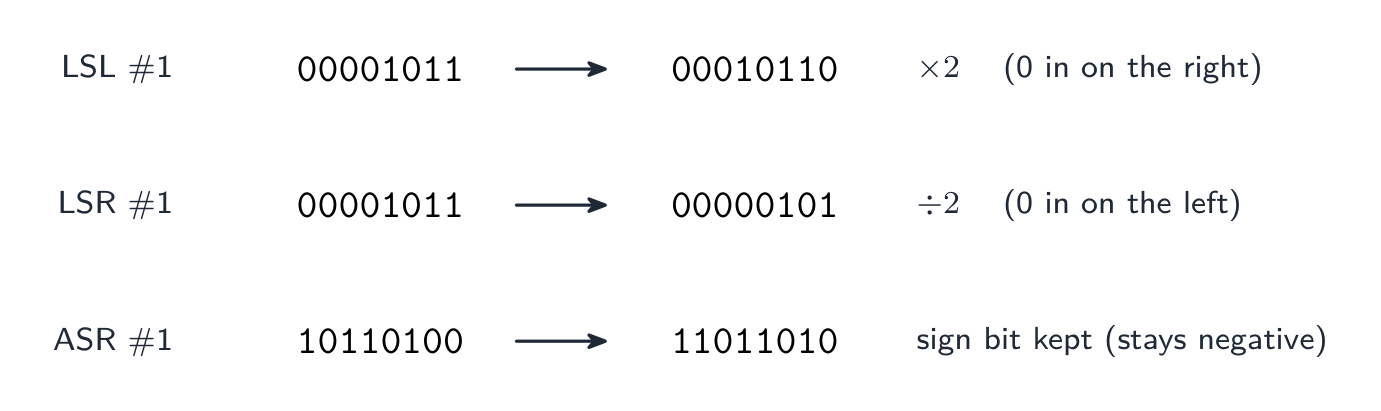
논리 시프트는 모든 비트를 몇 자리씩 왼쪽 또는 오른쪽으로 이동시키고, 새 위치에는 0을 채웁니다.
- 1자리 왼쪽 시프트 (
LSL #1) — 비트가 왼쪽으로 이동하고, 오른쪽에 0이 들어옴; 부호 없는 숫자에서는 × 2가 됩니다. - 1자리 오른쪽 시프트 (
LSR #1) — 비트가 오른쪽으로 이동하고, 왼쪽에 0이 들어옴; 부호 없는 숫자에서는 정수 ÷ 2가 됩니다.
$n$자리만큼 시프트하면 $2^{n}$배로 곱하거나 나눕니다. 예: 00001011 (11) LSL #1 → 00010110 (22).
Bits shifted off the end are lost, so the multiplication is only correct while they were zeros. LSL #2 on the two's-complement integer 11001010 gives 00101000: the two 1s that fell off the left are gone, the sign bit has changed, and the result is no longer four times the original.
산술 오른쪽 시프트는 부호 비트를 유지하여 부호 있는 음수가 음수로 남게 합니다. 순환 시프트(회전)는 한쪽 끝에서 떨어지는 비트를 다른 쪽 끝에 다시 연결하여, 비트가 사라지지 않도록 합니다.
"10011110에 대해 3자리 산술 오른쪽 시프트의 결과를 보여라": 빈 자리를 차기 위해 부호 비트를 복사하고, 11110011. 동일한 시프트를 01011100에 적용하면 00001011이 됩니다. 10000110에 대해 1자리 순환 왼쪽 시프트를 적용하면 00001101이 됩니다: 최상위 1이 오른쪽에 다시 나타납니다.
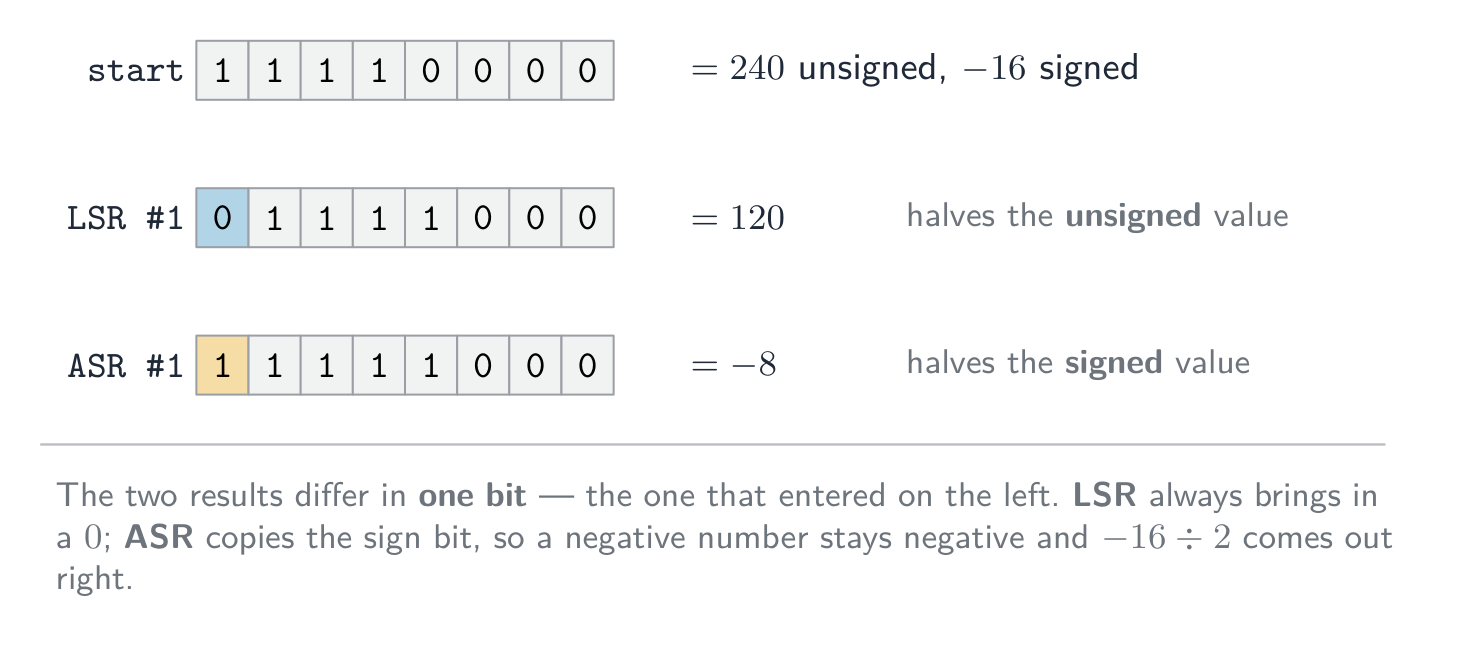
The difference between the two right shifts is a single bit. Take 11110000, which is 240 read as unsigned and $-16$ read as signed. LSR #1 brings in a 0 and gives 01111000 $= 120$, which is the correct half of 240. ASR #1 copies the sign bit instead and gives 11111000 $= -8$, which is the correct half of $-16$. Neither is wrong — each halves the value under one reading.
모니터링/제어를 위한 비트 조작
임베디드 디바이스는Often 한 신호마다 레지스터의 비트 하나를 사용합니다(예: 비트 $n$ = LED $n$). 마스크—비트 매스킹—을 사용하여 다음과 같은 작업을 할 수 있습니다:
- 비트 $n$ 설정:
R = R OR비트 $n$가 설정된 마스크를 사용합니다. - clear bit $n$:
R = R ANDa mask with bit $n$ clear and the rest set. - 비트 $n$ 토글링:
R = R XOR비트 $n$가 설정된 마스크를 사용합니다. - 비트 $n$ 테스트:
R AND마스크를 적용한 후 결과가 0이 아닌지 확인합니다.
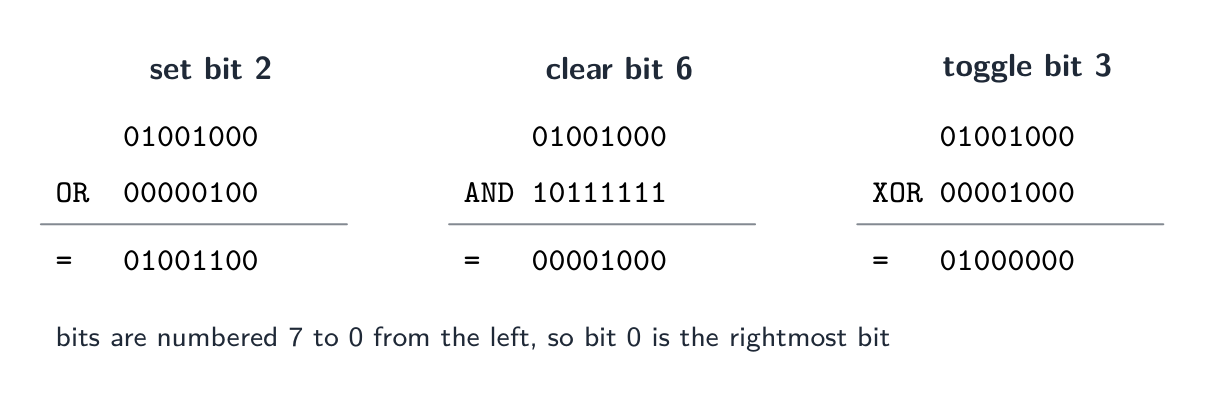
비트 조작은 빠르고 memory 사용량이 적으며, 한 바이트당 최대 8개의 on/off 상태를 저장할 수 있게 해준다.
In the exam's instruction set these are AND, OR and XOR with a mask written as a denary, binary or hexadecimal operand. With the ACC holding 10101100:
| 지시어 | 마스크 | ACC 결과 | 효과 |
|---|---|---|---|
AND B00001111 |
00001111 |
00001100 |
하위 4비트만 유지(나머지는 소거됨) |
OR #1 |
00000001 |
10101101 |
최소 유의 비트(LSB)를 설정하고 나머지는 변경하지 않음 |
XOR &FF |
11111111 |
01010011 |
모든 비트를 반전함 |
AND B00001000 이후 CMP #0 |
00001000 |
00001000 |
bit 3 테스트: 비교가 불일치하므로 bit 3는 set되어 있음 |
LSL #2 |
10110000 |
왼쪽으로 두 자리 이동, 최상위 두 비트 손실 | |
LSR #3 |
00010101 |
shifts right three places, zeros entering on the left |
"최하위 비트를 1로 설정하고 나머지는 그대로 두는 지령을 쓰시오": OR #1, 또는 OR B00000001. 비트를 clear하려면 AND을 사용하여 해당 위치에 0이 있고 나머지에는 1들이 있는 마스크를 사용하라; 비트를 테스트하려면, 해당 위치에 1만 있는 마스크로 AND을 수행한 후 결과를 0과 비교하라. 모니터링 장치에서, 센서당 레지스터의 한 비트는 단일 AND가 특정 센서가 켜져 있는지 확인하게 하고, 단일 OR가 액추에이터의 제어 비트를 켜면서 나머지는 방해하지 않게 한다.
탐색하기
바이트의 비트를 이동하고 마스크로 선택한다
연산자를 선택하고 각 결과 비트를 확인하라. 왼쪽 이동(<<) moves every bit up one place (×2); a right shift (>>)은 값을 아래로 내린다(÷2); mask와 AND 연산으로 원치 않는 비트를 지운다.
어휘
연습하기
| English | 한국어 |
|---|---|
| mask/mæsk/ | 마스크 |
4.3
출제자가 인정하는 정의
정의 문제는 고정된 문구로 채점합니다. 이 내용들을 정확히 외우고, 답은 하나만 제시하십시오.
| 용어 | 정의 |
|---|---|
| 저장 프로그램 개념 | 프로그램 지시어와 데이터 모두 메인 메모리에 저장되며, 지시어는 하나씩 가져와서 실행됨 |
| 레지스터 | 프로세서 내부의 작고 매우 빠른 저장 위치로, 특정한 목적을 가짐 |
| 프로그램 카운터(PC) | 다음 지시어의 주소를 저장하는 레지스터 |
| 메모리 주소 레지스터(MAR) | 읽거나 쓰는 메모리 위치의 주소를 저장하는 레지스터 |
| 메모리 데이터 레지스터(MDR) | 방금 메모리에서 읽었거나 곧 메모리에 쓸 데이터를 저장하는 레지스터 |
| 현재 지시어 레지스터(CIR) | 현재 디코딩되고 실행 중인 지시어를 저장하는 레지스터 |
| 어큐뮬레이터(ACC) | 마지막 산술 또는 논리 연산의 결과를 저장하는 범용 레지스터 |
| 캐시 메모리 | 프로세서 근처에 있는 작고 빠른 메모리로, 자주 사용되는 지시어와 데이터를 저장 |
| 인터럽트 | 장치나 프로그램으로부터 발생하는 신호로, 프로세서를 정지시키고 현재 작업을 중단한 뒤 인터럽트 서비스 루틴을 실행하게 합니다 |
| 어셈블리 언어 | 각(elem) 지시어에 대입되는 기계어 지시어가 하나씩 대응되는 저수준 언어 |
| 즉시 주소 방식 | 피연산자가 명령어에 직접 적힌 값입니다 |
| 직접 주소 방식 | 피연산자가 명령어에 적힌 주소의 내용입니다 |
| 간접 주소 방식 | 명령어에 있는 주소가 피연산자의 주소를 가리킵니다 |
| 인덱스 주소 방식 | 피연산자의 주소는 명령어의 주소와 인덱스 레지스터의 내용을 더한 값입니다 |
| 상대 주소 방식 | 피연산자의 주소는 현재 명령어의 주소로부터의 오프셋으로 주어집니다 |
| logical shift | every bit moves the given number of places and zeros fill the vacated places |
어휘
연습하기
| English | 한국어 |
|---|---|
| logical shift/ˈlɒdʒɪkl ʃɪft/ | 논리 시프트 |
| cyclic shift/ˈsaɪklɪk ʃɪft/ | 순환 시프트 |
4.3
시험 팁
- PC, MAR, MDR, CIR, ACC를 사용하여 .fetch-execute 사이클을 register-transfer 용어로 학습하고 PC를 증가시키는 요인을 이해합니다.
- 각 레지스터의 역할을 설명하십시오; 주소 버스는 일방향이고 데이터 버스는 양방향입니다.
- 주소 방식을 구분하십시오(즉시, 직접, 간접, 인덱스) — 빈번히 출제되는 주제입니다.
- 클럭 속도, 코어 수, 캐시 크기 및 word 길이가 성능에 미치는 영향을 설명할 수 있어야 합니다.
- 이_Handle수 시프트일 때 논리적인지 산술적인지 명시해야 합니다. 왼쪽 시프트는 2배, 오른쪽 시프트는 2로 나누는 연산에 해당합니다.
흔한 실수
- PC가 현재 지시어를 stored한다고 말하거나, MDR이 주소를 stored한다고 말하는 것은 틀립니다. PC는 다음 지시어의 주소를 store하며, MDR은 데이터나 지시어를 store할 뿐 절대 주소를 store하지 않습니다.
- PC의 증분을 fetch 단계에서 빼버리거나 execute 단계 뒤에 배치하는 것은 틀립니다. 주소가 MAR로 복사되는 즉시 이루어집니다.
LDD 10를 "load 10"으로 읽는 것은 틀립니다.LDD 10는 주소 10의 content를 load하고,LDM #10는 숫자 10 자체를 load합니다.CMP또는OUT에 대한 ACC 열에 값을 넣는 것은 틀립니다. compare는 flag만 설정할 뿐이며, output은 출력 열로 goes합니다.- 인터럽트가 "즉시" 처리된다고 말하는 것은 틀립니다. 프로세서는 현재 지시어를 완료한 뒤 사이클 끝에서 인터럽트를 check합니다.
- 음의 2의 보수를 number에 논리적 오른쪽 시프트를 사용하는 것은 틀립니다. 부호 bit를 유지하는 것은 오직 산술적 시프트뿐입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| register transfer/ˈredʒɪstə ˈtrænsfɜː/ | 레지스터 전송 |
| control bus/kənˈtrəʊl bʌs/ | 제어 버스 |
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.