| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 데이터 저장 및 검색을 위한 파일 기반 방식의 한계에 대한 이해 | |
| 파일 기반 방식의 한계를 해결하는 관계형 데이터베이스의 특징 설명 | |
| 관계형 데이터베이스 모델과 관련된 용어에 대한 이해 및 활용 | 엔티티, 테이블, 레코드, 필드, 튜플, 속성, 주키, 후보키, 보조키, 외부키, 관계(일대다, 일대일, 다대다), 참조 무결성, 색인화 포함 |
| 엔티티-관계(E-R) 도표를 사용하여 데이터베이스 설계를 문서화 | |
| 정규화(normalisation) 과정에 대한 이해 | 첫 번째 정규 형식 (1NF), 두 번째 정규 형식 (2NF), 세 번째 정규 형식 (3NF) |
| 주어진 데이터베이스 테이블 세트가 3NF인지 아닌지에 대한 이유 설명 | |
| 데이터베이스 설명, 주어진 데이터 세트 또는 주어진 테이블 세트를 기반으로 정규화된 데이터베이스 설계 작성 |
데이터베이스
A-Level 컴퓨터 과학 · 주제 8
 17:16
데이터베이스 및 관계 모델
데이터베이스 이전에는 각 프로그램이 자체 플랫 파일을 보관했습니다—프로그램마다 하나의 파일. 상점을 상상해 보십시오. 판매 프로그램, 청구서 생성 프로그램, 배송 프로그램…
영어 내레이션 · 영어 + 중국어 자막 burned-in
8.1
파일 기반 저장소 및 그 한계

Syllabus
출처: Cambridge International syllabus
데이터베이스 이전에는 프로그램이 플랫 파일에 데이터를 저장했습니다—보통 프로그램마다 하나의 파일을 사용했습니다. 소규모 데이터에는 적절하지만 규모가 커지면 문제가 발생합니다.
한계
- 데이터 중복 — 동일한 데이터(예: 고객의 주소)가 여러 파일에 각각 저장되므로(프로그램별 하나씩), 저장 공간이 낭비되고 모든 사본을 업데이트해야 함.
- 데이터 일관성 부족 — 한 사본은 업데이트되었으나 다른 사본은 그렇지 않아 파일 간에 불일치가 발생하고 어느 쪽이 옳은지 알 수 없습니다.
- 데이터 의존성 — 각 프로그램은 해당 파일의 정확한 레이아웃을 위해 작성되므로, 필드의 길이를 변경하거나 필드를 추가할 때마다 파일을 읽는 모든 프로그램을 다시 작성해야 함.
- 공유 접근 불가 — 파일은 하나의 프로그램이 사용하는 동안 잠기므로, 사용자들이 동시에 데이터를 작업할 수 없음.
- 약한 무결성 — 유효하지 않은 값이나 존재하지 않는 고객과의 링크를 막는 중앙 규칙이 없음; 약한 보안 — 접근 권한이 파일 단위가 아니라 필드 단위가 아님; 그리고 **질문(query)**을 파일 간에 걸쳐 요청할 때마다 새로운 프로그램이 필요함.

**관계형 데이터베이스(relational database)**는 데이터를 테이블에 저장하고, 모든 프로그램이 사용하는 단일 소프트웨어(DBMS)가 이를 관리함으로써 이러한 문제를 해결함.

관계형 데이터베이스가 더 나은 이유 — 3점 만점 답안. 각 데이터 항목은 한 번만 저장되며, 하나의 테이블 내에 위치하고 테이블들은 키로 연결되므로 중복과 불일치가 없으며; 데이터는 프로그램으로부터 독립적이며, 프로그램은 필요한 것을 DBMS에 요청하므로 구조 변경 시 영향을 받지 않으며; 그리고 DBMS는 무결성 규칙을 강제하고, 사용자 및 필드 단위로 접근을 통제하며, 다수 사용자 동시 접속을 허용하고, 새로운 프로그램 작성 없이 어떤 질문에도 응답 가능함.
작업 예제. 수리점이 고객, 기기 및 수리 작업을 파일 기반 방식으로(프로그램별 하나씩) 저장하고 있다. 이로 인해 발생하는 세 가지 문제와 관계형 데이터베이스가 이를 어떻게 해결하는지 설명하시오.
고객의 이름과 전화번호는 수리 파일 및 청구서 파일에 중복하여 저장됩니다(중복); 고객이 번호를 변경할 때 한 파일은 수정되나 다른 파일은 수정되지 않습니다(일관성 부족); 그리고 수리점이 신형 보고서를 필요로 할 때(기술자별 수리 건수 등) 해당 파일을 읽기 위한 새로운 프로그램을 작성해야 합니다(임시 질의 불가). 관계형 데이터베이스에서는 고객을 CUSTOMER 테이블에 한 번만 저장하고 REPAIR 테이블에서 CustomerID로 참조하므로, 변경 사항도 한 번만 적용되어 모든 곳에서 반영되며, 보고서 생성은 단일 SQL 질의로 가능합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ | 관계형 데이터베이스 |
| DBMS/ˌdiː biː em ˈes/ | Glossary {"sense": "데이터베이스 관리 시스템", "subject": "A-Level 컴퓨터 과학", "term": "DBMS"} |
| query/ˈkwɪərɪ/ | 쿼리 |
| SQL/ˌes kjuː ˈel/ | SQL |
8.1
관계형 모델 — 용어
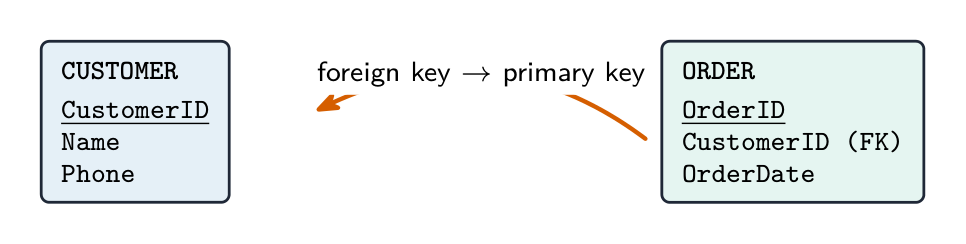
- 테이블(관계) — 행과 열로 구성된 격자; 각 엔티티 유형마다 하나의 테이블(예:
CUSTOMER)을 사용합니다. - record (row, also called a tuple) — one row; one instance of the entity.
- 필드(열, 또한 속성이라고도 함) — 하나의 열; 각 레코드에 대한 정보 한 가지입니다.
- 주요 키 — 각 레코드를 고유하게 식별하는 필드(또는 필드들); NULL이나 중복이 허용되지 않습니다.
- 외부 키 — 값이 다른 테이블의 주요 키와 일치하여 두 테이블을 연결하는 필드입니다.
- 합성 키 — 두 개 이상의 필드가 결합되어 형성된 주요 키입니다.
- 후보 키 — 주요 키가 될 수 있는 임의의 필드(또는 필드들)입니다.
- 보조 키 — 빠른 검색을 위해 인덱싱된 비주요 필드입니다.
- 인덱싱 — 필드에 인덱스를 구축하여 조회 및 조인트 연산을 빠르게 수행하도록 하는 과정입니다.
- 참조 무결성 — 모든 외부 키 값은 기존 주요 키와 일치해야 하며(오르파인 레코드 없음), 이를 보장하는 규칙입니다.
테이블은 주키 아래에 밑줄을 그으며 외부 키를 표기하는 줄임표 기법으로 작성됨:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
해설 예시. relational database에서 entity, primary key 및 referential integrity의 의미를 설명하고, tuple과 attribute에 대한 용어 ↔ 설명 표를 완성하십시오.
An entity is something about which data is stored — a person, object or event — which becomes one table. A primary key is the attribute (or combination of attributes) that uniquely identifies each record in a table. Referential integrity means that every foreign-key value must match the value of a primary key in the table it refers to, so a record cannot refer to one that does not exist. A tuple is one row of a table (one record); an attribute is one column (one field). Learn the pairs: table/relation, record/tuple, field/attribute.
탐색하기
SELECT를 사용하여 관계형 테이블 읽기
관계형 테이블은 행(레코드)과 열(필드)로만 구성됩니다. WHERE는 조건에 맞는 행을 유지하고, SELECT는 요청한 열만 남깁니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| flat files/flæt faɪlz/ | 플랫 파일 |
| data redundancy/ˈdeɪtə rɪˈdʌndənsi/ | 데이터 중복 |
| data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ | 데이터 일관성 부족 |
| field/fiːld/ | 필드 |
| integrity/ɪnˈteɡrɪti/ | 무결성 |
| table/ˈteɪbl/ | 표 |
| entity/ˈentɪti/ | 엔티티 |
| record/ˈrekɔːd/ | 레코드 |
| tuple/ˈtuːpl/ | 튜플 |
| attribute/ˈætrɪbjuːt/ | 속성 |
| primary key/ˈpraɪməri kiː/ | 주키 |
| foreign key/ˈfɒrən kiː/ | 외부 키 |
| composite key/ˈkɒmpəzɪt kiː/ | 복합 키 |
| candidate key/ˈkændɪdeɪt kiː/ | 후보 키 |
| secondary key/ˈsekəndəri kiː/ | 서브 키 |
| indexing/ˈɪndeksɪŋ/ | 인덱싱 |
| referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ | 참조 무결성 |
| entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ | Glossary {"sense": "실체 관계도", "subject": "A-Level 컴퓨터 과학", "term": "entity-relationship diagram"} |
8.1
엔티티-관계(E-R) 다이어그램

엔티티-관계 다이어그램은 구조를 보여줍니다: 각 엔티티는 직사각형, 각 관계는 선으로 표현되며, 각 끝에 **카디널리티(cardinality)**가 표시됩니다:
- 일대일(one-to-one)(1:1).
- 일대다 (1:M) — 각 고객은 여러 주문을 가지며, 각 주문은 하나의 고객을 가집니다.
- 다대다 (M:N) — 학생들은 여러 과목을 수강하고, 과목에는 여러 학생들이 있습니다.

다대다 관계는 직접 저장할 수 없습니다. 두 외래 키를 포함하는 **연결 표(link table)**을 통해 두 일대다 관계로 분리합니다:
ENROLMENT(StudentID, CourseID, EnrolmentDate)

주어진 테이블 세트를 위한 E-R 다이어그램 그리기. 각 테이블은 하나의 엔티티가 됩니다. 한 테이블이 다른 테이블에 대해 외계 키를 포함할 whenever 관계가 존재하며, 이는 외계 키를 가진 테이블(다수 말단)에서 primary key를 가진 테이블(단수 말단)로 향합니다. 두 개의 외계 키를 가지고 다른 정체성이 없는 테이블은 일반적으로 다대다 관계를 해결하기 위해 연결 테이블(link table) 역할을 합니다. 각 선에는 관계 유형을 표기하십시오.
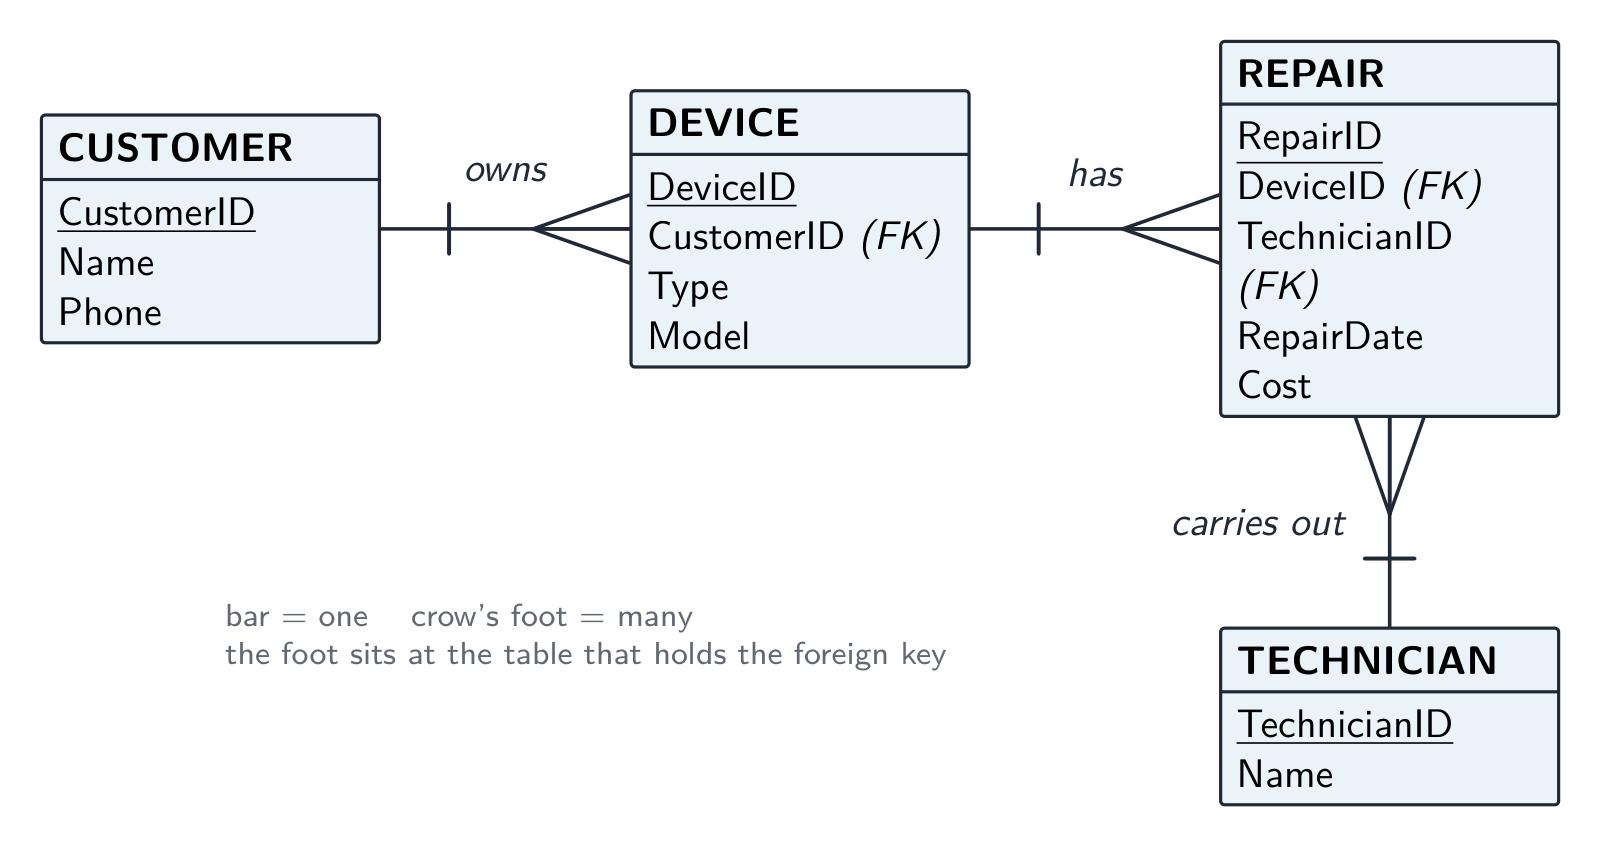
작업 예제. 수리점에는 CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) 및 REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost) 표가 있습니다. 관계와 그 유형을 식별하십시오.
DEVICE이 CustomerID을 포함하므로 CUSTOMER–DEVICE는 일대다(한 고객, 여러 기기)입니다. REPAIR이 DeviceID을 포함하므로 DEVICE–REPAIR는 일대다이며, 또한 TechnicianID을 포함하므로 TECHNICIAN–REPAIR는 일대다입니다. CUSTOMER–REPAIR에 대한 직접적인 선은 없습니다: 연결은 DEVICE를 통해 이루어집니다. 세 개의 선, 세 개의 크로스발, 모두 REPAIR 또는 DEVICE 끝에 있습니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| cardinality/ˌkɑːdɪˈnælɪti/ | Glossary {"sense": "카디널리티", "subject": "A-Level 컴퓨터 과학", "term": "cardinality"} |
| one-to-many/wʌn tə ˈmeni/ | 일대다 관계 |
| link table/lɪŋk ˈteɪbl/ | Glossary {"sense": "연결 표", "subject": "A-Level 컴퓨터 과학", "term": "link table"} |
8.1
정형화

**정형화(Normalisation)**는 중복과 불일치를 줄이기 위해 표를 구성하며, **정형 단계(normal forms)**를 순서대로 거칩니다.
- 첫 번째 정형 단계(1NF) — 모든 필드는 단일(원자적) 값을 가지며, 반복 그룹이 없고, 기본 키가 있어야 합니다.
- 두 번째 정형 단계(2NF) — 1NF 조건을 충족해야 하며, 모든 비키 필드가 전체 기본 키에 의존해야 합니다(합성 키인 경우에만 해당).
- 세 번째 정형 단계(3NF) — 2NF 조건을 충족해야 하며, 모든 비키 필드가 오직 기본 키에만 의존해야 하고, 다른 비키 필드에 의존해서는 안 됩니다(종속 종속성(transitive dependency) 없음).
3NF 설계는 각 사실을 한 번만 저장하므로 삽입/수정/삭제 이분법(anomalies)이 사라집니다. 대가로 표가 더 많아지고 조인(join)이 더 필요합니다. 3NF를 목표로 하십시오.
3NF 설계를 만들기 위해: 엔티티와 속성을 찾으세요; 각 엔티티의 기본 키를 선택하세요; 반복되거나 원자적이지 않은 필드를 분할하세요(1NF); 합성 키의 일부에 의존하는 필드를 분할하세요(2NF); 키에 의해 종속적으로 의존하는 필드를 분할하세요(3NF); 관계에 대한 외래 키를 추가하십시오.
작업 예제. 표 ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity)은 합성 기본 키 (OrderID, ProductID)을 가집니다. 이를 3NF로 정형하십시오. 각 비키 필드를 키에 대해 테스트하십시오. Quantity은 OrderID과 ProductID 모두에 의존하므로 적절합니다. 그러나 CustomerID은 OrderID에만 의존합니다—합성 키의 일부에만 의존합니다. 이는 **부분 종속성(partial dependency)**이므로, 이 표는 2NF가 아닙니다. 이를 ORDER_LINE(OrderID, ProductID, Quantity)과 ORDER(OrderID, CustomerID, CustomerName)로 분할하십시오. 이제 3NF를 테스트하십시오: 새로운 ORDER 표에서, CustomerName은 CustomerID에 의존하는데, 이는 키가 아님—즉 **종속 종속성(transitive dependency)**입니다. 다시 분할하십시오: ORDER(OrderID, CustomerID)과 CUSTOMER(CustomerID, CustomerName). 각 단계를 위반하는 종속성의 이름을 붙이십시오(부분 종속성은 2NF를 위반, 종속 종속성은 3NF를 위반); "반복된 데이터가 있음"이라는 설명은 증상일 뿐이며 점수를 주지 않습니다.
모든 표에 대해 질문할 세 가지 문제. 모든 셀이 단일 값이고 반복 그룹이 없습니까? 그렇지 않으면 1NF가 아닙니다. 키가 합성이면, 모든 비키 필드가 전체 키에 의존합니까? 일부 필드가 일부에 의존하면 부분 종속성이 있어 표는 2NF가 아닙니다. 모든 비키 필드가 키에만 의존합니까? 어떤 필드가 다른 비키 필드에 의존하면 종속 종속성이 있어 표는 3NF가 아닙니다. "표가 3NF가 아닌 이유를 설명하시오"라는 답변은 종속성과 관련된 필드를 명시해야 합니다.
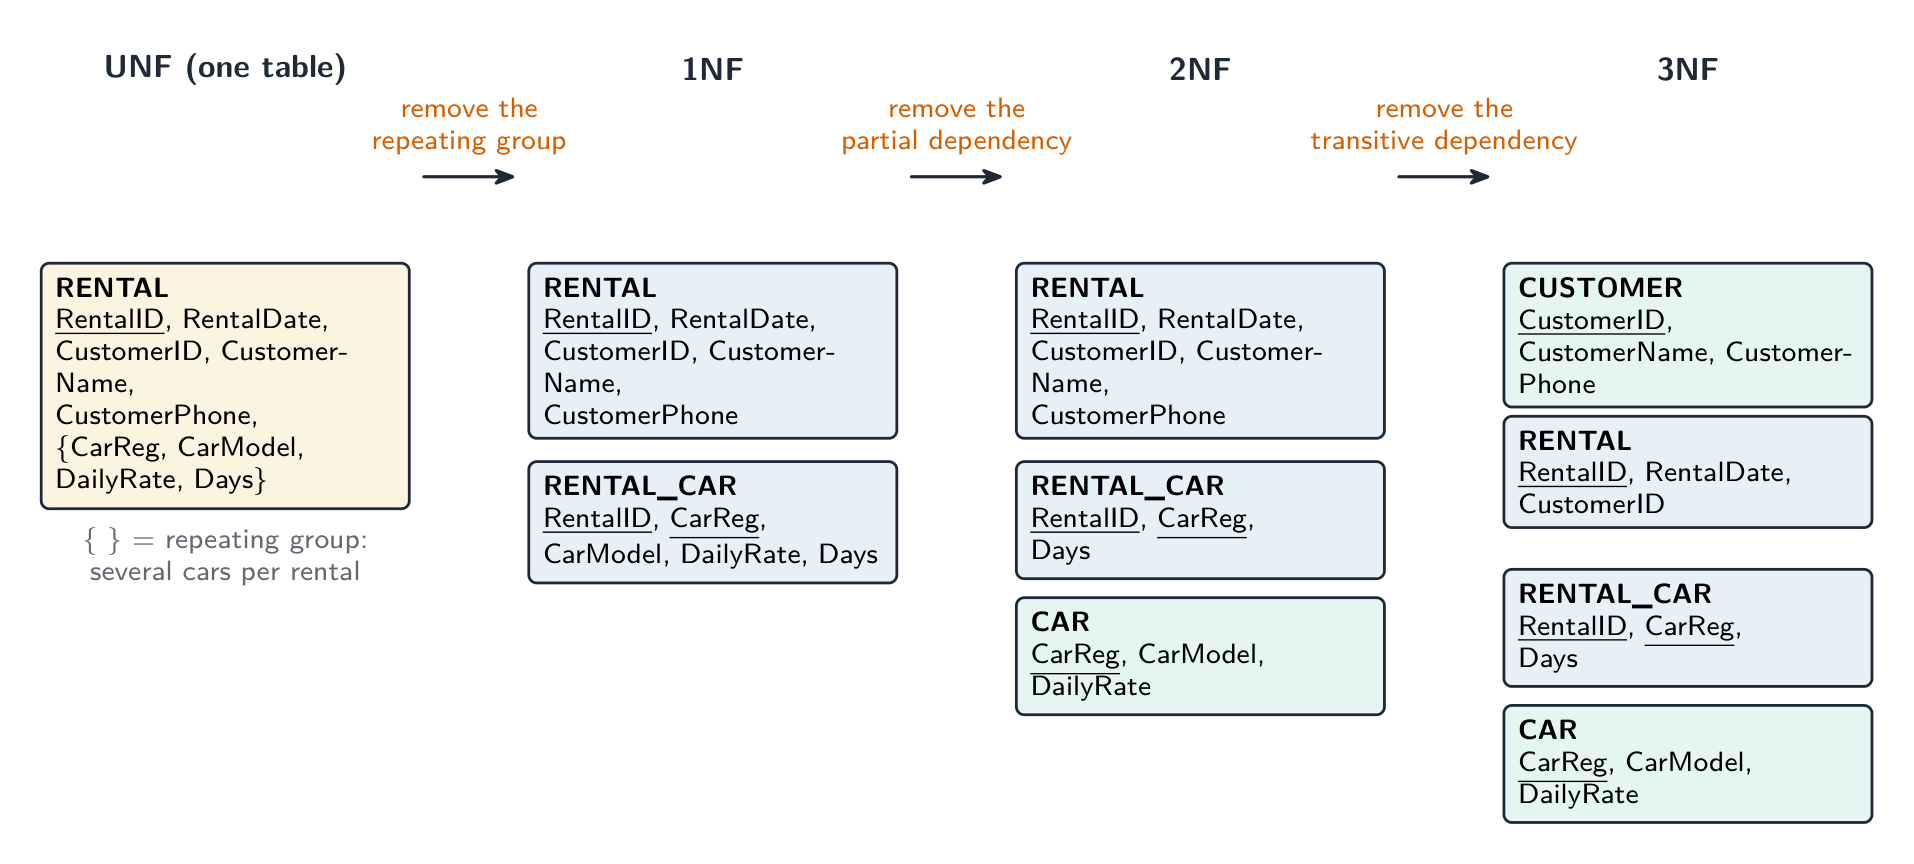
Worked example. A car-rental shop records each rental as RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), where one rental can include several cars. Explain why the table is not normalised and produce a 3NF design.
1NF가 아님: CarReg, CarModel, DailyRate, Days의 자동차 필드는 반복 그룹을 형성하고 — 한 번의 렌트에 여러 대의 차량이 포함됨. 이들을 합성 키 (RentalID, CarReg)과 함께 RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days)로 이동합니다. 2NF가 아님: RENTAL_CAR에서 CarModel과 DailyRate은 CarReg에만 의존합니다 — 이는 **부분 종속(partial dependency)**입니다. 이들을 CAR(CarReg, CarModel, DailyRate)로 이동하고 RENTAL_CAR(RentalID, CarReg, Days)만 남깁니다. 3NF가 아님: RENTAL에서 CustomerName과 CustomerPhone은 비키 필드인 CustomerID에 의존합니다 — 이는 **전치 종속(transitive dependency)**입니다. 이들을 CUSTOMER(CustomerID, CustomerName, CustomerPhone)로 이동하고 RENTAL(RentalID, RentalDate, CustomerID)만 남깁니다. 3NF 설계는 네 개의 테이블 — CUSTOMER, RENTAL, RENTAL_CAR, CAR —이며, CustomerID, RentalID, CarReg를 외래 키(foreign key)로 사용합니다. 모든 주키(primary key)에는 밑줄을 그으십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| join/dʒɔɪn/ | 조인 |
| normalisation/ˌnɔːməlaɪˈzeɪʃn/ | Glossary {"sense": "정규화", "subject": "A-Level 컴퓨터 과학", "term": "normalisation"} |
| normal forms/ˈnɔːml fɔːmz/ | Glossary {"sense": "范式", "subject": "A-Level 컴퓨터 과학", "term": "normal forms"} |
| atomic/əˈtɒmɪk/ | Glossary {"sense": "원자적", "subject": "A-Level 컴퓨터 과학", "term": "atomic"} |
| transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ | Glossary {"sense": "전이 의존성", "subject": "A-Level 컴퓨터 과학", "term": "transitive dependency"} |
| partial dependency/ˈpɑːʃl dɪˈpendənsi/ | 부분 종속성 |
8.2
데이터베이스 관리 시스템 (DBMS)

Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 파일 기반 방식의 문제를 해결하기 위해 **데이터베이스 관리 시스템(DBMS)이 제공하는 기능에 대한 이해 | 다음 포함: • 데이터 관리, 데이터 사전 유지 포함 • 데이터 모델링 • 논리적 스키마 • 데이터 무결성 • 데이터 보안, 백업 절차 및 사용자 개인/그룹에 대한 접근 권한 사용 포함 |
| DBMS 내 소프트웨어 도구들이 실제 어떻게 사용되는지 이해 | 다음 포함: • 개발자 인터페이스 • 쿼리 프로세서의 사용 및 목적 |
출처: Cambridge International syllabus
DBMS는 데이터베이스를 중앙에서 관리합니다. 파일 기반 방식의 한계를 해결하는 기능들:
- 데이터 사전 — 모든 테이블, 필드, 타입 및 키에 대한 설명; 프로그램은 구조를 하드 코딩하는 대신 이를 쿼리합니다.
- 중복/일관성 제어 — 동일한 사실은 한 번만 저장됩니다.
- 동시 접근(concurrent access) 제어 — 잠금(lock)과 트랜잭션(transaction)을 통해 여러 사용자가 동시에 작업할 수 있습니다.
- 백업 및 복구; 보안 및 사용자별 권한 설정.
- 무결성 규칙(integrity rules) — 키, 고유성 및 범위 제약 조건 등을 중앙에서 강제합니다.
- 트랜잭션(transactions) — 성공하거나 실패해야 하는 일련의 연산 그룹입니다.
- 뷰(views) — 각 사용자에게 데이터의 '그들만의' 조각만 보여주는 가상의 테이블입니다.
- 데이터 관리 및 데이터 모델링 — 데이터 저장 방식을 통제하고 이를 물리적 저장소와 독립적인 **논리 스키마(logical schema)**라는 논리적 설계로 정의합니다.
- 데이터 무결성 및 데이터 보안 — 정확성을 강제하고 접근을 중앙에서 통제합니다.
- **쿼리 프로세서(query processor)**가 쿼리를 실행하며, **개발자 인터페이스(developer interface)**는 애플리케이션 구축을 위한 도구와 API를 제공합니다.
도구로는 데이터 사전 에디터, 쿼리 빌더, 빌더, 리포트 생성기, 사용자 관리, SQL 에디터 등이 포함됩니다.
What the data dictionary holds (a "give three items" question): the names of the tables; the names of the fields in each table; each field's data type and length; the primary and foreign keys and the relationships between tables; validation rules; indexes; and who may access each table. It is metadata — data about the data — and the DBMS uses it to check every query and every change.
How the DBMS keeps the data secure (a "describe two methods" question): authentication — a username and password, or a biometric, before any access; access rights — each user or group is allowed to read, write or delete only certain tables or fields, often through a view; encryption of the stored data and of data sent to it, so a copied file is unreadable; backups taken regularly, so the data can be restored after loss; and a transaction log that records who changed what.
두 가지 소프트웨어 도구. 개발자 인터페이스는 프로그래머가 데이터베이스와 그에 기반한 애플리케이션을 구축하는 데 사용하는 것: 테이블 생성 및 키/검증 설정, 쿼리 및 SQL 작성, 폼 및 리포트 디자인을 물리적 저장 방식을 알지 않고도 수행합니다. 쿼리 프로세서는 쿼리(프로그램의 SQL 또는 인터페이스에서 생성된 쿼리)를 받아 데이터 사전과 대조하여 가장 효율적인 실행 방법을 산출하고, 데이터를 검색하여 결과를 반환합니다.
논리 스키마(logical schema). DBMS는 논적 설계(어떤 테이블과 필드가 존재하며 어떻게 관련되는지)를 물리적 저장소(파일, 인덱스, 디스크 블록)와 분리하여 유지합니다. 프로그램은 논적 스키마와 상호작용하므로 물리적 저장소를 재편하더라도 단일 프로그램도 변경하지 않아도 됩니다 — 이것이 파일 기반 방식이 부족했던 데이터 독립성(data independence)입니다.
탐색하기
데이터베이스 서비스 실험실
DBMS가 질문을 안전한 공유 데이터 접근으로 변환하는 과정을 확인하십시오.
탐색하기
데이터베이스 서비스 실험실
DBMS가 질문을 안전한 공유 데이터 접근으로 변환하는 과정을 확인하십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| data dictionary/ˈdeɪtə ˈdɪkʃənəri/ | Glossary {"sense": "데이터 사전", "subject": "A-Level 컴퓨터 과학", "term": "data dictionary"} |
| concurrent access/kənˈkʌrənt ˈækses/ | Glossary {"sense": "동시 접근", "subject": "A-Level 컴퓨터 과학", "term": "concurrent access"} |
| transactions/trænˈsækʃnz/ | 트랜잭션 |
| backup/ˈbækʌp/ | 백업 |
| views/vjuːz/ | 뷰 |
| data management/ˈdeɪtə ˈmænɪdʒmənt/ | Glossary {"sense": "데이터 관리", "subject": "A-Level 컴퓨터 과학", "term": "data management"} |
| data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ | Glossary {"sense": "데이터 모델링", "subject": "A-Level 컴퓨터 과학", "term": "data modelling"} |
| logical schema/ˈlɒdʒɪkl ˈskiːmə/ | Glossary {"sense": "논리적 스키마", "subject": "A-Level 컴퓨터 과학", "term": "logical schema"} |
| data integrity/ˈdeɪtə ɪnˈteɡrɪti/ | Glossary {"sense": "데이터 무결성", "subject": "A-Level 컴퓨터 과학", "term": "data integrity"} |
| data security/ˈdeɪtə sɪˈkjʊərɪti/ | Glossary {"sense": "데이터 보안", "subject": "A-Level 컴퓨터 과학", "term": "data security"} |
| query processor/ˈkwɪərɪ ˈprəʊsesə/ | Glossary {"sense": "쿼리 프로세서", "subject": "A-Level 컴퓨터 과학", "term": "query processor"} |
| developer interface/dɪˈveləpə ˈɪntəfeɪs/ | Glossary {"sense": "개발자 인터페이스", "subject": "A-Level 컴퓨터 과학", "term": "developer interface"} |
| authentication/ɔːˌθentɪˈkeɪʃn/ | 인증 |
8.3
DDL 및 DML
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| DBMS가 모든 데이터베이스 구조 생성/수정을 **데이터 정의 언어(DDL)를 통해 수행함을 이해 | |
| DBMS가 모든 쿼리 및 데이터 유지를 DML을 통해 수행함을 이해 | |
| DDL 및 DML 모두 산업 표준이 **Structured Query Language(SQL)임을 이해 | 주어진 SQL 문장 이해 |
| 주어진 **SQL(DDL) 문장을 이해하고 간단한 **SQL(DDL) 문장 작성이 가능하도록 함 (문장 하위 집합 사용) | 데이터베이스 생성(CREATE DATABASE) 테이블 정의 생성(CREATE TABLE), 적절한 데이터 타입을 가진 속성 생성 포함: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME 테이블 정의 변경(ALTER TABLE) 테이블에 주키 추가(PRIMARY KEY (필드)) 테이블에 외부키 추가(FOREIGN KEY (필드) REFERENCES 테이블 (필드)) |
| (최대 두 개의) 데이터베이스 테이블에 저장된 데이터를 조회하거나 수정하는 SQL 스크립트 작성 (DML) | SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG를 포함한 쿼리 |
| 데이터 유지 관리 including INSERT INTO, DELETE FROM, UPDATE |
출처: Cambridge International syllabus
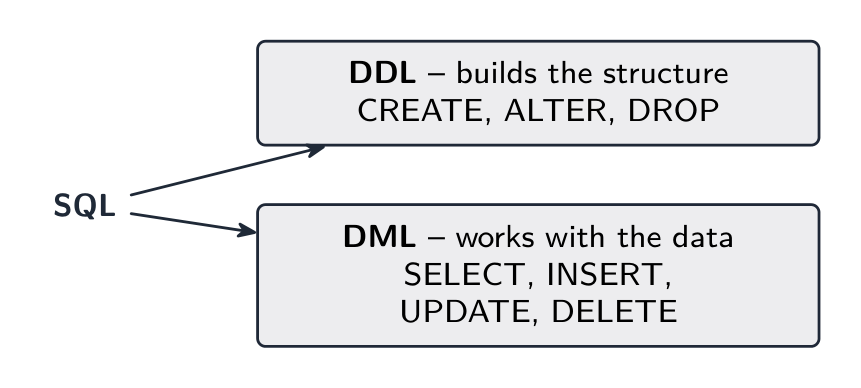
SQL(Structured Query Language)은 두 부분으로 나뉩니다:
- Data Definition Language (DDL) — 구조(테이블, 키, 제약 조건)를 생성하거나 수정합니다.
- Data Manipulation Language (DML) — 데이터(삽입, 업데이트, 삭제, 쿼리)를 조작합니다.
DML 기본
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
외래 키 추가:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
수정 및 삭제:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
일반적인 유형: INTEGER, REAL, VARCHAR(n), CHAR(n) (또는 CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s).
DML 기본
SELECT를 사용한 쿼리:

SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT는 필드를 나열하고, FROM는 테이블명을 명시하며, WHERE는 행을 필터링하고, ORDER BY는 정렬합니다.
조인(join) 은 외래 키 관계를 사용하여 두 개의 테이블을 결합합니다:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
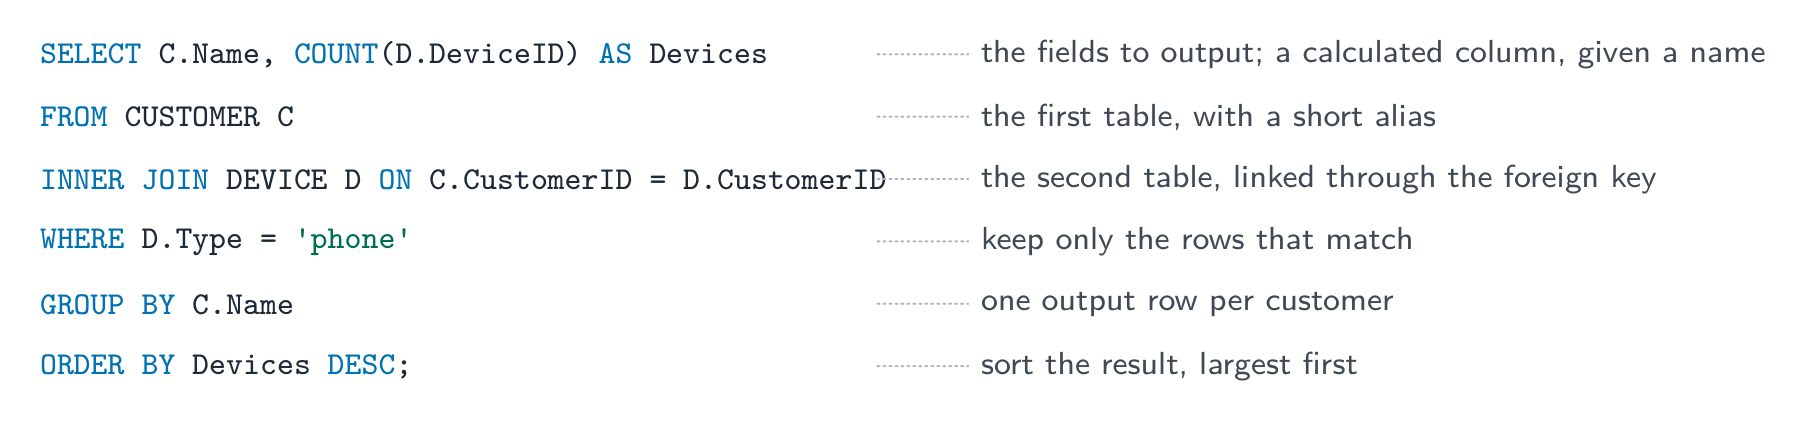
집계 함수(aggregate functions) (COUNT, SUM, AVG, MIN, MAX)는Often GROUP BY와 함께 사용됩니다:
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
삽입, 업데이트, 삭제:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
항상 ⦿ WHERE 구문을 ⦿ UPDATE과 ⦿ DELETE에 붙여야 하며, 그렇지 않으면 변경 사항이 모든 행에 영향을 미칩니다.
시험용 SQL 팁
- 문제에서 제시한 정확한 테이블 및 필드 이름을 사용하십시오.
- 문자열은 single quote(
'Smith')로 감싸고, 숫자는 감싸지 마십시오. - 비교 연산자:
=,<,>,<=,>=,<>. LIKE 'A%'는 A로 시작하는 모든 것을 일치시킵니다(%= 임의의 문자열,_= 한 문자);IN (1,2,3);BETWEEN 10 AND 20.- 조건을
AND/OR/NOT로 결합하고, 각 문장 끝에는 세미콜론(;)을 넣으십시오.
고사에서 요구하는 DDL 패턴. 매 CREATE TABLE는 각 필드에 타입을 명시하고, 주키를 표시하며, 각 외래키와 그外이 참조하는 테이블을 선언합니다. 복합 키는 별도의 줄에 선언됩니다:
CREATE TABLE RENTAL_CAR (
  RentalID INTEGER,
  CarReg VARCHAR(8),
  Days INTEGER,
  PRIMARY KEY (RentalID, CarReg),
  FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID),
  FOREIGN KEY (CarReg) REFERENCES CAR(CarReg)
);
작동 예제. CUSTOMER(CustomerID, Name, Phone)와 DEVICE(DeviceID, CustomerID, Type, Model)을 사용하여 다음 SQL 스크립트를 작성하십시오: (a) 장치 종류가 'tablet'인 모든 고객의 이름과 전화번호를 이름 순서대로 나열; (b) 각 종류의 장치 수 카운트; (c) 고객 17번의 전화번호를 '0771 234 5678'으로 기록; (d) 고객 17번에게 속한 새로운 장치 추가, ID 305, 모델 'X1'인 'laptop'.
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
점수는 절 clause마다 부여됩니다 — 필드, 테이블, 조인 조건, WHERE, ORDER BY 등 — 따라서 하나의 잘못된 절만 있어도 나머지 절은 점수를 받을 수 있습니다. 두 개의 테이블이 관련될 때마다 Table.Field을 쓰십시오.
작동 예제. 이 스크립트가 무엇을 하는지 설명하십시오: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
It outputs each technician's name with the total cost of the repairs that technician has carried out, one row per technician: the two tables are joined on TechnicianID, the rows are grouped by name, and the costs in each group are added. When asked what a script does, describe the result, not the syntax.
SQL 조건 및 키
LIKE 'Li%'은 Li로 시작하는 텍스트에 매칭; %는 임의의 개수의 문자를 나타내고 _은 정확히 하나를 나타냅니다. AND는 두 조건 모두를 요구; OR은 적어도 하나의 조건을 요구합니다. 결합할 때는 괄호를 사용하십시오.
CREATE DATABASE Club;
CREATE TABLE Booking (
  MemberID INTEGER,
  EventID INTEGER,
  PRIMARY KEY (MemberID, EventID)
);
ALTER TABLE Booking ADD FOREIGN KEY (MemberID)
  REFERENCES Member(MemberID);
SELECT Name FROM Member
WHERE Name LIKE 'Li%' AND (Year = 12 OR Year = 13)
ORDER BY Name DESC;
The composite primary key makes the pair unique, not each column separately. A foreign key prevents a non-null reference to a missing parent record. ON UPDATE CASCADE carries a parent-key change to referencing rows; ON DELETE CASCADE deletes those rows when the parent is deleted.
탐색하기
INNER JOIN으로 두 테이블을 연결(stitch)
외래 키가 primary key와 일치하는 행을 매칭합니다 — 여기서는 Orders.CustomerID = Customer.CustomerID — 각 매칭 쌍을 하나의 더 넓은 행으로 결합합니다.
탐색하기
SELECT … WHERE
Queries를 단계별로 진행하세요: WHERE는 일치하는 행을 유지하고, SELECT는 요청한 열을 선택합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ | 데이터 정의 언어 |
| Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ | 데이터 조작 언어 |
| aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ | 집계 함수 |
8.3
출제자가 인정하는 정의
정의 문제는 고정된 문구로 채점합니다. 이 내용들을 정확히 외우고, 답은 하나만 제시하십시오.
| 용어 | 정의 |
|---|---|
| 엔티티 | 데이터가 저장되는 대상 — 사람, 사물 또는 사건 — 관계형 데이터베이스에서 테이블로 구현됨 |
| 속성 | 엔티티에 대한 하나의 데이터 항목(테이블의 열) |
| tuple | one row of a table: one instance of the entity |
| 주키 | 테이블 내 각 레코드를 고유하게 식별하는 속성 또는 속성의 조합 |
| 외래키 | 한 테이블의 속성 중 다른 테이블의 주키 값과 일치하여 두 테이블을 연결하는 데 사용되는 속성 |
| 후보 키 | 주키로 선택될 수 있는 어떤 속성(또는 조합) |
| 이차 키 | 주키가 아닌 인덱스 속성으로, 테이블 내에서 빠르게 검색하거나 정렬할 수 있게 함 |
| 복합 키 | 두 개 이상의 속성이 결합된 주키 |
| 참조 무결성 | 모든 외래키 값은 해당 테이블에서 참조하는 주키 값 중 이미 존재하는 값과 일치해야 함 |
| 1NF | 모든 속성이 원자적이고, 반복되는 그룹이 없으며, 주키가 있는 테이블 |
| 2NF | 1NF이며, 비주키 속성이 주키 전체에 종속되어 있음(부분 종속 없음) |
| 3NF | 2NF이며, 비주키 속성이 다른 비주키 속성에 종속되지 않음(전치 종속 없음) |
| 데이터 사전 | DBMS가 데이터베이스 구조에 대해 유지하는 메타데이터: 테이블, 필드, 타입, 키, 관계, 검증 정보 |
| DDL / DML | 데이터베이스 구조를 정의하거나 변경하는 언어 / 데이터베이스 내 데이터를 조회하고 관리하는 언어 |
8.3
시험 팁
- 용어를 정확히 정의: 엔티티, 속성, 주키, 외래키, 그리고 관계 유형(1:1, 1:다수, 다수:다수).
- 각 정형화 단계마다 이유 제시: 1NF(반복된 그룹 없음), 2NF(부분 종속 없음), 3NF(비주키 종속 없음) — 그리고 관련된 필드명 명시.
- DBMS가 제공하는 기능 설명(데이터 독립성, 보안, 무결성, 동시 접근, 데이터 사전, 개발자 인터페이스, 쿼리 프로세서).
- DDL(구조 정의)과 DML(데이터 조회 및 변경)을 구분하고, SQL 절을 하나씩 작성:
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - 테이블로부터 E-R 다이어그램을 그리려면 먼저 모든 외래키를 찾으십시오: 모든 외래키는 하나의 일대다 관계이며, '다'는 외래키가 포함된 테이블에 위치함.
흔한 실수
- 일대다 관계를 직접 그리는 방법. 이는 두 개의 일대다 관계로 분리되어야 하며, 양쪽 외래키를 포함하는 링크 테이블을 통해 연결됨.
- "3NF가 아님"을 "데이터가 중복됨"으로 설명. 종속 유형(부분 또는 전치)과 관련된 필드명 명시.
- SQL에서 문자열은 이중 따옴표로 감싸거나 숫자는 따옴표로 감쌈. 문자열은
'single quotes'를 필요로 함; 숫자는 필요 없음. INNER JOIN뒤에ON조건을 누락함. 이것이 없으면 두 테이블이 연결되지 않음.SELECT에서COUNT또는SUM옆에 일반 필드를 배치하되GROUP BY이 없는 경우.WHERE없이UPDATE또는DELETE사용. 테이블의 모든 행을 변경하거나 삭제함.
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.