| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| データの保存および検索における**ファイルベースアプローチ(file-based approach)**の限界に対する理解を示す | |
| ファイルベースアプローチの限界に対応する**リレーショナルデータベース(relational database)**の特徴を説明する | |
| リレーショナルデータベースモデルに関連する用語を理解し使用できる | エンティティ(entity)、テーブル(table)、レコード(record)、フィールド(field)、タプル(tuple)、属性(attribute)、主キー(primary key)、候補キー(candidate key)、セカンダリーキー(secondary key)、外部キー(foreign key)、関係性(relationship)(one-to-many、one-to-one、many-to-many)、参照整合性(referential integrity)、**インデックス化(indexing)**を含む |
| **エンティティ・リレーションシップ図(E-R diagram)**を使用してデータベース設計を文書化する | |
| 正規化プロセスを理解する | 第一正規形 (1NF)、第二正規形 (2NF)、第三正規形 (3NF) |
| 指定されたデータベーステーブルが、なぜ、あるいはなぜなら、3NFにあるのかを説明する | |
| データベースの説明、与えられたデータセット、または与えられたテーブルセットに基づいて、正規化されたデータベース設計を作成する |
データベース
A-Levelコンピュータ科学 · トピック 8
 17:18
データベースとリレーショナルモデル
データベース以前は、各プログラムが独自のフラットファイルを保持していました。各プログラムごとに1つのファイルです。店舗を想像してみてください。販売プログラム、請求書作成プログラム、配送プログラム…
英語ナレーション・英語+中文字幕 burning-in
8.1
ファイルベースの保存とその限界

シラバス
出典: Cambridge International シラバス
データベース以前、プログラムはデータをフラットファイルに保存していました——通常、各プログラムごとに1つのファイルでした。小規模なデータには適していますが、大規模になると機能しなくなります。
限界
- データの重複 ——同じデータ(顧客の住所など)が複数のファイルに格納されており、各プログラムごとに1つずつあるため、ストレージが浪費され、すべてのコピーを更新する必要があります。
- データの不整合 ——1つのコピーが更新された場合、他のコピーが更新されていないと、ファイル間に矛盾が生じ、どちらが正しいか分かりません。
- データ依存性 ——各プログラムは、対応するファイルの正確なレイアウトのために書かれており、フィールドの長さを変更したり、新しいフィールドを追加したりすると、そのファイルを読むすべてのプログラムを書き直す必要があります。
- 共有アクセスの欠如 ——1つのプログラムがファイルを使用している間、ファイルはロックされるため、ユーザーは同時にデータにアクセスできません。
- 弱いデータ完全性 ——不正な値や存在しない顧客へのリンクを阻止する中央のルールがありません;弱いセキュリティ ——アクセス権限はファイル単位であり、フィールド単位ではありません;また、ファイル間での照会を行う每次都新的なプログラムが必要です。

リレーショナルデータベースは、これらを解決するために、データをテーブルに格納し、すべてのプログラムが利用する1つのソフトウェア(DBMS)によって管理されます。

リレーショナルデータベースが優れている理由 — 3点満点の回答。 各データ項目は一度だけ1つのテーブルに保存され、テーブルはキーによってリンクされるため、重複も不整合もありません; データはプログラムから独立しており、プログラムは必要なデータをDBMSに要求するため、構造が変わっても影響を受けません; DBMSは整合性ルールを強制し、ユーザーおよびフィールドごとのアクセスを制御し、複数用户同时使用を許可し、新たなプログラムを作成することなくあらゆる照会に応答する。
** worked example.** 修理店は顧客、機器、修理作業をファイルベースのアプローチで管理しています——各プログラムごとに1つのファイル。これが引き起こす3つの問題と、リレーショナルデータベースがそれらをどのように解消するかを説明してください。
顧客の名前と電話番号は修理ファイルおよび請求書ファイルの両方に保存されており(重複)、電話番号が変更された際、一方のファイルは更新されるものの他方は更新されない(一貫性の欠如)ことが生じます。また、店側が新しいレポート(技師別修理件数など)を必要とした場合、ファイルを読み込むための新しいプログラムを作成する必要があり、アドホックなクエリはできません。リレーショナルデータベースでは、顧客情報はCUSTOMERテーブルに1度だけ保存され、REPAIRテーブルからCustomerIDで参照されるため、変更は一度行われ everywhere に反映されます。レポートは単一のSQLクエリで生成可能です。
語彙
練習する
| English | 日本語 |
|---|---|
| flat files/flæt faɪlz/ | フラットファイル |
| data redundancy/ˈdeɪtə rɪˈdʌndənsi/ | データ冗長性 |
| data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ | データ不整合 |
| field/fiːld/ | フィールド |
| integrity/ɪnˈteɡrɪti/ | 完全性 |
| relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ | リレーショナルデータベース |
| DBMS/ˌdiː biː em ˈes/ | データベース管理システム |
| SQL/ˌes kjuː ˈel/ | 構造化クエリ言語 |
| entity/ˈentɪti/ | エンティティ |
| record/ˈrekɔːd/ | レコード |
| tuple/ˈtuːpl/ | タプル |
| attribute/ˈætrɪbjuːt/ | 属性 |
8.1
リレーショナルモデル — 用語
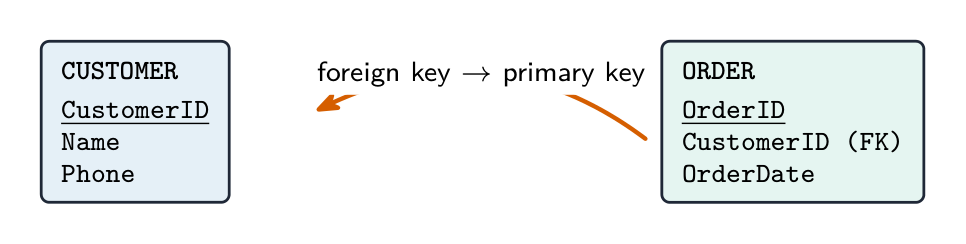
- テーブル(関係) — 行と列からなるグリッド;各エンティティ(例:
CUSTOMER)ごとに1つのテーブルを持つ。 - レコード(行、タプルとも呼ばれる)——1つの行;エンティティの1つのインスタンス。
- フィールド(列、属性とも呼ばれる)——1つの列;各レコードに関する1つの情報要素。
- プライマリキー ——各レコードを一意に識別するフィールド(またはフィールド群);null値や重複は許可されない。
- フォロイキー ——値が他テーブルのプライマリキーと一致するフィールドで、2つのテーブルを接続する。
- コンポジットキー ——2つ以上のフィールドを組み合わせたプライマリキー。
- キャンディデートキー ——プライマリキーになりうる任意のフィールド(またはフィールド群)。
- セカンダリキー ——高速検索のためにインデックス付けされた非プライマリフィールド。
- インデックス化 ——フィールドにインデックスを構築し、照会やジョインを高速化する。
- 参照完全性 ——すべてのフォロイキー値は、既存のプライマリキーと一致しなければならない(孤児レコードは存在しない)。
テーブルは省略表記で書き、プライマリキーは下線付きとし、フォロイキーを注記する:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
** worked example.** リレーショナルデータベースにおけるエンティティ、プライマリキー、参照完全性の意味を述べ、タプルおよび属性の用語↔説明表を完成させてください。
エンティティとは、データを格納する対象(人物、物体、出来事)であり、1つのテーブルとなります。プライマリキーとは、テーブル内の各レコードを一意に識別する属性(または属性の組み合わせ)です。参照完全性とは、すべてのフォロイキー値が、参照先テーブルのプライマリキーの値と一致することを意味し、存在しないレコードを参照することはできません。タプルとは、1つの行(1つのレコード)のこと;属性とは、1つの列(1つのフィールド)のこと。ペアを覚える:テーブル/リレーション、レコード/タプル、フィールド/属性。
探索
SELECTを使ってリレーショナルテーブルを読み込む
リレーショナルテーブルは単に行(レコード)と列(フィールド)から構成されます。WHERE句は条件に一致する行を保持し、SELECT句は要求した列のみを抽出します。
語彙
練習する
| English | 日本語 |
|---|---|
| table/ˈteɪbl/ | 表 |
8.1
エンティティ・リレーションシップ図 (E-R図)

エンティティ・リレーションシップ図は構造を示します:各エンティティは長方形、各リレーションシップは線で表現され、両端にカーディナリティが記載されます:
- 1対1(1:1)。
- 1対多 (1:M) — 各顧客には複数の注文があり、各注文は1つの顧客を持つ。
- 多対多 (M:N) — 学生は複数の科目を受講し、科目には複数の学生がいる。

A many-to-many relationship cannot be stored directly. Break it into two one-to-many relationships through a link table holding the two foreign keys:
ENROLMENT(StudentID, CourseID, EnrolmentDate)

与えられたテーブル群に対するE-R図の描画法。 各テーブルはエンティティとなる。あるテーブルが他テーブルに対して外キーを持っている場所には関係が存在し、外キーを持つテーブル(多数端)から、その主キーを持つテーブル(単一端)へ向かう。2つの外キーを持ち、他のアイデンティティを持たないテーブルは通常、多対多関係を解決するためのリンクテーブルである。各線には関係タイプをラベル付けする。
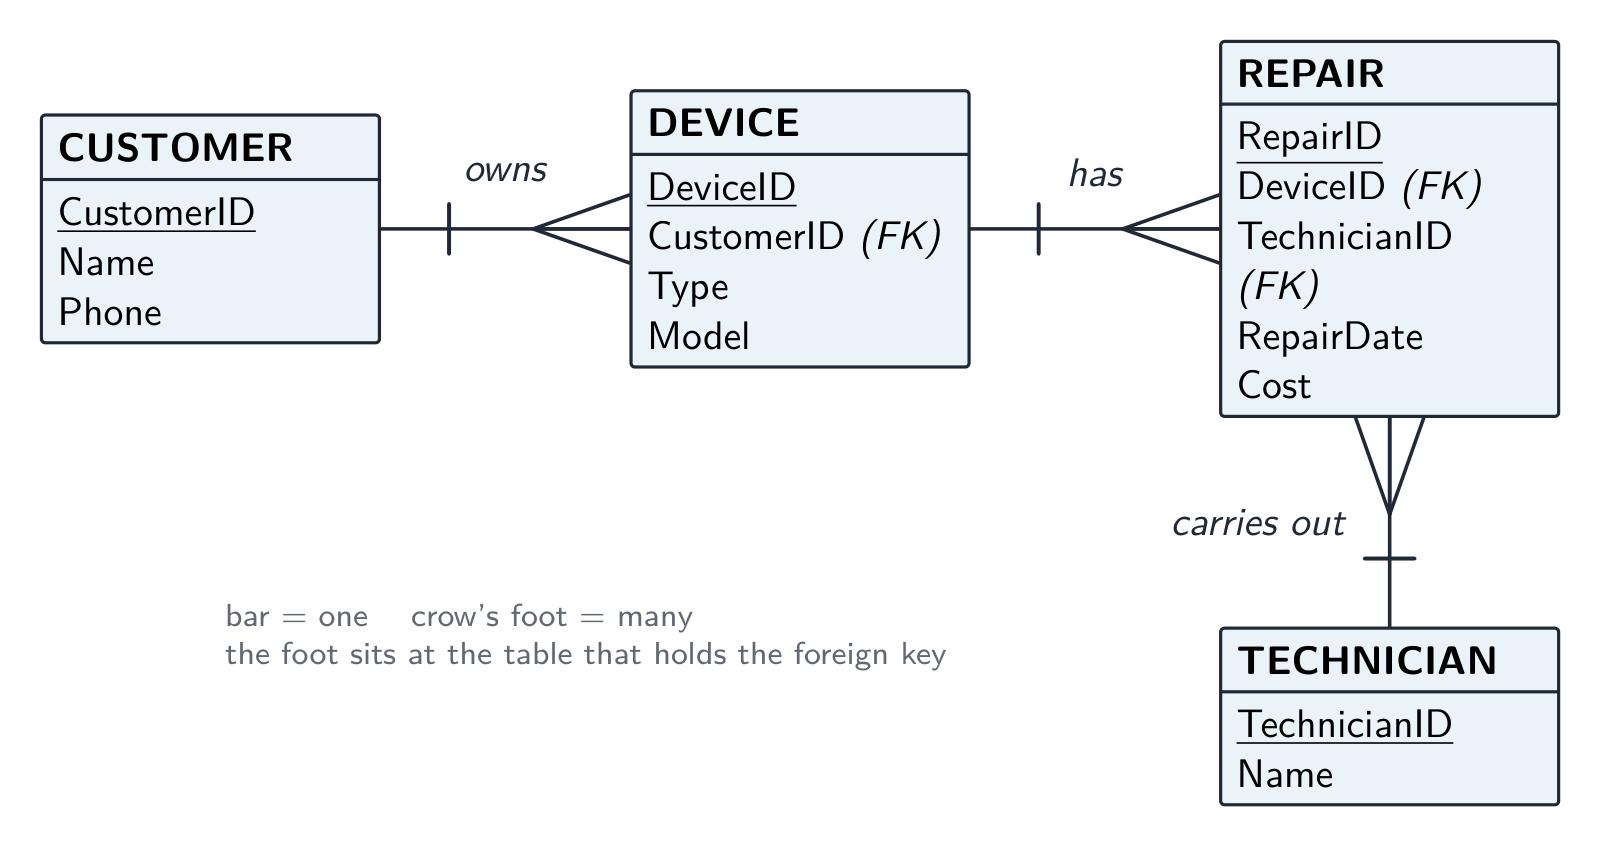
演習問題。 修理店は CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name), REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost) というテーブルを持っている。それらの関係とそのタイプを特定せよ。
DEVICE は CustomerID を持つため、CUSTOMER–DEVICE は 1対多 (1人の顧客、複数のデバイス)である。REPAIR は DeviceID を持つため、DEVICE–REPAIR は 1対多 であり、また TechnicianID も持つため、TECHNICIAN–REPAIR は 1対多 である。CUSTOMER–REPAIR に直接の線はない:リンクは DEVICE を通じて行われる。3本の線、3つのCrow's feet、すべて REPAIR または DEVICE の端にある。
語彙
練習する
| English | 日本語 |
|---|---|
| foreign key/ˈfɒrən kiː/ | 外部鍵 |
| composite key/ˈkɒmpəzɪt kiː/ | 複合鍵 |
| candidate key/ˈkændɪdeɪt kiː/ | 候補鍵 |
| secondary key/ˈsekəndəri kiː/ | セカンダリーキー |
| indexing/ˈɪndeksɪŋ/ | インデックス付け |
| cardinality/ˌkɑːdɪˈnælɪti/ | 基数 |
| one-to-many/wʌn tə ˈmeni/ | 一対多 |
| link table/lɪŋk ˈteɪbl/ | リンクテーブル |
8.1
正規化

正規化とは、重複と不整合を削減するために、順序立てて正規形を経ることでテーブルを整理することである。
- 第1正規形 (1NF) — 各フィールドは単一の(原子的な)値のみを保持し、反復グループはなく、主キーがある。
- 第2正規形 (2NF) — 1NFを満たし、かつ非キーフィールドが完全な主キーに依存していること(複合主キーの場合のみ重要)。
- 第3正規形 (3NF) — 2NFを満たし、かつ非キーフィールドが主キーのみに依存しており、他の非キーフィールドには依存しないこと(伝達依存なし)。
3NF設計では各事実を一度だけ格納するため、挿入・更新・削除の異常が消滅する。その代償として、テーブル数とジョインが増える。3NFを目指す。
3NF設計を作成するには:エンティティとその属性を見つけ、各々に主キーを選択し、反復/非原子的フィールドを分割(1NF)、複合主キーの一部に依存するフィールドを分割(2NF)、鍵に伝達的に依存するフィールドを分割(3NF)、そして関係对外キーを追加する。
計算例。 テーブル ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) は複合主キー (OrderID, ProductID) を持つ。これを 3NF に正規化せよ。各非キーフィールドをキーに対してテストする。Quantity は 両方 の OrderID と ProductID に依存しており、これは問題ない。しかし CustomerID は OrderID alone に依存している—複合主キーの一部のみである。これは部分依存であるため、このテーブルは 2NF ではない。それを ORDER_LINE(OrderID, ProductID, Quantity) と ORDER(OrderID, CustomerID, CustomerName) に分割せよ。次に 3NF をテストする:その新しい ORDER テーブルにおいて、CustomerName は CustomerID に依存しているが、それはキーではない—転移依存関係である。さらに分割する:ORDER(OrderID, CustomerID) と CUSTOMER(CustomerID, CustomerName) 。各正規形を破る依存関係の名前を答える(部分依存が 2NF を破り、転移依存関係が 3NF を破る);「重複データがある」は症状の説明であり、得点はない。
どのテーブルに対しても問うべき3つの質問。 すべてのセルは単一の値であり、反復グループはないか? もしそうでないなら、1NFではない。 鍵が複合的な場合、すべての非キーフィールドが完全な鍵に依存しているか? もし一部に依存するフィールドがあれば、部分的依存 が存在し、2NFではない。 すべての非キーフィールドが鍵のみに依存しているか? もし別の非キーフィールドに依存するフィールドがあれば、伝達依存が存在し、3NFではない。「なぜこのテーブルは3NFではないか」と答える場合は、依存の種類と関連するフィールドを明記する。
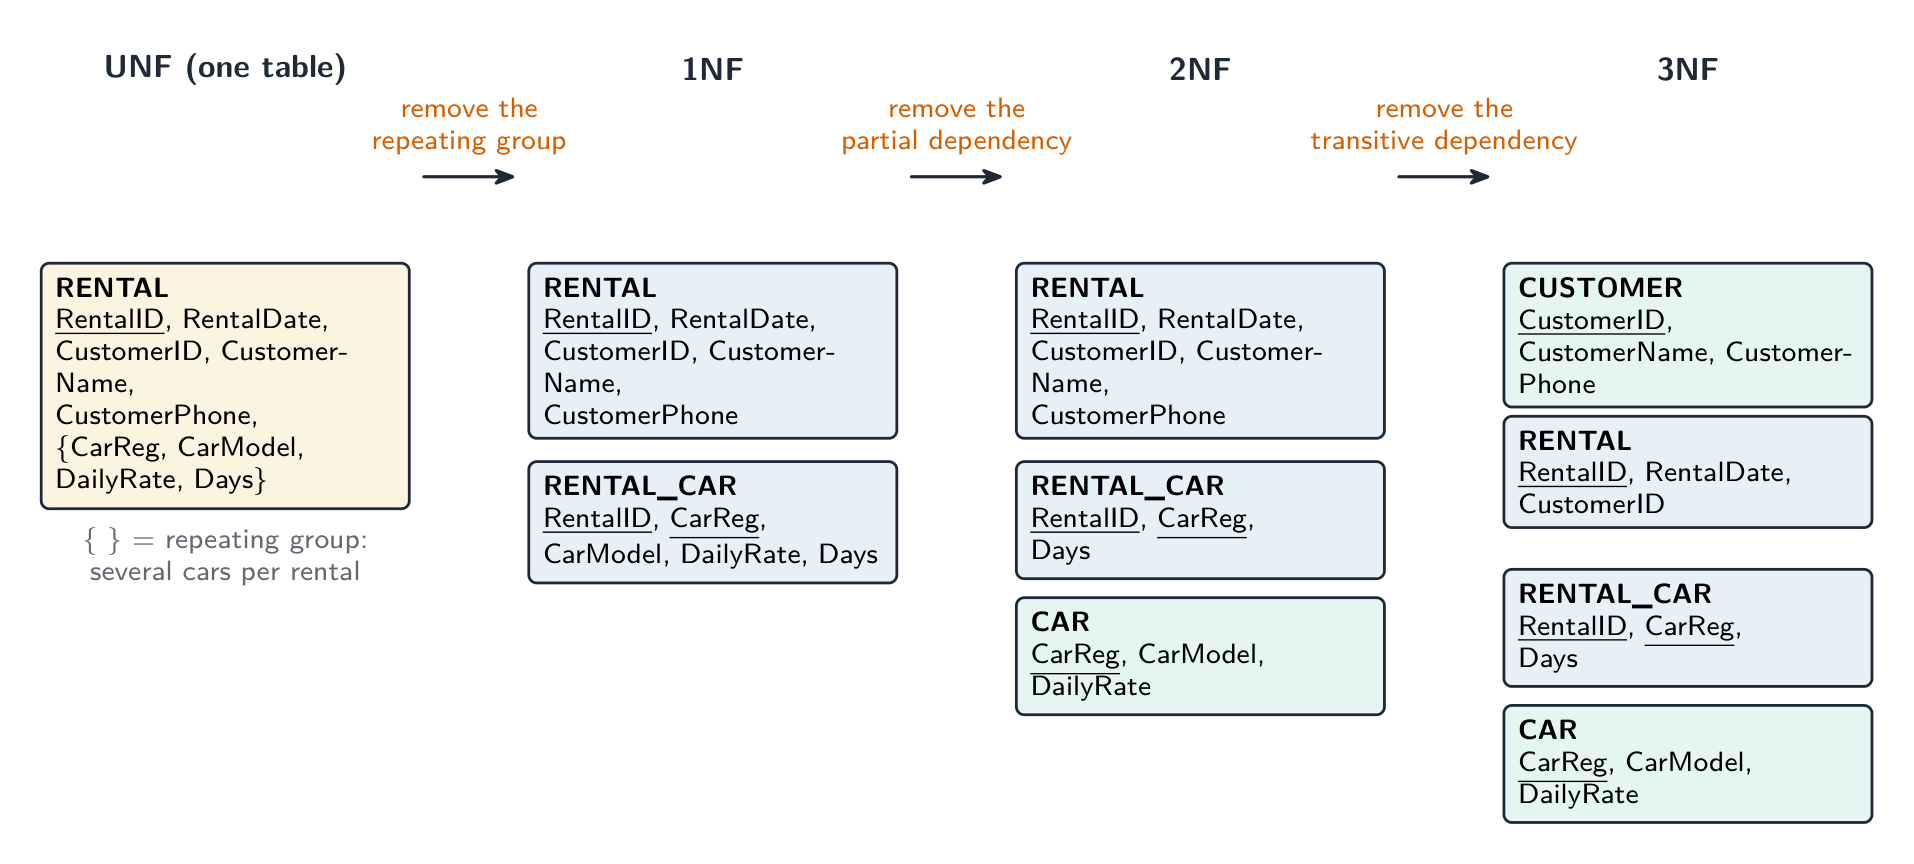
演習問題。 自動車レンタル店は各レンタルを RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days) として記録しており、1回のレンタルに複数の車が含まれる可能性がある。このテーブルが正規化されていない理由を説明し、3NF設計を作成せよ。
1NF 不符合: CarReg, CarModel, DailyRate, Days カートフィールドは反復グループを形成している — 1回のレンタルで複数のカートがある。これらを RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) に移動し、複合キー (RentalID, CarReg) を使用する。2NF 不符合: RENTAL_CAR において、CarModel と DailyRate は CarReg のみに依存しており、部分依存関係である。これらを CAR(CarReg, CarModel, DailyRate) に移動させ、RENTAL_CAR(RentalID, CarReg, Days) を残す。3NF 不符合: RENTAL において、CustomerName と CustomerPhone は非キーフィールドである CustomerID に依存しており、転移依存関係である。これらを CUSTOMER(CustomerID, CustomerName, CustomerPhone) に移動させ、RENTAL(RentalID, RentalDate, CustomerID) を残す。3NF デザインは4つのテーブル — CUSTOMER、RENTAL、RENTAL_CAR、CAR — で構成され、CustomerID、RentalID、CarReg が外部キーとなる。すべての主キーに下線を引く。
語彙
練習する
| English | 日本語 |
|---|---|
| normalisation/ˌnɔːməlaɪˈzeɪʃn/ | 正規化 |
| normal forms/ˈnɔːml fɔːmz/ | 正規形 |
| atomic/əˈtɒmɪk/ | 原子 |
| transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ | 伝達依存 |
| partial dependency/ˈpɑːʃl dɪˈpendənsi/ | 部分依存 |
| data dictionary/ˈdeɪtə ˈdɪkʃənəri/ | データ辞書 |
| concurrent access/kənˈkʌrənt ˈækses/ | 並列アクセス |
| transactions/trænˈsækʃnz/ | トランザクション |
| backup/ˈbækʌp/ | バックアップ |
| views/vjuːz/ | ビュー |
| data management/ˈdeɪtə ˈmænɪdʒmənt/ | データ管理 |
| data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ | データモデリング |
| logical schema/ˈlɒdʒɪkl ˈskiːmə/ | 論理スキーマ |
| data integrity/ˈdeɪtə ɪnˈteɡrɪti/ | データ整合性 |
| data security/ˈdeɪtə sɪˈkjʊərɪti/ | データセキュリティ |
| query processor/ˈkwɪərɪ ˈprəʊsesə/ | クエリプロセッサー |
| developer interface/dɪˈveləpə ˈɪntəfeɪs/ | 開発者用API |
| authentication/ɔːˌθentɪˈkeɪʃn/ | 認証 |
| Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ | データ定義言語 |
| Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ | データ操作言語 |
| aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ | 集計関数 |
8.2
データベース管理システム (DBMS)

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ファイルベースアプローチの問題に対応する**データベース管理システム(Database Management System, DBMS)**が提供する機能に対する理解を示す | 以下を含む: • データ管理、**データ辞書(data dictionary)**の維持を含む • データモデリング(data modelling) • 論理スキーマ(logical schema) • データ整合性(data integrity) • データセキュリティ、バックアップ手順および個人/ユーザーグループへのアクセス権限の使用を含む |
| DBMSに含まれるソフトウェアツールを実際にどのように使用するかを理解する | 以下を含む: • **開発者インターフェース(developer interface)**の使用と目的 • クエリプロセッサ(query processor) |
出典: Cambridge International シラバス
DBMS はデータベースを中央で管理する。ファイルベースの限界を克服する機能:
- データ辞書 — 各テーブル、フィールド、型、キーの説明; プログラムは構造をハードコードする代わりにこれを照会する。
- 重複/一貫性制御 — 各事実は一度だけ格納される。
- 同時アクセス制御 — ロックとトランザクションにより、多くのユーザーが同時に作業できる。
- バックアップと復旧; セキュリティおよびユーザーごとの権限。
- 整合性ルール — キー、一意制約、範囲制約などが中央で強制される。
- トランザクション — すべて成功するか、すべて失敗する操作のグループ。
- ビュー — ユーザーごとに「自分の」データのスライスを表示する仮想テーブル。
- データ管理とデータモデリング — データの格納方法を制御し、論理スキーマ(物理的な格納とは無関係な論理設計)としてその構造を定義する。
- データ整合性とデータセキュリティ — 中央で正しさを強制し、アクセスを制御する。
- クエリプロセッサがクエリを実行する; 開発者インターフェースはアプリケーション構築のためのツールとAPIを提供する。
このツールの例: データ辞書エディタ、クエリビルダー、フォームビルダー、レポート生成機、ユーザー管理、SQLエディタ。
データ辞書が保持する内容(「3つ答える」問題): テーブルの名前; 各テーブルに含まれるフィールドの名前; 各フィールドのデータ型と長さ; 主キーと外部キー、およびテーブル間の関係; 検証ルール; インデックス; どのユーザーがどのテーブルにアクセスできるか。これはメタデータ — データについてのデータ — であり、DBMS はこれを参照してすべてのクエリと変更を確認する。
DBMS がデータを保護する方法(「2つの方法を説明する」問題):認証 — アクセス前にユーザー名とパスワード、または生体情報による確認;アクセス権 — 各ユーザーまたはグループは、通常はビューを通じて、特定のテーブルやフィールドのみが読み取り、書き込み、削除可能とする;暗号化 — 格納されているデータや送信されるデータを暗号化し、コピーされたファイルが読めないようにする;バックアップ — 定期的に作成することで、損失後にデータを復元できるようにする; トランザクションログ — 誰が何を変更したかを記録する。
2つのソフトウェアツール。開発者インターフェースは、プログラマーがデータベースおよび其上のアプリケーションを構築するために使用するもの: テーブルの作成、キーと検証の設定、クエリと SQL の記述、フォームとレポートのデザインを行うが、データの物理的な格納方法を知る必要はない。クエリプロセッサはクエリ(プログラムからの SQL またはインターフェース内で構築されたクエリ)を受け取り、データ辞書に基づいて検証し、最も効率的な実行方法を決定し、データを取得して結果を返す。
論理スキーマ。 DBMSは論理的設計(どのテーブルやフィールドが存在し、それらがどのように関連しているか)と物理的格納(ファイル、インデックス、ディスクブロック)を分離して管理します。プログラムは論理スキーマで動作するため、物理的な格納を再編成してもプログラムを一度も変更することなく対応できます。これはファイルベースの手法では欠けていたデータ独立性です。
探索
データベースサービスラボ
DBMSがクエリを安全な共有データアクセスに変換する様子を見よ。
探索
データベースサービスラボ
DBMSがクエリを安全な共有データアクセスに変換する様子を見よ。
8.3
DDL と DML
シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| DBMSが**データ定義言語(Data Definition Language, DDL)**を使用してデータベース構造のすべての作成・修改を行うことを理解する | |
| DBMSがDMLを使用してデータのすべての照会と保守を行うことを理解する | |
| DDLおよびDMLの業界標準が**構造化クエリ言語(Structured Query Language, SQL)**であることを理解する | 与えられたSQLステートメントを理解する |
| 与えられた**SQL(DDL)ステートメントを理解し、簡易的なSQL(DDL)**ステートメントを記述 subset を使用して記述できる | データベースの作成(CREATE DATABASE) テーブル定義の作成(CREATE TABLE)、適切なデータ型を持つ属性の作成を含む: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME テーブル定義の変更(ALTER TABLE) テーブルへの主キーの追加(PRIMARY KEY (field)) テーブルへの外部キーの追加(FOREIGN KEY (field) REFERENCES Table (Field)) |
| (最大2つの)データベーステーブルに格納されているデータを照会または修正する**SQLスクリプト(DML)**を記述する | 以下のクエリを含む:SELECT... FROM、WHERE、ORDER BY、GROUP BY、INNER JOIN、SUM、COUNT、AVG |
| データ保守操作 including INSERT INTO、DELETE FROM、UPDATE |
出典: Cambridge International シラバス
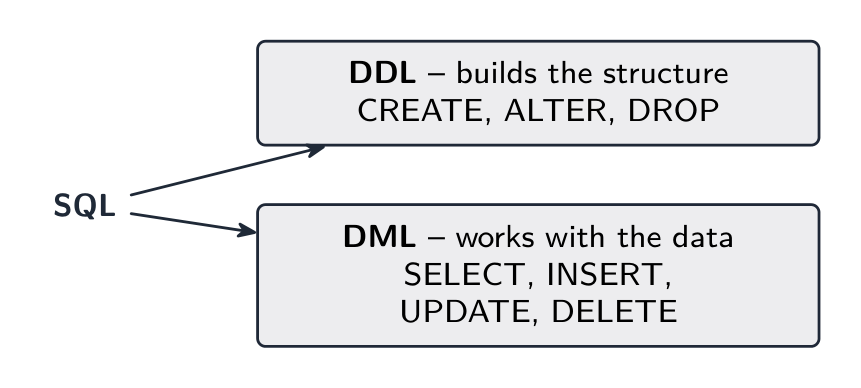
SQL (Structured Query Language) には2つの側面がある:
- データ定義言語 (DDL) — 構造(テーブル、キー、制約)を作成または変更する。
- データ操作言語 (DML) — データを操作する(挿入、更新、削除、クエリ)。
DDL 基礎
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
外部キーを追加:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
修改と削除:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
一般的な型: INTEGER, REAL, VARCHAR(n), CHAR(n) (また CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s)。
DML 基礎
SELECT を用いたクエリ:

SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT はフィールドをリストアップし、FROM はテーブル名を指定し、WHERE は行をフィルタし、ORDER BY はソートする。
ジョインは外部キー関係を使って2つのテーブルを結合する:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
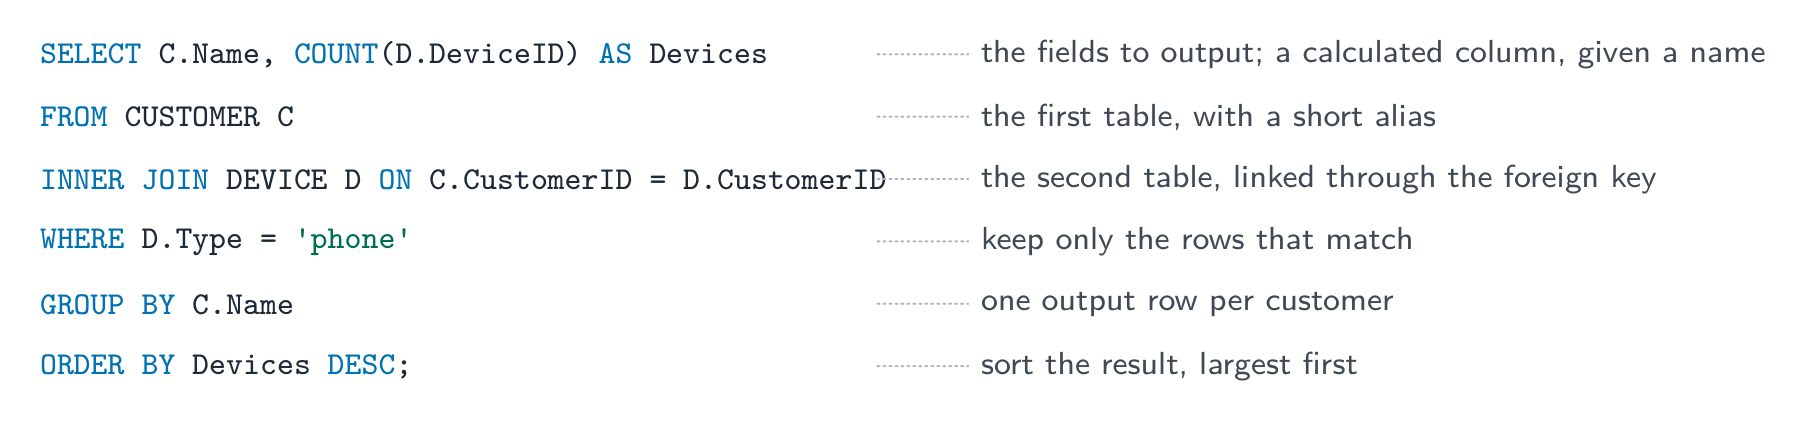
集計関数 (COUNT, SUM, AVG, MIN, MAX) は often GROUP BY と併用される:
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
挿入、更新、削除:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
UPDATE と DELETE に対して必ず WHERE 句を付ける。そうしないと変化はすべての行に影響を与える。
試験用 SQL のヒント
- 問題文にある正確なテーブル名とフィールド名を使用する。
- ストリングはシングルクォート (
'Smith') で囲み、数字は囲まない。 - 比較演算子:
=,<,>,<=,>=,<>。 LIKE 'A%'は、Aで始まる anything(任意の文字列)に一致します(%= 任意の文字列、_= 単一文字);IN (1,2,3);BETWEEN 10 AND 20。AND/OR/NOTを用いて条件を組み合わせ、各文の末尾にセミコロン ; を添えます。
試験で求められるDDLパターン。 各CREATE TABLEはフィールド名と型を指定し、主キーをマークし、参照するテーブルを含む外键を宣言します;複合キーは別行に宣言します:
CREATE TABLE RENTAL_CAR (
  RentalID INTEGER,
  CarReg VARCHAR(8),
  Days INTEGER,
  PRIMARY KEY (RentalID, CarReg),
  FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID),
  FOREIGN KEY (CarReg) REFERENCES CAR(CarReg)
);
** worked example(演習例)。** CUSTOMER(CustomerID, Name, Phone) と DEVICE(DeviceID, CustomerID, Type, Model) を用いて、SQLスクリプトを以下のように記述してください:(a) 機種が'tablet'であるすべての顧客の名前と電話番号を、名前順に並べ替えて表示;(b) 各種類のデバイスの件数をカウント;(c) カスタマーID 17の電話番号を'0771 234 5678'に更新;(d) カスタマーID 17に属する、ID 305、モデル'X1'の'laptop'一个新デバイスを追加。
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
採点は句ごとに与えられます — フィールド、テーブル、結合条件、WHERE、ORDER BY など — したがって、一つの句に誤りがあっても残りの部分には点数がつきます。二つのテーブルが関わる場合は Table.Field を書きなさい。
Worked example(演習例)。 このスクリプトが何をするかを説明しなさい:SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
これは、各テクニシャンが実施した修理の合計費用と共に、そのテクニシャンの名前を出力します(テクニシャンごとに一行)。二つのテーブルは TechnicianID で結合され、行は名前でグループ化され、各グループ内の費用が加算されます。スクリプトが何をするかを問われた場合、構文ではなく結果を説明しなさい。
SQLの条件とキー
LIKE 'Li%' は Li で始まるテキストに一致します;% は任意の文字数を表し、_ はちょうど1文字を表します。AND は両方の条件を必要とし、OR は少なくとも1つの条件を必要とします。これらを組み合わせる際は括弧を使用してください。
CREATE DATABASE Club;
CREATE TABLE Booking (
  MemberID INTEGER,
  EventID INTEGER,
  PRIMARY KEY (MemberID, EventID)
);
ALTER TABLE Booking ADD FOREIGN KEY (MemberID)
  REFERENCES Member(MemberID);
SELECT Name FROM Member
WHERE Name LIKE 'Li%' AND (Year = 12 OR Year = 13)
ORDER BY Name DESC;
合成主キーにより「ペア」が一意になり、個々の列が個別に一意になるわけではありません。外部キーは、欠落した親レコードへの非null参照を防ぎます。ON UPDATE CASCADE は親キーの変更を参照元行に引き継ぎます;ON DELETE CASCADE は親が削除される際にそれらの行を削除します。
探索
INNER JOINで2つのテーブルを接続する
結合は外鍵が主鍵と等しい行を一致させます — ここではOrders.CustomerID = Customer.CustomerID — し、一致するペアをより広い1つの行に組み合わせます。
探索
SELECT … WHERE
クエリの処理を追跡します:WHEREで条件に一致する行を抽出し、その後SELECTで指定した列を選択します。
語彙
練習する
| English | 日本語 |
|---|---|
| query/ˈkwɪərɪ/ | クエリ |
| primary key/ˈpraɪməri kiː/ | 主鍵 |
| join/dʒɔɪn/ | ジョイン |
| referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ | 参照整合性 |
| entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ | 実体関係図 |
8.3
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| エンティティ | データが格納される対象 — 人、物体、イベントなど — リレーショナルデータベースではテーブルとして表されます |
| アトリビュート | エンティティに関するデータの一つ(テーブルの列) |
| タプル | テーブルの一行:エンティティの一次元实例(instance) |
| 主キー | テーブル内の各レコードを一意に識別するアトリビュート、またはアトリビュートの組み合わせ |
| 外键 | 一方のテーブルにあるアトリビュートで、値が他方のテーブルの主キーと一致し、二つを結びつけるために使用されるもの |
| 候補キー | 主キーとして選ばれ得るいかなるアトリビュート(または組み合わせ) |
| サブキー | 非主キーアトリビュートで、インデックス付けされており、テーブル内で高速に検索やソートが可能であるもの |
| 複合キー | 二つ以上のアトリビュートを組み合わせた主キー |
| 参照整合性 | 参照先となるテーブルにおける既存の主キー値に一致する外键値のみが許容されること |
| 第1正規形 | 各属性が原子的で、重複グループがなく、主キーがある表 |
| 第2正規形 | 1NFにおいて、かつ非鍵属性が主鍵全体に依存している(部分依存がない) |
| 第3正規形 | 2NFの条件を満たし、かつ非キー属性が他の非キー属性に依存していない(伝達依存がない) |
| データ辞書 | DBMSがデータベースの構造について保持するメタデータ:テーブル、フィールド、型、キー、関係、検証ルール |
| DDL / DML | データベースの構造を定義・変更するために使われる言語 / その中のデータを照会・管理するために使われる言語 |
8.3
試験対策
- 以下の用語を正確に定義すること:エンティティ、アトリビュート、主キー、外键、および関係の種類(1:1、1:many、many:many)。
- 各正規形において理由を述べる:1NF(反復群なし)、2NF(部分依存なし)、3NF(非キー依存なし)— 関連するフィールド名も明記すること。
- DBMS が提供するものを説明すること(データ独立性、セキュリティ、整合性、同時アクセス、データ辞書、開発者向けインターフェース、クエリプロセッサ)。
- DDL(構造の定義)と DML(データの照会と変更)を区別し、SQLの句ごとに記述しなさい:
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY。 - テーブルからE-R図を描く際、まず各外键を見つける:各外键は「多数」側がそれを保持するテーブルに位置する、一つの一対多の関係に対応する。
一般的なミス
- 一対多関係を直接描く場合。両方の外键を含むリンクテーブルを介して、二つの一対多関係に分割しなければならない。
- 「データが重複している」という理由で「3NFではない」と説明する場合。どの依存(部分依存または推移依存)か、および関連するフィールドを明記すること。
- SQLでは、文字列をダブルクォートで囲むか、数字をクォートで囲む。文字列は
'single quotes'を必要とし、数字は不要である。 INNER JOINの後にON条件を省略すること。これがないと二つのテーブルは連結されない。COUNTまたはSUMに隣接する通常のフィールドを、GROUP BYを持たないSELECT内に配置すること。UPDATEまたはDELETEにWHEREを付けないこと。これによりテーブル内の全レコードが更新・削除される。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。