Ce que ce cours est, et comment l'utiliser
Voici le cinquième cours de commerce universitaire : statistiques d’entreprise. Il s’agit de transformer des données en décisions sans se tromper soi-même. Un jeu de données que chacun peut reproduire sert de fil conducteur à l’ensemble du cours : 40 délais de livraison de plats à emporter, en minutes, pour le service de Nimbus le week-end. Chaque statistique de ce document peut être recalculée à partir des données présentées à la fin.
L’habitude centrale du cours : énoncer l’affirmation, préciser l’incertitude et dire ce qui vous ferait changer d’avis. Les moyennes sont accompagnées d’erreurs types, les tests de leurs hypothèses et les corrélations d’avertissements. Chaque exemple corrigé a été vérifié par rapport aux moyenne silencieuse.
- Les unités 5.1–5.2 portent sur la collecte et la description des données : échantillonnage, biais et représentations fidèles.
- Les unités 5.3–5.5 portent sur le raisonnement face au hasard : probabilités, estimation et tests.
- Les unités 5.6–5.7 relient et décident : régression, corrélation et les limites qui séparent l’analyse de la persuasion.
Chaque unité commence par la question, puis la méthode, puis deux exemples exemples (le second étant plus difficile), erreurs courantes et court résumé.
Données et échantillonnage
Pourquoi c’est important. Chaque nombre figurant dans un rapport d’entreprise provient d’une certaine méthode de sélection des données. Avant de l’interpréter, vous devez savoir ce qui a été sélectionné, comment et qui a été omis. Sinon, l’analyse qui suit ne fait qu’habiller une supposition.
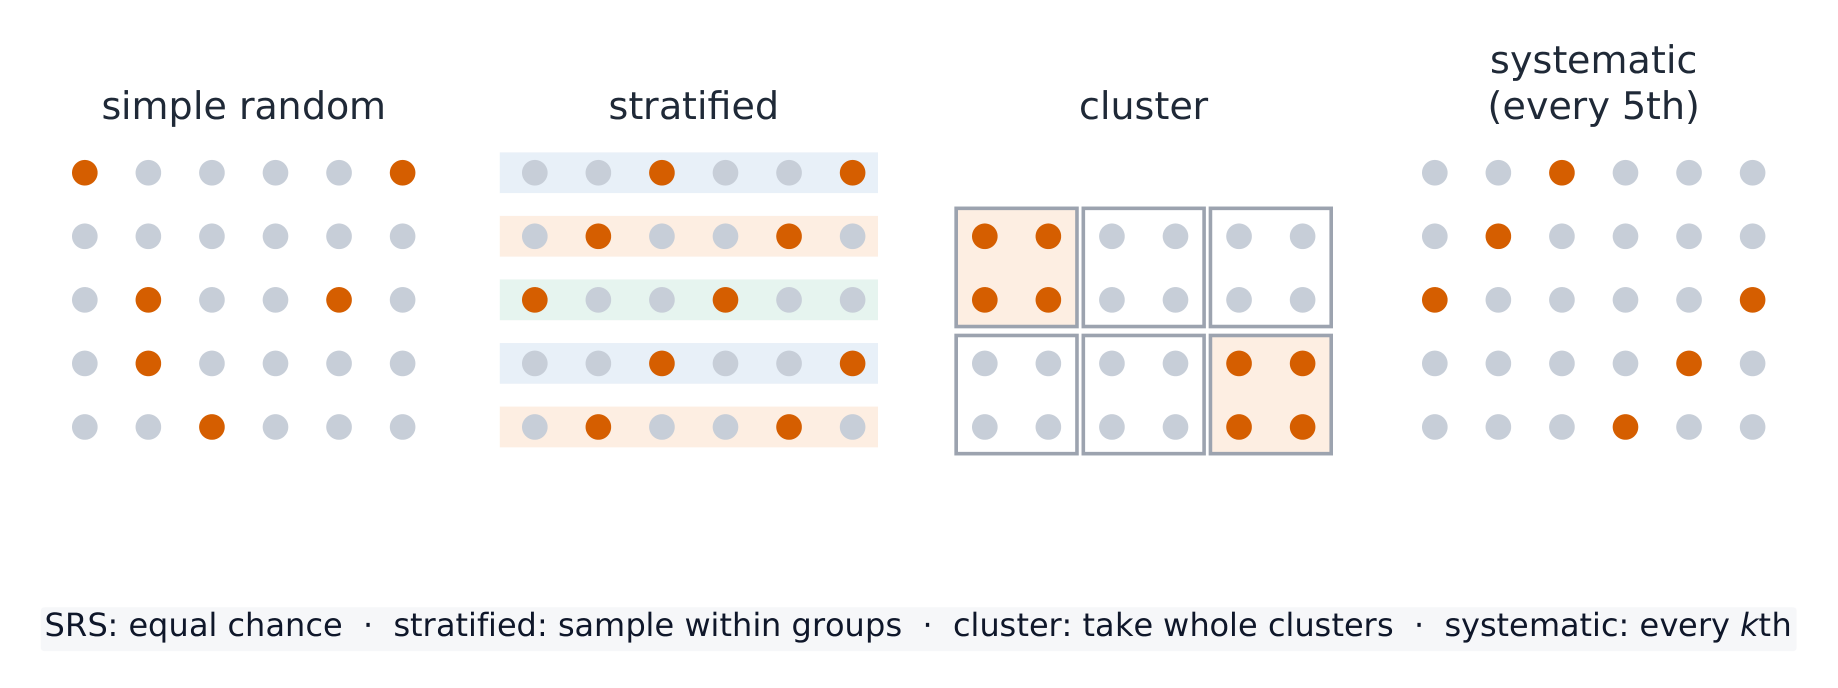
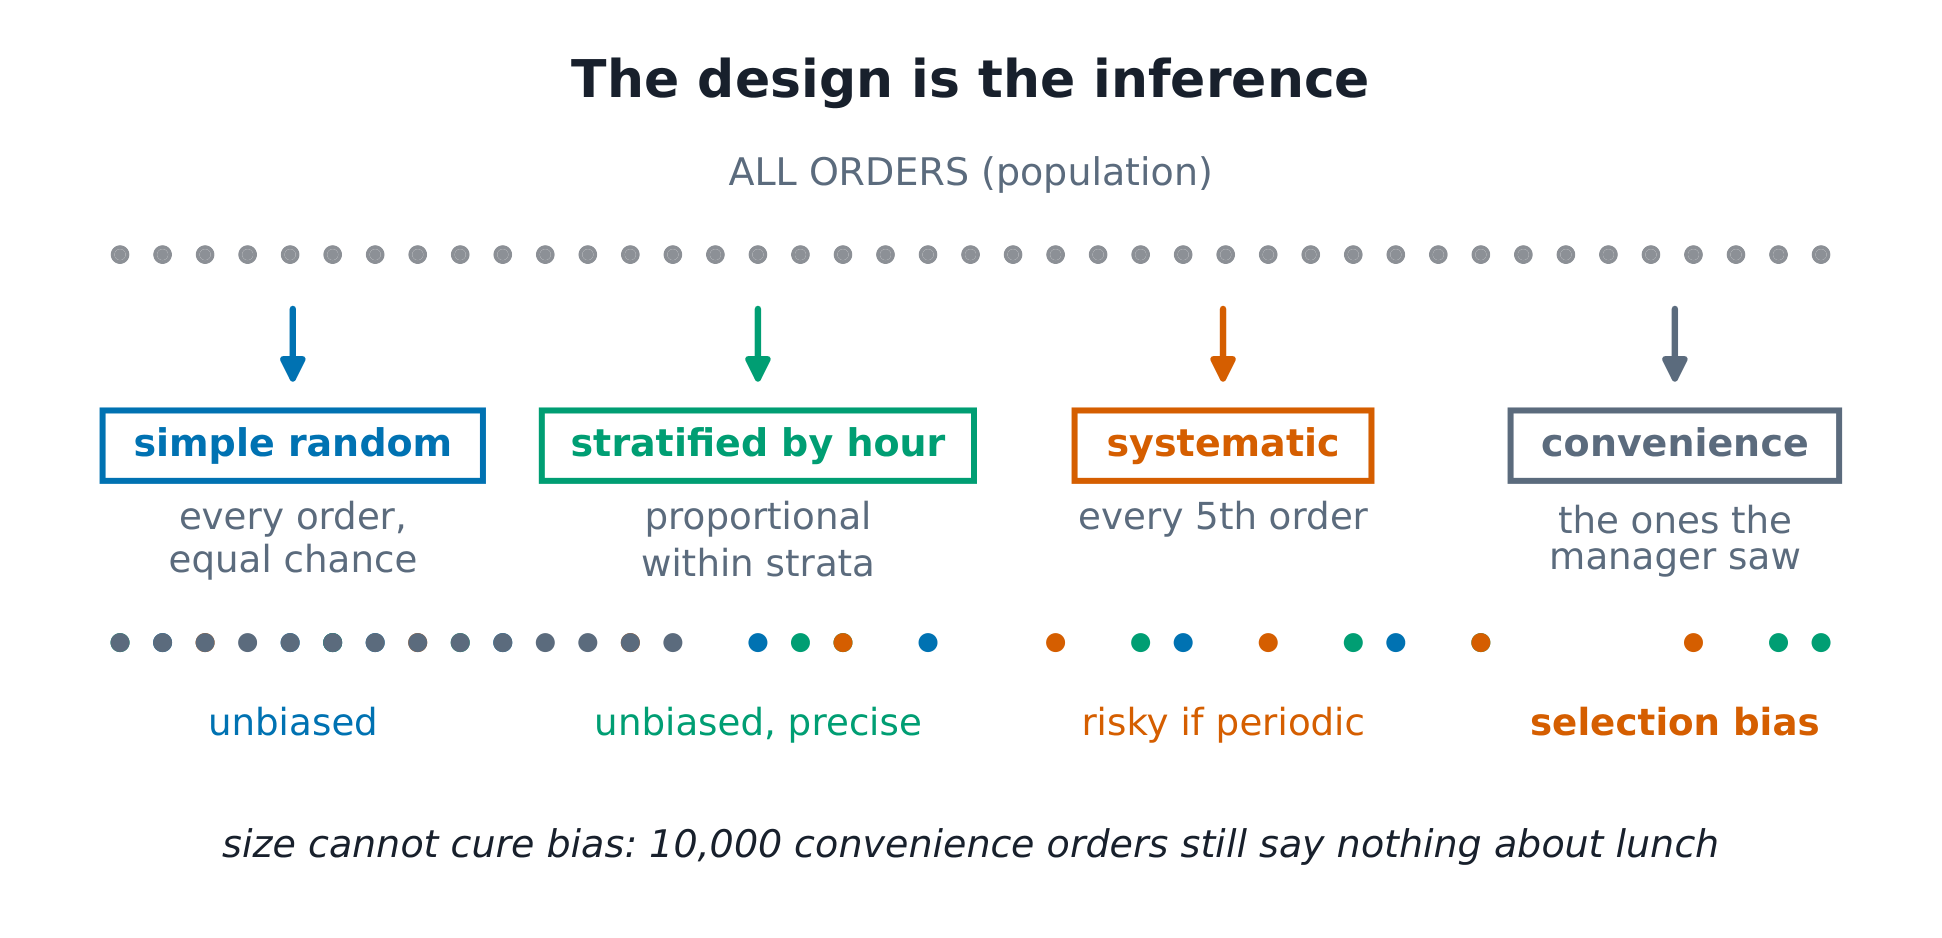
L’idée. Les 40 délais de livraison constituent un échantillon du service du week-end ; toutes les commandes d’une période constitueraient la population. La façon dont l’échantillon est choisi détermine ce qu’il peut réellement vous apprendre. Un échantillon aléatoire simple donne à chaque commande la même probabilité d’être choisie. Un échantillon de convenance (les commandes que le responsable a eu l’occasion de voir) ne le fait pas.
Les définitions.
- Les données sont quantitatives (minutes de livraison) ou catégorielles (identité du livreur).
- Les échelles de mesure sont nominale, ordinale, d’intervalle et de rapport. Les minutes sont mesurées sur une échelle de rapport : zéro signifie une absence de durée.
- Un biais est une erreur systématique causée par la conception de l’étude :
- biais de sélection : qui peut être atteint ;
- biais de non-réponse : qui répond ;
- biais du survivant : qui est encore présent.
- Un dictionnaire des données indique la signification, l’unité et le codage de chaque champ. C’est le passeport du jeu de données, et sa lecture critique constitue l’étape zéro de toute analyse.
Pourquoi la taille ne peut pas corriger un biais. Si l’échantillon est aléatoire, sa moyenne est une estimation sans biais de la moyenne de la population : en moyenne, sur de nombreux échantillons, elle atteint la valeur réelle. Si la conception est biaisée, aucune taille d’échantillon ne la corrige. Un échantillon de convenance de 10,000 commandes du soir ne dit toujours rien sur le déjeuner. Le biais est une propriété de la conception, pas de la taille.
Exemple corrigé 1 : lire le dictionnaire. Le dictionnaire du jeu de données :
| champ | type | remarques |
|---|---|---|
delivery_min |
rapport, minutes, une décimale | valeur manquante lorsque le livreur a oublié d’arrêter le chronomètre (3 cas) |
hour |
ordinal, 11–21 | |
rider_id |
nominal |
Avant de calculer une moyenne : les 3 valeurs manquantes ne correspondent pas à zéro minute et ne sont pas manquantes au hasard (les livreurs oublient plus souvent lorsqu’ils sont très occupés). La décision : indiquer la moyenne des 37 cas complets et signaler aussi les valeurs manquantes, sans jamais présenter une moyenne en passant leur absence sous silence.
Exemple corrigé 2 : adapter la conception à la question. Nimbus souhaite savoir si le service est plus lent le week-end.
- Plan A : analyser les 40 délais (tous relevés le samedi).
- Plan B : échantillonner 20 commandes du samedi et 20 commandes du mercredi, soit un échantillon stratifié, car la question compare les jours.
Le plan A répond à « comment se passe le samedi ? » ; seul le plan B répond à la question posée. Examinez le piège dans l’autre sens : échantillonner 20 + 20 puis les regrouper dans une seule moyenne donne aux deux jours le même poids, que l’activité de l’entreprise soit réellement répartie ainsi ou non. La conception doit correspondre à l’affirmation, dans les deux sens.
Erreurs fréquentes.
- Considérer un échantillon de convenance comme aléatoire parce qu’il est grand.
- Ignorer la non-réponse. Les clients qui n’ont pas répondu à l’enquête vous apprennent aussi quelque chose.
- Lire un jeu de données sans son dictionnaire. Les unités et les codes sont souvent à l’origine d’erreurs d’analyse.
Résumé. Le plan d’étude détermine ce que vous pouvez conclure. Le biais est systématique et un échantillon plus grand ne peut pas le corriger. Le dictionnaire fait partie des données.
Mesures descriptives et visualisation
Pourquoi c’est important. « Livraison moyenne : 27.4 minutes » est une phrase qui masque toute une distribution. La description n’est pas une formalité avant les « vraies » statistiques : c’est là que se trouvent la plupart des enseignements utiles à l’entreprise et que la plupart des graphiques d’entreprise induisent en erreur.
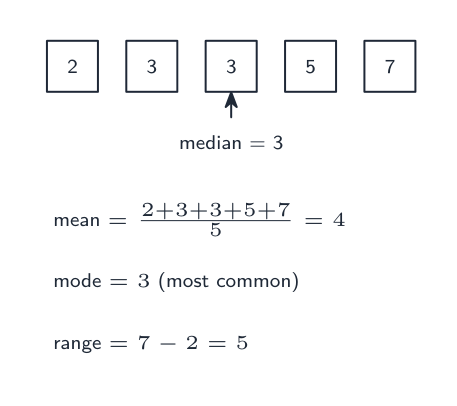
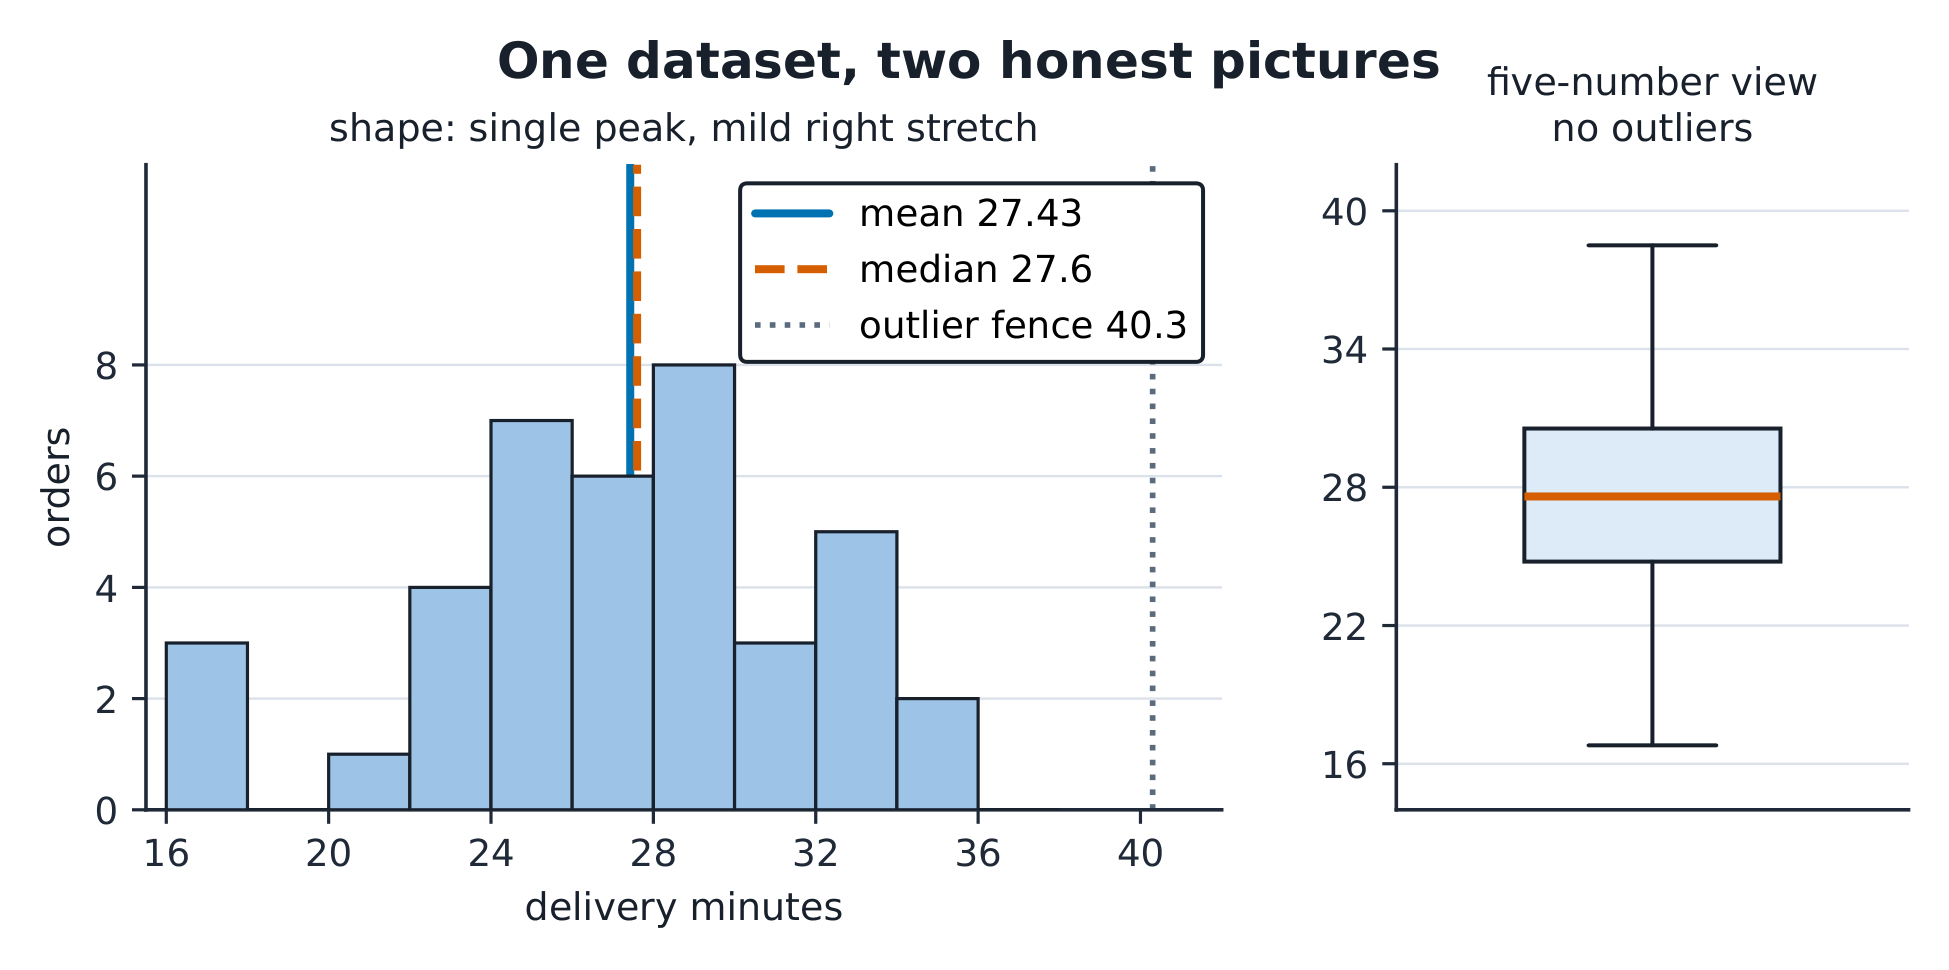
L’idée. Tout jeu de données répond à quatre questions : le centre, la dispersion, la forme et les valeurs aberrantes. Pour les 40 temps :
| mesure | valeur |
|---|---|
| moyenne | 27.43 |
| médiane | 27.6 |
| écart-type | 4.91 |
| quartiles (selon la règle $(n+1)p$) | 24.5 / 27.6 / 30.9 |
| écart interquartile | 6.3 |
L’histogramme présente un seul pic, il est approximativement symétrique et s’étire un peu vers la droite. Le temps le plus élevé, 38.5, est élevé mais reste à l’intérieur de la limite des valeurs aberrantes : Q3 + 1.5 × écart interquartile = 40.3.
Les définitions.
- Moyenne = somme ÷ $n$ ; médiane = valeur centrale dans la série ordonnée.
- Écart-type : $s = \sqrt{\sum(x_i-\bar x)^2/(n-1)}$.
- Écart interquartile = Q3 − Q1. Les valeurs aberrantes sont inférieures à Q1 − 1.5 × écart interquartile ou supérieures à Q3 + 1.5 × écart interquartile.
- Forme : symétrique, asymétrique ou présentant plusieurs pics.
La moyenne est entraînée par une longue queue ; la médiane y résiste. Pour les données asymétriques comme les revenus ou les retards, indiquez la médiane et expliquez pourquoi.
Les calculs. Pour les données, $\bar x = 1{,}097.2/40 = 27.43$. Le numérateur de la formule de l’écart-type est $\sum(x_i-\bar x)^2 = 940.3$, donc $s = \sqrt{940.3/39} = 4.91$. Pourquoi diviser par $n - 1$ ? Les écarts dans un échantillon sont liés entre eux ($\sum(x_i - \bar x) = 0$), donc diviser par $n$ sous-estime la dispersion. Un « degré de liberté » est utilisé pour estimer d’abord la moyenne.
Exemple corrigé 1 : une représentation fidèle. Une diapositive marketing présente le graphique des livraisons avec un axe des ordonnées commençant à 24 minutes. Les commandes de 17 à 23 minutes disparaissent et les différences semblent trois fois plus grandes. Redessinez-le à partir de zéro (ou avec une rupture clairement indiquée sur l’axe), et la moyenne de 27.4 apparaît dans une représentation fidèle. Tronquer l’axe est la plus vieille astuce qui soit : les nombres n’ont pas changé, mais la représentation, si.
Exemple corrigé 2 : une valeur aberrante. Ajoutez une erreur de saisie : une livraison de 168 minutes (le chronomètre ne s’est jamais arrêté). Avec 41 valeurs :
| mesure | avant | après | variation |
|---|---|---|---|
| moyenne | 27.43 | 30.86 | +3.43 |
| médiane | 27.6 | 27.7 | +0.1 |
| écart-type | 4.91 | 22.5 | environ 4.5 fois plus grand |
Une seule erreur de frappe a déplacé la moyenne de plus de 3 minutes et multiplié l’écart-type par quatre et demi, mais a à peine modifié la médiane. Vérifiez par rapport à la limite : les quartiles bougent à peine, Q3 + 1.5 × écart interquartile vaut toujours environ 40, et 168 est bien au-delà. La limite permet de repérer l’erreur, et le dictionnaire l’explique. Pour traiter les valeurs aberrantes : examinez-les, consignez vos constatations, puis décidez. Ne les supprimez jamais sans le signaler.
Erreurs fréquentes.
- Citer une moyenne pour des données asymétriques sans préciser leur asymétrie.
- Supprimer des valeurs aberrantes avant de les examiner.
- Choisir des types de graphiques parce qu’ils sont esthétiques. Un diagramme en barres représentant une seule variable continue masque tout ce qu’un histogramme montre.
Résumé. Indiquez les quatre éléments : centre (moyenne et médiane), dispersion (écart-type, écart interquartile), forme et valeurs aberrantes. Une représentation peut induire en erreur même lorsque les nombres sont exacts.
Probabilités et distributions
Pourquoi c'est important. « Quelle est la probabilité que cette commande soit en retard ? » est une question de probabilité. Deux modèles classiques, la loi binomiale et la loi normale, permettent de répondre à la plupart de ses variantes en entreprise. Il faut savoir associer la question au modèle et expliquer pourquoi.
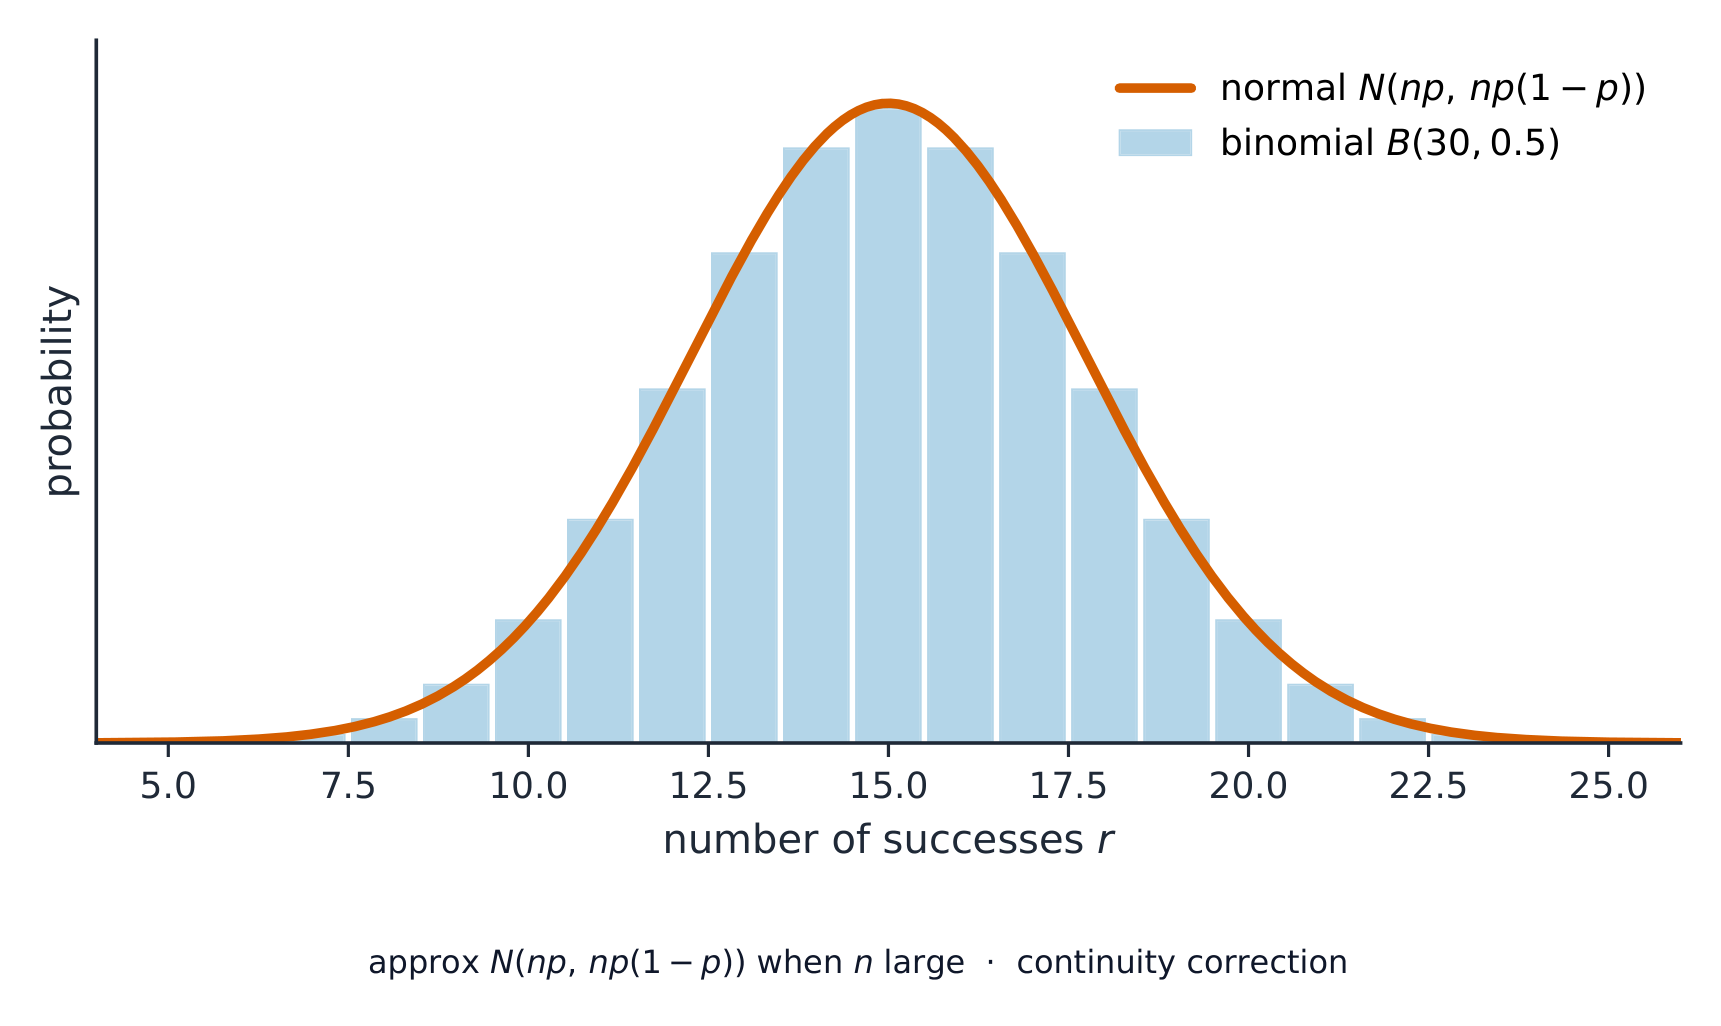
L’idée. Si 20 % des commandes sont en retard, le nombre de commandes en retard parmi les 5 suivantes suit une loi binomiale :
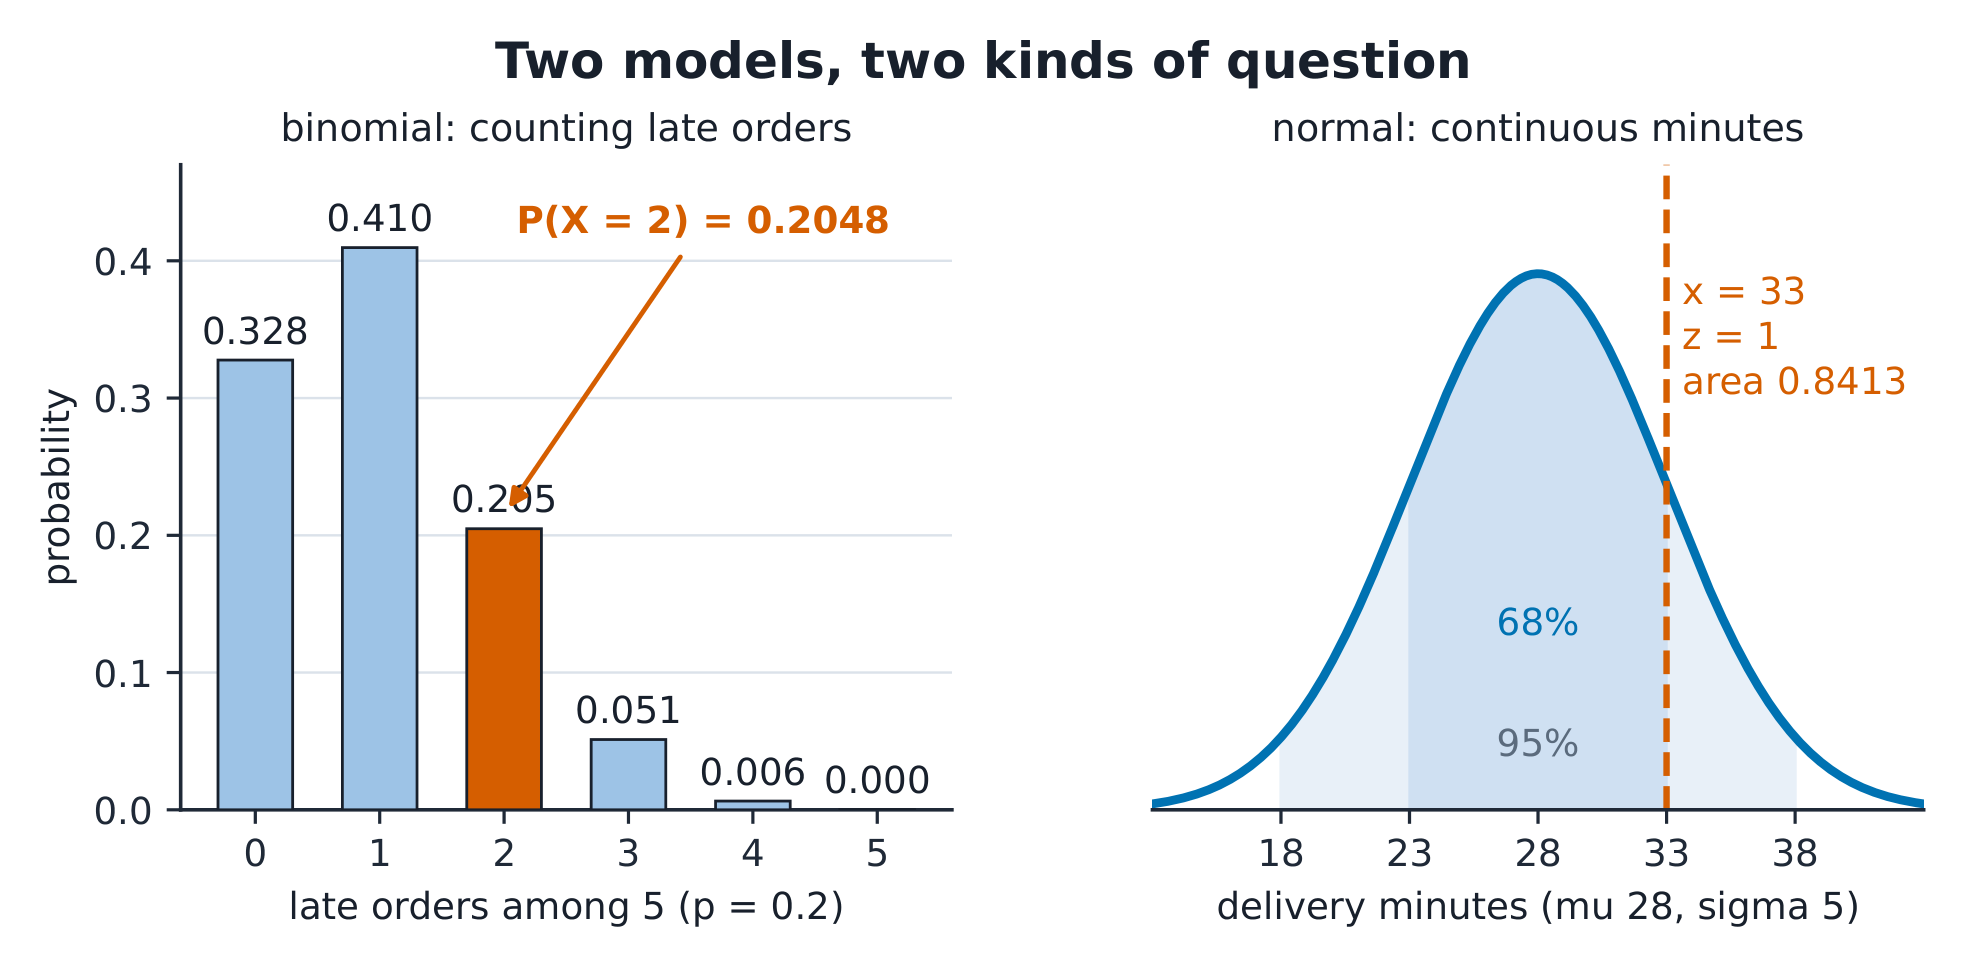
Les temps de livraison eux-mêmes se regroupent autour d’une valeur centrale, avec des queues symétriques. Ils sont modélisés par la courbe normale, où 68 %, 95 % et 99.7 % des valeurs se trouvent respectivement à moins de 1, 2 et 3 écarts-types de la moyenne.
Les définitions.
- Règle d’addition : $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.
- Indépendance : $P(A|B) = P(A)$.
- Loi binomiale : $n$ essais indépendants, chacun ayant une probabilité de succès $p$.
- Loi normale : symétrique et en forme de cloche, entièrement décrite par sa moyenne $\mu$ et son écart-type $\sigma$.
- Centrage et réduction : $z = (x - \mu)/\sigma$ transforme toute loi normale en loi normale centrée réduite.
Les calculs.
- Loi binomiale : il existe $\binom{5}{2} = 10$ façons dont 2 commandes sur 5 peuvent être en retard, chacune ayant une probabilité de $0.2^2 \times 0.8^3 = 0.02048$, donc $P(X = 2) = 0.2048$. De plus $P(X \le 1) = 0.8^5 + 5(0.2)(0.8^4) = 0.7373$.
- Loi normale : avec $\mu = 28$ et $\sigma = 5$, une commande prenant 33 minutes se situe à $z = 1$ au-dessus de la moyenne, et $\Phi(1) = 0.8413$ des commandes sont plus rapides. C’est le nombre le plus utilisé dans le tableau.
Exemple corrigé 1 : la promesse de service. Nimbus promet « 30 minutes ou votre dessert est gratuit". Sous le modèle $\mu = 28$, $\sigma = 5$ :
Ainsi, un tiers des commandes donnerait droit à un dessert gratuit. Avec une cuisine plus rapide, $\mu = 26$ : $P(X > 30) = P(z > 0.8) = 0.2119$, soit encore une sur cinq. Le coût de la promesse est une probabilité. Seule une cuisine plus rapide (un $\mu$ plus petit) modifie la queue ; un délai promis plus long ne fait que déplacer la limite.
Exemple corrigé 2 : associer le modèle à la question.
| question | modèle | réponse |
|---|---|---|
| (a) probabilité qu’au moins 4 des 20 prochaines commandes soient en retard ($p = 0.2$) | loi binomiale | $1 - P(X \le 3) = 1 - 0.4114 = 0.5886$ |
| (b) probabilité qu’une commande prenne plus de 35 minutes ($\mu = 28$, $\sigma = 5$) | loi normale | $z = 1.4$, queue $0.0808$ |
| (c) le cuisinier a vérifié au hasard 2 des 3 desserts du jour : probabilité que les deux soient les 2 desserts lents | dénombrement par combinaisons | $1/\binom{3}{2} = 1/3$ |
Un modèle incorrect reste incorrect, même si les calculs sont effectués avec assurance. La raison du choix du modèle fait partie de la réponse.
Erreurs fréquentes.
- Additionner les probabilités d’événements qui peuvent se produire ensemble sans soustraire la probabilité de leur intersection.
- Utiliser la loi normale pour des dénombrements (utilisez la loi binomiale) ou pour des données de retard asymétriques sans le préciser.
- Confondre la queue indiquée dans le tableau avec la partie centrale. Tracez toujours la courbe et coloriez la zone avant de chercher le nombre.
Résumé. Dénombrements → loi binomiale ; données continues symétriques → loi normale ; $z = (x-\mu)/\sigma$ permet de passer de l’une à l’autre. Indiquez le modèle avant de calculer.
Échantillonnage et estimation
Pourquoi c’est important. Les 40 temps constituent un échantillon. Nimbus pourrait avoir la discipline qui consiste à dire ce que LE UNIQUE nombre que vous avez dit sur la la discipline de préciser ce que le seul nombre dont on dispose dit de la vérité que l’on ne peut pas observer, en l’entourant d’un intervalle fiable.
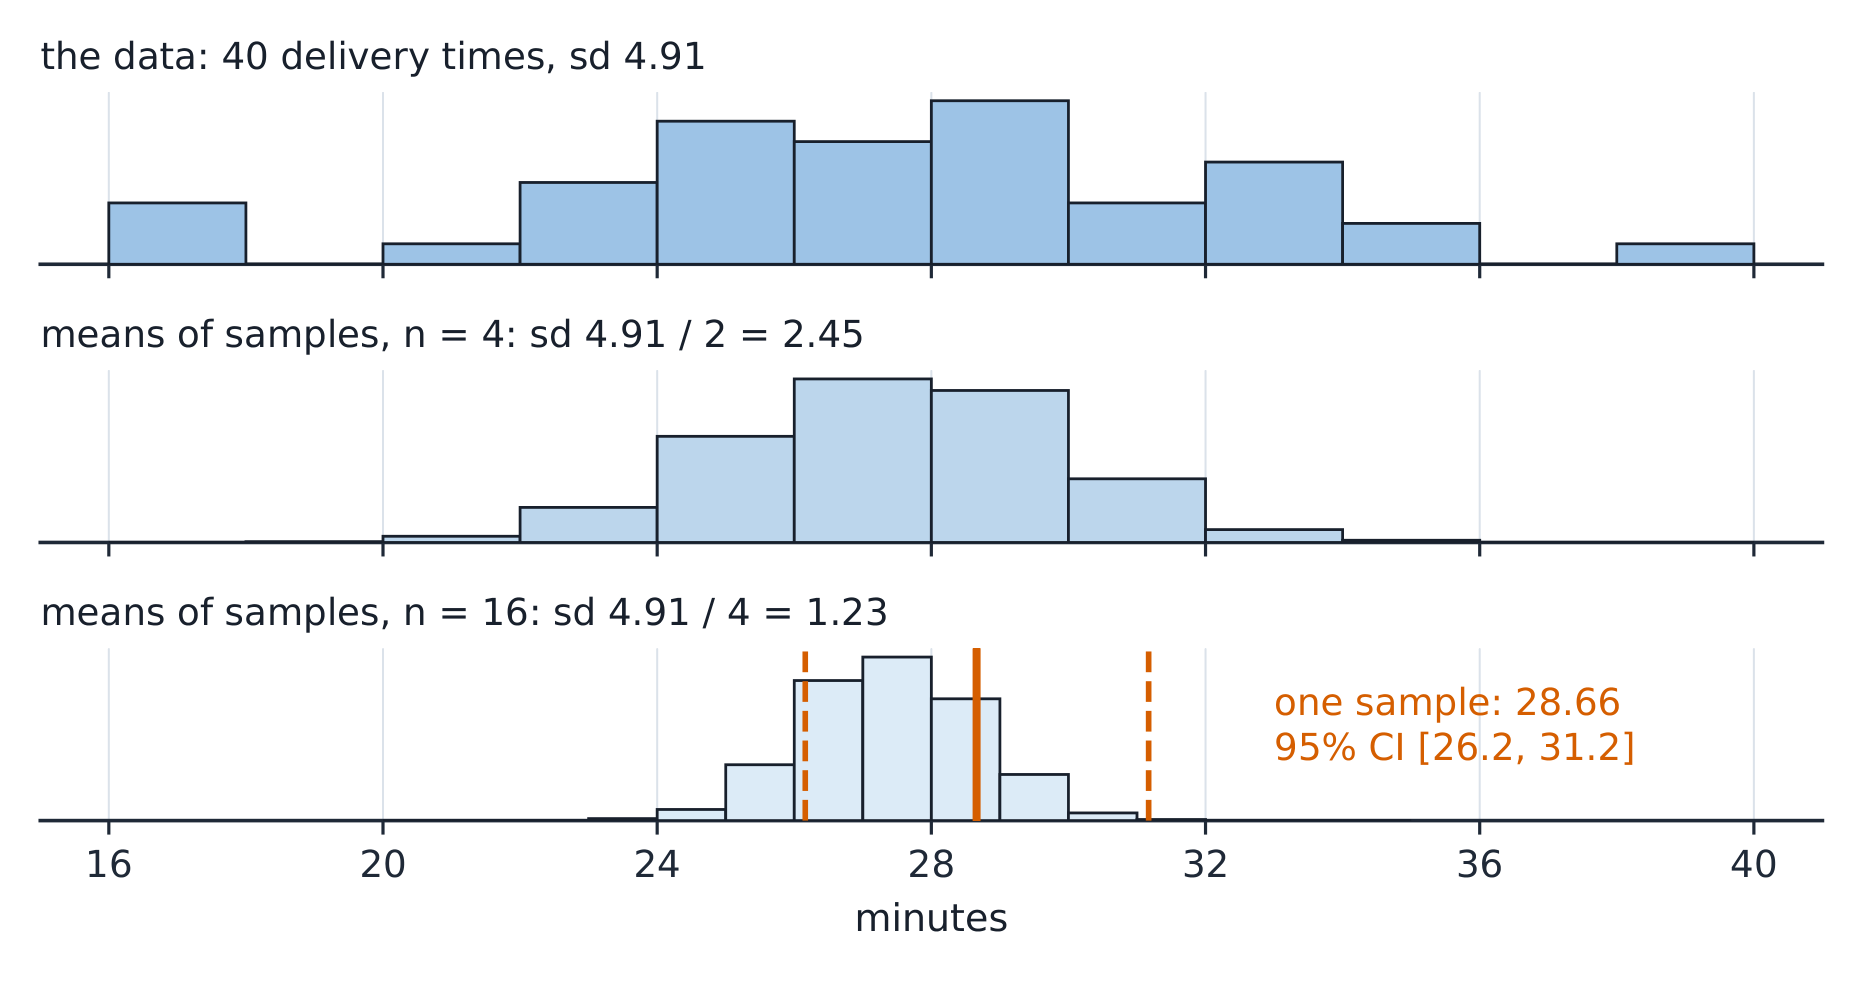
L’idée. Prenez un échantillon aléatoire de 16 commandes et calculez sa moyenne ; puis recommencez encore et encore. Les moyennes elles-mêmes forment une distribution : elle est moins étalée que les données et centrée sur la vraie moyenne. C’est le théorème central limite, et la largeur de cette distribution diminue avec $\sqrt{n}$.
Les définitions.
- L’erreur standard de la moyenne, $SE = s/\sqrt{n}$, est l’ écart-type de la moyenne de l’échantillon, et non celui des données.
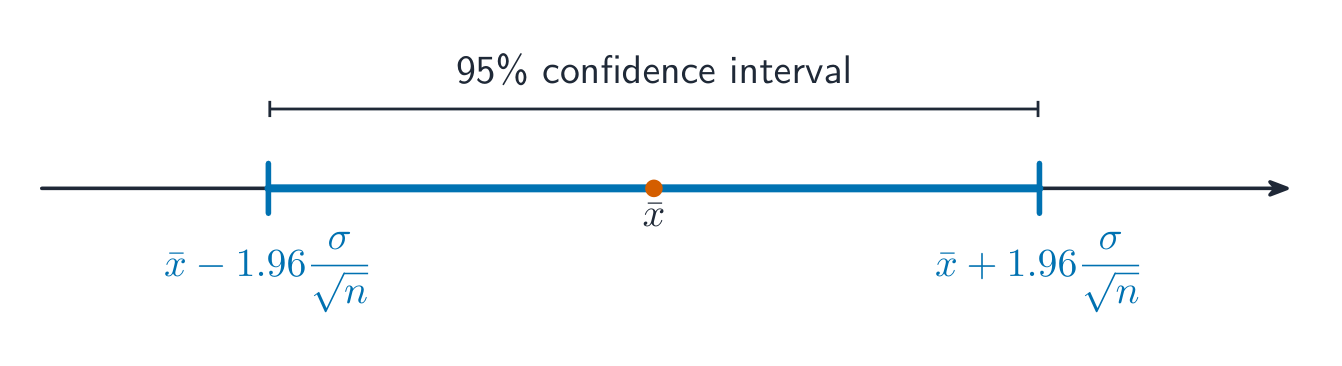
- Un intervalle de confiance à 95 % est $\bar x \pm t \times SE$.
- Le niveau de confiance décrit la méthode : 95 % des intervalles construits de cette façon contiennent la vraie moyenne. Il ne signifie pas « une probabilité de 95 % que la vraie valeur se trouve dans cet intervalle précis ».
Le calcul. L’échantillon aléatoire de 16 commandes du cours (produit avec la graine aléatoire 11) a une moyenne de 28.66 et un écart-type de 4.70, donc $SE = 4.70/\sqrt{16} = 1.175$. Avec $t_{15} = 2.131$, l’intervalle à 95 % est $28.66 \pm 2.50$, soit [26.2, 31.2]. Multipliez la taille de l’échantillon par quatre (64 commandes) et l’erreur standard est divisée par deux. La précision coûte $\sqrt{n}$ : le taux d’échange le plus coûteux en statistiques.
Exemple corrigé 1 : interpréter correctement l’intervalle. « La livraison moyenne est comprise entre 26.2 et 31.2 minutes, avec un niveau de confiance de 95 %. » Trois interprétations :
- (a) « La vraie moyenne a 95 % de chances d’être dans [26.2, 31.2]. » Faux.
- (b) « 95 % des commandes prennent de 26 à 31 minutes. » Faux : c’est le rôle d’un intervalle de prédiction, qui serait beaucoup plus large.
- (c) « La méthode qui a produit cet intervalle contient la vraie moyenne dans 95 % de ses applications. » Vrai.
L’intervalle porte sur la moyenne, et la confiance porte sur la méthode.
Exemple corrigé 2 : le prix de la précision. Le responsable veut connaître la moyenne à ±0.5 minutes près. La condition est $t \cdot s/\sqrt{n} \le 0.5$. Pour la taille d’échantillon nécessaire, $t \approx 1.97$ et non les 2.131 de $n = 16$, donc
Une précision cinq fois plus grande (de ±2.5 à ±0.5) exige plus de vingt fois plus de données (de 16 à 343). Et si ces commandes formaient un échantillon de convenance, 343 observations biaisées ne font que multiplier l’erreur par 343. La précision et l’absence de biais sont deux choses différentes qui ont chacune un coût.
Erreurs fréquentes.
- Confondre l’écart-type (dispersion des données) et l’erreur standard (incertitude sur la moyenne).
- Interpréter le niveau de confiance comme une probabilité concernant cet intervalle précis.
- Oublier que l’intervalle suppose un échantillon aléatoire. Les calculs ne peuvent pas corriger le plan d’étude.
Résumé. $SE = s/\sqrt{n}$. Le théorème central limite rend les moyennes approximativement normales. Utilisez $\bar x \pm t \cdot SE$ et interprétez la confiance comme une propriété de la méthode.
Test d'hypothèses
Pourquoi c’est important. « Le service en semaine est-il vraiment plus lent que le service le week-end ? » Un test permet de se demander formellement si les données seraient surprenantes en l’absence de tout effet. Utilisé honnêtement, il impose de la rigueur aux affirmations ; utilisé comme un rituel, il en fabrique.
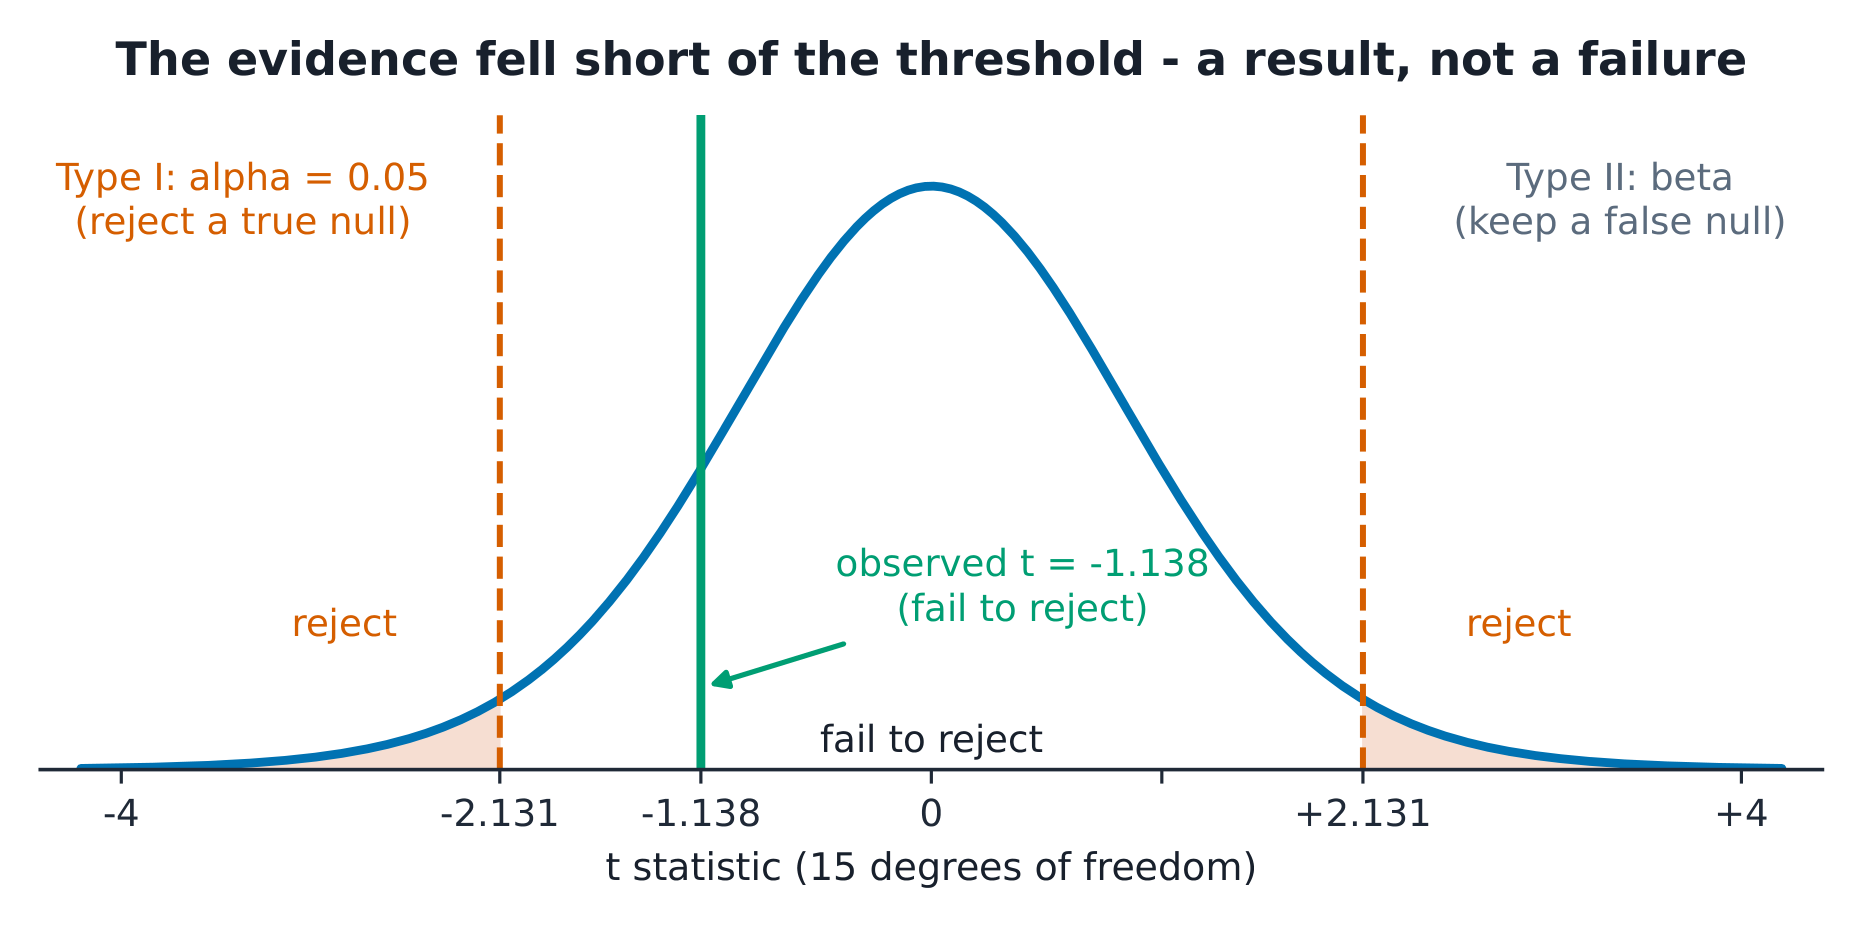
L’idée. Posez une hypothèse nulle ($H_0$ : la moyenne est 30) et une hypothèse alternative. Déterminez à quel point l’échantillon serait extrême si $H_0$ était vraie, et ne rejetez $H_0$ que s’il dépasse un seuil choisi. La valeur p p est la probabilité d’obtenir des données au moins aussi extrêmes si $H_0$ était vraie.
Les définitions. Un test d’hypothèse compare le caractère extrême des données à un seuil choisi.
- Statistique de test : $t = (\bar x - \mu_0)/(s/\sqrt n)$.
- Seuil de signification $\alpha$ : la proportion d’erreurs de type I (rejet d’une hypothèse $H_0$ vraie) que l’on choisit, généralement 0.05.
- Erreur de type II $\beta$ : ne pas détecter un effet réel. Puissance $= 1 - \beta$.
- « Statistiquement significatif » signifie seulement que $p < \alpha$.
Le calcul. La moyenne est-elle de 30 minutes ? Avec l’échantillon obtenu avec la graine 11 :
La valeur critique au seuil de $\alpha = 0.05$, pour un test bilatéral, avec 15 degrés de liberté, est $|t| > 2.131$. Puisque $1.14 < 2.131$, nous ne rejetons pas $H_0$. Les données sont compatibles avec une moyenne de 30 minutes, ainsi qu’avec de nombreuses autres valeurs. Remarquons ce que cela ne dit pas : ni « la moyenne est de 30 », ni « il n’y a pas de différence », mais seulement « cet échantillon ne serait pas surprenant si la moyenne était de 30 ».
Exemple résolu 1 : une valeur p présentée honnêtement. Un livreur affirme que son itinéraire du samedi est plus rapide. Ses 16 trajets prennent en moyenne 26.9 minutes contre 28.7 pour l’établissement, avec $s = 4.0$, donc $t = (26.9 - 28.7)/(4.0/4) = -1.8$, et $p \approx 0.09$. « Presque significatif » n’est pas une catégorie : indiquez $p = 0.09$ et tenez compte du coût d’une erreur dans la décision. Si seuls des desserts gratuits dépendent de la réponse, $\alpha = 0.10$ pourrait convenir ; si la formation du personnel en dépend, utilisez 0.05 ou 0.01. $\alpha$ est un choix commercial portant un nom grec.
Exemple résolu 2 : significatif ne veut pas dire important.
- Avec 4,000 commandes dans chacun des deux groupes, une différence de 0.4 minutes donne $SE = 5\sqrt{2/4000} \approx 0.11$, donc $z \approx 3.6$ et $p < 0.01$. La différence est statistiquement significative, mais aucun client ne remarque 24 secondes.
- Avec 8 commandes dans chaque groupe, une différence de 3 minutes donne $SE = 5\sqrt{2/8} = 2.5$, donc $t = 1.2$ et $p \approx 0.25$. Le test ne peut pas la détecter, mais tous les clients la remarqueraient.
La solution consiste à indiquer la taille de l’effet avec son intervalle : « 0.4 minutes, IC à 95 % [0.2, 0.6] : significatif, mais négligeable ». La significativité répond à la question « l’effet existe-t-il ? » ; la taille de l’effet répond à « est-il important ? ». Une entreprise a besoin de la seconde réponse.
Erreurs fréquentes.
- « Accepter » l’hypothèse nulle. On ne la rejette pas : l’absence de preuve d’un effet ne prouve pas l’absence d’effet.
- Penser que $p$ est la probabilité que l’hypothèse soit vraie.
- Manipulation des valeurs p : répéter les tests jusqu’à ce qu’un résultat franchisse 0.05. L’unité 5.7 examine ce problème.
Résumé. $t = (\bar x - \mu_0)/SE$. Rejetez l’hypothèse au-delà d’un seuil choisi selon la marge d’erreur que vous acceptez. $p$ concerne les données, pas l’hypothèse. Significatif ne veut pas dire important : indiquez toujours la taille de l’effet.
Régression et corrélation
Pourquoi est-ce important ? « Les livraisons plus longues correspondent-elles à des adresses plus éloignées ? » La régression transforme des paires de nombres en une droite, mesure à quel point ils évoluent ensemble et, si l’on manque de prudence, suggère une cause. Cette unité ajuste la droite, interprète ce qu’elle ne décrit pas et encadre les affirmations sur les causes.
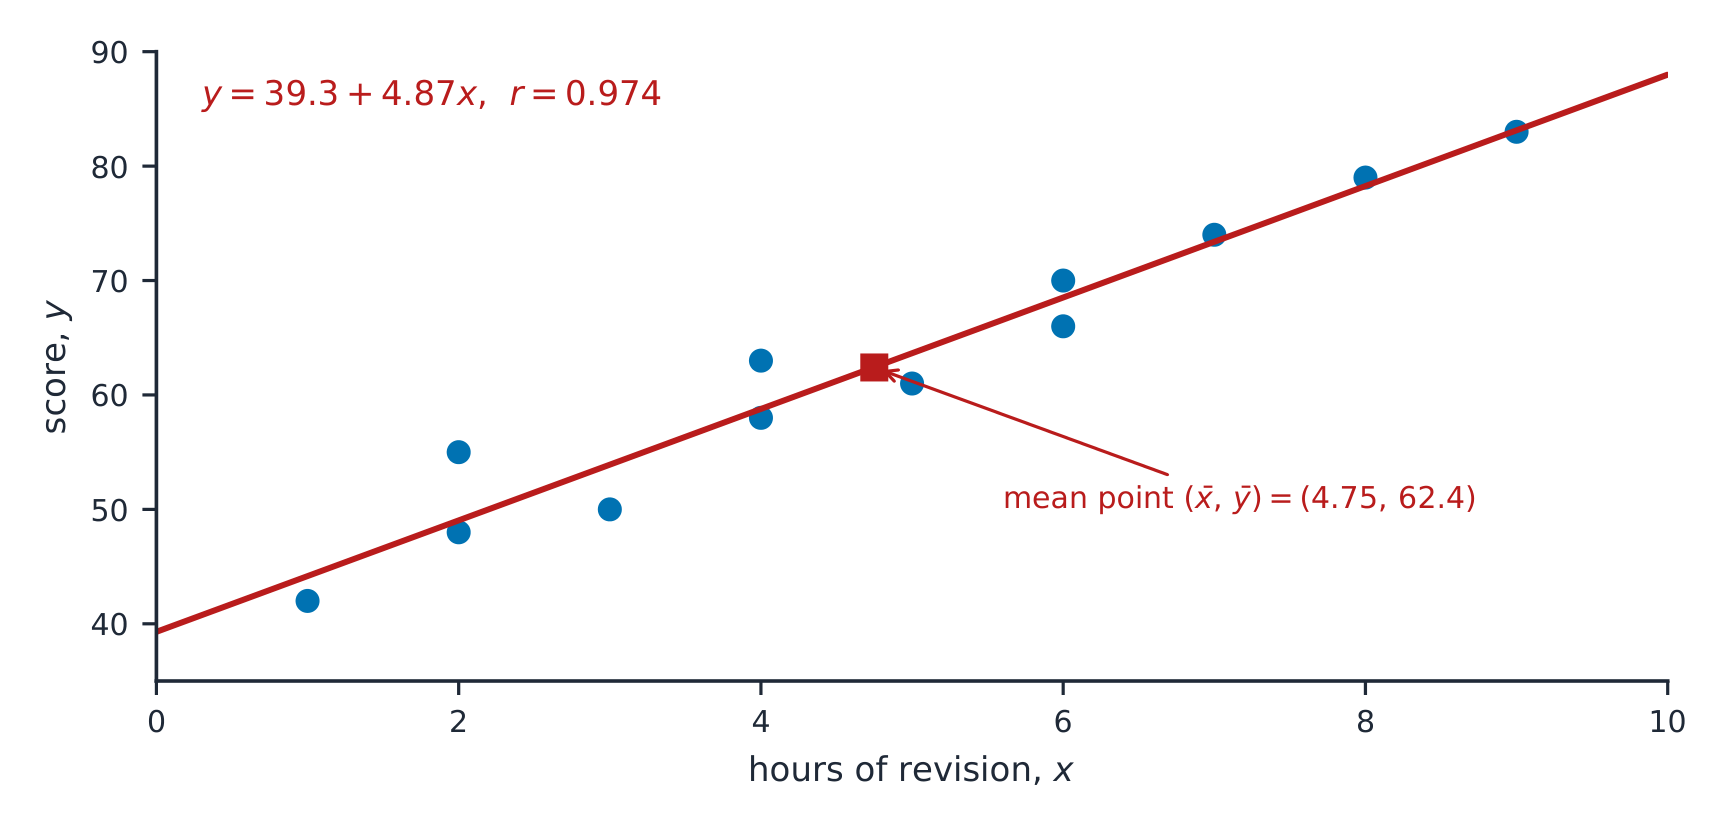
L’idée. Le suivi de douze livraisons fournit la distance (1.0–3.75 km) et le temps. Le nuage est resserré et monte vers la droite. La droite des moindres carrés est
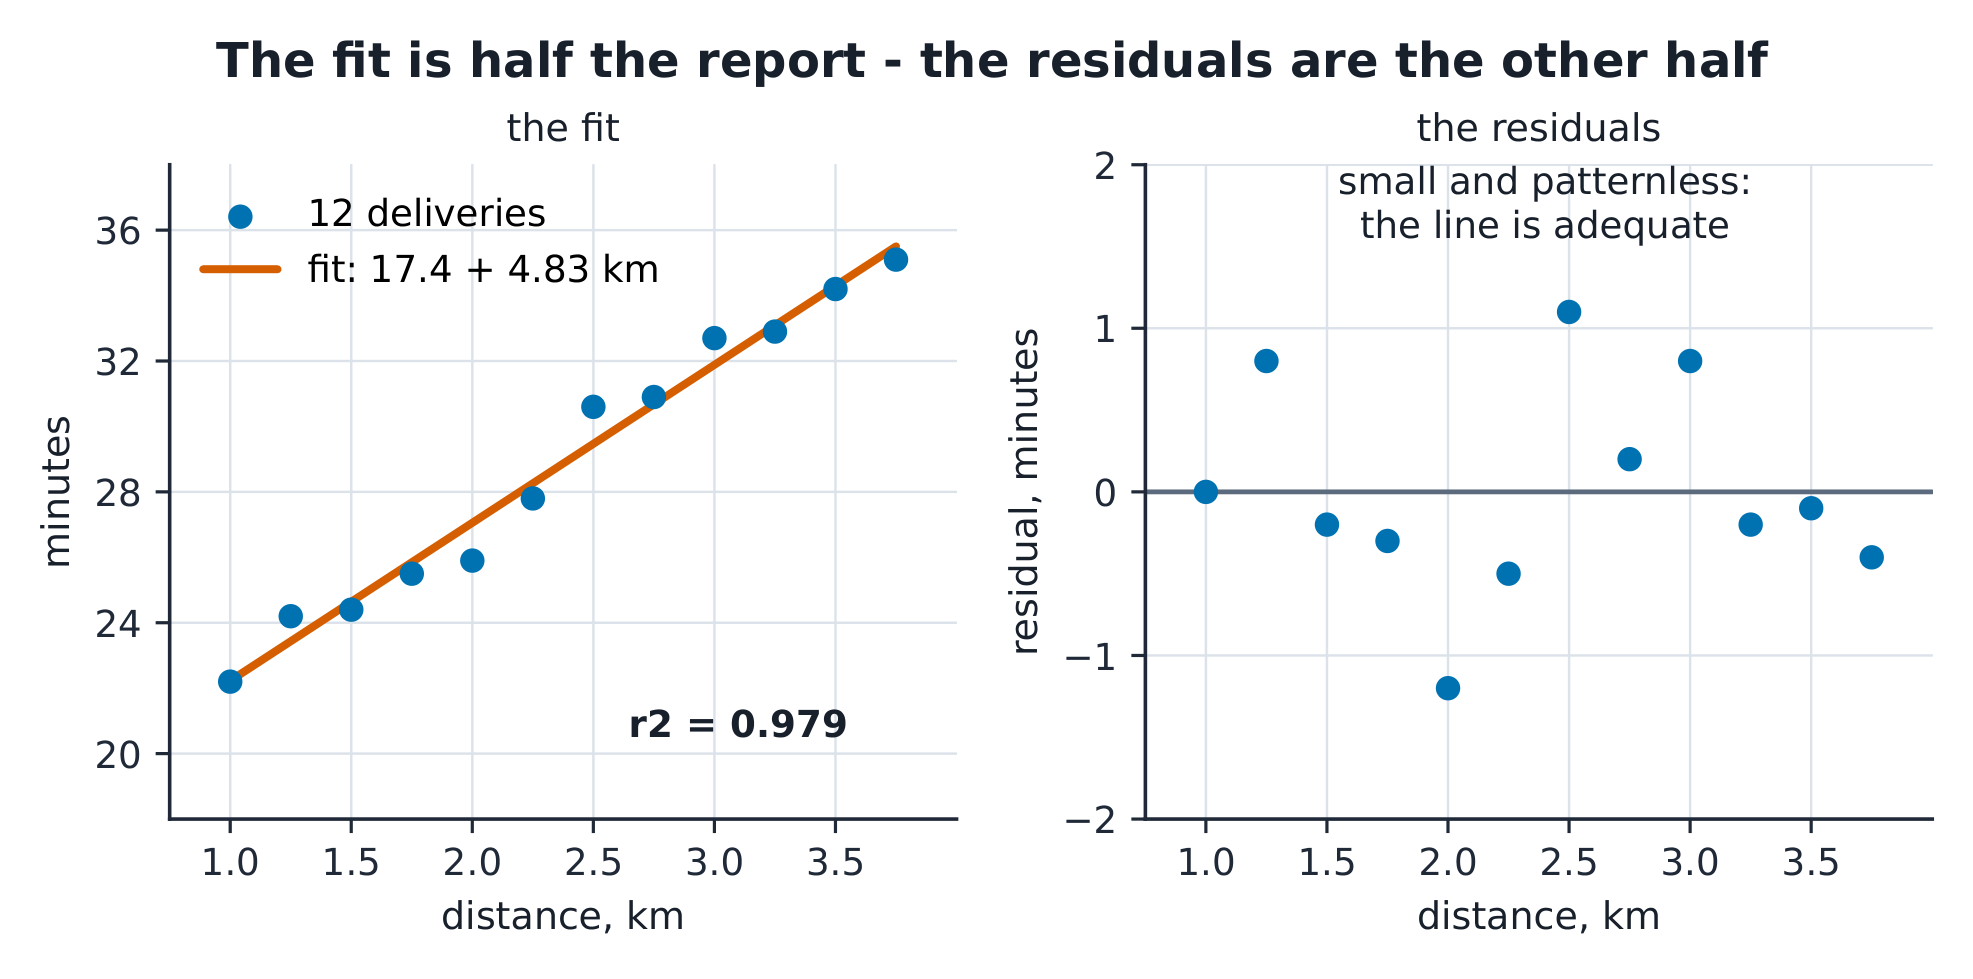
donc chaque kilomètre supplémentaire ajoute 4.83 minutes. La corrélation est $r = 0.989$, et $r^2 = 0.979$ : 97.9 % de la variation du temps est associée à la distance.
Les définitions.
- Pente : la variation de $\hat y$ pour chaque unité supplémentaire de $x$.
- Ordonnée à l’origine : $\hat y$ lorsque $x = 0$ (souvent sans signification : 0 km ne correspond pas à une livraison).
- Résidu : $y - \hat y$, la partie que la droite ne décrit pas.
- $r^2$ : la part de la variation de $y$ expliquée par la droite.
- L’extrapolation au-delà de l’étendue des données relève de la fiction.
Comment trouver la droite. La méthode des moindres carrés minimise $\sum(y_i - a - bx_i)^2$, ce qui donne $b = r \, s_y/s_x$ et $a = \bar y - b\bar x$. Pour les 12 livraisons, $b = 4.83$ et $a = 17.4$. Les résidus vont de −1.2 à +1.1 minutes sans tendance particulière, donc une droite convient bien ici, comme le montre le graphique des résidus.
Exemple résolu 1 : interpréter l’ajustement.
- Le temps prévu pour une livraison de 2 km est de $17.4 + 9.7 = 27.1$ minutes ; pour une livraison de 3 km, il est de 31.9 minutes.
- L’ordonnée à l’origine, 17.4 minutes pour 0 km, peut être interprétée comme le temps en cuisine et le temps de remise de la commande. Cette interprétation n’a de sens ici que parce qu’il existe une raison réelle de s’attendre à un temps de préparation fixe. Énoncez de telles interprétations ; ne les supposez pas acquises.
- Une prévision pour 7 km (51 minutes) est une extrapolation : aucune donnée au-delà de 3.75 km ne confirme la validité de la droite à cette distance.
Exemple résolu 2 : corrélation ne signifie pas causalité. Une corrélation de 0.989 est aussi forte que celles que l’on peut trouver dans des données commerciales, mais elle ne prouve toujours rien sur la cause. D’autres facteurs pourraient intervenir : la distance et le temps augmentent tous deux avec la circulation, et la manière dont les commandes sont attribuées (les livreurs prennent les commandes éloignées aux heures creuses) pourrait faire évoluer la distance et le temps ensemble sans que la distance détermine le temps au rythme donné par la droite ajustée. La formulation honnête est : « La distance prédit le temps dans cet échantillon ($r^2 = 0.98$) ; pour établir un taux causal, il faudrait maintenir constante l’attribution des itinéraires. » La corrélation décrit comment deux variables ont évolué ensemble dans ce jeu de données ; la causalité est une affirmation sur ce qui changerait à la suite d’une intervention. Ces différentes affirmations exigent des preuves différentes.
Erreurs fréquentes.
- Interpréter $r^2 = 0.98$ comme « des prévisions exactes à 98 % ».
- Interpréter l’ordonnée à l’origine lorsque $x = 0$ n’a pas de sens.
- Extrapoler au-delà des données.
- L’erreur classique : conclure à une causalité à partir d’une corrélation, sans mécanisme, sans expérience et sans prudence.
Résumé. $\hat y = a + bx$ par la méthode des moindres carrés. Vérifiez les résidus ; ne les supposez pas conformes. $r^2$ mesure l’association ; seul le protocole d’une étude peut établir la causalité.
Limites des décisions
Pourquoi c'est important. Tout ce qui précède dans cette unité peut être fait correctement et néanmoins parvenir à une conclusion fausse : en posant de nombreuses questions, en s’arrêtant quand cela vous arrange ou en affirmant une certitude qui n’a jamais existé. Cette dernière unité est la liste de vérification qui permet aux statistiques de rester une discipline plutôt qu’un moyen de persuader.
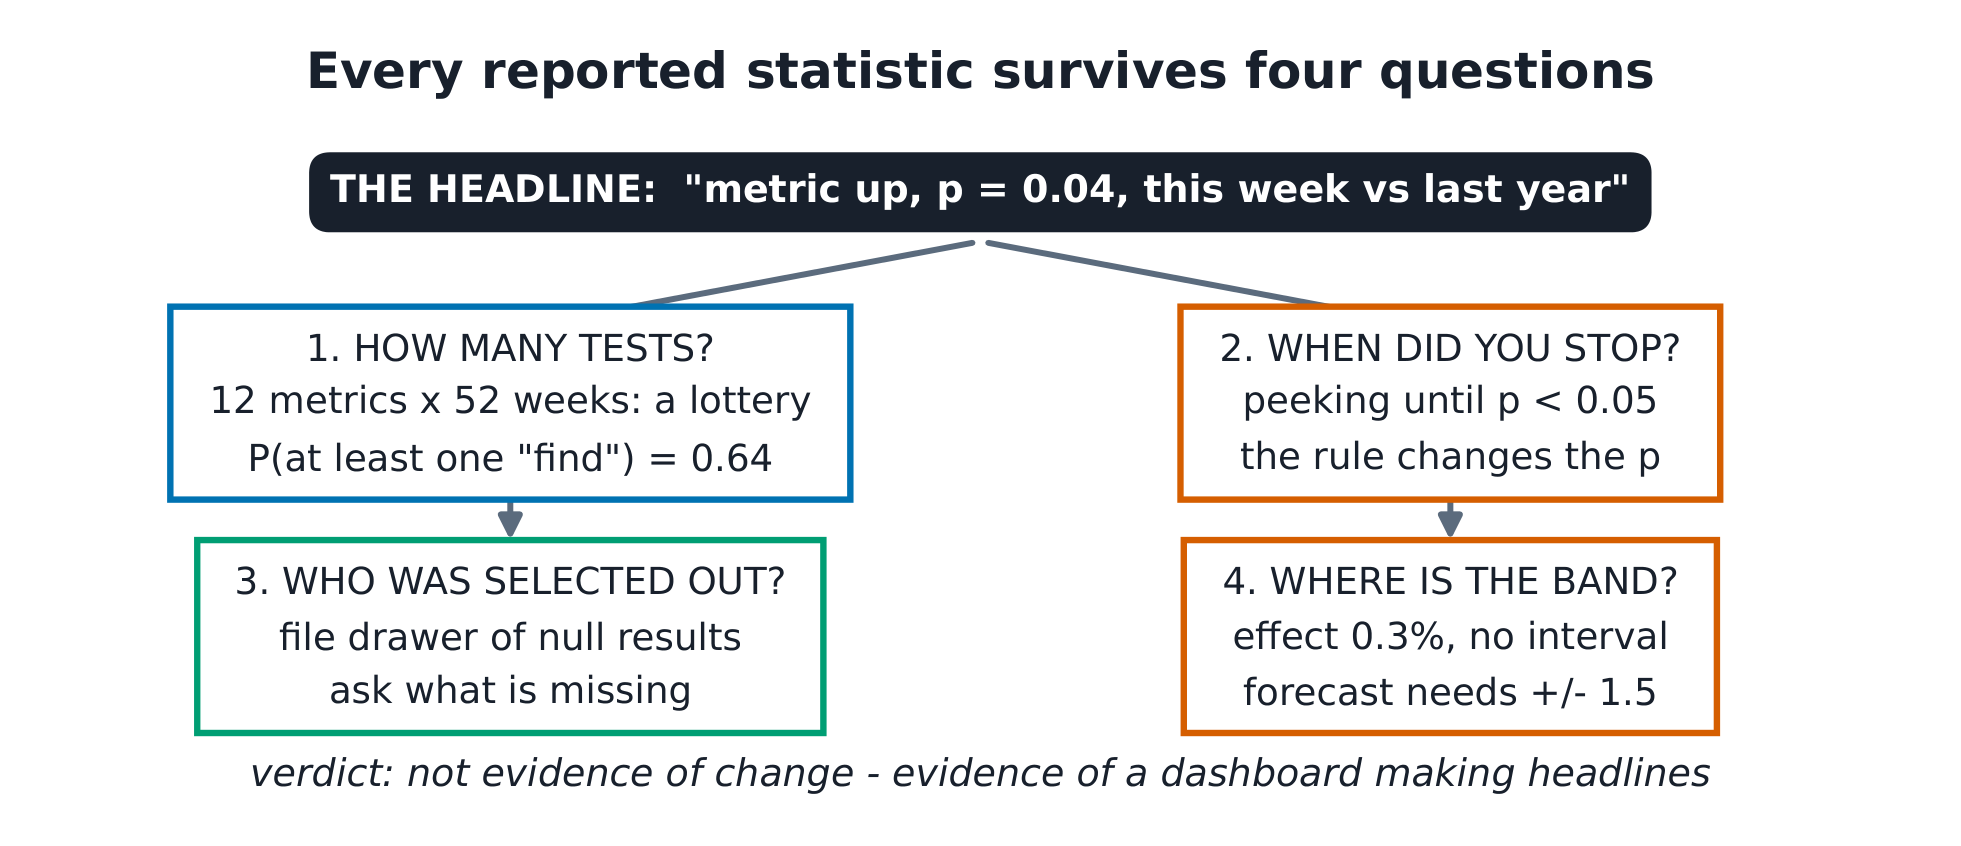
L’idée. Les pièges :
- tests multiples : 20 questions au seuil de $\alpha = 0.05$ produiront par construction des résultats « significatifs » dus au hasard ;
- règles d’arrêt : examiner les données encore et encore, puis s’arrêter dès que $p < 0.05$ ;
- choix des résultats : ne rapporter que la seule mesure qui a varié ;
- fausse certitude : présenter les prévisions sous forme de valeurs uniques, sans intervalles.
Les définitions.
- Manipulation des valeurs p : essayer de nombreuses versions d’une analyse jusqu’à ce que l’une franchisse le seuil.
- Formulation a posteriori d’une hypothèse : inventer l’hypothèse après avoir vu les résultats.
- Biais de publication ou de sélection : le tiroir rempli de résultats sans effet que personne ne vous montre.
- Une prévision sans intervalle n’est qu’une impression.
Le calcul des tests multiples. Avec 20 tests indépendants au seuil de $\alpha = 0.05$:
Un résultat dû au hasard est donc probable : ce n’est pas une découverte. La règle de Bonferroni : pour 20 tests avec un $\alpha$ global de 0.05, chaque test nécessite $p < 0.05/20 = 0.0025$. L’exemple de l’unité 5.5 peut maintenant être interprété des deux façons : $p = 0.09$ n’est pas significatif, et c’est aussi l’un des rares tests qui ont été rapportés. Le nombre de tests non rapportés contribue à déterminer le sens d’une valeur p.
Exemple résolu 1 : examiner un tableau de bord. Un tableau de bord suit 12 mesures chaque semaine. Cette semaine, l’une d’elles indique $p = 0.04$ par rapport à l’année dernière.
- Combien de comparaisons ? 12 mesures × 52 semaines : cette « découverte » provient d’une loterie comportant des centaines de billets.
- Cela a-t-il été déclaré à l’avance ? Non.
- La taille de l’effet est-elle importante ? Elle est de 0.3 %.
Verdict : ce n’est pas une preuve de changement ; c’est la preuve que les tableaux de bord peuvent produire des titres accrocheurs. La bonne réponse consiste à effectuer un test de confirmation, planifié à l’avance, sur de nouvelles données.
Exemple résolu 2 : une prévision présentée honnêtement. Le responsable prévoit : « moyenne des livraisons samedi prochain : 27.4 minutes ». La réponse du jeu de données : la moyenne d’un nouveau samedi comptant 40 commandes a $SE \approx 4.91/\sqrt{40} = 0.78$, et le 27.4 à partir duquel elle est prévue comporte à nouveau la même erreur. L’erreur de prévision est donc
et la prévision devrait être formulée ainsi : « 27.4 ± 2.2, avec un niveau de confiance de 95 % ». Même dans ce cas, la moyenne d’un samedi donné se situera hors de cet intervalle environ une fois sur vingt. Conséquence pour les décisions : prévoyez les effectifs en fonction de la limite supérieure de l’intervalle (29.6), et non de la valeur unique. Un nombre sans son incertitude ne permet pas de gérer la situation ; on ne peut qu’espérer qu’il se réalise.
Erreurs fréquentes.
- Considérer un résultat significatif parmi de nombreux tests comme une découverte.
- Penser que « nous n’avons pas rejeté » signifie « nous avons prouvé l’hypothèse nulle », l’inverse du piège présenté dans l’unité 5.5.
- Demander aux prévisions une certitude au lieu de demander l’intervalle.
Résumé. Comptez les tests, déclarez les règles à l’avance, montrez ce qui a été omis et donnez un intervalle pour chaque prévision. Les statistiques gagnent le droit de guider les décisions en reconnaissant ce qu’elles ne savent pas.
Le jeu de données (reproductible)
40 temps de livraison de plats à emporter, en minutes, à une décimale, classés :
16.8, 17.2, 17.3, 21.1, 22.8, 22.9, 23.0, 23.0, 24.3, 24.4, 24.9, 25.2, 25.2, 25.2, 25.5, 26.0, 26.1, 26.9, 27.4, 27.5, 27.7, 28.2, 28.4, 28.7, 28.7, 28.9, 28.9, 29.2, 29.3, 30.4, 31.0, 31.4, 32.2, 32.5, 33.2, 33.3, 33.7, 34.8, 35.5, 38.5
Statistiques vérifiées : $n$ = 40 ; somme 1,097.2 ; moyenne 27.43 ; médiane 27.6 ; écart-type 4.91 ; quartiles (selon la règle $(n+1)p$) 24.5 / 27.6 / 30.9 ; écart interquartile 6.3 ; aucun point au-delà des bornes à 1.5 × l’écart interquartile (15.0 et 40.3). L’échantillon d’estimation (graine 11, $n$ = 16) : moyenne 28.66, écart-type 4.70, erreur standard 1.175, IC à 95 % [26.2, 31.2], $t$ par rapport à 30 = −1.14. Les paires de régression (12 livraisons, km en fonction des minutes) : pente 4.83, ordonnée à l’origine 17.4, $r$ = 0.989, $r^2$ = 0.979. Tous les chiffres de ce document peuvent être recalculés à partir de ces valeurs.