| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer la compréhension des ordinateurs à jeu d'instructions réduit (RISC) et des ordinateurs à jeu d'instructions complexe (CISC) | Différences entre RISC et CISC Comprendre la gestion des interruptions sur les processeurs CISC et RISC |
| Montrer la compréhension de l'importance/usage du pipelining et des registres dans les processeurs RISC | |
| Montrer la compréhension des quatre architectures informatiques de base | SISD, SIMD, MISD, MIMD |
| Montrer la compréhension des caractéristiques des ordinateurs parallèles massifs | |
| Montrer la compréhension du concept de machine virtuelle | Donner des exemples du rôle des machines virtuelles Comprendre les avantages et limites des machines virtuelles |
Matériel et machines virtuelles
Informatique A-Level · Sujet 15
 15:02
RISC, Pipelines & Logique
Deux concepteurs de puces font face au même problème : faire exécuter les programmes rapidement. L'un dit — construisez des instructions puissantes, afin que chacune fasse beaucoup de travail. L'autre dit — gardez…
Narration en anglais · Sous-titres anglais + 中文 incrustés
15.1
Processeurs RISC vs CISC

Programme
Source : Programme Cambridge International
Deux styles de conception de CPU. Le CPU se branche directement sur la carte mère 主板, la carte principale reliant le processeur, la mémoire et toutes les autres parties de l'ordinateur.

CISC
Un CISC 复杂指令集 (Complex Instruction Set Computers) possède de nombreuses instructions souvent complexes (une instruction peut effectuer plusieurs accès mémoire et opérations), de longueur variable, ce qui rend le décodage complexe. Il effectue davantage par instruction en matériel. Exemples : Intel x86.
RISC
Un RISC 精简指令集 (Reduced Instruction Set Computers) possède un petit ensemble d'instructions simples, chacune effectuant une opération de base, toutes de longueur fixe (décodage rapide). Seules les instructions load et store accèdent à la mémoire ; tout le reste est de register 寄存器 à register. Les programmes sont plus longs mais chaque instruction est rapide et prévisible, ce qui convient au pipelinage. Exemples : ARM, RISC-V.
| Fonctionnalité | CISC | RISC |
|---|---|---|
| Jeu d'instructions | nombreux | peu |
| Longueur des instructions | variable | fixe |
| Accès mémoire | nombreuses instructions | seulement load/store |
| Amenable au pipeline | difficile | naturellement |
| Cycles par instruction | variable | généralement 1 |
Le compromis consiste à faire plus par instruction (CISC) contre exécuter chaque instruction plus vite et de manière prévisible (RISC). Les puces Intel modernes traduisent les instructions CISC en micro-opérations RISC simplifiées en interne.
"Identifiez quatre caractéristiques d'un processeur RISC." N'importe lesquelles de quatre : un petit jeu d'instructions simples ; des instructions de longueur fixe (un mot) ; la plupart des instructions s'achèvent en un cycle d'horloge ; beaucoup de registres à usage général ; seules les instructions load et store accèdent à la mémoire (toute l'arithmétique est de register à register) ; contrôle hard-wired (pas de microcode) ; conçu pour le pipelining ; le compiler effectue plus de travail, donc les programmes contiennent plus d'instructions et nécessitent plus de mémoire. "Identifiez quatre caractéristiques d'un processeur CISC." N'importe lesquelles de quatre : un grand jeu d'instructions, dont beaucoup sont complexes (une instruction peut effectuer plusieurs opérations) ; instructions de longueur variable ; instructions prenant plusieurs cycles d'horloge ; moins de registres ; instructions pouvant accéder directement à la mémoire ; contrôle microprogrammé ; moins adapté au pipelining ; programmes plus courts, donc un compilateur plus simple et moins de mémoire. "Décrivez ce que signifient RISC et CISC" (deux points chacun) : nommez l'acronyme et donnez l'idée définissante (peu d'instructions simples monocycle ; beaucoup d'instructions complexes multicycle).
Gestion des interruptions sur les deux architectures. Sur un processeur CISC, l'instruction courante, aussi complexe soit-elle, est terminée avant que l'interruption ne soit traitée ; le processeur sauvegarde ensuite le contenu de ses registres (y compris le compteur programme) sur la pile, saute vers le routine de service d'interruption, et restaure les registres après. Sur un processeur RISC avec un pipeline, plusieurs instructions sont en cours d'exécution au moment où l'interruption 中断 arrive, donc le processeur doit soit laisser toutes les instructions du pipeline terminer, soit discarder (flush) les instructions partiellement exécutées et les redémarrer après l'interruption ; dans les deux cas, le pipeline est vidé, les registres sont sauvegardés, et la routine de service s'exécute. La formulation de l'examen : "le pipelining rend la gestion des interruptions plus complexe, car le contenu du pipeline doit être géré avant que l'interruption ne puisse être traitée".
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| motherboard/ˈmʌðəbɔːd/ | 主板 | zhǔ bǎn |
| CISC/sɪsk/ | 复杂指令集 | fù zá zhǐ lìng jí |
| RISC/rɪsk/ | 精简指令集 | jīng jiǎn zhǐ lìng jí |
| register/ˈredʒɪstə/ | 寄存器 | jì cún qì |
| interrupt/ˈɪntərʌpt/ | 中断 | zhōng duàn |
15.1
Pipelining
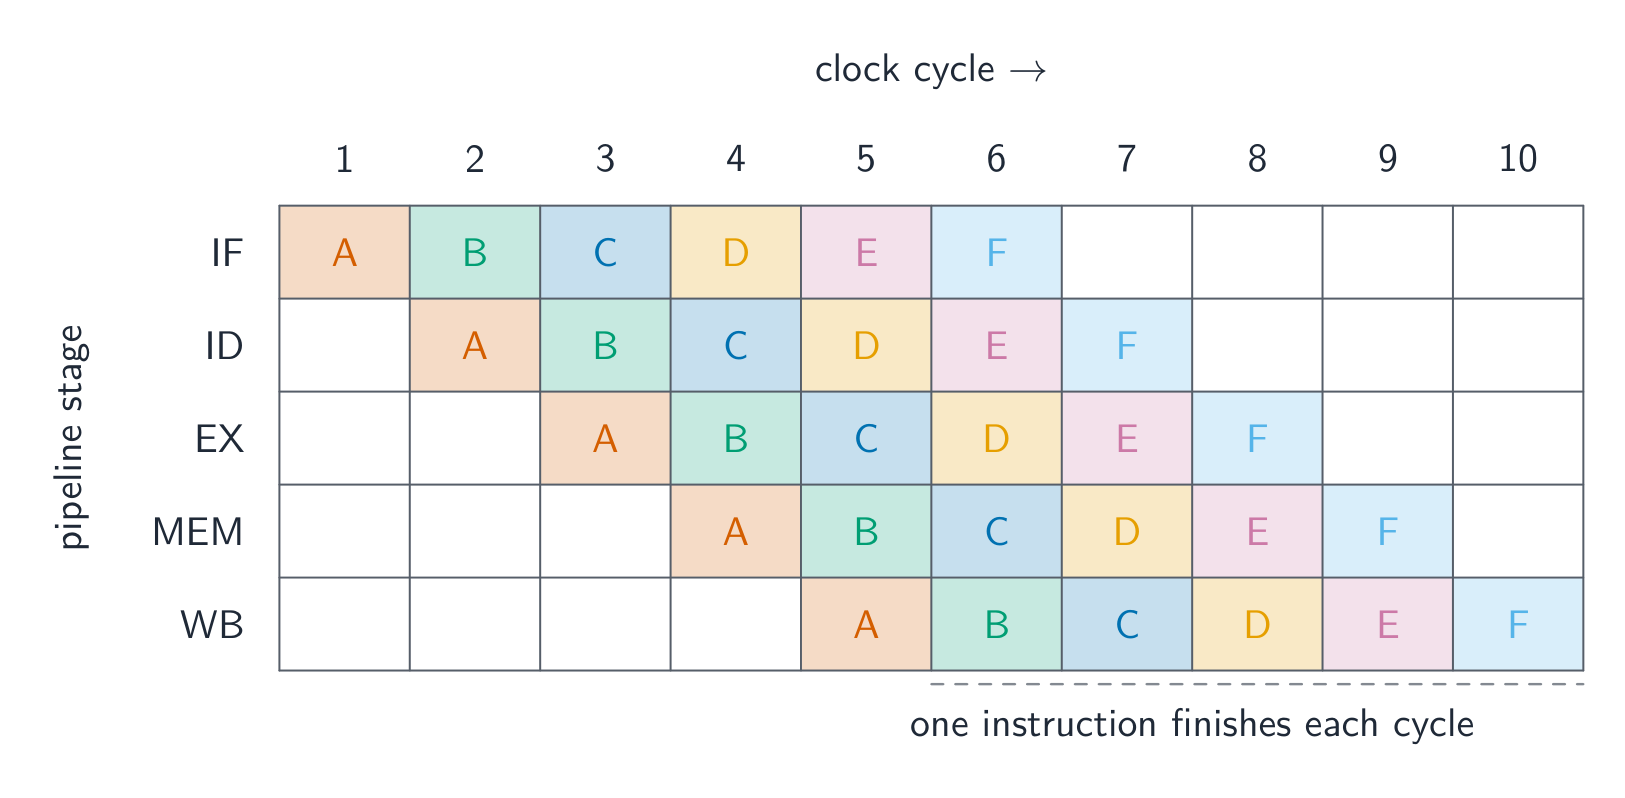
Un pipeline 流水线 traite les instructions en stages chevauchants, comme une chaîne d'assemblage : Fetch → Decode → Execute (dans l'ALU 算术逻辑单元) → Memory access → Write back. Chaque stage travaille sur une instruction différente à la fois, donc une fois le pipeline rempli, une instruction se termine par cycle. Les instructions RISC à longueur fixe et simples font en sorte que chaque stage prenne le même temps. Un pipeline peut subir un stalling sur un hazard 冒险 — un hazard de données (une instruction a besoin d'un résultat pas encore prêt) ou un hazard de contrôle (une branchement rend l'adresse suivante inconnue).
Les puces RISC gardent les données dans beaucoup de registres parce que la mémoire est lente et les registres rapides ; le compilateur alloue les valeurs aux registres judicieusement.
"Décrivez l'utilisation du pipelining dans les processeurs RISC" (trois points). (1) Le cycle fetch-execute est divisé en stages (fetch, decode, execute, memory access, write back) ; (2) plusieurs instructions sont dans le pipeline à la fois, chacune à un stage différent, donc pendant qu'une est exécutée, la suivante est décodée et celle d'après est fetched ; (3) une nouvelle instruction commence, et une se termine, dans chaque cycle d'horloge une fois le pipeline plein, ce qui augmente le throughput 吞吐量 (le nombre d'instructions terminées par seconde), bien que chaque instruction prenne encore le même temps individuellement. Les instructions RISC à longueur fixe monocycle sont ce qui rend les stages égaux et le pipeline possible.
Exemple résolu. Un processeur utilise cinq stages de pipeline (IF, ID, OF, EX, WB). Quatre instructions entrent dans le pipeline l'une après l'autre. À quel cycle la dernière instruction se termine-t-elle, et combien de cycles prendraient ces quatre instructions sans pipelining ?
L’instruction 1 occupe IF au cycle 1, ID en 2, OF en 3, EX en 4 et WB en 5 ; l’instruction 2 commence un cycle plus tard et se termine au cycle 6 ; l’instruction 3 au cycle 7 ; l’instruction 4 au cycle 8. En général, $n$ instructions à travers $k$ stades prennent $n + k - 1$ cycles, ici $4 + 5 - 1 = 8$. Sans pipeline, chaque instruction prend tous les cinq cycles avant que la suivante ne commence : $4 \times 5 = 20$ cycles. Le tableau de l’examen est rempli en écrivant les stades de chaque instruction en diagonale, une colonne à droite de l’instruction précédente.
Un processeur fonctionnant à cette vitesse dégage beaucoup de chaleur, donc un heat-sink 散热器 et un ventilateur sont placés dessus. Les ailettes métalliques dissipent la chaleur et le ventilateur l'éloigne, maintenant le CPU suffisamment frais pour fonctionner.

Explorer
Comment le pipelinage se remplit
Passez en revue les cycles d'horloge. Une fois le pipeline plein, une nouvelle instruction se termine tous les cycles — bien que chacune prenne encore plusieurs stades — parce que les stades de différentes instructions se chevauchent.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| pipeline/ˈpaɪplaɪn/ | 流水线 | liú shuǐ xiàn |
| ALU/ˌeɪ el ˈjuː/ | 算术逻辑单元 | suàn shù luó jí dān yuán |
| hazard/ˈhæzəd/ | 冒险 | mào xiǎn |
| throughput/ˈθruːpʊt/ | 吞吐量 | tūn tǔ liàng |
| heat-sink/hiːt sɪŋk/ | 散热器 | sàn rè qì |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | 弗林分类 | fú lín fēn lèi |
15.1
Taxonomie de Flynn
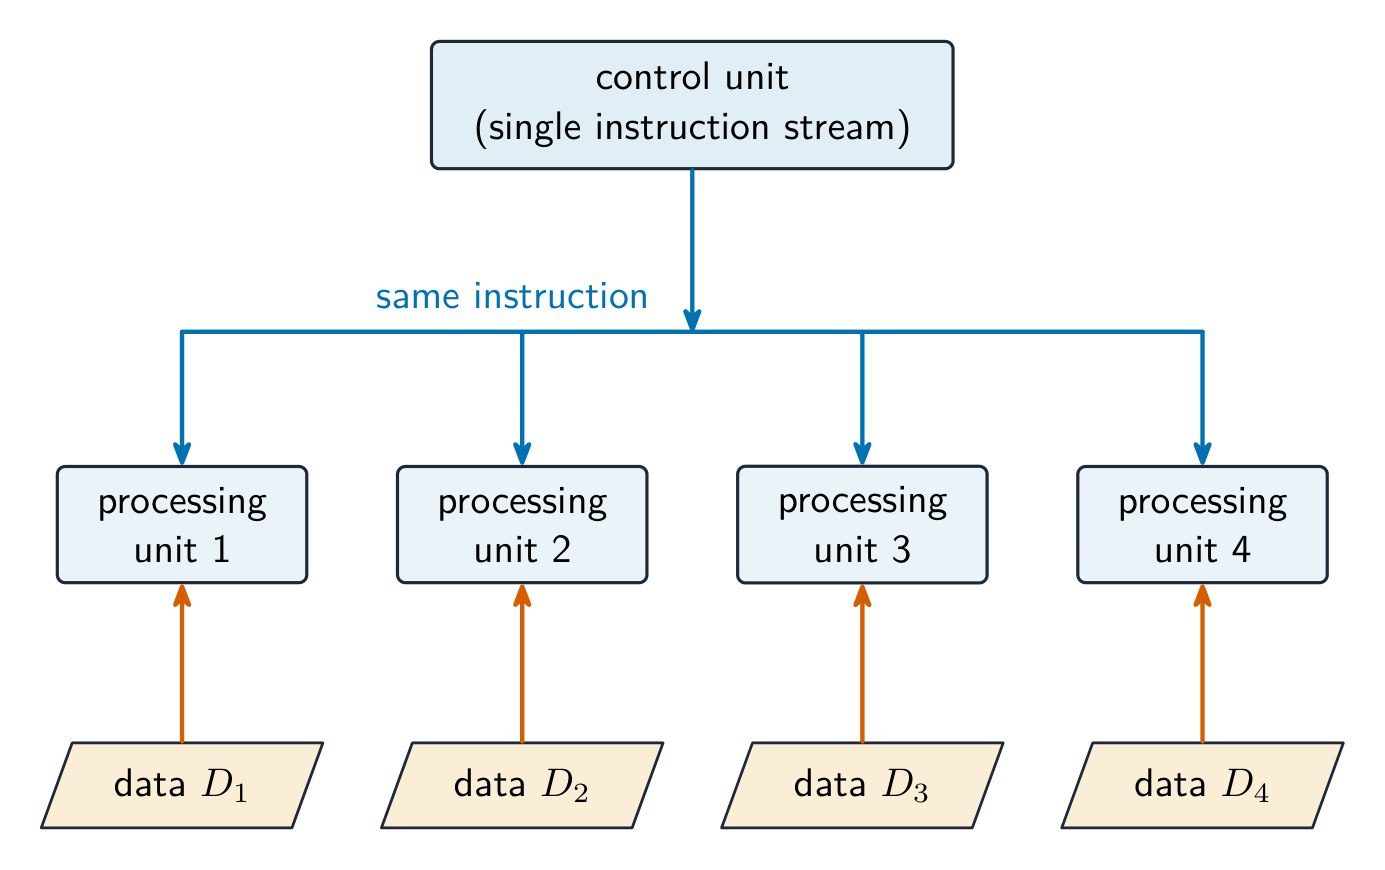
La taxonomie de Flynn 弗林分类 classe les ordinateurs selon le nombre de flux d'instructions et de données :
- SISD — une instruction, un flux de données (un cœur unique traditionnel).
- SIMD 单指令多数据 — une instruction agit sur de nombreux éléments de données simultanément (GPU, extensions vectorielles CPU). Idéal pour les images, vidéo, tableaux scientifiques.
- MISD — plusieurs opérations sur les mêmes données ; rare, surtout théorique.
- MIMD 多指令多数据 — de nombreux processeurs exécutent différentes instructions sur différentes données (CPU multi-cœurs, clusters). Le plus général.
Décrire les quatre architectures (deux points chacune). SISD : non processeur unique exécute une instruction à la fois sur un élément de données ; pas de parallélisme, la machine von Neumann traditionnelle. SIMD : une instruction est appliquée simultanément à de nombreux éléments de données, par de multiples éléments de traitement agissant synchronisés ; utilisé pour le traitement matriciel et graphique. MISD : plusieurs processeurs appliquent différentes instructions aux mêmes données ; rarement utilisé, par exemple un système tolérant aux pannes où plusieurs processeurs vérifient un seul flux. MIMD : de nombreux processeurs, chacun exécutant ses propres instructions sur ses propres données, indépendamment ; l'ordinateur multi-cœur et le cluster.
Une carte graphique 显卡 (avec son GPU) est un exemple réel de matériel SIMD : elle possède des milliers de petits cœurs exécutant la même instruction sur de nombreux pixels ou nombres simultanément, d'où la rapidité des GPU pour les images, vidéo et apprentissage automatique.


Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| SIMD/ˈsɪmdiː/ | 单指令多数据 | dān zhǐ lìng duō shù jù |
| MIMD/ˈmɪmdiː/ | 多指令多数据 | duō zhǐ lìng duō shù jù |
| graphics card/ˈɡræfɪks kɑːd/ | 显卡 | xiǎn kǎ |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 大规模并行 | dà guī mó bìng xíng |
15.1
Ordinateurs massivement parallèles

Un système massivement parallel 大规模并行 utilise des milliers de processeurs sur un réseau rapide, chacun avec sa propre mémoire (distributed memory 分布式内存), échangeant des données par messages. C'est du MIMD, nécessite un logiciel spécifiquement écrit (MPI, CUDA), et convient à la simulation climatique, à l'entraînement de machine learning 机器学习 à grande échelle, et à l'astrophysique. Les plus grands supercomputers 超级计算机 sont massivement parallèles.
"Esquissez les caractéristiques des ordinateurs massivement parallèles" (trois points). Un très grand nombre de processeurs (milliers), chacun avec sa propre mémoire, connectés par un réseau (une interconnexion haute vitesse ou un bus) afin qu'ils puissent passer des messages entre eux ; ils travaillent simultanément sur des parties du même problème, donc le problème doit être écrit comme un programme pouvant être divisé en parties s'exécutant en parallèle et combinant leurs résultats. C'est une disposition MIMD.
Les processeurs vivent dans des racks de server 服务器 hauts, occupant souvent toute une pièce (un data centre 数据中心), câblés ensemble pour travailler sur un gros problème en même temps.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ | 分布式内存 | fēn bù shì nèi cún |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | 超级计算机 | chāo jí jì suàn jī |
| server/ˈsɜːvə/ | 服务器 | fú wù qì |
| data centre/ˈdeɪtə ˈsentə/ | 数据中心 | shù jù zhōng xīn |
15.1
Machines virtuelles
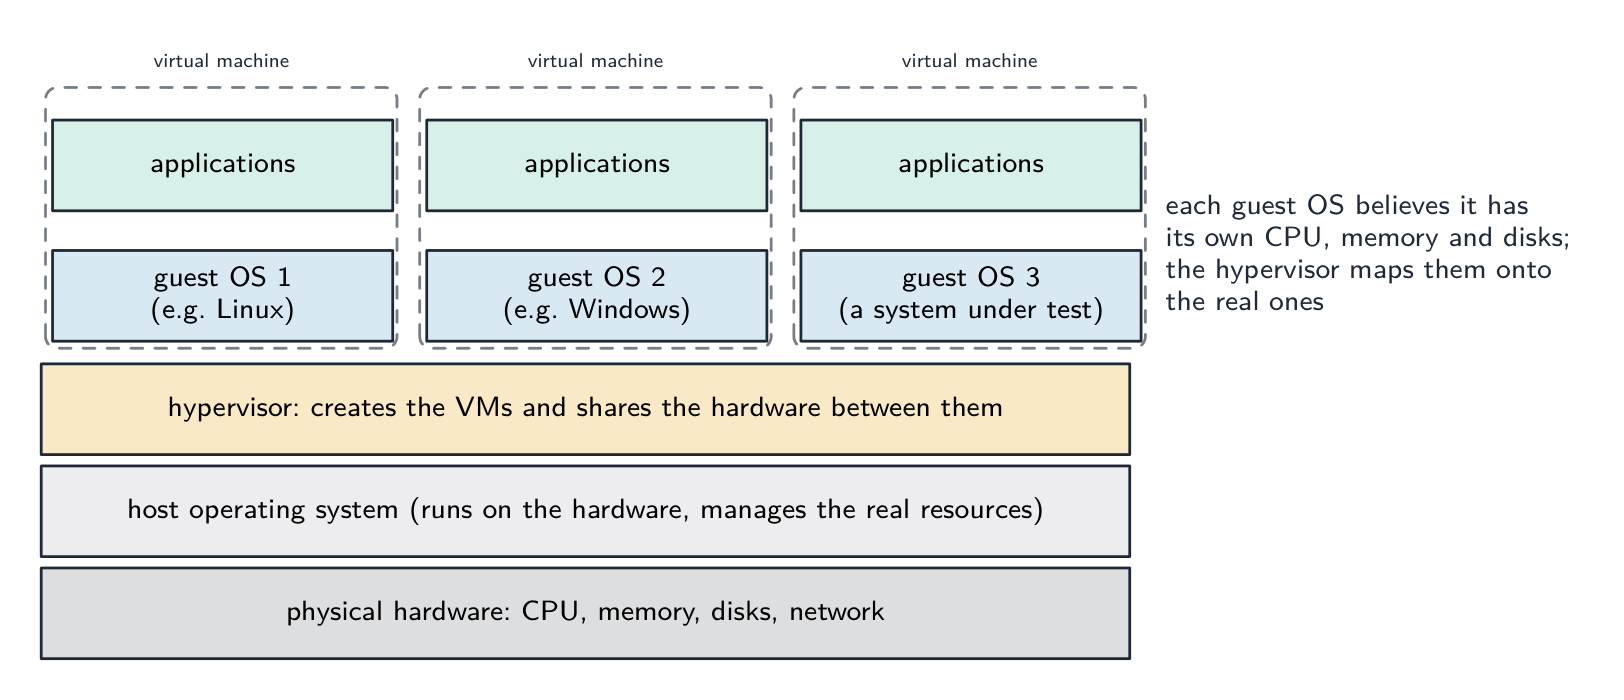
Une virtual machine 虚拟机 (VM) est une émulation logicielle d'un ordinateur entier — le logiciel à l'intérieur voit un CPU, une mémoire et des disques qui semblent réels mais sont gérés par un logiciel hôte.
- une system VM exécute un OS complet. Un hypervisor 虚拟机监控器 crée et gère les VM, chacune amorçant son propre OS invité. Utilisations : exécuter différents OS sur une même machine ; consolidation de serveurs ; sandboxing 沙箱 (logiciel risqué exécuté isolément) ; snapshots.
- une process (language) VM exécute un programme dans du bytecode 字节码 portable — la JVM (Java), le CLR (.NET), CPython. Avantages : portabilité (« écrire une fois, exécuter partout »), vérifications de sécurité en temps d'exécution, et just-in-time compilation 即时编译 pour une vitesse quasi-native. Le coût est une couche supplémentaire et la nécessité d'avoir la VM installée.
"Décrivez ce que signifie une machine virtuelle" (deux points). Une émulation (implémentation) logicielle d'un système informatique qui s'exécute sur un ordinateur hôte et se comporte, pour les programmes qui y tournent, comme un ordinateur physique séparé avec son propre processeur, sa mémoire et son stockage. Le système d'exploitation hôte 宿主操作系统 s'exécute sur le matériel réel, gère les ressources réelles et (via l'hyperviseur) crée et contrôle les machines virtuelles ; chaque système d'exploitation invité 客户操作系统 s'exécute à l'intérieur d'une machine virtuelle, gère les applications qui y sont, et ignore que son matériel est virtuel.
Avantages (donner deux). Plusieurs systèmes d'exploitation différents peuvent s'exécuter sur une même machine simultanément ; des logiciels peuvent être testés sur de nombreux systèmes sans acheter le matériel ; un nouveau système informatique peut être émulé et testé avant sa construction ; chaque VM est isolée, donc un crash ou un malware dans l'une n'affecte pas l'hôte ni les autres ; les VMs peuvent être copiées, déplacées et sauvegardées sous forme de fichiers, et un serveur peut être partagé entre de nombreux utilisateurs, réduisant les coûts matériels. Limitations (donner deux). Une VM s'exécute plus lentement que le matériel réel car chaque instruction passe par la couche d'émulation ; elle consomme la mémoire et la puissance de traitement de l'hôte, donc l'hôte doit être puissant ; certaines fonctionnalités ou périphériques matériels ne sont pas exactement émulés, donc le logiciel testé peut se comporter différemment sur la vraie machine ; des licences sont nécessaires pour chaque OS invité, et la configuration du système nécessite une expertise.
Explorer
Laboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ | 虚拟机 | xū nǐ jī |
| hypervisor/ˌhaɪpəˈvaɪzə/ | 虚拟机监控器 | xū nǐ jī jiān kòng qì |
| sandboxing/ˈsændbɒksɪŋ/ | 沙箱 | shā xiāng |
| bytecode/ˈbaɪtkəʊd/ | 字节码 | zì jié mǎ |
| just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ | 即时编译 | jí shí biān yì |
| host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ | 宿主操作系统 | sù zhǔ cāo zuò xì tǒng |
| guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ | 客户操作系统 | kè hù cāo zuò xì tǒng |
| Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ | 布尔代数 | bù ěr dài shù |
| Boolean/ˈbuːlɪən/ | 布尔 | bù ěr |
| truth tables/truːθ ˈteɪblz/ | 真值表 | zhēn zhí biǎo |
| De Morgan's laws/də ˈmɔːɡənz lɔːz/ | 德摩根定律 | dé mó gēn dìng lǜ |
15.2
Algèbre booléenne
Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Produire des tables de vérité pour des circuits logiques incluant des additeurs demi et complets | Peut inclure des portes logiques avec plus de deux entrées |
| Montrer la compréhension d'un bascule (SR, JK) | Dessiner un circuit logique et dériver une table de vérité pour une basculle Comprendre le rôle des bascules comme éléments de stockage de données |
| Montrer la compréhension de l'algèbre de Boolean | Comprendre les lois de De Morgan Effectuer l'algèbre de Boolean en utilisant les lois de De Morgan Simplifier un circuit/logique en utilisant l'algèbre de Boolean |
| Montrer la compréhension des cartes de Karnaugh (K-map) | Comprendre les avantages de l'utilisation des cartes de Karnaugh Résoudre des problèmes logiques en utilisant les cartes de Karnaugh |
Source : Programme Cambridge International
Algèbre booléenne 布尔代数 simplifie les expressions booléennes 布尔, qui peuvent également être décrites par des tables de vérité 真值表. Symboles : + pour OR, · pour AND (souvent omis), une barre au-dessus pour NOT.
Les lois clés incluent les lois commutative, associative et distributive (comme en algèbre ordinaire), ainsi que :
- identité $A + 0 = A$, $A \cdot 1 = A$ ; nul $A + 1 = 1$, $A \cdot 0 = 0$.
- idempotent $A + A = A$ ; inverse $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$.
- Lois de De Morgan 德摩根定律 : $(A + B)' = A' \cdot B'$ ; $(A \cdot B)' = A' + B'$ — nier l'ensemble, échanger AND/OR, nier chaque opérande.
- absorption 吸收律 : $A + AB = A$.
La simplification réduit le nombre de termes, donc le circuit logique résultant a moins de portes. Exemple : $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
Les lois avec leurs noms (citer le nom à chaque étape quand "montrer tout le calcul" est demandé).
| Loi | Forme OR | Forme AND |
|---|---|---|
| identité | $A + 0 = A$ | $A \cdot 1 = A$ |
| nul (annulation) | $A + 1 = 1$ | $A \cdot 0 = 0$ |
| idempotent | $A + A = A$ | $A \cdot A = A$ |
| complément (inverse) | $A + \overline{A} = 1$ | $A \cdot \overline{A} = 0$ |
| commutative | $A + B = B + A$ | $A \cdot B = B \cdot A$ |
| associative | $A + (B + C) = (A + B) + C$ | $A(BC) = (AB)C$ |
| distributive | $A + BC = (A + B)(A + C)$ | $A(B + C) = AB + AC$ |
| absorption | $A + AB = A$ | $A(A + B) = A$ |
| De Morgan | $\overline{A + B} = \overline{A} \cdot \overline{B}$ | $\overline{A \cdot B} = \overline{A} + \overline{B}$ |
| double négation | $\overline{\overline{A}} = A$ |
Exemple résolu. Simplifier $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, en montrant tout le calcul.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan sur la barre extérieure) $= A \cdot B + A + B$ (double négation) $= A + B$ (absorption, $A + AB = A$, appliqué avec $A + B$ absorbant $AB$).
Exemple résolu. Simplifier $(\overline{A + B}) \cdot (\overline{A} + B)$.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (De Morgan) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (distributif) $= \overline{A}\,\overline{B} + 0$ (idempotent, complémentaire) $= \overline{A}\,\overline{B}$.
Exemple résolu. Simplifier $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (distributive) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (complément, identité) $= \overline{B}(\overline{A} + AC)$ (distributive) $= \overline{B}(\overline{A} + C)$, utilisant $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Appliquer De Morgan à un terme à trois entrées fonctionne de la même manière : $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Somme-de-produits à partir d'une table de vérité. Prendre chaque ligne dont la sortie est 1, écrire l'AND de ses entrées (une variable barrée où elle est 0), et OR les termes : une ligne avec $A = 1, B = 0, C = 1$ donne $A\,\overline{B}\,C$. C'est la forme somme-de-produits 积之和 demandée à l'examen, et c'est le point de départ tant pour la simplification algébrique que pour la carte de Karnaugh.
Explorer
Algèbre booléenne
A·B, A+B, Ā …
L'algèbre booléenne n'est que ces portes écrites sous forme d'expressions — comparez les tables de vérité.
Explorer
Tables de vérité booléennes
Choisissez un opérateur et les entrées pour construire sa table de vérité — l'algèbre derrière les circuits logiques.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| absorption/əbˈsɔːpʃn/ | 吸收律 | xī shōu lǜ |
| sum-of-products/sʌm ɒv ˈprɒdʌkts/ | 积之和 | jī zhī hé |
| Karnaugh map/ˈkɑːnɔː mæp/ | 卡诺图 | kǎ nuò tú |
| Gray code/ɡreɪ kəʊd/ | 格雷码 | gé léi mǎ |
| half adder/hɑːf ˈædə/ | 半加器 | bàn jiā qì |
15.2
Cartes de Karnaugh
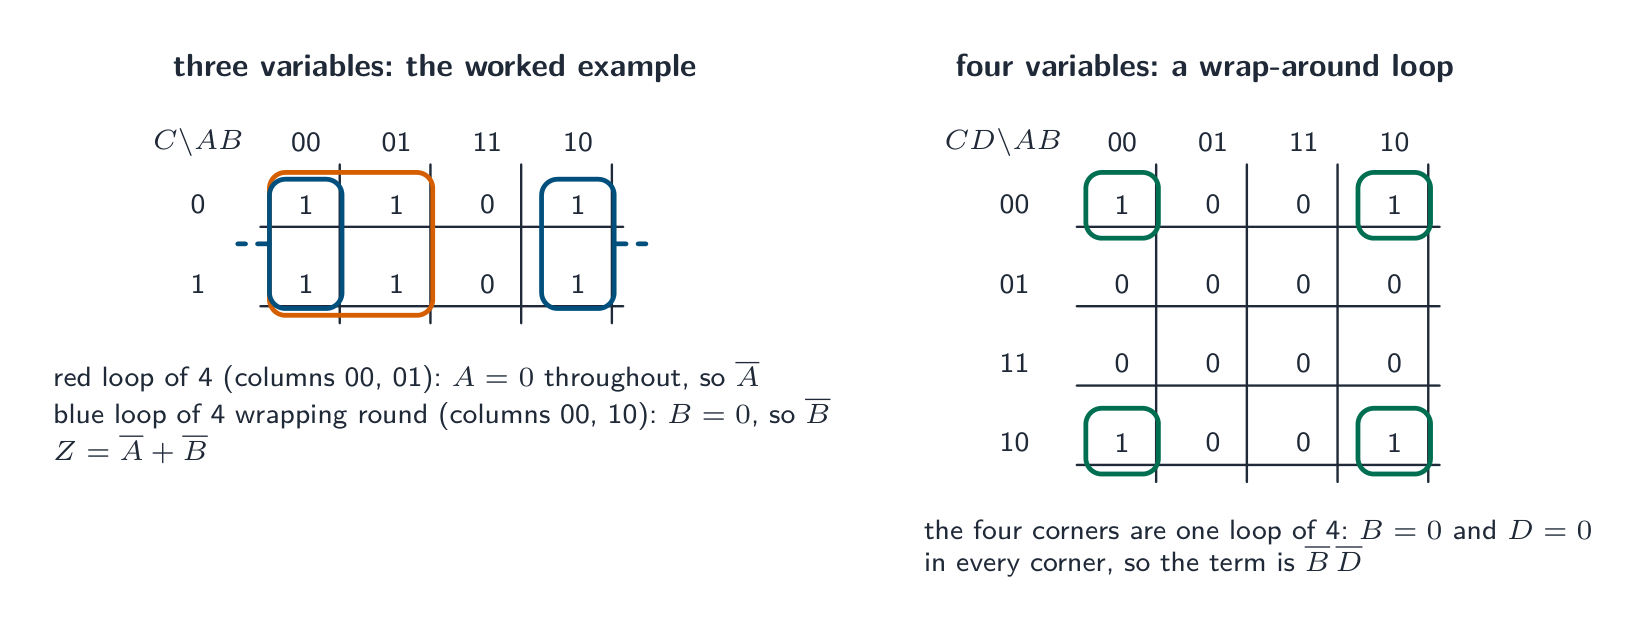
Une carte de Karnaugh 卡诺图 (K-map) simplifie une expression booléenne en regroupant des 1 adjacents d'une table de vérité. Les colonnes et lignes utilisent l'ordre code Gray 格雷码 (00, 01, 11, 10) afin que les cellules adjacentes diffèrent par une seule variable.
Placer un 1 dans chaque cellule où la sortie est 1. Trouver des groupes rectangulaires de 1s dont les côtés sont des puissances de 2 (1, 2, 4, 8), en faisant le tour des bords si cela permet un plus grand groupe. Plus le groupe est grand, plus le terme est simple : un groupe de 2 fait disparaître une variable, un groupe de 4 en fait disparaître deux, et ainsi de suite — les variables qui changent dans le groupe disparaissent. ORer les termes de groupe ensemble pour l'expression simplifiée. Couvrir tous les 1s en utilisant le moins de groupes, les plus grands possible.
Exemple résolu. Une carte de Karnaugh pour $A$ et $B$ a des 1s dans les cellules $\overline{A}B$ et $AB$. Simplifier. Les deux 1s sont adjacents - ils partagent la colonne $B=1$ - donc les regrouper comme un rectangle de 2. À l'intérieur de ce groupe $B$ reste 1 tout au long tandis que $A$ changement de 0 à 1, et toute variable qui change dans un groupe disparaît. Donc le groupe laisse simplement $X = B$. Comparer cela avec la somme des produits lue directement depuis la table, $\overline{A}B + AB$ : le même circuit, deux portes en moins. Deux règles font la plupart du travail - rendre chaque groupe aussi grand que possible (un groupe de 2 fait disparaître une variable, 4 en fait disparaître deux, 8 en fait disparaître trois), et se souvenir que la carte fait le tour de ses bords, donc les colonnes gauche et droite sont adjacentes. Ce tour est le regroupement que la plupart des candidats manquent.
Construire et lire une carte K. Étiqueter les colonnes $AB$ et les lignes $C$ (ou $CD$) dans l'ordre code-Gray 00 01 11 10, afin que les cellules voisines diffèrent par une seule variable. Placer un 1 dans chaque cellule dont le minterme apparaît dans l'expression (ou dont la ligne de la table de vérité affiche 1). Ensuite, tracer les moins, plus grands boucles qui couvrent chaque 1 : chaque boucle doit être un rectangle de $1, 2, 4$ ou $8$ cellules, les boucles peuvent se chevaucher, peuvent faire le tour des bords gauche-droit et haut-bas, et les quatre coins ensemble forment une boucle. Pour chaque boucle, écrire les variables qui sont constantes à l'intérieur (barrées si 0), et ORer les termes de boucle : c'est la somme-de-produits optimale. Pourquoi utiliser une ? Elle donne l'expression la plus simple sans algèbre, en quelques étapes, avec moins de risques d'erreur, et la même carte convient à trois ou quatre variables.
Exemple résolu. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
Sur la carte à trois variables, les 1s remplissent les colonnes 00, 01 et 10 dans les deux lignes. La boucle de quatre sur les colonnes 00 et 01 a $A = 0$ tout au long et $B$, $C$ varient toutes deux : terme $\overline{A}$. La boucle de quatre sur les colonnes 00 et 10 (en faisant le tour) a $B = 0$ tout au long : terme $\overline{B}$. Donc $Z = \overline{A} + \overline{B}$, ce que confirme l'algèbre booléenne : $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Deux boucles de deux seraient également correctes mais pas optimales ; une boucle est aussi grande que le permettent les 1s.
Exemple résolu (quatre variables). Une carte a des 1s seulement dans ses quatre coins : $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ et $A\,\overline{B}\,C\,\overline{D}$. Parce que les lignes supérieures et inférieures sont adjacentes et que les colonnes extérieures le sont aussi, les coins forment une boucle de quatre ; $B = 0$ et $D = 0$ dans chacun d'eux tandis que $A$ et $C$ varient, donc $Z = \overline{B}\,\overline{D}$.
15.2
Demi-additionneur et additionneur complet

Un demi-additionneur 半加器 additionne deux bits simples $A$ et $B$, donnant une somme $S$ et une retenue 进位 $C$ :
| A | B | S | C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
Donc $S = A \text{ XOR } B$ et $C = A \text{ AND } B$. Il ignore toute retenue d'entrée — d'où "demi".
Un additionneur complet 全加器 additionne trois bits ($A$, $B$, retenue entrante), donnant une somme et une retenue sortante : $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Il peut être construit à partir de deux additionneurs partiels plus une porte OU. Enchaîner des additionneurs complets (chaque retenue sortante alimentant la retenue entrante suivante) crée un additionneur « ripple-carry » multi-bits.

Table de vérité de l'additionneur complet. Avec les entrées $A$, $B$ et la retenue d'entrée $C_{\text{in}}$ : la somme $S$ est 1 quand un nombre impair d'entrées est 1, et la retenue de sortie est 1 quand deux ou plus d'entrées sont 1.
| $A$ | $B$ | $C_{\text{in}}$ | $S$ | $C_{\text{out}}$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
Les questions de circuit que l'examen pose. Étant donné un circuit d'une porte XOR et d'une porte AND partageant deux entrées, ou deux demi-additionneurs et une porte OR, "compléter la table de vérité (montrer votre calcul)" signifie ajouter une colonne pour chaque sortie de porte intermédiaire et remplir les lignes dans l'ordre ; "donner le nom du circuit" est demi-additionneur ou additionneur complet ; "indiquer la finalité de chaque sortie" est la somme des bits et la retenue vers la colonne suivante. Somme-de-produits pour le demi-additionneur : $S = \overline{A}B + A\overline{B}$, $C = AB$. Une chaîne d'additionneurs complets, chacun passant sa retenue de sortie à la retenue d'entrée suivante, additionne deux nombres multi-bits.
Explorer
Les portes à l'intérieur d'un additionneur
Le bit de somme d'un demi-additionneur est une porte XOR et sa retenue est une porte AND — alternez A et B et observez la ligne de la table de vérité s'allumer.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| carry/ˈkæri/ | 进位 | jìn wèi |
| full adder/fʊl ˈædə/ | 全加器 | quán jiā qì |
15.2
Bascules (Flip-flops)
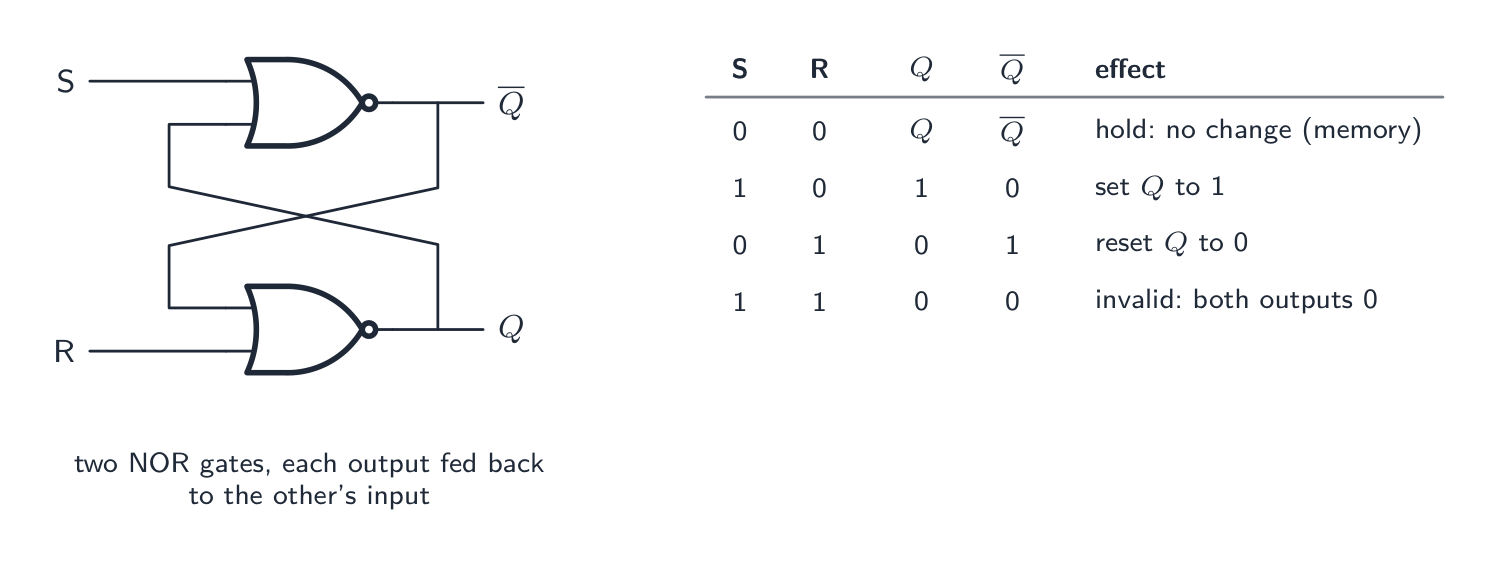
Une bascule 触发器 est un circuit bistable 双稳态 — deux états stables (0 et 1) — qui mémorise son état. Elle stocke un bit et constitue l'élément de base des registres et de la SRAM.
Bascule SR
Une basculle SR SR触发器 a des entrées S (set/positionnement) et R (reset/réinitialisation) et des sorties Q et $\overline{Q}$. S=1,R=0 positionne Q à 1 ; S=0,R=1 la réinitialise à 0 ; S=0,R=0 maintient ; S=1,R=1 est invalide. Construite à partir de deux portes NOR croisées.
"Dessinez un circuit logique pour une bascule SR et étiquetez les entrées." Deux portes NOR (ou deux portes NAND), la sortie de chaque porte étant connectée en retour à l'une des entrées de l'autre ; l'entrée libre d'une porte est S, celle de l'autre R ; les sorties sont $Q$ et $\overline{Q}$. La rétroaction est ce qui rapporte des points : sans elle, il n'y a pas de mémoire. "Énoncez le rôle d'une bascule." Pour stocker un bit de données ; c'est l'élément mémoire de base à partir duquel sont construits les registres et la RAM statique, et elle conserve sa valeur jusqu'à ce qu'elle soit délibérément modifiée. L'entrée invalide $S = R = 1$ rend les deux sorties égales à 0, de sorte que $\overline{Q}$ n'est plus le complément de $Q$, et l'état après le retour des deux entrées à 0 est imprévisible, ce qui constitue la faiblesse de la bascule SR.
Bascule JK
Une bascule JK JK触发器 améliore cette configuration en utilisant l'entrée précédemment invalide 1,1 comme toggle 翻转 (la sortie s'inverse). Cela la rend idéale pour construire des compteurs 计数器 (une chaîne de bascules en mode toggle). Elle est généralement horlogée — les entrées ne sont activées qu'en bord d'horloge, maintenant les bascules synchronisées.

Les bascules constituent les briques de construction des registres (n bits = n bascules), des compteurs et des cellules SRAM 静态RAM.
Tableau de vérité d'une bascule JK. L'entrée clock 时钟 détermine quand les entrées J et K sont lues, de sorte que la sortie ne change qu'au passage d'un front d'horloge : avec $J = K = 0$, la sortie est maintenue ; $J = 1, K = 0$ définit $Q$ à 1 ; $J = 0, K = 1$ la remet à zéro à 0 ; $J = K = 1$ la retourne (Q devient $\overline{Q}$). La dernière ligne correspond exactement à l'entrée interdite de la bascule SR transformée en entrée utile, ce qui explique pourquoi la bascule JK est préférée : chaque combinaison d'entrées est valide, et le fonctionnement horlogé en fait la brique de construction des compteurs et des registres à décalage.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| flip-flop/flɪp flɒp/ | 触发器 | chù fā qì |
| bistable/baɪˈsteɪbl/ | 双稳态 | shuāng wěn tài |
| toggle/ˈtɒɡl/ | 翻转 | fān zhuǎn |
| counters/ˈkaʊntəz/ | 计数器 | jì shù qì |
| SRAM/ˈesræm/ | 静态RAM | jìng tài RAM |
| clock/klɒk/ | 时钟 | shí zhōng |
| SR flip-flop/ˌes ˈɑː flɪp flɒp/ | SR触发器 | SR chù fā qì |
| JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ | JK触发器 | JK chù fā qì |
15.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| RISC | un processeur avec un petit ensemble d'instructions simples, de longueur fixe, la plupart exécutées en un seul cycle d'horloge, utilisant de nombreux registres et le pipeline |
| CISC | un processeur avec un grand ensemble d'instructions complexes, de longueur variable, dont beaucoup prennent plusieurs cycles d'horloge et accèdent directement à la mémoire |
| pipeline | division du cycle fetch-execute en étapes afin que plusieurs instructions soient traitées simultanément, chacune se trouvant à une étape différente |
| SISD / SIMD / MISD / MIMD | une instruction sur un élément de données ; une instruction sur plusieurs éléments de données ; plusieurs instructions sur un élément de données ; plusieurs instructions sur plusieurs éléments de données |
| ordinateur massivement parallèle | milliers de processeurs, chacun avec sa propre mémoire, connectés par un réseau et travaillant simultanément sur un même problème |
| machine virtuelle | émulation logicielle d'un système informatique s'exécutant sur un ordinateur hôte et se comportant comme un ordinateur physique distinct |
| hyperviseur | logiciel créant des machines virtuelles et partageant le matériel de l'hôte entre elles |
| tableau de vérité | table listant toutes les combinaisons d'entrées d'un circuit logique avec les sortie(s) résultante(s) |
| somme-de-produits | expression booléenne écrite sous forme de OU de termes ET, un terme pour chaque combinaison d'entrées donnant 1 |
| carte de Karnaugh | grille des sorties du tableau de vérité, disposées selon l'ordre Gray, dans laquelle des boucles de 1 adjacents donnent l'expression simplifiée |
| demi-additionneur | circuit additionnant deux bits, produisant une somme et une retenue |
| additionneur complet | circuit additionnant deux bits et une retenue entrante, produisant une somme et une retenue sortante |
| bascule | circuit bistable stockant un bit, conservant sa sortie jusqu'à ce que ses entrées la modifient |
15.2
Conseils d'examen
- RISC et CISC sont répondus sous forme de listes de caractéristiques : simple, fixe, un cycle, nombreux registres, charge/sauvegarde, pipeline face à complexe, variable, multi-cycles, moins de registres, accès direct à la mémoire, microcode. Quatre de chaque.
- Pipeline : étapes, plusieurs instructions à la fois, une terminée par cycle, débit accru ; $n + k - 1$ cycles pour $n$ instructions traversant $k$ étapes ; les interruptions doivent vider le pipeline.
- Les quatre catégories de Flynn sont "combien de flux d'instructions" par "combien de flux de données" ; dire ce qui s'exécute sur quoi. Massivement parallèle : nombreux processeurs, propre mémoire, réseau, même problème.
- Machine virtuelle : émulation d'un ordinateur sur un hôte ; OS hôte sur le matériel, hyperviseur le partageant, OS invité à l'intérieur. Deux avantages et deux limites, chacun une phrase complète.
- Algèbre de Boole : nommez chaque loi au fur et à mesure de son utilisation ; De Morgan inverse l'opérateur et nie chaque terme ; vérifiez avec un tableau de vérité si vous avez des doutes.
- Carte K : ordre Gray, plus grandes boucles de 1/2/4/8, enveloppement autorisé, un terme par boucle avec les variables inchangées. Expliquez pourquoi : expression la plus simple sans algèbre.
- Demi-additionneur donne somme et retenue ; additionneur complet prend aussi une retenue entrante ; bascule SR est deux portes NOR/NAND croisées et stocke un bit ; JK 1,1 toggle.
Erreurs courantes
- Échanger les listes de caractéristiques RISC et CISC, ou proposer "plus rapide" comme caractéristique ; donner les caractéristiques de conception, pas un verdict.
- Décrire le pipeline comme "exécutant des instructions en parallèle sur plusieurs cœurs" ; ce sont des étapes d'un seul processeur qui se chevauchent.
- Confondre SIMD (une instruction, plusieurs données) avec MIMD (plusieurs des deux), ou décrire MISD comme le cas courant.
- Définir une machine virtuelle comme "une copie d'un ordinateur" sans le mot émulation ni l'hôte et l'invité.
- Appliquer De Morgan seulement à une partie d'une expression sous une longue barre, ou supprimer la barre sans échanger AND pour OR.
- Boucler un groupe de trois, ou un groupe non rectangulaire, dans une carte K ; ordonner les colonnes 00, 01, 10, 11 au lieu de l'ordre Gray.
- Écrire la retenue d'un demi-additionneur comme XOR et la somme comme AND.
- Dessiner une bascule SR comme deux portes sans rétroaction, ou omettre l'état invalide de son tableau de vérité.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.