Qué es este curso y cómo usarlo
Este es el duodécimo curso en Medicina Universitaria: epidemiología, bioestadística y medicina basada en la evidencia (MBE) — el kit de herramientas que transforma preguntas clínicas en números y números en decisiones. Se alinea con el material de estadísticas UNI-BUS-05 revisado donde las matemáticas se superponen.
caso a continuación es ficticio y nada aquí licencia ni guía el tratamiento. el conjunto de datos a continuación es sintético o tiene licencia abierta, cada resumen evaluado es ficticio, y nada aquí otorga licencia ni guía para el tratamiento.
- Las unidades 12.1–12.3 miden y comparan: frecuencia de enfermedades, diseños de estudios, sesgo y causalidad.
- Las unidades 12.4–12.6 cuantifican: pruebas diagnósticas, inferencia, ensayos y revisiones.
- La unidad 12.7 aplica: valoración, certeza y el paciente ante ti.
El hábito de la MEBC: preguntar en PICO, medir en riesgos y razones, decidir con intervalos no rituales** — cada cálculo a continuación es sintético, verificado por máquina y algo que recalculas.
Medir la enfermedad: incidencia y prevalencia
Por qué importa. Antes de cualquier comparación, la enfermedad debe contarse — y las dos cuentas clásicas responden preguntas distintas: qué tan rápido aparecen nuevos casos, y cuántos existen al mismo tiempo.
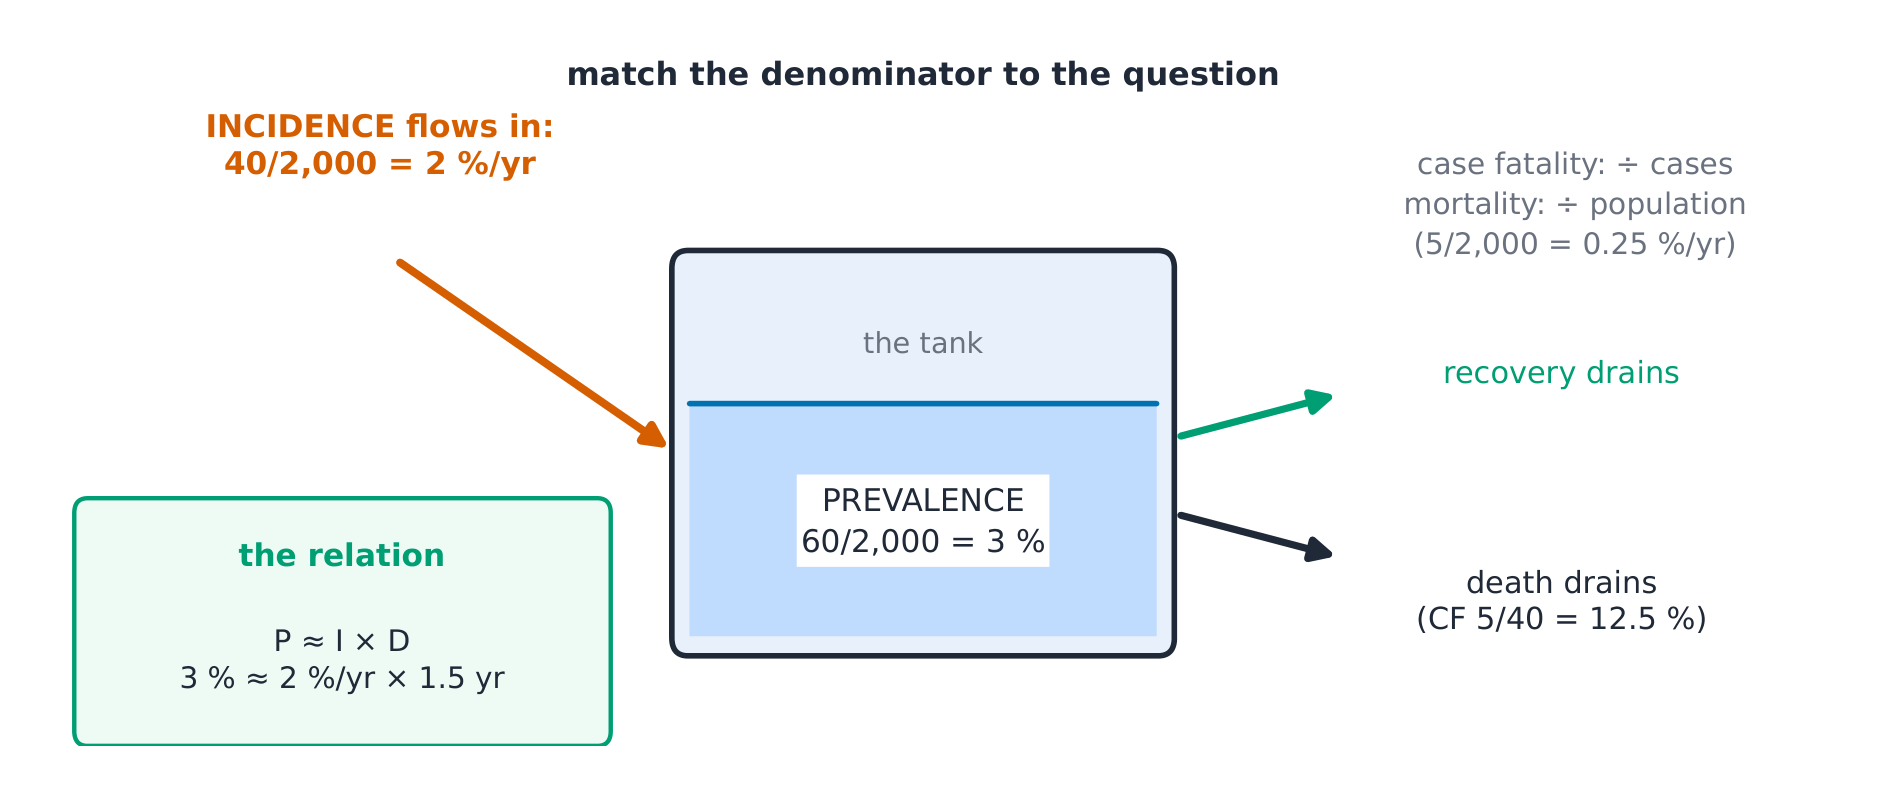
La idea, con una imagen. Incidencia = nuevos casos ÷ personas en riesgo ÷ tiempo; prevalencia = casos existentes ÷ población en un instante ✓. Están vinculadas: prevalencia ≈ incidencia × duración — enfermedades largas se acumulan, las breves desaparecen entre encuestas.
La derivación (por qué existe la estandarización). Las tasas brutas mezclan dos efectos: riesgo de enfermedad y estructura etaria de la población. Un distrito con más residentes mayores puede mostrar una tasa bruta más alta con tasas específicas por edad MENORES ✓. La estandarización directa aplica las tasas específicas por edad de cada grupo a una población estándar y las suma — el total artificial es comparable porque la mezcla etaria ahora es idéntica.
Ejemplo resuelto 1 — una ciudad sintética. 2,000 residentes, un año, 40 nuevos casos de una enfermedad → incidencia 40/2,000 = 2 % por año ✓. En el día del censo 60 personas tienen la enfermedad → prevalencia puntual 60/2,000 = 3 % ✓. Verifique el enlace: 3 % ≈ 2 %/año × 1.5 años de duración media — los números son consistentes sistema.
Worked example 2 — clinical link: mortality's three faces. (Fictional dataset) of the 40 new cases, 5 died within the year: case fatality 5/40 = 12.5 % ✓; the yearly deaths from this cause in the whole town were 5/2,000 = 0.25 % (cause-specific mortality rate); and if the town recorded 20 deaths from all causes that year, this disease caused 5/20 = 25 % of them (proportional mortalidad). Mismas muertes, tres denominadores, tres preguntas diferentes.
Errores comunes. Llamar a la prevalencia una tasa (es una proporción — sin unidad de tiempo). Comparar tasas brutas entre poblaciones con diferente estructura de edades (estandarice primero). Leer la mortalidad por caso como mortalidad (el denominador son casos, no personas). tiempo). Comparar tasas brutas entre poblaciones con diferente estructura de edades (estandarice primero). Leer la mortalidad por caso como mortalidad (el denominador son casos, no personas). estructuras (standardise first). Reading case fatality as mortality (the denominator is cases, not people).
Resumen. Incidencia = nuevos/expuestos/tiempo; prevalencia = existentes/población; P ≈ I × D; la estandarización ajusta la mezcla de edades; mortalidad por caso (casos), mortalidad específica por causa (población), mortalidad proporcional (todas las muertes) — ajuste el denominador a la pregunta.
Diseños de estudio
Por qué importa. Cada pregunta clínica tiene diseños que la responden adecuadamente y diseños que no pueden — elegir el diseño es elegir qué sesgos se lidiarán.
La idea, con una imagen. La escalera: ensayo aleatorizado (experimento) → cohortes (se sigue a expuestos y no expuestos hacia adelante) → casos-controles (se mira hacia atrás desde el desenlace) → transversal (una sola instantánea) → ecológico (grupos, no individuos) ✓.
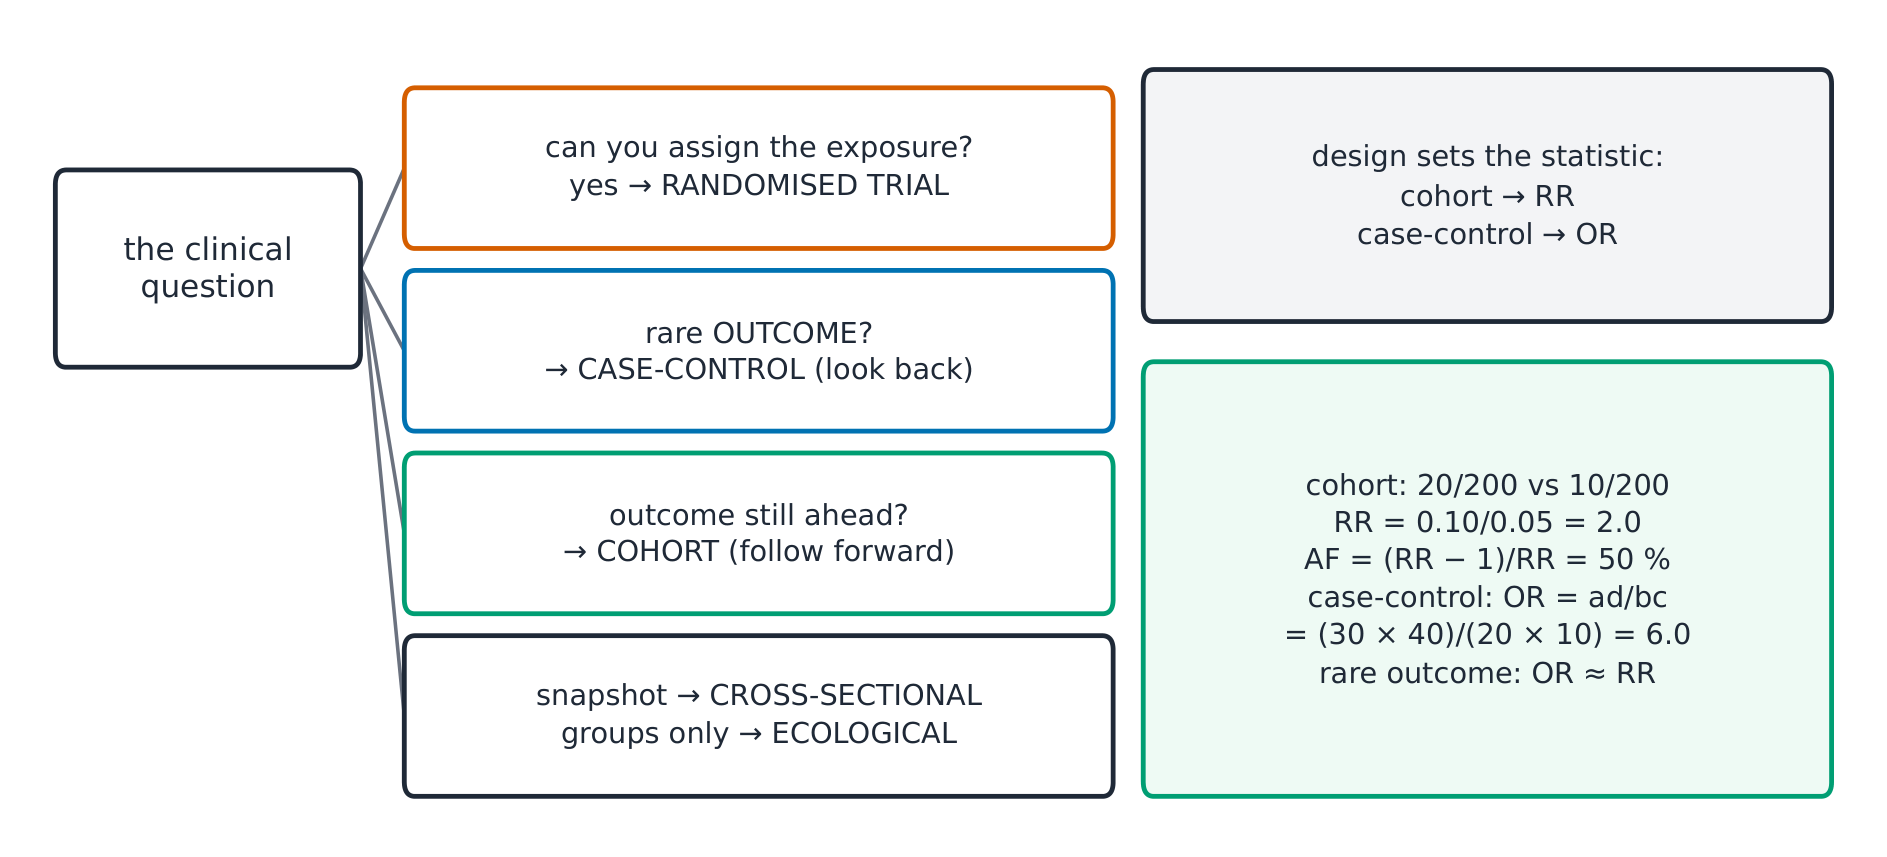
La derivación (por qué RR pertenece a cohortes y OR a casos-controles). Una RESULTADO, por lo que el "riesgo" en cada brazo es un artefacto de la proporción de muestreo — solo el cociente de probabilidades $RR = \frac{a/(a+b)}{c/(c+d)}$ es válido ✓. El diseño dicta la estadística, no la preferencia. only the odds ratio $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ is valid ✓. The design dictates the statistic, not preference.
Worked example 1 — one synthetic cohort. Exposed 200, 20 events; unexposed 200, 10 events: risks 0.10 vs 0.05 → $RR = 2.0$ ✓, attributable Ejemplo resuelto $(RR-1)/RR = 50\ \%$ — enlace clínico: el espejo de casos-controles. (Ficticio) are half "because of" the exposure under the assumptions.
Worked example 2 — clinical link: the case-control mirror. (Fictional) 30 of 40 cases exposed; 20 of 60 controls exposed: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. A rare outcome makes OR approximate RR — one number, exposición, caso-control por resultado; OR de enfermedad rara ≈ RR; atribuible
Errores comunes. Calcular la RR a partir de un estudio de casos y controles (los denominadores son elegidos por el investigador, no se encuentran). Leer una OR transversal como causal (la exposición y el desenlace son simultáneos). Igualar "prospectivo" con "mejor" (una cohorte prospectiva aún puede tener confusión; solo la aleatorización equilibra lo desconocido). "prospective" with "better" (a prospective cohort still confounds; only aleatorización equilibra lo desconocido).
Resumen. Ensayo → cohorte (RR) → casos y controles (OR) → transversal → ecológico; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; las muestras de cohorte se seleccionan por exposure, case-control by outcome; rare-disease OR ≈ RR; attributable fracción $(RR-1)/RR$.
Sesgo, confusión y causalidad
Por qué importa. Los números mienten de tres formas: sistemáticamente (sesgo), a través de una tercera variable (confusión) y por asociación sin causa. Nombrar el modo de fallo es la mitad del análisis crítico. el modo de fallo es la mitad de la evaluación crítica.
La idea, con una imagen. Sesgo es error sistemático en el diseño o medición: sesgo de selección (quién entra), sesgo de información/recuerdo (qué se recuerda o registra). Confusión es una tercera variable vinculada a ambas, exposición y desenlace, que finge ser la causa ✓.
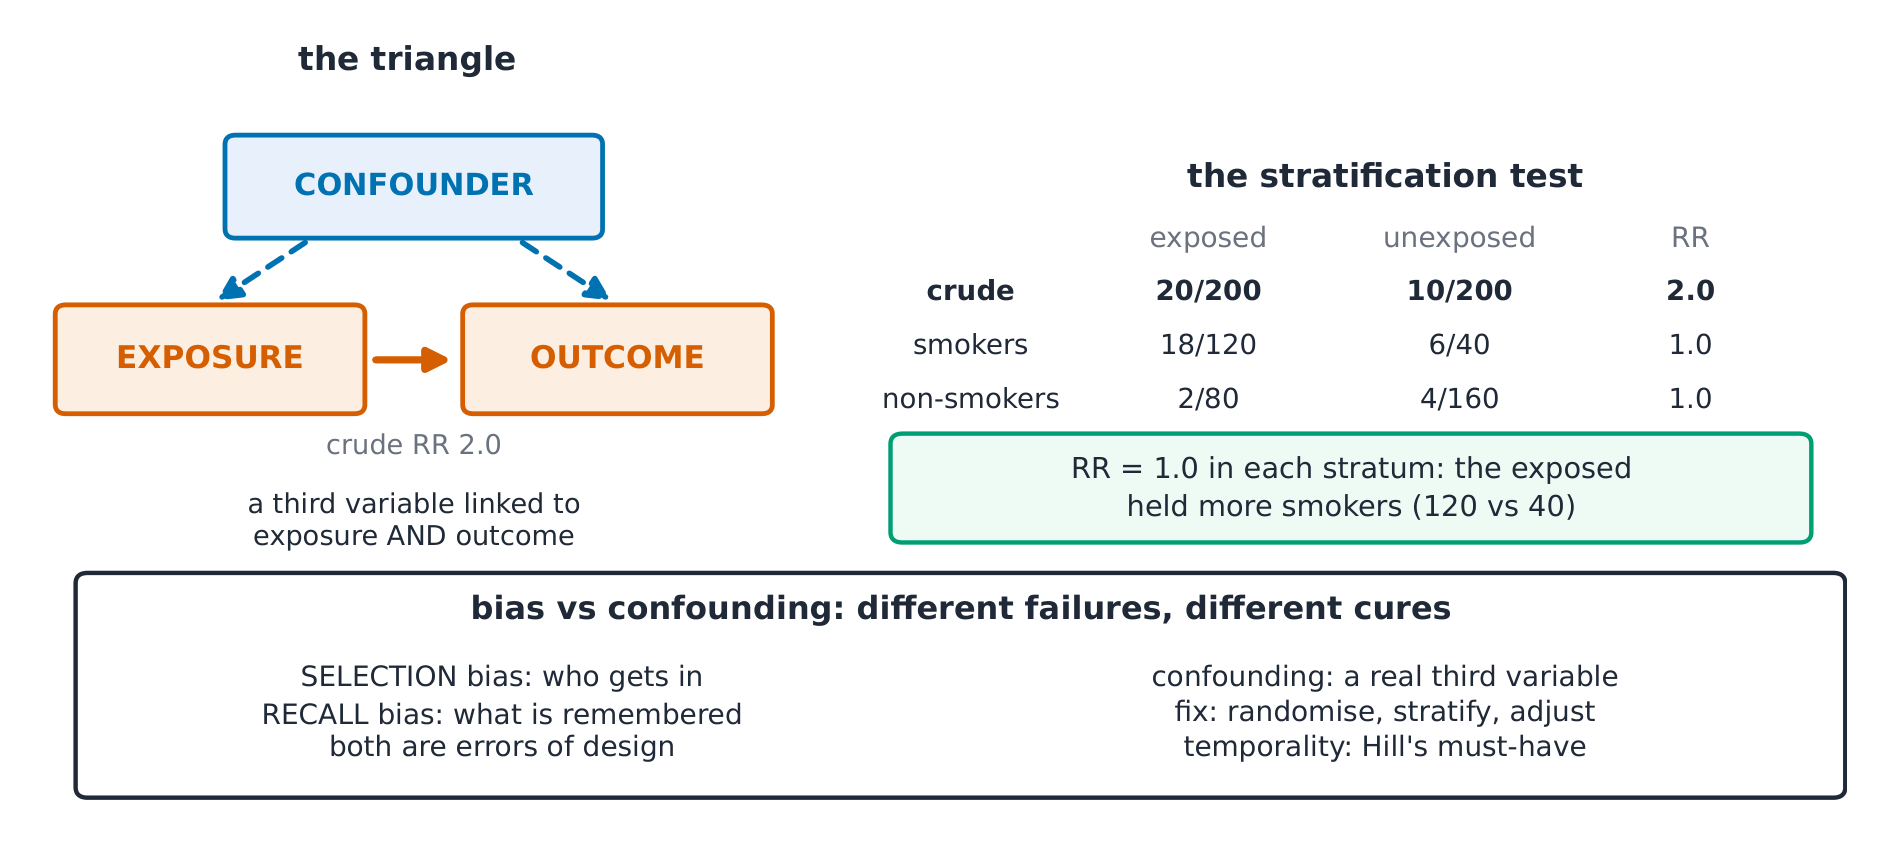
La derivación (por qué la estratificación es la prueba). Si una tercera variable es el verdadero impulsor, la asociación debería desaparecer dentro de los estratos donde está controlada bruto: constante $RR$ 2.0, pero dentro de no fumadores $RR$ 1.0 y dentro de fumadores $RR$ 1.0 → el tabaquismo fue el factor de confusión ✓. Si la asociación persiste dentro de los estratos (por ejemplo, 2.0 y 1.9), la exposición mantiene su propia señal. La aleatorización evita el sesgo de confusión de forma prospectiva al equilibrar incluso las variables desconocidas ✓.
Ejemplo resuelto 1 — tabla estratificada. (Sintético) bruto: expuestos 20/200 eventos vs no expuestos 10/200 → RA 2.0. Estratificar por tabaquismo: no fumadores 6/100 vs 3/100 (RR 2.0 ✓ dentro), fumadores 14/100 vs 7/100 (RA 2.0) — la asociación sobrevive a la estratificación: el tabaquismo NO fue el factor de confusión aquí; la señal de la exposición se mantiene. Ahora aplique la misma tabla bruta tabla a un desglose diferente — expuestos: 120 fumadores (18 eventos) y 80 no fumadores (2 eventos); no expuestos: 40 fumadores (6 eventos) y 160 no fumadores (4 eventos). El riesgo en fumadores es del 15 % en ambos brazos y non-smokers' 2.5 % in both, so RR is 1.0 inside each stratum: the grupo expuesto simplemente contenía más fumadores, y el tabaquismo SÍ fue el factor de confusión ✓. Una sola tabla bruta, dos veredictos — solo los estratos pueden distinguirlas.
Ejemplo resuelto 2 — enlace clínico: preguntas de evaluación. (Abstracto ficcional) "los bebedores de café tenían el doble de riesgo": pregunte quién fue estudiado (selección), cómo se midió la exposición (recordatorio — los pacientes con enfermedad recuerdan de forma diferente), y cómo debería verse un factor de confusión (asociado con el café Y con el desenlace, como el tabaquismo). Bradford Hill's puntos de vista — temporalidad primero, luego fuerza, consistencia, relación dosis-respuesta, plausibilidad — convierte un titular en una lista de verificación ✓.
Errores comunes. Tratar la confusión y el sesgo de medición como un solo problema (la confusión es una mezcla de efectos a través de una tercera variable, corregida mediante aleatorización, estratificación o ajuste; los sesgos de selección e información son errores sobre quién se estudia y cómo se miden las cosas, lo cual ningún análisis corrige completamente). Esperar que los grandes datos curen la confusión (mayor precisión alrededor de una estimación sesgada). Exigir cada punto de vista de Hill (son puntos de vista, no un marcador de puntuación; la temporalidad es lo único innegociable).
Resumen. Sesgo = error sistemático (selección, información/recuerdo); confundidor = tercera variable en ambas trayectorias; la prueba de estratificación anula la asociación si hay confusión; la aleatorización equilibra lo desconocido; los puntos de vista de Hill con la temporalidad primero.
Pruebas diagnósticas
Por qué importa. Los números de una prueba no son propiedades exclusivas de esta — la sensibilidad y especificidad pertenecen a la prueba, pero los valores predictivos pertenecen a la población que la utiliza. Malinterpretar esto es el error cuantitativo más común en el razonamiento clínico.
La idea, con una imagen. El 2×2: sensibilidad = a/(a+c) (enfermo, prueba positiva); especificidad = d/(b+d) (sano, prueba negativa); VPP = a/(a+b), VPN = d/(c+d) — y el árbol de frecuencia natural muestra por qué la prevalencia mueve los valores predictivos ✓.

La derivación (por qué la prevalencia impulsa el VPP). VPP = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. Con Se = Sp = 90 %: a una prevalencia de 10 %, el VPP = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — incluso una prueba excelente es como lanzar una moneda en una clínica con baja prevalencia. El brazo de falsos positivos se escala con la mayoría sana. el brazo escala con la mayoría sana.
Ejemplo resuelto 1 — el árbol de frecuencias naturales (sintético). 1,000 personas, sanos → 10 verdaderos negativos, 100 falsos positivos ✓. VPP = 90/10 = 900 %; sano → 810 verdaderos negativos, 90 falsos positivos ✓. VPP = 90/180 = 50 %; VPN = 810/820 = 98.8 % ✓. Mismo test con prevalencia 1 %: 9 VP vs 99 VF → VPP 9/108 = 8.3 % ✓ — un árbol, dos mundos.
Ejemplo resuelto 2 — vínculo clínico: el cociente de verosimilitud viaja. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: un resultado positivo multiplica las probabilidades previas al diagnóstico en 9 independientemente de la prevalencia clínica. Probabilidades previas 1:9 (10 %) → posteriores 9:9 = 1:1 → probabilidad 50 % — la misma VPP, derivada en una línea. Cocientes de verosimilitud (CV) son la forma portátil del test; los valores predictivos son locales.
correcta sobre un 90 % de los ENFERMOS — digamos de qué). Aplicar un VPP de libro de texto a correcto sobre el 90 % de los ENFERMOS — digamos, de qué). Aplicar una VPP de libro de texto a una clínica con diferente prevalencia. Confundir las dos columnas (sensibilidad se lee hacia abajo en la columna enferma; especificidad hacia abajo en la columna sana).
Resumen. Se = a/(a+c), Sp = d/(b+d) — propiedades de la prueba; PPV/NPV — propiedades poblacionales, varían con la prevalencia; los árboles de frecuencia natural lo hacen visible; $LR+ = Se/(1-Sp)$ multiplica las probabilidades portátiles (0.9/0.1 = 9); 50 % PPV en 10 % de prevalencia a pesar de que Se = Sp = 90 %.
Inferencia estadística para datos clínicos
Por qué importa. La inferencia es cómo una muestra habla sobre una población — y la lectura errónea de valores p e intervalos de confianza son los errores característicos de la literatura moderna.
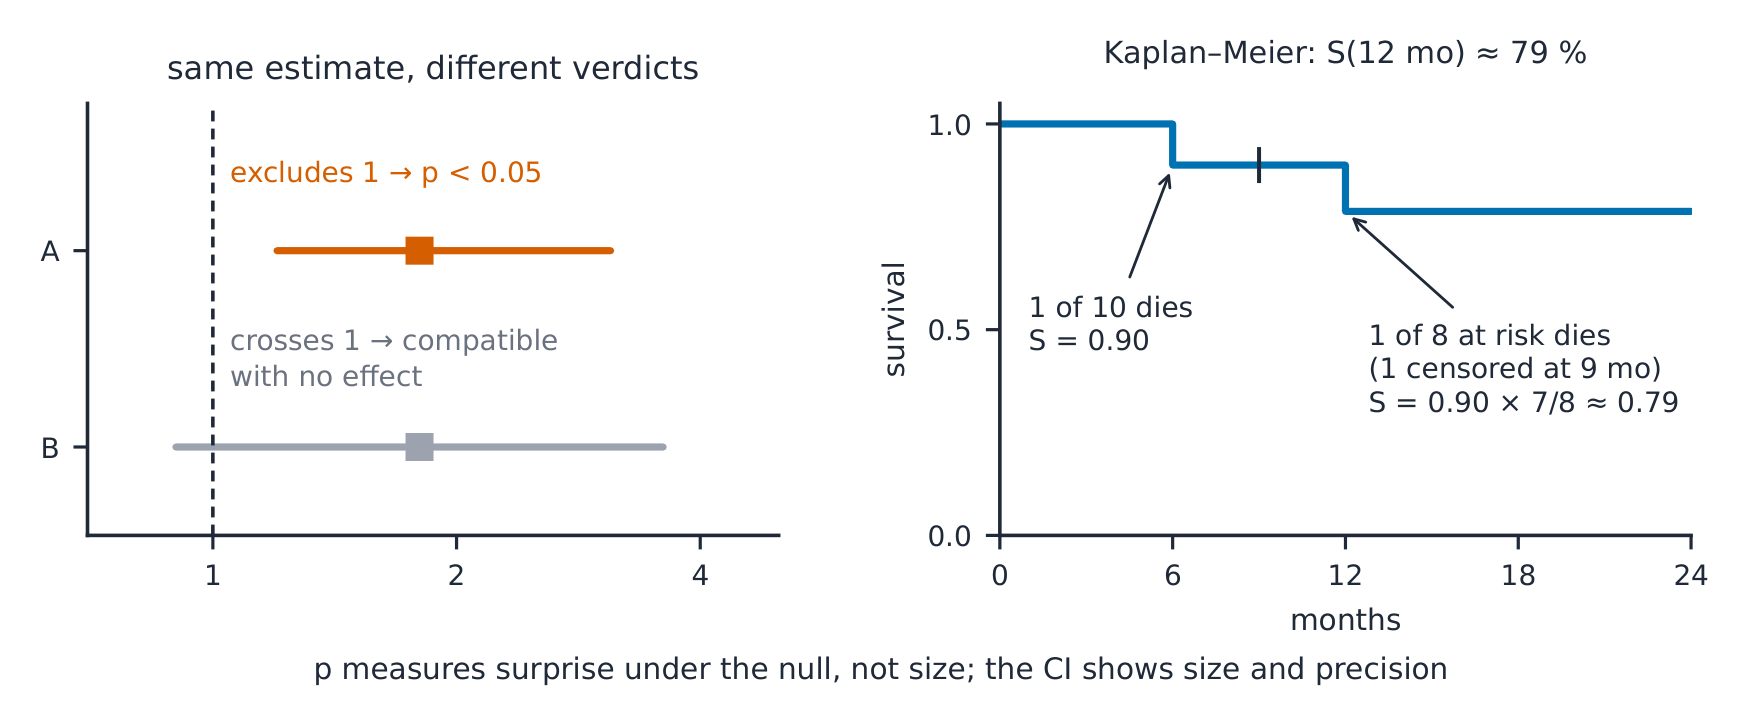
La idea, con una imagen. Un intervalo de confianza del 95 % es el rango de valores verdaderos compatibles con los datos en ese nivel; un valor p P es la probabilidad de obtener datos al menos tan extremos SI la hipótesis nula fuera verdadera ✓. El IC resume magnitud y precisión; el valor p solo resume la sorpresa.
La derivación (por qué la prueba se adapta al tipo de dato). Conteos por grupo → χ²; dos medias (aproximadamente normales) → prueba t (pareada cuando cada fila se mide dos veces); varias medias → ANOVA; distribuidas asimétricamente/muestra pequeña → rangos (alternativas no paramétricas) alternativas; dos mediciones continuas → correlación (Pearson, o Spearman para rangos) ✓. La escala de medición decide la prueba — decidir después observar los resultados invita a formular la pregunta incorrecta.
Ejemplo resuelto 1 — lectura de un intervalo. (Abstracto ficticio) RR 1.8, IC 95 % CI 1.2–3.1: el intervalo excluye 1, por lo que los datos son incompatibles con "ningún efecto" en este nivel (p < 0.05 sigue); el ancho indica que la estimación es imprecisa pero consistentemente superior a 1 ✓. Un RR 1.8 con IC 0.9–3.6 sugiere lo opuesto — misma estimación puntual, diferente conclusión, y solo el intervalo lo revela.
Ejemplo resuelto 2 — vínculo clínico: aritmética de Kaplan–Meier. (Sintético) 10 pacientes inscritos; a los 6 meses se registró 1 evento entre 10 en riesgo: $S = 9/10 = 0.90$; a los 12 meses se registró 1 evento entre los 8 aún en riesgo (uno censurado): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. La supervivencia mediana es el tiempo en que la curva cruza 50 %; el censura elimina personas del denominador, no de la lógica de la estimación.
Errores comunes. "p > 0.05 significa ausencia de diferencia" (significa que los datos son compatibles con ausencia de diferencia — la falta de evidencia no equivale a evidencia de ausencia). Interpretar el IC como una probabilidad del 95 % de que la verdad esté dentro (el intervalo es una propiedad del procedimiento, aplicado a la estimación de esta muestra). Seleccionar la prueba después de ver cuál arroja p < 0.05.
Resumen. IC = verdades compatibles, refleja magnitud y precisión; p-valor = P(datos tan extremos | nula); nunca "demostrado" o "sin efecto" basándose únicamente en p; χ²/t/ANOVA/rango/correlación elegidos según el tipo de datos; la curva de Kaplan–Meier se multiplica (1 − eventos/en riesgo); mediana = 50 % de cruce.
Ensayos clínicos y revisiones sistemáticas
Por qué es importante. Los ensayos son el mecanismo de prueba y las revisiones son su ensamblaje: el vocabulario (randomización, enmascaramiento, ITT, NNT) es lo que todo resumen y todo gráfico de bosque asume que conoces.
La idea, con una imagen. La columna vertebral de un ensayo: elegibilidad → randomización (asignación al azar, asignación oculta) → enmascaramiento (participante, clínico, evaluador de resultados) → análisis por intención de tratar (analizar según fue randomizado, todos incluidos) ✓. Las revisiones agrupan en un gráfico de bosque: cuadrados (tamaño = peso), líneas (IC), rombo (agrupado) y heterogeneidad $I^2$ ✓.
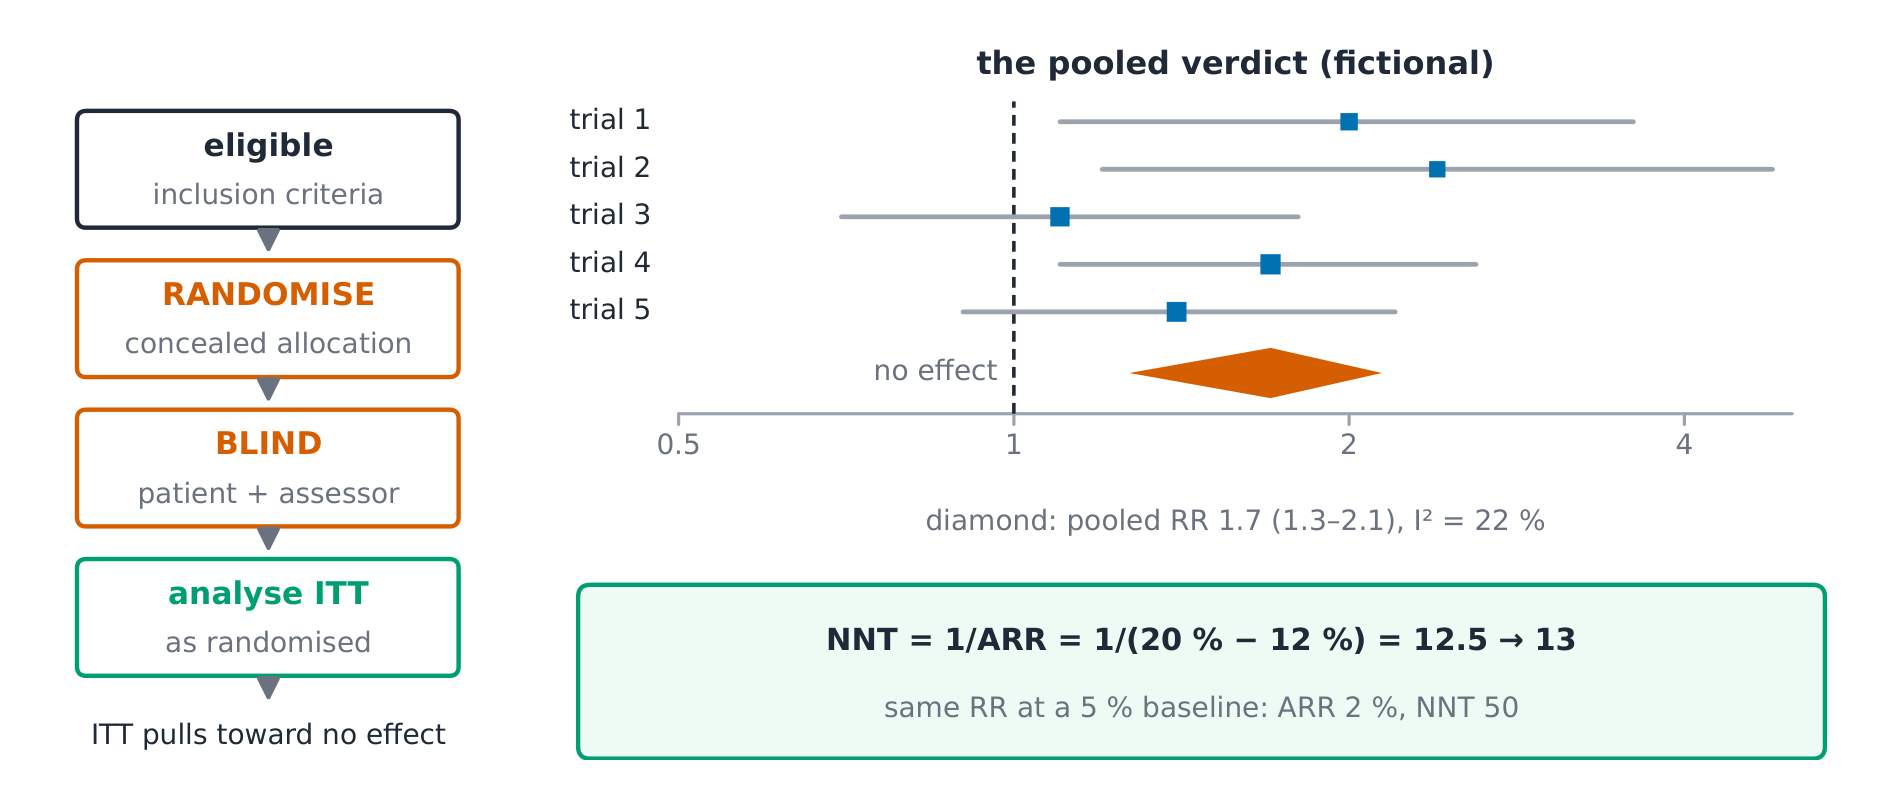
La derivación (por qué NNT es el tamaño clínico del efecto). NNT = $1/ARR$: tasa de eventos en control 20 %, tratado 12 % → RRA 8 % → NNT = 1/0.08 = 12.5 → 13 personas tratadas para que una se beneficie ✓. El NNT convierte una razón abstracta en carga de trabajo: y su denominador (IAR) disminuye cuando el riesgo basal baja, por lo que los resultados de los ensayos no se trasladan a clínicas de menor riesgo sin ajustes.
Ejemplo resuelto 1 — la lógica ITT. (Ensayo ficticio) 20 % control vs 12 % tratado: RRA 8 %, NNT 13 ✓. Si 30 % del brazo tratado abandonaron su asignación temprana, laITT aún los considera como tratados — diluyendo el aparente efecto hacia la nula — porque la pregunta es sobre la POLÍTICA de asignación, no sobre la biología del adherente ✓. El análisis por protocolo responde una pregunta diferente y hereda el sesgo de adherencia.
Ejemplo resuelto 2 — vínculo clínico: leer el diamante. (Ficticio) (bosque) cinco ensayos, RR individuales 1.1–2.4 con IC amplios, RR agrupado 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: el rombo se sitúa a la derecha de 1 y su intervalo El mismo rombo con 1 provocaría "¿por qué discrepan estos ensayos?" antes de confiar en cualquier combinación. El mismo rombo con $I^2 = 78\ \%$ provocaría "¿por qué estos ensayos Resumen. Aleatorizar (oculto) → enmascarar → analizar según asignación original (ITT,
Errores comunes. Igualar la aleatorización con el enmascaramiento (la azaroso equilibra grupos; el enmascaramiento equilibra las expectativas — un ensayo puede tener uno solo). reducen el ARR e inflan el NNT. protección). Tratar el rombo agrupado como verdad absoluta a pesar de una alta heterogeneidad.
Resumen. Aleatorizar (oculto) → enmascarar → analizar según asignación aleatoria (ITT, diluye hacia nulo); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); bosque: cuadrados ponderados, rombo agrupado, discrepancia en $I^2$; clínicas con baja tasa base reducen el ARR e inflan el NNT.
Evaluación crítica y aplicación de evidencia
Por qué es importante. La evidencia se convierte en medicina solo en la cabecera del paciente: valorada para su validez, cuantificada por su importancia y adaptada al paciente que tiene frente a usted. Esta unidad es la síntesis del curso.
La idea, con una imagen. La columna vertebral de la valoración: PICO (población, intervención, comparación, resultado) que establece el marco → validez (¿hubo sesgo en los resultados?) → magnitud (¿cuánto, qué precisión?) → aplicabilidad (¿mi paciente se asemeja a la población estudiada?) ✓. Clasificación de certeza (GRADE): la evidencia randomizada comienza alta y la observacional baja; se reduce ante riesgo de sesgo, inconsistencia, indirectividad, imprecisión o sesgo de publicación; se incrementa ante efectos grandes o gradiente dosis-respuesta ✓. La pirámide clasifica la susceptibilidad promedio al sesgo, no la verdad de cada estudio —un ensayo defectuoso puede engañar más que una buena cohorte La derivación (por qué la jerarquía es un punto de partida, no un veredicto). Los diseños difieren en su control TÍPICO del sesgo: la aleatorización equilibra factores de confusión medidos y no medidos; las cohortes presentan confusión; los estudios caso-control añaden
 sesgo de recuerdo ✓. Sin embargo, la jerarquía evalúa la clase de diseño, mientras que el veredicto corresponde al estudio concreto —un ensayo pequeño, sin cegamiento y analizado según protocolo
puede merecer menos confianza que una cohorte grande pre-registrada con ajuste de propensión. GRADE existe precisamente porque la clase de diseño es solo el punto de partida. medidos y no medidos; las cohortes presentan confusión; los estudios caso-control añaden sesgo de memoria ✓. Pero la jerarquía clasifica el diseño, mientras que el veredicto pertenece al estudio concreto — un pequeño ensayo sin enmascaramiento, analizado por protocolo, puede merecer menos confianza que una cohorte grande pre-registrada con ajuste de propensión. GRADE existe precisamente porque la clase del diseño es solo el punto de partida.
Ejemplo resuelto 1 — un resumen ficticio en cinco preguntas. (Ficticio) "Aleatorizado, doble ciego, n = 400; RR 0.75 (0.60–0.94)": validez — aleatorizado y enmascarado ✓; magnitud — 25 % de reducción relativa, intervalo excluye 1; aplicabilidad local — ¿se incluyeron pacientes como el mío (edad, gravedad, medicaciones coadyuvantes)?; resultados — ¿relevantes para el paciente o sustitutos?; certeza — ¿hay factores de disminución? Cinco preguntas, un veredicto estructurado ✓.
Ejemplo resuelto 2 — vínculo clínico: trasplantar la NNT. (Ficticio) a ensayo en enfermedad grave (línea base 20 %, ARR 8 %, NNT 13); mi paciente de clínica tiene una línea base del 5 %: con la misma reducción de riesgo relativo, el ARR se escala al $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. El efecto relativo puede trasladarse; la carga absoluta — la carga de trabajo y la aritmética beneficio-riesgo — es local.
Errores comunes. Evaluar solo por validez (un efecto válido pero pequeño sigue siendo inútil: la magnitud y la precisión determinan la importancia). Calificar por revista o etiqueta de diseño por sí solas (GRADE parte de ahí y avanza con las deficiencias de la evidencia). Aplicar promedios grupales al paciente cuya característica definitoria fue un criterio de exclusión.
Resumen. PICO → validez → magnitud → aplicabilidad; GRADE: comenzar desde diseño, disminuir por sesgo/inconsistencia/indirecta/imprecisión, aumentar para efectos grandes; la pirámide es una predeterminación, no un veredicto; los efectos relativos se trasladan, los beneficios absolutos (ARR, NNT) son locales — recalcular antes de aplicar.