| English | 释义 | 拼音 |
|---|---|---|
| CISC/sɪsk/ | 复杂指令集 | fù zá zhǐ lìng jí |
| RISC/rɪsk/ | 精简指令集 | jīng jiǎn zhǐ lìng jí |
| pipelining/ˈpaɪplaɪnɪŋ/ | 流水线 | liú shuǐ xiàn |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | 弗林分类 | fú lín fēn lèi |
| register/ˈredʒɪstə/ | 寄存器 | jì cún qì |
| ALU/ˌeɪ el ˈjuː/ | 算术逻辑单元 | suàn shù luó jí dān yuán |
| hazard/ˈhæzəd/ | 冒险 | mào xiǎn |
| SIMD/ˈsɪmdiː/ | 单指令多数据 | dān zhǐ lìng duō shù jù |
| MIMD/ˈmɪmdiː/ | 多指令多数据 | duō zhǐ lìng duō shù jù |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 大规模并行 | dà guī mó bìng xíng |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | 超级计算机 | chāo jí jì suàn jī |
你口袋里的手机跑的不是英特尔
- 三十年里,最快的处理器就是最复杂的那些:增加指令,让每条指令做更多的事。英特尔靠这个建起了一个帝国。
- 后来一家英国小公司把一颗刻意做得简单的处理器放进了手机。指令更少、长度全都一样、几乎没有一条碰内存。它每条指令做的事更少,却还是赢了。
- 它赢是因为简单、统一的指令可以被重叠执行,而重叠比复杂更值钱。
- 这一课讲 CISC(复杂指令集)和 RISC(精简指令集)、流水线(pipelining)、弗林分类的四种架构,以及处理器的发热与速度极限通向何处。
CISC 与 RISC
- CISC(复杂指令集计算机)有许多、往往很复杂的指令:一条可能执行多次内存访问和多个操作。它们长度可变,所以译码很复杂。它靠硬件让每条指令做更多事。例子:Intel x86。
- RISC(精简指令集计算机)有一小组简单指令,每条只做一个基本操作,全部定长、译码很快。只有 load 和 store 碰内存;其余都是寄存器(register)到寄存器。例子:ARM。
- RISC 的程序更长,但每条指令又快又可预测,而这正是流水线所需要的。
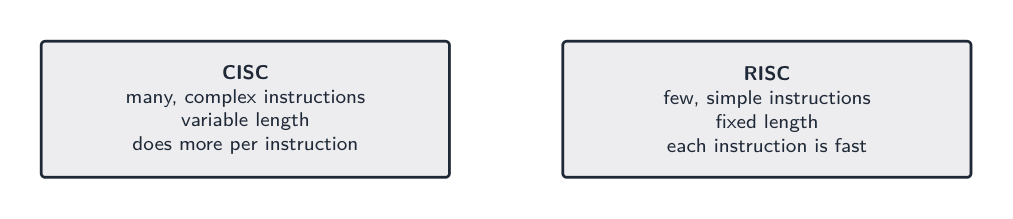
每条指令做得更多,还是每条指令更快更可预测
A RISC processor is characterised by:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
RISC keeps instructions few, simple and fixed-length (usually 1 cycle); CISC has many complex variable-length ones.
考试要考的区别
| 特征 | CISC | RISC |
|---|---|---|
| 指令集 | 多而复杂 | 少而简单 |
| 指令长度 | 可变 | 定长 |
| 内存访问 | 许多指令都可访问内存 | 只有 load 和 store |
| 寄存器 | 较少 | 很多 |
| 每条指令的周期数 | 不一 | 通常一个 |
| 流水线 | 较难 | 天然适合 |
- 现代英特尔芯片在内部把自己的 CISC 指令翻译成更简单的类 RISC 微操作,这是这场争论谁赢了的最清楚的证据。
Match each term to its description.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
RISC = simple + fixed-length + load/store; CISC = complex + variable-length; pipelining overlaps stages for speed.
In a RISC processor, the only instructions that access memory are load and ____.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Everything else is register to register. That restriction is what makes instructions fixed-length, uniform in timing and easy to pipeline.
流水线
- 流水线以重叠的阶段处理指令,像装配线一样:取指、译码、在算术逻辑单元(ALU)中执行、访存、写回。
- 每个阶段同时在处理不同的指令,所以流水线一旦填满,每个周期完成一条指令。
- 它不让任何单条指令变快。它提高的是吞吐量:每秒完成的指令更多。
- RISC 定长、简单的指令让每个阶段耗时相同,这就是 RISC 流水线干净、而 CISC 不干净的原因。
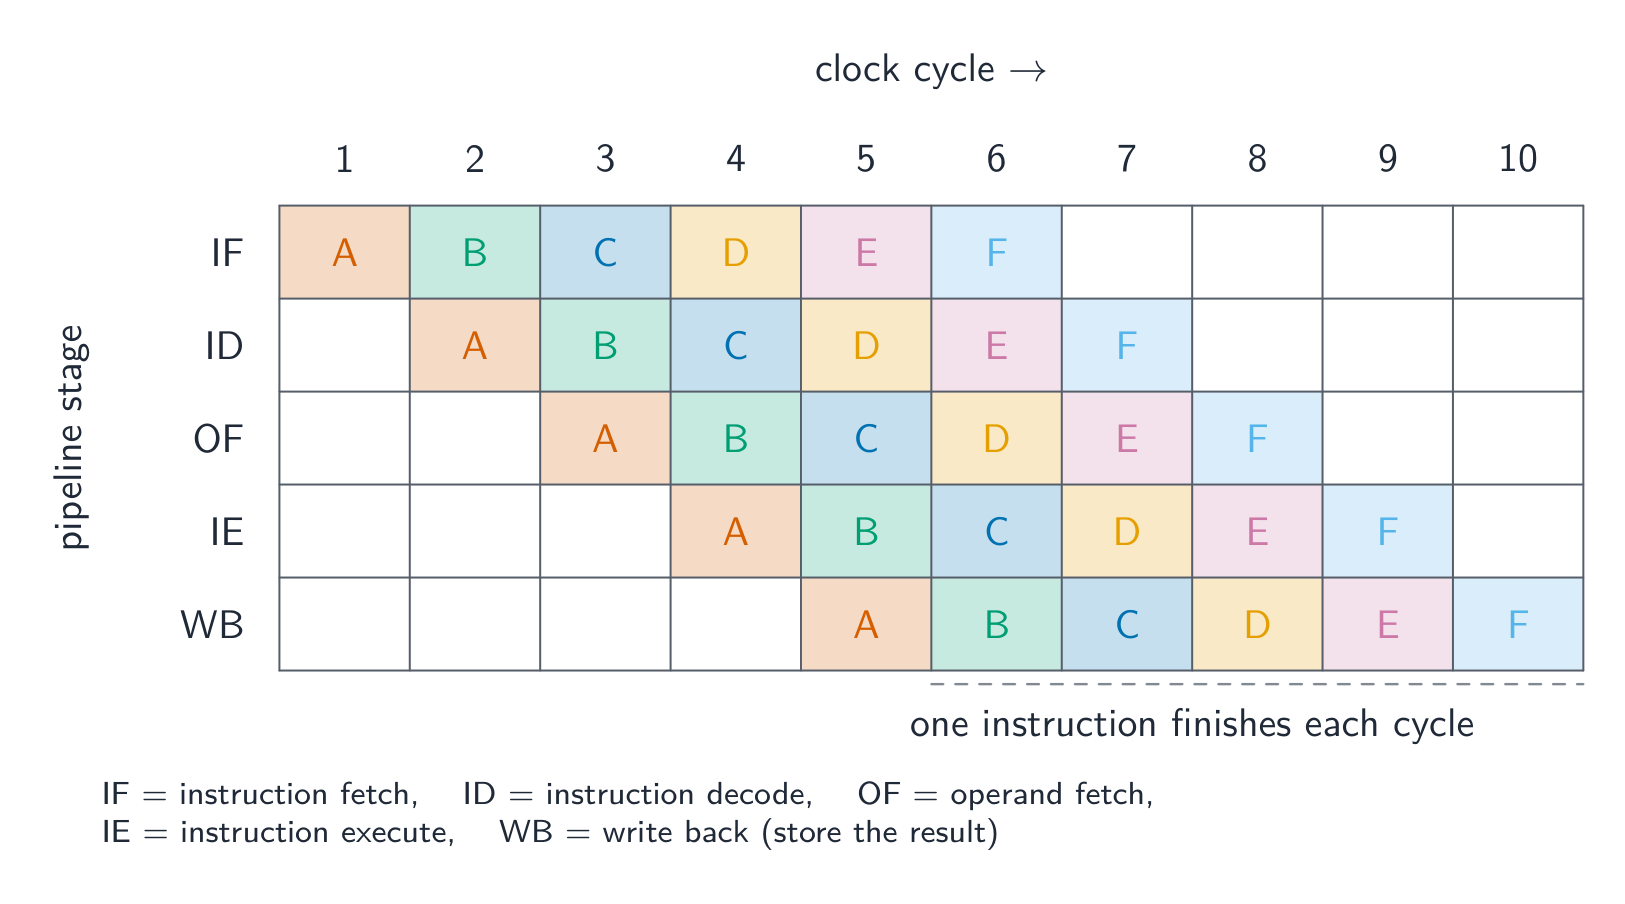
六条指令同时在途,每个周期完成一条
How pipelining fills up
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap.
When a pipeline is full, it completes about:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Overlapping the stages means a new instruction finishes each cycle once the pipeline is full.
Pipelining speeds up a processor by:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Stages of different instructions run at the same time.
例题:流水线为什么更快
- 一条五级流水线每级一个周期。解释它为什么比一条接一条地执行指令更快。
- 没有流水线时,每条指令占用处理器全部五个阶段,所以每五个周期完成一条。
- 有流水线时,取指部件在当前指令还在译码时就开始取下一条,所以同时有五条指令在进行;一旦填满,每个周期完成一条。
- 没有任何单条指令执行得更快;吞吐量提高了约五倍。要明确说出这一点:这是最常被漏掉的一分。
What does pipelining actually improve?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Stages overlap, so five instructions are in progress at once and one completes per cycle. No individual instruction is executed any faster.
冒险
- 冒险(hazard)会让流水线停顿。数据冒险发生在一条指令需要前一条尚未产生的结果时,它必须等待。
- 控制冒险发生在分支处:在分支结果确定之前,处理器不知道下一条该取哪条指令。
- 两者都浪费周期,这就是处理器要预测分支、并在各级之间转发结果的原因。
A data hazard stalls the pipeline when an instruction needs a result that is not ready yet; a control hazard comes from a branch changing which instruction runs next.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Hazards force the pipeline to stall (or flush), which is why they reduce the ideal one-per-cycle throughput.
Match each pipeline hazard to what causes it.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Both stall the pipeline and waste cycles, which is why processors forward results between stages and predict branches.
弗林分类
- 弗林分类(Flynn's taxonomy)按指令流和数据流的数量对计算机分类。
- SISD:一条指令流、一条数据流,传统的单核。
- SIMD(单指令多数据):一条指令同时作用于许多数据项。这就是 GPU 或 CPU 的向量部件,适合图像、视频和科学数组。
- MISD:对同一数据做几种操作;罕见,基本是理论上的。MIMD(多指令多数据):许多处理器对不同数据运行不同指令,即多核 CPU 或集群,最通用。
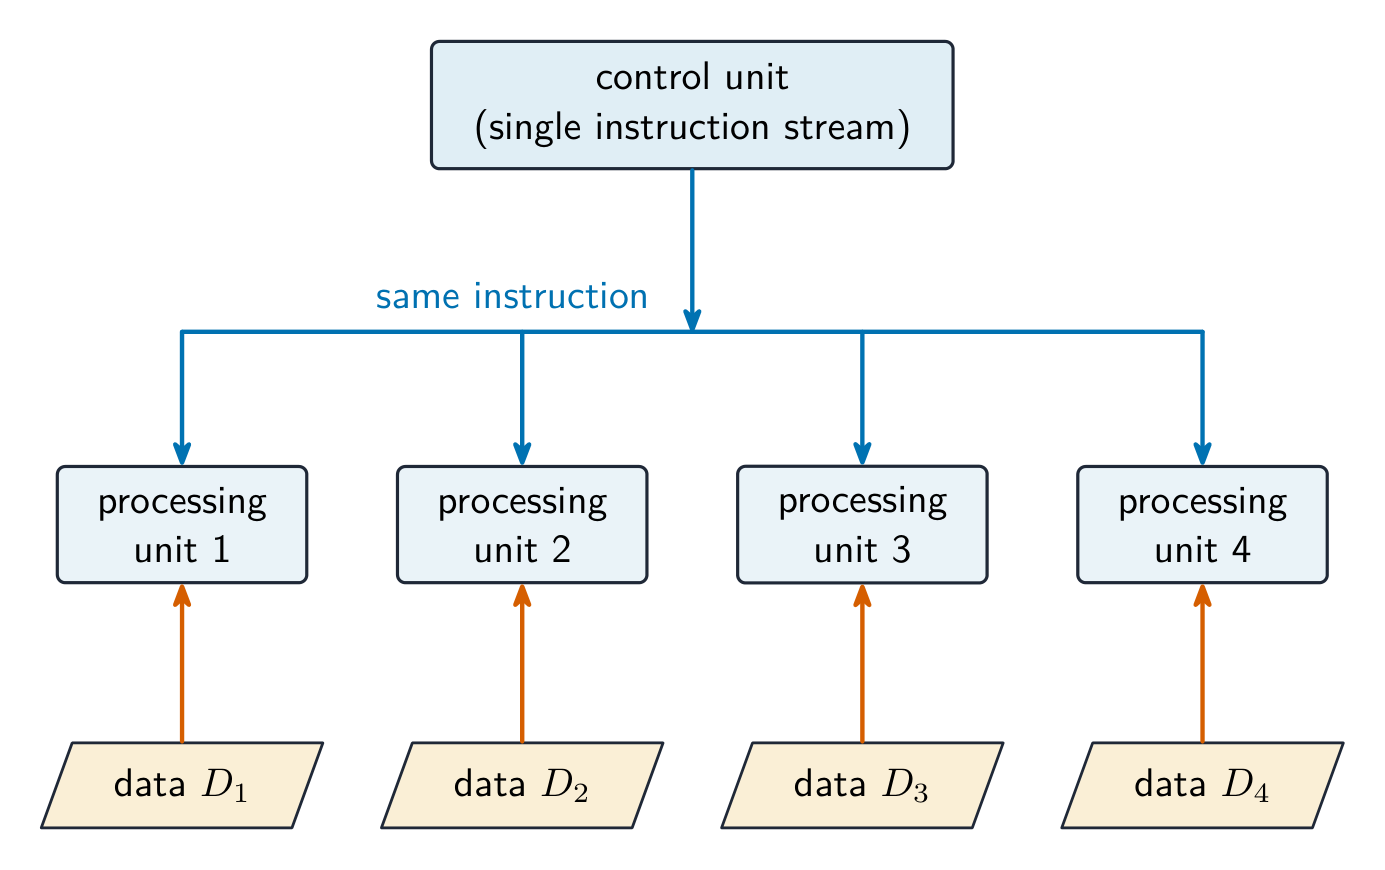
一条指令,许多数据项
Which describe SIMD? Select 所有 that apply.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Different programs on different data is MIMD, the multi-core case. SIMD is one instruction stream over many data streams.
大规模并行计算机
- 大规模并行(massively parallel)系统用数千个处理器通过高速网络连接,每个有自己的内存,靠消息交换数据而不是共享内存。
- 它属于 MIMD,需要专门编写的软件,因为程序员必须划分问题并管理通信。
- 最大的超级计算机(supercomputers)就是这样:气候模拟、大型机器学习训练和天体物理都这样运行。
A massively parallel computer's processors share one block of memory.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Each processor has its own memory, and they exchange data by messages over a fast network. That distributed memory is what the term means.
例题:给机器归类
- 一块显卡对两百万个像素施加同样的亮度调整。 SIMD:一条指令、许多数据项,这正是 GPU 数千个小核心的用途。
- 一台四核笔记本同时运行浏览器、编译器和音乐播放器。 MIMD:不同数据上的不同指令,每核一条流。
- 一个气象中心把大气分成网格,分给一万个处理器,每个有自己的内存,把边界值作为消息传递。 大规模并行,它是 MIMD 的一种形式。
- 说出类别,再用指令流和数据流的数量论证。
容易丢掉的分
- 流水线提高吞吐量;它不缩短任何单条指令。要说出来。
- 在 RISC 中,只有 load 和 store 碰内存。这一个事实解释了定长、多寄存器和干净的流水线。
- SIMD 是一条指令作用于多数据;MIMD 是多指令作用于多数据。回答前先数流。
- 大规模并行意味着数千个处理器加分布式内存和消息传递,不只是"一台很快的计算机"。
你掌握了
- CISC:许多复杂的变长指令,每条做得更多 · RISC:少数简单的定长指令,只有 load 和 store,寄存器多,每条一个周期
- 流水线重叠取指、译码、执行、访存和写回,填满后每周期完成一条:提高吞吐量,不是让指令变快;数据冒险和控制冒险会让它停顿
- 弗林:SISD、SIMD(GPU)、MISD、MIMD(多核)
- 大规模并行:数千处理器、分布式内存、消息传递、属于 MIMD,超级计算机使用它