| English | 释义 | 拼音 |
|---|---|---|
| Unicode/ˈjuːnɪkəʊd/ | 统一码 | tǒng yī mǎ |
| character set/ˈkærɪktə set/ | 字符集 | zì fú jí |
| ASCII/ˈæski/ | ASCII码 | ASCII mǎ |
| encoding/enˈkəʊdɪŋ/ | 编码 | biān mǎ |
| code point/kəʊd pɔɪnt/ | 码点 | mǎ diǎn |
| UTF-8/ˌjuː tiː ˈef eɪt/ | UTF-8编码 | UTF-8 biān mǎ |
变成乱码的那封邮件
- 整个 1990 年代,在华沙敲下、在东京读到的消息常常变成一堵乱码。两台计算机都用八位存一个字符。它们只是对最高的 128 个模式的含义意见不合。
- 波兰的代码页在那里放波兰字母。日本的在那里放自己的字符。传输中什么都没损坏:字节完好地到达,却被对着另一张表来读。
- 解决办法是不再按国家各有一张表,而是给每种文字的每个字符一个永久的号码。这就是 Unicode(统一码),也是你发的表情符号能原样到达的原因。
- 这一课讲文字怎样变成数字:字符集(character set)、ASCII、Unicode,以及存储它们的编码。
字符集给每个字符一个号码
- 计算机不存字母,只存数字。字符集是计算机能表示的字符的集合,每个字符有自己的二进制代码。
- 一个字符的号码是它的码点(code point)。
A是 65,a是 97,数字0是 48。 - 码点不是字符的含义;它是一个约定的标签。文字之所以可读,只因为两台机器用同一个字符集。
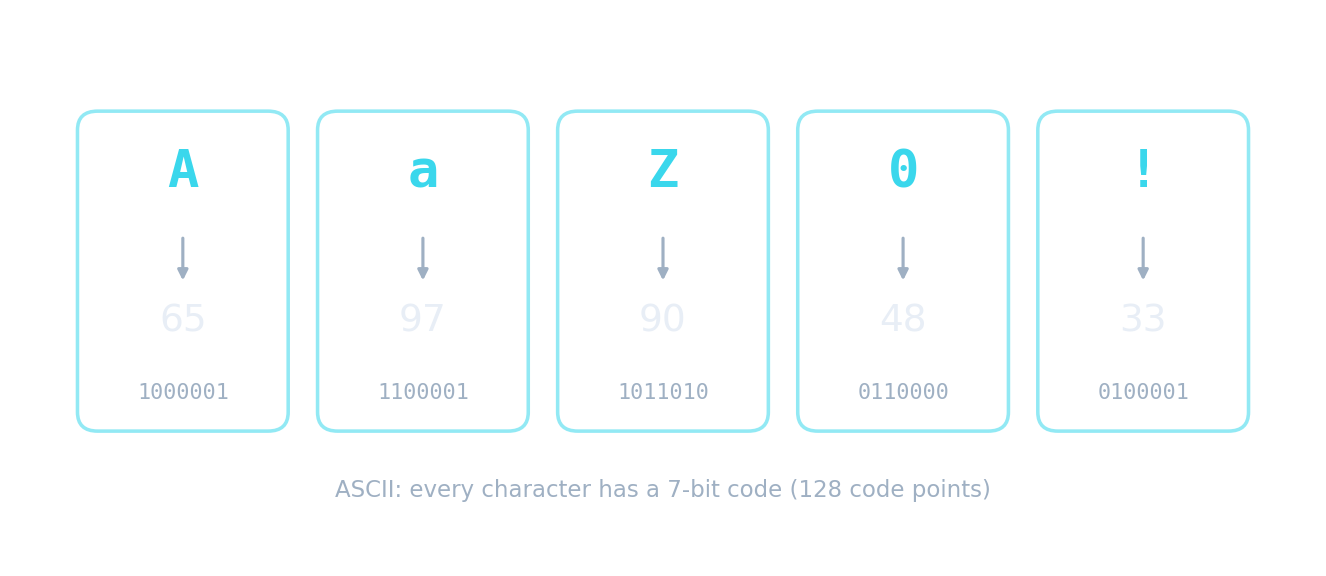
字母是那个图形;字节是那个数字
一个字符被存为一个数
每个字符都有一个代码数字——'A' 是 65。翻转这些位,看那个代码的二进制和十六进制,正是计算机保存它的方式。
一个像 ASCII 这样的字符集定义:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
一个字符集把每个字符映射到一个数字(它的码点),那是计算机实际存储的东西。
ASCII
- ASCII(ASCII码,美国信息交换标准代码)用 7 位,给出 $2^7 = 128$ 个码点:基本拉丁字母、数字、标点,以及回车之类的 32 个控制码。
- 扩展 ASCII 用 8 位,给出 256 个码点。低 128 个与 ASCII 完全相同;高 128 个因地区而异,这正是弄坏那封邮件的东西。
- 从不要求你背下某个代码,但会要求你说出数量:7 位,128;8 位,256。
7 位 ASCII 有多少个不同的码点?
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
7 位给出 $2^7 = 128$ 个码点。
扩展 ASCII 有多少个不同的码点?
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
八位构成$2^{8} = 256$。低$128$位与标准7位ASCII匹配;高$128$位因地区而异。
Unicode
- Unicode 是一个通用字符集:给几乎每种活着或死去的文字中的几乎每个字符一个码点,再加上符号和表情符号,超过 149,000 个。
- 码点与它怎样存储是分开的。编码(encoding)把码点变成字节。
- UTF-8(UTF-8编码)每个字符用 1 到 4 个字节,并且兼容 ASCII:前 128 个码点占一个字节,与 ASCII 完全相同。UTF-16 用 2 或 4 个字节;UTF-32 固定用 4 个。
关于 UTF-8 哪个是真的?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
UTF-8 是一种可变长度的 Unicode 编码(1–4 字节);它的前 128 个码点与 ASCII 匹配,所以纯 ASCII 文本是有效的 UTF-8。
Unicode 和 UTF-8 是什么关系?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
字符集分配号码;编码决定每个号码占多少字节。UTF-16 和 UTF-32 是同一集合的其他编码。
例题:比较 ASCII 和 Unicode
- 给出用 Unicode 代替 ASCII 的一个优点和一个缺点。[2]
- 优点:Unicode 能表示多得多的字符,所以任何文字——中文、阿拉伯文、希腊文——和表情符号都能存储,一份文档里可以混用多种语言;文件可移植,因为没有按国家各异、彼此不合的代码页。
- 缺点:对只有英文的文本,Unicode 文件通常更大,因为一个字符可能占不止一个字节。
- 两半都要有。单说"它字符更多"两分里只得一分。
Unicode 相对 ASCII 的一个关键优点是它:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Unicode 覆盖几乎每一种书写系统加上符号和表情符号——远超 ASCII 的基本英语集。
对于只有英语的文本,一个 Unicode 文件通常比同样文本的 ASCII 更大。
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Unicode 编码每个字符可能用更多字节,所以纯英语文本通常比 7 位 ASCII 更大——通用覆盖的权衡。
Unicode 相对 ASCII 有哪些优点?选出所有适用的。
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
大小是代价,不是好处:对纯英文,Unicode 文件通常更大。
例题:文本文件的大小
- 一条 500 个字符的消息用扩展 ASCII 存储。文件有多少字节?
- 扩展 ASCII 每个字符用 8 位即一个字节,所以 $500 \times 1 = 500$ 字节,或 $500 \times 8 = 4000$ 位。
- *同一条消息用 UTF-32 呢?*每个字符四个字节,所以 2000 字节。
- 写出每字符的位数,相乘,再一次性换算。中途混用位和字节是常见的失分点。
一条 500 字符的消息用扩展 ASCII 存储。需要多少字节(忽略文件头)?
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
每字符占八位(一字节):共$500 \times 1 = 500$字节或$4000$比特。在UTF-32中,相同文本需要$2000$字节。
用二进制和十六进制读一个字符
- 因为码点只是一个数,它像任何数一样转换。
A是 65,二进制是0100 0001,十六进制是41。 - 两个有用的规律:数字
0到9从 48 开始;小写比大写大 32,所以a(97)是A(65)加 32。这个差正好是一位。 - 给出
A= 65 并问E的题,要的是 $65 + 4 = 69$,而不是背下来的表。
A 的 ASCII 码是 65。E 的 ASCII 码是多少?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
字母是连续的,所以 E 在 A 之后四位。除了一个锚点值,什么都不用背。
容易丢掉的分
- ASCII 是 7 位、128 个码点;扩展 ASCII 是 8 位、256 个。不要给普通 ASCII 写 8 位。
- Unicode 是字符集;UTF-8 是它的一种编码。它们不是两个对立的集合。
- UTF-8 是变长的,1 到 4 个字节,不是永远一个,也不是永远四个。
- Unicode 的缺点是纯英文文本的文件大小,不是"它更慢"或"它更难读"。
你掌握了
- 字符集给每个字符一个码点;文字就是数字加上关于怎样读它们的约定
- ASCII:7 位、128 个码点、只有英文 · 扩展 ASCII:8 位、256 个,高半部分因地区而异
- Unicode:每种文字和表情符号各有一个码点,由编码存储;UTF-8 是 1 到 4 字节且兼容 ASCII
- Unicode 换来字符、可移植性和多语言混排;代价是纯英文文本的文件更大