Mã ký tự — ASCII và Unicode
Đã giới thiệu| English | Ý nghĩa |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | Unicode |
| character set/ˈkærɪktə set/ | bộ ký tự |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | mã hóa |
| code point/kəʊd pɔɪnt/ | điểm mã |
| UTF-8/ˌjuː tiː ˈef eɪt/ | UTF-8 |
Email nhận được dưới dạng vô nghĩa
- Trong suốt thập niên 1990, một tin nhắn gõ ở Warsaw và đọc ở Tokyo thường đến dưới dạng một khối văn bản vô nghĩa. Cả hai máy tính đều lưu trữ tám bit cho mỗi ký tự. Chúng đơn giản là không thống nhất về ý nghĩa của 128 mẫu mã cao nhất.
- Bảng mã của Ba Lan đã dành phần đó cho các chữ cái Ba Lan. Bảng mã của Nhật Bản đã dành phần đó cho các ký tự của riêng mình. Không có dữ liệu nào bị lỗi trong quá trình truyền: các byte đến nguyên vẹn nhưng được giải mã dựa trên bảng tra cứu khác.
- Giải pháp là dừng việc sử dụng bảng mã theo từng quốc gia và gán mỗi ký tự trong mọi hệ chữ viết một con số, mãi mãi. Đó chính là Unicode, và đó cũng là lý do biểu tượng cảm xúc bạn gửi đến vẫn hiển thị đúng hình ảnh.
- Bài học này giải thích cách văn bản trở thành số: bảng ký tự, ASCII, Unicode, và các định dạng mã hóa lưu trữ chúng.
Một bảng ký tự gán mỗi ký tự một con số
- Máy tính không lưu trữ chữ cái, chỉ lưu trữ số. Bảng ký tự là tập hợp các ký tự mà máy tính có thể biểu diễn, mỗi ký tự có mã nhị phân riêng.
- Số đại diện cho một ký tự được gọi là mã điểm.
Alà 65,alà 97,0là chữ số thì 48. - Vị trí mã không phải là ý nghĩa của ký tự; nó chỉ là một nhãn quy ước. Văn bản dễ đọc vì cả hai máy đều sử dụng cùng một bảng ký tự.
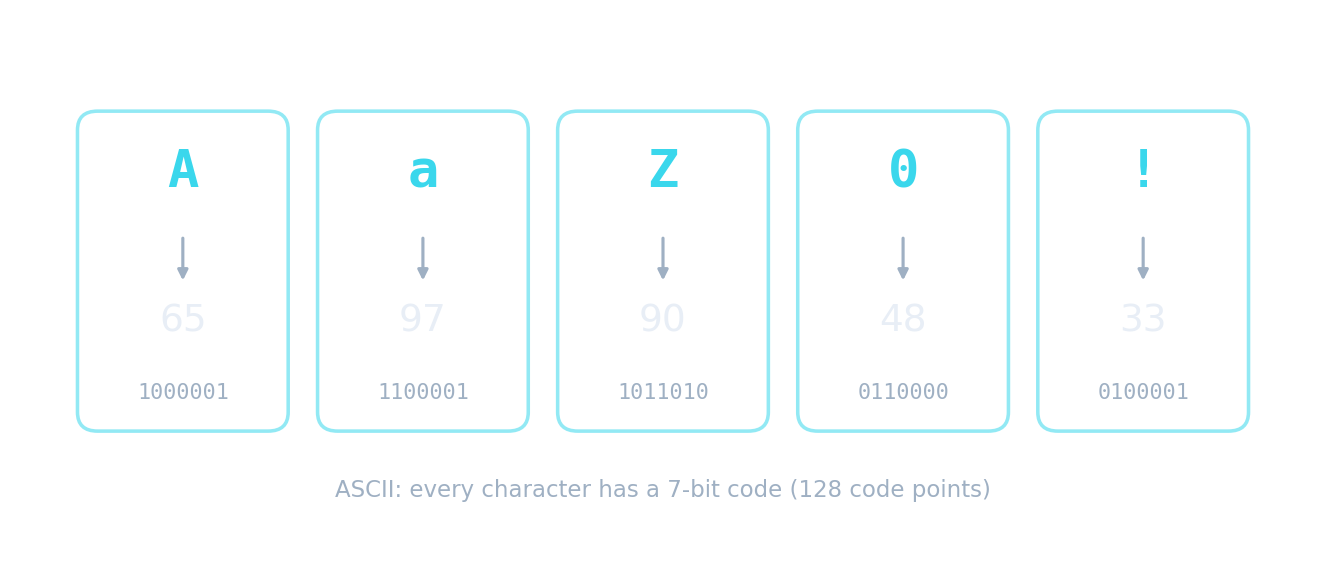
Chữ cái là hình ảnh; byte là con số
Một ký tự được lưu trữ dưới dạng một số
Mỗi ký tự có một mã số — 'A' là 65. Đảo ngược các bit để xem mã này trong nhị phân và thập lục phân, đúng như máy tính lưu giữ nó.
Một tập hợp ký tự như ASCII xác định:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Một tập hợp ký tự ánh xạ mỗi ký tự sang một số (mã điểm của nó), đây chính là thứ máy tính thực sự lưu trữ.
ASCII
- ASCII (American Standard Code for Information Interchange) sử dụng 7 bit, tạo ra $2^7 = 128$ vị trí mã: các chữ cái Latin cơ bản, chữ số, dấu chấm câu, và 32 mã điều khiển như trả về đầu dòng.
- Extended ASCII sử dụng 8 bit, tạo ra 256 vị trí mã. 128 vị trí thấp giống hệt ASCII; 128 vị trí cao khác nhau tùy khu vực, đây chính là nguyên nhân gây ra lỗi email nói trên.
- Bạn không bao giờ được yêu cầu học thuộc các mã, nhưng bạn được yêu cầu đưa ra các con số đếm: 7 bit tương ứng 128; 8 bit tương ứng 256.
7-bit ASCII có bao nhiêu mã điểm khác nhau?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
7 bit cho $2^7 = 128$ mã điểm.
Extended ASCII có bao nhiêu mã điểm khác nhau?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Tám bit cho 2^8 = 256. 128 bit thấp khớp với ASCII 7-bit thuần túy; 128 bit cao khác nhau tùy khu vực.
Unicode
- Unicode là bộ ký tự phổ quát: một mã điểm cho hầu hết mọi ký tự trong mọi hệ chữ viết đang hoặc đã từng tồn tại, cùng các biểu tượng và emoji, hơn 149,000 cái.
- Vị trí mã tách biệt với cách lưu trữ. Một định dạng mã hóa chuyển đổi vị trí mã thành các byte.
- UTF-8 UTF-8 sử dụng từ 1 đến 4 byte cho mỗi ký tự và tương thích ASCII: 128 mã điểm đầu tiên là một byte, giống hệt ASCII. UTF-16 sử dụng 2 hoặc 4 byte; UTF-32 sử dụng cố định 4.
Điều nào đúng về UTF-8?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
UTF-8 là một mã hóa Unicode có độ dài biến đổi (1–4 byte); 128 mã điểm đầu tiên của nó khớp với ASCII, nên văn bản ASCII thuần túy đều hợp lệ UTF-8.
Mối quan hệ giữa Unicode và UTF-8 là gì?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Tập ký tự gán các con số; mã hóa quyết định mỗi con số cần bao nhiêu byte. UTF-16 và UTF-32 là các mã hóa khác của cùng một tập ký tự.
Ví dụ minh họa: so sánh ASCII và Unicode
- Nêu một ưu điểm và một nhược điểm khi sử dụng Unicode thay vì ASCII. [2]
- Ưu điểm: Unicode biểu diễn rất nhiều ký tự hơn, nên văn bản trong bất kỳ hệ chữ viết nào, tiếng Trung, tiếng Ả Rập, tiếng Hy Lạp, và emoji đều có thể được lưu trữ, một tài liệu duy nhất có thể pha trộn nhiều ngôn ngữ; file dễ di chuyển vì không còn sự bất đồng về bảng mã theo từng quốc gia.
- Nhược điểm: đối với văn bản chỉ dùng tiếng Anh, file Unicode thường lớn hơn, vì một ký tự có thể chiếm nhiều hơn một byte.
- Cả hai ý đều cần thiết. Chỉ nêu "có nhiều ký tự hơn" là chỉ đạt một điểm trong tổng số hai điểm.
Một lợi thế chính của Unicode so với ASCII là nó:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Unicode bao phủ gần như mọi hệ thống viết cùng ký hiệu và emoji — vượt xa bộ English cơ bản của ASCII.
Đối với văn bản chỉ bằng tiếng Anh, một file Unicode thường lớn hơn cùng đoạn văn bản đó trong ASCII.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Các mã hóa Unicode có thể sử dụng nhiều byte hơn cho mỗi ký tự, vì vậy văn bản tiếng Anh thuần túy thường lớn hơn so với ASCII 7-bit — đây là sự đánh đổi để có khả năng bao quát toàn cầu.
Những lợi ích nào sau đây là ưu điểm của Unicode so với ASCII? Chọn tất cả các đáp án đúng.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Kích thước là sự đánh đổi, không phải lợi ích: đối với văn bản tiếng Anh thuần túy, một file Unicode thường lớn hơn.
Ví dụ minh họa: kích thước của một file văn bản
- Một tin nhắn gồm 500 ký tự được lưu trữ trong Extended ASCII. File có dung lượng bao nhiêu byte?
- Extended ASCII sử dụng 8 bit, tức một byte cho mỗi ký tự, nên $500 \times 1 = 500$ bytes, hoặc $500 \times 8 = 4000$ bits.
- Tin nhắn tương tự trong UTF-32? Bốn byte cho mỗi ký tự, nên 2000 bytes.
- Hiển thị số bit mỗi ký tự, nhân số, rồi chuyển đổi một lần. Nhầm lẫn giữa bit và byte ở giữa đường là nguyên nhân phổ biến khiến mất điểm.
Một tin nhắn 500 ký tự được lưu trong ASCII mở rộng. Nó cần bao nhiêu byte (bỏ qua bất kỳ tiêu đề nào)?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Tám bit, một byte, cho mỗi ký tự: 500 x 1 = 500 byte, hoặc 4000 bit. Trong UTF-32, đoạn văn bản tương tự cần 2000 byte.
Đọc một ký tự ở dạng nhị phân và thập lục phân
- Vì vị trí mã chỉ là một con số, nó chuyển đổi giống như bất kỳ số nào khác.
Alà 65, tương đương0100 0001trong nhị phân và41trong thập lục phân. - Hai quy luật hữu ích: các chữ số
0đến9chạy từ 48, và chữ thường nhỏ hơn 32 đơn vị so với chữ hoa, nêna(97) bằngA(65) cộng 32. Sự chênh lệch này nằm ở một bit duy nhất. - Một câu hỏi cho bạn biết
A= 65 và yêu cầu tìmEsẽ muốn đáp án $65 + 4 = 69$, chứ không phải bảng tra cứu thuộc lòng.
Mã ASCII cho A là 65. Mã ASCII cho E là gì?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Các chữ cái liên tiếp nhau, nên E nằm sau A bốn bước. Không cần ghi nhớ gì ngoài một giá trị neo.
Điểm số dễ mất
- ASCII là 7 bit và 128 vị trí mã; Extended ASCII là 8 bit và 256. Đừng viết 8 bit cho ASCII thuần túy.
- Unicode là bảng ký tự; UTF-8 là định dạng mã hóa của nó. Chúng không phải là hai bảng cạnh tranh.
- UTF-8 có độ dài thay đổi, từ 1 đến 4 byte, không phải lúc nào cũng một byte và cũng không phải lúc nào cũng bốn byte.
- Nhược điểm của Unicode là kích thước file đối với văn bản tiếng Anh thuần túy, chứ không phải "nó chậm hơn" hay "khó đọc hơn".
Bạn đã nắm vững
- Một bảng ký tự gán mỗi ký tự một vị trí mã; văn bản là tập hợp các con số cộng với thỏa thuận chung về cách đọc chúng
- ASCII: 7 bit, 128 vị trí mã, chỉ tiếng Anh · Extended ASCII: 8 bit, 256, nửa trên khác nhau tùy khu vực
- Unicode: một vị trí mã cho mọi hệ chữ viết và emoji, được lưu trữ qua định dạng mã hóa; UTF-8 có độ dài 1 đến 4 byte và tương thích ASCII
- Unicode thu nhận thêm ký tự, tính di động và hỗ trợ ngôn ngữ hỗn hợp; nhưng làm tăng dung lượng tệp đối với văn bản tiếng Anh thuần túy