หลักสูตรนี้คืออะไร และการใช้หลักสูตรนี้
นี่คือหลักสูตรที่สิบสองใน University Medicine: วิทยาระบาดศาสตร์, สถิติชีวภาพ และ การแพทย์เชิงประจักษ์ (EBM) — เครื่องมือที่แปลงคำถามทางคลินิกให้เป็นตัวเลข และเปลี่ยนตัวเลขให้เป็น การตัดสินใจ ซึ่งสอดคล้องกับเนื้อหาสถิติ UNI-BUS-05 ที่ทบทวนแล้วซึ่ง คณิตศาสตร์มีการทับซ้อนกัน
ขอบเขตของรายวิชา ระบุไว้เพียงครั้งเดียว: เป็นรายวิชาการศึกษา ไม่ใช่ปริญญาแพทยศาสตร์; ทุกกรณีด้านล่างนี้เป็นเรื่องสมมติ และข้อมูลนี้ไม่อนุญาตหรือชี้แนะการรักษา ชุดข้อมูลด้านล่างเป็นข้อมูลสังเคราะห์หรือมีใบอนุญาตเปิด, ทุก abstract ที่ประเมินเป็น เรื่องสมมติ, และไม่มีอะไรในที่นี้ที่อนุญาตหรือแนะนำการรักษา
- หน่วย 12.1–12.3 วัดและเปรียบเทียบ: ความถี่ของโรค, การออกแบบการศึกษา, ความลำเอียงและสาเหตุ
- หน่วย 12.4–12.6 คำนวณ: การทดสอบวินิจฉัย, การอนุมาน, การทดลองและการทบทวน
- หน่วย 12.7 ใช้: การประเมิน, ความมั่นใจ, และผู้ป่วยอยู่หน้าคุณ
นิสัย EBM: ถามด้วย PICO, วัดด้วยความเสี่ยงและอัตราส่วน, ตัดสินใจด้วย ช่วงความเชื่อมั่นไม่ใช่พิธีกรรม — การคำนวณทั้งหมดด้านล่างเป็นข้อมูลสังเคราะห์, ตรวจสอบโดยเครื่อง, และสิ่งที่คุณต้องคำนวณใหม่
การวัดโรค: อัตราการเกิดใหม่และความชุก
ทำไมถึงสำคัญ. ก่อนการเปรียบเทียบใด ๆ โรคต้องถูกนับ — และที่ ตัวชี้วัดคลาสสิกสองแบบตอบคำถามต่างกัน: ความเร็วที่เคสใหม่เกิดขึ้น, และจำนวนที่มีอยู่พร้อมกัน
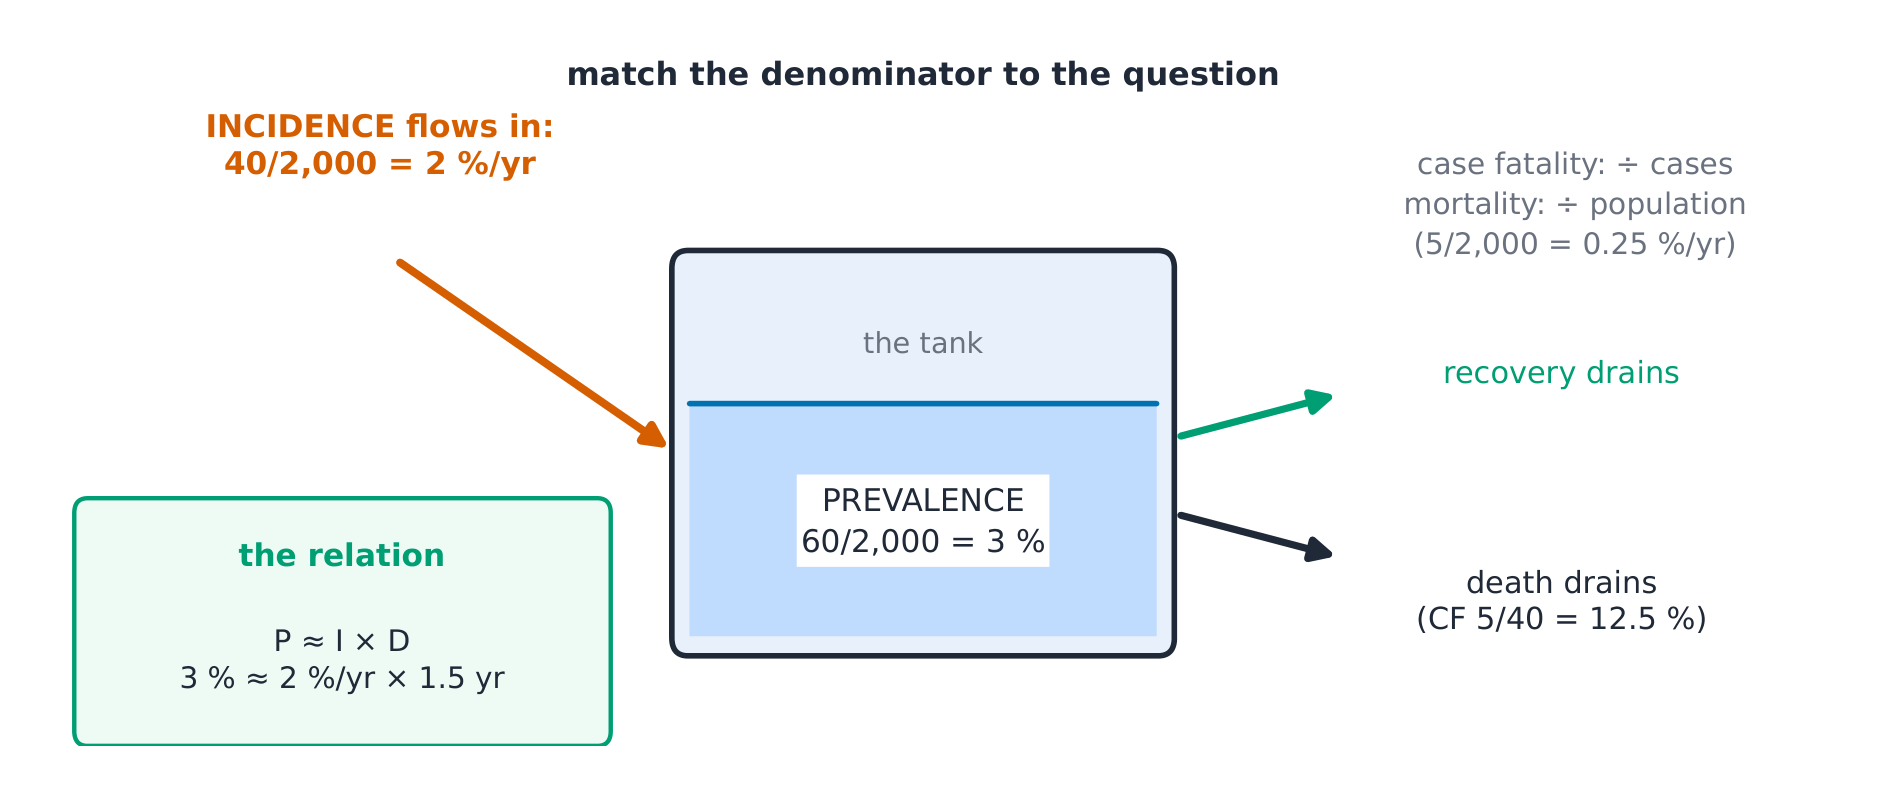
แนวคิด พร้อมภาพประกอบ อัตราเกิดใหม่ (Incidence) = เคสใหม่ ÷ คนที่เสี่ยง ÷ เวลา; ความชุก (Prevalence) = เคสที่มีอยู่ ÷ ประชากร ณ ช่วงเวลาหนึ่ง ✓ They are linked: prevalence ≈ incidence × duration — long diseases สะสม, Brief ones vanish between surveys. สะสมอยู่, แบบสั้นๆ จะหายไประหว่างการสำรวจ
 การหาสูตร (เหตุผลของการปรับมาตรฐาน) อัตราดิบผสมผลจากสอง
ปัจจัย: ความเสี่ยงของโรคและโครงสร้างอายุประชากร เขตที่มีผู้สูงอายุมากกว่าอาจแสดงอัตราดิบที่สูงขึ้น แต่มีอัตราเฉพาะกลุ่มอายุที่ต่ำกว่า ✓ การปรับมาตรฐานโดยตรงนำอัตราเฉพาะกลุ่มอายุของแต่ละกลุ่มไปใช้กับประชากรมาตรฐานเดียว แล้วรวมเข้าด้วยกัน — ผลรวมสมมติจะเปรียบเทียบกันได้เพราะ ผู้สูงอายุอาจแสดงอัตรา thô สูงกว่าด้วยอัตราจำแนกตามอายุที่ต่ำกว่า ✓ การปรับมาตรฐานโดยตรงนำแต่ละกลุ่มอัตราจำแนกตามอายุไปใช้กับหนึ่ง ประชากรมาตรฐานและรวมผล — จำนวนรวมที่สร้างขึ้นสามารถเปรียบเทียบกันได้เพราะ องค์ประกอบทางอายุตอนนี้เหมือนกันแล้ว
ตัวอย่างทำทีละขั้นตอน 1 — เมืองสมมติ. 2,000 ชาวเมือง, หนึ่งปี, 40 กรณีใหม่ ของโรค →อุบัติการณ์ 40/2,000 = 2 % ต่อปี ✓. ในวันสำรวจ 60 คนเป็นโรคนี้ →อุบัติการณ์จุด 60/2,000 = 3 % ✓. ตรวจสอบความเชื่อมโยง: 3 % ≈ 2 %/ปี × 1.5 ปี ระยะเวลาเฉลี่ย — ตัวเลขเหล่านี้สอดคล้องกัน ระบบ
ตัวอย่างทำทีละขั้นตอน 2 — เชื่อมโยงทางคลินิก: มุมมองสามด้านของความตาย. (ข้อมูลจำลอง) จาก 40 กรณีใหม่, 5 ตายภายในหนึ่งปี: อัตราความตายจากโรค 5/40 = 12.5 % ✓; การตายต่อปีจากสาเหตุนี้ในทั้งเมืองคือ 5/2,000 = 0.25 % (อัตราการตายจำเพาะสาเหตุ); และหากเมืองบันทึก 20 การตายจาก ทุกสาเหตุในปีนั้น, โรคนี้ทำให้เกิด 5/20 = 25 % ของกรณี (สัดส่วน จำนวนผู้เสียชีวิตเท่าเดิม แต่ตัวส่วนต่างกัน 3 แบบ ตอบคำถามที่ต่างกัน 3 ข้อ
ข้อผิดพลาดพบบ่อย การเรียกความชุกว่าเป็นอัตรา (เป็นสัดส่วน — ไม่มีหน่วยเวลา) การเปรียบเทียบอัตราดิบระหว่างประชากรที่มีโครงสร้างอายุต่างกัน (ต้องปรับมาตรฐานก่อน) การอ่านค่าความตายจากโรคเป็นอัตราตาย (ตัวส่วนคือผู้ป่วย ไม่ใช่ประชากร) หน่วยเวลา). เปรียบเทียบอัตรา thô ระหว่างประชากรที่มีโครงสร้างอายุต่างกัน (ต้องปรับมาตรฐานก่อน). อ่านค่าอัตราความตายจากโรคเป็นการตาย (ตัวส่วนคือกรณี, ไม่ใช่คน) structures (standardise first). Reading case fatality as mortality (the denominator is cases, not people).
สรุป อัตราการเกิดใหม่ = กรณีใหม่/กลุ่มเสี่ยง/เวลา; ความชุก = กรณีที่มีอยู่/ประชากร; P ≈ I × D; การปรับมาตรฐานแก้ปัญหาโครงสร้างอายุ; ความตายจากโรค (ตัวส่วนคือผู้ป่วย), อัตราตายเฉพาะสาเหตุ (ตัวส่วนคือประชากร), อัตราตายส่วนประกอบ (ตัวส่วนคือการเสียชีวิตทั้งหมด) — เลือกใช้ให้ตรงกับโจทย์ ตัวส่วนให้สอดคล้องกับคำถาม
รูปแบบการศึกษา
ทำไมถึงสำคัญ ทุกคำถามทางคลินิกมีรูปแบบการศึกษาที่เหมาะสมและไม่เหมาะสม — การเลือกแบบศึกษา คือการเลือกว่าจะรับมือกับความลำเอียงใด และการออกแบบที่ไม่สามารถทำได้ — การเลือกการออกแบบคือการเลือกว่าคุณจะเผชิญกับอคติประเภทใด จะต่อสู้
แนวคิดพร้อมภาพบันได: การทดลองแบบสุ่ม (การทดลอง) → กลุ่มตัวอย่าง (ติดตามผู้ได้รับและไม่ได้รับปัจจัยเสี่ยงไปข้างหน้า) → กรณี-ควบคุม (มองย้อนกลับจากผลลัพธ์) → ตัดขวาง (ภาพถ่ายเดียว) → นิเวศวิทยา (ระดับกลุ่ม ไม่ใช่บุคคล) ✓. จากผลลัพธ์) → แบบข้ามตัด (ภาพเดียว) →เชิงนิเวศ (กลุ่ม ไม่ใช่ บุคคล) ✓
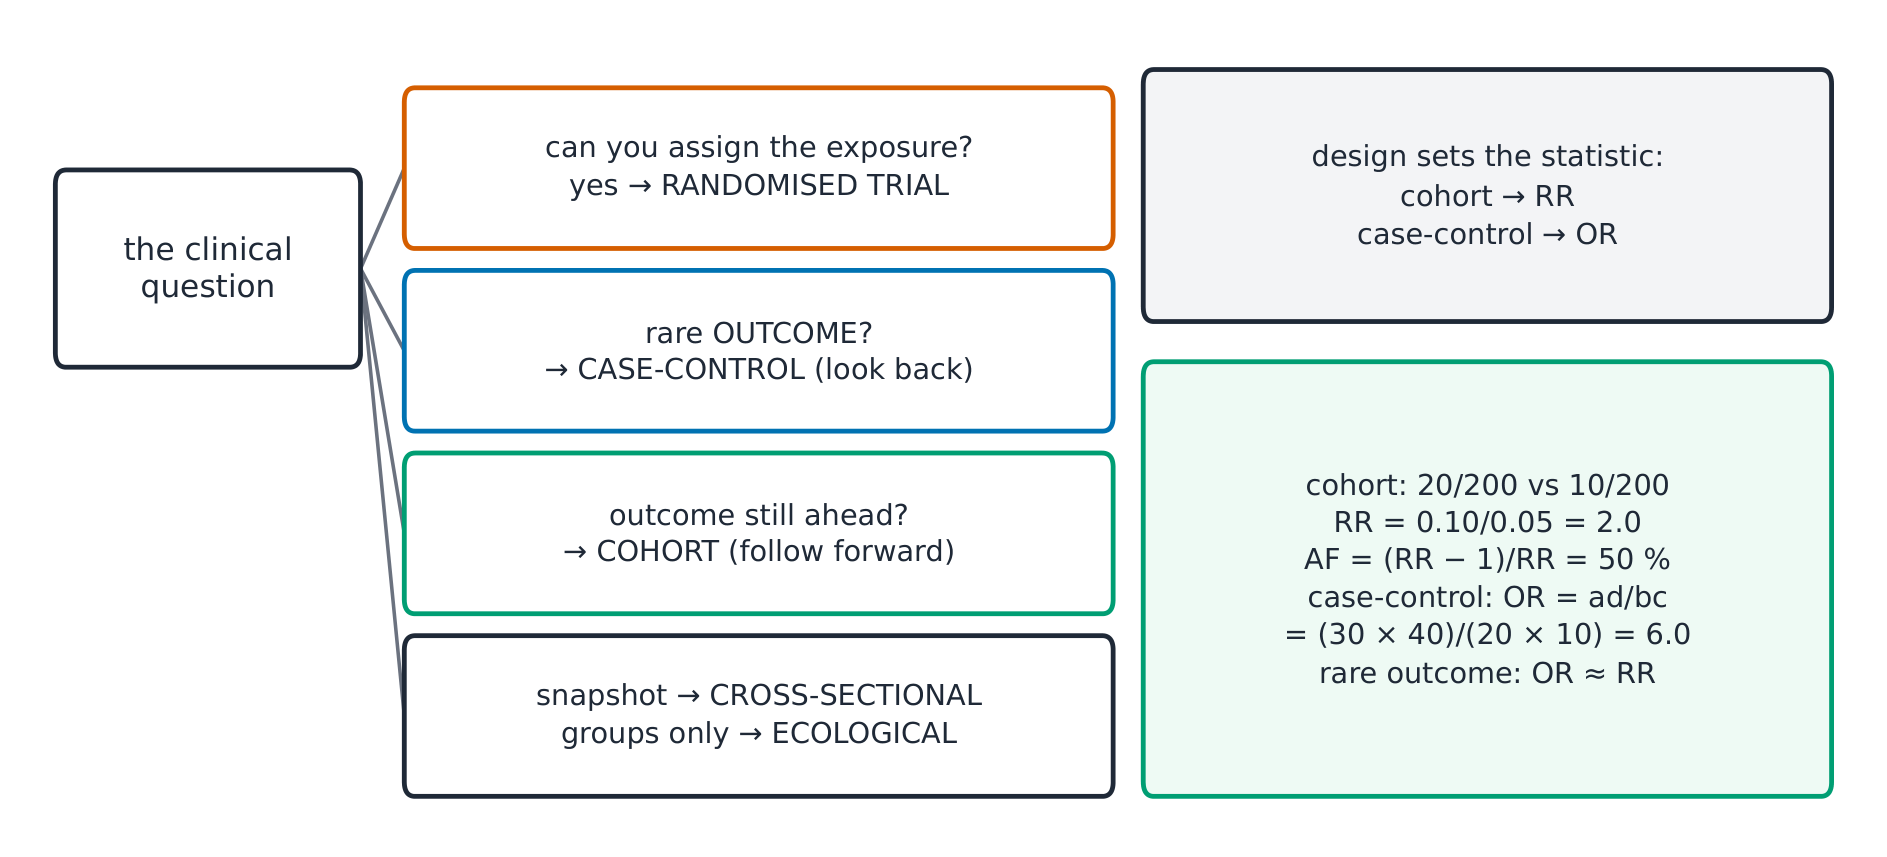
การ derivation (เหตุผลว่าทำไม RR จึงเกี่ยวข้องกับกลุ่มตัวอย่าง และ OR กับกรณี-ควบคุม). A กลุ่มตัวอย่างโดย EXPOSURE ดังนั้นความเสี่ยงในแต่ละกลุ่มจึงประมาณได้: relative risk $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. กรณี-ควบคุมตัวอย่างโดย OUTCOME ดังนั้น "ความเสี่ยง" ในแต่ละกลุ่มเป็นผลจากการเลือกตัวอย่าง — เพียง odds ratio $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ เท่านั้น Valid ✓. การออกแบบกำหนดสถิติ ไม่ใช่ความชอบ.
ตัวอย่างคำนวณ 1 — กลุ่มตัวอย่างสังเคราะห์หนึ่ง. สัมผัส 200, 20 เหตุการณ์; ไม่ได้รับสัมผัส 200, 10 เหตุการณ์: ความเสี่ยง 0.10 เทียบกับ 0.05 → $RR = 2.0$ ✓, ส่วนที่ attributable อยู่ในกลุ่มที่ได้รับสัมผัส $(RR-1)/RR = 50\ \%$ ✓ — เหตุการณ์ของกลุ่มที่ได้รับสัมผัส เป็นครึ่งหนึ่ง "เนื่องจาก" การได้รับสัมผัส ภายใต้สมมติฐาน
Worked example 2 — clinical link: the case-control mirror. (Fictional) 30 of 40 cases exposed; 20 of 60 controls exposed: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. A rare outcome makes OR approximate RR — one number, สองแบบการออกแบบ และการสุ่มเลือกกำหนดว่าอันไหนถูกต้องตามหลักสถิติ
ข้อผิดพลาดทั่วไป. คำนวณ RR จากการศึกษาแบบกรณี-ควบคุม (ตัวส่วนถูกเลือกโดยนักวิจัย ไม่ใช่หาได้จริง). อ่าน odds ถูกเลือกโดยนักวิจัย ไม่ใช่หาเจอเอง). อ่านค่า odds แบบข้ามตัด "prospective" เท่ากับ "ดีกว่า" (การศึกษากลุ่มตัวอย่างแบบ prospective ยังมีการรบกวน; มีเพียง randomisation ที่ปรับสมดุลปัจจัยที่ไม่ทราบ.). การสุ่มช่วยปรับสมดุลปัจจัยที่ไม่ทราบ (randomisation balances the unknowns).
สรุป. การทดลอง → คอฮอร์ต (RR) → กรณีศึกษา (OR) → แบบข้ามตัด → เชิงนิเวศวิทยา; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; ตัวอย่างกลุ่มตาม การสัมผัสโรค, กรณี-ควบคุมตามผลลัพธ์; โรคหายาก OR ≈ RR; ส่วนแบ่งที่ อธิบายได้ $(RR-1)/RR$.
ความคลาดเคลื่อน การรบกวน และเหตุและผล
ทำไมถึงสำคัญ ตัวเลขหลอกได้สามแบบ: แบบมีระบบ (ความคลาดเคลื่อน), จาก ตัวแปรที่สาม (การรบกวน), และการสัมพันธ์โดยไม่มีความสัมพันธ์เชิงเหตุผล การระบุรูปแบบ ความล้มเหลวคือครึ่งหนึ่งของกระบวนการประเมินอย่างมีวิจารณญาณ
แนวคิดพร้อมภาพประกอบ ความคลาดเคลื่อน คือข้อผิดพลาดที่มีระบบในการออกแบบหรือ การวัด: ความคลาดเคลื่อนจากการเลือก (ใครได้รับโอกาสเข้า) ข้อมูล/ความคลาดเคลื่อนจากการจำ (สิ่งใด ถูกจดจำหรือบันทึก) การรบกวน คือตัวแปรที่สามซึ่งเกี่ยวข้องกับทั้ง both exposure and outcome that pretends to be the cause ✓.
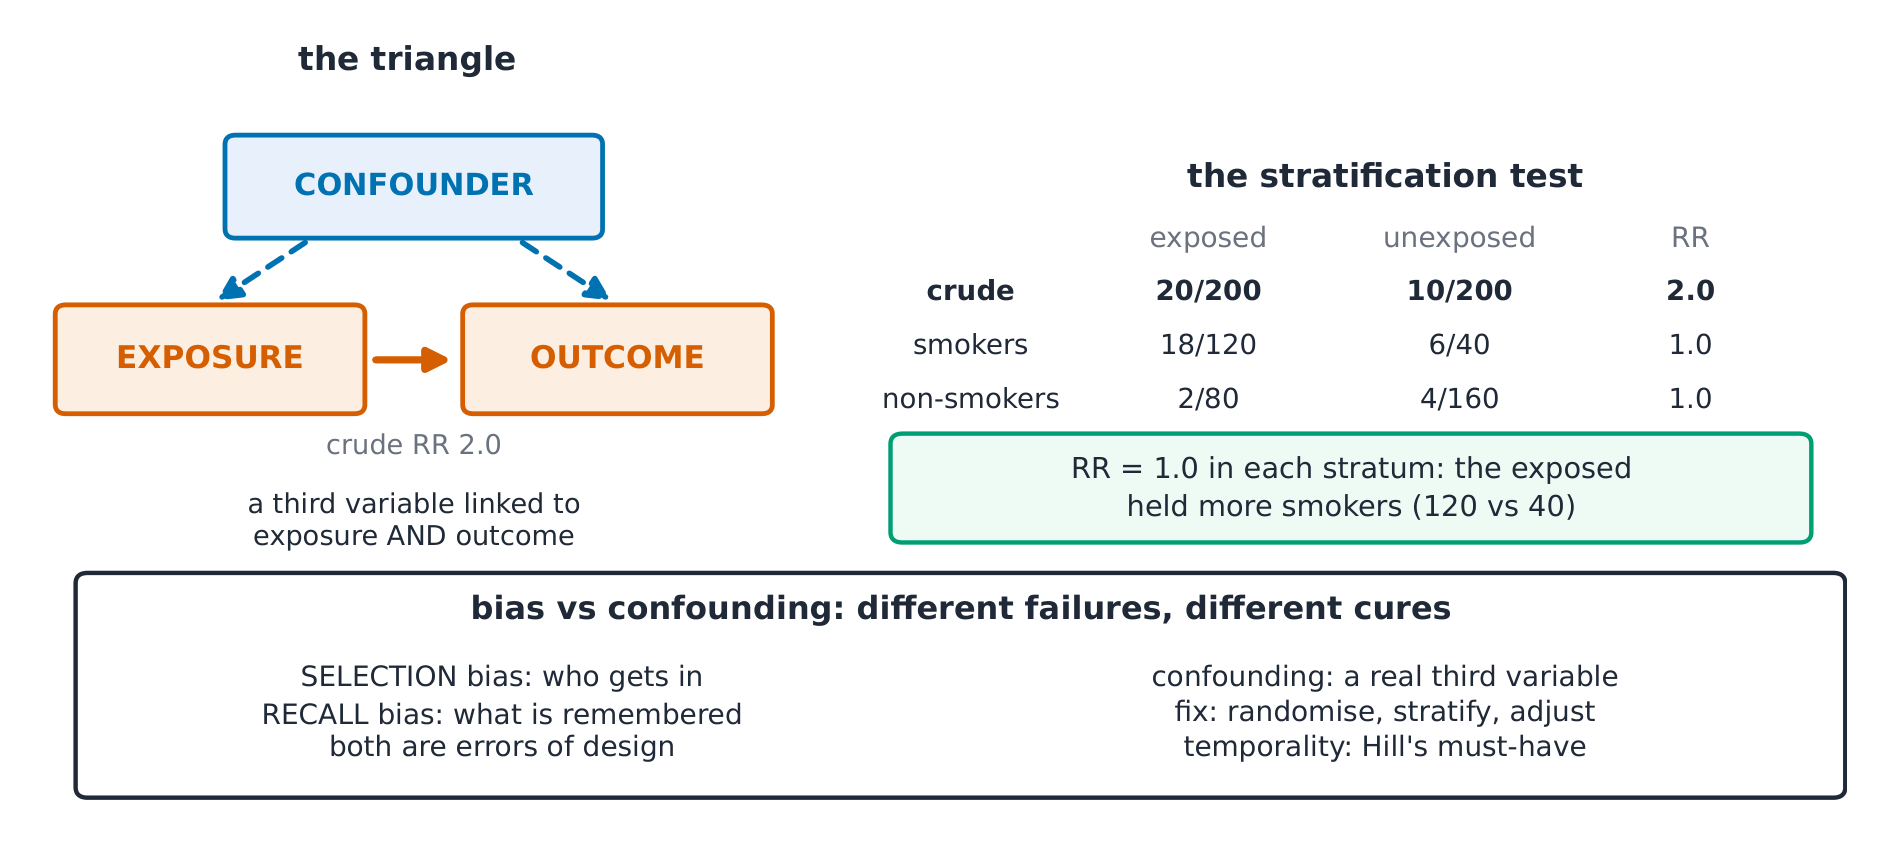
การพิสูจน์ (ทำไมการแยกชั้นจึงเป็นหลักฐาน) หากตัวแปรที่สามเป็น ตัวขับเคลื่อนจริง ความสัมพันธ์ควรหายไปภายใน strata ที่มันคงที่: constant: crude $RR$ 2.0, but within non-smokers $RR$ 1.0 and within smokers ชั้น (เช่น $RR$ และ 1.0) การสัมผัสโรคยังคงสัญญาณของตัวเอง การสุ่ม strata (เช่น 2.0 และ 1.9), การได้รับสัมผัสยังคงสัญญาณของตัวเองไว้ การสุ่ม ป้องกันความบิดเบือนล่วงหน้าโดยปรับสมดุลแม้ปัจจัยที่ไม่ทราบก็ ✓
Worked example 1 — the stratified table. (Synthetic) crude: exposed 20/200 เหตุการณ์ เทียบกับ ไม่ได้รับสัมผัส 10/200 → RR 2.0. แบ่งชั้นตามการสูบบุหรี่: ผู้ไม่สูบบุหรี่ 6/100 เทียบกับ 3/100 (RR 2.0 ✓ ภายใน), ผู้สูบบุหรี่ 14/100 เทียบกับ 7/100 (RR 2.0) — ความสัมพันธ์ยังคงอยู่หลังการแบ่งชั้น: การสูบบุหรี่ไม่ใช่ confounder here; the exposure's signal stands. Now give the same crude ตารางแยกกลุ่มแบบต่าง — กลุ่มสัมผัส: 120 คนสูบบุหรี่ (18 เหตุการณ์) และ 80 non-smokers (2 events); unexposed: 40 smokers (6 events) and 160 non-smokers (4 events). Smokers' risk is 15 % in both arms and ความเสี่ยงของผู้ไม่สูบบุหรี่คือ 2.5 % ในทั้งสองกลุ่ม ดังนั้น RR จึงเท่ากับ 1.0 ภายในแต่ละชั้น: การ กลุ่มที่สัมผัสมีจำนวนคนสูบบุหรี่มากกว่า และการสูบบุหรี่ IS ตัวแปรกวนจริง ✓. ตารางรวมหนึ่งตาราง ให้ข้อสรุปสองอย่าง — เพียงแค่การแยกชั้นเท่านั้นที่จะบอกความแตกต่างได้
ตัวอย่างวิธีทำ 2 — เชื่อมโยงทางคลินิก: คำถามในการประเมินผล (ข้อมูลสมมติ abstract) "coffee drinkers had twice the risk": ask who was studied จำ differently), และตัวแปรกวนควรมีลักษณะอย่างไร (เกี่ยวข้องกับกาแฟ AND กับผลลัพธ์, เช่น การสูบบุหรี่). มุมมองของ Bradford Hill — ความสัมพันธ์เชิงเวลามาก่อน, แล้วตามด้วยความแรง, ความสอดคล้อง, ความสัมพันธ์ระหว่างปริมาณกับผล, ความเป็นไปได้ — เปลี่ยนหัวข้อข่าวให้เป็นรายการตรวจสอบ ✓. ข้อผิดพลาดที่พบบ่อย. การ treating ตัวแปรกวนและการวัดค่าผิดเป็นปัญหาเดียว (ตัวแปรกวนคือการผสมผสานของผลผ่านตัวแปรที่สาม, แก้ไขได้ โดยการสุ่ม, การแยกชั้นหรือการปรับ; การเลือกและ information bias คือข้อผิดพลาดในคนที่ถูกศึกษาและวิธีการวัดค่า, ซึ่งไม่มี
Common mistakes. Treating confounding and measurement bias as one เงื่อนไขที่ขาดไม่ได้ โดยมีความสัมพันธ์เชิงเวลาเป็นอันดับแรก. by randomisation, stratification or adjustment; selection and information bias are errors in who is studied and how things are measured, which no การวิเคราะห์ซ่อมแซมได้ครบถ้วน) คาดการณ์ว่าข้อมูลขนาดใหญ่จะแก้ความสับสน (ความแม่นยำสูงขึ้นรอบๆ ค่าที่เอียง estimate). Demanding every Hill viewpoint (they are viewpoints, not a คะแนน; ความต่อเนื่องทางเวลาเป็นเงื่อนไขเดียวที่ไม่สามารถต่อรองได้)
สรุป. ความลำเอียง = ข้อผิดพลาดแบบมีระบบ (การเลือกตัวอย่าง, ข้อมูล/การจำ); ตัวแปรกวน = ตัวแปรที่สามที่มีผลต่อทั้งสองเส้นทาง; การทดสอบแบ่งชั้นจะลดทอน ความสัมพันธ์ลงหากมีความสับสน; การสุ่มตัวอย่างช่วยปรับสมดุลปัจจัยที่ไม่ทราบ; มุมมองของฮิลล์โดยเริ่มจากความต่อเนื่องทางเวลาเป็นอันดับแรก viewpoints with temporality first.
Diagnostic tests
ความไวและความจำเพาะเป็นของทดสอบ แต่ ค่าทำนาย เป็นของ ประชากรที่ใช้มัน การตีความผิดนี้เป็นข้อผิดพลาดทางปริมาณที่พบบ่อยที่สุดในการคิดวิเคราะห์ทางคลินิก ต่อประชากรที่ใช้มัน การอ่านค่าผิดนี้เป็นข้อผิดพลาดเชิงปริมาณที่พบบ่อยที่สุด (ป่วย, ผลบวก); ความจำเพาะ = d/(b+d) (สุขภาพดี, ผลลบ); PPV = a/(a+b), NPV = d/(c+d) — และต้นไม้ความถี่ธรรมชาติแสดงเหตุผลว่าทำไมความชุกจึงทำให้ค่าทำนายเปลี่ยนแปลง ✓
แนวคิด พร้อมภาพประกอบ 2×2: ความไว (Sensitivity) = a/(a+c) (เป็นโรค, ผลตรวจบวก); ความจำเพาะ (Specificity) = d/(b+d) (สุขภาพดี, ผล ตรวจลบ); PPV = a/(a+b), NPV = d/(c+d) — และต้นไม้อัตราธรรมชาติ แสดงว่าทำไมการเปลี่ยนแปลงของอัตราการเกิดโรคจึงส่งผลต่อค่าทำนาย ✓

การหาสูตร (ทำไมอัตราการเกิดโรคจึงขับเคลื่อน PPV) PPV = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓ ด้วย Se = Sp = 90 %: ที่อัตราการเกิดโรค 10 %, PPV = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — แม้จะเป็นกรณี การทดสอบที่แม่นยำมากอาจเทียบเท่าการโยนเหรียญในคลินิกที่มีอัตราป่วยต่ำ ค่าบวกหลอกรวม กลุ่มคนมีน้ำหนักเท่ากับส่วนเกินที่เป็นสุขภาพดี
ตัวอย่างแสดงวิธีทำ 1 — ต้นไม้ความถี่ธรรมชาติ (สังเคราะห์). 1,000 คน, อัตราป่วย 10 %: 100 มีโรค → 90 บวกจริง, 10 ลบหลอก; 900 สุขภาพดี → 810 ลบจริง, 90 บวกหลอก ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. ทดสอบเดียวกันที่อัตราป่วย 1 %: 9 TP เทียบกับ 99 FP → PPV 9/108 = 8.3 % ✓ — ต้นไม้เดียว โลกสองแบบ
ตัวอย่างแสดงวิธีทำ 2 — เชื่อมโยงทางคลินิก: อัตราส่วน likelihood ล่องลอยได้. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: ผลบวกจะคูณ Odds ก่อนทดสอบ ด้วย 9 ไม่ว่าclinicจะมีอัตราป่วยเท่าไร Odds ก่อนทดสอบ 1:9 (10 %) → Odds หลังทดสอบ 9:9 = 1:1 → ความน่าจะเป็น 50 % — PPV เดิมกัน ได้มาในบรรทัดเดียว อัตราส่วน likelihood (LRs) คือ รูปแบบพกพาของการทดสอบ; ค่าทำนายเป็นของเฉพาะพื้นที่
ข้อผิดพลาดที่พบบ่อย. การอ้าง sensitivity ว่า "การทดสอบถูก 90 %" (มันถูก เกี่ยวกับ 90 % ของผู้ที่มีโรค — เช่น ของสิ่งใด) การนำ PPV จากตำราไปใช้กับ คลินิกที่มีอัตราป่วยต่างกัน สับสนระหว่างสองคอลัมน์ (sensitivity อ่านลง คอลัมน์ผู้ที่มีโรค; specificity ลง คอลัมน์สุขภาพดี) ลดตามคอลัมน์ที่เป็นโรค; ความจำเพาะลดตามคอลัมน์สุขภาพดี)
สรุป. Se = a/(a+c), Sp = d/(b+d) — คุณสมบัติการทดสอบ; PPV/NPV — population properties, move with prevalence; natural-frequency trees make it visible; $LR+ = Se/(1-Sp)$ multiplies odds portably (0.9/0.1 = 9); 50 % PPV at 10 % prevalence despite Se = Sp = 90 %.
การอนุมานทางสถิติสำหรับข้อมูลทางคลินิก
และการตีความ p-value กับช่วงความเชื่อมั่นผิดๆ เป็นสัญญาณของข้อผิดพลาดใน วรรณกรรมสมัยใหม่ the modern literature.
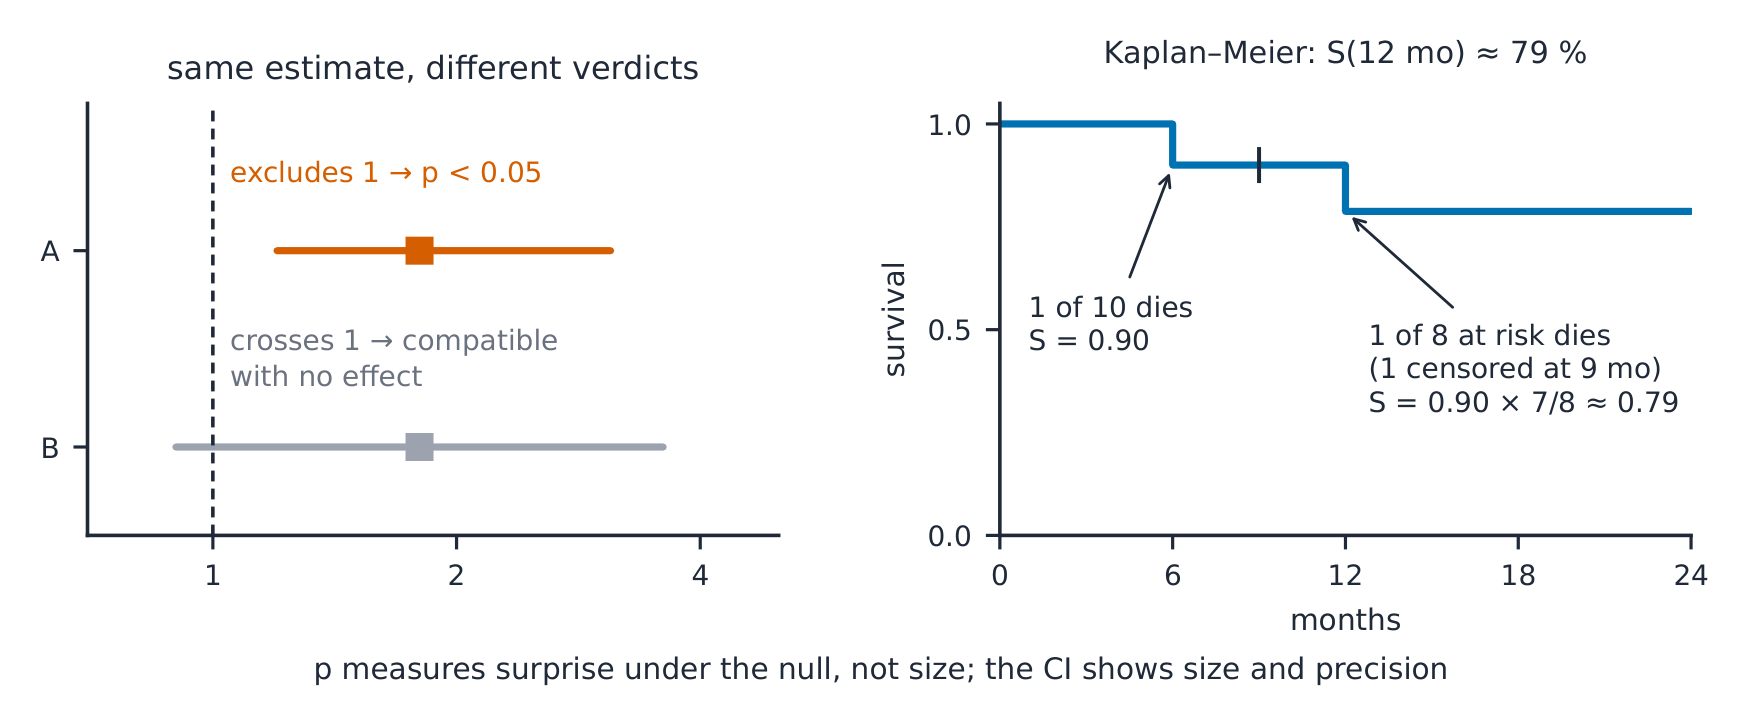
The idea, with a picture. A 95 % confidence interval is the P คือความน่าจะเป็นของข้อมูลที่รุนแรงอย่างน้อยเท่านี้ หากรถสมมติฐานศูนย์ เป็นจริง ✓ ช่วงความเชื่อมั่นสรุปขนาดและความแม่นยำ; ส่วน p-value สรุปแค่ ความประหลาดใจเท่านั้น summarises surprise.
การหาที่มา (เหตุผลที่ทดสอบตามชนิดของข้อมูล). การนับจำนวนตามกลุ่ม → χ²; ค่าเฉลี่ยสองกลุ่ม (แบบปกติ-ish) → t-test (ใช้เมื่อแต่ละแถววัดค่า สองครั้ง); ค่าเฉลี่ยหลายกลุ่ม → ANOVA; ข้อมูลเบี่ยงเบน/ตัวอย่างเล็ก → Rank test (Non-parametric) ทางเลือก; การวัดต่อเนื่องสองตัวแปร → Correlation (Pearson, หรือ Spearman สำหรับลำดับชั้น) ✓. สเกลของการวัดเป็นตัวกำหนดการเลือกทดสอบ — หากตัดสินใจหลัง ดูผลลัพธ์แล้ว จะนำไปสู่คำถามที่ไม่ถูกต้องได้.
ตัวอย่างทำพร้อม 1 — อ่านค่าจากช่วงความเชื่อมั่นหนึ่ง. (บทคัดย่อสมมติ) RR 1.8, 95 % CI 1.2–3.1: the interval excludes 1, so the data are incompatible with "ไม่มีผล" ที่ระดับนี้ (p < 0.05 ตามมา); ความกว้างของช่วงบ่งชี้ว่าค่าประมาณมีความ ไม่แน่นอน แต่มีค่าสูงกว่า 1 อย่างสม่ำเสมอ ✓. RR 1.8 ที่มี CI 0.9–3.6 บอกถึง สิ่งตรงกันข้าม — จุดประมาณค่าเดียวกัน แต่ข้อสรุปต่างกัน และเพียงช่วง บอกคุณ
ตัวอย่างวิธีทำ 2 — เชื่อมโยงทางคลินิก: คณิตศาสตร์ Kaplan–Meier (สังเคราะห์) ผู้เข้าร่วม 10 คน; ที่เวลา 6 เดือน เกิดเหตุการณ์ 1 จากผู้ที่มีความเสี่ยง 10 คน: $S = 9/10 = 0.90$; at 12 months 1 event among the 8 still at risk (one censored): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. Median survival is the time the curve crosses 50 %; censoring removes people from the denominator, เป็นคุณสมบัติของกระบวนการ ใช้กับค่าประมาณจากตัวอย่างนี้) การเลือก
ข้อผิดพลาดที่พบบ่อย "p > 0.05 หมายความว่าไม่มีความแตกต่าง" (หมายถึงข้อมูลสอดคล้องกับความไม่แตกต่าง — การขาดหลักฐาน ≠ หลักฐานของการขาดความแตกต่าง) บทสรุป. CI = ความจริงที่เป็นไปได้ แสดงขนาดและความแม่นยำ; p-value = อ่านค่า CI ว่ามีความน่าจะเป็น 95 % ที่ค่าจริงอยู่ภายในช่วง (ช่วงเป็นคุณสมบัติของกระบวนการ ใช้กับค่าประมาณจากตัวอย่างนี้) a property of the procedure, applied to this sample's estimate). Choosing เลือกการทดสอบหลังจากเห็นผลว่า p < 0.05 แล้ว
Summary. CI = compatible truths, carries size and precision; p-value = P(data this extreme | null); never "proven" or "no effect" from p alone; χ²/t/ANOVA/rank/correlation เลือกตามชนิดข้อมูล; กราฟ Kaplan–Meier- คูณ (1 − เหตุการณ์/กลุ่มเสี่ยง);Median = 50 % ตัดผ่าน
การทดลองทางคลินิกและการทบทวนวรรณกรรมเชิงระบบ
เหตุผลที่สำคัญ การทดลองคือกลไกในการพิสูจน์ และการทบทวนวรรณกรรมคือการประกอบกัน — คำศัพท์ (การสุ่ม, การบดบัง, ITT, NNT) คือสิ่งที่ทุกบทคัดย่อและ every forest plot assumption คุณต้องรู้ assembly — คำศัพท์ (randomisation, blinding, ITT, NNT) คือสิ่งที่ทุก abstract และ forest plot สมมติว่าคุณรู้
แนวคิด พร้อมภาพประกอบ กระดูกสันหลังของการทดลอง: ความเหมาะสม → การสุ่ม (การมอบหมายแบบสุ่ม, การจัดกลุ่มที่ปิดบัง) → การบดบัง (ผู้เข้าร่วม, นักวิจัย, ผู้ประเมินผลลัพธ์) → การวิเคราะห์ตาม เจตนาในการรักษา (วิเคราะห์ตามการสุ่ม, นับทุกคน) ✓. การทบทวนรวมผลเข้าเป็น กราฟป่า: สี่เหลี่ยม (ขนาด = น้ำหนัก), เส้น (ช่วงความเชื่อมั่น), รูปเพชร (ผลรวม), และ ความไม่สม่ำเสมอ $I^2$ ✓.
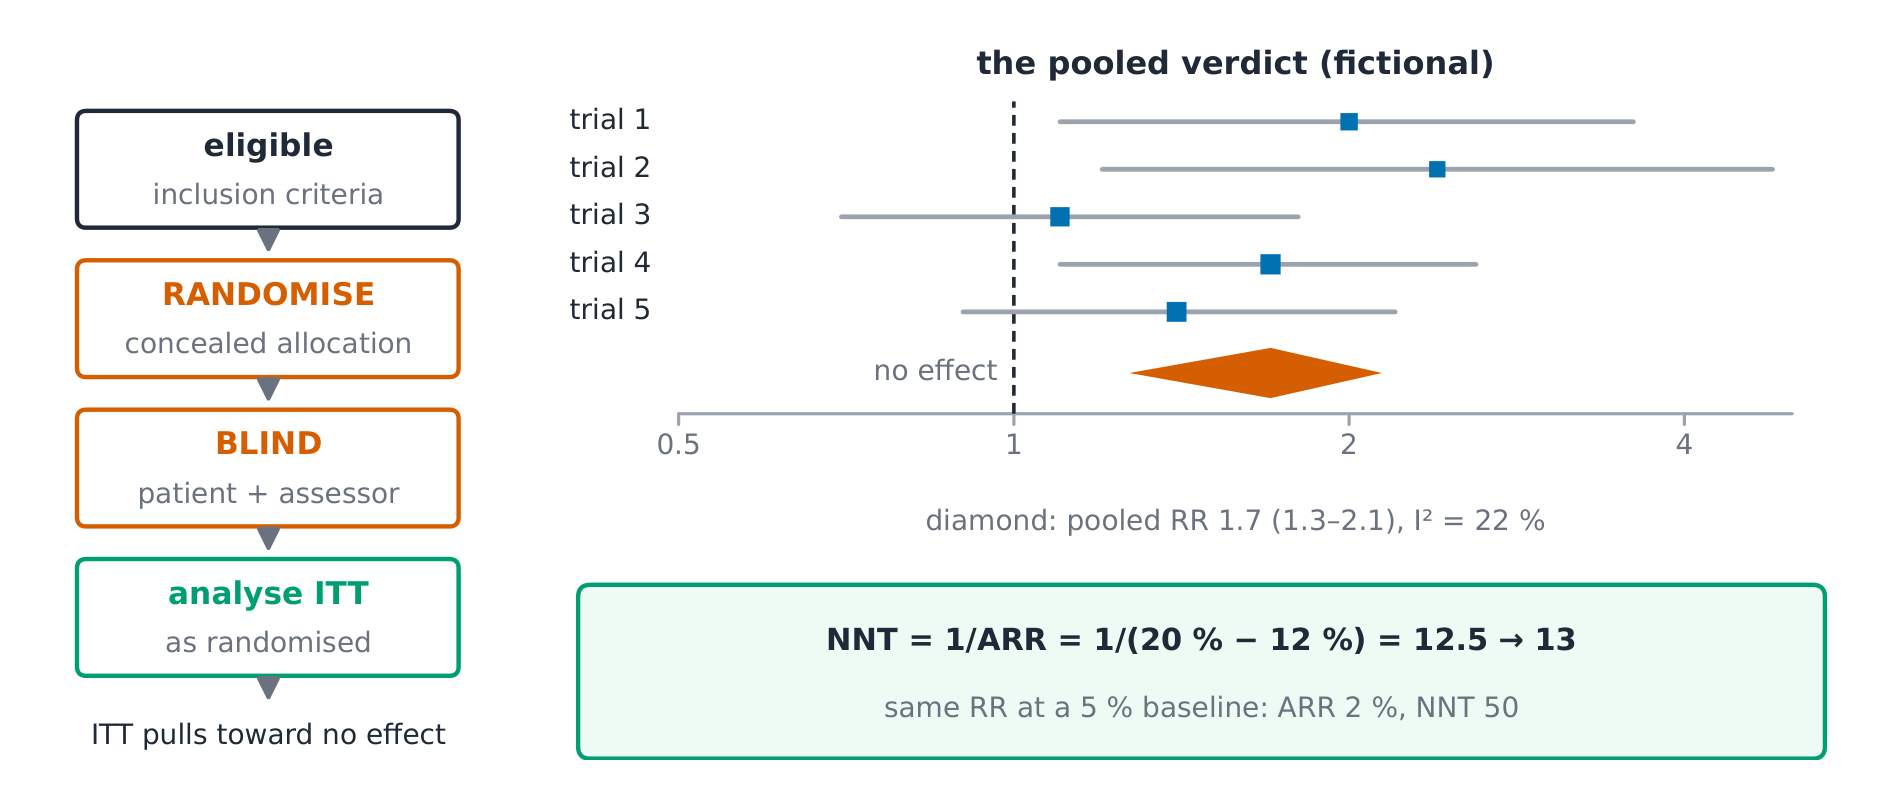
การหาค่า (ทำไม NNT จึงเป็นขนาดทางคลินิกของผล) NNT = $1/ARR$: อัตราเหตุการณ์ในกลุ่มควบคุม 20 %, กลุ่มรับการรักษา 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13 คนต้องได้รับการรักษาเพื่อให้ได้ประโยชน์หนึ่งคน ✓. NNT แปลง อัตราส่วนที่เป็นนามธรรมให้เป็นภาระงาน — และตัวหาร (ARR) จะลดลงเมื่อ ความเสี่ยงพื้นฐานต่ำลง นั่นจึงเป็นเหตุผลว่าทำไมผลการทดลองจึงไม่สามารถนำไปใช้กับ คลินิกที่มีความเสี่ยงต่ำกว่าโดยไม่มีการปรับเปลี่ยน
ตัวอย่างคำนวณ 1 — หลักการ ITT (การทดลองสมมติ) 20 % กลุ่มควบคุมเทียบกับ 12 % กลุ่มรับการรักษา: ARR 8 %, NNT 13 ✓. หาก 30 % ของกลุ่มรับการรักษาหยุดการ มอบหมายก่อนกำหนด ITT ยังคงนับพวกเขาว่าเป็นกลุ่มรับการรักษา — ทำให้ผลที่ปรากฏดูเบี่ยงเบนไปจาก ศูนย์ — เพราะคำถามคือนโยบายการมอบหมาย, ไม่ใช่ชีววิทยาของผู้ปฏิบัติตาม × คำตอบแบบ Per-protocol ตอบคำถามที่ต่างกัน และได้รับอคติจากการปฏิบัติตาม
ตัวอย่างคำนวณ 2 — เชื่อมโยงทางคลินิก: อ่านรูปเพชร (กราฟป่าสมมติ) ห้าการทดลอง, RR เฉพาะเจาะจง 1.1–2.4 พร้อมช่วงความเชื่อมั่นกว้าง, RR รวม 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: รูปสี่เหลี่ยมจตุรัสตั้งอยู่ทางขวาของ 1 และช่วงค่าของมัน ตัด 1 ออก มี heterogeneity ต่ำ — ผลที่สม่ำเสมอในหลายบริบท หากใช้รูปสี่เหลี่ยมจตุรัสเดียวกันพร้อมกับ $I^2 = 78\ \%$ จะทำให้เกิดคำถามว่า "ทำไมการทดลองเหล่านี้ถึงขัดแย้งกัน?" ก่อนที่จะเชื่อถือการรวมข้อมูลใดๆ ข้อผิดพลาดที่พบบ่อย. การเทียบเท่าการสุ่มเข้ากลุ่มกับการบดบัง (การสุ่มช่วยกระจายกลุ่มอย่างสุ่ม; การบดบังช่วยลดความคาดหวัง — การทดลองหนึ่งอาจมีเพียงอย่างเดียว)
ข้อผิดพลาดทั่วไป. สับสน randomisation กับ blinding (chance balance groups; blindness balance expectations — การทดลองอาจมีเพียงอย่างใดอย่างหนึ่ง) อ่าน per-protocol ว่าเป็นการวิเคราะห์ที่ซื่อสัตย์ (มันทำลายการป้องกันของ randomisation). treating the pooled diamond เป็นความจริงแม้จะมี high เหตุผลที่สำคัญ. หลักฐานจะกลายเป็นการแพทย์ได้ก็ต่อเมื่ออยู่ในห้องผู้ป่วย: ผ่านการประเมินความถูกต้อง, วัดขนาดความสำคัญ, และจับคู่กับผู้ป่วยที่อยู่หน้าคุณ หน่วยนี้เป็นการสังเคราะห์ของหลักสูตร
แนวคิด พร้อมภาพประกอบ. โครงสร้างหลักของการประเมิน: PICO (ประชากร, Intervention, การเปรียบเทียบ, ผลลัพธ์) → ความถูกต้อง (ผลลัพธ์มีการเบี่ยงเบนหรือไม่?) → ขนาด (มากแค่ไหน, แม่นยำแค่ไหน?) → การนำไปใช้ (ผู้ป่วยของฉัน...) dilutes toward null); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); forest: squares weighted, diamond pooled, $I^2$ ความไม่สอดคล้องกัน;คลินิก baseline ต่ำ ลด ARR และเพิ่ม NNT
การประเมินความสำคัญและการนำหลักฐานไปใช้
ทำไมถึงสำคัญ. หลักฐานกลายเป็นการแพทย์ก็ต่อเมื่ออยู่ที่เตียงผู้ป่วย: ประเมิน validity, ขนาดสำหรับความสำคัญ, และจับคู่กับผู้ป่วยที่อยู่หน้า คุณ. หน่วยนี้เป็นการสังเคราะห์ของหลักสูตร
แนวคิดพร้อมภาพ. Spine ของการประเมิน: PICO (population, intervention, comparison, outcome) กรอบ → validity (ผลลัพธ์มี bias หรือไม่?) → size (ใหญ่แค่ไหน, แม่นยำเท่าไหร่?) → applicability (ผู้ป่วยของคุณ คล้ายคลึงกับประชากรที่ศึกษา? ✓. การประเมินความมั่นใจ (GRADE): การสุ่ม หลักฐานเริ่มต้นระดับสูง และหลักฐานเชิงสังเกตการณ์เริ่มต้นระดับต่ำ; ลดระดับเนื่องจากความเสี่ยงของ ความลำเอียง ความไม่สอดคล้องกัน ความไม่ตรงไปตรงมา ความไม่แม่นยำ หรือความลำเอียงในการตีพิมพ์; เพิ่มระดับ เมื่อมีผลขนาดใหญ่หรือมีแนวโน้มตามปริมาณการได้รับ treatment ✓.

ที่มา (ทำไมลำดับชั้นถึงเป็น prior ไม่ใช่คำตัดสิน). รูปแบบการวิจัย มีความแตกต่างในการควบคุมความลำเอียงแบบทั่วไป: การสุ่มช่วยปรับสมดุลตัวแปรที่รบกวน ความลำเอียงจากการจำ recall bias ✓. แต่ลำดับชั้นให้คะแนนตามประเภทรูปแบบการวิจัย ส่วนคำตัดสิน เป็นของงานวิจัยเฉพาะนั้น — การทดลองขนาดเล็ก ไม่มีการบอด และวิเคราะห์ตามโปรโตคอล เป็นส่วนหนึ่งของงานวิจัยนี้ — เป็นงานขนาดเล็ก, ไม่มีการบอด, วิเคราะห์ตามโปรโตคอล จุดเริ่มต้นเท่านั้น. การปรับ propensity. GRADE มีอยู่จริงเพราะระดับการออกแบบเป็นเพียง จุดเริ่มต้นเท่านั้น
ตัวอย่างฝึกหัด 1 — บทคัดย่อสมมติใน 5 คำถาม. (สมมติ) "Randomised, double-blind, n = 400; RR 0.75 (0.60–0.94)": validity — สุ่มและบอด ✓; ขนาด — ลดลง 25% เมื่อเทียบ, ช่วงค่าไม่รวม 1; local applicability — were patients like mine enrolled (age, severity, ยาอื่นร่วมด้วย)?; ผลลัพธ์ — เกี่ยวข้องต่อผู้ป่วยหรือเป็นค่าแทน?; ความมั่นใจ — มีลักษณะลดระดับความเชื่อมั่นหรือไม่? ห้าคำถาม, คำตัดสินที่มีโครงสร้างหนึ่งข้อ ✓
ตัวอย่างฝึกหัด 2 — เชื่อมโยงทางคลินิก: การนำ NNT ไปใช้. (สมมติ) a การทดลองในโรครุนแรง (ค่าพื้นฐาน 20 %, ARR 8 %, NNT 13); ผู้ป่วยของฉัน คลินิกทำงานที่ระดับ 5 %: ด้วยอัตราการลดความเสี่ยงสัมพัทธ์เท่ากัน ARR จะ ขยายผลสู่ $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. ผลสัมพัทธ์อาจ เปลี่ยนแปลงได้; ภาระสัมบูรณ์ — งานที่ต้องทำและสมการผลดีต่อผลเสีย — เป็นเฉพาะพื้นที่
ข้อผิดพลาดทั่วไป. ประเมินเพียงความถูกต้อง (มีผลที่ถูกต้องแต่เล็กเกินไป ก็ไม่มีประโยชน์: ขนาดและความแม่นยำเป็นตัวชี้วัดความสำคัญ) การให้คะแนนตามชื่อ วารสารหรือฉลากการออกแบบเพียงอย่างเดียว (GRADE เริ่มต้นจากจุดนั้นและปรับตัวไปตามข้อบกพร่องของ หลักฐาน) การนำค่าเฉลี่ยกลุ่มไปใช้กับผู้ป่วยที่มีลักษณะสำคัญคือ เกณฑ์การคัดออก
สรุป. PICO → ความถูกต้อง → ขนาด → ความเหมาะสมในการนำไปใช้; GRADE: เริ่มจากการ ออกแบบ, ลดระดับเมื่อมีความลำเอียง/ความไม่สอดคล้อง/ความอ้อมงาย/ความไม่แม่นยำ, เพิ่มระดับ สำหรับการเปลี่ยนแปลงขนาดใหญ่; กรวยเป็นข้อมูลก่อนหน้า ไม่ใช่คำตัดสิน; ผลสัมพัทธ์ เปลี่ยนแปลงได้, ผลลัพธ์สัมบูรณ์ (ARR, NNT) เป็นเฉพาะพื้นที่ — คำนวณใหม่ก่อนนำไปใช้