| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Показать понимание процессоров RISC (с упрощённым набором инструкций) и CISC (со сложным набором инструкций) | Различия между RISC и CISC Понимание обработки прерываний на процессорах CISC и RISC |
| Показать понимание важности/использования конвейеризации и регистров в процессорах RISC | |
| Показать понимание четырёх базовых архитектур компьютеров | SISD, SIMD, MISD, MIMD |
| Показать понимание характеристик масштабируемых параллельных вычислительных систем | |
| Показать понимание концепции виртуальной машины | Привести примеры роли виртуальных машин Понять преимущества и ограничения виртуальных машин |
Аппаратное обеспечение и виртуальные машины
Информатика A-Level · Тема 15
 15:02
RISC, конвейеры и логика
Два разработчика чипов сталкиваются с одной проблемой: заставить программы работать быстро. Один говорит — создавайте мощные инструкции, чтобы каждая выполняла много работы. Другой говорит — держите…
Английское озвучивание · Английский + китайские субтитры (встроенные)
15.1
Процессоры RISC против CISC

Программа
Источник: Программа Cambridge International
Два стиля проектирования процессора. Сам процессор подключается к материнской плате — основной плате, которая связывает процессор, память и все остальные компоненты компьютера вместе.

CISC
CISC (Complex Instruction Set Computers) имеет множество, часто сложных инструкций (одна может выполнять несколько обращений к памяти и операций), переменной длины, поэтому их декодирование сложно. В аппаратном обеспечении выполняется больше действий за одну инструкцию. Примеры: Intel x86.
RISC
RISC (Reduced Instruction Set Computers) имеет небольшой набор простых инструкций, каждая выполняет одну базовую операцию, все они фиксированной длины (быстро декодируются). Только загрузка и выгрузка обращаются к памяти; всё остальное происходит между регистрами. Программы длиннее, но каждая инструкция выполняется быстро и предсказуемо, что подходит для конвейеризации. Примеры: ARM, RISC-V.
| Характеристика | CISC | RISC |
|---|---|---|
| Набор инструкций | много | мало |
| Длина инструкции | переменная | фиксированная |
| Обращения к памяти | многие инструкции | только загрузка/выгрузка |
| Подходит для конвейера | сложнее | по природе |
| Циклов на инструкцию | варьируется | обычно 1 |
Компромисс заключается в том, чтобы делать больше за одну инструкцию (CISC) против выполнения каждой инструкции быстрее и предсказуемее (RISC). Современные процессоры Intel преобразуют инструкции CISC в более простые микрооперации, похожие на RISC, внутренним образом.
"Опишите четыре характеристики процессора RISC." Любые четыре из: небольшого набора простых инструкций; инструкций фиксированной длины (одно слово); большинства инструкций, завершающихся за один такт; множества регистров общего назначения; только инструкций загрузки и выгрузки обращаются к памяти (все арифметические операции выполняются между регистрами); аппаратного управления (без микрокода); спроектирован для конвейеризации; компилятор выполняет большую часть работы, поэтому программы содержат больше инструкций и требуют больше памяти. "Опишите четыре характеристики процессора CISC." Любые четыре из: большого набора инструкций, многие из которых сложны (одна инструкция может выполнять несколько операций); инструкций переменной длины; инструкций, требующих нескольких тактов; меньшего количества регистров; инструкций, способных обращаться к памяти напрямую; микропрограммированного управления; менее подходит для конвейеризации; коротких программ, поэтому требуется более простой компилятор и меньше памяти. "Опишите значение терминов RISC и CISC" (по два балла каждый): назовите расшифровку и дайте определяющую идею (мало простых одноцикловых инструкций; много сложных многоцикловых инструкций).
Обработка прерываний в двух архитектурах. На процессоре CISC текущая инструкция, какой бы сложной она ни была, завершается до обслуживания прерывания; затем процессор сохраняет содержимое своих регистров (включая счетчик команд) в стек, переходит к подпрограмме обработки прерываний и восстанавливает регистры после этого. На процессоре RISC с конвейером несколько инструкций находятся на середине выполнения в момент поступления прерывания, поэтому процессор должен либо позволить каждой инструкции в конвейере завершиться, либо отбросить (очистить) частично выполненные инструкции и перезапустить их после прерывания; в любом случае конвейер опустошается, регистры сохраняются, и запускается подпрограмма обработки. Формулировка экзамена: "Конвейеризация усложняет обработку прерываний, потому что содержимое конвейера должно быть обработано перед тем, как можно будет выполнить обслуживание прерывания".
Словарь
Тренировать
| English | Русский |
|---|---|
| motherboard/ˈmʌðəbɔːd/ | материнская плата |
| CISC/sɪsk/ | Сложный набор инструкций |
| RISC/rɪsk/ | Упрощённый набор инструкций |
| register/ˈredʒɪstə/ | регистр |
| interrupt/ˈɪntərʌpt/ | Прерывание |
15.1
Конвейеризация
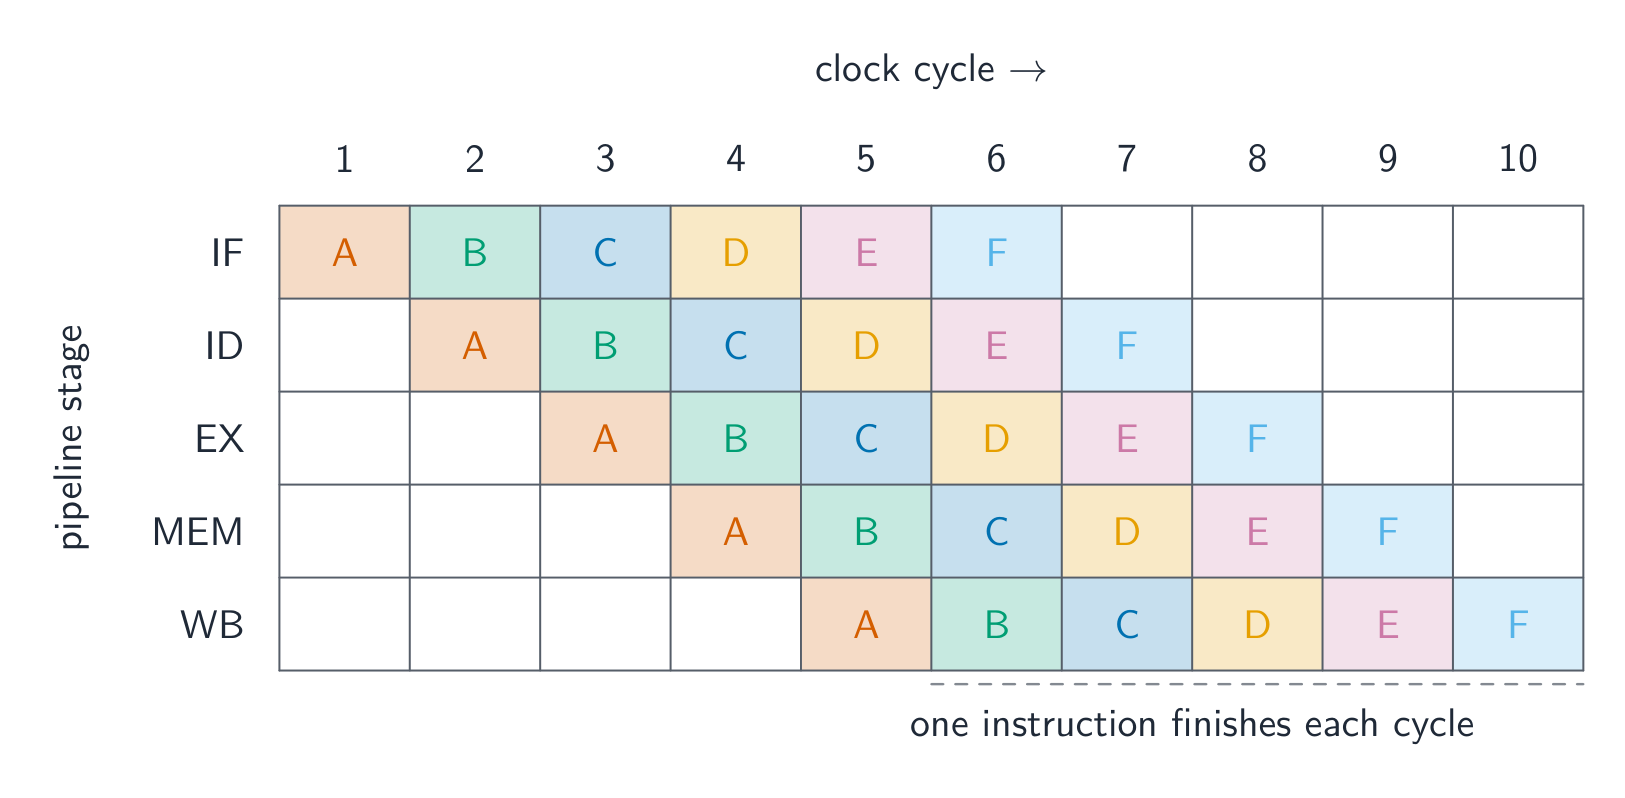
Конвейер обрабатывает инструкции на перекрывающихся этапах, подобно сборочной линии: Извлечение → Декодирование → Выполнение (в АЛУ) → Доступ к памяти → Запись обратно. Каждый этап работает над разной инструкцией одновременно, поэтому, как только конвейер заполнится, одна инструкция завершается за цикл. Инструкции RISC фиксированной длины и простоты делают продолжительность каждого этапа одинаковой. Конвейер может остановиться из-за опасности — опасности данных (инструкция требует результат, который еще не готов) или опасности управления (ветвление делает следующий адрес неизвестным).
Чипы RISC хранят данные во множестве регистров, так как память медленная, а регистры быстрые; компилятор рационально распределяет значения по регистрам.
"Опишите применение конвейеризации в процессорах RISC" (три балла). (1) Цикл извлечения и выполнения разделен на этапы (извлечение, декодирование, выполнение, доступ к памяти, запись обратно); (2) несколько инструкций находятся в конвейере одновременно, каждая на разном этапе, поэтому пока одна выполняется, следующая декодируется, а та, что после неё, извлекается; (3) новая инструкция начинается, а одна завершается в каждом такте после заполнения конвейера, что увеличивает производительность (количество завершенных инструкций в секунду), хотя каждая инструкция по отдельности занимает то же время. Инструкции RISC фиксированной длины и одноцикловые, что обеспечивает равную длительность этапов и возможность конвейеризации.
Разбор примера. Процессор использует пять этапов конвейера (IF, ID, OF, EX, WB). Четыре инструкции поступают в конвейер одна за другой. На каком такте завершится последняя инструкция, и сколько тактов они заняли бы без конвейеризации?
Инструкция 1 занимает IF в такте 1, ID в 2, OF в 3, EX в 4 и WB в 5; инструкция 2 начинается на один такт позже и завершается в такте 6; инструкция 3 — в такте 7; инструкция 4 — в такте 8. В целом $n$ инструкций через $k$ стадий занимают $n + k - 1$ тактов, здесь $4 + 5 - 1 = 8$. Без конвейеризации каждая инструкция требует все пять тактов до начала следующей: $4 \times 5 = 20$ тактов. Таблица экзамена заполняется путем записи стадий каждой инструкции по диагонали, сдвигаясь на одну колонку вправо относительно предыдущей инструкции.
Процессор, работающий с такой высокой скоростью, выделяет много тепла, поэтому сверху установлены радиатор и вентилятор. Металлические ребра рассеивают тепло, а вентилятор обдувает его, поддерживая температуру CPU достаточно низкой для работы.

Исследовать
Как заполняется конвейер
Процесс заполнения тактовых циклов. Как только конвейер заполнен, новая инструкция завершается каждый цикл — даже если каждая занимает несколько этапов, потому что этапы разных инструкций накладываются друг на друга.
Словарь
Тренировать
| English | Русский |
|---|---|
| pipeline/ˈpaɪplaɪn/ | пайплайн |
| ALU/ˌeɪ el ˈjuː/ | Арифметико-логическое устройство (АЛУ) |
| hazard/ˈhæzəd/ | Зависимость (конфликт) |
| throughput/ˈθruːpʊt/ | пропускная способность |
| heat-sink/hiːt sɪŋk/ | радиатор |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | Таксономия Флинна |
15.1
Таксономия Флинна
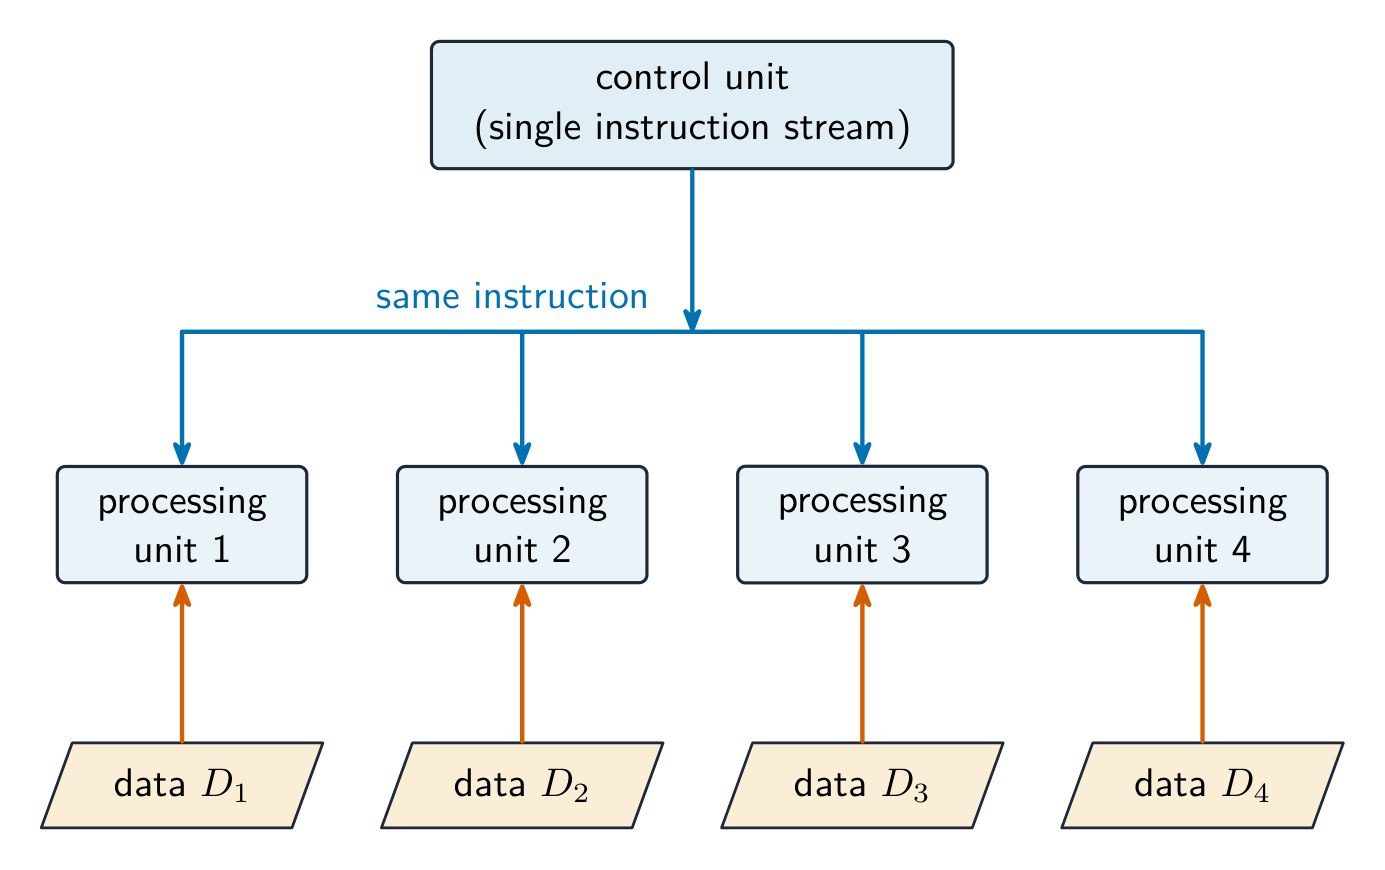
Таксономия Флинна классифицирует компьютеры по количеству потоков инструкций и данных:
- SISD — одна инструкция, один поток данных (традиционный одноядерный процессор).
- SIMD — одна инструкция обрабатывает множество элементов данных одновременно (GPU, векторные расширения CPU). Отлично подходит для изображений, видео и научных массивов.
- MISD — несколько операций над одними данными; редко встречается, преимущественно теоретически.
- MIMD — множество процессоров выполняет разные инструкции на разных данных (многоъядерные процессоры, кластеры). Наиболее универсальная архитектура.
Описание четырех архитектур (по два балла за каждую). SISD: один процессор выполняет одну инструкцию за раз над одним элементом данных; нет параллелизма, традиционная машина фон Неймана. SIMD: одна инструкция применяется одновременно к множеству элементов данных множеством вычислительных элементов, действующих синхронно; используется для обработки массивов и графики. MISD: несколько процессоров применяют разные инструкции к одним и тем же данным; редко используется, например, в отказоустойчивых системах, где несколько процессоров проверяют один поток. MIMD: множество процессоров, каждый из которых выполняет собственные инструкции над собственными данными независимо; многоъядерный компьютер и кластер.
Видеокарта (со своим GPU) является реальным примером аппаратного обеспечения SIMD: она содержит тысячи малых ядер, выполняющих одну и ту же инструкцию на многих пикселях или числах одновременно, благодаря чему GPU так быстро обрабатывают изображения, видео и машинное обучение.


Словарь
Тренировать
| English | Русский |
|---|---|
| SIMD/ˈsɪmdiː/ | Одна инструкция — множество данных |
| MIMD/ˈmɪmdiː/ | Множество инструкций — множество данных |
| graphics card/ˈɡræfɪks kɑːd/ | видеокарта |
15.1
Масштабно-параллельные компьютеры

Масштабно-параллельная система использует тысячи процессоров в высокоскоростной сети, каждый со своей собственной памятью (распределённая память), обменивающихся данными посредством сообщений. Это MIMD, требует специально написанного программного обеспечения (MPI, CUDA) и подходит для климатического моделирования, крупного обучения машинному обучению и астрофизики. Крупнейшие суперкомпьютеры являются масштабно-параллельными.
"Обрисуйте характеристики масштабно-параллельных компьютеров" (три балла). Очень большое количество процессоров (тысячи), каждый со своей собственной памятью, соединённых сетью (высокоскоростным межсоединением или шиной), чтобы они могли передавать сообщения друг другу; они работают одновременно над частями одной задачи, поэтому задача должна быть записана как программа, которую можно разделить на части, выполняемые параллельно и объединяющие свои результаты. Это arrangement типа MIMD.
Процессоры расположены в высоких серверных стойках, часто занимая целую комнату (центр обработки данных), соединённых проводами, чтобы они могли работать над одной большой задачей одновременно.
Словарь
Тренировать
| English | Русский |
|---|---|
| server/ˈsɜːvə/ | сервер |
| data centre/ˈdeɪtə ˈsentə/ | центр обработки данных |
| virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ | виртуальная машина |
| hypervisor/ˌhaɪpəˈvaɪzə/ | гипервизор |
| sandboxing/ˈsændbɒksɪŋ/ | песочница |
| bytecode/ˈbaɪtkəʊd/ | байт-код |
| just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ | сборка по требованию |
| host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ | хост-операционная система |
| guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ | гостевая операционная система |
| Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ | булева алгебра |
| Boolean/ˈbuːlɪən/ | Булева величина |
| truth tables/truːθ ˈteɪblz/ | таблицы истинности |
| De Morgan's laws/də ˈmɔːɡənz lɔːz/ | законы де Моргана |
| absorption/əbˈsɔːpʃn/ | закон поглощения |
| sum-of-products/sʌm ɒv ˈprɒdʌkts/ | сумма произведений |
| Karnaugh map/ˈkɑːnɔː mæp/ | карта Карно |
| Gray code/ɡreɪ kəʊd/ | код Грея |
15.1
Виртуальные машины
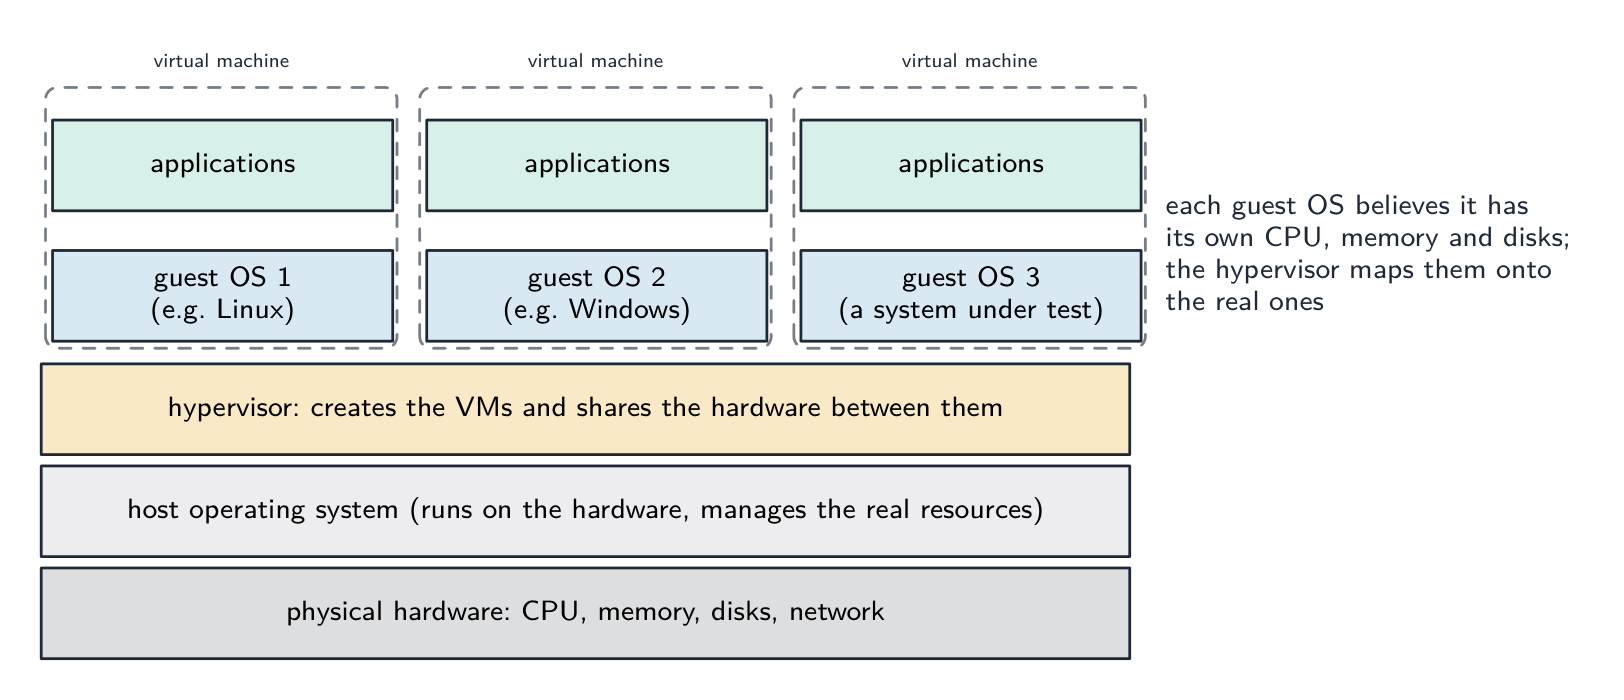
Виртуальная машина (VM) — это программная эмуляция всего компьютера: программное обеспечение внутри видит CPU, память и диски, которые выглядят настоящими, но управляются хост-программным обеспечением.
- системная VM запускает полную ОС. Гипервизор создаёт и управляет VM, каждая загружает свою собственную гостевую ОС. Применение: запуск различных ОС на одном компьютере; консолидация серверов; песочница (рискованное ПО работает изолированно); снимки состояния.
- процессная (языковая) VM запускает одну программу в переносимом байт-коде — JVM (Java), CLR (.NET), CPython. Преимущества: переносимость («написано один раз — работает везде»), проверки безопасности во время выполнения и компиляция «при необходимости» для скорости, близкой к нативной. Недостаток: дополнительный уровень и необходимость установки VM.
"Опишите, что понимается под виртуальной машиной" (два балла). Программная эмуляция (реализация) компьютерной системы, работающей на хост-компьютере и ведущая себя для программ, запущенных внутри неё, как отдельный физический компьютер со своим процессором, памятью и хранилищем. Хостовая операционная система работает на реальном оборудовании, управляет настоящими ресурсами и (через гипервизор) создает и контролирует виртуальные машины; каждая гостевая операционная система работает внутри виртуальной машины, управляет приложениями в ней и не знает, что её оборудование является виртуальным.
Преимущества (укажите два). Несколько различных операционных систем могут работать на одной машине одновременно; ПО можно тестировать на многих системах без покупки оборудования; новую вычислительную систему можно смоделировать и опробовать до её создания; каждая ВМ изолирована, поэтому сбой или вредоносное ПО в одной не влияют на хост или другие; ВМ можно копировать, перемещать и резервировать как файлы, а сервер может использоваться многими пользователями, что снижает затраты на оборудование. Ограничения (укажите два). ВМ работает медленнее реального оборудования, потому что каждая инструкция проходит через слой эмуляции; она потребляет память и вычислительные мощности хоста, поэтому сам хост должен быть мощным; некоторые аппаратные функции или устройства не эмулируются точно, поэтому тестируемое ПО может вести себя иначе на реальном компьютере; требуются лицензии для каждой гостевой ОС, а настройка системы требует компетенций.
Исследовать
Лаборатория вычислительных концепций
Классифицируйте конкретные примеры по вычислительной идее, которую они демонстрируют.
15.2
Булева алгебра
Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Составлять таблицы истинности для логических схем, включая полусумматоры и полные сумматоры | Могут включать логические вентили с более чем двумя входами |
| Показать понимание триггера (SR, JK) | Нарисовать логическую схему и вывести таблицу истинности для триггера Понимать роль триггеров как элементов хранения данных |
| Показать понимание булевой алгебры | Понять законы де Морана Выполнять преобразования булевой алгебры с использованием законов де Морана Упрощать логическую схему/выражение с помощью булевой алгебры |
| Показать понимание карт Карно (K-map) | Понимать преимущества использования карт Карно Решать логические задачи с помощью карт Карно |
Источник: Программа Cambridge International
Булева алгебра упрощает булевы выражения, которые также могут быть описаны с помощью таблиц истинности. Символы: + для ИЛИ, · для И (часто опускается), черта сверху для НЕ.
Ключевые законы включают коммутативный, ассоциативный и дистрибутивный (как в обычной алгебре), а также:
- тождественный ⟨$A + 0 = A$⟩, ⟨$A \cdot 1 = A$⟩; нулевой ⟨$A + 1 = 1$⟩, ⟨$A \cdot 0 = 0$⟩.
- идемпотентный ⟨$A + A = A$⟩; обратный ⟨$A + \overline{A} = 1$⟩, ⟨$A \cdot \overline{A} = 0$⟩.
- Законы де Моргана: ⟨$(A + B)' = A' \cdot B'$⟩; ⟨$(A \cdot B)' = A' + B'$⟩ — отрицать всё выражение, поменять местами И/ИЛИ, отрицать каждый операнд.
- поглощение: ⟨$A + AB = A$⟩.
Упрощение уменьшает количество слагаемых, поэтому resulting логическая схема имеет меньше вентилей. Пример: $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
Законы с их названиями (цитируйте название каждого шага, когда требуется «показать все вычисления»).
| Закон | Форма ИЛИ | Форма И |
|---|---|---|
| тождественный | ⟨$A + 0 = A$⟩ | ⟨$A \cdot 1 = A$⟩ |
| нулевой (аннулирование) | ⟨$A + 1 = 1$⟩ | ⟨$A \cdot 0 = 0$⟩ |
| идемпотентный | ⟨$A + A = A$⟩ | ⟨$A \cdot A = A$⟩ |
| дополняющий (обратный) | ⟨$A + \overline{A} = 1$⟩ | ⟨$A \cdot \overline{A} = 0$⟩ |
| коммутативный | ⟨$A + B = B + A$⟩ | ⟨$A \cdot B = B \cdot A$⟩ |
| ассоциативный | ⟨$A + (B + C) = (A + B) + C$⟩ | ⟨$A(BC) = (AB)C$⟩ |
| дистрибутивный | $A + BC$ $= (A + B)(A + C)$ |
$A(B + C)$ $= AB + AC$ |
| поглощение | ⟨$A + AB = A$⟩ | ⟨$A(A + B) = A$⟩ |
| де Морган | ⟨$\overline{A + B} = \overline{A} \cdot \overline{B}$⟩ | ⟨$\overline{A \cdot B} = \overline{A} + \overline{B}$⟩ |
| двойное отрицание | ⟨$\overline{\overline{A}} = A$⟩ |
Разобранный пример. Упростите $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, показав все вычисления.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (де Морган для внешней черты) $= A \cdot B + A + B$ (двойное отрицание) $= A + B$ (поглощение, $A + AB = A$, применено с $A + B$, поглощающим $AB$).
Разобранный пример. Упростите $(\overline{A + B}) \cdot (\overline{A} + B)$.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (де Морган) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (дистрибутивный) $= \overline{A}\,\overline{B} + 0$ (идемпотентный, дополняющий) $= \overline{A}\,\overline{B}$.
Разобранный пример. Упростите $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (дистрибутивный) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (дополняющий, тождественный) $= \overline{B}(\overline{A} + AC)$ (дистрибутивный) $= \overline{B}(\overline{A} + C)$, используя $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Применение де Моргана к трехвходовому терму работает аналогично: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Сумма произведений из таблицы истинности. Возьмите каждую строку, где выход равен 1, запишите И входных переменных (переменная берется с чертой, если она равна 0), и объедините эти произведения через ИЛИ: строка с ⟨$A = 1, B = 0, C = 1$⟩ дает ⟨$A\,\overline{B}\,C$⟩. Это форма суммы произведений, которую просят на экзамене, и она служит отправной точкой как для алгебраического упрощения, так и для карты Карно.
Исследовать
Булева алгебра
A·B, A+B, Ā …
Булева алгебра — это просто эти логические элементы, записанные как выражения — сравните таблицы истинности.
Исследовать
Таблицы истинности булевых выражений
Выберите оператор и входные данные, чтобы построить его таблицу истинности — алгебру, стоящую за логическими схемами.
Словарь
Тренировать
| English | Русский |
|---|---|
| half adder/hɑːf ˈædə/ | Полуаддитор |
15.2
Карты Карно
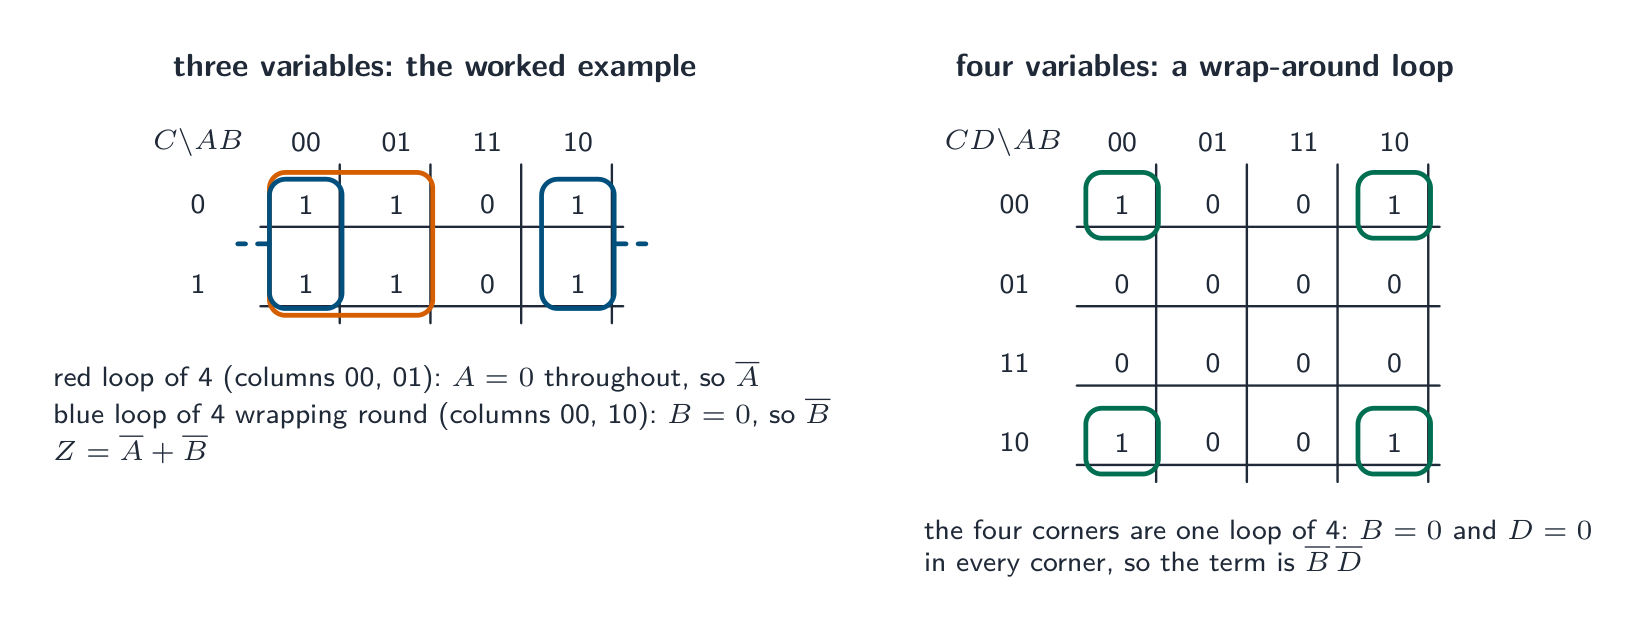
Карта Карно (K-карта) упрощает булево выражение путём группировки соседних 1 из таблицы истинности. Столбцы и строки используют порядок кода Грея (00, 01, 11, 10), чтобы соседние ячейки отличались ровно на одну переменную.
Разместите 1 в каждой ячейке, где вывод равен 1. Найдите прямоугольные группы 1, стороны которых равны степеням 2 (1, 2, 4, 8), с охватом краев, если это создает большую группу. Чем больше группа, тем проще термин: группа из 2 убирает одну переменную, группа из 4 убирает две и так далее — переменные, изменяющиеся внутри группы, исчезают. ИЛИ сгруппируйте члены для получения упрощенного выражения. Покройте все 1, используя как можно меньше и максимально крупные группы.
Разобранное решение. Карта Карно для $A$ и $B$ содержит 1 в ячейках $\overline{A}B$ и $AB$. Упростите. Два 1 являются смежными — они находятся в одном столбце $B=1$, поэтому объединяем их в прямоугольник из 2. Внутри этой группы $B$ остается неизменным на уровне 1, а $A$ меняется от 0 до 1; любая переменная, изменяющаяся внутри группы, исчезает. Таким образом, группа дает просто $X = B$. Сравните это с суммой произведений, записанной напрямую из таблицы, $\overline{A}B + AB$: та же схема, но на два элемента меньше. Два правила выполняют основную работу — делайте каждую группу максимально возможной (группа из 2 убирает одну переменную, из 4 — две, из 8 — три) и помните, что карта сворачивается по краям, поэтому левый и правый столбцы смежны. Именно этот «сворот» чаще всего упускают кандидаты.
Построение и чтение карты Карно. Обозначьте столбцы $AB$ и строки $C$ (или $CD$) в порядке кода Грея 00 01 11 10, так чтобы соседние ячейки отличались только одной переменной. Поставьте 1 в каждой ячейке, чей минтерм встречается в выражении (или чья строка таблицы истинности выдает 1). Затем проведите наименьшее количество наибольших контуров, покрывающих все 1: каждый контур должен быть прямоугольником из $1, 2, 4$ или $8$ ячеек; контуры могут перекрываться, могут оборачиваться через левый–правый и верхний–нижний края, а четыре угла вместе образуют один контур. Для каждого контура запишите переменные, которые являются постоянными внутри него (с чертой, если 0), и объедините (OR) члены контуров: это оптимальная сумма произведений. Зачем это нужно? Это дает самое простое выражение без алгебры, за несколько шагов, с меньшей вероятностью ошибки, и одна и та же карта подходит для трех или четырех переменных.
Разобранное решение. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
На карте трех переменных 1 занимают столбцы 00, 01 и 10 в обеих строках. Цикл из четырех над столбцами 00 и 01 имеет постоянный $A = 0$, при этом $B$ и $C$ меняются: член $\overline{A}$. Цикл из четырех над столбцами 00 и 10 (со сворачиванием) имеет постоянный $B = 0$: член $\overline{B}$. Итого $Z = \overline{A} + \overline{B}$, что подтверждается булевой алгеброй: $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Два цикла по два также были бы верны, но не оптимальны; цикл должен быть максимально большим, насколько позволяют 1.
Разобранное решение (четыре переменные). Карта содержит 1 только в четырех углах: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ и $A\,\overline{B}\,C\,\overline{D}$. Поскольку верхняя и нижняя строки смежны, как и крайние столбцы, углы образуют один цикл из четырех; в них все значения $B = 0$ и $D = 0$ постоянны, а $A$ и $C$ меняются, следовательно, получаем $Z = \overline{B}\,\overline{D}$.
15.2
Полусумматор и полный сумматор

Полусумматор складывает два однобитных числа $A$ и $B$, давая сумму $S$ и перенос $C$:
| A | B | S | C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
Таким образом, $S = A \text{ XOR } B$ и $C = A \text{ AND } B$. Он игнорирует входной перенос — отсюда «полусумматор».
Полный сумматор складывает три бита ($A$, $B$, входной перенос), давая сумму и выходной перенос: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Его можно собрать из двух полусумматоров и вентиля OR. Цепочка полных сумматоров (где выходной перенос каждого подается на входной перенос следующего) образует многобитный сумматор с «цепной передачей» переноса (ripple-carry adder).

Полная таблица истинности полусумматора. При входах $A$, $B$ и переносе на входе $C_{\text{in}}$: сумма $S$ равна 1, когда количество входных сигналов, равных 1, нечетно, а перенос на выходе равен 1, когда два или более входа равны 1.
| $A$ | $B$ | $C_{\text{in}}$ | $S$ | $C_{\text{out}}$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
Вопросы по схеме, которые ставит экзамен. Дана схема из вентиля XOR и вентиля AND с общими входами, либо двух полусумматоров и вентиля OR: «дополните таблицу истинности (покажите решение)» означает добавление столбца для каждого промежуточного выхода вентиля и заполнение строк по порядку; «укажите название схемы» — это полусумматор или полный сумматор; «укажите назначение каждого выхода» — это сумма битов и перенос в следующий разряд. Сумма произведений для полусумматора: $S = \overline{A}B + A\overline{B}$, $C = AB$. Цепочка полных сумматоров, передающих свой выходной перенос на входной перенос следующего, складывает два многобитных числа.
Исследовать
Вентили внутри сумматора
Бит суммы полусумматора — это вентиль XOR, а бит переноса — вентиль AND — измените A и B и посмотрите, как загорится соответствующая строка таблицы истинности.
Словарь
Тренировать
| English | Русский |
|---|---|
| carry/ˈkæri/ | перенос |
| full adder/fʊl ˈædə/ | полный сумматор |
15.2
Триггеры
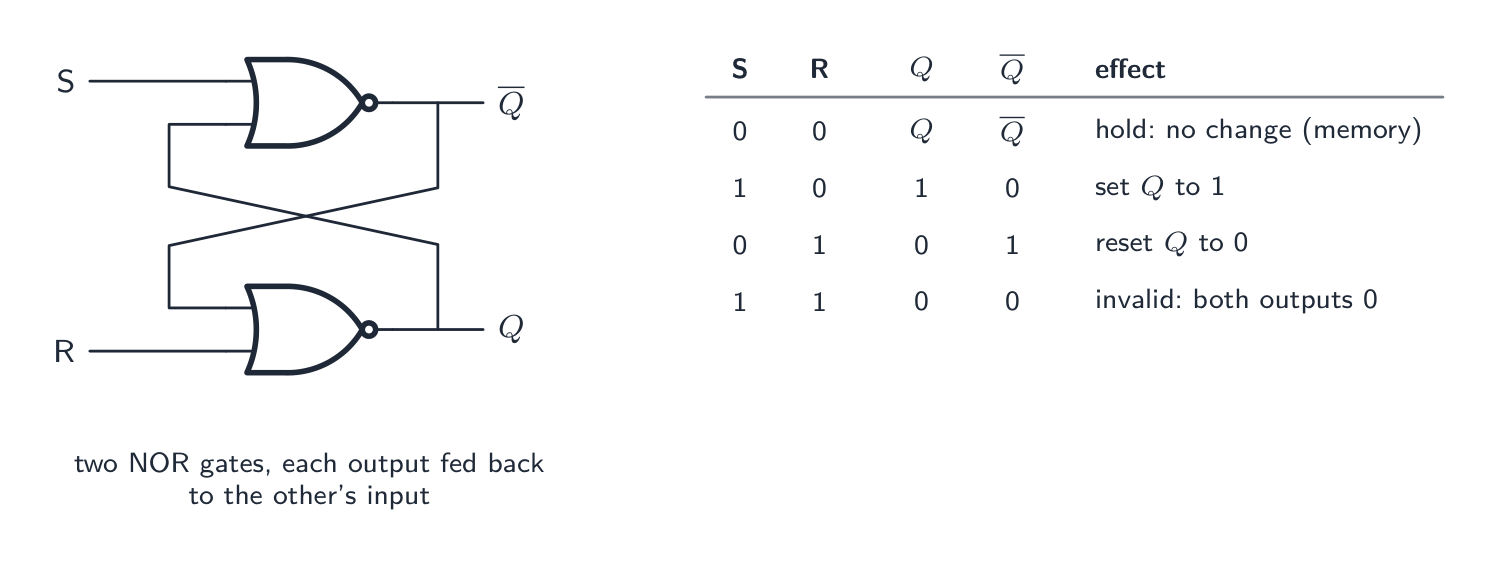
Триггер — это бистабильная схема — два устойчивых состояния (0 и 1), которая помнит свое состояние. Он хранит один бит и является базовым элементом регистров и SRAM.
SR-триггер
SR-триггер SR имеет входы S (установка) и R (сброс) и выходы Q и $\overline{Q}$. S=1,R=0 устанавливает Q в 1; S=0,R=1 сбрасывает его в 0; S=0,R=0 удерживает; S=1,R=1 является недопустимым. Собирается из двух взаимоувязанных вентилей NOR.
"Нарисуйте логическую схему SR-триггера и подпишите входы." Два NOR-вентиля (или два NAND-вентиля), выход каждого подключен обратно к одному из входов другого; свободный вход одного вентиля — это S, другого — R; выходы — это $Q$ и $\overline{Q}$. Обратная связь — именно за это дают баллы: без нее нет памяти. «Укажите назначение триггера». Хранить один бит данных; это базовый элемент памяти, из которого собираются регистры и статическое ОЗУ, и он удерживает свое значение до тех пор, пока его специально не изменят. Недопустимый вход $S = R = 1$ делает оба выхода равными 0, поэтому $\overline{Q}$ больше не является дополнением к $Q$, а состояние после возврата обоих входов в 0 непредсказуемо, что является слабостью SR-триггера.
JK-триггер
JK-триггер JK улучшает предыдущий вариант, используя ранее недопустимый вход 1,1 как переключение (выход инвертируется). Это делает его идеальным для построения счетчиков (цепочки переключающихся триггеров). Обычно он синхронизируется по тактовому сигналу — входы реагируют только на фронт тактового сигнала, синхронизируя работу триггеров.

Триггеры являются строительными блоками регистров (n бит = n триггеров), счетчиков и ячеек SRAMRAM.
Таблица истинности JK-триггера. Вход синхронизации определяет момент считывания входов J и K, поэтому выход изменяется только при тактовом импульсе: при $J = K = 0$ выход удерживается; $J = 1, K = 0$ устанавливает $Q$ в 1; $J = 0, K = 1$ сбрасывает его в 0; $J = K = 1$ инвертирует (Q становится $\overline{Q}$). Последняя строка — это запретный вход SR-триггера, превращённый в полезный, благодаря чему JK-триггер предпочтительнее: каждая комбинация входов допустима, а синхронная работа делает его базовым элементом счётчиков и регистров сдвига.
Словарь
Тренировать
| English | Русский |
|---|---|
| flip-flop/flɪp flɒp/ | триггер |
| bistable/baɪˈsteɪbl/ | бистабильный элемент |
| toggle/ˈtɒɡl/ | переключение |
| counters/ˈkaʊntəz/ | счётчики |
| SRAM/ˈesræm/ | статическое ОЗУ |
| clock/klɒk/ | тактовый сигнал |
| SR flip-flop/ˌes ˈɑː flɪp flɒp/ | SR-триггер |
| JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ | JK-триггер |
15.2
Определения, принимаемые экзаменатором
Вопросы на определение оцениваются по фиксированной формулировке. Выучите их точно и дайте только один ответ.
| Термин | Определение |
|---|---|
| RISC | процессор с малым набором простых инструкций фиксированной длины, выполняемых в основном за один тактовый цикл, использующий множество регистров и конвейеризацию |
| CISC | процессор с большим набором сложных инструкций переменной длины, многие из которых занимают несколько тактовых циклов и обращаются к памяти напрямую |
| конвейеризация | разделение цикла выборки–исполнения на этапы, позволяющее обрабатывать одновременно несколько инструкций, каждая из которых находится на своём этапе |
| SISD / SIMD / MISD / MIMD | одна инструкция на одном элементе данных; одна инструкция на многих элементах данных; много инструкций на одном элементе данных; много инструкций на многих элементах данных |
| massively parallel computer (массово параллельный компьютер) | тысячи процессоров, каждый со своей памятью, соединённых сетью и работающих одновременно над одной задачей |
| виртуальная машина | программная эмуляция вычислительной системы, работающая на хосте и ведущая себя как отдельная физическая машина |
| гипервизор | программное обеспечение, создающее виртуальные машины и распределяющее аппаратные ресурсы хоста между ними |
| таблица истинности | таблица, перечисляющая все возможные комбинации входов логической схемы и соответствующие им выходы |
| сумма произведений | булево выражение, записанное как дизъюнкция конъюнкции термов, по одному терму для каждой комбинации входов, дающей 1 |
| Карта Карно | сетка выходов таблицы истинности, расположенных в порядке Грея, где циклы смежных 1 дают упрощенное выражение |
| полусумматор | схема, складывающая два бита и выдающая сумму и перенос |
| полный сумматор | схема, складывающая два бита и входной перенос, выдающая сумму и выходной перенос |
| триггер | бистабильная схема, хранящая один бит, удерживающая свой выход до тех пор, пока входы не изменят его состояние |
Словарь
Тренировать
| English | Русский |
|---|---|
| massively parallel/ˈmæsɪvli ˈpærəlel/ | Массовая параллельность |
| distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ | распределённая память |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | машинное обучение |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | Суперкомпьютеры |
15.2
Советы для экзамена
- RISC и CISC отвечают в виде списков характеристик: простые, фиксированные, один цикл, много регистров, загрузка/выгрузка, конвейеризация против сложных, переменных, многотактных, меньше регистров, прямой доступ к памяти, микрокода. По четыре пункта.
- Конвейеризация: этапы, несколько инструкций одновременно, одна завершается за цикл, выше пропускная способность; $n + k - 1$ циклов для $n$ инструкций через $k$ этапов; прерывания должны опустошить конвейер.
- Четыре категории Флинна: «сколько потоков инструкций» на «сколько потоков данных»; скажите, что выполняется на чём. Massively parallel: много процессоров, собственная память, сеть, решение одной задачи.
- Виртуальная машина: эмуляция компьютера на хосте; ОС хоста на железе, гипервизор делит его, гостевая ОС внутри. Два преимущества и два ограничения, каждое — полное предложение.
- Булева алгебра: называйте каждый закон при применении; де Морган меняет оператор и инвертирует каждый терм; проверяйте таблицей истинности, если сомневаетесь.
- Карта Карно: порядок кода Грея, максимальные контуры из 1/2/4/8 единиц, допускается огибание, один терм на контур с неизменяющимися переменными. Укажите почему: самое простое выражение без алгебры.
- Полусумматор даёт сумму и перенос; полный сумматор также принимает входной перенос; SR-триггер — это две перекрёстно связанных NOR/NAND вентилей, хранящих один бит; вход 1,1 у JK инвертирует состояние.
Распространенные ошибки
- Обмен списками характеристик RISC и CISC местами или указание «быстрее» как характеристики; приводите конструктивные особенности, а не вердикт.
- Описание конвейеризации как «выполнения инструкций параллельно на нескольких ядрах»; это этапы одного процессора, перекрывающие друг друга.
- Смешение SIMD (одна инструкция, много данных) с MIMD (много всего), или описание MISD как типичного случая.
- Определение виртуальной машины как «копии компьютера» без слова «эмуляция» или упоминания хоста и гостя.
- Применение де Моргана только к части выражения под длинной чертой или удаление черты без замены AND на OR.
- Контур из трёх элементов или прямоугольной формы в карте Карно; упорядочивание столбцов 00, 01, 10, 11 вместо кода Грея.
- Запись переноса полусумматора как XOR, а суммы как AND.
- Рисунок SR-триггера двумя вентилями без обратной связи или отсутствие запрещённого состояния в таблице истинности.
Интерактивные уроки по этой теме
Пройдите его шаг за шагом с упражнениями мгновенной проверки.