RISC, CISC and pipelining
Введено| English | Значение |
|---|---|
| CISC/sɪsk/ | Сложный набор инструкций |
| RISC/rɪsk/ | Упрощённый набор инструкций |
| pipelining/ˈpaɪplaɪnɪŋ/ | Конвейеризация |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | Таксономия Флинна |
| register/ˈredʒɪstə/ | регистр |
| ALU/ˌeɪ el ˈjuː/ | Арифметико-логическое устройство (АЛУ) |
| hazard/ˈhæzəd/ | Зависимость (конфликт) |
| SIMD/ˈsɪmdiː/ | Одна инструкция — множество данных |
| MIMD/ˈmɪmdiː/ | Множество инструкций — множество данных |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | Массовая параллельность |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | Суперкомпьютеры |
Телефон в вашем кармане не работает на Intel
- Тридцать лет самые быстрые процессоры были самыми сложными: добавьте инструкции, и каждая выполняет больше работы. Intel построила империю на этом.
- Затем небольшая британская компания поместила в телефон преднамеренно простой процессор. Меньше инструкций, все одинаковой длины, почти без обращения к памяти. Он мог выполнять меньше за одну инструкцию, но всё равно победил.
- Он победил, потому что простые, однородные инструкции можно перекрывать, а перекрытие важнее сложности.
- Этот урок касается CISC и RISC, ** конвейеризации**, четырех архитектур таксономии Флинна и того, куда ведут ограничения тепла и скорости процессора.
CISC и RISC
- CISC (Complex Instruction Set Computer) имеет множество, часто сложных инструкций: одна может выполнять несколько обращений к памяти и операций. Они имеют переменную длину, поэтому декодирование сложное. Он выполняет больше за одну инструкцию в аппаратном обеспечении. Пример: Intel x86.
- RISC (Reduced Instruction Set Computer) имеет малый набор простых инструкций, каждая выполняет одну базовую операцию, все они фиксированной длины и быстро декодируются. Только загрузка и выгрузка обращаются к памяти; всё остальное происходит между регистрами. Пример: ARM.
- Программы RISC длиннее, но каждая инструкция выполняется быстро и предсказуемо, что именно необходимо конвейеру.
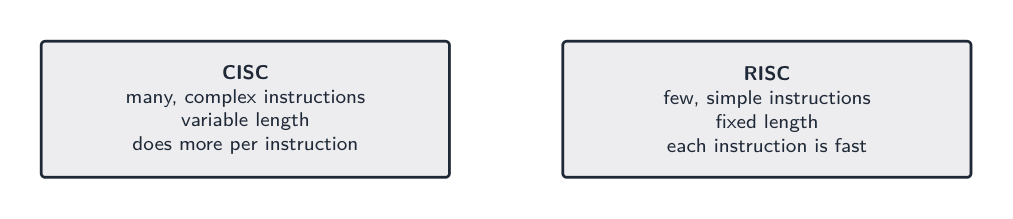
Больше на одну инструкцию, либо быстрее и более предсказуемо на одну инструкцию
A RISC processor is characterised by:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
RISC keeps instructions few, simple and fixed-length (usually 1 cycle); CISC has many complex variable-length ones.
Различия, которые требуются в экзамене
| Характеристика | CISC | RISC |
|---|---|---|
| Набор инструкций | много, сложные | мало, простые |
| Длина инструкции | переменная | фиксированная |
| Доступ к памяти | многие инструкции могут обращаться к памяти | только загрузка и выгрузка |
| Регистры | меньше | много |
| Такты на инструкцию | варьируется | обычно один |
| Конвейеризация | сложнее | естественна |
- Современные процессоры Intel преобразуют свои инструкции CISC во внутренние упрощённые микрооперации, напоминающие RISC, что является наиболее явным доказательством того, какой подход победил в споре.
Match each term to its description.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
RISC = simple + fixed-length + load/store; CISC = complex + variable-length; pipelining overlaps stages for speed.
In a RISC processor, the only instructions that access memory are load and ____.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Everything else is register to register. That restriction is what makes instructions fixed-length, uniform in timing and easy to pipeline.
Конвейеризация
- Конвейер обрабатывает инструкции на перекрывающихся этапах, как сборочная линия: выборка, декодирование, выполнение в АЛУ, доступ к памяти, запись результата.
- Каждый этап работает над различными инструкциями одновременно, поэтому после заполнения конвейера одна инструкция завершается за такт.
- Это не делает ни одну отдельную инструкцию быстрее. Оно увеличивает производительность: больше инструкций завершается в секунду.
- Фиксированная длина и простота инструкций RISC обеспечивают одинаковое время выполнения для каждого этапа, благодаря чему конвейеры RISC работают чисто, а CISC — нет.
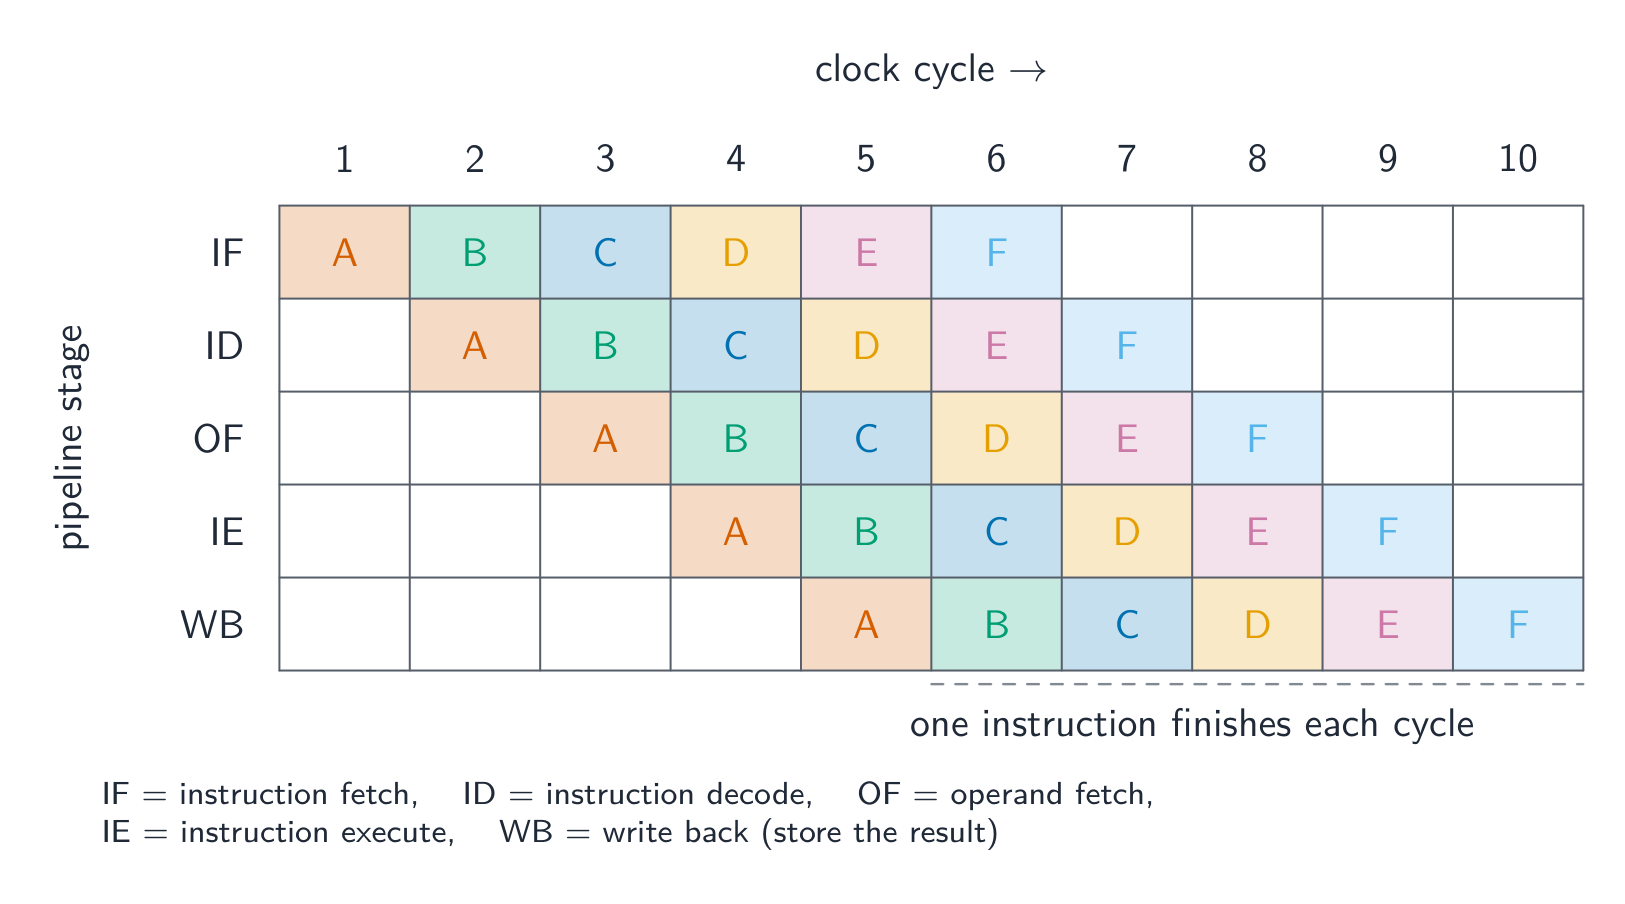
Шесть инструкций находятся в работе, одна завершается каждый такт
How pipelining fills up
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap.
When a pipeline is full, it completes about:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Overlapping the stages means a new instruction finishes each cycle once the pipeline is full.
Pipelining speeds up a processor by:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Stages of different instructions run at the same time.
Разобранное решение: почему конвейеризация быстрее
- Пятиэтапный конвейер работает с одним тактом на этап. Объясните, почему он быстрее последовательного выполнения инструкций.
- Без конвейера каждая инструкция занимает процессор на всех пяти этапах, поэтому одна завершается каждые пять тактов.
- С конвейером блок выборки начинает следующую инструкцию, пока текущая ещё находится на этапе декодирования, поэтому одновременно выполняются пять инструкций, и после заполнения конвейера одна завершается каждый такт.
- Отдельные инструкции не выполняются быстрее; возрастает производительность примерно в пять раз. Укажите это явно: это самый частый пункт, который забывают отметить.
What does pipelining actually improve?
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Stages overlap, so five instructions are in progress at once and one completes per cycle. No individual instruction is executed any faster.
Зависимости
- Зависимость вызывает простой конвейера. Зависимость по данным возникает, когда инструкция требует результат, который предыдущая ещё не выдала, поэтому она должна ждать.
- Управляющая зависимость возникает при ветвлении: до разрешения перехода процессор не знает, какую инструкцию выбирать следующей.
- Обе тратят такты, поэтому процессоры предсказывают переходы и передают результаты между этапами.
A data hazard stalls the pipeline when an instruction needs a result that is not ready yet; a control hazard comes from a branch changing which instruction runs next.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Hazards force the pipeline to stall (or flush), which is why they reduce the ideal one-per-cycle throughput.
Match each pipeline hazard to what causes it.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Both stall the pipeline and waste cycles, which is why processors forward results between stages and predict branches.
Таксономия Флинна
- Таксономия Флинна классифицирует компьютеры по количеству потоков инструкций и потоков данных.
- SISD: один инструкционный поток, один поток данных, традиционное одноядерное устройство.
- SIMD: одна инструкция обрабатывает множество элементов данных одновременно. Это видеокарта или векторный блок процессора, подходящий для изображений, видео и научных массивов.
- MISD: несколько операций над одними данными; редко встречается и чаще всего теоретичен. MIMD: множество процессоров выполняют различные инструкции над разными данными, что представляет собой многоядерный процессор или кластер, и является наиболее универсальным.
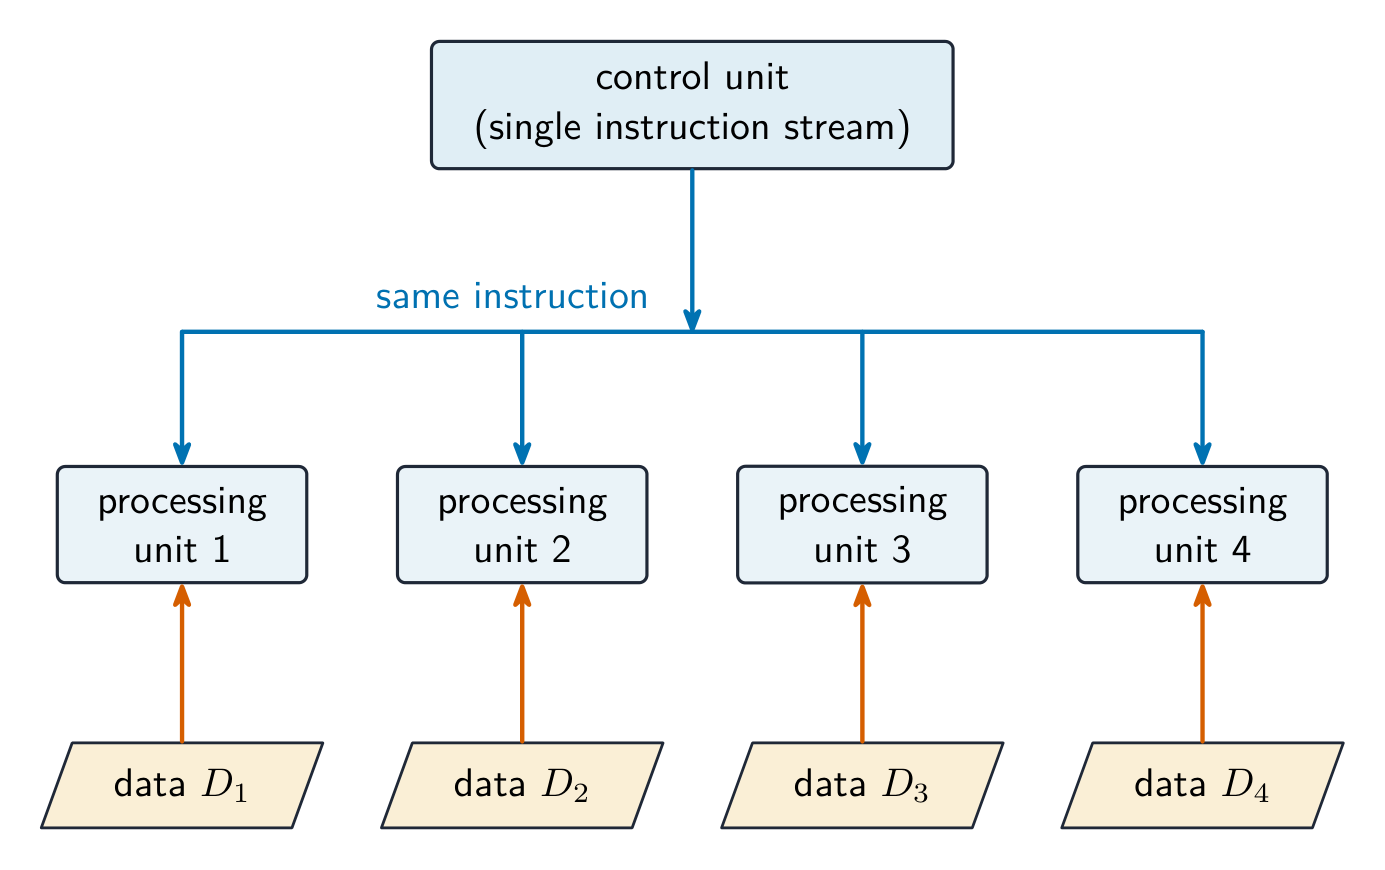
Одна инструкция, множество элементов данных
Which describe SIMD? Select все that apply.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Different programs on different data is MIMD, the multi-core case. SIMD is one instruction stream over many data streams.
Масштабно параллельные компьютеры
- Масштабно параллельная система использует тысячи процессоров, соединённых быстрой сетью, каждый из которых имеет собственную память, обмениваясь данными посредством сообщений, а не разделяя память.
- Это MIMD, требующее специально написанного программного обеспечения, поскольку программист должен разделить задачу и управлять коммуникацией.
- Именно такими являются крупнейшие суперкомпьютеры: моделирование климата, обучение машинного обучения и астрофизика работают таким образом.
A massively parallel computer's processors share one block of memory.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Each processor has its own memory, and they exchange data by messages over a fast network. That distributed memory is what the term means.
Разобранное решение: определите тип машины
- Видеокарта применяет одинаковую коррекцию яркости к двум миллионам пикселей. SIMD: одна инструкция, множество элементов данных, что именно предназначено для тысяч малых ядер GPU.
- Четырёхъядерный ноутбук одновременно запускает браузер, компилятор и музыкальный плеер. MIMD: различные инструкции над разными данными, один поток на ядро.
- Метеостанция делит атмосферу на сетку across ten thousand processors, each with its own memory, passing boundary values as messages. Масштабно параллельная, что является формой MIMD.
- Назовите категорию, затем обоснуйте количеством инструкционных и потоков данных.
Потерянные баллы
- Конвейеризация повышает производительность; она не сокращает длительность отдельной инструкции. Укажите это.
- В RISC только загрузка и выгрузка обращаются к памяти. Этот один факт объясняет фиксированную длину, большое количество регистров и чистоту конвейера.
- SIMD — одна инструкция над многими данными; MIMD — множество инструкций над многими данными. Посчитайте потоки перед ответом.
- Масштабно параллельная означает тысячи процессоров с распределённой памятью и обменом сообщениями, а не просто «быстрый компьютер».
Вы поняли
- CISC: много сложных переменных инструкций, больше на одну инструкцию · RISC: мало простых фиксированных инструкций, только загрузка и выгрузка, много регистров, один такт каждая
- ** конвейер ** перекрывает выборку, декодирование, выполнение, обращение к памяти и запись результата, поэтому при полной загрузке каждый такт завершается одна инструкция: выше ** пропускная способность **, но не более быстрые инструкции; ** данные ** и ** управляющие помехи ** останавливают его
- ** Флинн **: SISD, ** SIMD ** (GPU), MISD, ** MIMD ** (многопотоковые процессоры)
- ** массовая параллельность **: тысячи процессоров, распределённая память, обмен сообщениями, MIMD, используются суперкомпьютерами