| English | 의미 |
|---|---|
| CISC/sɪsk/ | 복합 명령어 집 |
| RISC/rɪsk/ | 간소화 명령어 집 |
| pipelining/ˈpaɪplaɪnɪŋ/ | 파이프라인 |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | 플린 분류법 |
| register/ˈredʒɪstə/ | 레지스터 |
| ALU/ˌeɪ el ˈjuː/ | 산술 논리 유닛(ALU) |
| hazard/ˈhæzəd/ | 위험 |
| SIMD/ˈsɪmdiː/ | 단일 명령어 다중 데이터 |
| MIMD/ˈmɪmdiː/ | 다중 지령 다중 데이터 |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 대규모 병렬 처리 |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | 슈퍼컴퓨터 |
주머니 속 전화기는 인텔 프로세서를 사용하지 않는다
- 30년 동안 가장 빠른 프로세서는 가장 복잡한 ones이었다: 명령어를 추가하면 각 ones이 더 많은 작업을 수행했다. 인텔은 이를 기반으로 제국을 건설했다.
- 이후 작은 영국의 회사가 의도적으로 간단한 프로세서를 전화기에 넣었다. fewer instructions, 모든 동일한 길이, 메모리에 거의 닿지 않음. instruction당 더 많은 일을 할 수는 없었지만, 그럼에도 승리했다.
- 승리한 이유는 단순하고 일관된 명령어들은 중첩(overlapped) 될 수 있으며, 중첩이 복잡성보다 더 가치 있기 때문이다.
- 이 교훈은 CISC, RISC, 파이프라인(pipelining), 플린의 분류법(Flynn's taxonomy)의 네 가지 아키텍처, 그리고 프로세서의 열과 속도 한계가 어디로 이어지는지를 포함한다.
CISC와 RISC
- CISC(Complex Instruction Set Computer)는 ** banyak(many), often complex** instructions: one may perform several memory accesses and operations. They are of variable length, so decoding is intricate. It does more per instruction, in hardware. Example: Intel x86.
- RISC(Reduced Instruction Set Computer)는 작고 단순한 명령어 set을 가지며, 각 명령어는 하나의 기본 작업을 수행하고, 모두 고정 길이이며 복호화가 빠릅니다. 오직 load와 store만 메모리를 접촉하며, 나머지는 모두 레지스터 간 작업입니다. 예: ARM.
- RISC 프로그램은 길지만, 각 명령어는 빠르고 예측 가능하여 파이프라인이 정확히 필요로 하는 특성을 가집니다.

명령어당 더 많은 기능, 또는 명령어당 빠르고 예측 가능함
RISC 프로세서는 다음과 같은 특징을 가집니다:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
RISC는 Few指令, 단순하고 고정 길이(通常 1 사이클); CISC는 복잡하고 가변 길이의 Many指令.
시험에서 요구하는 차이점
| 기능 | CISC | RISC |
|---|---|---|
| 명령어 set | 많음, 복잡함 | 적음, 단순함 |
| 명령어 길이 | 가변 | 고정 |
| 메모리 접근 | 여러 명령어가 메모리에 접근할 수 있음 | 오직 load와 store |
| 레지스터 | 적음 | 많음 |
| 명령어당 사이클 | 변동적 | 보통 하나 |
| 파이프라이닝 | 어려움 | 자연스러움 |
- 현대 인텔 칩은 내부적으로 CISC 명령어를 더 간단한 RISC 스타일의 마이크로 오퍼레이션으로 변환하는데, 이는 어떤 설계가 논쟁에서 승리를 했는지 가장 명확한 증거입니다.
각 용어와 설명을 매칭하십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
RISC = 단순함 + 고정 길이 + 로드/스토어; CISC = 복잡함 + 가변 길이; 파이프라인은 속도를 위해 단계를 오버랩시킵니다.
RISC 프로세서에서 메모리에 접근하는 유일한 명령어는 load와 ____입니다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
나머지 모든 것은 레지스터 간 연산입니다. 이 제한이 명령어의 길이를 고정하고 타이밍을 균일하게 하며 파이프라인 처리를 용이하게 합니다.
파이프라이닝
- 파이프라인은 조립 라인처럼 명령어를 중첩된 단계에서 처리합니다:.fetch, decode, ALU에서의 execute, 메모리 접근, write back.
- 각 단계는 동시에 서로 다른 명령어를 처리하므로, 파이프라인이 채워지면 사이클마다 한 개의 명령어가 완료됩니다.
- 단일 명령어의 속도를 높이지 않습니다. **스루풋(throughput)**을 증가시킵니다: 초당 더 많은 명령어가 완료됩니다.
- RISC의 고정 길이 및 단순한 명령어는 모든 단계를 동일한 시간으로 만들어 RISC 파이프라인이 깔끔하게 작동하고 CISC는 그렇지 않은 이유입니다.
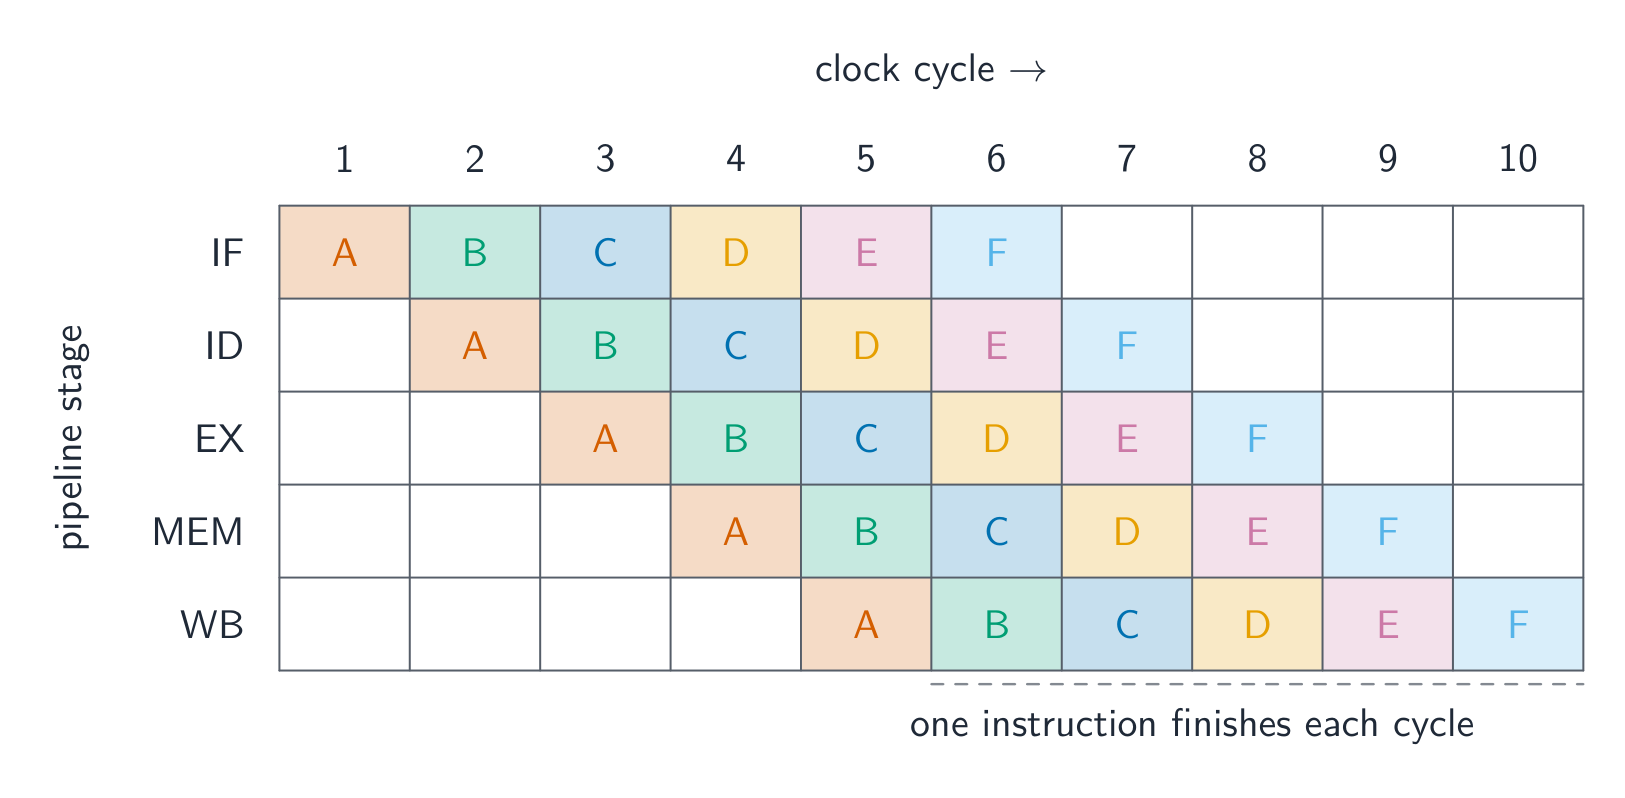
비행 중인 여섯 명령어, 사이클마다 하나 완료
파이프라인이 채워지는 과정
클럭 사이클을 단계별로 살펴보십시오. 파이프라인이 가득 차면 — 각 명령어가 여전히 여러 단계를 거치더라도 — 서로 다른 명령어의 단계가 겹치므로 매 클럭 사이클마다 새로운 명령어가 완료됩니다.
파이프라인가 가득 차면, 약 다음과 같이 완료됩니다:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
스테이지를 오버랩하면 파이프라인가 채워진 후 매 사이클마다 새로운 명령어가 완료됩니다.
파이프라이닝은 프로세서를 다음처럼 가속화합니다:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
서로 다른 명령어의 스테이지가 동시에 실행됩니다.
worked example: 파이프라이닝이 빠른 이유
- 5단계 파이프라인이 단계당 한 사이클로 작동합니다. 왜 순차적으로 명령어를 행하는 것보다 빠른지 설명하십시오.
- 파이프라인이 없으면 각 명령어가 프로세서를 5단계 전체에 점유하므로 5사이클마다 하나 완료됩니다.
- 파이프라인에서는 현재 명령어가 아직 디코딩되는 동안 다음 명령어의 fetch가 시작되므로 5개의 명령동이 동시에 진행되고, 채워지면 사이클마다 하나가 완료됩니다.
- No individual instruction is executed faster; the throughput rises about fivefold. Say that explicitly: it is the mark most often missed.
파이프라이닝이 실제로 개선하는 것은 무엇입니까?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
스테이지가 오버랩되어 5개의 명령어가 동시에 진행되고 매 사이클마다 1개가 완료됩니다. 개별 명령어의 실행 속도는 빨라지지 않습니다.
해저드(Hazards)
- **해저드(hazard)**는 파이프라인을 정지시킵니다. **데이터 해저드(data hazard)**는 명령어가 이전 명령어가 아직 생성하지 않은 결과를 필요로 하여 기다려야 할 때 발생합니다.
- **제어 해저드(control hazard)**는 분기(branch)에서 발생합니다: 분기가 해결되기 전까지 프로세서는 다음에 어떤 명령어를FETCH해야 할지 알 수 없습니다.
- 둘 다 사이클을 낭비하므로 프로세서는 분기를 예측하고 단계 간에 결과를 전달(foreward)합니다.
데이터 하저드는 명령어가 아직 준비되지 않은 결과를 필요할 때 파이프라인을 정지시키고, 제어 하저드는 분기 지점에 의해 다음에 실행될 명령어가 결정됨으로써 발생합니다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
하자는 파이프라인이 스탈(또는 플러시)되게 하여, 이상적인 1사이클당 처리량을 낮추게 합니다.
각 파이프라인 하저드와 이를 유발한 원인을 짝매우십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
둘 다 파이프라인을 정지시키고 사이클을 낭비하므로, 프로세서는 스테이지 간 결과 전달 및 분기 예측을 사용합니다.
플린의 분류(Flynn's taxonomy)
- 플린의 분류는 컴퓨터를 명령어 스트림과 데이터 스트림의 개수에 따라 분류합니다.
- SISD: 하나의 명령어 스트림, 하나의 데이터 스트림, 전통적인 단일 코어.
- SIMD: 하나의 명령어가 여러 데이터 항목을 동시에 조작합니다. GPU 또는 CPU 벡터 유닛이며, 이미지, 영상, 과학용 배열에 적합합니다.
- MISD: 같은 데이터에 대한 여러 연산; 드물고 대부분 이론적입니다. MIMD: 여러 프로세서가 서로 다른 데이터에 대해 서로 다른 명령어를 실행하며, 이는 멀티 코어 CPU 또는 클러스터이며 가장 일반적인 형태입니다.
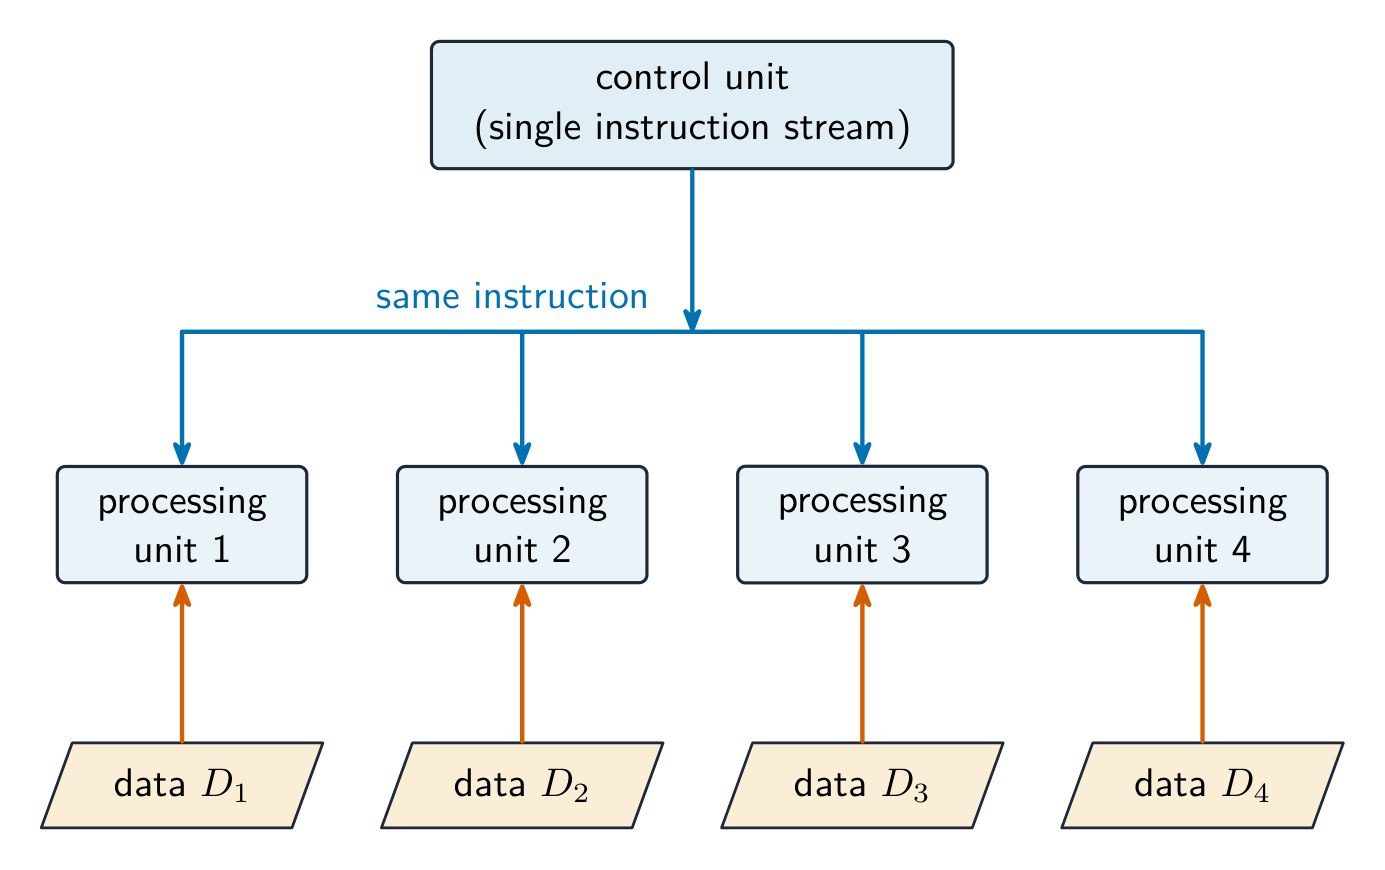
하나의 명령어, 여러 데이터 항목
SIMD를 설명하는 것을 선택하십시오. 모두 적용되는 것을 선택하십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
서로 다른 데이터에서 서로 다른 프로그램은 MIMD이며, 멀티코어 사례입니다. SIMD는 여러 데이터 스트림 위에 하나의 명령어 스트림입니다.
대량 병렬计算机(Massively parallel computers)
- 대량 병렬(massively parallel) 시스템은 수천 개의 프로세서를 고속 네트워크로 연결하여 사용하며, 각 프로세서는 자신의 메모리를 가지고 있으며, 메모리를 공유하는 대신 **메시지(message)**로 데이터를 교환합니다.
- MIMD이며, specially written software가 필요합니다. 프로그래머는 문제를 나누고 통신을 관리해야 하기 때문입니다.
- 이것이 가장 큰 **슈퍼컴퓨터(supercpuers)**의 모습입니다: 기후 시뮬레이션, 머신러닝 훈련, 천체 물리학 등이 이 방식으로 작동합니다.
대규모 병렬 컴퓨터의 프로세서는 하나의 메모리 블록을 공유합니다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
각 프로세서는 자체 메모리를 가지며, 빠른 네트워크를 통해 메시지를 exchanging으로 데이터를 교환합니다. 이것이 분산 메모리의 의미입니다.
worked example: 기계 배치하기
- 그래픽 카드는 두백만 픽셀에 동일한 밝기 조정 적용. SIMD: 하나의 명령어로 여러 데이터 항목을 처리하는 것,这正是GPU의 수천 개의 작은 코어가 설계된 목적입니다.
- 4코어 노트북이 브라우저, 컴파일러, 음악 플레이어를 동시에 실행. MIMD: 서로 다른 데이터에 대해 서로 다른 명령어, 코어당 하나의 스트림.
- 気象센터는 대기를 만 개의 프로세서로 격자형으로 나누고, 각 프로세서는 자체 메모리를 가지며境界값을 메시지 형태로 전달합니다. 대규모 병렬(Massively parallel), 이는 MIMD의 일종입니다.
- 범위를 명시한 뒤 명령어와 데이터 스트림의 개수를 근거로 정당화하십시오.
놓칠 수 있는 점
- 파이프라이닝은 **스루풋(throughput)**을 높일 뿐, 단일 명령어의 시간을 단축하지 않습니다. 그렇게 말하십시오.
- RISC에서 오직 load와 store만 메모리를 접촉합니다. 그 한 가지 사실은 고정 길이, 많은 레지스터, 깨끗한 파이프라인을 설명합니다.
- SIMD는 하나의 명령어에 여러 데이터; MIMD는 여러 명령어에 여러 데이터입니다. 답하기 전에 스트림을 세십시오.
- 대량 병렬은 단순히 "빠른 컴퓨터"가 아니라 **분산 메모리(distributed memory)**와 메시지 패싱이 있는 수천 개의 프로세서를 의미합니다.
이해했습니다
- CISC: 많은 복잡한 가변 길이 명령어, 명령어당 더 많은 기능 · RISC: 적은 단순 고정 길이 명령어, 오직 load와 store, 많은 레지스터, 사이클당 하나
- 파이프라인은 명령어_FETCH_, Decode, Execute, Memory, Write-back 단계를 겹치게 처리하므로, 완전히 채워진 상태에서는 한 사이클당 하나의 명령어가 완료됩니다. 이는 **처리량(Throughput)**을 높이는 것이지, 개별 명령어의 속도를 빠르게 만드는 것이 아닙니다. **데이터 및 제어 충돌(Hazards)**이 발생하면 파이프라인이 정지합니다.
- 플린(Flynn) 분류법: SISD, SIMD(GPU 등), MISD, MIMD(멀티코어)
- 대규모 병렬(Massively Parallel): 수천 개의 프로세서를 사용하며, 분산 메모리와 메시지 전달 방식을 채택한 MIMD 아키텍처로, 슈퍼컴퓨터에서 주로 활용됩니다.