| English | 의미 |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | 유니코드 |
| character set/ˈkærɪktə set/ | 문자 집합 |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | 인코딩 |
| code point/kəʊd pɔɪnt/ | 코드 포인트 |
| UTF-8/ˌjuː tiː ˈef eɪt/ | UTF-8 인코딩 |
무작위 문자로 도착한 이메일
- 1990년대에는华沙에서 입력하고 도쿄에서 읽은 메시지가 종종 의미 없는 글자 덩어리로 도착했습니다. 두 컴퓨터 모두 문자당 8비트를 저장했습니다. 단순히 최상위 128 패턴의 의미를 서로 다르게 해석했기 때문입니다.
- 폴란드의 코드 페이지는 폴란드 문자를 여기에 배치했습니다. 일본의 것은 자국 문자를 배치했습니다. 전송 중 데이터는 손상되지 않았으며, 바이트는 원본 그대로 도착하여 다른 표에 따라 읽혔습니다.
- 해결책은 국가별 표를 폐지하고 모든 스크립트의 모든 문자에 영구적으로 하나의 번호를 부여하는 것이었습니다. 이것이 유니코드이며, 보내신 이모지가 동일한 이미지로 도착하는 이유입니다.
- 이 수업은 텍스트가 숫자로 변환되는 과정입니다: 문자 집합, ASCII, 유니코드, 그리고 이를 저장하는 인코딩 방식.
문자 집합은 각 문자에 번호를 부여합니다
- 컴퓨터는 문자를 저장하지 않고 오직 숫자만 저장합니다. 문자 집합은 컴퓨터가 표현할 수 있는 문자의 집합이며, 각 문자마다 고유한 이_Handle 코드가 할당됩니다.
- 한 문자의 번호는 코드 포인트입니다.
A은 65,a은 97,0숫자는 48입니다. - 코드 포인트는 문자의 의미가 아닙니다. 이는 합의된 라벨일 뿐입니다. 두 기계가 동일한 문자 집합을 사용하기 때문에만 텍스트가 가독 가능합니다.
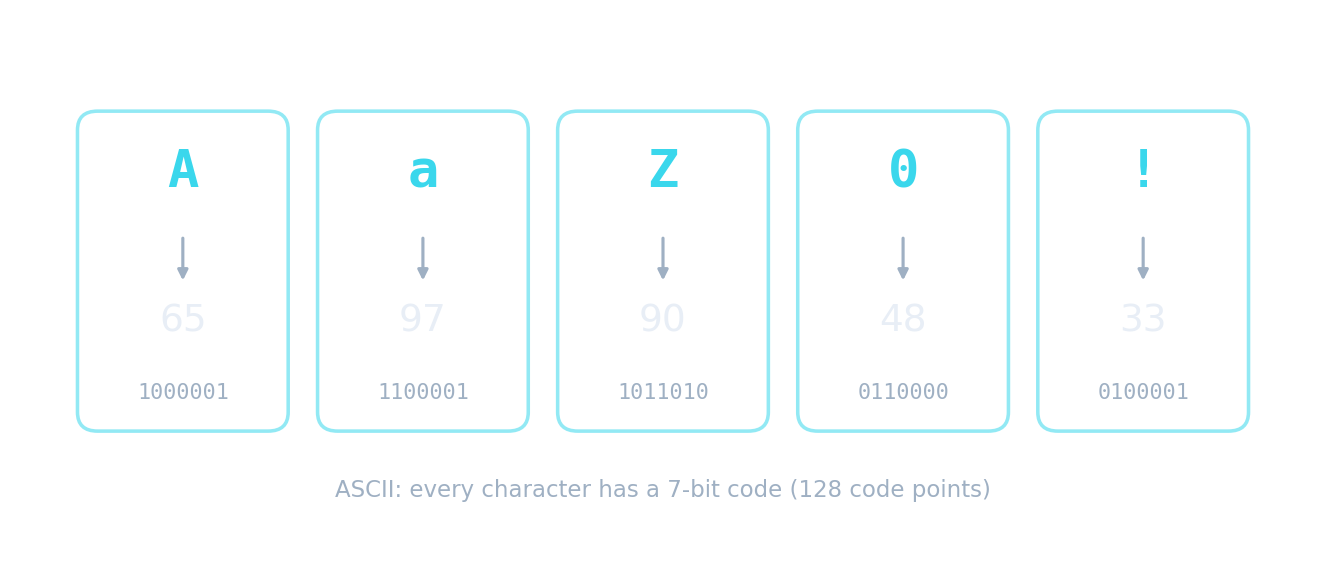
문자는 그림이며, 바이트는 숫자입니다
문자는 number로 저장됨
각 문자에는 코드 번호가 있습니다. 'A'는 65입니다. 비트를 반전시켜 이 코드를 이진수와 hex로 보고, 컴퓨터가 실제로 보관하는 방식을 정확히 확인하세요.
ASCII와 같은 문자 세트가 정의하는 것은:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
문자 세트는 각 문자를 number(코드 포인트)로 매핑하며, 이것이 컴퓨터가 실제로 저장하는 것입니다.
ASCII
- ASCII (American Standard Code for Information Interchange)는 7비트를 사용하여 $2^7 = 128$개의 코드 포인트를 제공합니다: 기본 라틴 문자, 숫자, 구두부호, 및 캐리지 리턴과 같은 32개의 제어 코드.
- 확장 ASCII는 8비트를 사용하여 256개의 코드 포인트를 제공합니다. 하위 128은 ASCII와 동일하며, 상위 128은 지역에 따라 달라져这正是 해당 이메일이 깨진 정확히 그 이유입니다.
- 특정 코드를 암기하라는 질문은 하지 않으나, 개수를 묻는 질문은 합니다: 7비트는 128개, 8비트는 256개.
7비트 ASCII는 몇 가지 서로 다른 코드 포인트를 가집니까?
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
7비트는 $2^7 = 128$개의 코드 포인트를 제공합니다.
확장 ASCII는 몇 가지 서로 다른 코드 포인트를 가집니까?
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
8비트는 2^8 = 256을 제공합니다. 하위 128은 평소 7비트 ASCII와 일치하며, 상위 128은 지역별로 다릅니다.
유니코드
- 유니코드는 범용 문자 집합입니다: 현재 또는 소멸한 모든 스크립트의 거의 모든 문자, 기호, 이모지에 대해 단일 코드 포인트를 제공하며, 총 149,000개 이상입니다.
- 코드 포인트는 저장 방식과 분리됩니다. 인코딩은 코드 포인트를 바이트로 변환합니다.
- UTF-8: UTF-8은 문자당 1~4 바이트를 사용하며 ASCII 호환성이 있습니다. 첫 번째 128 코드 포인트는 ASCII와 동일한 1바이트입니다. UTF-16은 2 또는 4 바이트를 사용하고, UTF-32은 고정된 4 바이트를 사용합니다.
UTF-8에 대해 참인 것은 무엇입니까?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
UTF-8은 가변 길이 유니코드 인코딩(1~4바이트)으로, 첫 128개 코드 포인트는 ASCII와 일치하므로 평문 ASCII 텍스트는 유효한 UTF-8입니다.
유니코드와 UTF-8의 관계는 무엇입니까?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
sets가 숫자를 할당하고, encoding이 각 숫자가 몇 바이트를 차지할지 결정합니다. UTF-16과 UTF-32는 동일한 set의 다른 인코딩입니다.
worked example: ASCII와 유니코드 비교
- 유니코드를 사용하는 것의 장점 하나와 단점 하나를 제시하십시오. [2]
- 장점: 유니코드는 훨씬 더 많은 문자를 표현하므로 중국어, 아랍어, 그리스어, 이모지 등 모든 스크립트의 텍스트를 저장할 수 있으며, 단일 문서 내에서 언어를 혼합할 수 있습니다. 국가별 코드 페이지 간 충돌이 없으므로 파일은 이동성이 높습니다.
- 단점: 영어 전용 텍스트의 경우 유니코드 파일은 일반적으로 크기가 크며, 문자당 1바이트보다 더 많은 바이트가 필요하기 때문입니다.
- 두 부분 모두 필요합니다. "더 많은 문자를 가진다"는 설명만으로는 2점 중 1점만_GETS_합니다.
ASCII 대비 유니코드의 주요 장점은:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
유니코드는 거의 모든 글쓰기 체계와 기호, 이모지를 포함하며, ASCII의 기본 영어 세트보다 훨씬 넓습니다.
영어 전용 텍스트의 경우, 유니코드 파일이 동일한 ASCII 텍스트보다 일반적으로 더 큽니다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
유니코드 인코딩은 문자당 더 많은 바이트를 사용할 수 있으므로, 평문 영어 텍스트는 7비트 ASCII보다 일반적으로 더 큽니다—보편적 커버리지를 위한 대가입니다.
ASCII 대비 유니코드의 장점은 무엇입니까? 모두 선택하십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
크기는 장점이 아닌 대가입니다: 평문 영어의 경우 유니코드 파일이 일반적으로 더 큽니다.
worked example: 텍스트 파일의 크기
- 500자의 메시지가 확장 ASCII에 저장될 때, 파일 크기는 바이트로 얼마입니까?
- 확장 ASCII는 문자당 8비트, 즉 1바이트를 사용하므로 $500 \times 1 = 500$바이트, 또는 $500 \times 8 = 4000$비트가 됩니다.
- UTF-32로 같은 메시지를 저장할 때? 문자당 4바이트이므로 2000바이트입니다.
- 비트당 문자 수를 표시한 후 곱한 뒤, 한 번에 단위 변환을 수행하십시오. 중간에 비트와 바이트를 혼용하면 보통 점수를 잃게 됩니다.
500문자 메시지가 확장된 ASCII에 저장됩니다. 헤더는 무시했을 때 몇 바이트가 필요합니까?
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
문자당 8비트, 즉 1바이트: 500 x 1 = 500바이트 또는 4000비트. UTF-32에서는 동일한 텍스트가 2000바이트가 필요합니다.
이_Handle와 Hex로 문자 읽기
- 코드 포인트는 단순히 숫자이므로 다른 숫자와 같이 변환됩니다.
A은 65이며, 이는 이_Handle로0100 0001, Hex로41입니다. - 유용한 두 패턴: 숫자
0부터9까지는 48에서 시작하며, 소문자는 대문자보다 32 크므로a(97)은A(65)에 32를 더한 값입니다. 이 차이는 단일 비트입니다. A= 65임을given하고E을 구하는 문제라면, 암기한 표가 아닌 $65 + 4 = 69$을 구해야 합니다.
A의 ASCII 코드는 65입니다. E의 ASCII 코드는 무엇입니까?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
문자들은 연속적이므로 E는 A에서 네 번째입니다. 하나의 기준값만 알면其余는 기억할 필요가 없습니다.
놓칠 수 있는 점
- ASCII는 7비트 128개 코드 포인트; 확장 ASCII는 8비트 256개입니다. plain ASCII에 8비트를 적지 마십시오.
- 유니코드는 문자 집합이고, UTF-8은 그에 대한 인코딩입니다. 이들은 서로 경쟁하는 집합이 아닙니다.
- UTF-8은 가변 길이로, 1~4바이트이며, 항상 1바이트이거나 항상 4바이트가 아닙니다.
- 유니코드의 단점은plain 영어에 대한 파일 크기이며, "더 느리다"거나 "읽기 어렵다"가 아닙니다.
이해했습니다
- 문자 집합은 각 문자에 코드 포인트를 부여하며, 텍스트는 숫자 plus 그 읽기에 대한 합의입니다.
- ASCII: 7비트, 128개 코드 포인트, 영어 전용 · 확장 ASCII: 8비트, 256개, 상위 절반은 지역에 따라 다름
- 유니코드: 모든 스크립트와 이모지에 대해 단일 코드 포인트, 인코딩으로 저장됨; UTF-8은 1~4바이트이며 ASCII 호환
- 유니코드(Unicode)는 문자, 호환성 및 다국어 지원을 제공하지만, 순수 영어 텍스트의 경우 파일 크기가 커집니다