| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 선형 탐색 및 이진 탐색 방식에 대한 이해 | 선형 탐색 구현 알고리즘 작성 이진 탐색 구현 알고리즘 작성 이진 탐색 사용에 필요한 조건 이진 탐색 성능이 데이터 항목 수에 따라 어떻게 달라지는지 |
| 삽입 정렬 및 버블 정렬 방법을 이해하기 | 삽입 정렬을 구현하는 알고리즘 작성. 버블 정렬을 구현하는 알고리즘 작성. 정렬 루틴의 성능은 초기 데이터 순서와 데이터 항목 수에 따라 달라질 수 있음 |
| **추상 데이터 타입(ADT)**의 이해 및 활용 | 다음 각 구조물에서 항목을 찾는 알고리즘 작성: 연결 리스트, 이진 트리 다음 각 구조물에 항목을 삽입하는 알고리즘 작성: 스택, 큐, 연결 리스트, 이진 트리 다음 각 구조물에서 항목을 삭제하는 알고리즘 작성: 스택, 큐, 연결 리스트 그래프가 ADT의 예임을 이해. 그래프의 핵심 특징 설명 및 특정 상황에 대한 사용 근거 제시. 그래프 구조에 대한 코드 작성은 요구되지 않음 |
| Show how it is possible for ADTs to be implemented from another ADT | Describe the following ADTs and demonstrate how they can be implemented from appropriate built-in types or other ADTs: stack, queue, linked list, dictionary, binary tree |
| 동일한 작업을 수행하는 서로 다른 알고리즘을 기준(예: 작업 완료 소요 시간, 사용 메모리 등)으로 비교할 수 있음 | Big O 표기법을 사용하여 시간 및 공간 복잡도를 명시하는 데 포함 |
계산적 사고와 문제 해결
A-Level 컴퓨터 과학 · 주제 19
 15:33
검색 및 정렬
백만 명의 이름이 있는 전화번호부. 하나씩 확인하면 백만 번의 비교를 할 수도 있습니다. 하지만 이미 그 비법을 알고 있습니다: 중간에서 엽니다…
영어 내레이션 · 영어와 중국어 자막 전환 가능
19.1
검색 알고리즘
Syllabus
출처: Cambridge International syllabus
검색은 데이터 모음에서 목표값을 찾아 그 위치를 반환하거나 “찾지 못함”을 반환한다. 데이터 모음으로는 배열을 흔히 사용한다.
선형 검색
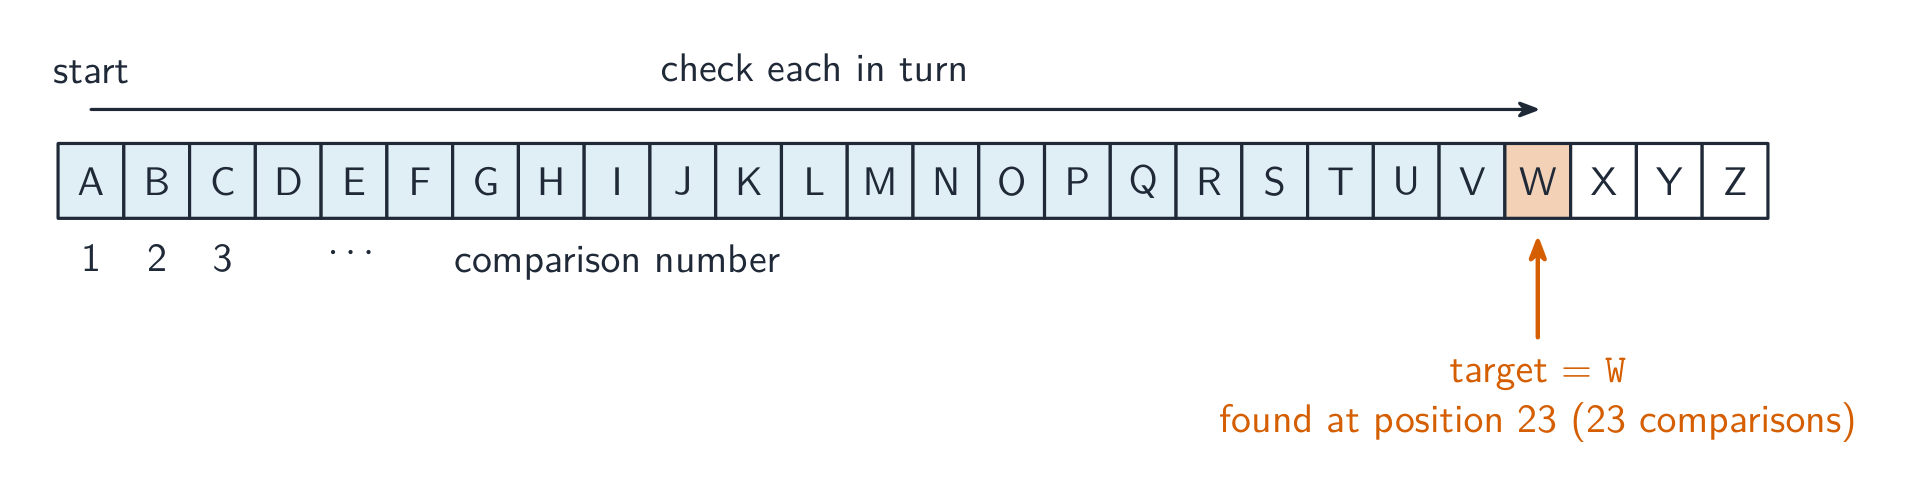
선형 검색은 시작부터 끝까지 이동하며 각 요소를 목표와 비교한다:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
준비가 필요 없으므로 모든 리스트에서 작동한다. 최악의 경우는 목표값이 끝에 있거나 없는 경우로 O($n$)이며, 최선의 경우 비교 횟수는 1이다. 정렬되지 않은 데이터나 작은 리스트에 사용한다. 반환되는 -1은 “찾지 못함”을 뜻하는 실제로 존재할 수 없는 위치인 센티널 값이며, 호출한 쪽에서 IF result = -1을 검사한다.
시험 문제 버전. Paper 3에서는 플래그와 WHILE 루프를 사용하여 작성된 선형 검색을 완성하고, Paper 4에서는 인덱스 또는 개수를 반환하는 함수를 작성할 것을 요구하며, 둘 다 다음과 같다:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
첫 번째 일치 지점에서 멈추려면, Found ← TRUE을 설정하고 인덱스를 기억하는 WHILE Index <= 100 AND NOT Found 루프를 사용한다. 채점 포인트는 모든 요소를 순회하는 루프, 비교, 그리고 값이 없을 때 반환되는 값에 해당한다.
이진 검색
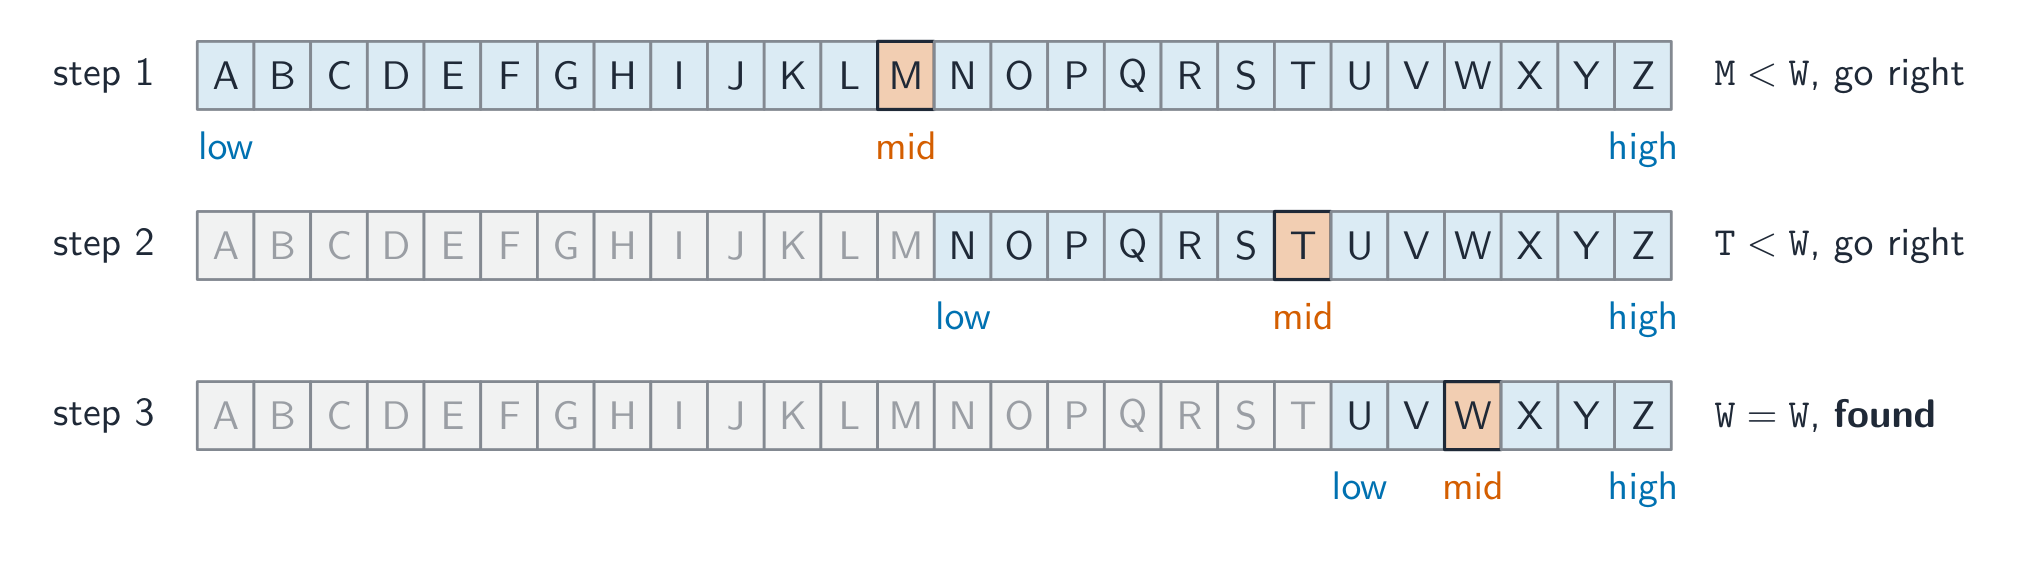
이진 검색은 데이터가 정렬되어 있어야 한다. 중간 요소를 보고, 그것이 목표라면 완료; 목표가 작으면 왼쪽 절반, 크면 오른쪽 절반을 검색 — 매번 범위를 반으로 줄인다:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Worst case O($\log_{2} n$) — for a million items, about 20 comparisons. Much faster than linear search on large sorted arrays, but you must sort first (a one-off O($n \log n$) cost), worth it if you search many times.
“이진 검색에 필요한 조건을 쓰시오.” 데이터가 순서대로 정렬되어 있어야 한다. 검색할 키를 기준으로 오름차순 또는 내림차순으로 정렬한다. “이진 검색을 수행하는 방법을 설명하시오” (3점): (1) 리스트 또는 현재 범위의 가운데 항목을 찾아 목표값과 비교한다. (2) 일치하면 검색을 끝낸다. 목표값이 더 작으면 앞쪽 절반에서, 더 크면 뒤쪽 절반에서 반복한다. (3) 항목을 찾거나 범위가 빌 때까지 범위를 계속 절반으로 줄인다. 범위가 비면 항목이 없다는 뜻이다.
시험 문제 버전인 경계값과 플래그가 포함된 버전은 알고리즘 완성 요청 시 복제해야 하는 것이다:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
예제: 이진 검색 추적. Names[0:9]에는 Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo이 저장되어 있다. 시험에 제시된 방법으로 먼저 Target = "Ivy"을 검색하고 다음으로 Target = "Cat"을 검색하는 과정을 추적하여 각 단계의 Lower, Upper, MiddleIndex을 쓰시오.
“Ivy”를 검색하는 경우:
| Lower | Upper | MiddleIndex | Names[MiddleIndex] | 결과 |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy이므로 Lower ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy이므로 Lower ← 8 |
| 8 | 9 | 8 | Ivy | Found ← TRUE |
세 번 비교한 후 출력은 8이다. “Cat”을 검색할 때: 가운데는 4이다. Eva > Cat이므로 Upper ← 3이다. 다음 가운데는 1이다. Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat이므로 Upper ← 2이다. 이제 Lower(3)이 Upper(2)보다 크므로 반복문이 끝나고 네 번 비교한 후 “Not found”가 출력된다. 이는 항목이 10개일 때의 최악의 경우이다. $\lceil\log_2 10\rceil = 4$. DIV은 내림하므로 0와 9의 중간은 4이며 4.5이나 5이 아니다. 문자열은 알파벳순인 문자 코드 순서로 비교한다.
“항목 수에 따라 성능이 어떻게 달라지는지 설명하시오.” 비교할 때마다 남은 항목 수가 절반으로 줄어들므로 최대 비교 횟수는 약 $\log_{2} n$이다. 리스트 크기가 두 배가 되어도 비교 횟수는 한 번만 늘어난다. 이는 **O($\log n$)**이다. “선형 검색과 이진 검색을 비교하시오”: 선형 검색은 최대 $n$번 비교하며 O($n$), 평균적으로는 그 절반을 비교하지만 정렬되지 않은 데이터에서도 작동한다. 이진 검색은 최대 $\log_{2} n$번 비교하며 O($\log n$), 큰 리스트에서 훨씬 빠르지만 데이터를 먼저 정렬해야 하고 가운데 항목에 직접 접근할 수 있어야 한다. 연결 리스트가 아닌 배열을 사용한다. 항목이 $1000$개일 때 비교 횟수는 각각 $1000$과 $10$이다.
탐색하기
선형 검색 대 이진 검색
값을 검색합니다. 이진 탐색은 각 단계마다 목록의 크기를 절반으로 줄입니다(정렬된 데이터에 한함); 선형 탐색은 하나씩 순차적으로 확인합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | 삽입 정렬 |
| bubble sort/ˈbʌbl sɔːt/ | 버블 정렬 |
| binary search/ˈbaɪnəri sɜːtʃ/ | 이진 탐색 |
| array/əˈreɪ/ | 배열 |
| linear search/ˈlɪnɪə sɜːtʃ/ | 선형 탐색 |
19.1
정렬 알고리즘
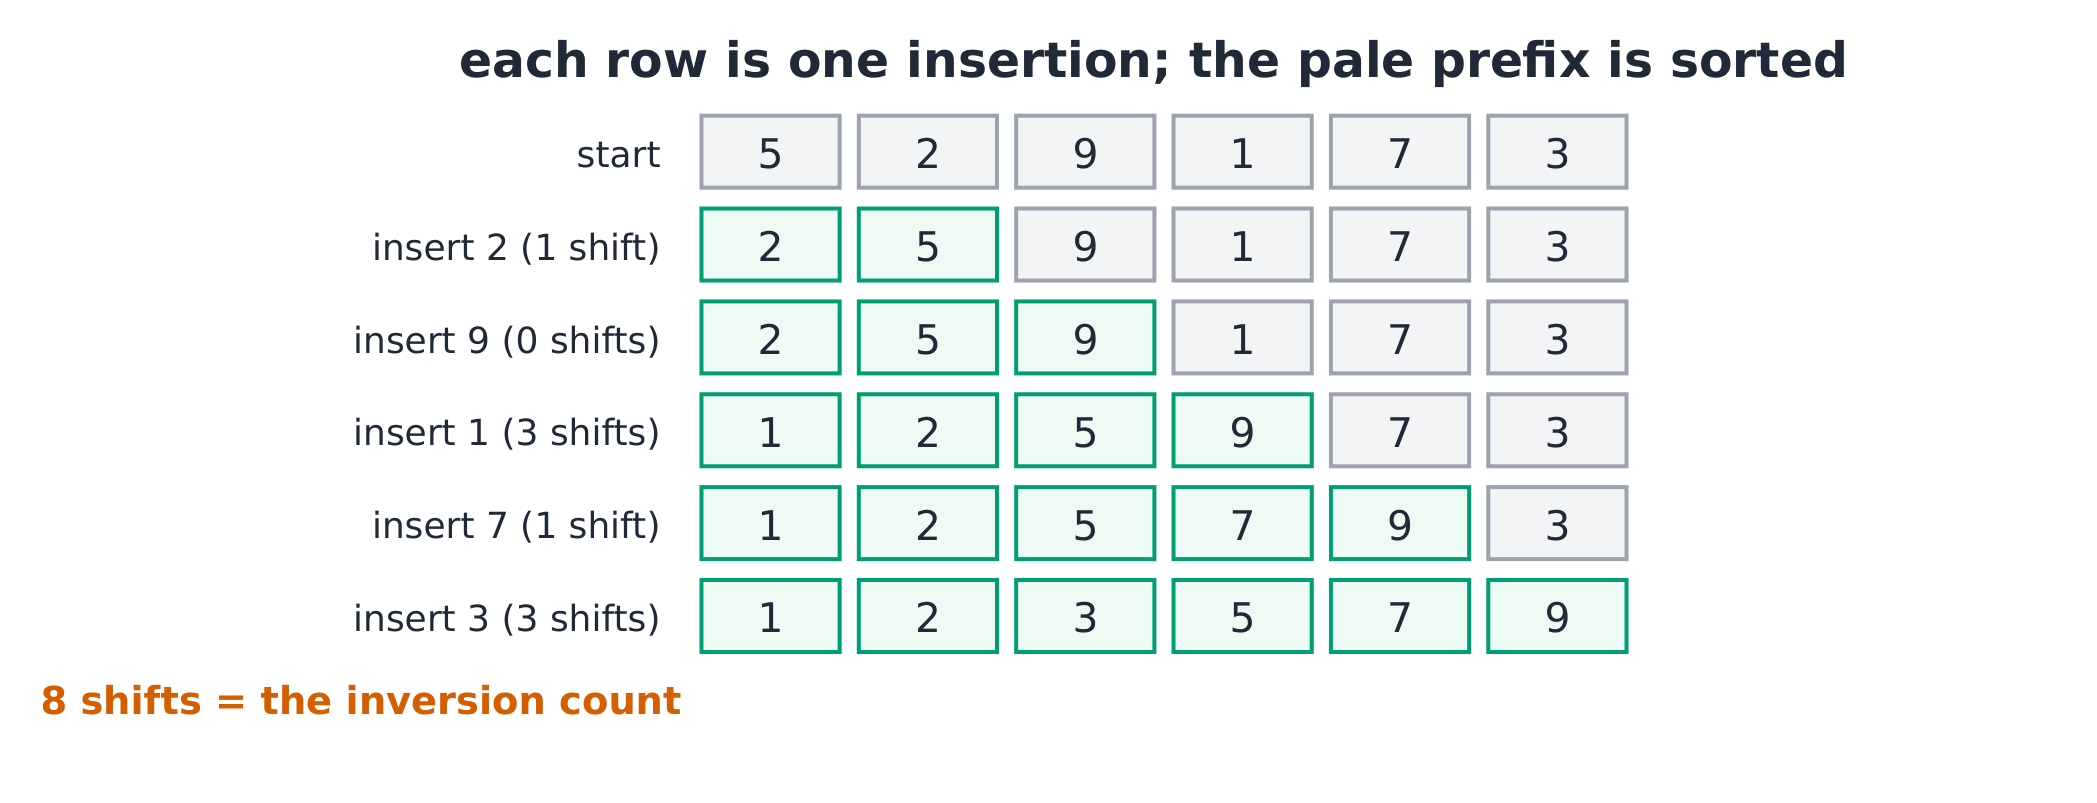
버블 정렬
버블 정렬은 배열을 반복해서 순회하며 순서가 잘못된 인접한 항목 쌍을 교환하므로 매 회차마다 가장 큰 항목이 끝으로 올라간다.
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
최선 경우 O($n$)(이미 정렬되어 있어 초기 탈출이 가능한 경우); 평균/최악 경우 O($n^{2}$). 간단하지만 큰 $n$에는 느립니다.
삽입 정렬
삽입 정렬은 왼쪽에서부터 정렬된 접두사를 구성하며, 각 새 요소를 더 큰 요소들을 오른쪽으로 밀어내며 제자리에 삽입한다:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
최상의 경우 O($n$)(이미 정렬됨); 최악 O($n^{2}$). 작은 또는 거의 정렬된 배열에 적합하다. in place로 정렬하며 안정적(stable)(동일한 요소의 순서를 유지).
정렬 추적
일반적인 과제로는 외부 pass마다 배열의 상태를 보여주는 것이다. [D, T, H, R]에 대해 삽입 정렬 사용: pass 1(key T) 변화 없음; pass 2(key H) → [D, H, T, R]; pass 3(key R) → [D, H, R, T].
유래 (역순 개수). 역순은 순서가 깨진
같은 배열을 버블 정렬하면 다르게 이동한다. 1회차에는 D/T를 비교하여 교환하지 않고, T/H와 T/R을 비교하여 각각 교환한다. 그 결과 가장 큰 항목이 끝에 있는 [D, H, R, T]이 된다. 2회차에는 교환이 없으므로 플래그가 정렬을 중단한다. 각 회차가 끝난 후 전체 배열을 보여 주고, 요구하면 비교 횟수를 세시오. 1회차에는 $3$번, 2회차에는 $2$번이며, 위의 방식은 매 회차마다 한 위치 일찍 멈추므로 총 $5$번이다.
정렬을 처음부터 작성하기. “DataArray[1:1000]을 오름차순으로 정렬하는 의사코드를 작성하시오”에는 조기 종료 플래그가 있는 완전한 버블 정렬이나 삽입 정렬을 선언과 들여쓰기를 갖추어 작성한다. 어느 쪽이든 모든 입력에 대해 작동하면 만점을 받는다.
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
내림차순으로 정렬하려면 >을 <로 바꾼다. 레코드나 2차원 배열을 한 필드로 정렬할 때는 해당 필드를 비교하되 레코드 전체 또는 모든 열을 교환한다. 주어진 버블 정렬과 “같은 작업을 수행하는” 삽입 정렬을 작성하라는 요구에는 배열 이름과 정렬 방향을 그대로 유지하고, 내림차순이면 비교 방향을 반대로 하여 위의 삽입 정렬을 재현한다.
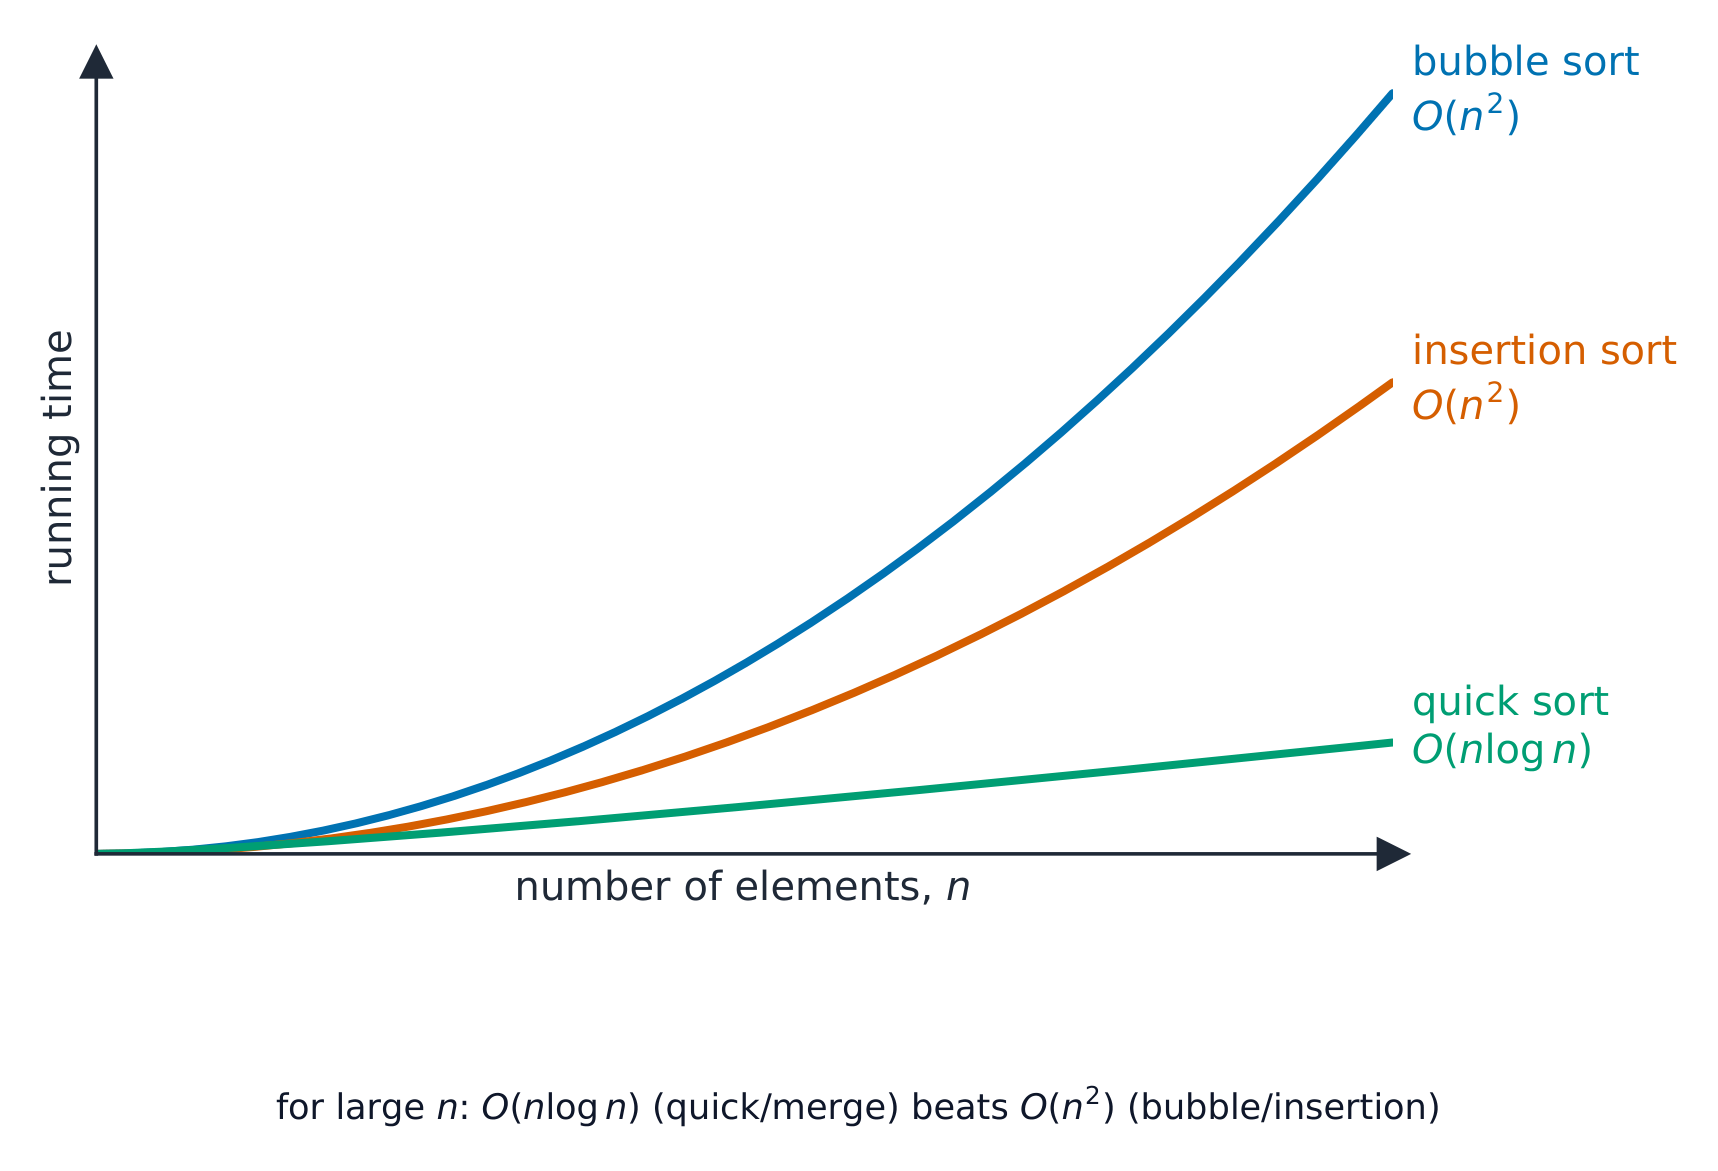
“정렬 성능이 데이터의 영향을 받는 방식 두 가지를 설명하시오” (2점). (1) 항목의 수: $O(n^{2})$ 정렬에서는 항목이 두 배가 되면 시간이 네 배 걸린다. (2) 데이터가 이미 정렬된 정도: 플래그를 사용하는 버블 정렬이나 삽입 정렬은 이미 정렬된 데이터를 한 번 순회하면 끝나고 $O(n)$, 역순으로 정렬된 데이터에서 가장 많은 작업을 수행한다. 교환 횟수는 순서가 잘못된 쌍의 수에 따라 달라진다. 값의 범위나 중복 값의 수, 항목이 이동 비용이 큰 대형 레코드인지 여부도 인정된다. 버블 정렬과 삽입 정렬은 모두 최악과 평균의 경우 O($n^{2}$), 최선의 경우 O($n$)이다. 퀵 정렬과 병합 정렬은 O($n \log n$)이므로 대량의 데이터에 사용한다.
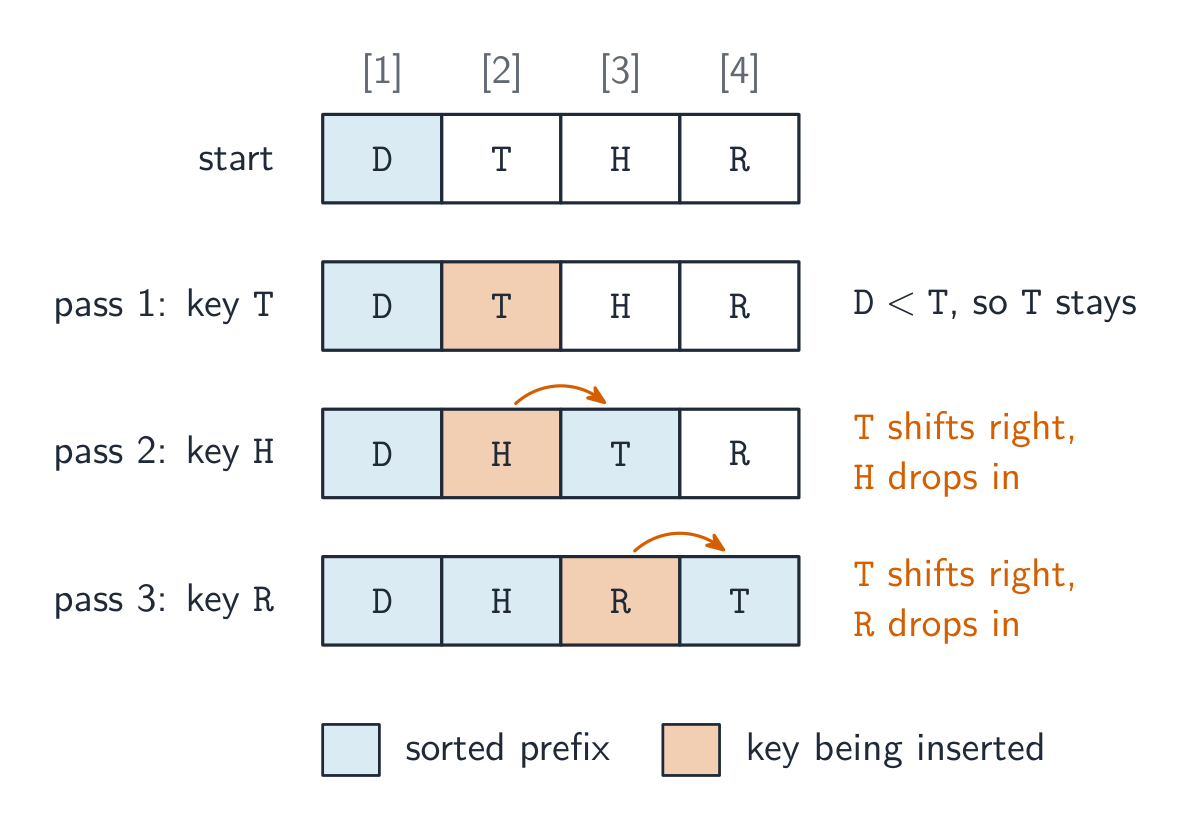
[D, T, H, R]의 삽입 정렬: 각 키를 패스별로 제자리에 밀어 넣음
탐색하기
정렬 과정 보기
정렬 알고리즘이 단계를 거치며 바가 순서대로 배치되는 과정을step-by-step으로 확인하세요 — 정렬 알고리즘이 어떻게 작동하는지 한 단계씩 보여줍니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| in place/ɪn pleɪs/ | 인플레이스 |
| stable/ˈsteɪbl/ | 안정성 |
19.1
알고리즘 내 ADT
주제 10의 추상 데이터 타입(ADTs)이 수많은 알고리즘 내부에 사용됩니다: 스택은 깊이 우선 탐색 및 Undo 기능을 구동하고, 큐는 너비 우선 탐색 및 출력 순서를 구동하며, 연결 리스트는 데이터의 증감에 대응합니다.
ADT는 배열뿐 아니라 다른 ADT로도 만들 수 있다. 스택 두 개로 큐를 만들거나, 연결 리스트로 스택을 만들 수 있다. 이때 삽입은 맨 앞에 머리 노드를 추가하는 것이다. 머리와 꼬리 포인터가 있는 연결 리스트로 큐를 만들고, 자식 포인터 두 개가 있는 노드로 이진 트리를 만들 수도 있다. 딕셔너리는 키→값 쌍을 저장하며 흔히 해시 테이블을 사용한다. 이렇게 계층화하면 관심사가 분리되어 ADT를 사용하는 알고리즘이 내부 구현 방식을 알 필요가 없다.
시험에서 설명 및 구현을 요구하는 ADT
스택 (후입선출): 항목은 동일한 끝, 즉 상단에서 추가(push)되고 제거(pop)됩니다. 포인터 TopOfStack은 상단 항목의 인덱스를 유지합니다. 배열과 해당 포인터 하나로 구현되며, push는 스택이 가득 차지 않았는지 확인한 후 포인터를 증가시키고 항목을 저장하며, pop은 비어 있지 않은지 확인한 후 상단 항목을 반환하고 포인터를 감소시킵니다.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
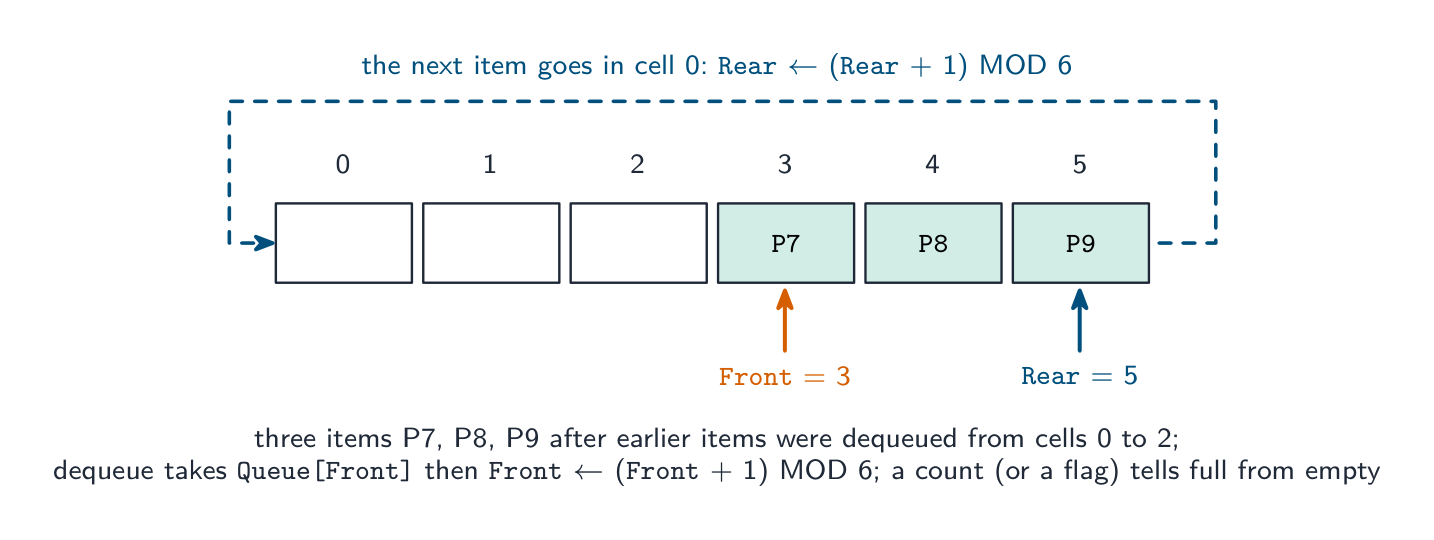
큐 (선입선출): 항목은 후방(enqueue)에서 합류하고 전방(dequeue)에서 이탈합니다. 두 개의 포인터와 카운트가 필요합니다. 선형 큐에서는 전방 포인터가 배열을 따라 이동하여 시작 부분의 공간이 낭비되는 문제가 발생합니다. 순환 큐는 포인터를 MOD으로 감싸서 모든 셀을 재사용하게 합니다.
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
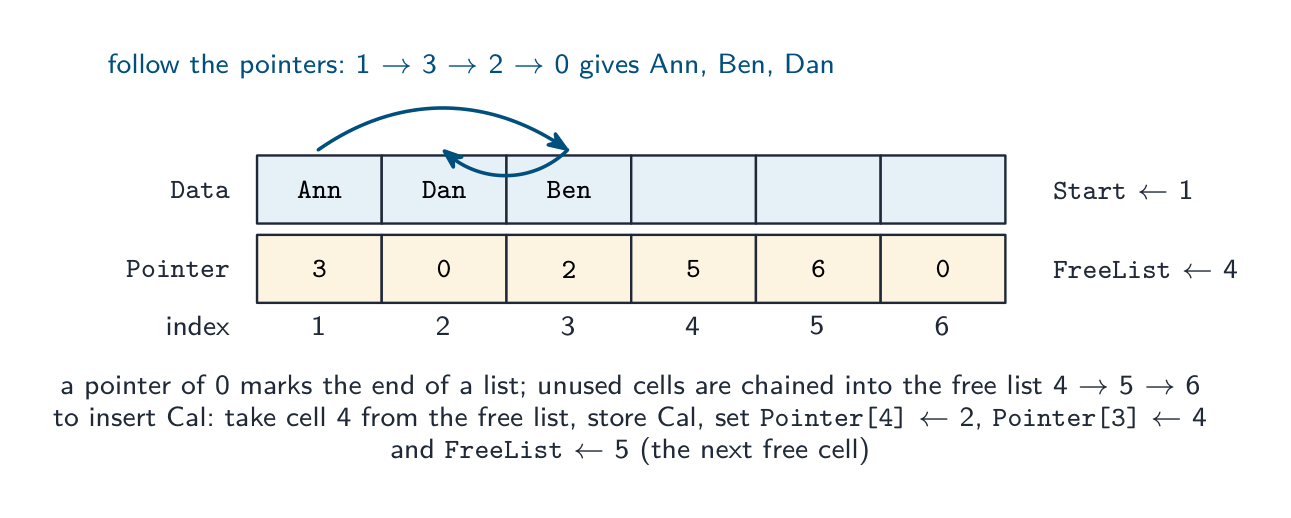
Linked list: a sequence of nodes, each holding a data item and a pointer to the next node; a start pointer gives the first node and a null pointer (0 or $-1$) ends the list. In an array implementation two parallel arrays hold the data and the pointers, and unused cells are chained into a free list so that an insertion knows where to put the new node.
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
정렬된 목록에 삽입하려면: 첫 번째 빈 셀(NewNode ← FreeList, FreeList ← Pointer[FreeList])을 가져와 항목을 저장한 후, Previous과 Current 포인터를 사용하여 목록을 순회하여 Data[Current] > Item 또는 끝까지 이동합니다. 이후 Pointer[NewNode] ← Current와 Start ← NewNode(처음 삽입되는 경우) 또는 Pointer[Previous] ← NewNode을 설정합니다. 삭제 시에는 삭제된 노드를 건너뛰어 이전 노드를 재연결하고, 해당 셀을 빈 목록(Free List)에 반환합니다.
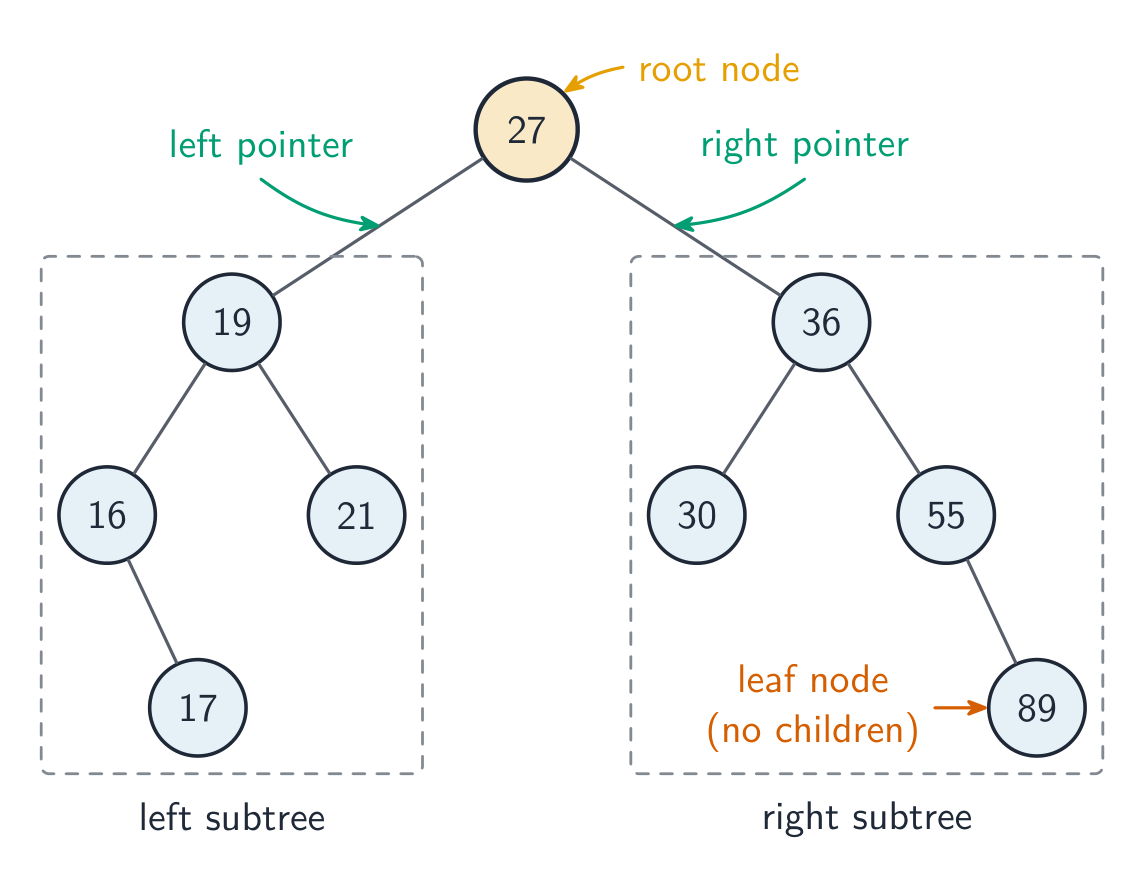
Binary tree: a root node, each node holding data, a left pointer to a subtree of smaller values and a right pointer to a subtree of larger values. Implemented as a 2D array (or three 1D arrays) Tree[Index, 0..2] for left pointer, data, right pointer, with a root pointer and a next-free pointer.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
삽입: 양쪽 포인터를 $-1$로 설정한 다음 빈 노드에 항목을 저장합니다. 트리가 비어 있으면 루트로 만들거나, 그렇지 않으면 비교를 통해 왼쪽 또는 오른쪽으로 내려가며 따르려는 포인터가 $-1$이 될 때까지 이동하여 해당 포인터를 새 노드로 설정합니다. 다른 ADT로부터의 ADT: 스택은 push와 pop이 모두 시작 지점에서 작동하는 연결 리스트; 큐는 시작 포인터와 끝 포인터가 있는 연결 리스트; 큐는 두 스택으로 만들 수 있음(push는 하나에, pop은 다른 쪽에, 두 번째가 비면 모든 것을 옮김); 이진 트리의 노드는 포인터로 연결된 레코드나 객체이므로 노드의 연결 구조로부터 구축됩니다. 새 ADT의 어떤 연산이 기존 ADT의 어떤 연산에 매핑되는지 말하시오.
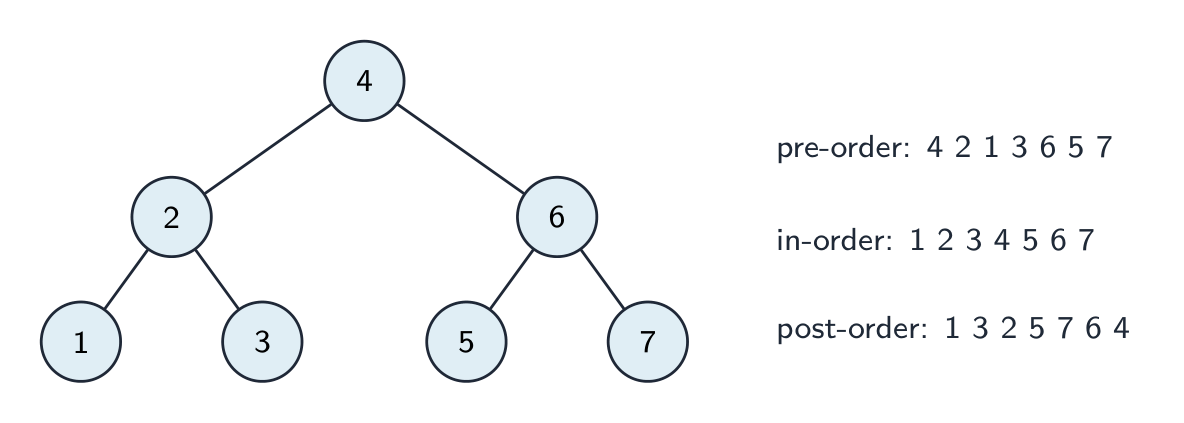
첫 번째 그림은 이진 검색 트리를 보여 준다. 각 노드에는 최대 두 개의 자식 노드가 있고, 노드보다 작은 값은 왼쪽에, 큰 값은 오른쪽에 놓인다. 두 번째 그림은 트리를 순회하는 세 가지 방법을 보여 준다.
어휘
연습하기
| English | 한국어 |
|---|---|
| linked list/lɪŋkt lɪst/ | 연결 목록 |
| stack/stæk/ | 스택 |
| queue/kjuː/ | 큐 |
| node/nəʊd/ | node: 노드 |
| pointers/ˈpɔɪntəz/ | 포인터 |
| binary tree/ˈbaɪnəri triː/ | 이진 트리 |
| dictionary/ˈdɪkʃənəri/ | 사전 |
| circular queue/ˈsɜːkjʊlə kjuː/ | 순환队列 |
| free list/friː lɪst/ | free list: 빈 목록 |
19.1
알고리즘 비교
시간 복잡도
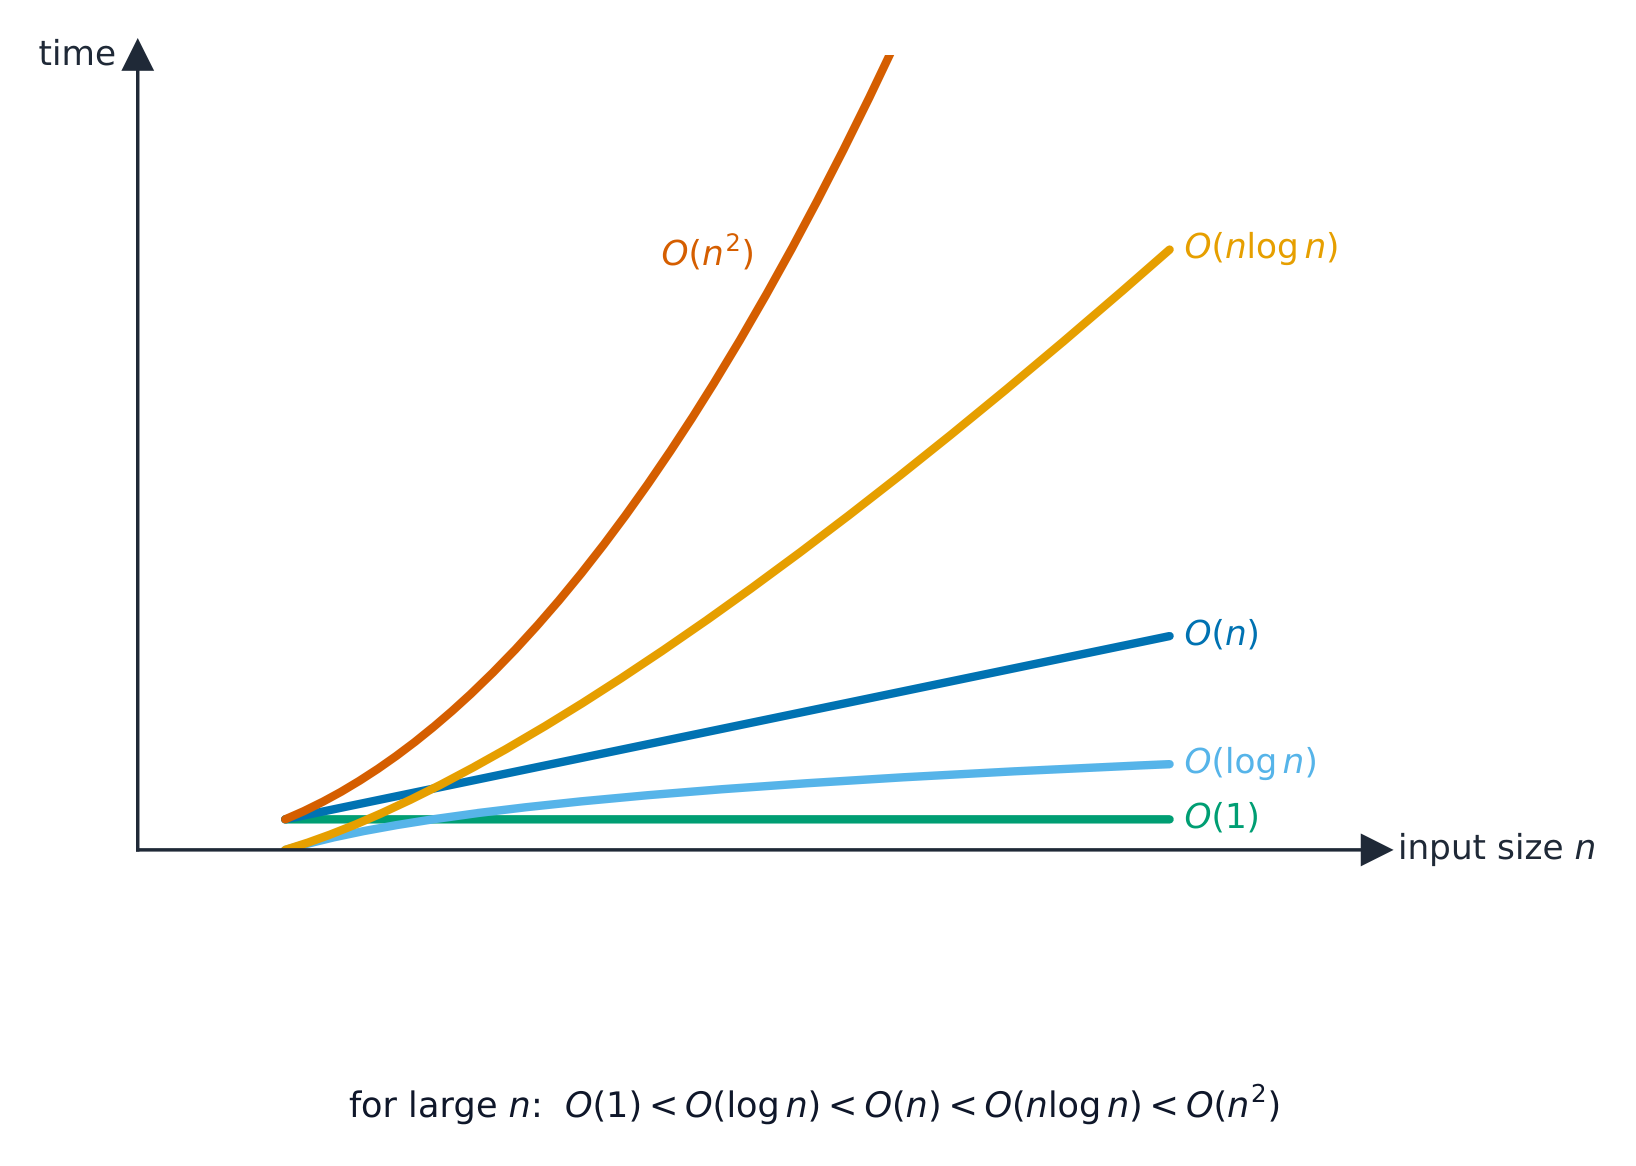
Time complexity is how the running time grows with input size $n$, written in Big-O notationO (the dominant term): O(1) constant, O($\log n$) binary search, O($n$) linear search, O($n \log n$) good sorts, O($n^{2}$) bubble/insertion sort. A smaller order is better at scale, even if another algorithm is faster for small $n$.
구체적으로 설명하자면: 백만 항목을 정렬할 때, 특정 $O(n \log n)$ SORT는 몇 분의 일초 만에 완료되지만, 특정 $O(n^{2})$ SORT는 수 분이 걸릴 수 있습니다.
해설 예제. 정렬된 목록에 $1000$개 항목이 있습니다. 각 탐색이 최악의 경우 몇 번의 비교를 필요로 합니까?
선형 탐색은 항목을 하나씩 확인하므로 최대 $1000$번의 비교가 필요할 수 있습니다—이는 $O(n)$입니다. 이진 탐색은 매 단계마다 목록을 반으로 줄이므로 최대 $\lceil \log_2 1000 \rceil = 10$번의 비교면 충분합니다—이는 $O(\log n)$입니다. 목록을 $2000$개로 두 배로 늘리면 이진 탐색에는 비교가 하나만 추가되지만, 선형 탐색에는 최대 $1000$번 추가됩니다—즉, 규모에서의 승자를 결정하는 것은 순수한 속도보다 성장의 순서입니다.
차수 설명하기. O(1): 항목 수와 관계없이 시간이 일정하다. 스택에 항목을 넣거나 배열 원소를 읽는 경우이다. O($\log n$): 시간이 항목 수의 로그에 따라 증가하므로 데이터가 두 배가 되어도 정해진 단계 수만큼만 추가된다. 이진 검색이 이에 해당한다. O($n$): 시간이 항목 수에 비례하여 증가한다. 선형 검색이나 리스트를 한 번 순회하는 경우이다. O($n \log n$): 선형보다 조금 더 빠르게 증가한다. 효율적인 정렬이 이에 해당한다. O($n^{2}$): 시간이 항목 수의 제곱에 따라 증가하므로 데이터가 두 배가 되면 시간은 네 배가 된다. 버블 정렬과 삽입 정렬이 이에 해당한다. “Names[0:99]의 이진 검색에 대한 빅 오를 쓰시오”에는 $O(\log n)$이라고 답하고, “그 의미를 설명하시오”에는 위와 같이 답한다. 빅 오는 실제 시간이 아니라 시간이나 메모리가 증가하는 방식을 측정한다.
예제: 코드의 차수. 각 코드 조각의 시간 복잡도를 쓰시오. n은 항목 수이다.
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A는 $O(n^{2})$이다. 바깥쪽 반복 $n$회 각각에 대해 안쪽 명령문이 $n$번 실행되므로 총 $n \times n$번이다. B는 $O(\log n)$이다. $n$이 매 회차 절반으로 줄어들므로 반복문은 약 $\log_2 n$번 실행된다. $n = 64$일 때는 6회이다. C는 $O(n)$이다. 연속된 두 반복문은 $n + n = 2n$단계를 거치며 상수는 생략한다. 규칙은 중첩 반복문의 횟수는 곱하고, 연속된 반복문의 횟수는 더하며, 가장 빠르게 증가하는 항만 남기는 것이다. 따라서 $3n^{2} + 5n + 2$은 $O(n^{2})$이다.
공간 복잡도
공간 복잡도는 추가적으로 필요한 메모리 양입니다. 버블 및 인서트 정렬은 O(1)의 추가 메모리를 사용하며(in-place), 병합 정렬은 O($n$)을 사용하며, 재귀는 스택 깊이에 비례하는 스택 메모리를 사용합니다. 종종 시간-메모리 트레이드오프가 존재합니다.
기타 기준
간결함(코딩 및 유지보수가 쉬움), 안정성, 적응성(거의 정렬된 데이터에서 더 빠름). 적절한 알고리즘은 데이터와 제약 조건에 따라 달라집니다.
탐색하기
n에 따른 실행 시간의 성장 양상
n을 위쪽으로 슬라이드하며 곡선을 비교해 보십시오: O(1)과 O(log n)은 거의 평평하게 유지되고, O(n)은 일정하게 상승하며, O(n²)는 급격히 폭발합니다. 이것이 Big-O가 시계로 측정하는 것이 아니라, 대규모 입력에서 알고리즘을 비교하는 기준이 되는 이유입니다.
탐색하기
Big-O 성장률
입력 크기 n을 변경하여 각 알고리즘의 작업량이 얼마나 빠르게 증가하는지 비교해 보세요. 이것이 시간 복잡도의 핵심 개념입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| time complexity/taɪm kəmˈpleksɪti/ | 시간 복잡도 |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | 대O 표기법 |
| space complexity/speɪs kəmˈpleksɪti/ | 공간 복잡도 |
19.2
재귀
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 재귀에 대한 이해 | 재귀의 필수적 특징 프로그래밍 언어에서의 재귀 표현 방식 재귀 알고리즘 작성 및 추적 재귀 사용이 유리한 경우 |
| 컴파일러가 재귀 프로그래밍 코드를 번역하기 위해 수행해야 할 일에 대한 인식 | 스택과 언와인딩의 활용 |
출처: Cambridge International syllabus

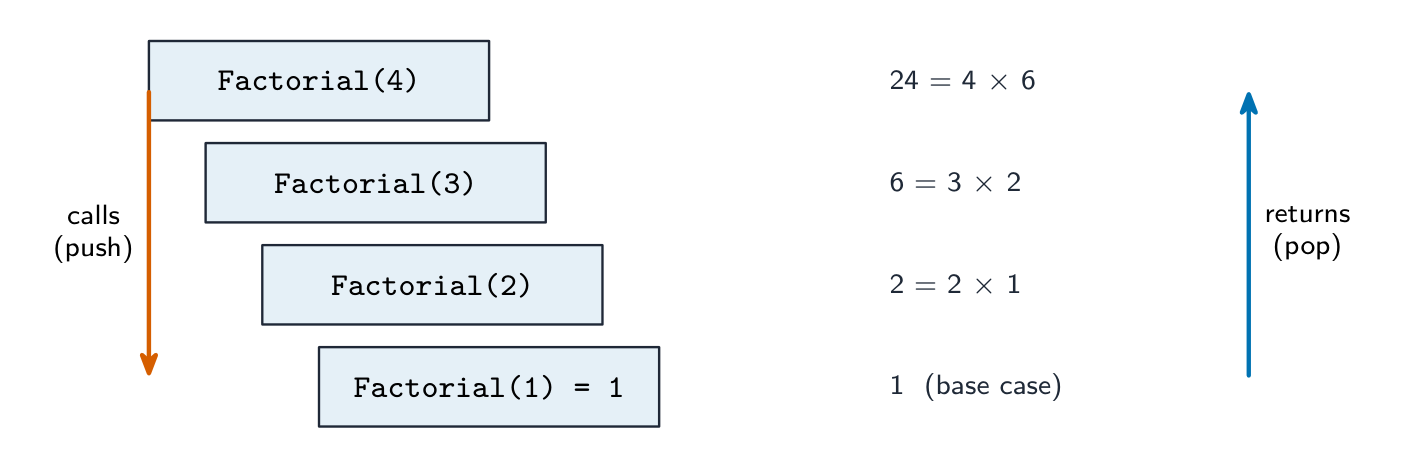
재귀 알고리즘은 재귀를 사용합니다: Routine이 동일한 문제의 더 작은 버전을 전달하여 스스로를 호출하며, 베이스 케이스에 도달하여 체인이 멈출 때까지 계속됩니다. 두 부분으로 구성됩니다: 직접 해결 가능한 작은 크기인 베이스 케이스(없으면 재귀가 절대 멈추지 않음)와 입력을 축소하여 자신을 호출하는 재귀 단계입니다.
계승(Factorial):
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
재귀는 self-similar한 문제에 자연스럽습니다: 트리, 분할 정복(이진 탐색, 병합 정렬), 중첩된 데이터. 적합하지 않을 때는 루프가 일반적으로 깔끔합니다.
“재귀의 의미를 설명하시오” (2점). 자기 자신을 이용하여 정의된 함수나 프로시저가 매번 문제의 더 작은 형태를 가지고 본문 안에서 자기 자신을 호출하며, 기본 사례에 도달할 때까지 이를 반복하는 것이다. “재귀의 필수 특징 세 가지를 쓰시오”: (1) 추가 호출 없이 값을 반환하는 기본 사례, 즉 종료 조건. (2) 루틴이 자기 자신을 호출하는 일반 사례. (3) 재귀가 종료되도록 호출할 때마다 매개변수를 줄여 문제가 기본 사례에 가까워지는 것. 일부 채점 기준에서는 호출이 되돌아가면서 값이 반환된다는 점도 추가한다.
“재귀를 사용하면 유리한 경우를 설명하고 예를 드시오.” 문제가 자기 자신의 더 작은 형태로 자연스럽게 정의되어 재귀 풀이가 반복문보다 더 짧고 명확하며 수학적 정의에 더 가까운 경우이다. 예로 팩토리얼이나 피보나치 수, 이진 검색, 이진 트리 순회, 병합 정렬이나 퀵 정렬, 폴더 안의 폴더 같은 중첩 구조 처리가 있다. 깊이가 크면 스택이 넘칠 수 있고, 같은 부분 문제를 여러 번 계산하는 단순 피보나치 방식에서는 비효율적이므로 적합하지 않다.
재귀 호출 추적
Factorial(4)에 대해: 호출들은 Factorial(1)=1까지 내려간 후 **풀림(unwinding)**이 다시 위로 증폭됩니다: 2*1=2, 3*2=6, 4*6=24. 최종 결과 24. 각 대기 중인 호출을 스택에 추적하십시오.
해설 예제. 아래 함수는 설명 없이 주어졌습니다. Unknown(3, 5)를 추적하고 출력값 및 반환 값을 명시하시오.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Call 1: $X = 3, Y = 5$: $3 < 5$, output 8, call Unknown(4, 4). Call 2: $4 < 4$ is false, return 0. Unwinding: call 1 returns $0 + 1 = 1$. Output 8, return value 1. 추적을 테이블로 작성하되 각 호출당 한 행을 배치하십시오(파라미터, 조건, 출력, 반환 내용), 그리고 가장 깊은 호출부터 위로 향하는 반환을 수행하십시오: 이것이 채점 기준에서 원하는 풀림 과정입니다.
해설 예제(피보나치). Fib(n)이 n < 2일 때 n을 반환하고, 그렇지 않으면 Fib(n - 1) + Fib(n - 2)을 반환합니다. Fib(5)를 구하시오.
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. 따라서 Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. 베이스 케이스가 여러 번 도달됩니다(Fib(2)이 세 번 계산됨), 이것이 이 버전이 느린 이유입니다: $n = 5$을 위해 15번의 호출을 수행하며, $n$가 매번 증가할 때마다 호출 횟수는 대략 두 배가 됩니다.
재귀를 반복문으로 변환하기. 모든 재귀 Routine은 루프를 사용하여 다시 쓸 수 있으며, 이는 메모리 사용량을 줄이고 속도를 높입니다: 누적 결과를 유지하고 기본 사례에서 위로 루프를 돌립니다. Factorial을 루프로 표현한 예:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
재귀 삽입 정렬 또는 탐색을 반복형으로 변경하라는 요청을 받으면, 자기 자신을 호출하는 부분을 재귀가 진행하던 인덱스에 대한 루프로 교체하고, 기본 사례를 루프의 종료 조건으로 전환합니다.
위험 요소
- 무한 재귀: 기본 사례를 누락할 경우 발생하며, 스택 오버플로우로 인해 프로그램이 충돌합니다.
- 깊은 재귀 시 높은 메모리 사용량.
- 작업을 반복할 경우 느립니다(초기 Fibonacci는 지수 함수적 — 루프를 사용하거나 메모이제이션을 적용하세요).
탐색하기
재귀는 잎에서 위로 올라가며 풀림
fib(4) 평가 시 실제 호출이 완료되는 순서대로 단계별 진행: 잎(기본 경우)이 먼저 해결되고, 각 부모가 자식을 결합합니다. fib(2)가 두 번 계산됨을 주의하십시오—이 반복 작업이 naive 재귀가 느린 이유입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| recursion/rɪˈkɜːʃn/ | 재귀 |
| factorial/fækˈtɔːrɪəl/ | 계승 |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | 분할정복 |
| general case/ˈdʒenərəl keɪs/ | 일반 경우 |
| parameters/pəˈræmɪtəz/ | parameters: 매개변수 |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | 스택 오버플로우 |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | 메모이제이션 |
| local variables/ˈləʊkl ˈveərɪəblz/ | 로컬 변수 |
| stack frame/stæk freɪm/ | 스택 프레임 |
| return address/rɪˈtɜːn əˈdres/ | 반환 주소 |
19.2
컴파일러가 재귀 코드에 수행하는 작업
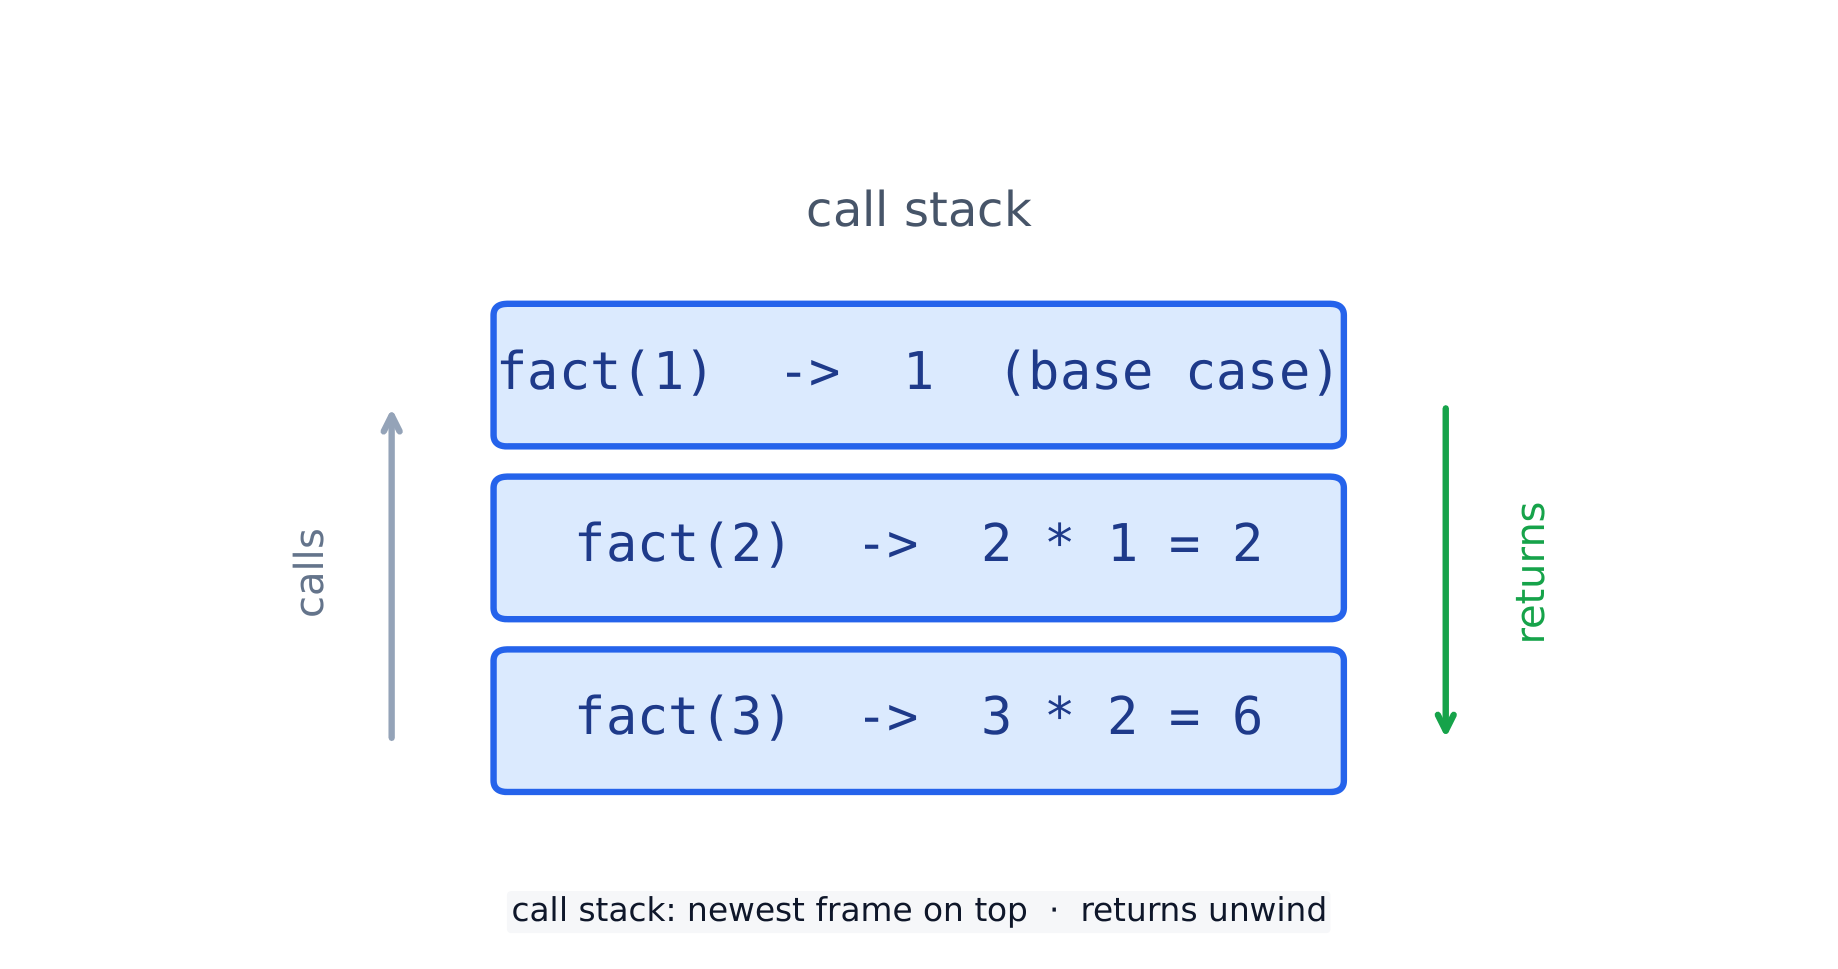
재귀는 매번 다른 복사본이 필요한데, 그중에서도 파라미터와 로컬 변수에 대해 각 호출마다 독립적인 사본을 가져야 합니다. 컴파일러는 이러한 정보들을 호출 스택에 보관합니다. 각 호출마다 파라미터, 로컬 변수, 그리고 복귀 주소(호출자 내에서 재시작할 위치)를 포함하는 스택 프레임을 밀어 넣습니다. 함수가 반환되면 반환값이 전달되고 프레임이 제거되며, 제어 흐름은 복귀 주소에서 다시 시작됩니다.
각 호출에는 고유한 프레임이 있으므로 재귀 호출끼리 서로의 변수를 덮어쓰지 않는다. 재귀가 깊으면 스택이 커질 수 있으며, 지나치게 깊으면 스택이 넘칠 수 있다. 이는 일반적인 비재귀 호출에 사용되는 것과 같은 호출 및 반환 방식이며, 별도의 “재귀 방식”이 있는 것은 아니다.
“재귀를 구현하는 데 스택이 적합한 이유를 설명하시오” (3점). 각 재귀 호출은 복귀 주소, 매개변수, 지역 변수를 저장해야 하며, 호출은 이루어진 순서의 역순으로 완료된다. 마지막으로 호출된 것이 가장 먼저 끝난다. 이는 스택의 후입선출 동작과 정확히 일치한다. 새로 호출할 때마다 프레임을 푸시하고, 반환할 때마다 가장 최근 프레임을 팝하여 호출자의 상태를 복원하고 어디서 계속할지 알려 준다. 재귀 코드를 변환할 때 이를 처리하는 것은 컴파일러의 역할이다. 컴파일러는 매 호출마다 스택 프레임을 푸시하고 매 반환마다 팝하는 코드를 생성하며, 결과가 돌아오면서 프레임이 차례로 해제된다.
어휘
연습하기
| English | 한국어 |
|---|---|
| call stack/kɔːl stæk/ | 호출 스택 |
| base case/beɪs keɪs/ | 기본 경우 |
| recursive case/rɪˈkɜːsɪv keɪs/ | 재귀 경우 |
19.2
출제자가 인정하는 정의
정의 문제는 고정된 문구로 채점합니다. 이 내용들을 정확히 외우고, 답은 하나만 제시하십시오.
| 용어 | 정의 |
|---|---|
| 선형 탐색 | 시작점에서부터 타겟을 찾거나 끝까지 도달할 때까지 항목을 하나씩 확인함 |
| 이진 탐색 | 정렬된 목록의 중간 항목과 타겟을 반복적으로 비교하여 타겟이 포함될 수 없는 절반을 버림 |
| 버블 정렬 | 목록 전체를 반복적으로 통과하여 잘못된 순서에 있는 인접 항목을 swapping하며, 한 통과에서 swaps가 일어나지 않을 때까지 지속함 |
| 삽입 정렬 | 항목을 하나씩 가져와 이미 정렬된 항목들 사이에서 올바른 위치에 삽입함 |
| 추상 데이터 타입(ADT) | 저장 방식과 독립적으로 정의되는 데이터 집합과 그에 수행 가능한 연산들의 묶음 |
| 스택 | 상단에서 push와 pop을 수행하는 후입선출 구조 |
| 큐 | 후방에서 추가하고 전방에서 제거하는 선입선출 구조 |
| linked list | 데이터와 다음 노드를 가리키는 포인터를 각각 보유한 노드의 연속, 시작 포인터 보유 |
| 이진 트리 | 각 노드가 데이터와 더 작은 값의 왼쪽 서브트리, 더 큰 값의 오른쪽 서브트리에 대한 포인터를 가짐 |
| Big O 표기법 | 알고리즘이 요구하는 시간(또는 메모리)을 입력 크기에 따른 성장률에 따라 분류하는 방법 |
| 재귀 | 기본 사례가 호출을 멈출 때까지 문제의 더 작은 버전을 가지고 자신을 호출하는 Routine |
| 기본 사례 | 재귀 Routine이 자신을 호출하지 않고 반환하는 조건 |
| 풀려나옴(unwinding) | 스택 프레임이 제거되면서 가장 깊은 호출부터 첫 번째 호출까지 이어지는 재귀 호출들의 반환 과정 |
19.2
시험 팁
- 탐색: 선형 탐색은 순서가 필요 없고 O($n$); 이진 탐색은 정렬된 배열이 필요하며 매번 절반으로 줄이고 O($\log n$). 두 알고리즘 모두 경계값과 플래그를 포함해 암기해야 함.
- 정렬: 버블 정렬은 swap 플래그를, 삽입 정렬은 larger(items)을 오른쪽으로 이동시키는 key를 사용; 최악의 경우 O($n^{2}$), 정렬된 데이터에서는 O($n$). 성능은 항목 수와 정렬 정도에 의존함.
- ADT 구현은 포인터 관리: 상단 포인터; MOD를 사용하는 front, rear, count; start, 포인터 및 free list; left/right 포인터를 가진 root. 항상 full 및 empty 여부를 확인해야 함.
- 빅 오는 증가 방식에 관한 것으로 상수, 로그, 선형, 제곱이 있다. 이진 검색에 대해서는 “데이터가 두 배가 되면 비교가 한 번 늘어난다”라고 쓰시오.
- 재귀: 기본 사례, 일반 사례, 기본 사례로의 진전; 문제가 자신에 의해 정의될 때 유리함; 호출들이 역순으로 반환되므로 복귀 주소와 변수를 스택이 보유. 표를 사용하여 추적하고 가장 깊은 호출부터 풀려나옴.
흔한 실수
- $O(2n)$ 또는 $O(n^{2} + n)$을 쓸 때 상수와 더 작은 항을 생략하면 각각 $O(n)$와 $O(n^{2})$이 된다.
- 추적할 때 가운데 인덱스를 $(Lower + Upper) / 2$으로 계산하는 것: 시험에 제시된 방식은
DIV을 사용하므로 내림하시오. - 정렬되지 않은 데이터나 연결 리스트에 대해 이진 탐색을 사용하거나,
Lower ← MiddleIndex대신MiddleIndex + 1을 설정하여 무한 루프에 빠지는 경우. - 버블 정렬의 내부 루프가 한 통과마다 배열 끝까지 실행되거나, 임시 변수 없이 swap을 수행하는 경우.
- full 여부를 테스트하지 않는 push 또는 enqueue, 혹은 empty 여부를 테스트하지 않는 pop 또는 dequeue.
- 원형 큐에서 MOD 없이 queue의 front 포인터를 이동하거나, front = rear가 항상 empty를 의미한다고 간주하는 경우.
- 연결리스트에 삽입할 때 배열 내용을 이동시키거나, 포인터만 변경하는 경우(이 문맥에서는 삽입 시 포인터 변경이 적절함을 강조하는 오류 예시일 가능성이 높음). 참고: 원문 'shifting the array contents; only the pointers change'는 연결리스트에서 배열처럼 데이터를 이동시키는 오류를 지적하는 것으로 해석됨. -> 연결리스트에 삽입할 때 배열 내용을 이동시키면 안 되며, 오직 포인터만 변경되어야 함.
- 기본 사례가 없는 재귀 함수, 또는 재귀 호출이 문제를 더 작게 만들지 않는 경우.
- 재귀 호출을 추적하는 데는 성공했으나, 다시 위로 올라가는 과정에서 남은 작업을 추가하는 것을 잊어버림.
- “왜 스택을 사용하는가”에 “빠르기 때문”이라고 답하는 것: 이유는 반환이 후입선출 순서로 이루어지기 때문이다.
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.