מה הקורס הזה הוא, וכיצד להשתמש בו
זהו הקורס החמישי בלימודי עסקים באוניברסיטה: סטטיסטיקה עסקית. הוא עוסק בהפיכת נתונים להחלטות בלי להטעות את עצמכם. מערך נתונים אחד שכל אחד יכול לשחזר מלווה את כל הקורס: זמני אספקה של 40 משלוחי מזון, בדקות, משירות סוף השבוע של נימבוס. אפשר לחשב מחדש כל נתון סטטיסטי בחוברת הזאת מתוך הנתונים המפורטים בסופה.
ההרגל המרכזי של הקורס: ציינו את הטענה, ציינו את אי-הוודאות ואמרו מה יגרום לכם לשנות את דעתכם. ממוצעים מלווים ב שגיאות תקן, מבחנים מלווים בהנחות שלהם, ומתאמים מלווים באזהרות. כל דוגמה פתורה נבדקה מול מאגר הנתונים.
- יחידות 5.1–5.2 עוסקות באיסוף נתונים ובתיאורם: דגימה, הטיה וייצוגים חזותיים מהימנים.
- יחידות 5.3–5.5 עוסקות בהסקה על אקראיות: הסתברות, אמידה ו בדיקת השערות.
- יחידות 5.6–5.7 מקשרות וקובעות: רגרסיה, קורלציה, וה מגבלות שמפרידות בין ניתוח לשכנוע.
כל יחידה מתחילה בשאלה, אחריה השיטה, ואז שתי דוגמאות דוגמאות (השנייה קשה יותר), טעויות נפוצות וסיכום קצר.
נתונים ודגימה
למה זה חשוב. כל מספר בדוח עסקי התקבל באמצעות דרך כלשהי לבחירת נתונים. לפני שמפרשים את המספר, צריך לדעת מה נבחר, כיצד ומי לא נכלל. אחרת הניתוח שבא אחר כך רק מקשט ניחוש.
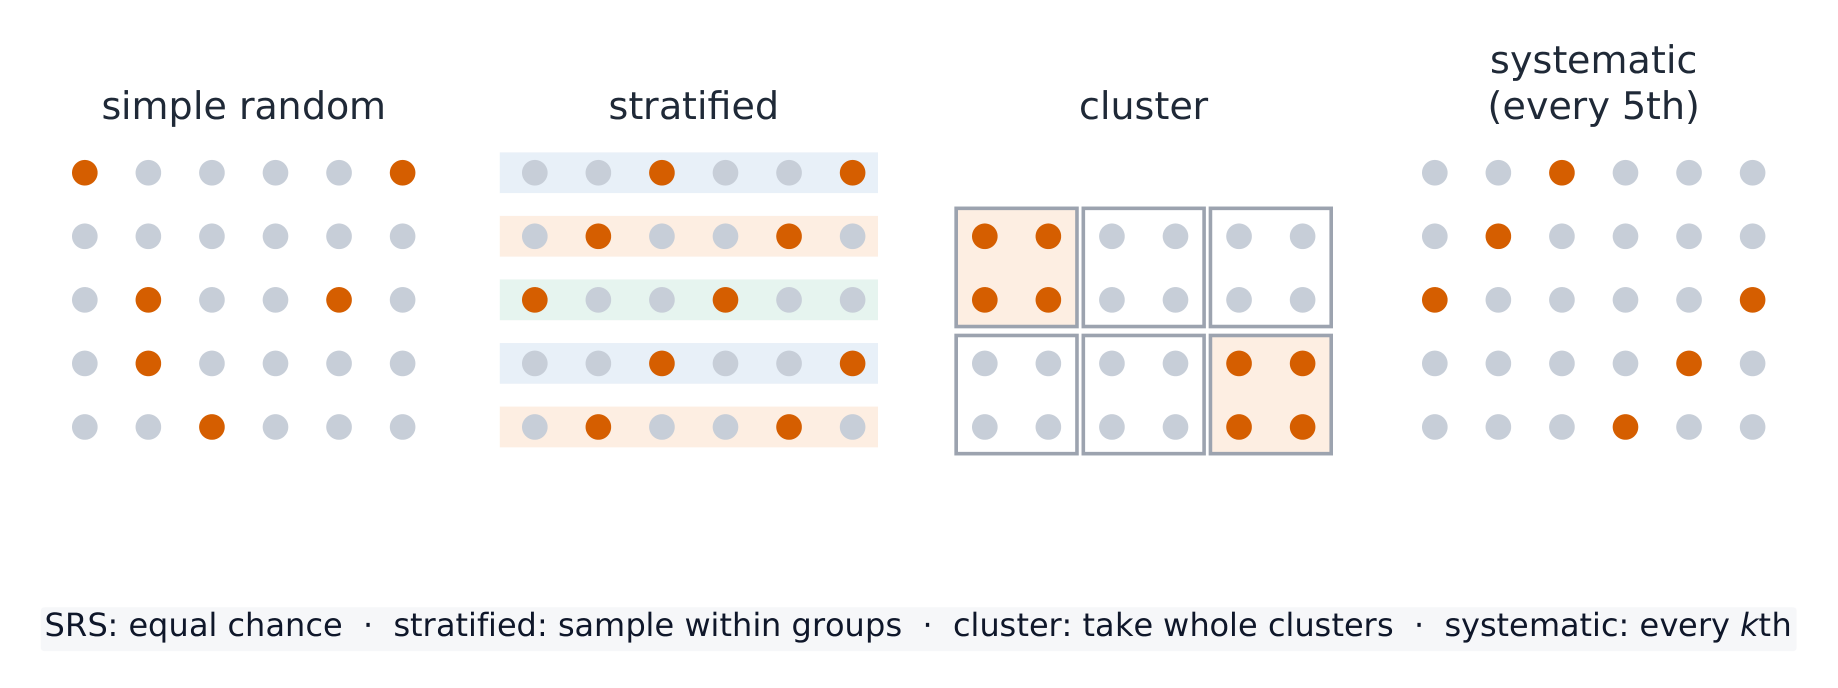
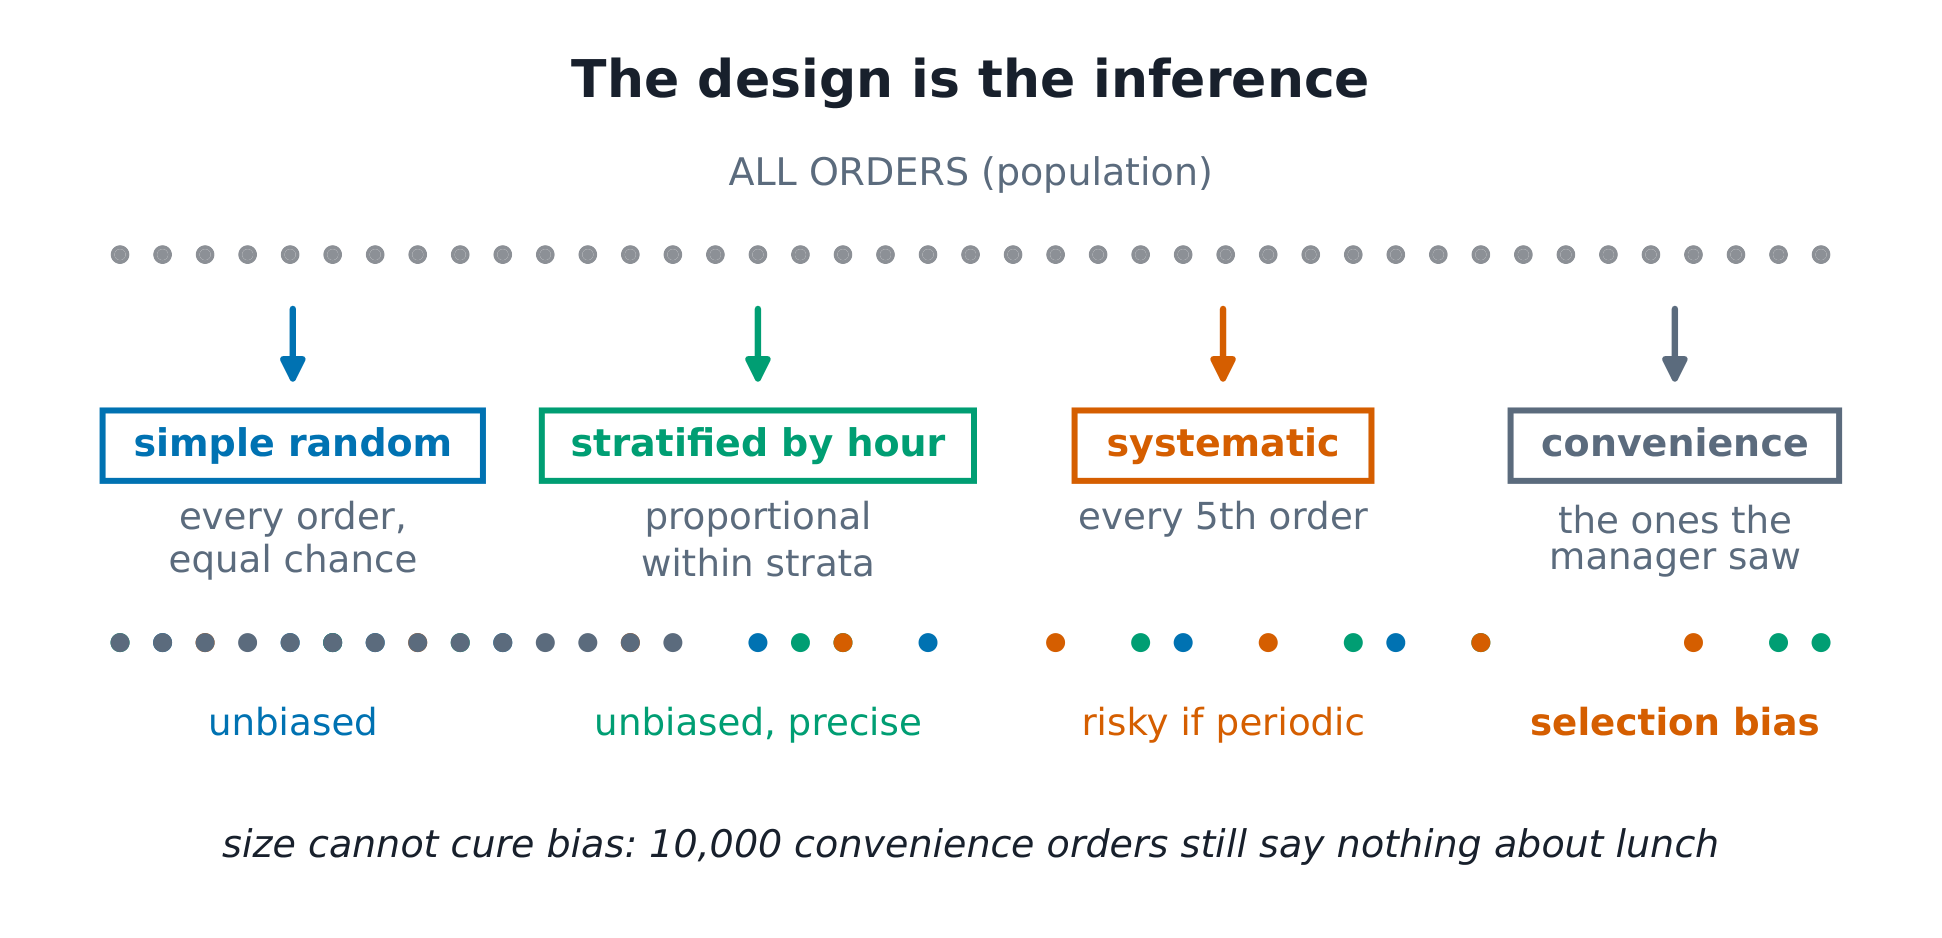
הרעיון. 40 זמני המשלוח הם מדגם מתוך שירות סוף השבוע; כל ההזמנות בתקופה מסוימת יהיו האוכלוסייה. האופן שבו בוחרים את המדגם קובע מה אפשר להסיק ממנו באופן מהימן. מדגם מקרי פשוט מעניק לכל הזמנה סיכוי שווה להיבחר. מדגם נוחות (ההזמנות שהמנהל הזדמן לראות) אינו עושה זאת.
ההגדרות.
- הנתונים הם כמותיים (דקות משלוח) או קטגוריאליים (איזה שליח).
- סולמות המדידה הם שמי, סדר, רווח ומנה. דקות נמדדות בסולם מנה: אפס פירושו היעדר מוחלט.
- הטיה היא שגיאה שיטתית הנגרמת מתכנון המחקר:
- הטיית בחירה: אל מי אפשר להגיע;
- הטיית אי־השבה: מי משיב;
- הטיית שרידות: מי עדיין נותר.
- מילון נתונים מתעד את המשמעות, יחידת המידה והקידוד של כל שדה. זהו הדרכון של מערך הנתונים, וקריאה ביקורתית שלו היא שלב האפס של כל ניתוח.
מדוע גודל אינו יכול לתקן הטיה. אם המדגם מקרי, ממוצע המדגם הוא אומד חסר הטיה של ממוצע האוכלוסייה: בממוצע, על פני מדגמים רבים, הוא קולע לערך האמיתי. אם התכנון מוטה, שום גודל מדגם לא יציל אותו. מדגם נוחות של 10,000 הזמנות ערב עדיין אינו אומר דבר על ארוחת הצהריים. הטיה היא תכונה של התכנון, לא של הגודל.
דוגמה פתורה 1: קריאת המילון. מילון מערך הנתונים:
| שדה | סוג | הערות |
|---|---|---|
delivery_min |
מנה, דקות, ספרה אחת אחרי הנקודה העשרונית | חסר כשהשליח שכח לעצור את הטיימר (3 מקרים) |
hour |
סדר, 11–21 | |
rider_id |
שמי |
לפני חישוב ממוצע כלשהו: 3 הערכים החסרים אינם אפס דקות, והם אינם חסרים באקראי (שליחים שוכחים לעיתים קרובות יותר כשהם עסוקים). ההחלטה: לדווח על הממוצע של 37 המקרים השלמים וגם על הערכים החסרים, ולעולם לא להציג ממוצע בלי לציין זאת.
דוגמה פתורה 2: התאמת התכנון לשאלה. נימבוס רוצה לדעת אם השירות בסוף השבוע איטי יותר.
- תכנון א: לנתח את 40 הזמנים (כולם מיום שבת).
- תכנון ב: לדגום 20 הזמנות מיום שבת ו־20 מיום רביעי, זהו מדגם שכבתי משום שהשאלה משווה בין ימים.
תכנון א עונה על השאלה "איך נראה יום שבת?"; רק תכנון ב עונה על השאלה שנשאלה. בדקו את המלכודת גם בכיוון ההפוך: דגימה של 20 + 20 ואז חיבורם לממוצע אחד מעניקים לשני הימים משקל שווה, בין שפעילות העסק מתחלקת כך בפועל ובין שלא. התכנון חייב להתאים לטענה, בשני הכיוונים.
טעויות נפוצות.
- התייחסות למדגם נוחות כאל מדגם מקרי משום שהוא גדול.
- התעלמות מאי־השבה. גם הלקוחות שלא השיבו לסקר מלמדים אתכם משהו.
- קריאת מערך נתונים ללא המילון שלו. יחידות וקודים הם מקומות שבהם ניתוחים משתבשים.
סיכום. התכנון קובע מה אפשר להסיק. הטיה היא שיטתית, ומדגם גדול יותר אינו יכול לתקן אותה. המילון הוא חלק מהנתונים.
מדדי תיאור והצגה ויזואלית
למה זה חשוב. "ממוצע המשלוחים: 27.4 דקות" הוא משפט אחד שמסתיר התפלגות שלמה. תיאור אינו שלב פורמלי לפני הסטטיסטיקה "האמיתית": בו נמצאות רוב התובנות העסקיות, ובו רוב התרשימים העסקיים מטעים.
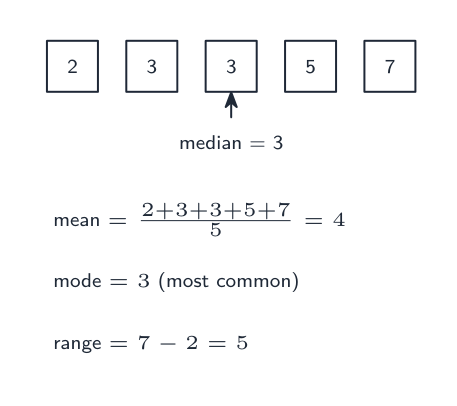
הרעיון. כל מערך נתונים עונה על ארבע שאלות: מרכז, פיזור, צורה וערכים חריגים. עבור 40 הזמנים:
| מדד | ערך |
|---|---|
| ממוצע | 27.43 |
| חציון | 27.6 |
| סטיית תקן | 4.91 |
| רבעונים (לפי כלל $(n+1)p$) | 24.5 / 27.6 / 30.9 |
| טווח בין־רבעוני | 6.3 |
ההיסטוגרמה מציגה שיא אחד, התפלגות סימטרית בקירוב, הנמשכת מעט ימינה. הזמן הגדול ביותר, 38.5, גבוה אך נמצא בתוך גבול החריגים: Q3 + 1.5 × IQR = 40.3.
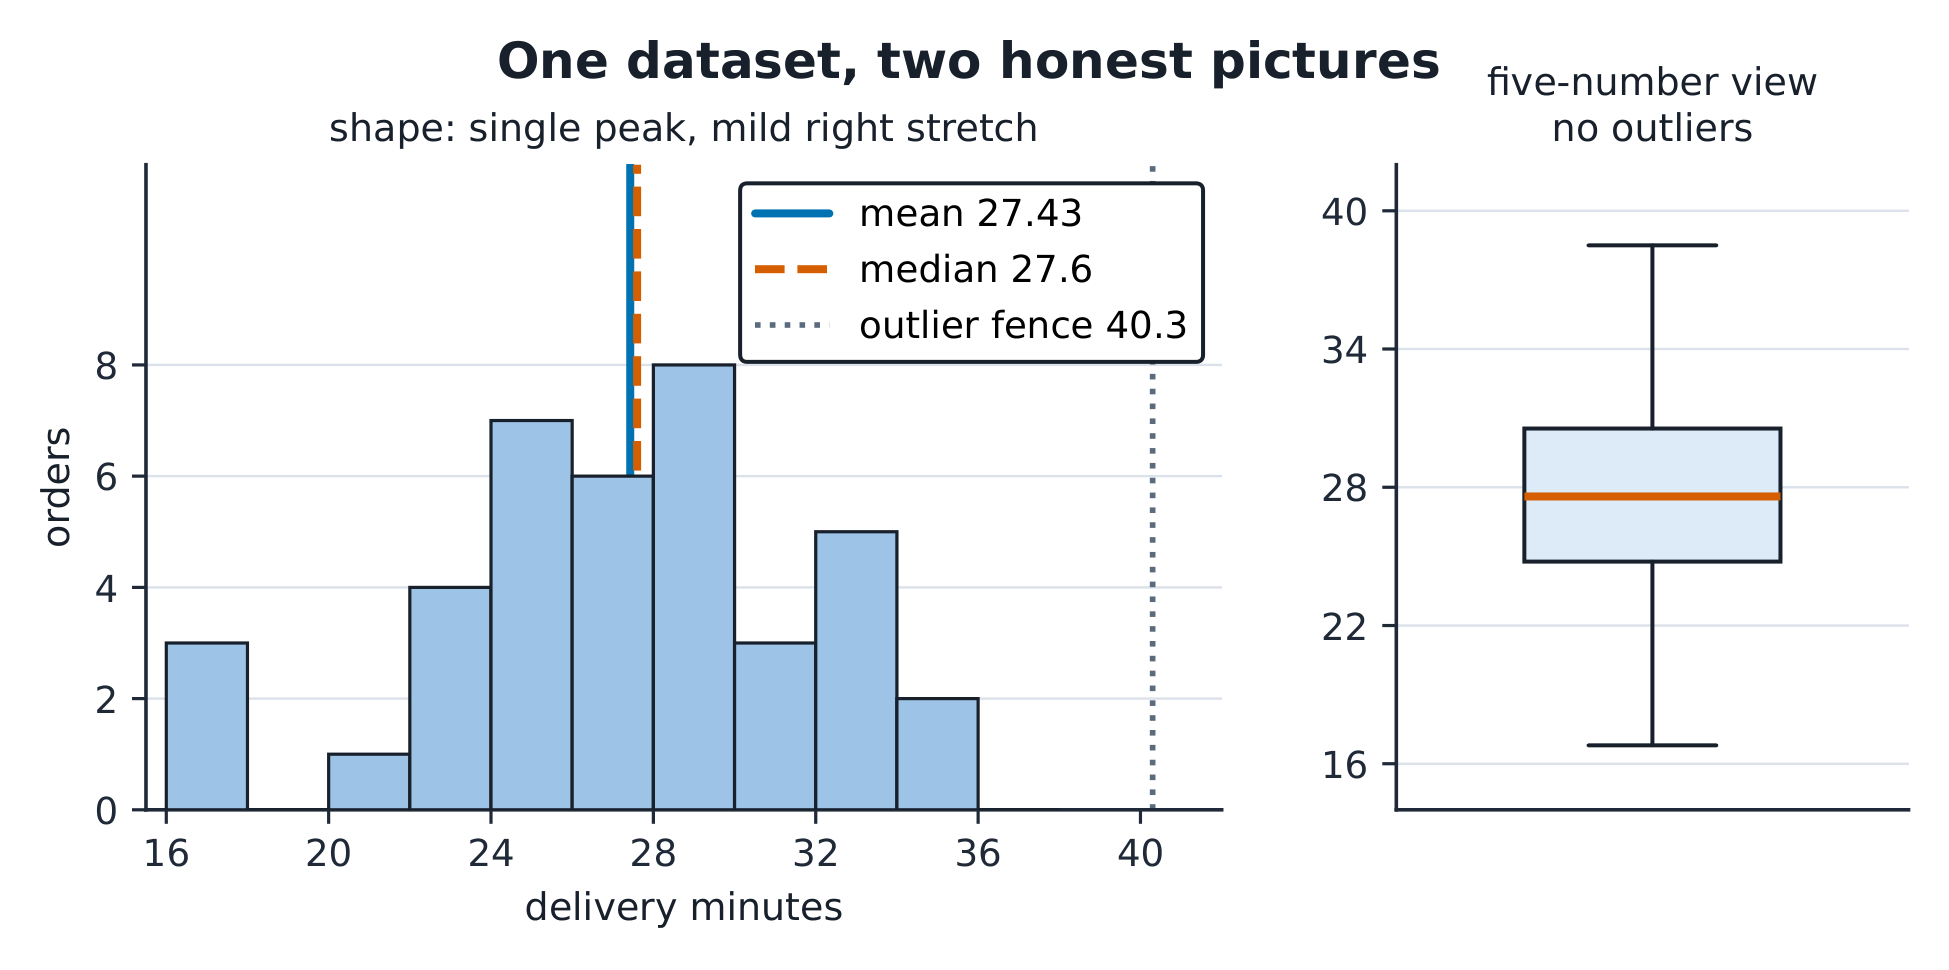 *סט נתונים אחד, שתי תמונות כנות: צורה מההיסטוגרם, חמישה מספרים מהגרף הקופסא
ההגדרות.
- ממוצע = סכום ÷ $n$; חציון = הערך האמצעי לאחר סידור הנתונים.
- סטיית תקן: $s = \sqrt{\sum(x_i-\bar x)^2/(n-1)}$.
- IQR = Q3 − Q1. ערכים חריגים הם ערכים הנמוכים מ־Q1 − 1.5 × IQR או גבוהים מ־ Q3 + 1.5 × IQR.
- צורה: סימטרית, מוטה או בעלת כמה שיאים.
הממוצע נמשך לכיוון זנב ארוך; החציון עמיד בפניו. בנתונים מוטים כגון הכנסות או עיכובים, דווחו על החציון והסבירו מדוע.
החישובים. עבור הנתונים, $\bar x = 1{,}097.2/40 = 27.43$. החלק העליון של נוסחת סטיית התקן הוא $\sum(x_i-\bar x)^2 = 940.3$, ולכן $s = \sqrt{940.3/39} = 4.91$. מדוע מחלקים ב־$n - 1$? הסטיות במדגם קשורות זו לזו ($\sum(x_i - \bar x) = 0$), ולכן חלוקה ב־$n$ ממעיטה באומדן הפיזור. "דרגת חופש" אחת מנוצלת לצורך אמידת הממוצע תחילה.
דוגמה פתורה 1: תמונה מהימנה. שקופית שיווקית מציגה את תרשים המשלוחים כשציר ה־y מתחיל ב־24 דקות. ההזמנות של 17–23 דקות נעלמות, וההבדלים נראים גדולים פי שלושה. שרטטו אותו מחדש מאפס (או עם שבירה מסומנת בבירור בציר), והממוצע של 27.4 יוצג בתמונה מהימנה. קיטוע הציר הוא התרגיל הישן ביותר: המספרים לא השתנו, אבל התמונה השתנתה.
דוגמה פתורה 2: ערך חריג אחד. הוסיפו שגיאת הזנת נתונים אחת: משלוח שנמשך 168 דקות (הטיימר לא נעצר). עם 41 ערכים:
| מדד | לפני | אחרי | שינוי |
|---|---|---|---|
| ממוצע | 27.43 | 30.86 | +3.43 |
| חציון | 27.6 | 27.7 | +0.1 |
| סטיית תקן | 4.91 | 22.5 | גדולה בערך פי 4.5 |
הקשה שגויה אחת שינתה את הממוצע ביותר מ־3 דקות והכפילה את סטיית התקן פי ארבעה וחצי, אך כמעט לא השפיעה על החציון. בדקו מול הגבול: הרבעונים כמעט אינם זזים, Q3 + 1.5 × IQR הוא עדיין בערך 40, ו־168 נמצא הרחק מחוץ לו. הגבול מזהה את השגיאה, והמילון מסביר אותה. טיפול בערכים חריגים: חקרו, תעדו את ממצאיכם ואז החליטו. לעולם אל תמחקו אותם בלי לציין זאת.
טעויות נפוצות.
- הצגת ממוצע לנתונים מוטים בלי לציין שהם מוטים.
- מחיקת ערכים חריגים לפני שבודקים אותם.
- בחירת סוגי תרשימים משום שהם נראים יפה. תרשים עמודות של משתנה רציף אחד מסתיר את כל מה שהיסטוגרמה מציגה.
סיכום. דווחו על כל הארבעה: מרכז (ממוצע וחציון), פיזור (סטיית תקן, טווח בין־רבעוני), צורה וערכים חריגים. תמונה יכולה להטעות גם כשה מספרים נכונים.
סיכוי והתפלגויות
מדוע זה חשוב. "מהו הסיכון שהמשלוח הזה יהיה מאוחר?" היא שאלת הסתברות. שני מודלים מקובלים, הבינומי והנורמלי, עונים על רוב הגרסאות העסקיות שלה. המיומנות היא להתאים את השאלה למודל ולהסביר מדוע.
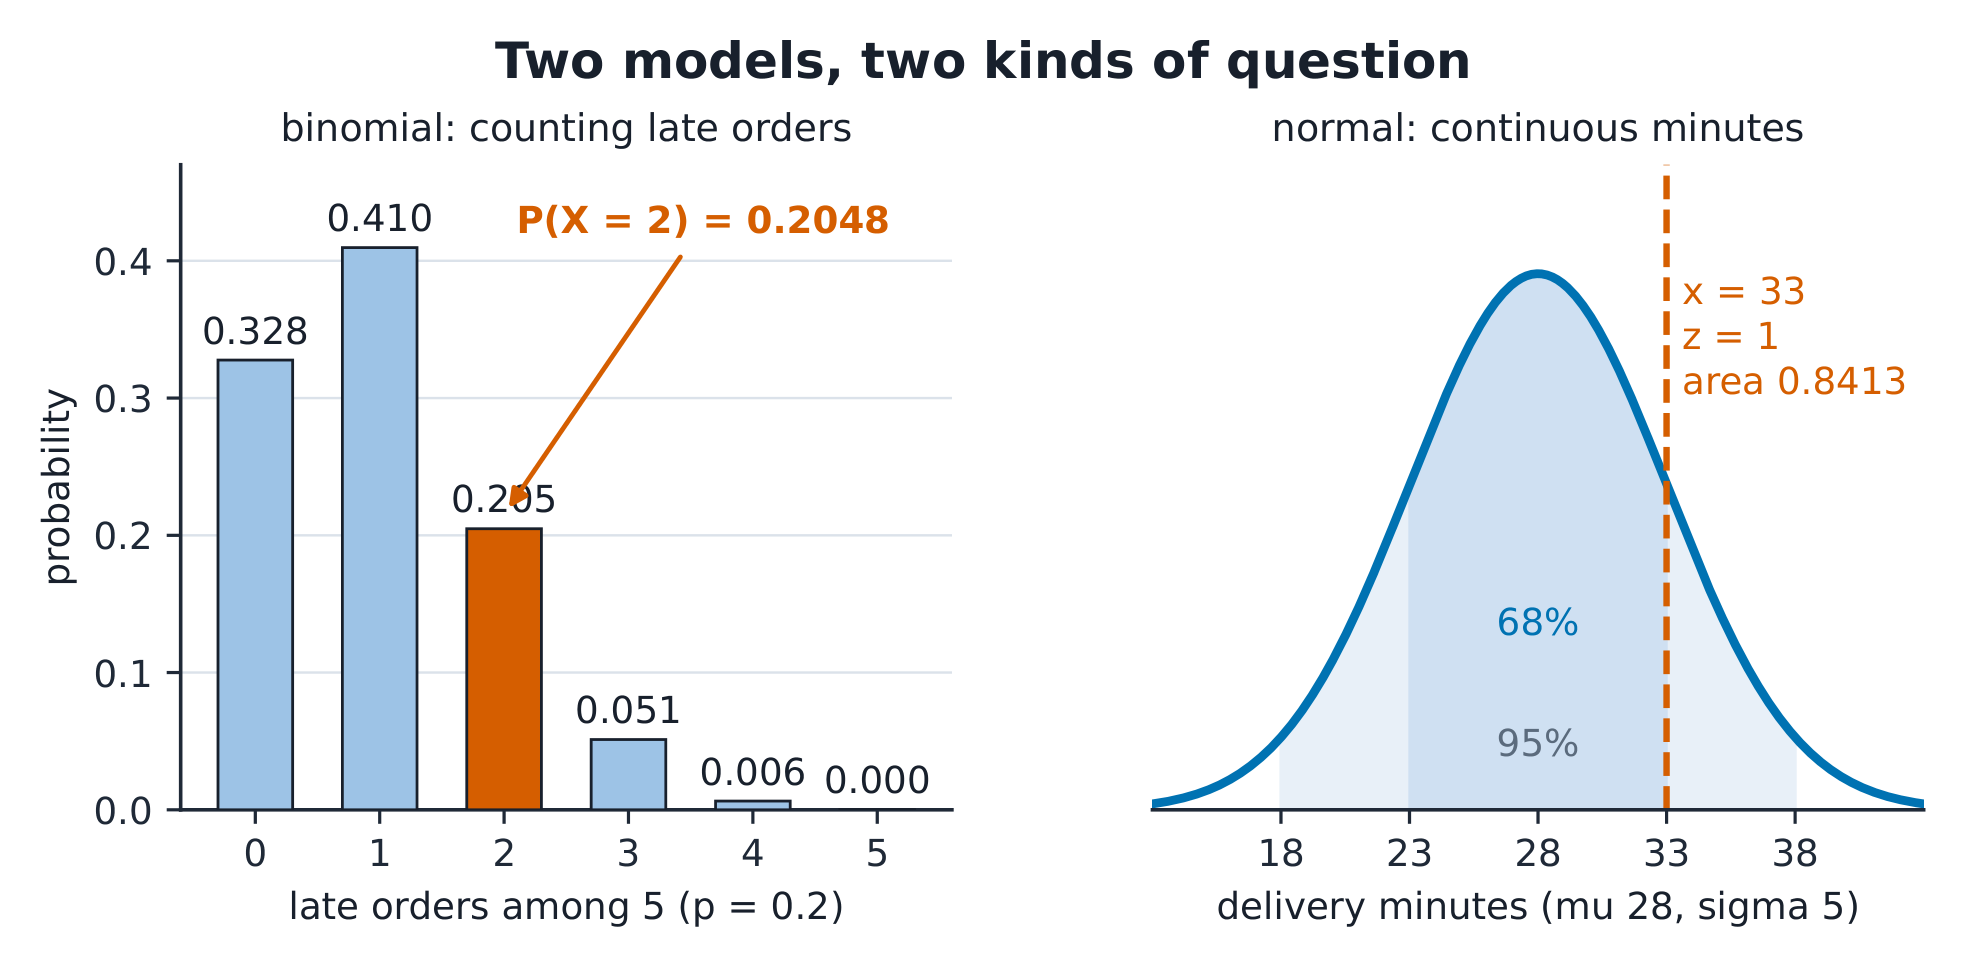
הרעיון. אם 20% מההזמנות מאחרות, מספר ההזמנות המאחרות מבין 5 הבאות מתפלג לפי התפלגות בינומית:
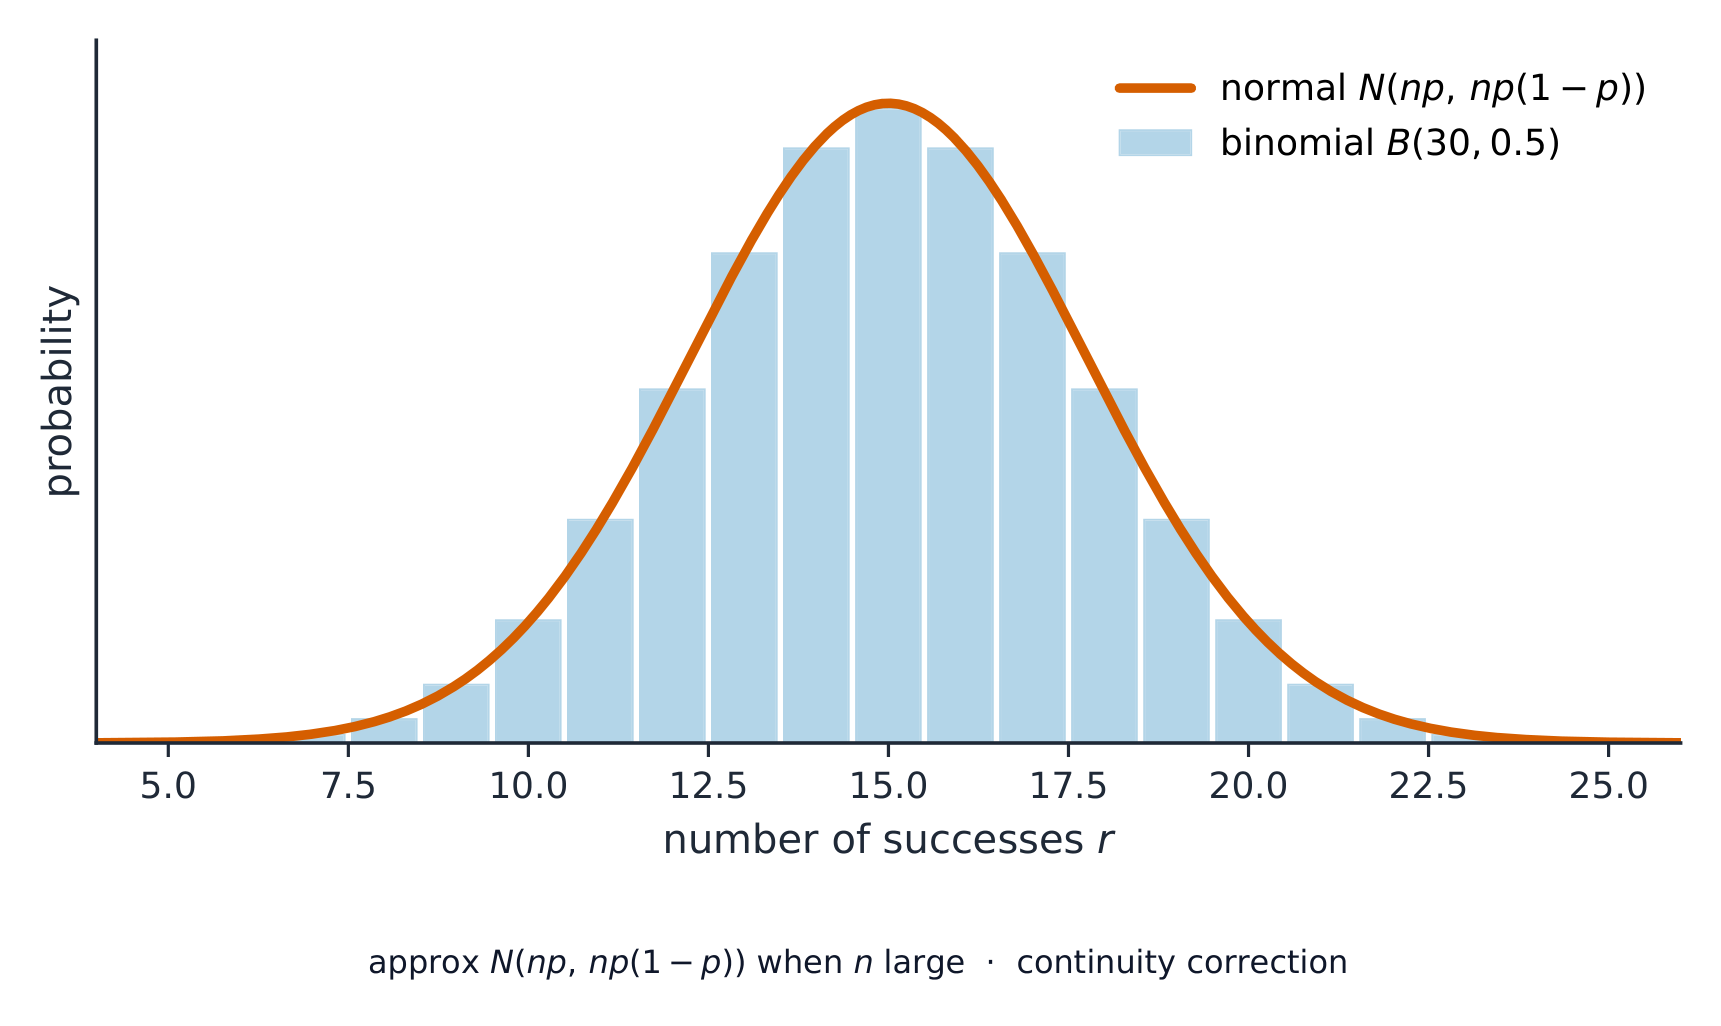
זמני המשלוח עצמם מתקבצים סביב מרכז, עם זנבות סימטריים. אפשר לתאר אותם באמצעות העקומה הנורמלית, שבה 68%, 95% ו־ 99.7% מהערכים נמצאים במרחק של עד 1, 2 ו־3 סטיות תקן מהממוצע.
ההגדרות.
- כלל החיבור: $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.
- אי־תלות: $P(A|B) = P(A)$.
- בינומית: $n$ ניסויים בלתי תלויים, שלכל אחד מהם הסתברות הצלחה $p$.
- נורמלית: סימטרית ובצורת פעמון, ומתוארת במלואה על ידי הממוצע $\mu$ וסטיית התקן $\sigma$ שלה.
- תקנון: $z = (x - \mu)/\sigma$ הופך כל התפלגות נורמלית לעקומה הנורמלית התקנית.
החישובים.
- בינומית: יש $\binom{5}{2} = 10$ סדרים שבהם 2 מתוך 5 יכולים לאחר, כל אחד בהסתברות $0.2^2 \times 0.8^3 = 0.02048$, ולכן $P(X = 2) = 0.2048$. כמו כן $P(X \le 1) = 0.8^5 + 5(0.2)(0.8^4) = 0.7373$.
- נורמלית: כאשר $\mu = 28$ ו־$\sigma = 5$, הזמנה שנמשכת 33 דקות נמצאת $z = 1$ מעל הממוצע, ו־$\Phi(1) = 0.8413$ מההזמנות מהירות יותר. זהו המספר הנפוץ ביותר בטבלה.
דוגמה פתורה 1: הבטחת השירות. נימבוס מבטיחה "30 דקות או הקינוח שלך חינם". תחת המודל $\mu = 28$, $\sigma = 5$:
לכן שליש מההזמנות יזכו בקינוח חינם. עם מטבח מהיר יותר, $\mu = 26$: $P(X > 30) = P(z > 0.8) = 0.2119$, עדיין אחת מכל חמש. ה עלות ההבטחה היא הסתברות. רק מטבח מהיר יותר (ערך קטן יותר של $\mu$) משנה את הזנב; הבטחה לזמן ארוך יותר רק מזיזה את הקו.
דוגמה פתורה 2: התאמת המודל לשאלה.
| שאלה | מודל | תשובה |
|---|---|---|
| (א) ההסתברות שלפחות 4 מתוך 20 ההזמנות הבאות יאחרו ($p = 0.2$) | בינומי | $1 - P(X \le 3) = 1 - 0.4114 = 0.5886$ |
| (ב) ההסתברות שהזמנה אחת תימשך יותר מ־35 דקות ($\mu = 28$, $\sigma = 5$) | נורמלי | $z = 1.4$, זנב $0.0808$ |
| (ג) הטבח בדק באקראי 2 מתוך 3 הקינוחים של היום: מה ההסתברות ששניהם היו 2 הקינוחים האיטיים | ספירה באמצעות צירופים | $1/\binom{3}{2} = 1/3$ |
מודל שגוי נשאר שגוי גם כשמחשבים אותו בביטחון. הסיבה לבחירת המודל היא חלק מהתשובה.
טעויות נפוצות.
- חיבור ההסתברויות של מאורעות שיכולים להתרחש יחד בלי לחסר את החפיפה.
- שימוש במודל הנורמלי עבור ספירות (השתמשו בבינומי) או עבור נתוני עיכוב מוטים בלי לציין זאת.
- קריאת זנב ההתפלגות בטבלה כאילו היה החלק המרכזי. תמיד שרטטו את העקומה ו צבעו את השטח לפני שאתם מחפשים את המספר.
סיכום. ספירות → בינומית; נתונים רציפים סימטריים → נורמלית; $z = (x-\mu)/\sigma$ מתרגם ביניהם. ציינו את המודל לפני שאתם מחשבים.
חלוקות דגימה והערכה
למה זה חשוב. 40 הזמנים הם מדגם אחד. נימבוס יכולה להשתמש בשבת אחרת ולקבל ממוצע שונה. הערכה היא לאמץ את ההרגל לומר מה המספר היחיד שבידיה מלמד על האמת שאינה גלויה לעין, באמצעות טווח מהימן סביבו.
הרעיון. קחו מדגם מקרי של 16 הזמנות וחשבו את הממוצע שלו; ואז עשו זאת שוב ושוב. הממוצעים עצמם יוצרים התפלגות: היא צרה יותר מהתפלגות הנתונים ומרוכזת סביב הממוצע האמיתי. זהו משפט הגבול המרכזי, והרוחב של התפלגות זו מצטמצם עם $\sqrt{n}$.
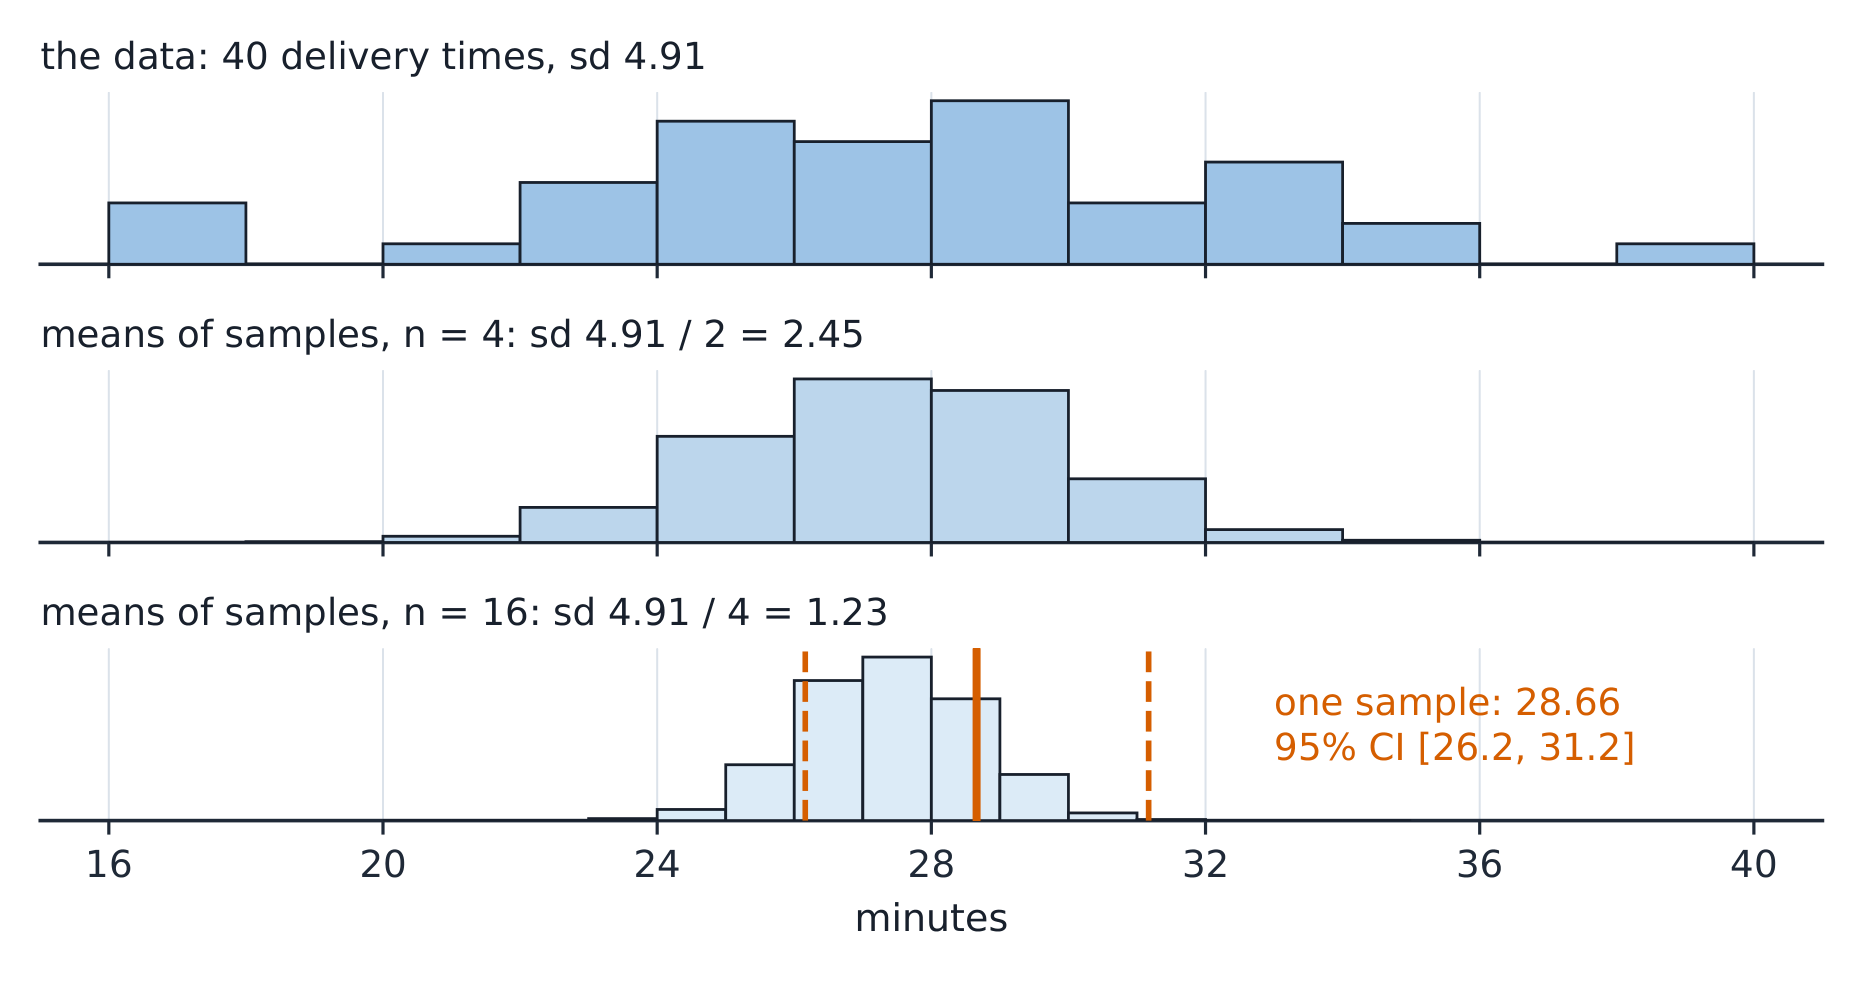 ההגדרות. שגיאה תקנית של הממוצע היא
ההגדרות.
- טעות התקן של הממוצע, $SE = s/\sqrt{n}$, היא סטיית התקן של ממוצע המדגם, ולא של הנתונים.
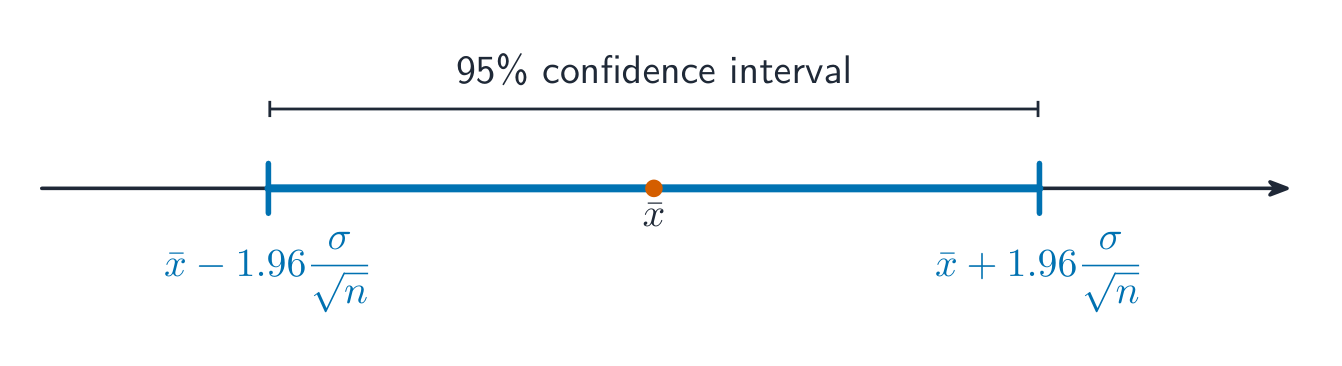
- רווח סמך של 95% הוא $\bar x \pm t \times SE$.
- רמת הסמך מתארת את השיטה: 95% מרווחי הסמך שנוצרים כך מכילים את הממוצע האמיתי. אין פירוש הדבר "הסתברות של 95% לכך ש האמת נמצאת ברווח המסוים הזה".
החישוב. במדגם המקרי של הקורס, הכולל 16 הזמנות (שנוצר עם ערך אתחול אקראי 11), הממוצע הוא 28.66 וסטיית התקן היא 4.70, ולכן $SE = 4.70/\sqrt{16} = 1.175$. עבור $t_{15} = 2.131$, רווח הסמך של 95% הוא $28.66 \pm 2.50$, כלומר [26.2, 31.2]. הגדילו את המדגם פי ארבעה (64 הזמנות) ושגיאת התקן תקטן בחצי. דיוק עולה $\sqrt{n}$: זהו שער החליפין היקר ביותר בסטטיסטיקה.
דוגמה פתורה 1: פירוש נכון של רווח הסמך. "זמן המשלוח הממוצע הוא בין 26.2 ל-31.2 דקות, ברמת סמך של 95%." שלושה פירושים:
- (א) "הסיכוי שהממוצע האמיתי נמצא ב-[26.2, 31.2] הוא 95%." שגוי.
- (ב) "95% מההזמנות נמשכות 26–31 דקות." שגוי: לשם כך נועד רווח חיזוי, שהיה רחב הרבה יותר.
- (ג) "השיטה שהפיקה את הטווח הזה כוללת את הממוצע האמיתי ב-95% מהשימושים בה." נכון.
הרווח מתייחס לממוצע, ורמת הסמך מתייחסת לשיטה.
דוגמה פתורה 2: מחיר הדיוק. המנהל רוצה לדעת את הממוצע בדיוק של ±0.5 דקות. התנאי הוא $t \cdot s/\sqrt{n} \le 0.5$. בגודל המדגם הנדרש, $t \approx 1.97$ (ולא 2.131 של $n = 16$), לכן
דיוק גבוה פי חמישה (מ-±2.5 ל-±0.5) דורש יותר מפי עשרים נתונים (מ-16 ל-343). ואם אותן הזמנות היו מדגם נוחות, 343 תצפיות מוטות הן פשוט טעות גדולה פי 343. דיוק והיעדר הטיה הם שני דברים שונים שיש לשלם עבורם.
טעויות נפוצות.
- בלבול בין סטיית התקן (פיזור הנתונים) לבין שגיאת התקן (אי-הוודאות של הממוצע).
- פירוש רמת הסמך כהסתברות הנוגעת לרווח הסמך המסוים הזה.
- שכחה שרווח הסמך מניח קיומו של מדגם אקראי. החישוב אינו יכול לתקן את מערך המחקר.
סיכום. $SE = s/\sqrt{n}$. משפט הגבול המרכזי גורם לממוצעים להתפלג בקירוב נורמלית. השתמשו ב-$\bar x \pm t \cdot SE$, ופרשו את רמת הסמך כתכונה של השיטה.
בדיקת הייפוטזה
למה זה חשוב. "האם השירות בימי חול באמת איטי יותר מהשירות בסוף השבוע?" מבחן הוא דרך פורמלית לשאול אם הנתונים היו מפתיעים אילו לא היה כל הבדל. כשמשתמשים בו ביושר, הוא מרסן טענות; כשמשתמשים בו כטקס, הוא מייצר אותן.
הרעיון. קבעו השערת אפס ($H_0$: הממוצע הוא 30) והשערה חלופית. חשבו עד כמה המדגם היה קיצוני אילו $H_0$ הייתה נכונה, ודחו את $H_0$ רק אם הוא מעבר לסף שנבחר. ערך ה-p p הוא הסיכוי לקבל נתונים קיצוניים לפחות באותה מידה אילו $H_0$ הייתה נכונה.
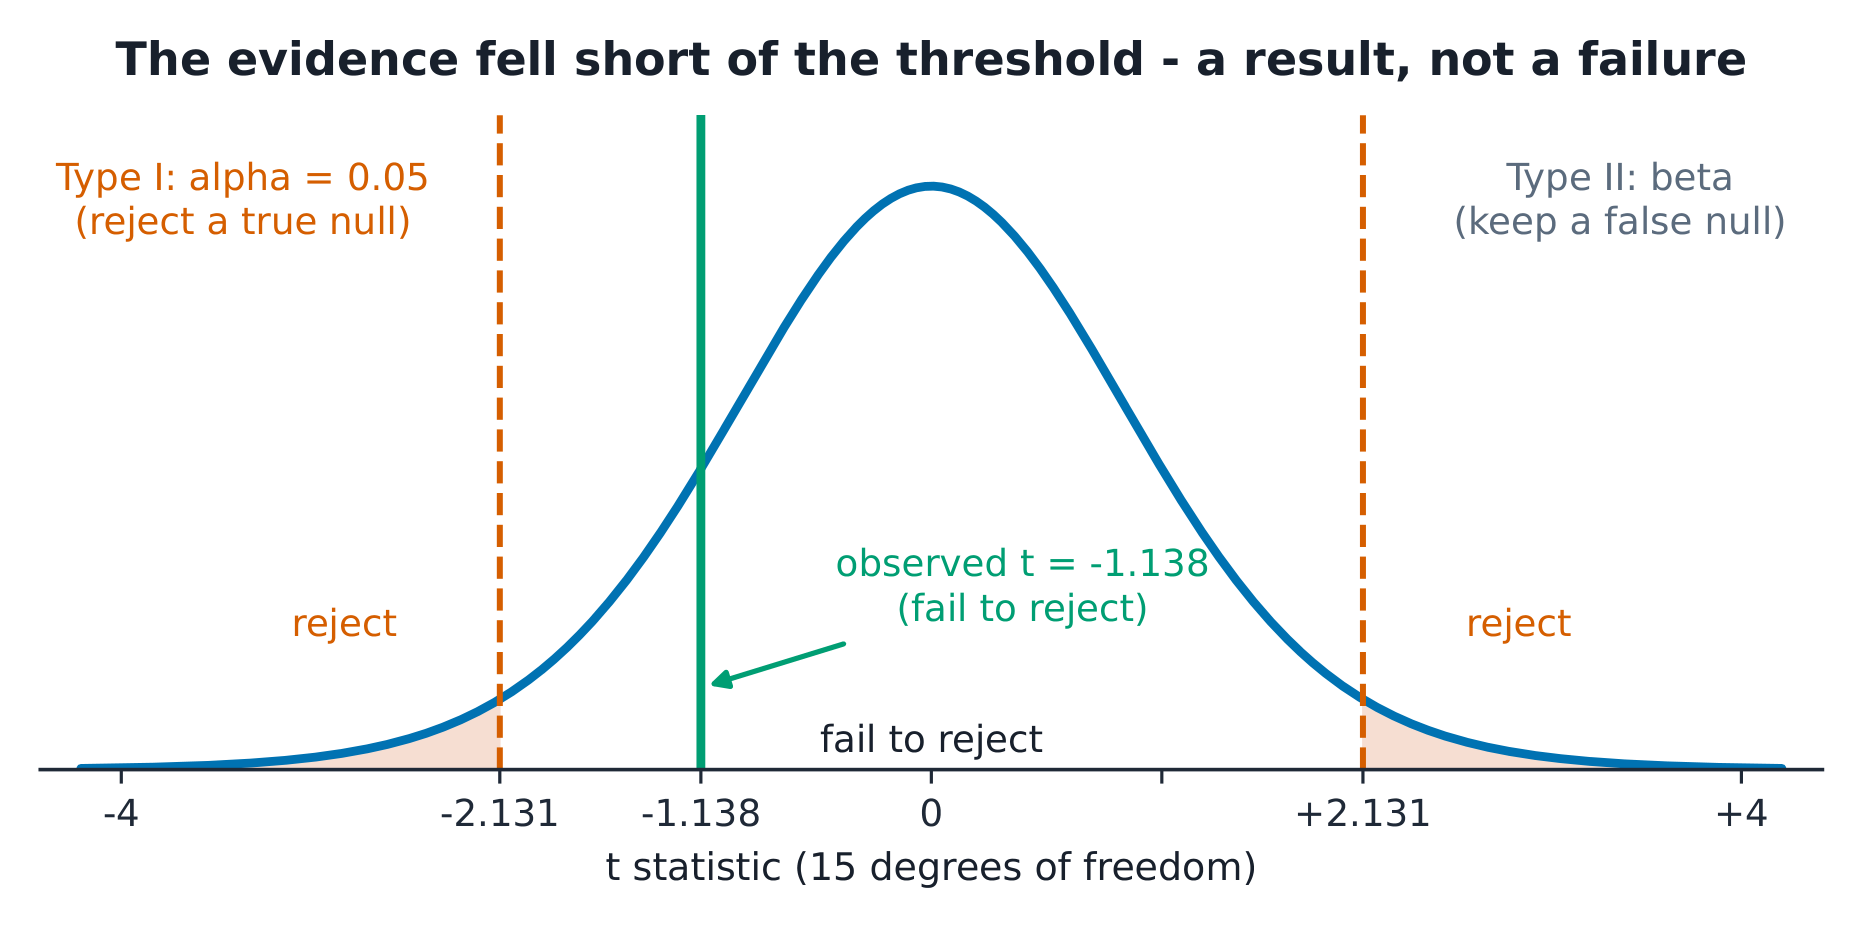
ההגדרות. מבחן השערות משווה את מידת הקיצוניות של הנתונים לסף שנבחר.
- סטטיסטי המבחן: $t = (\bar x - \mu_0)/(s/\sqrt n)$.
- רמת מובהקות $\alpha$: שיעור הטעויות מסוג I (דחיית $H_0$ נכונה) שאנו בוחרים, בדרך כלל 0.05.
- טעות מסוג II $\beta$: החמצת השפעה אמיתית. עוצמה $= 1 - \beta$.
- "מובהק סטטיסטית" פירושו רק ש-$p < \alpha$.
החישוב. האם הממוצע הוא 30 דקות? עבור המדגם שנוצר עם ערך התחלתי 11:
הערך הקריטי ברמה $\alpha = 0.05$, במבחן דו-צדדי, עם 15 דרגות חופש, הוא $|t| > 2.131$. מכיוון ש-$1.14 < 2.131$, אנו איננו דוחים את $H_0$. הנתונים עולים בקנה אחד עם ממוצע של 30 דקות, וגם עם ערכים רבים אחרים. שימו לב למה שאין בכך כדי לומר: לא "הממוצע הוא 30", ולא "אין הבדל", אלא רק "המדגם הזה לא היה מפתיע אילו הממוצע היה 30".
דוגמה פתורה 1: ערך p המדווח ביושר. שליח טוען שהמסלול שלו בשבת מהיר יותר. ממוצע 16 הנסיעות שלו הוא 26.9 דקות לעומת 28.7 של החנות, עם $s = 4.0$, לכן $t = (26.9 - 28.7)/(4.0/4) = -1.8$, וגם $p \approx 0.09$. "כמעט מובהק" אינו קטגוריה: דווחו על $p = 0.09$ והביאו בחשבון את מחיר הטעות בהחלטה. אם רק קינוחים חינם תלויים בתשובה, ייתכן ש-$\alpha = 0.10$ מתאים; אם הדרכה מחדש של הצוות תלויה בה, השתמשו ב-0.05 או ב-0.01. $\alpha$ היא בחירה עסקית בעלת שם יווני.
דוגמה פתורה 2: מובהקות אינה זהה לחשיבות.
- עם 4,000 הזמנות בכל אחת משתי קבוצות, להפרש של 0.4 דקות יש $SE = 5\sqrt{2/4000} \approx 0.11$, לכן $z \approx 3.6$ וגם $p < 0.01$. הוא מובהק סטטיסטית, אבל אף לקוח אינו מבחין ב-24 שניות.
- עם 8 הזמנות בכל קבוצה, להפרש של 3 דקות יש $SE = 5\sqrt{2/8} = 2.5$, לכן $t = 1.2$ וגם $p \approx 0.25$. המבחן אינו מסוגל לזהות אותו, אבל כל לקוח היה מבחין בו.
הפתרון הוא לדווח על גודל האפקט יחד עם רווח הסמך שלו: "0.4 דקות, רווח סמך של 95% [0.2, 0.6]: מובהק, אך זניח". מובהקות שואלת "האם הוא קיים?"; גודל האפקט שואל "האם הוא חשוב?". עסק זקוק לתשובה השנייה.
טעויות נפוצות.
- "קבלת" השערת האפס. אינכם דוחים אותה: היעדר ראיות להשפעה אינו ראיה להיעדר השפעה.
- המחשבה ש-$p$ הוא ההסתברות שההשערה נכונה.
- מניפולציה של ערך p: ביצוע מבחנים שוב ושוב עד שמשהו עובר את 0.05. יחידה 5.7 עוסקת בכך.
סיכום. $t = (\bar x - \mu_0)/SE$. דחו מעבר לסף שנבחר כתקציב הטעויות שלכם. $p$ מתייחס לנתונים, ולא להשערה. מובהק אינו אומר חשוב: דווחו תמיד על גודל האפקט.
רגרסיה וקורלציה
למה זה חשוב. "האם משלוחים ארוכים יותר מגיעים מכתובות מרוחקות יותר?" רגרסיה הופכת זוגות של מספרים לקו, מודדת עד כמה הם משתנים יחד, ואם אינכם נזהרים, מרמזת על סיבה. ביחידה זו נתאים את הקו, נפרש את מה שהוא מחמיץ, ונגביל את הטענה בדבר סיבות.
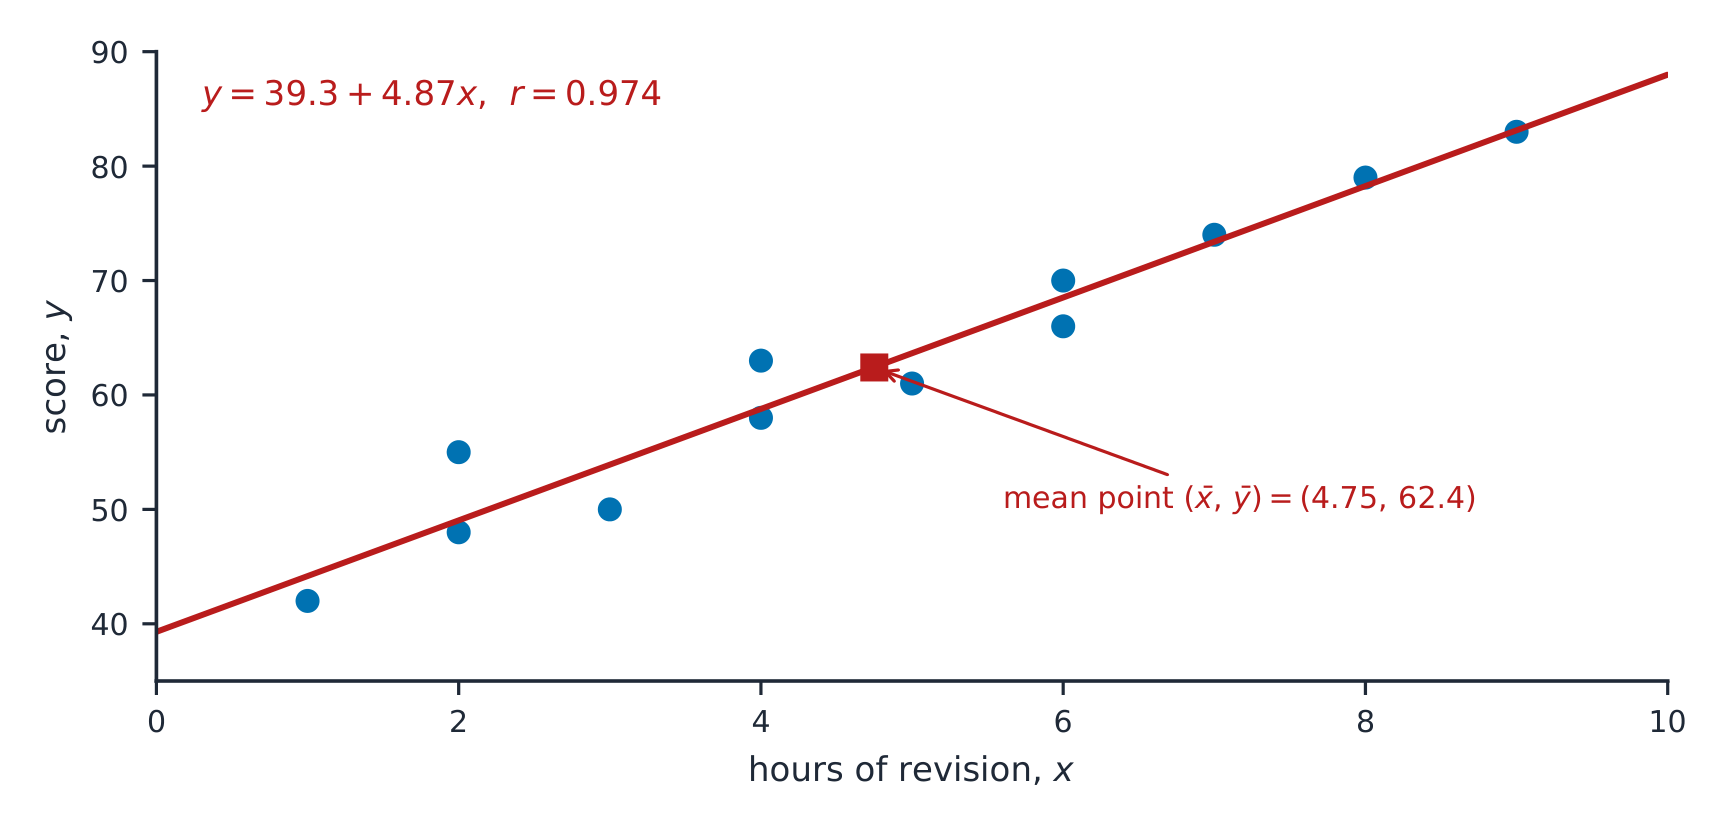
הרעיון. שנים עשר משלוחים שנערך אחריהם מעקב מספקים מרחק (1.0–3.75 ק״מ) ומשך זמן. הפיזור צפוף ועולה ימינה. קו הריבועים הפחותים הוא
כך שכל קילומטר נוסף מוסיף 4.83 דקות. המתאם הוא $r = 0.989$, ו-$r^2 = 0.979$: 97.9% מהשונות בזמן משתנה יחד עם המרחק.
ההגדרות.
- שיפוע: השינוי ב-$\hat y$ עבור כל יחידה נוספת של $x$.
- חיתוך עם הציר: $\hat y$ כאשר $x = 0$ (לעיתים קרובות חסר משמעות: 0 ק״מ אינם משלוח).
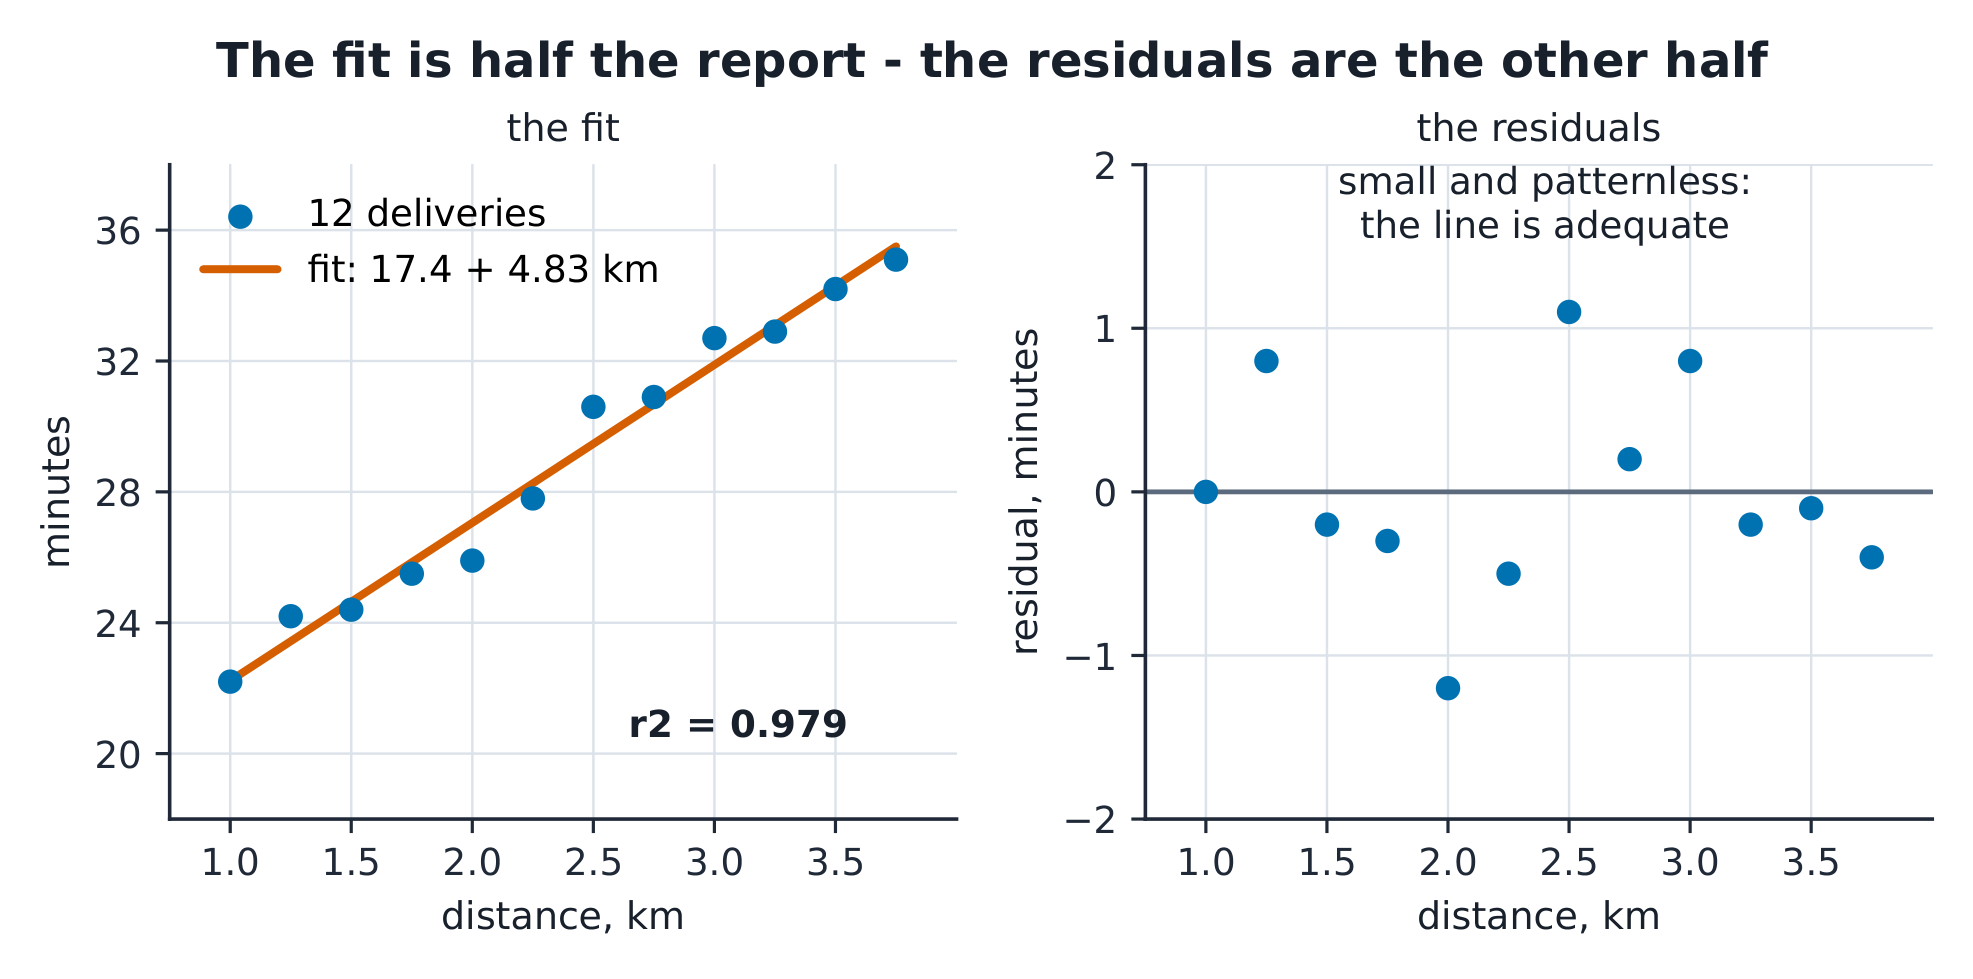
- שארית: $y - \hat y$, החלק שהקו מחמיץ.
- $r^2$: החלק מהשונות ב-$y$ שהקו מסביר.
- אקסטרפולציה מעבר לטווח הנתונים היא בגדר המצאה.
כיצד מוצאים את הקו. שיטת הריבועים הפחותים ממזערת את $\sum(y_i - a - bx_i)^2$, ומתקבלים $b = r \, s_y/s_x$ ו- $a = \bar y - b\bar x$. עבור 12 המשלוחים, $b = 4.83$ ו-$a = 17.4$. השאריות נעות בין −1.2 ל-+1.1 דקות ללא דפוס, לכן קו ישר מתאים כאן היטב, ותרשים השאריות הוא הראיה לכך.
דוגמה פתורה 1: פירוש ההתאמה.
- משך הזמן החזוי למשלוח למרחק 2 ק״מ הוא $17.4 + 9.7 = 27.1$ דקות; למשלוח למרחק 3 ק״מ, 31.9 דקות.
- את החיתוך עם הציר, 17.4 דקות במרחק 0 ק״מ, אפשר לפרש כזמן המטבח והמסירה. פירוש זה הגיוני כאן רק משום שיש סיבה ממשית לצפות לזמן הכנה קבוע. ציינו פירושים כאלה; אל תניחו אותם סתם כך.
- תחזית למרחק 7 ק״מ (51 דקות) היא אקסטרפולציה: אין נתונים מעבר ל-3.75 ק״מ שתומכים בקו בנקודה זו.
דוגמה פתורה 2: מתאם אינו סיבתיות. מתאם של 0.989 הוא חזק מאוד ביחס לנתונים עסקיים, ובכל זאת אינו מוכיח דבר על סיבה. ייתכן שמעורבים גורמים אחרים: המרחק והזמן גדלים שניהם עם עומס התנועה, ואופן הקצאת ההזמנות (שליחים מקבלים הזמנות מרוחקות בשעות שקטות) עשוי לגרום למרחק ולזמן להשתנות יחד מבלי שהמרחק יגרום לשינוי בזמן בקצב שהותאם. הניסוח הישר: "המרחק מנבא את הזמן במדגם הזה ($r^2 = 0.98$); קביעת קצב סיבתי תחייב לשמור על הקצאת המסלולים קבועה." מתאם מתאר כיצד שני משתנים השתנו יחד במערך הנתונים הזה; סיבתיות היא טענה בדבר מה שהיה משתנה אילו התערבתם. טענות שונות דורשות ראיות שונות.
טעויות נפוצות.
- פירוש $r^2 = 0.98$ כ-"98% תחזיות מדויקות".
- פירוש החיתוך עם הציר כאשר ל-$x = 0$ אין משמעות.
- ביצוע אקסטרפולציה מעבר לנתונים.
- הטעות הקלאסית: הסקת סיבתיות ממתאם, בלי מנגנון, בלי ניסוי ובלי זהירות.
סיכום. $\hat y = a + bx$ בשיטת הריבועים הפחותים. בדקו את השאריות; אל תניחו הנחות לגביהן. $r^2$ מודד קשר; רק מערך המחקר יכול להראות סיבתיות.
מגבלות החלטה
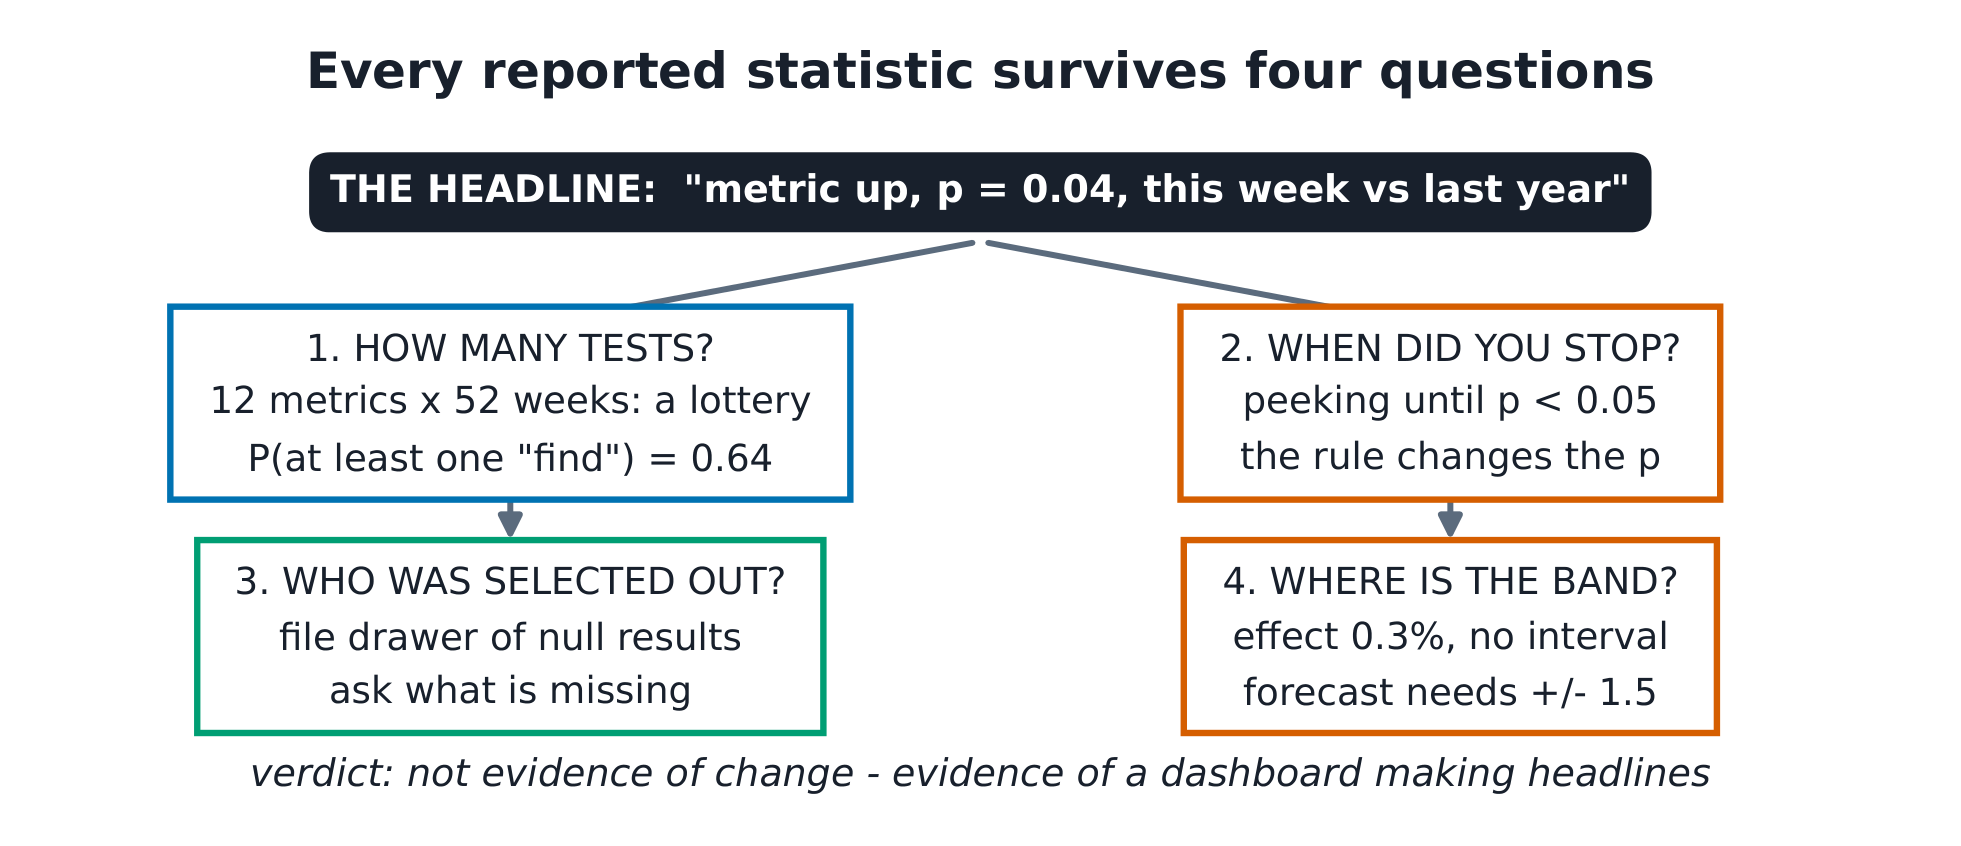
ועדיין לייצר שקר — על ידי שאלות רבות, עצירה בזמן ועדיין להגיע למסקנה שגויה: באמצעות שאילת שאלות רבות, עצירה כשנוח לכם, או דיווח על ודאות שמעולם לא הייתה קיימת. יחידה אחרונה זו היא רשימת הבדיקה ששומרת על הסטטיסטיקה כתחום ידע ולא כאמצעי שכנוע.
הרעיון. המלכודות:
- מבחנים מרובים: 20 שאלות ברמה $\alpha = 0.05$ יפיקו ממצאים מקריים "מובהקים" מעצם התכנון;
- כללי עצירה: בחינת הנתונים שוב ושוב, ועצירה ברגע ש-$p < 0.05$;
- בחירת תוצאות: דיווח רק על המדד האחד שהשתנה;
- ודאות שגויה: תחזיות הניתנות כמספרים בודדים, ללא רווחים.
ההגדרות.
- מניפולציה של ערך p: ניסיון של גרסאות רבות לניתוח עד שאחת עוברת את הסף.
- ניסוח השערה בדיעבד: המצאת ההשערה לאחר ראיית התוצאות.
- הטיית פרסום או בחירה: המגירה המלאה בתוצאות ללא השפעה שאיש אינו מראה לכם.
- תחזית ללא רווח היא רק מצב רוח.
החישוב של מבחנים מרובים. עם 20 מבחנים בלתי תלויים ברמה $\alpha = 0.05$:
לכן ממצא מקרי הוא סביר, ולא תגלית. כלל בונפרוני: עבור 20 מבחנים עם $\alpha$ כולל של 0.05, כל מבחן דורש $p < 0.05/20 = 0.0025$. כעת אפשר לפרש את הדוגמה מיחידה 5.5 בשתי הדרכים: $p = 0.09$ אינו מובהק, והוא גם אחד המבחנים המעטים שדווחו. מספר המבחנים שלא דווחו הוא חלק ממשמעותו של ערך p.
דוגמה פתורה 1: בדיקת לוח מחוונים. לוח מחוונים עוקב אחר 12 מדדים מדי שבוע. השבוע אחד מהם מציג $p = 0.04$ בהשוואה לשנה שעברה.
- כמה השוואות? 12 מדדים × 52 שבועות: ה"ממצא" הזה הגיע מהגרלה עם מאות כרטיסים.
- האם הוא הוגדר מראש? לא.
- האם גודל האפקט חשוב? הוא 0.3%.
מסקנה: זו אינה ראיה לשינוי; זו ראיה לכך שלוחות מחוונים יכולים לייצר כותרות. התגובה הנכונה היא בדיקת אימות, המתוכננת מראש, על נתונים חדשים.
דוגמה פתורה 2: תחזית כנה. המנהל חוזה: "ממוצע זמני המשלוח בשבת הקרובה: 27.4 דקות". תשובת מערך הנתונים: לממוצע של שבת חדשה עם 40 הזמנות יש $SE \approx 4.91/\sqrt{40} = 0.78$, וגם ל-27.4 שממנו מופקת התחזית יש אותה שגיאה. לכן שגיאת התחזית היא
והתחזית צריכה להיכתב כך: "27.4 ± 2.2, ברמת ביטחון של 95%". גם אז, הממוצע של שבת אחת ייפול מחוץ לטווח הזה בערך פעם אחת מתוך עשרים. המשמעות להחלטות: תכננו את מצבת העובדים לפי הקצה העליון של הטווח (29.6), ולא לפי המספר היחיד. מספר ללא מידת אי-הוודאות שלו אינו ניתן לניהול; אפשר רק לקוות שיתקיים.
טעויות נפוצות.
- התייחסות לתוצאה מובהקת אחת מבין רבות כאל ממצא.
- המחשבה ש"לא הצלחנו לדחות" פירושו "הוכחנו את השערת האפס", תמונת הראי של המלכודת ביחידה 5.5.
- דרישת ודאות מתחזיות במקום לבקש את הרווח.
סיכום. ספרו את הבדיקות, הגדירו את הכללים מראש, הציגו מה הושמט, וציינו טווח לכל תחזית. הסטטיסטיקה ראויה להנחות החלטות משום שהיא מודה במה שאינה יודעת.
המאגר (ניתן לשחזור)
זמני משלוח של 40 הזמנות אוכל, בדקות, עד ספרה אחת אחרי הנקודה העשרונית, ממוינים:
16.8, 17.2, 17.3, 21.1, 22.8, 22.9, 23.0, 23.0, 24.3, 24.4, 24.9, 25.2, 25.2, 25.2, 25.5, 26.0, 26.1, 26.9, 27.4, 27.5, 27.7, 28.2, 28.4, 28.7, 28.7, 28.9, 28.9, 29.2, 29.3, 30.4, 31.0, 31.4, 32.2, 32.5, 33.2, 33.3, 33.7, 34.8, 35.5, 38.5
נתונים סטטיסטיים שנבדקו: $n$ = 40; סכום 1,097.2; ממוצע 27.43; חציון 27.6; סטיית תקן 4.91; רבעונים (לפי כלל $(n+1)p$) 24.5 / 27.6 / 30.9; טווח בין-רבעוני 6.3; אין נקודות מעבר לגבולות 1.5 × הטווח הבין-רבעוני (15.0 ו-40.3). מדגם האמידה (זרע אקראי 11, $n$ = 16): ממוצע 28.66, סטיית תקן 4.70, שגיאת תקן 1.175, רווח סמך של 95% [26.2, 31.2], $t$ מול 30 = −1.14. זוגות נתוני הרגרסיה (12 משלוחים, ק״מ מול דקות): שיפוע 4.83, חיתוך עם הציר 17.4, $r$ = 0.989, $r^2$ = 0.979. את כל המספרים בדף זה אפשר לחשב מחדש מתוך הערכים האלה.