L'Informatique IGCSE (0478) comprend dix thèmes répartis sur deux épreuves : représentation des données, transmission des données, matériel, logiciel, internet, technologies automatisées et émergentes, conception d'algorithmes, programmation, bases de données et logique booléenne.
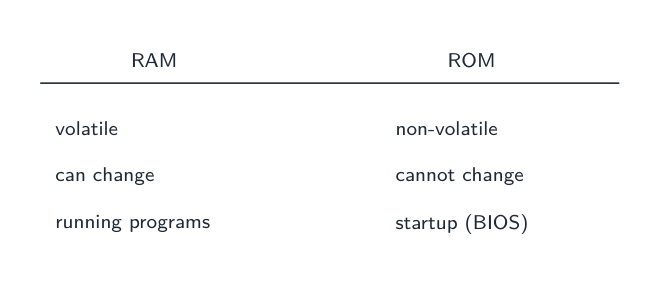
L'épreuve 1 est théorique, notée sur le vocabulaire précis — la différence entre RAM et ROM, un compilateur et un interpréteur, la validation et la vérification. Ce sont des points de définition, et une paraphrase les manque généralement.
L'épreuve 2 est axée sur la résolution de problèmes et la programmation, où les points vont à une méthode fonctionnelle : tableaux de traçage, pseudocode, et code qui fonctionnerait réellement. Maîtrisez les bases numériques et l'arithmétique binaire en premier — elles apparaissent isolément et à nouveau dans la transmission de données, la logique et le matériel.
Un ordinateur ne peut fonctionner qu'avec deux états : marche et arrêt. On écrit ces états comme 1 et 0. Un système qui n'utilise que deux chiffres 数字 est appelé binaire 二进制 (base 2).
Les ordinateurs représentent toutes les données — nombres, texte, son et images — sous forme de chaînes binaires de 0s et 1s
Tout type de données 数据 — nombres, texte, son et images — doit être converti en binaire avant qu'un ordinateur puisse l'utiliser. L'ordinateur traite ce binaire à l'aide de portes logiques 逻辑门, et le stocke dans des registres 寄存器 (petits stocks rapides à l'intérieur du processeur 处理器).
Un microprocesseur contient des millions de transistors minuscules, chacun étant un interrupteur qui est allumé (1) ou éteint (0) — la base physique du binaire
1 Comprendre comment et pourquoi les ordinateurs utilisent binaire pour représenter toutes les formes de données
• Toute forme de données doit être convertie en binaire pour être traitée par un ordinateur • Les données sont traitées à l'aide de portes logiques et stockées dans des registres
2 (a) Comprendre les systèmes numériques décimal, binaire et hexadécimal (b) Convertir entre (i) décimaux positifs et binaires positifs (ii) décimaux positifs et hexadécimaux positifs (iii) hexadécimaux positifs et binaires positifs
• Le décimal est un système de base 10 • Le binaire est un système de base 2 • L'hexadécimal est un système de base 16 • Les valeurs utilisées seront uniquement des entiers • Les conversions dans les deux sens, par ex. décimal vers binaire ou binaire vers décimal • Longueur maximale du nombre binaire de 16 bits
3 Comprendre comment et pourquoi l'hexadécimal est utilisé comme une méthode bénéfique de représentation des données
• Les domaines dans l'informatique où l'hexadécimal est utilisé doivent être identifiés • L'hexadécimal est plus facile à comprendre pour les humains que le binaire, car c'est une représentation plus courte du binaire
4 (a) Additionner deux entiers binaires positifs sur 8 bits (b) Comprendre le concept de débordement et pourquoi il se produit dans l'addition binaire
• Une erreur de débordement se produira si la valeur est supérieure à 255 dans un registre de 8 bits • Un ordinateur ou un dispositif a une limite prédéfinie qu'il peut représenter ou stocker, par exemple 16 bits • Une erreur de débordement se produit lorsqu'une valeur hors de cette limite doit être retournée
5 Effectuer un décalage logique binaire sur un entier binaire positif de 8 bits et comprendre l'effet que cela a sur l'entier binaire positif
• Effectuer des décalages logiques vers la gauche • Effectuer des décalages logiques vers la droite • Effectuer plusieurs décalages • Les bits décalés depuis la fin du registre sont perdus et des zéros sont insérés à l'extrémité opposée du registre • L'entier binaire positif est multiplié ou divisé selon le décalage effectué • Le(s) bit(s) de poids fort ou le(s) bit(s) de poids faible sont perdus
6 Utilisez le système binaire en complément à deux pour représenter des entiers binaires 8 bits positifs et négatifs
• Convertir un entier binaire ou décimal positif en un entier 8 bits en complément à deux et vice versa • Convertir un entier binaire ou décimal négatif en un entier 8 bits en complément à deux et vice versa
Source : Programme Cambridge International
Comptage en binaire : 0 à 15
Un système de numération 数制 est une façon d'écrire les nombres en utilisant un ensemble fixe de chiffres. Il vous en faut trois.
Système
Base
Chiffres utilisés
Décimal
10
0–9
Binaire
2
0 et 1
Hexadécimal
16
0–9 puis A–F
Le décimal 十进制 est le système de comptage normal (aussi appelé décimal).
Le binaire utilise uniquement 0 et 1.
Le hexadécimal 十六进制 (hex) utilise seize chiffres : 0–9, puis A, B, C, D, E, F valent respectivement 10, 11, 12, 13, 14, 15.
La base 基数 indique combien de chiffres différents un système utilise.
Valeur positionnelle
Chaque colonne d'un nombre a une valeur positionnelle 位值. En binaire, les valeurs doubles de droite à gauche. Pour un nombre sur 8 bits, elles sont :
128 64 32 16 8 4 2 1
Un tableau de valeur positionnelle sur 8 bits : les 1 sont placés sous les valeurs qui s'additionnent à 150
Un bit 位 est un 0 ou un 1 unique. Huit bits font un octet 字节. Quatre bits (la moitié d'un octet) forment un nibble 半字节.
Conversion entre systèmes de numération
Décimal → binaire. Écrire les valeurs positionnelles. Mettre un 1 sous chaque valeur nécessaire pour atteindre votre nombre ; mettre un 0 sous les autres.
Exemple : convertir le décimal 150 en binaire. $150 = 128 + 16 + 4 + 2$.
128 64 32 16 8 4 2 1
  1  0  0  1 0 1 1 0
Donc $150$ = 10010110.
Binaire → décimal. Additionner les valeurs positionnelles où il y a un 1. 10010110$= 128 + 16 + 4 + 2 = 150$.
Hexadécimal → binaire. Convertir chaque chiffre hexadécimal en son propre groupe de 4 bits (un nibble).
Exemple : hex F08. $F = 1111$, $0 = 0000$, $8 = 1000$, donc F08 = 1111 0000 1000.
Chaque chiffre hexadécimal correspond à son propre nibble de 4 bits — F08 = 1111 0000 1000
Binaire → hexadécimal. Regrouper les bits en nibbles de 4, en commençant par la droite. Convertir chaque nibble en un chiffre hexadécimal.
Décimal → hexadécimal. La méthode facile consiste d'abord à convertir en binaire, puis en hex.
Ce tableau aide avec les lettres hex :
Décimal
Binaire
Hex
10
1010
A
11
1011
B
12
1100
C
13
1101
D
14
1110
E
15
1111
F
Les questions Cambridge utilisent des nombres binaires allant jusqu'à 16 bits.
Exemple résolu. Convertir le décimal 100 en binaire sur 8 bits, puis en hexadécimal.
$100 = 64 + 32 + 4$, donc le binaire est 01100100. En divisant en nibbles, 01100100$= 6$ et $4$, donc l'hexadécimal est 64.
Pourquoi utiliser l'hexadécimal
L'hex est plus court que le binaire et plus facile à lire et écrire pour les humains. Un chiffre hex remplace 4 chiffres binaires, réduisant ainsi les erreurs. La valeur ne change pas — l'hex est simplement une façon plus courte d'afficher le même binaire.
Les informaticiens utilisent l'hex pour :
Adresses MAC et adresses IPv6
codes couleur en HTML (par exemple #FF0000 est rouge)
adresses mémoire 内存地址 et codes d'erreur
affichage du contenu de la mémoire (un « memory dump »)
Explorer
Binaire, décimal et hexadécimal
Saisissez un nombre et voyez-le en binaire, décimal et hexadécimal — et comment les valeurs de position le construisent.
Addition colonne par colonne ; les reports se propagent vers la gauche. 118 + 48 = 166
Débordement
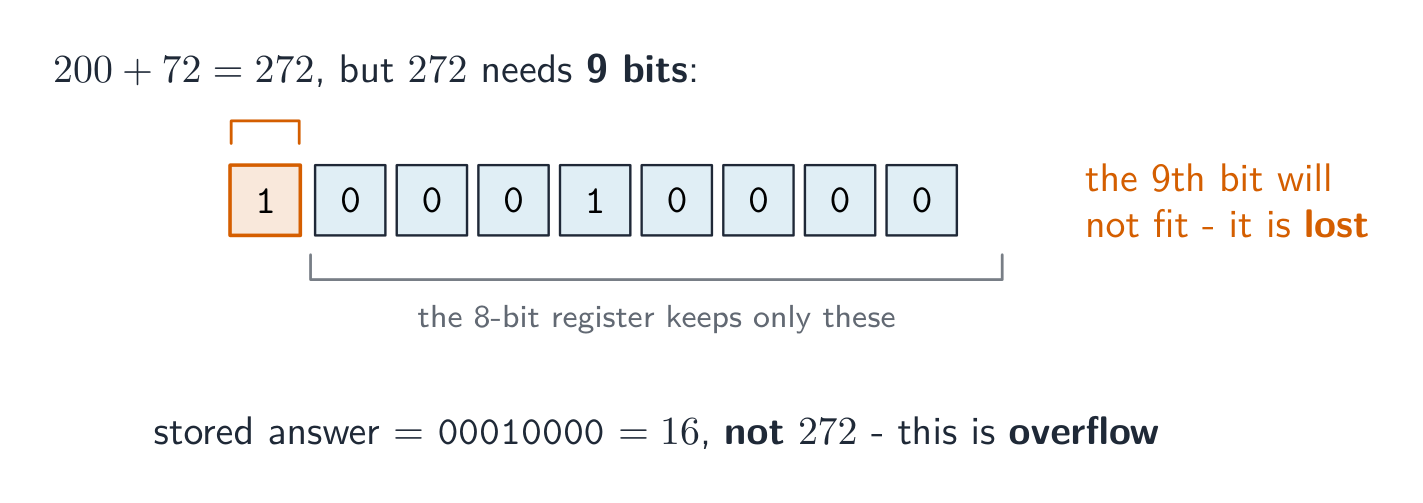
Un registre de 8 bits peut contenir des valeurs décimales allant de 0 à 255 uniquement. Si une addition donne un résultat supérieur à 255, la réponse nécessite un 9e bit. Le registre ne pouvant pas contenir ce bit supplémentaire, il est perdu. On appelle cela overflow 溢出 (une erreur de dépassement). Cela se produit lorsqu'une valeur sort de la limite que le registre peut stocker.
Exemple : 11001000 (200) $+$01001000 (72) $= 272$. En binaire, cela correspond à 1 00010000, ce qui nécessite 9 bits. Le 1 en position de poids fort ne tiendra pas dans 8 bits, donc la réponse stockée sera fausse.
L'addition de 200 et 72 nécessite 9 bits, mais un registre de 8 bits élimine le neuvième, donc la réponse est fausse
Un décalage binaire logique 逻辑二进制移位 déplace tous les bits vers la gauche ou vers la droite d'un certain nombre de positions.
Les bits qui sortent du registre sont perdus.
Des zéros sont ajoutés à l'extrémité vide.
Un décalage vers la gauche multiplie le nombre par 2 pour chaque position déplacée. Un décalage vers la droite le divise par 2 pour chaque position ; les bits de droite (les bits de poids faible(s) 最低有效位) sont perdus.
Exemple : décalage vers la gauche de 00110101 (53) de 2 positions.
Un décalage vers la gauche de 2 : chaque bit se déplace de 2 positions vers la gauche, les bits supérieurs sont perdus et des zéros remplissent la droite
Le résultat est 11010100 (212), ce qui correspond à $53 \times 4$. Les deux bits les plus à gauche ont été perdus et deux zéros sont entrés sur la droite. Si un 1 est expulsé par la sortie, cette information est définitivement perdue.
1.1
Complément à deux
Jusqu'à présent, les nombres étaient positifs. Le complément à deux 补码 permet à un registre de 8 bits de contenir également des nombres négatifs.
Dans le complément à deux, le bit de poids fort (le bit de poids le plus élevé 最高有效位, ou MSB) a une valeur de position négative :
-128 64 32 16 8 4 2 1
Si le MSB est 0, le nombre est positif.
Si le MSB est 1, le nombre est négatif.
Pour rendre un nombre positif négatif : écrivez le binaire positif, inversez chaque bit (0↔1), puis ajoutez 1.
Exemple : rendre $-40$ négatif.
$+40$ = 00101000
inverser les bits = 11010111
ajouter 1 = 11011000
Ainsi $-40$ = 11011000. Vérification en additionnant les valeurs de position : $-128 + 64 + 16 + 8 = -40$.
Le bit de poids fort vaut -128, donc 11011000 = -128 + 64 + 16 + 8 = -40
Pour lire un nombre en complément à deux négatif, il suffit d'additionner les valeurs de position (le MSB compte pour $-128$). La plage d'un nombre en complément à deux sur 8 bits va de $-128$ à $+127$.
1.2
Représentation du texte
Programme
Les candidats doivent être capables de :
Notes et orientations
1 Comprendre comment et pourquoi un ordinateur représente le texte et l'utilisation des ensembles de caractères, y compris le code américain standard pour l'échange d'informations (ASCII) et Unicode
• Le texte est converti en binaire pour être traité par un ordinateur • Unicode permet une plus grande gamme de caractères et de symboles qu'ASCII, y compris différentes langues et émojis • Unicode nécessite plus de bits par caractère que ASCII
2 Comprendre comment et pourquoi un ordinateur représente le son, y compris les effets du taux d'échantillonnage et de la résolution d'échantillonnage
• Une onde sonore est échantillonnée pour convertir le son en binaire, qui est ensuite traité par un ordinateur • Le taux d'échantillonnage est le nombre d'échantillons prélevés par seconde • La résolution d'échantillonnage est le nombre de bits par échantillon • La précision de l'enregistrement et la taille du fichier augmentent lorsque le taux et la résolution d'échantillonnage augmentent
3 Comprendre comment et pourquoi un ordinateur représente une image, y compris les effets de la résolution et de la profondeur de couleur
• Une image est une série de pixels convertis en binaire, qui sont ensuite traités par un ordinateur • La résolution est le nombre de pixels dans l'image • La profondeur de couleur est le nombre de bits utilisés pour représenter chaque couleur • La taille du fichier et la qualité de l'image augmentent lorsque la résolution et la profondeur de couleur augmentent
Source : Programme Cambridge International
Les ordinateurs stockent le texte en attribuant un numéro à chaque caractère, puis en stockant ce numéro en binaire. L'ensemble des caractères qu'un ordinateur peut utiliser, ainsi que leurs numéros, constituent un ensemble de caractères 字符集.
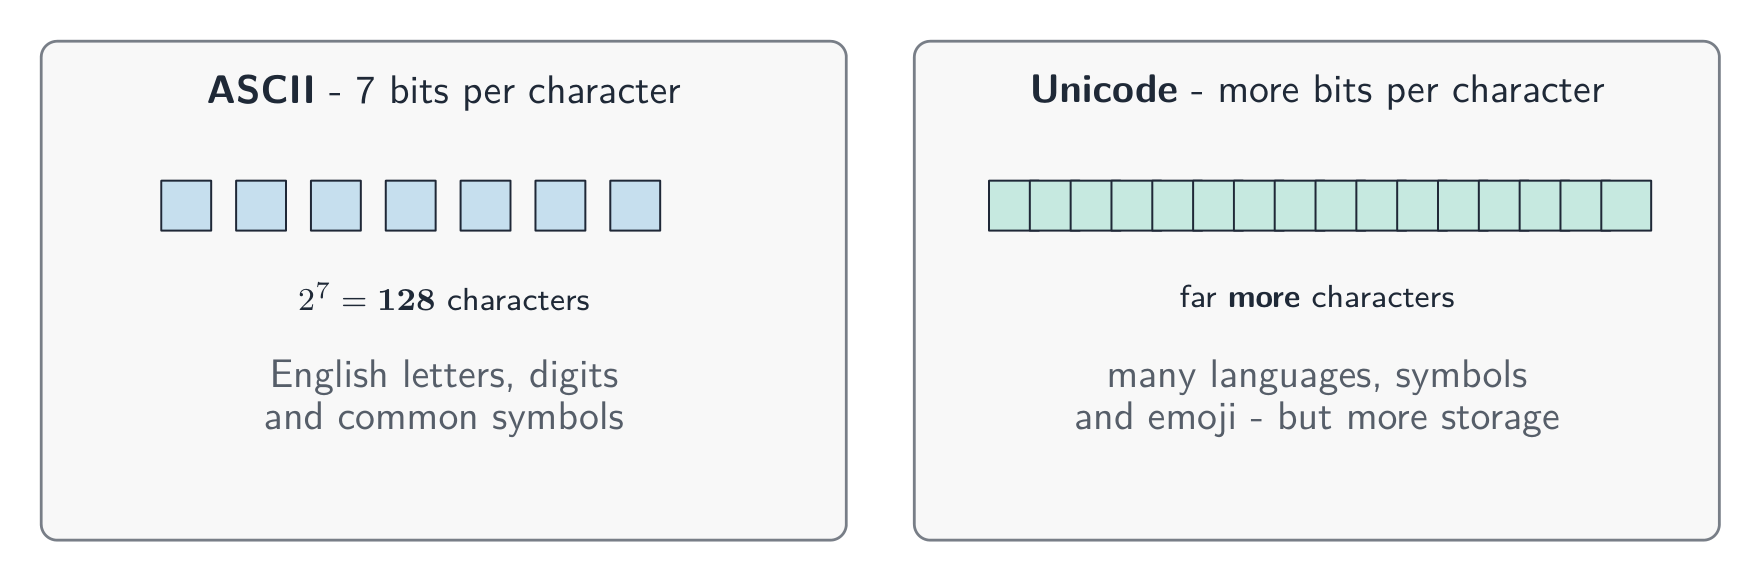
ASCII utilise 7 bits par caractère, offrant ainsi 128 caractères différents. C'est suffisant pour les lettres anglaises, les chiffres et les symboles courants.
Unicode utilise davantage de bits par caractère. Il peut représenter bien plus de caractères — de nombreuses langues, ainsi que des symboles et des emoji 表情符号.
Comme Unicode contient plus de caractères, il nécessite plus de bits par caractère que ASCII, donc le même texte occupe plus d'espace de stockage 存储。
ASCII utilise 7 bits pour 128 caractères ; Unicode utilise plus de bits pour beaucoup plus de caractères mais nécessite plus de stockage
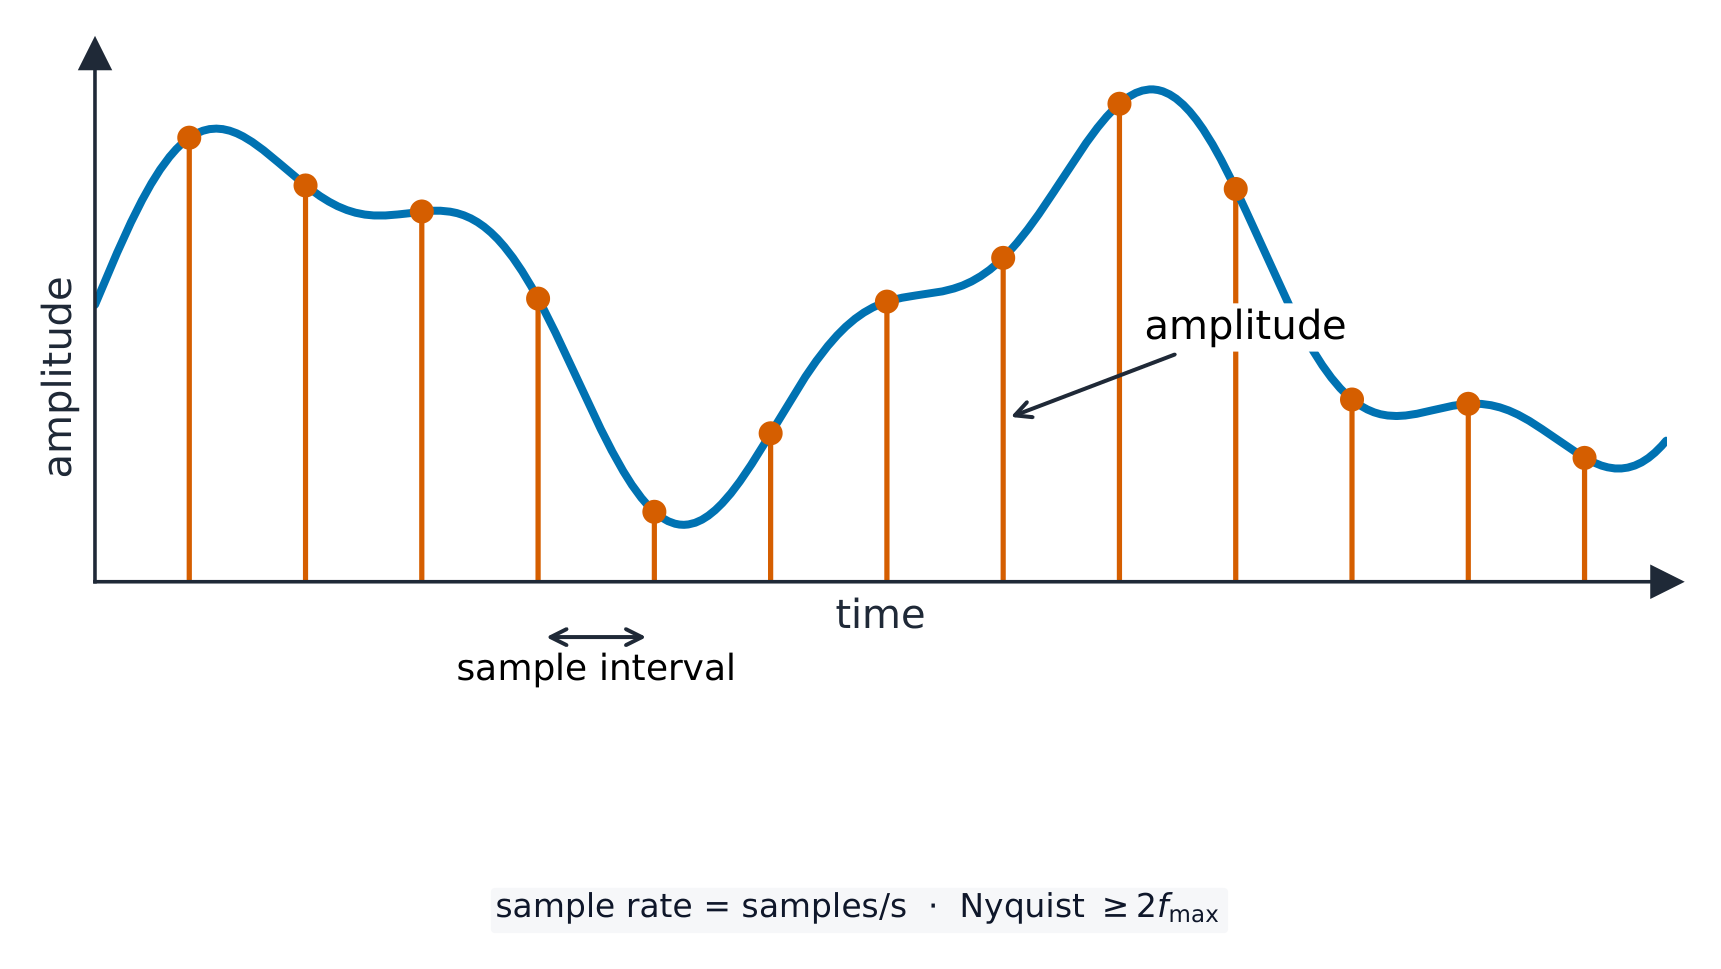
Une onde sonore 声波 est continue et change toujours. Pour la stocker, l'ordinateur mesure la hauteur de l'onde à des moments réguliers. On appelle cela l'échantillonnage 采样, et chaque mesure est un échantillon.
L'échantillonnage enregistre la hauteur de l'onde (amplitude) à des moments réguliers
Le taux d'échantillonnage 采样率 est le nombre d'échantillons prélevés par seconde (mesuré en Hz).
La résolution d'échantillonnage 采样分辨率 est le nombre de bits utilisés pour chaque échantillon. La hauteur de l'onde à un point d'échantillonnage est son amplitude 振幅。
Un taux d'échantillonnage plus élevé et une résolution d'échantillonnage plus élevée offrent un enregistrement plus précis, mais un fichier plus volumineux.
Explorer
Représentation du son
y = a sin(bt + c)
Le son est une onde ; l'échantillonnage enregistre sa hauteur de nombreuses fois par seconde.
1 Comprendre comment le stockage de données est mesuré
• Incluant : – bit – demi-octet (nibble) – octet – kibioctet (KiB) – mébioctet (MiB) – gibioctet (GiB) – tébioctet (TiB) – pébioctet (PiB) – exbioctet (EiB) • La quantité de la dénomination précédente présente dans la taille du stockage de données, par exemple : – 8 bits dans un octet – 1024 mébioctets dans un gibioctet
2 Calculer la taille d'un fichier image et d'un fichier sonore, en utilisant les informations fournies
• Les réponses doivent être données dans les unités spécifiées dans la question. Les calculs doivent utiliser la mesure de 1024 et non 1000 • Les informations fournies peuvent inclure : – résolution et profondeur de couleur de l'image – taux d'échantillonnage, résolution et durée de la piste audio
3 Comprendre le but et la nécessité de la compression de données
• La compression existe pour réduire la taille du fichier • Son impact, par exemple : – bande passante réduite requise – espace de stockage réduit requis – temps de transmission raccourci
4 Comprendre comment les fichiers sont compressés en utilisant des méthodes de compression avec perte et sans perte
• La compression avec perte réduit la taille du fichier en supprimant définitivement des données, par exemple en réduisant la résolution ou la profondeur de couleur, en réduisant le taux ou la résolution d'échantillonnage • La compression sans perte réduit la taille du fichier sans perte définitive de données, par exemple codage par longueur de course (RLE)
Source : Programme Cambridge International
Le stockage de données est mesuré en unités ci-dessous. Un nibble correspond à 4 bits et un octet à 8 bits ; à partir du kibibyte vers le haut, chaque unité est 1024 fois plus grande que la précédente (car $1024 = 2^{10}$, ce qui s'adapte au binaire)。
Unité
Équivaut à
bit
un seul 0 ou 1
nibble
4 bits
byte
8 bits
kibibyte (KiB)
1024 octets
mebibyte (MiB)
1024 KiB
gibibyte (GiB)
1024 MiB
tebibyte (TiB)
1024 GiB
pebibyte (PiB)
1024 TiB
exbibyte (EiB)
1024 PiB
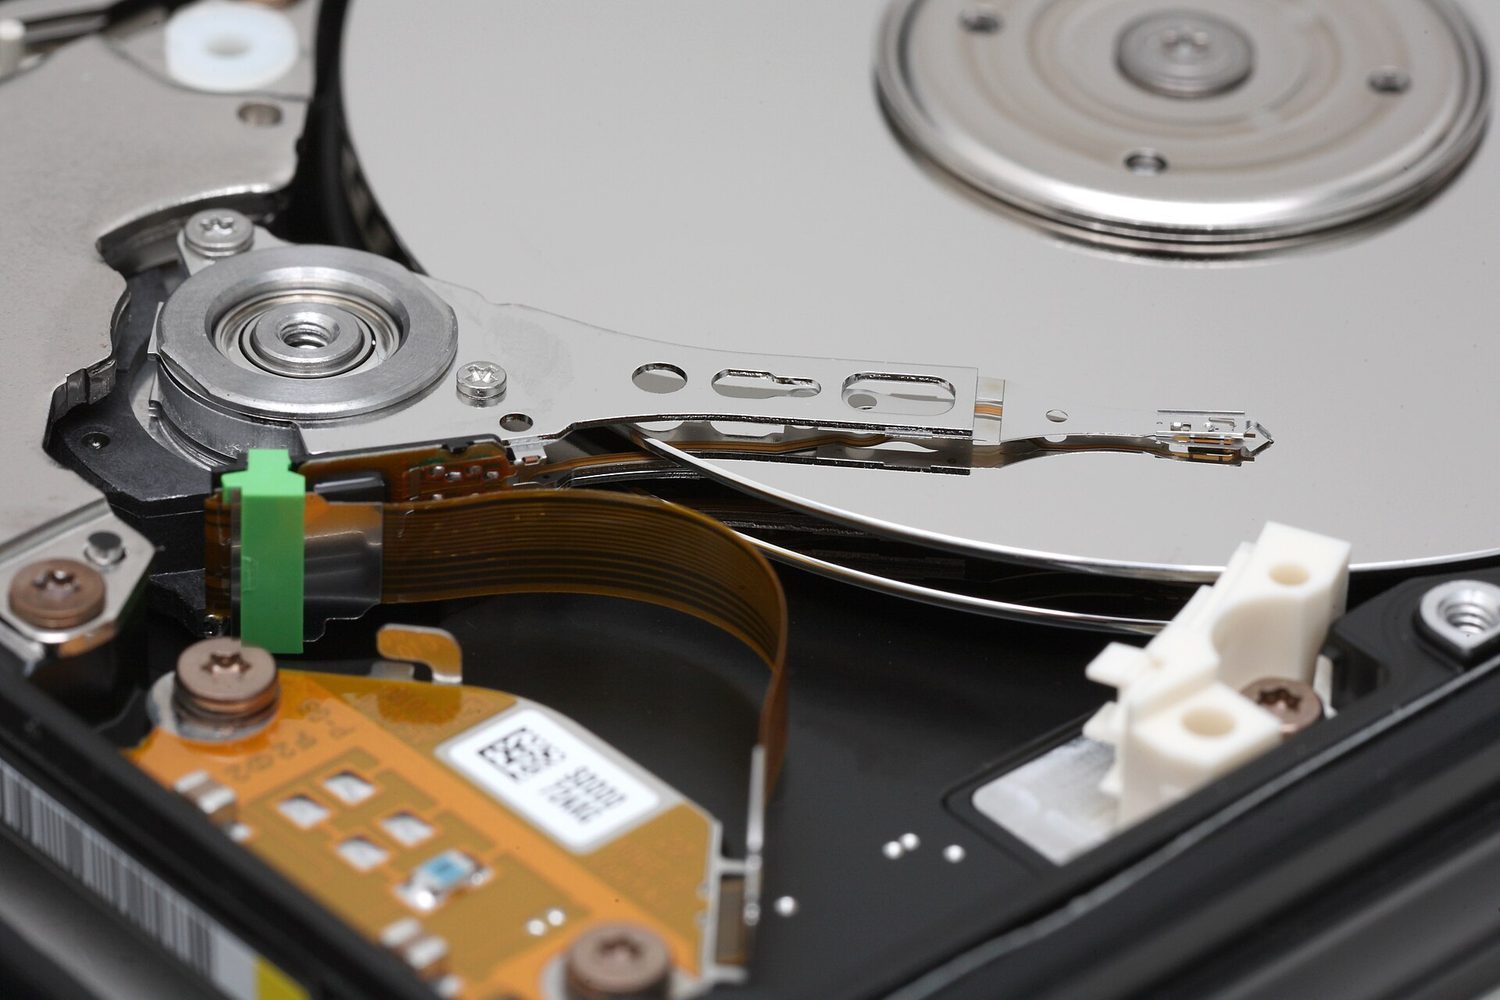
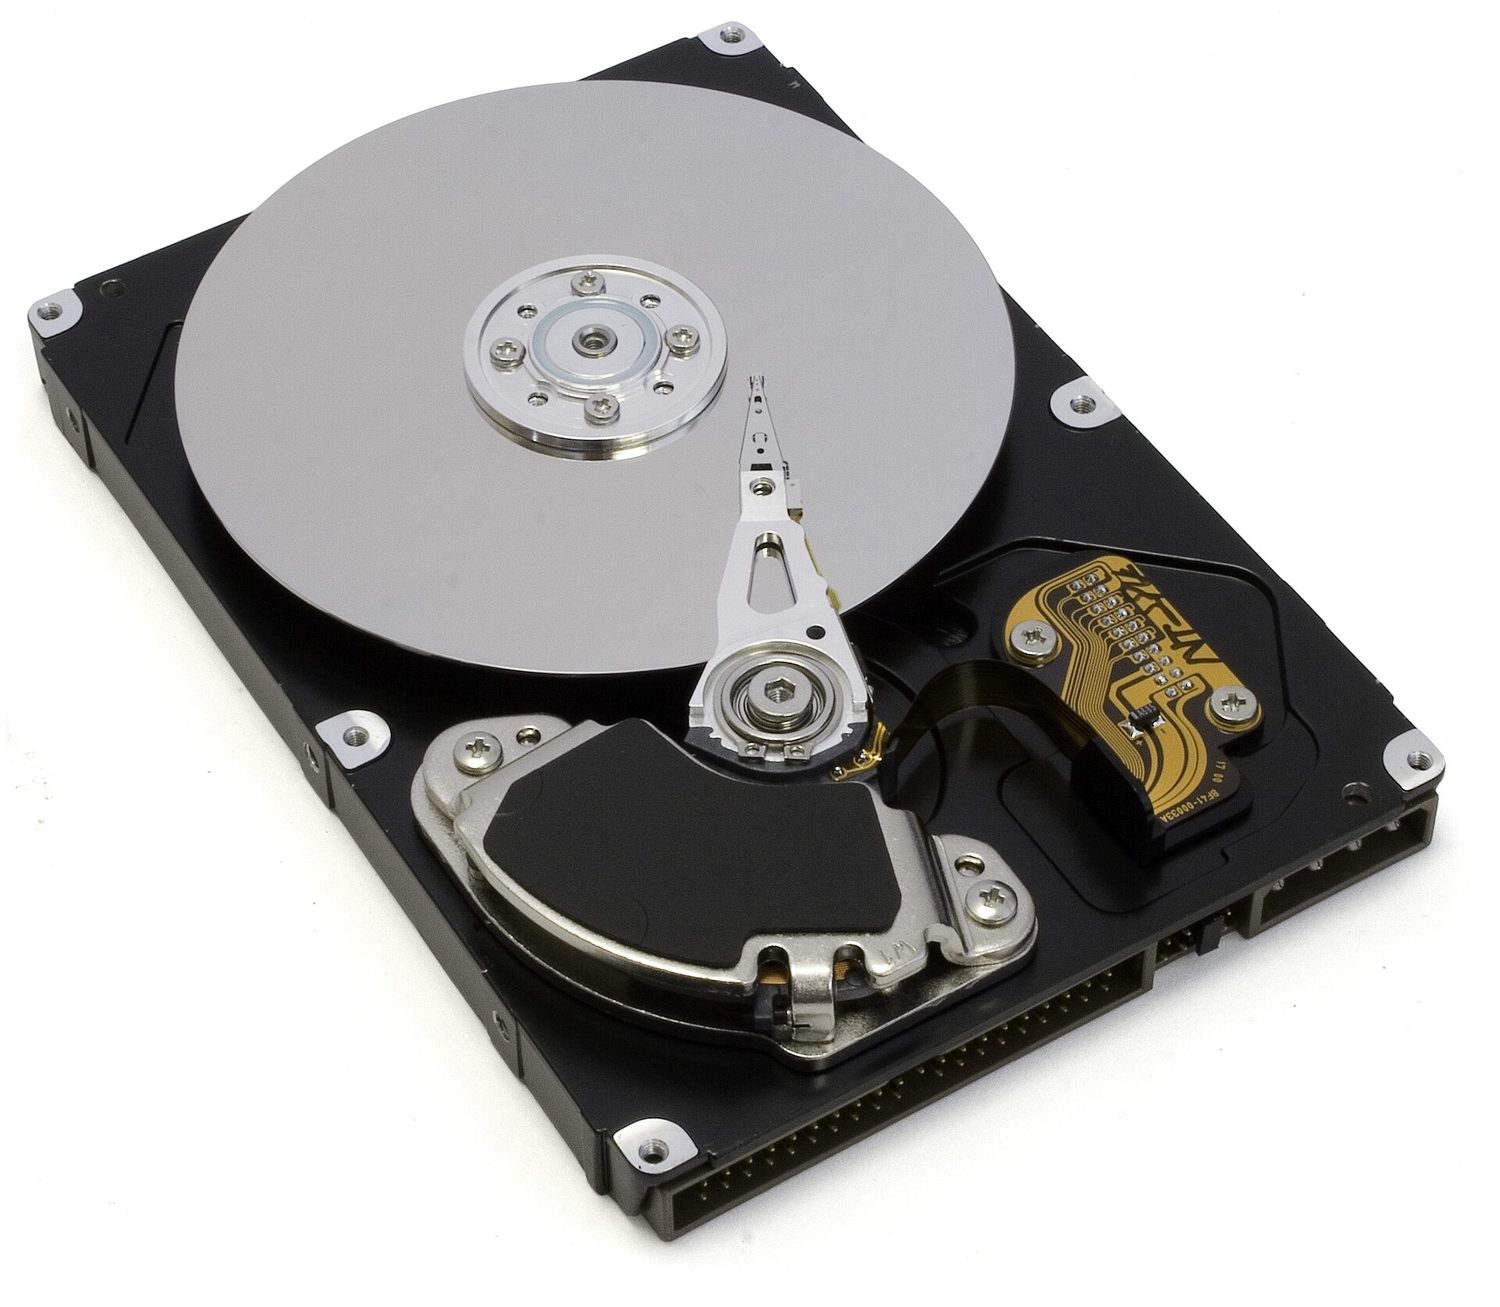
Plateaux de disque dur : le stockage est mesuré en octets — connaître la taille d'un fichier nécessite largeur × hauteur × profondeur de couleur pour les images
Taille de fichier sonore (en bits) $=$ taux d'échantillonnage $\times$ résolution d'échantillonnage $\times$ durée en secondes。
Divisez toujours par 1024 (et non 1000) pour convertir en KiB, MiB, etc. Donnez votre réponse dans l'unité demandée par la question。
Exemple résolu. Un son est enregistré pendant 30 secondes à un taux d'échantillonnage de 8,000 Hz avec une résolution d'échantillonnage de 16 bits. Calculez la taille du fichier en kibioctets (KiB).
La compression 压缩 rend un fichier plus petit. Un fichier plus petit :
occupe moins d'espace de stockage,
nécessite moins de bande passante 带宽 (la quantité de données qu'une connexion peut transporter),
prend moins de temps à envoyer (un temps de transmission 传输 plus court)。
Il existe deux types.
Compression sans perte
Sans perte 无损 compression rend le fichier plus petit avec aucune perte permanente de données. Le fichier original peut être reconstruit exactement.
Une méthode est le codage par longueur de série 行程编码 (RLE). Il remplace une suite de valeurs répétées par une copie unique de la valeur suivie d'un compteur indiquant combien de fois elle se répète. Par exemple, WWWWWWWW (8 blancs) est stocké sous la forme « 8 W ». Cela fonctionne bien lorsque les données comportent de nombreuses répétitions。
Le codage par longueur de série stocke chaque séquence une seule fois sous forme de compteur et de valeur
Compression avec perte
Avec perte 有损 compression réduit considérablement la taille du fichier en supprimant définitivement certaines données. Les données supprimées ne peuvent pas être récupérées. Par exemple :
réduction de la résolution ou de la profondeur de couleur d'une image,
réduction du taux d'échantillonnage ou de la résolution d'échantillonnage d'un son。
Utilisez une compression sans perte lorsque vous devez conserver chaque détail (fichiers texte et programmes). Utilisez une compression avec perte pour les photos, la musique et la vidéo, où une petite perte de qualité est acceptable pour obtenir un fichier beaucoup plus petit。
Explorer
Encodage par suites
Observez les symboles répétés être compressés en un compte — une compression sans perte simple.
Convertir décimal → binaire en soustrayant les valeurs de position (128, 64, 32…) ; binaire → décimal en additionnant les valeurs de position correspondant aux 1。
Pour convertir en hexadécimal, regroupez le binaire en nibbles de 4 bits à partir de la droite ; chaque nibble correspond exactement à un chiffre hexadécimal。
Overflow se produit lorsqu'un résultat nécessite plus de bits que le registre n'en possède (un registre de 8 bits ne contient que 0–255), donc le bit supplémentaire est perdu。
Taille de fichier en bits : pour une image, largeur × hauteur × profondeur de couleur ; pour un son, taux d'échantillonnage × résolution × secondes. Divisez par 8 pour obtenir des octets, puis par 1024 pour chaque unité supérieure。
Sans perte compression conserve chaque bit (texte ; codage par longueur de série) ; avec perte supprime définitivement les données (photos, musique) pour un fichier beaucoup plus petit。
La transmission de données 数据传输 signifie déplacer des données d'un endroit à un autre — par exemple de votre ordinateur vers un site web, ou d'un téléphone vers une imprimante。
Les données voyagent souvent le long d'un câble. Deux types courants sont illustrés ci-dessous。
Un câble Ethernet avec connecteur RJ45, souvent utilisé pour transmettre des données sur un réseau câbléUn câble à fibre optique transporte des données sous forme d'impulsions lumineuses le long de fines fibres de verre
Avant d'être envoyées, les données sont découpées en petites pièces de taille égale appelées paquets 数据包. Chaque paquet voyage séparément et ils sont reconstitués à l'autre extrémité。
L'utilisation de paquets présente des avantages :
si un paquet est perdu ou endommagé, seul ce paquet est renvoyé, et non tout le fichier ;
les paquets peuvent emprunter des routes différentes, évitant ainsi les routes congestionnées ou défaillantes ;
de nombreux utilisateurs peuvent partager la même connexion simultanément。
2.1
Structure d'un paquet
Programme
Les candidats doivent être capables de :
Notes et orientations
1 (a) Comprendre que les données sont découpées en paquets pour être transmises
(b) Décrire la structure d'un paquet
• Un paquet de données contient un : – en-tête de paquet – corps du paquet – fin de paquet • L'en-tête du paquet comprend les : – adresse de destination – numéro de paquet – adresse de l'expéditeur
(c) Décrire le processus de commutation de paquets
• Les données sont découpées en paquets • Chaque paquet peut prendre un itinéraire différent • Un routeur contrôle l'itinéraire d'un paquet • Les paquets peuvent arriver hors ordre • Une fois le dernier paquet arrivé, les paquets sont réordonnés
2 (a) Décrire comment les données sont transmises d'un appareil à un autre en utilisant différentes méthodes de transmission de données
(b) Expliquer l'adaptabilité de chaque méthode de transmission de données pour un scénario donné
• Incluant les avantages et inconvénients de chaque méthode
3 Comprendre l'interface bus série universel (USB) et expliquer comment elle est utilisée pour transmettre des données
• Incluant les avantages et inconvénients de l'interface
Source : Programme Cambridge International
Chaque paquet comporte trois parties.
Un paquet possède un en-tête, une charge utile (les données) et une fin de trame ; l'en-tête contient les adresses et le numéro du paquet
Partie
Ce qu'il contient
en-tête de paquet 包头
informations de contrôle (voir ci-dessous)
charge utile 有效载荷
les données réelles transportées
fin de trame 尾部
indique où se termine le paquet, ainsi qu'un contrôle d'erreur
L'en-tête de paquet contient :
l'adresse IP de l'expéditeur 地址 (d'où vient le paquet),
l'adresse IP du destinataire (où il va),
le numéro de paquet (pour que les paquets puissent être remis dans le bon ordre).
2.1
Commutation par paquets
La commutation par paquets 数据包交换 est la méthode permettant d'envoyer des paquets sur un réseau.
Les routeurs transmettent les paquets, et différents paquets peuvent emprunter des chemins différents vers le même destinataire
Des appareils spéciaux appelés routeurs 路由器 lisent l'en-tête de chaque paquet et choisissent le meilleur itinéraire pour celui-ci.
Chaque paquet peut suivre son propre chemin, donc les paquets peuvent voyager différemment.
Les paquets peuvent arriver hors ordre.
Une fois le dernier paquet arrivé, les paquets sont remis en ordre grâce à leurs numéros de paquet.
Explorer
Comment les données circulent sous forme de paquets
Suivez le commutation de paquets. Diviser un fichier en paquets adressés explique pourquoi la perte d'un seul paquet nécessite seulement sa retransmission, et pourquoi plusieurs utilisateurs peuvent partager la même ligne.
les bits peuvent arriver à des moments légèrement différents sur de longs fils
Série envoie un bit après l'autre sur un seul fil. Parallèle envoie plusieurs bits en même temps sur plusieurs fils, ce qui est plus rapide sur de courtes distances.
Série envoie un bit à la fois sur un fil ; parallèle envoie plusieurs bits simultanément sur plusieurs fils
Simplex, demi-duplex et full-duplex
Ces termes décrivent la direction dans laquelle les données peuvent circuler.
Simplex est un sens uniquement ; demi-duplex est deux sens mais un à la fois ; full-duplex est deux sens simultanément
Méthode
Direction
simplex 单工
un seul sens (ex. ordinateur → imprimante)
demi-duplex 半双工
deux sens, mais un à la fois (ex. talkie-walkie)
full-duplex 全双工
deux sens en même temps (ex. appel téléphonique)
Choisir une méthode
Le choix dépend de la distance, de la vitesse requise, du coût, et si les données doivent circuler dans les deux sens simultanément.
1 Comprendre la nécessité de vérifier les erreurs après la transmission de données et comment ces erreurs peuvent survenir
• Des erreurs peuvent survenir lors de la transmission de données en raison d'interférences, par exemple : perte de données, gain de données et modification de données
2 Décrire les processus impliqués dans chacune des méthodes de détection d'erreurs suivantes pour détecter des erreurs dans les données après la transmission : contrôle de parité (impair et pair), somme de contrôle et contrôle par écho
• Incluant le contrôle par byte de parité et bloc de parité
3 Décrire comment un chiffre de contrôle est utilisé pour détecter des erreurs de saisie de données et identifier des exemples où un chiffre de contrôle est utilisé, y compris les numéros de livre normalisés internationaux (ISBN) et les codes-barres
4 Décrire comment une requête de répétition automatique (ARQ) peut être utilisée pour établir que les données sont reçues sans erreur
• Incluant l'utilisation de : – accusés de réception positifs/négatifs – temporisation (timeout)
Source : Programme Cambridge International
Pendant le transit des données, des interférences 干扰 peuvent les modifier. Trois choses peuvent mal tourner :
perte de données — certains bits n'arrivent pas;
gain de données — des bits supplémentaires sont ajoutés;
modification de données — certains bits sont inversés.
Ainsi, le destinataire vérifie si les données sont arrivées correctement.
Un contrôle de parité 奇偶校验 ajoute un bit supplémentaire, le bit de parité 奇偶校验位, à chaque octet. Il existe deux types :
Un bit de parité est ajouté pour rendre le nombre de 1 pair (ou impair)
parité paire — le nombre total de 1 dans l'octet (y compris le bit de parité) doit être paire;
parité impaire — le nombre total de 1 doit être impaire.
Exemple (parité paire) : les données 1011001 ont quatre 1, qui sont déjà pairs, donc le bit de parité est 0 :
parity bit + data
    0        1011001
Pour trouver une erreur : le destinataire compte les 1. Si la parité paire a été convenue mais qu'un octet arrive avec un nombre impair de 1, une erreur s'est produite lors de la transmission.
Un contrôle de parité ne peut pas détecter toutes les erreurs. Si deux bits s'inversent, le comptage peut sembler correct.
Exemple résolu. Un bit de parité unique vous dit qu'une erreur s'est produite, mais pas où. Un bloc de parité 奇偶校验块 peut localiser le bit exact. Plusieurs octets sont envoyés ensemble, chacun avec un bit de parité de ligne, et un octet de parité supplémentaire octet de parité 奇偶校验字节 en bas contient un bit de parité pour chaque colonne. La parité paire est utilisée ci-dessous, et un bit a été inversé lors de la transmission. Trouvez-le.
La ligne byte 3 brise la parité paire, et la colonne b3 brise la parité paire. Le bit inversé se trouve à leur intersection : byte 3, bit b3. Le changer de 1 à 0 répare les données. Un bit de parité unique indique seulement qu'une erreur s'est produite ; un bloc de parité indique exactement où, permettant au destinataire même de la corriger.
Somme de contrôle
Une somme de contrôle 校验和 est une valeur calculée à partir de toutes les données avant l'envoi. Le destinataire recalculer la somme de contrôle à partir des données reçues. Si les deux valeurs ne correspondent pas, une erreur s'est produite et les données sont renvoyées.
Contrôle par écho
Dans un contrôle par écho 回送校验, le destinataire renvoie les données à l'expéditeur. L'expéditeur les compare avec l'original. Si elles diffèrent, une erreur s'est produite. (Cela nécessite d'envoyer les données deux fois, donc c'est lent.)
Demande de répétition automatique (ARQ)
La demande de répétition automatique 自动重传请求 (ARQ) utilise des messages appelés accusés de réception 确认.
Le destinataire envoie un accusé de réception positif si un paquet est arrivé correctement, ou un accusé de réception négatif sinon.
L'expéditeur démarre un minuteur de délai d'attente 超时. Si aucun accusé de réception positif ne revient à temps, l'expéditeur renvoie le paquet.
Chiffre de contrôle
Un chiffre de contrôle 校验码 est un chiffre supplémentaire placé à la fin d'un nombre, calculé à partir des autres chiffres. Il sert à détecter les erreurs lors de la saisie manuelle d'un nombre.
Lorsque le nombre est saisi, le chiffre de contrôle est recalculé et comparé. Il peut détecter :
non chiffre incorrect saisi,
une erreur de transposition 换位错误 (deux chiffres échangés, ex. 21 tapé comme 12),
un chiffre oublié ou un chiffre supplémentaire ajouté,
une erreur phonétique (un chiffre sonnant similaire, ex. 13 et 30).
Les chiffres de contrôle sont utilisés dans les codes-barres 条形码 et les ISBN (numéros de livre).
Explorer
Laboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
1 Comprendre la nécessité et le but de la cryptographie lors de la transmission de données
2 Comprendre comment les données sont chiffrées en utilisant la cryptographie symétrique et asymétrique
• La cryptographie asymétrique inclut l'utilisation de clés publiques et privées
Source : Programme Cambridge International
Pourquoi nous avons besoin de cryptographie
La cryptographie 加密 brouille les données afin qu'elles ne puissent pas être comprises si elles sont interceptées 拦截 (capturées) par la mauvaise personne. Les données lisibles sont appelées texte en clair 明文 ; après cryptographie, elles deviennent texte chiffré 密文.
La cryptographie ne stoppe pas les données d'être interceptées. Elle empêche seulement leur compréhension.
Chiffrement symétrique
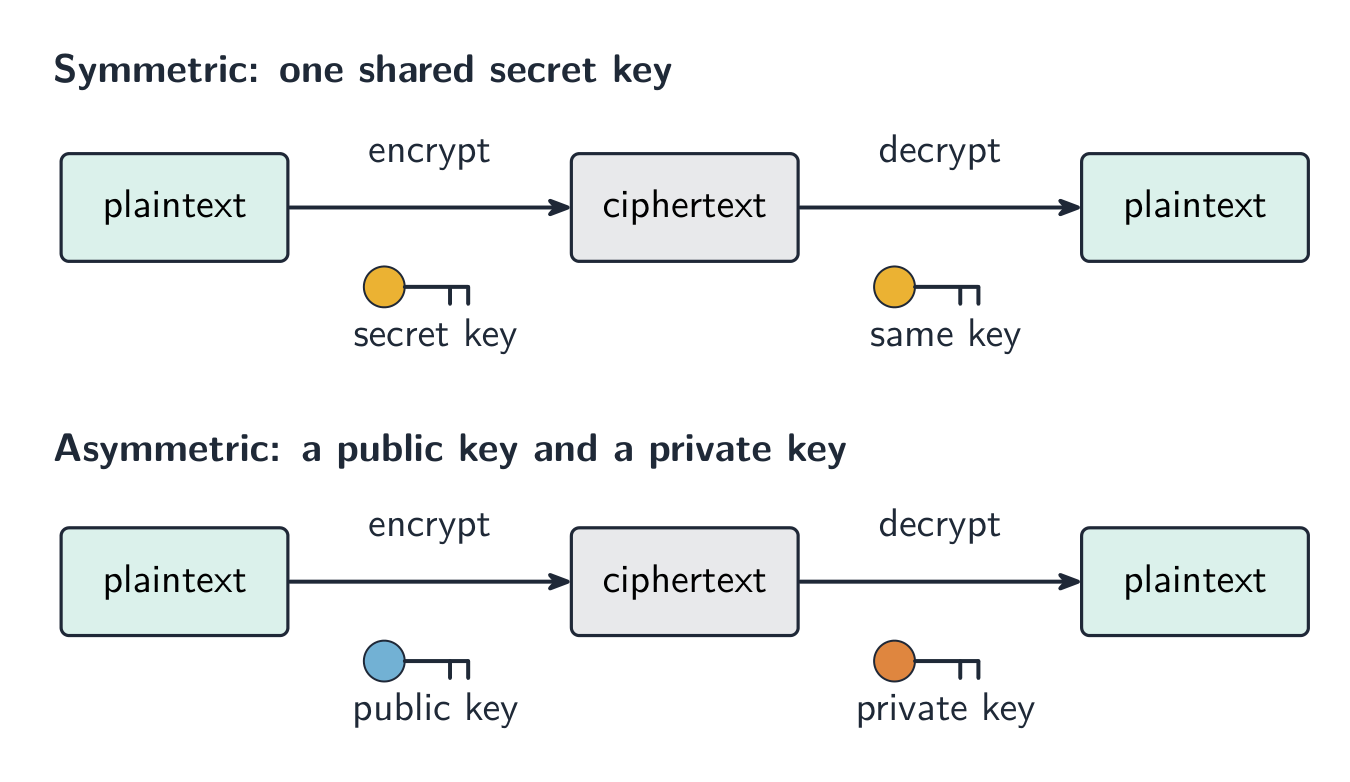
La cryptographie symétrique 对称加密 utilise une seule clé 密钥 pour chiffrer et déchiffrer les données. L'expéditeur et le destinataire doivent partager cette même clé secrète. Le risque est que la clé elle-même puisse être volée pendant le partage.
Cryptographie asymétrique
La cryptographie asymétrique 非对称加密 utilise deux clés différentes :
une clé publique 公钥 que tout le monde peut avoir, utilisée pour chiffrer;
une clé privée 私钥 gardée secrète, utilisée pour déchiffrer.
Les données chiffrées avec la clé publique ne peuvent être déchiffrées qu'avec la clé privée correspondante, donc la clé n'a jamais besoin d'être partagée. C'est plus sûr que de partager une seule clé secrète.
Le chiffrement symétrique utilise une clé partagée ; le chiffrement asymétrique utilise une clé publique pour chiffrer et une clé privée pour décrypter
Explorer
Le chiffrement de César
Décalez chaque lettre pour chiffrer un message — l'idée la plus simple d'un chiffrement et sa clé.
Les données sont envoyées sous forme de paquets (un en-tête avec les adresses et le numéro de paquet, une charge utile et une fin de trame). Les paquets peuvent emprunter des chemins différents et arriver hors ordre, puis être remis en ordre selon leurs numéros de paquet.
Associez les types de transmission : série (un bit à la fois, efficace sur de longues distances) vs parallèle (plusieurs bits simultanément, courtes distances) ; simplex / demi-duplex / full-duplex décrivent la direction.
Un bit de parité unique indique seulement qu'une erreur s'est produite ; un bloc de parité localise le bit erroné exact — la ligne et la colonne qui échouent toutes deux.
Apprenez les méthodes de détection d'erreurs et ce que chacune fait : contrôle de parité, somme de contrôle, contrôle par écho, ARQ et le chiffre de contrôle (pour les nombres saisis manuellement).
Symétrique utilise une clé partagée ; asymétrique utilise une clé publique pour chiffrer et une clé privée pour déchiffrer, donc aucune clé secrète n'est jamais partagée.
1 (a) Comprendre le rôle de l'unité centrale de traitement (CPU) dans un ordinateur
• L'unité centrale de traitement traite les instructions et les données saisies dans l'ordinateur afin que le résultat puisse être affiché
(b) Comprendre ce qu'est un microprocesseur
• Un microprocesseur est un type de circuit intégré sur une seule puce
2 (a) Comprendre la fonction des composants dans une unité centrale de traitement, dans un ordinateur ayant une architecture de Von Neumann
• Incluant : – unités : unité arithmétique et logique (UAL) et unité de contrôle (UC) – registres : compteur de programme (PC), registre d'adresse mémoire (MAR), registre de données mémoire (MDR), registre d'instruction courant (CIR) et accumulateur (ACC) – bus : bus d'adresses, bus de données et bus de contrôle
(b) Décrire le processus du cycle prélever-décoder-exécuter (PDE), y compris le rôle de chaque composant dans le processus
• Comment les instructions et les données sont prélevées de la mémoire vive (RAM) vers l'unité centrale de traitement, comment elles sont traitées en utilisant chaque composant et comment elles sont ensuite exécutées • Stockage de données et d'adresses dans des registres spécifiques • Utilisation de bus pour transmettre des données, des adresses et des signaux • Utilisation d'unités pour prélever, décoder et exécuter des données et des instructions
3 Comprendre ce qu'est un cœur, un cache et une horloge dans une unité centrale de traitement et expliquer comment ils peuvent affecter les performances de l'unité centrale de traitement
• Le nombre de cœurs, la taille du cache et la vitesse de l'horloge peuvent affecter les performances de l'unité centrale de traitement
4 Comprendre la fonction et l'utilisation d'un jeu d'instructions pour une unité centrale de traitement
• Un jeu d'instructions est une liste de toutes les commandes pouvant être traitées par une unité centrale de traitement, et les commandes sont du code machine
5 Décrire la fonction et les caractéristiques d'un système embarqué et identifier les appareils dans lesquels ils sont couramment utilisés
• Un système embarqué est utilisé pour effectuer des fonctions dédiées. Par exemple, dans les électroménagers, les voitures, les systèmes de sécurité, les systèmes d'éclairage ou les distributeurs automatiques. Cela diffère d'un ordinateur à usage général utilisé pour effectuer de nombreuses fonctions différentes. Par exemple, un ordinateur personnel (PC) ou un ordinateur portable
Source : Programme Cambridge International
Le cycle fetch-décodage-exécution
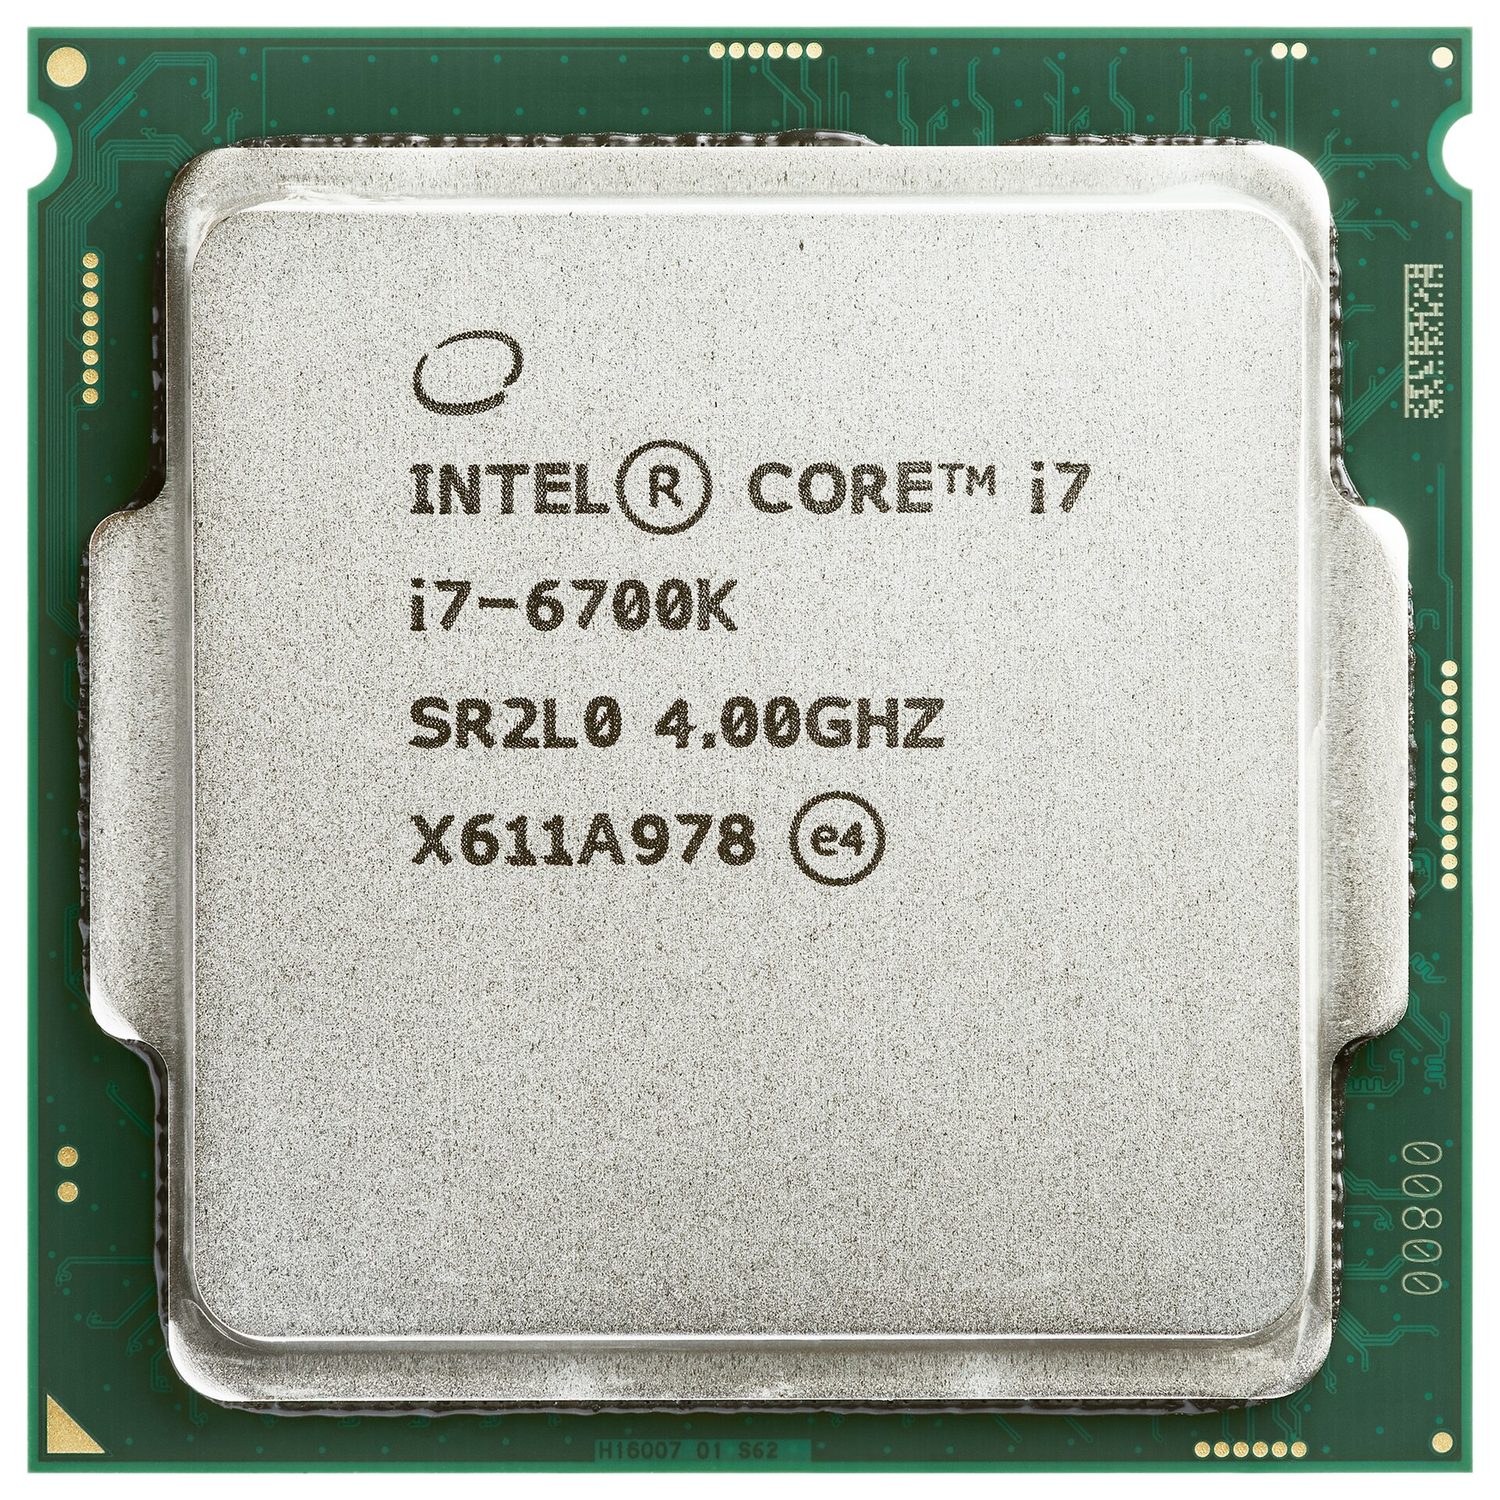
L'unité centrale de traitement 中央处理器 (CPU) est la partie de l'ordinateur qui traite les données et exécute des instructions 指令. Il exécute des programmes en répétant un cycle, des millions de fois par seconde.
Un processeur central (CPU) : la puce qui traite les données et exécute les instructions
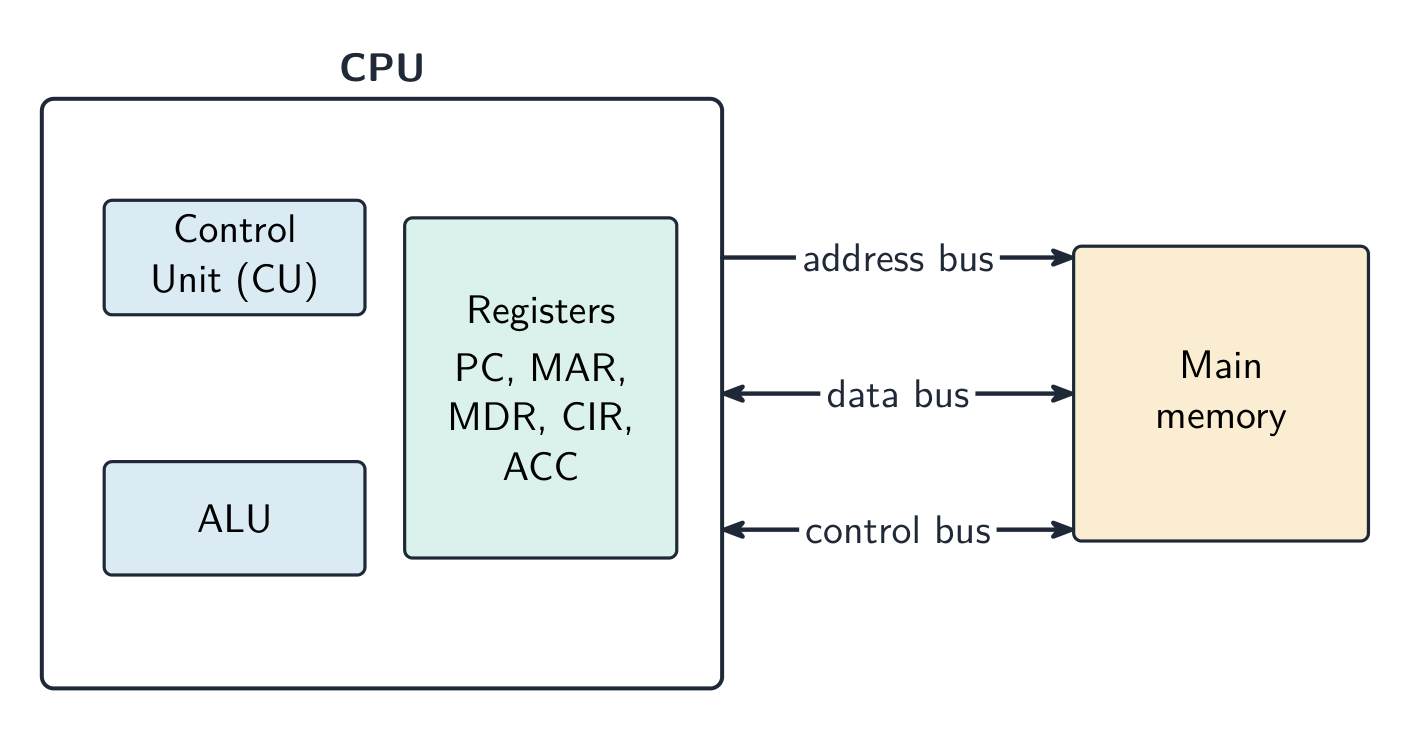
Composants du CPU
Composant
Rôle
unité arithmétique et logique 算术逻辑单元 (ALU)
effectue les calculs (addition, soustraction) et les opérations logiques (comparaison)
unité de contrôle 控制单元 (CU)
envoie des signaux de contrôle pour gérer toutes les parties et leur indiquer ce qu'elles doivent faire
registres 寄存器
mémoires très petites et très rapides qui stockent une seule donnée à la fois
Les composants sont reliés par des bus 总线 — des ensembles de fils qui transportent l'information :
le bus d'adresse 地址总线 transporte les adresses mémoire (un seul sens);
le bus de données 数据总线 transporte les données et les instructions (les deux sens);
le bus de contrôle 控制总线 transporte les signaux de contrôle.
Le CPU contient l'unité de contrôle, l'ALU et les registres ; trois bus le relient à la mémoire principale
Registres spéciaux
Ces registres sont utilisés pendant le cycle fetch–execute (prélèvement-exécution).
Registre
Fonction
compteur de programme 程序计数器 (PC)
contient l'adresse de l'instruction suivante
registre d'adresse mémoire 内存地址寄存器 (MAR)
contient l'adresse à lire ou à écrire
registre de données mémoire 内存数据寄存器 (MDR)
contient la donnée ou l'instruction fraîchement prélevée
registre d'instruction courante 当前指令寄存器 (CIR)
contient l'instruction actuellement exécutée
accumulateur 累加器 (ACC)
contient le résultat des calculs de l'ALU
Le cycle fetch–execute
Le cycle fetch–execute 取指执行周期 comprend trois étapes, répétées sans cesse :
Fetch (prélèvement) — l'instruction est copiée depuis la mémoire 内存 vers le CPU (en utilisant le PC, le MAR et le MDR). Le PC augmente ensuite de 1.
Decode (décodeage) — l'unité de contrôle détermine la signification de l'instruction.
Execute (exécution) — l'instruction est exécutée (l'ALU peut effectuer un calcul, avec le résultat allant vers l'accumulateur).
Le processeur répète trois étapes : prélever l'instruction, la décoder, puis l'exécuter
Mémoire cache
La cache 高速缓存 est une petite quantité de mémoire très rapide située à l'intérieur ou à proximité du CPU. Elle stocke les données et les instructions fréquemment utilisées par le CPU. Le CPU peut lire dans la cache beaucoup plus vite que dans la mémoire principale, ce qui accélère le fonctionnement de l'ordinateur.
Facteurs influençant la performance du CPU
Caractéristique
Effet
nombre de cores 核心
chaque core peut exécuter des instructions indépendamment, donc plus de cores permettent de réaliser davantage de tâches simultanément
taille de la cache
une cache plus grande stocke plus de données prêtes pour le CPU, réduisant ainsi ses temps d'attente
vitesse d'horloge 时钟速度
nombre de cycles par seconde ; une vitesse d'horloge plus élevée permet d'exécuter plus d'instructions par seconde
Exemple résolu. Deux ordinateurs sont identiques, sauf que A possède un processeur mono-cœur de 3.0 GHz avec 2 Mo de cache, et B possède un processeur quadricœur de 2.4 GHz avec 8 Mo de cache. Lequel est le meilleur pour le montage vidéo, et pourquoi ? Le montage vidéo se divise en de nombreuses tâches qui peuvent s'exécuter simultanément ; ainsi, les quatre cœurs de B peuvent traiter plusieurs flux en parallèle, tandis que A ne peut en traiter qu'un à la fois. Le cache plus volumineux de B conserve également les données fréquemment utilisées près du CPU, ce qui réduit la fréquence des accès à la RAM. B est le meilleur choix, même si A dispose d'une fréquence d'horloge plus élevée. Ne vous fiez jamais uniquement à la fréquence d'horloge : pesez ensemble les cœurs, le cache et la fréquence d'horloge, et liez chacun d'eux à la tâche accomplie.
Systèmes embarqués
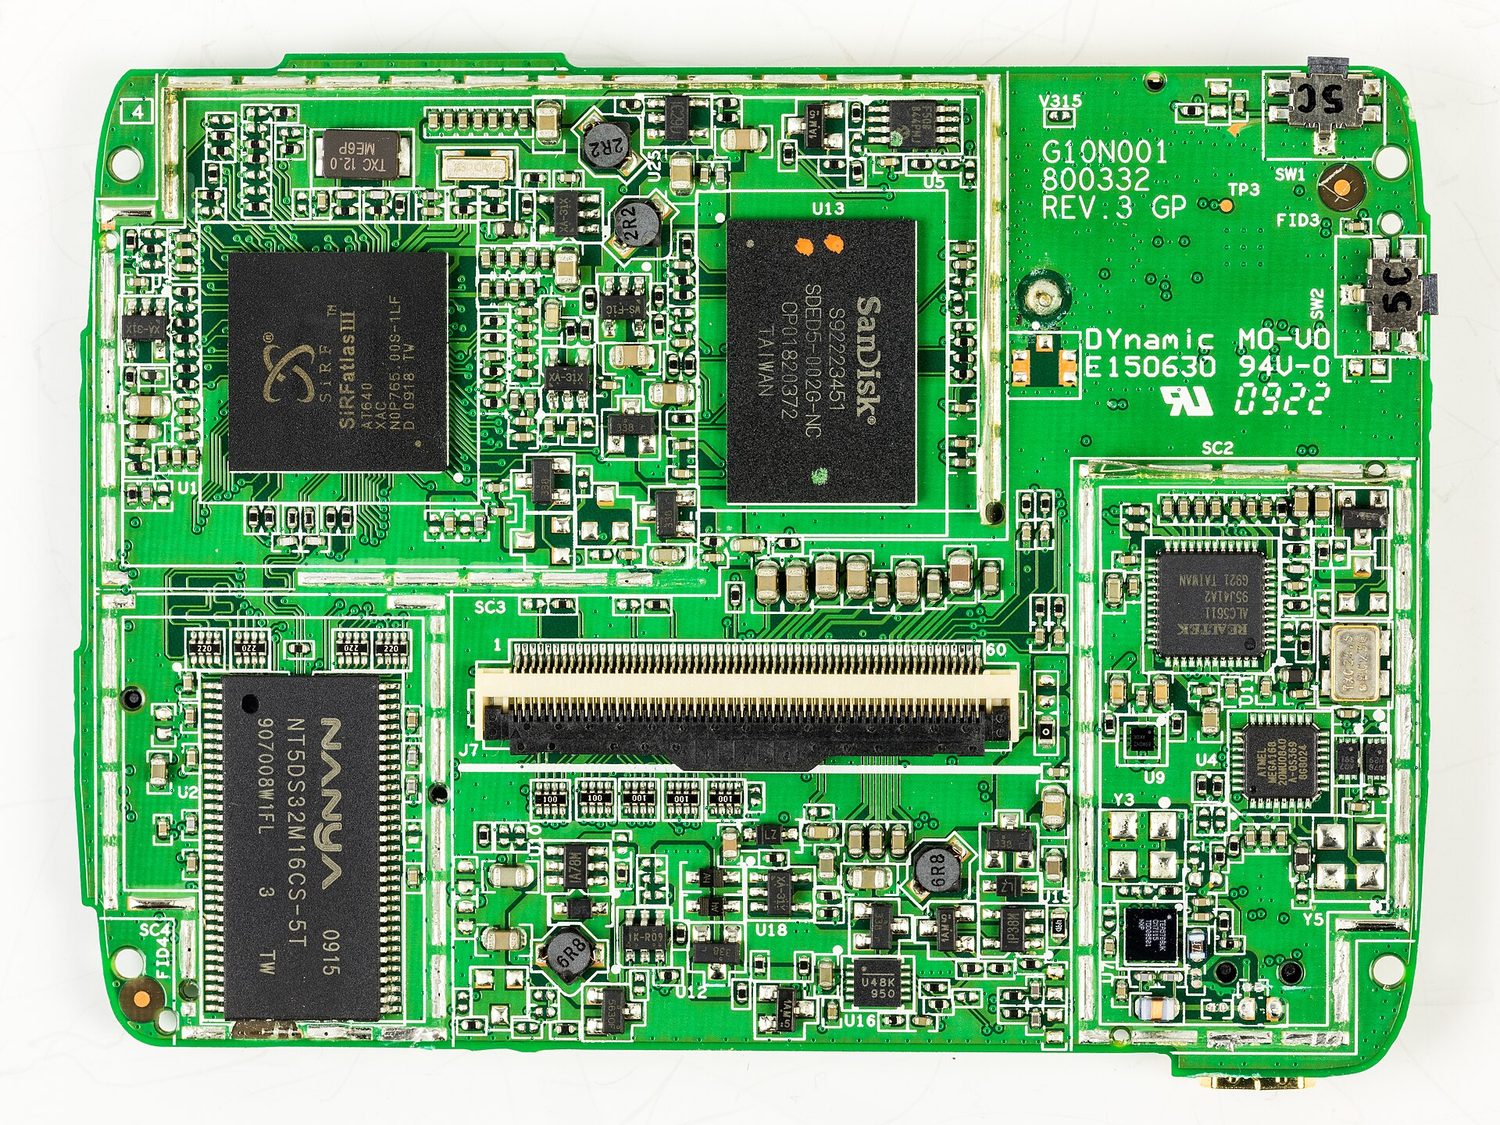
Un système embarqué 嵌入式系统 est un petit ordinateur intégré dans un appareil plus grand pour effectuer une tâche fixe unique. Il est dédié à cette tâche, est généralement compact et peu coûteux, et ne dispose pas de système d'exploitation généraliste. Exemples : une machine à laver, un micro-ondes, un décodeur TV.
La carte mère issue d'un GPS : un système embarqué est un petit ordinateur dédié comme celui-ci, intégré dans un appareil pour effectuer une tâche fixe unique
Explorer
Le cycle fetch-execute
Tournez autour de la boucle que le CPU répète des milliards de fois par seconde — chercher l'instruction, décoder sa signification, l'exécuter, puis tout recommencer.
(b) Identifier le type de données captées par chaque capteur et comprendre quand chaque capteur serait utilisé, y compris la sélection du capteur le plus adapté pour un contexte donné
Source : Programme Cambridge International
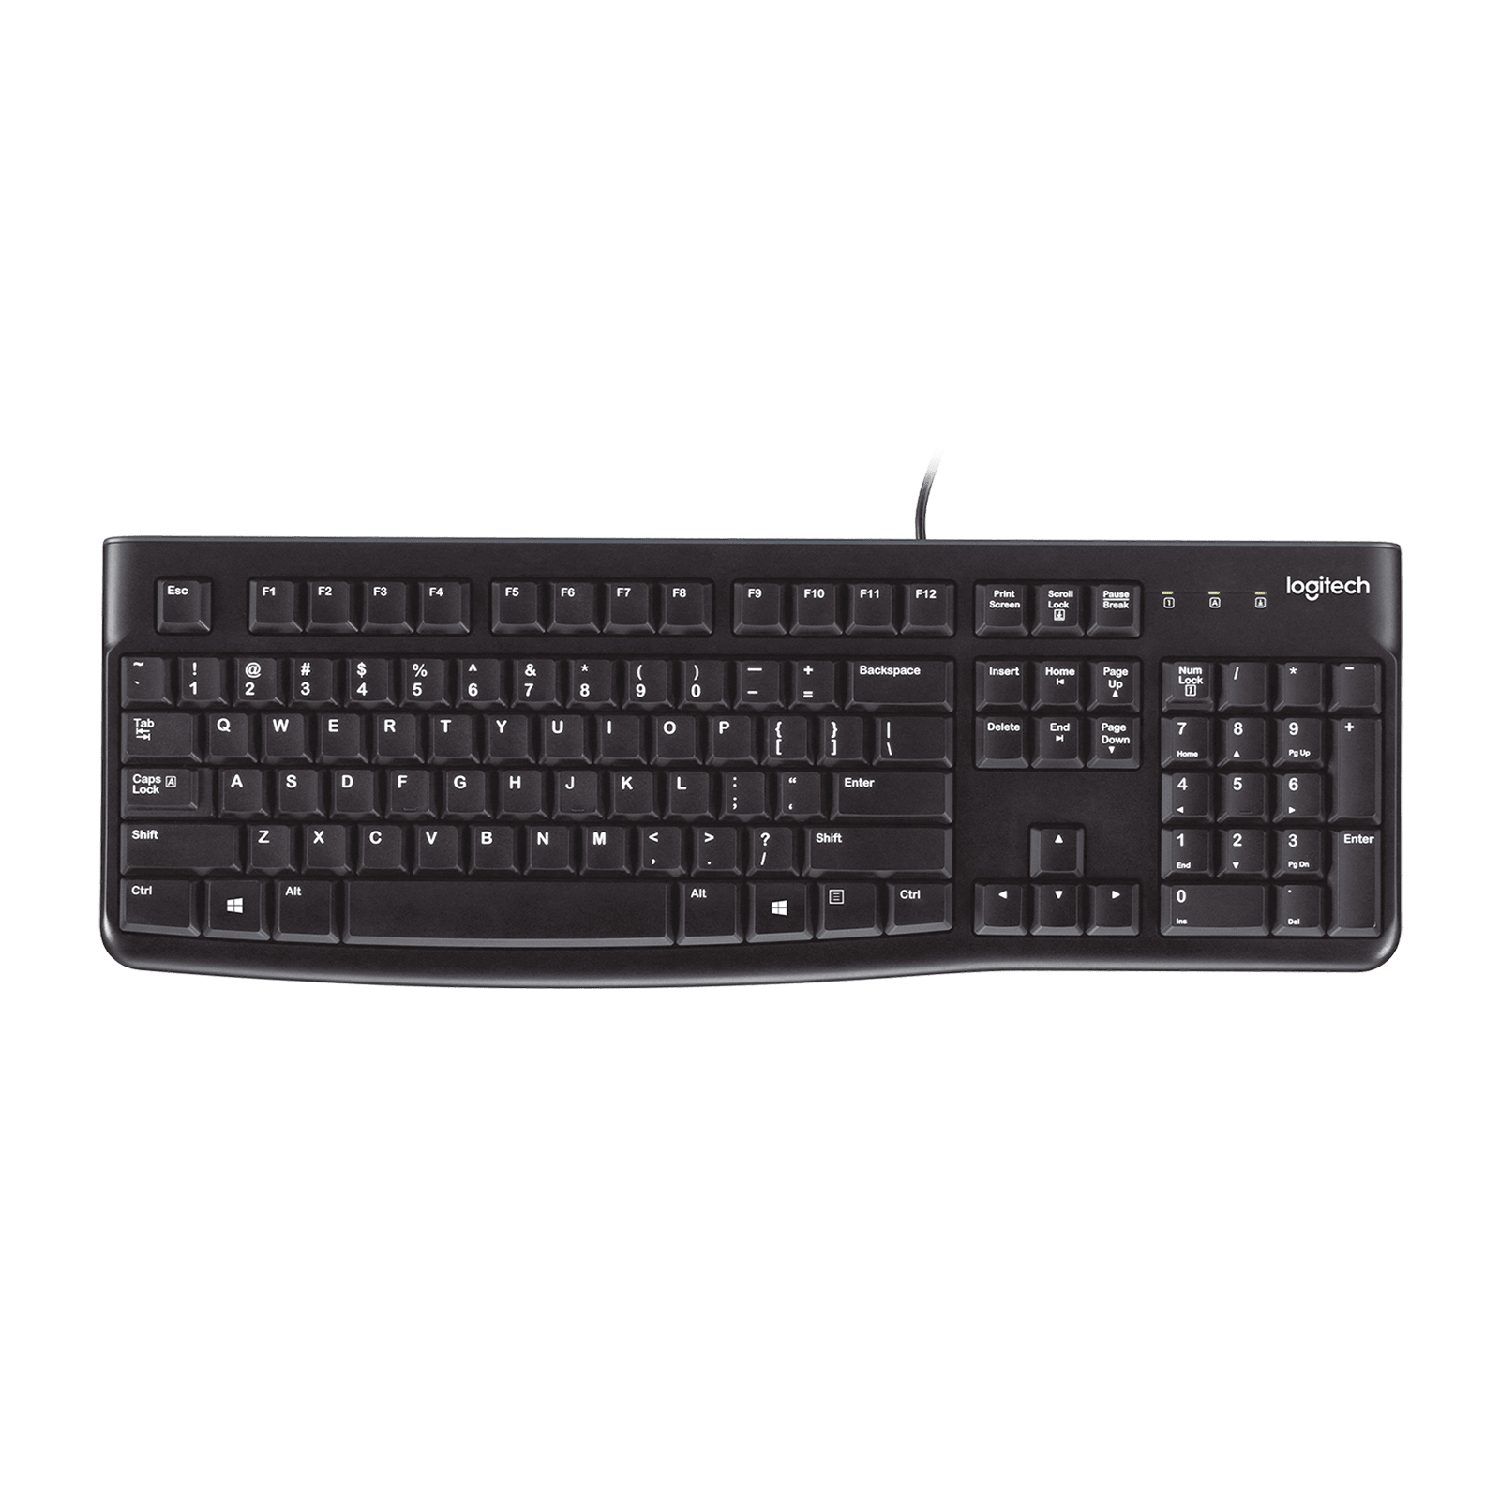
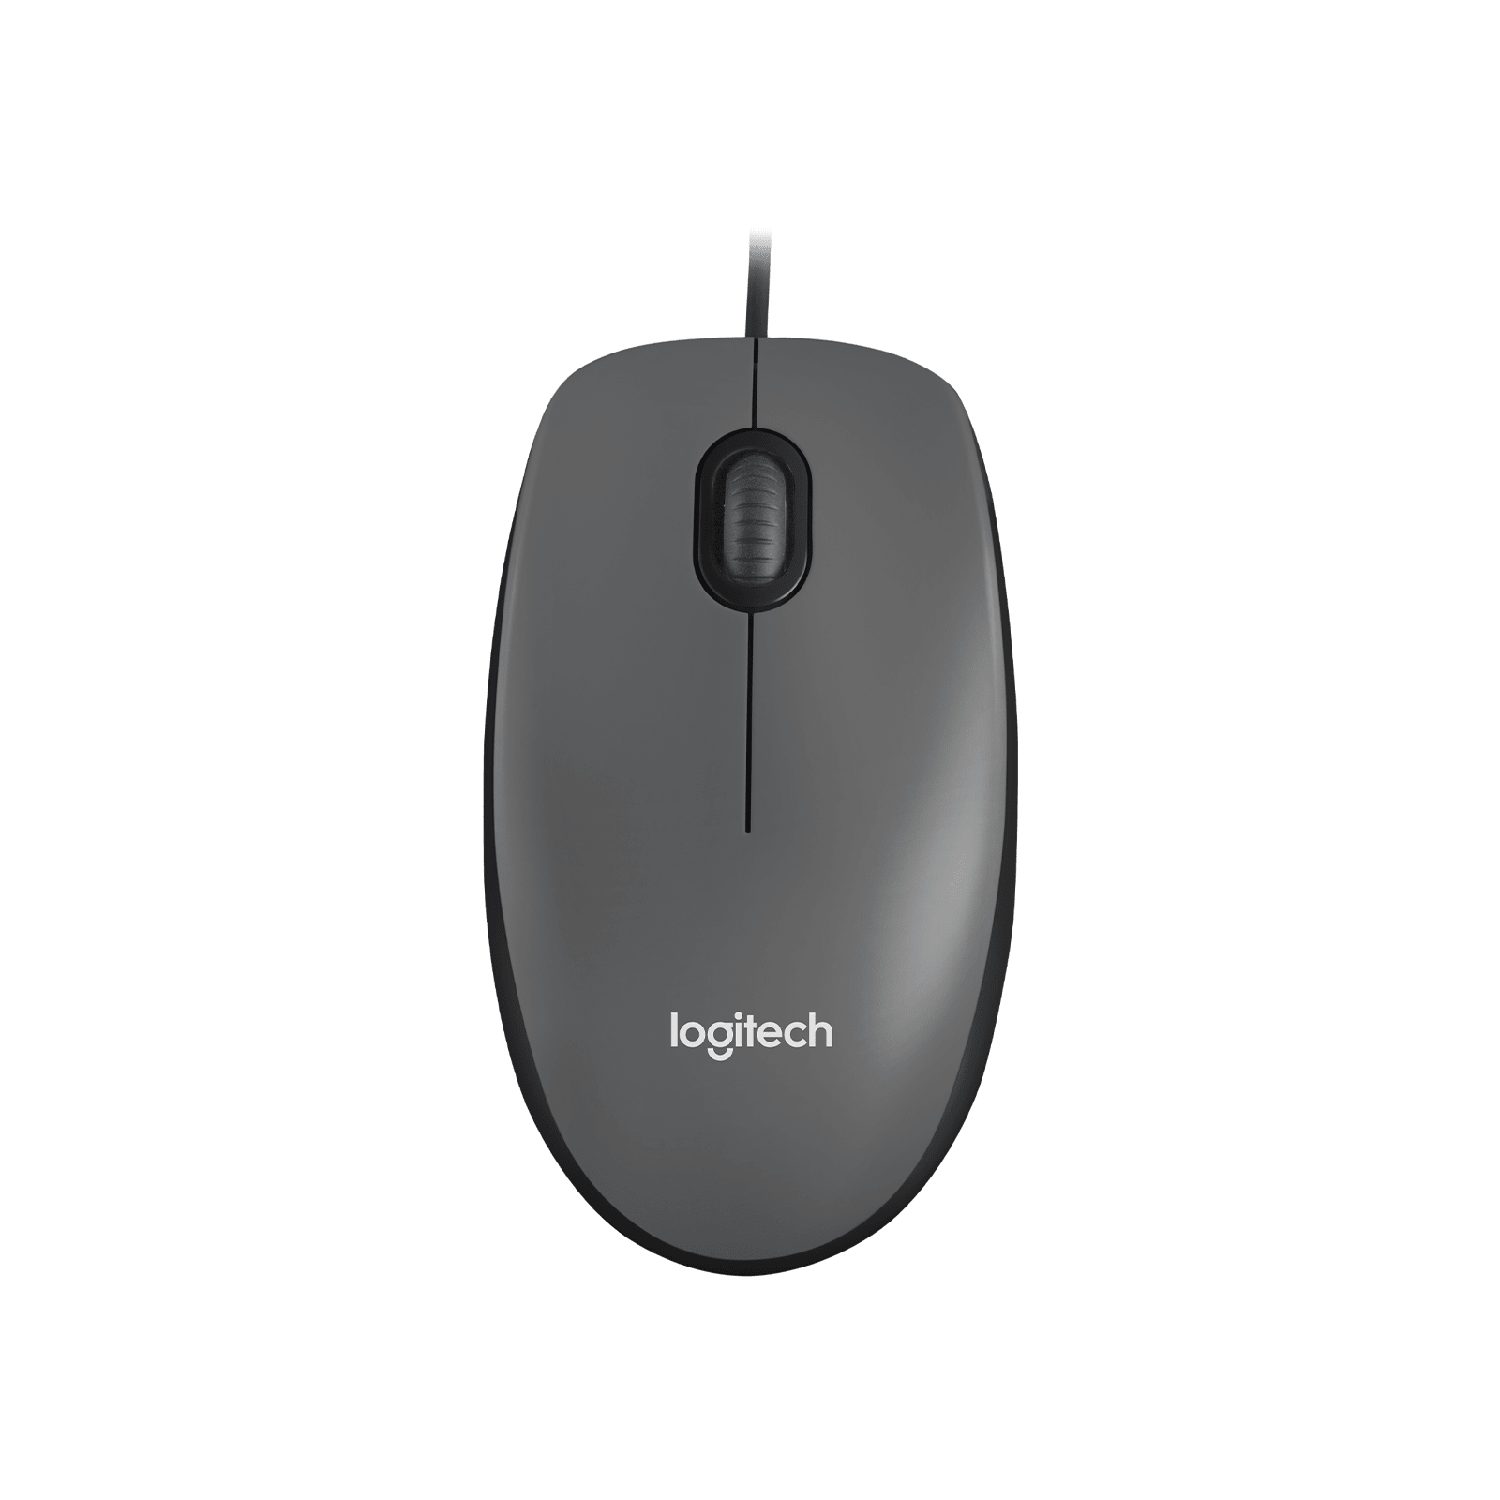
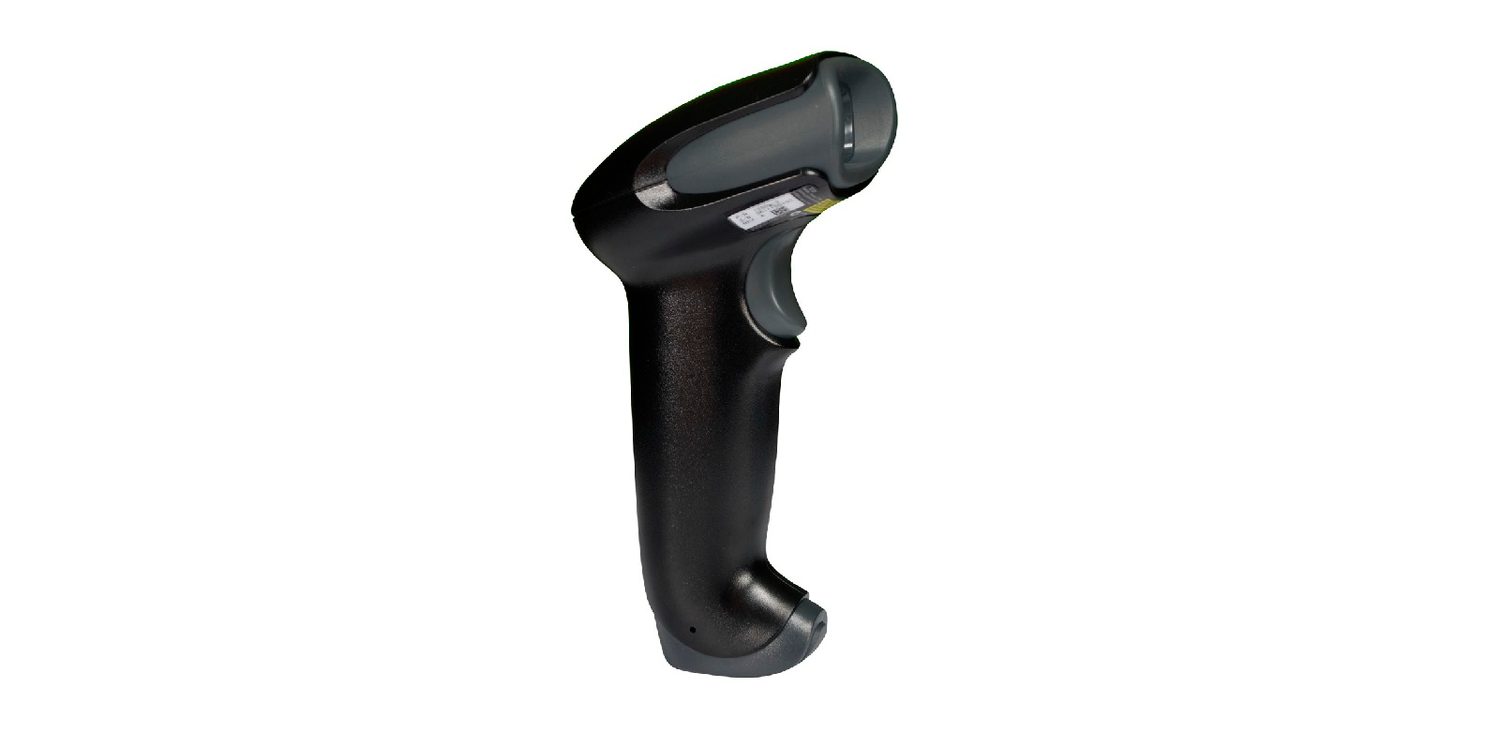
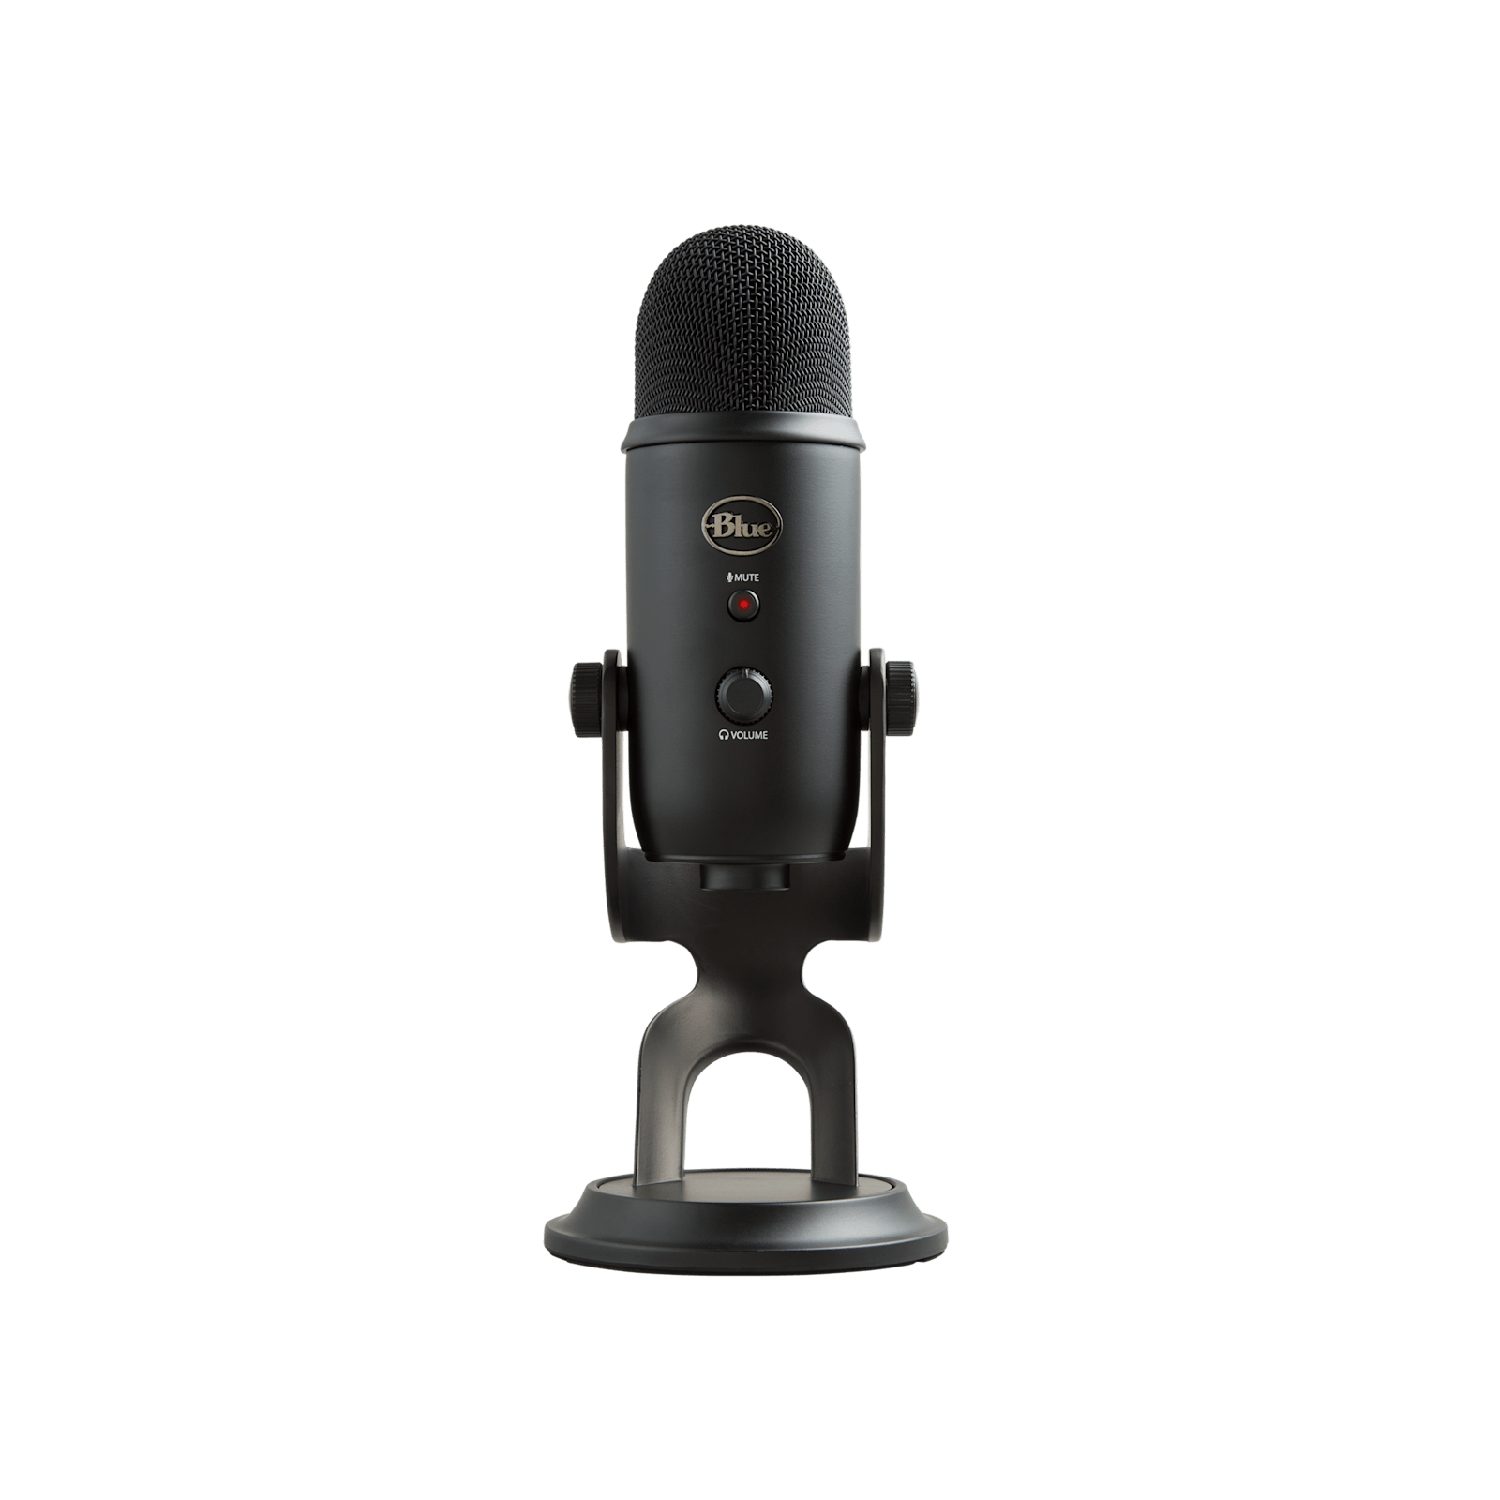
Un périphérique d'entrée envoie des données dans l'ordinateur.
Périphérique
Fonctionnement
lecteur de codes-barres 条形码扫描器
émet de la lumière sur les barres et lit le motif réfléchi
lecteur de QR codes 二维码扫描器
une caméra lit un motif carré de blocs noirs et blancs
clavier
l'appui sur une touche envoie le code correspondant au caractère
souris optique 光电鼠标
une lumière et un capteur suivent le mouvement sur une surface
microphone
convertit les ondes sonores en signal électrique
appareil photo numérique
un objectif focalise la lumière sur un capteur qui enregistre les pixels
capteurs 传感器
mesurent une grandeur physique (comme la température ou la lumière) et l'envoient sous forme de données
écran tactile 触摸屏
détecte l'endroit où votre doigt touche l'écran
Un clavier : chaque pression sur une touche envoie un code pour ce caractèreUn souris optique : une lumière et un capteur suivent son mouvement sur le bureauNumériseur plat : il projette de la lumière sur une page pour la copier dans l'ordinateurUn lecteur de codes-barres lit le motif de barres et l'envoie à l'ordinateurUn appareil photo numérique : un objectif focalise la lumière sur un capteur qui enregistre les pixelsUn microphone convertit les ondes sonores en signal électriqueUn capteur mesure une grandeur physique (ici, la température) et l'envoie sous forme de données
Un écran tactile peut fonctionner de trois manières :
résistif 电阻式 — deux couches sont pressées ensemble là où vous touchez;
capacitif 电容式 — il détecte la faible charge électrique de votre doigt;
infrarouge 红外线 — votre doigt brise une grille de faisceaux lumineux.
Un écran tactile détecte l'endroit où votre doigt le touche
Explorer
Dispositif et laboratoire de stockage
Classez les exemples informatiques selon leur rôle dans un système.
Un périphérique de sortie envoie des données hors de l'ordinateur vers l'utilisateur.
Périphérique
Fonctionnement
actionneur 执行器
convertit un signal électrique en mouvement (ex. : moteur ou vanne)
écran LCD/LED
affiche des images grâce à une grille de petits points colorés
projecteur 投影仪
projette une image agrandie sur un mur ou un écran
imprimante jet d'encre 喷墨打印机
pulvérise de fines gouttes d'encre sur le papier
imprimante laser 激光打印机
utilise un laser et de la poudre (toner) fixée sur le papier par la chaleur
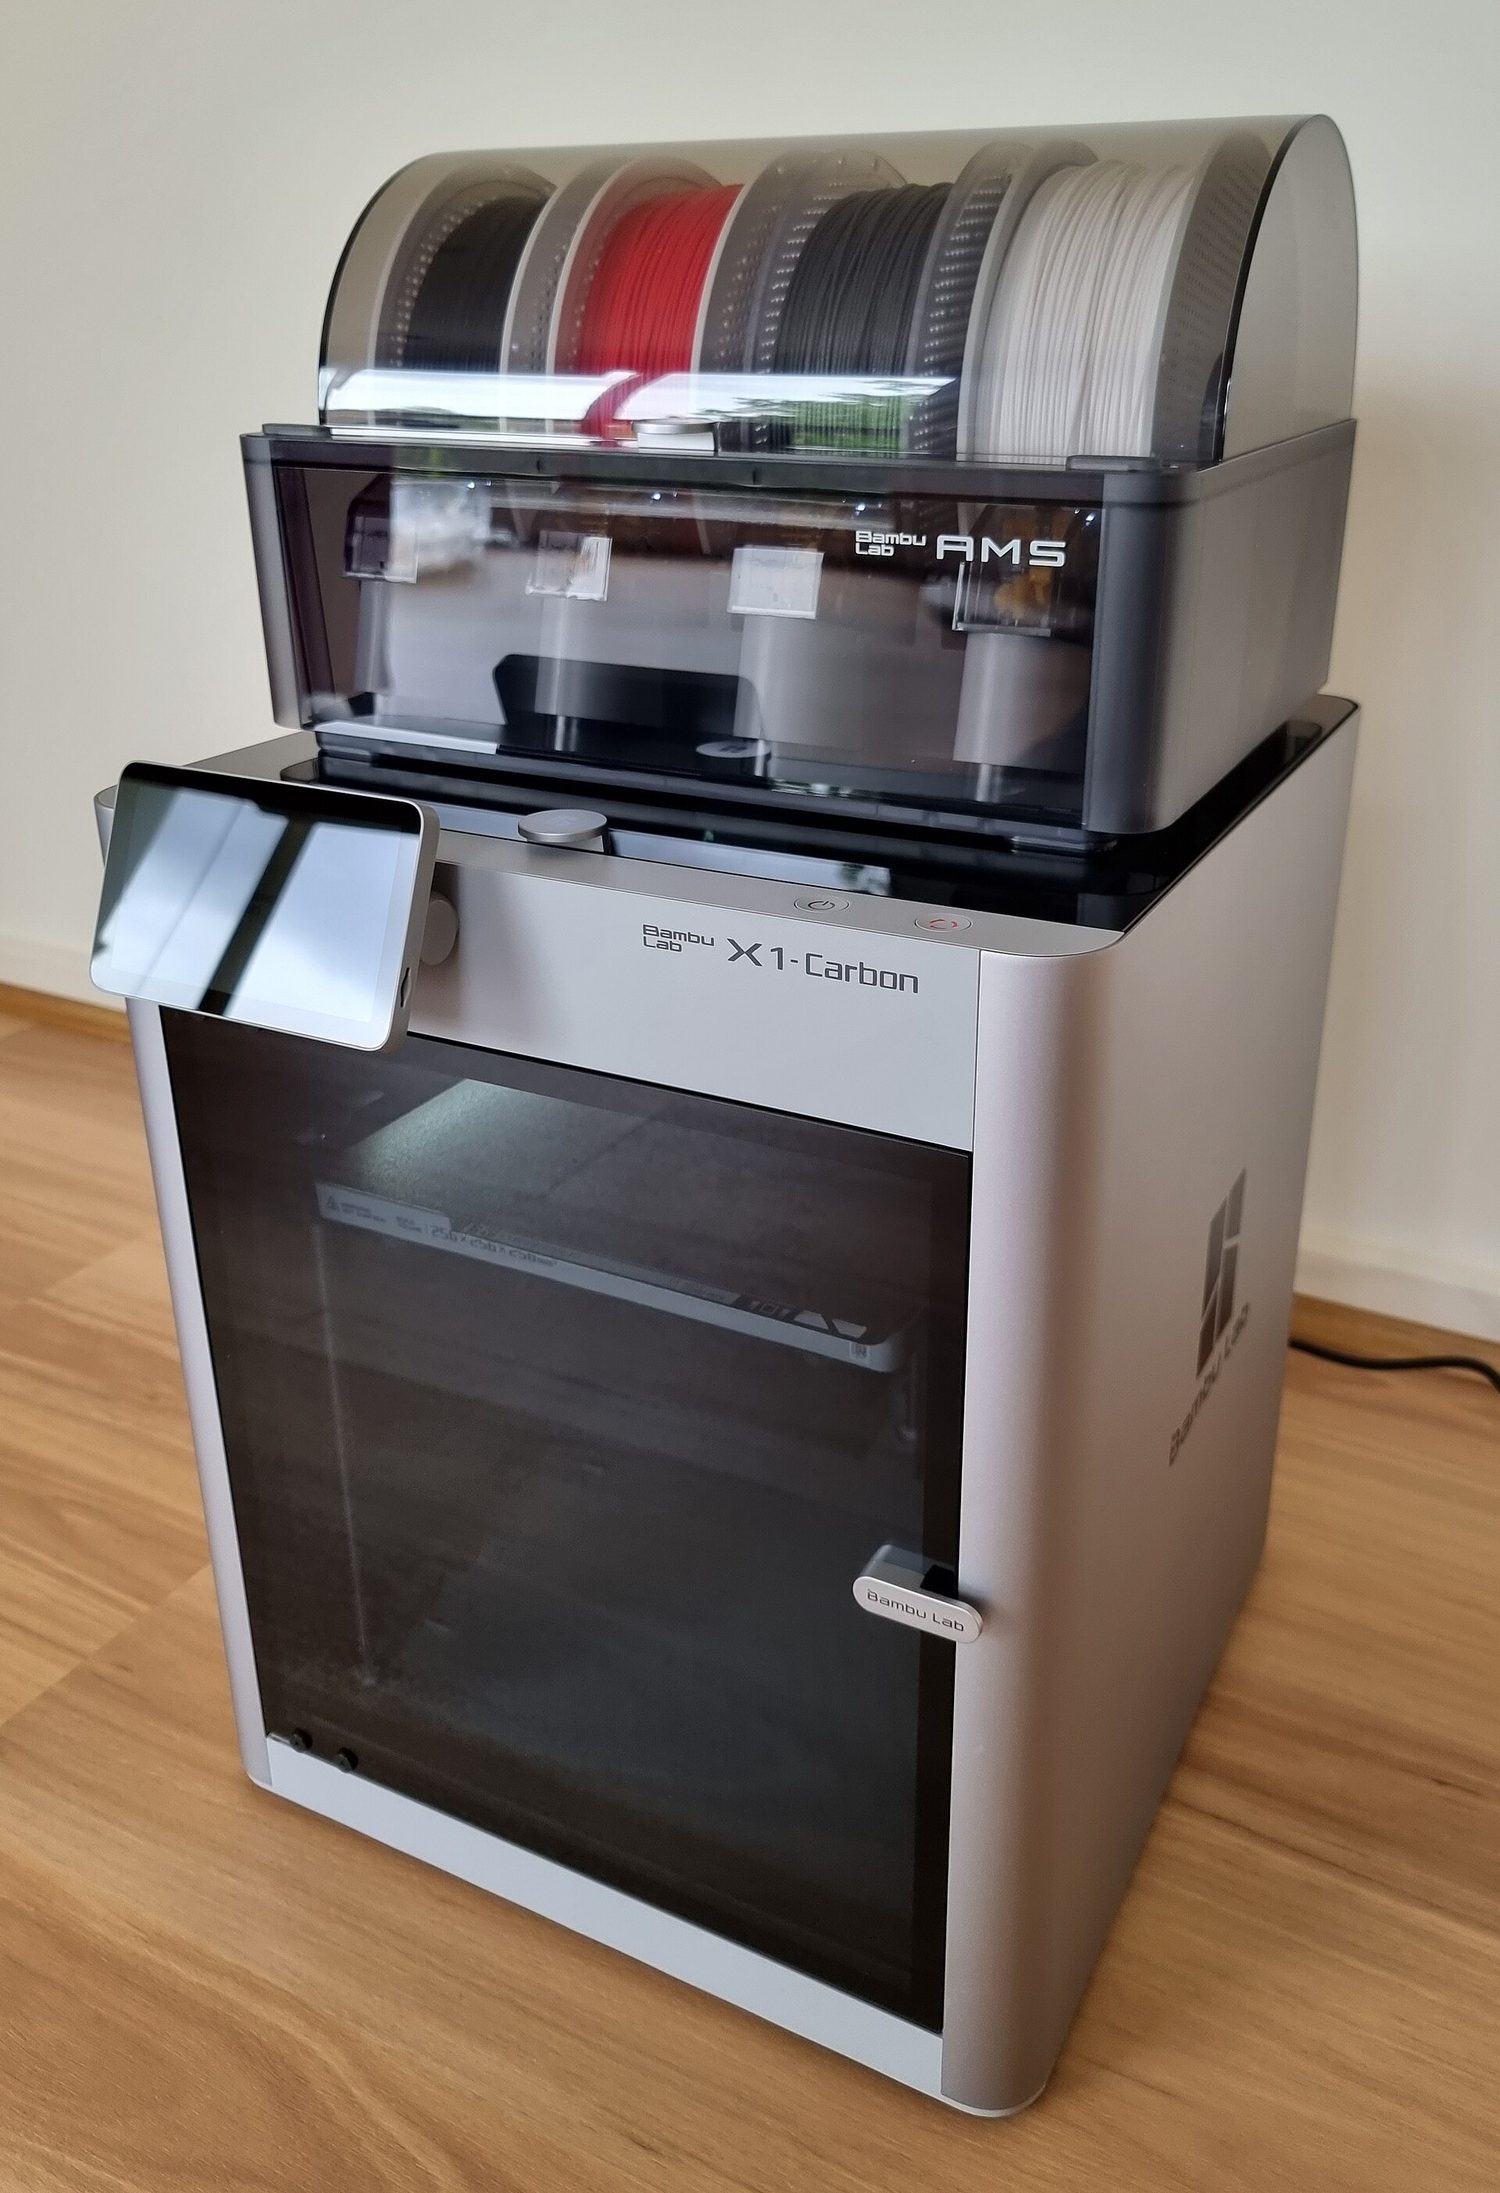
imprimante 3D
construit un objet solide couche par couche
haut-parleur 扬声器
convertit un signal électrique en son
Une imprimante jet d'encre pulvérise de minuscules gouttes d'encre sur le papierUne imprimante laser utilise un laser et de la poudre (toner) fixée sur le papier par la chaleurUne imprimante 3D construit un objet solide couche par coucheUn moniteur LCD/LED affiche des images grâce à une grille de petits points colorésUn haut-parleur convertit un signal électrique en sonDes écouteurs convertissent un signal électrique en son pour un seul auditeurUn actionneur tel qu'un moteur convertit un signal électrique en mouvement
• Le stockage primaire est directement accès par l'unité centrale de traitement • Incluant le rôle de : – mémoire vive (RAM) – mémoire morte (ROM) • Incluant pourquoi un ordinateur a besoin des deux RAM et ROM, et la différence entre eux
2 Comprendre ce qu'est le stockage secondaire
• Le stockage secondaire n'est pas directement accès par l'unité centrale de traitement et est nécessaire pour le stockage plus permanent des données
3 Décrire le fonctionnement du stockage magnétique, optique et à état solide (mémoire flash) et donner des exemples de chacun
• Le stockage magnétique utilise des plateaux divisés en pistes et secteurs. Les données sont lues et écrites à l'aide d'électroaimants. Incluant disque dur (HDD) • Le stockage optique utilise des lasers pour créer et lire des alvéoles et des landes. Incluant : CD, DVD et Blu-ray • Le stockage à état solide (mémoire flash) utilise la technologie NAND ou NOR. Des transistors sont utilisés comme portes de contrôle et portes flottantes. Incluant : disque à semi-conducteurs (SSD), carte SD et clé USB
4 Décrire ce que signifie la mémoire virtuelle, comment elle est créée et utilisée, et pourquoi elle est nécessaire
• Des pages de données sont transférées entre la RAM et la mémoire virtuelle selon les besoins
5 Comprendre ce que signifie le stockage en nuage (cloud storage)
• Le stockage en nuage peut être accédé à distance par rapport au stockage local des données
6 Expliquer les avantages et inconvénients du stockage de données dans le cloud par rapport au stockage local
• Des serveurs physiques et du matériel de stockage sont nécessaires pour stocker des données dans un cloud storage
Source : Programme Cambridge International
Le stockage primaire 主存储器 est la mémoire que le CPU peut utiliser directement. Il existe deux types.
La RAM est volatile et contient les programmes en cours ; la ROM est non-volatile et lecture-only
RAM
ROM
Nom complet
mémoire vive 随机存取存储器
mémoire morte 只读存储器
Lecture/écriture
lecture et écriture
lecture seule
Conserve-t-il les données sans alimentation ?
non — c'est volatile 易失性
oui — c'est non-volatile 非易失性
Contient
programmes et données en cours d'utilisation
instructions de démarrage (comment amorcer l'ordinateur)
Les deux sont nécessaires : la ROM indique à l'ordinateur comment démarrer, puis la RAM contient les programmes que vous lancez.
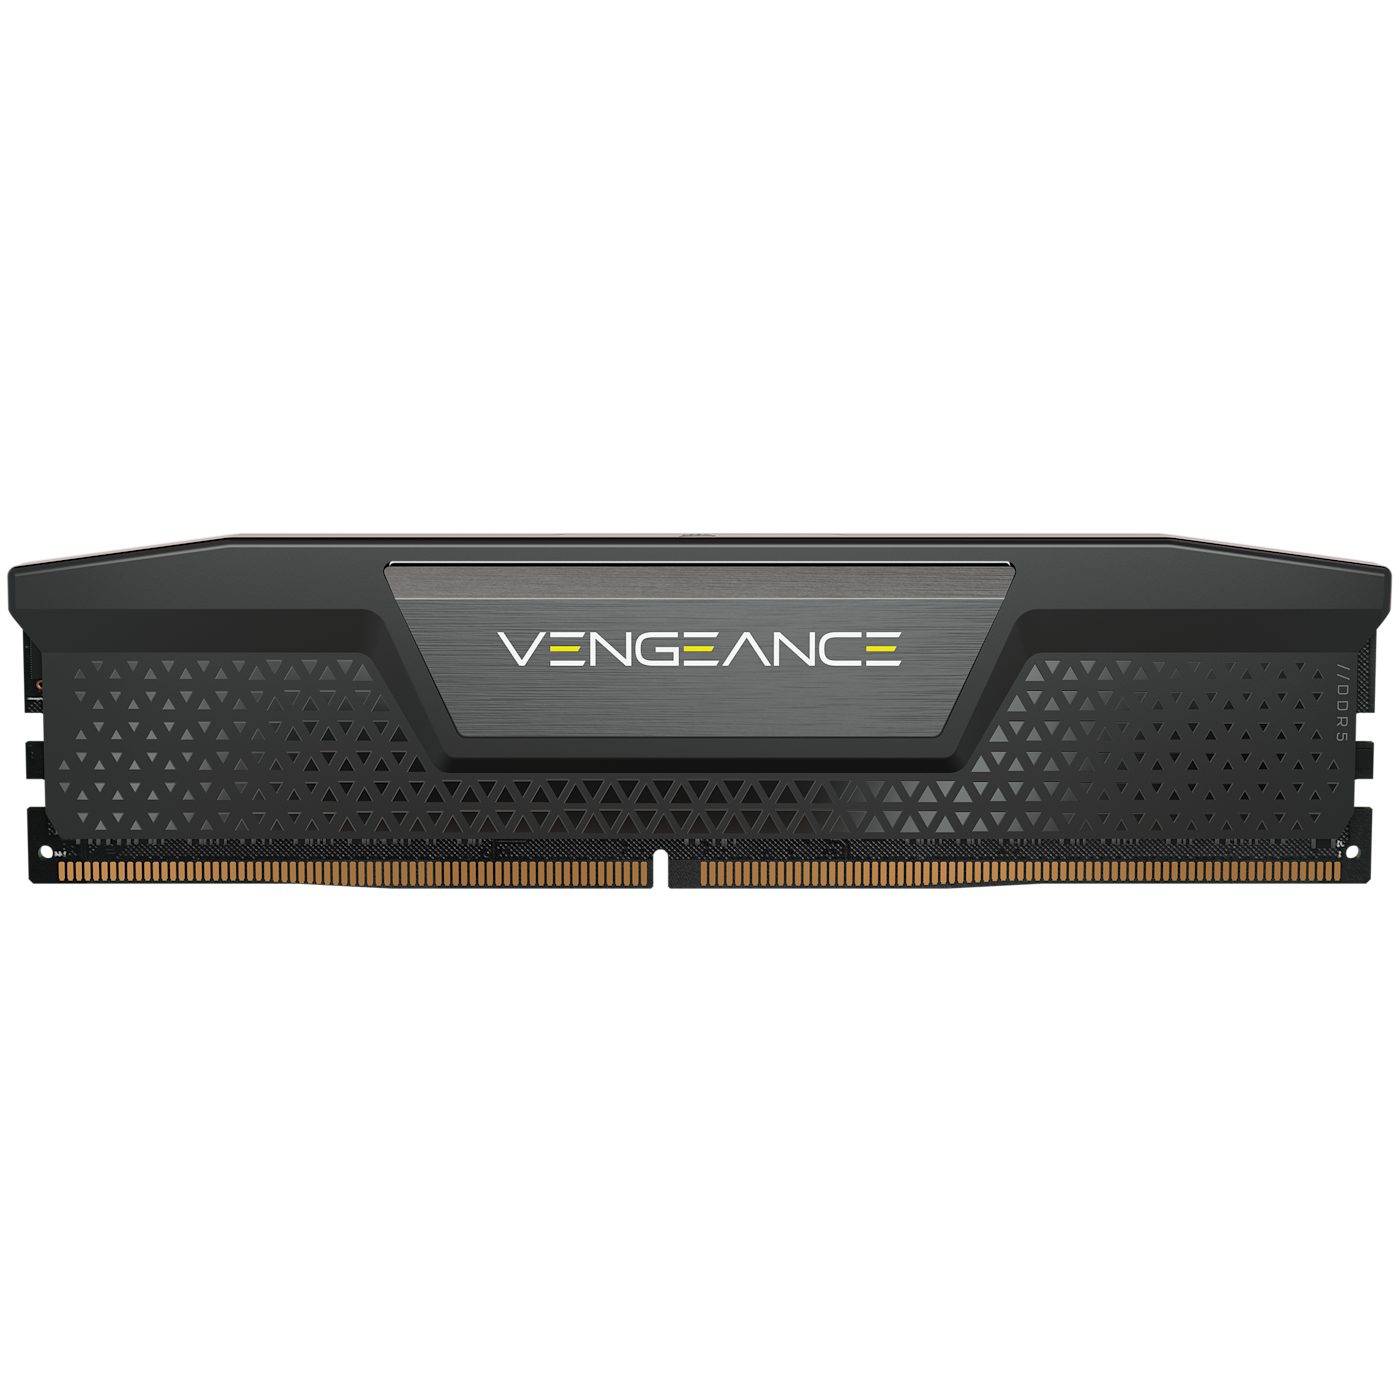
Un module de RAM (mémoire vive) : il contient les programmes et les données en cours d'utilisation
Le stockage secondaire 辅助存储器 conserve les données de manière permanente, même lorsque l'alimentation est coupée. Il est non-volatile et sert au stockage à long terme. Il existe trois types.
Type
Méthode de stockage des données
Exemples
stockage magnétique 磁存储
les données sont stockées sous forme de zones magnétisées sur des disques en rotation
disque dur (HDD), bande magnétique
stockage optique 光存储
les données sont stockées sous forme de marques lues par un laser
CD, DVD, Blu-ray
stockage à semi-conducteurs 固态存储
les données sont stockées dans une mémoire flash 闪存, sans pièces mobiles
SSD, clé USB, carte mémoire
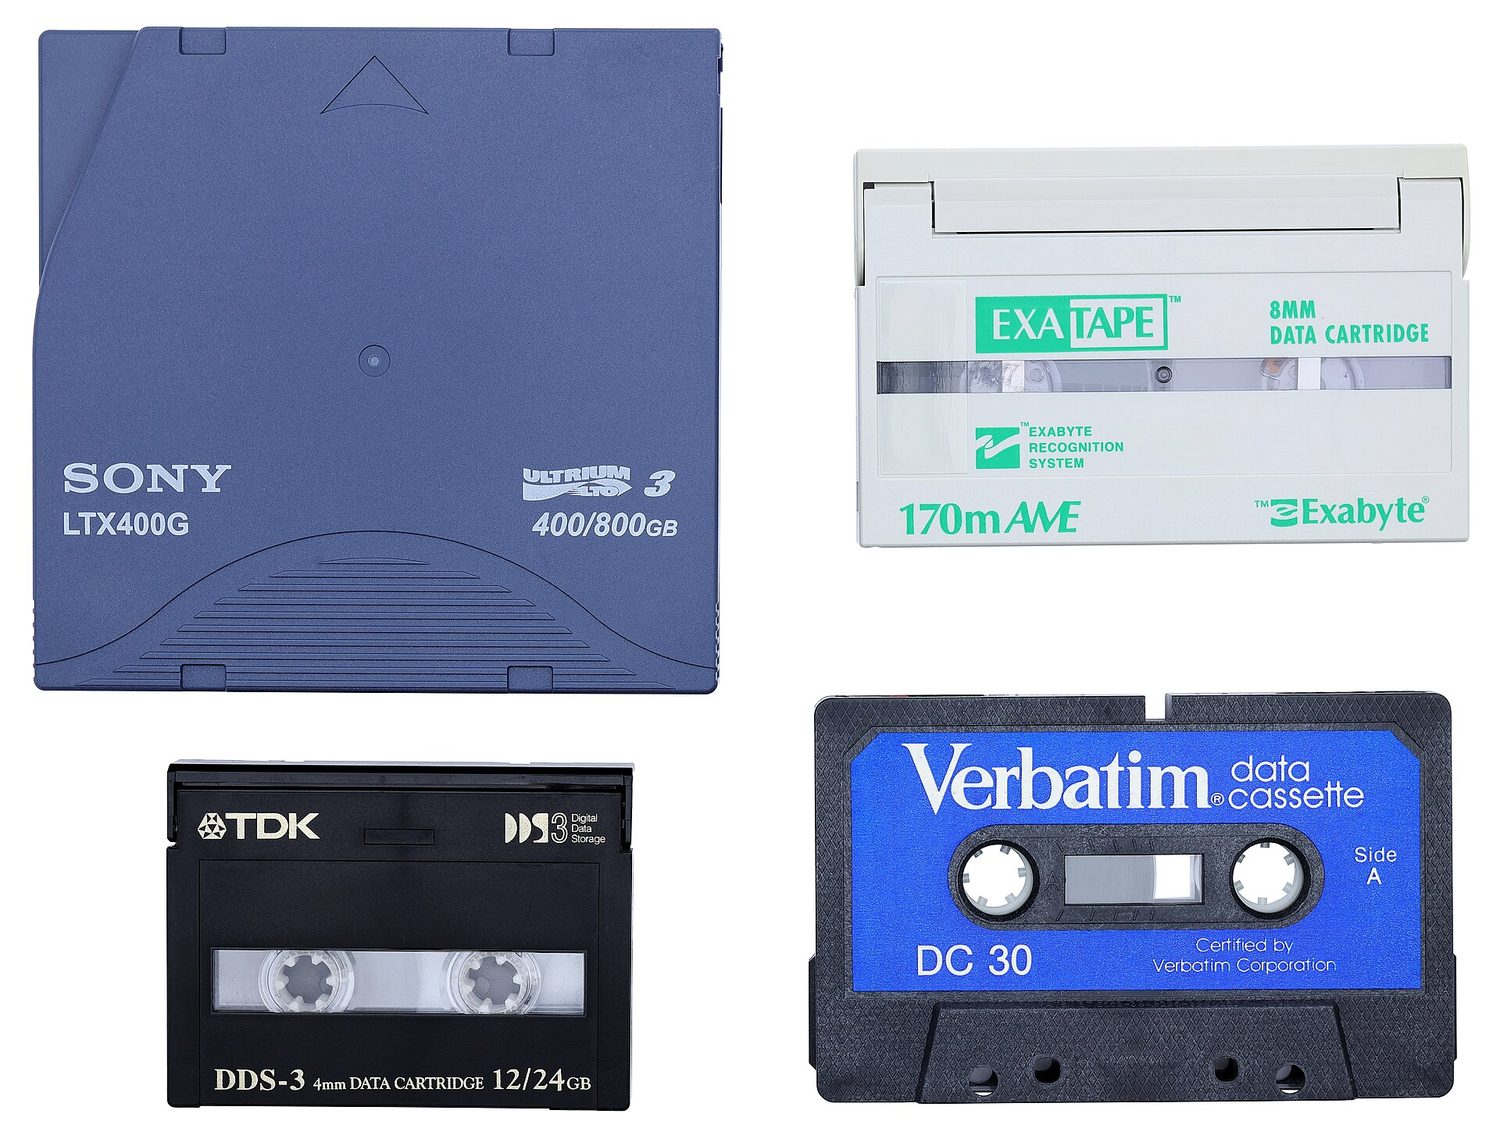
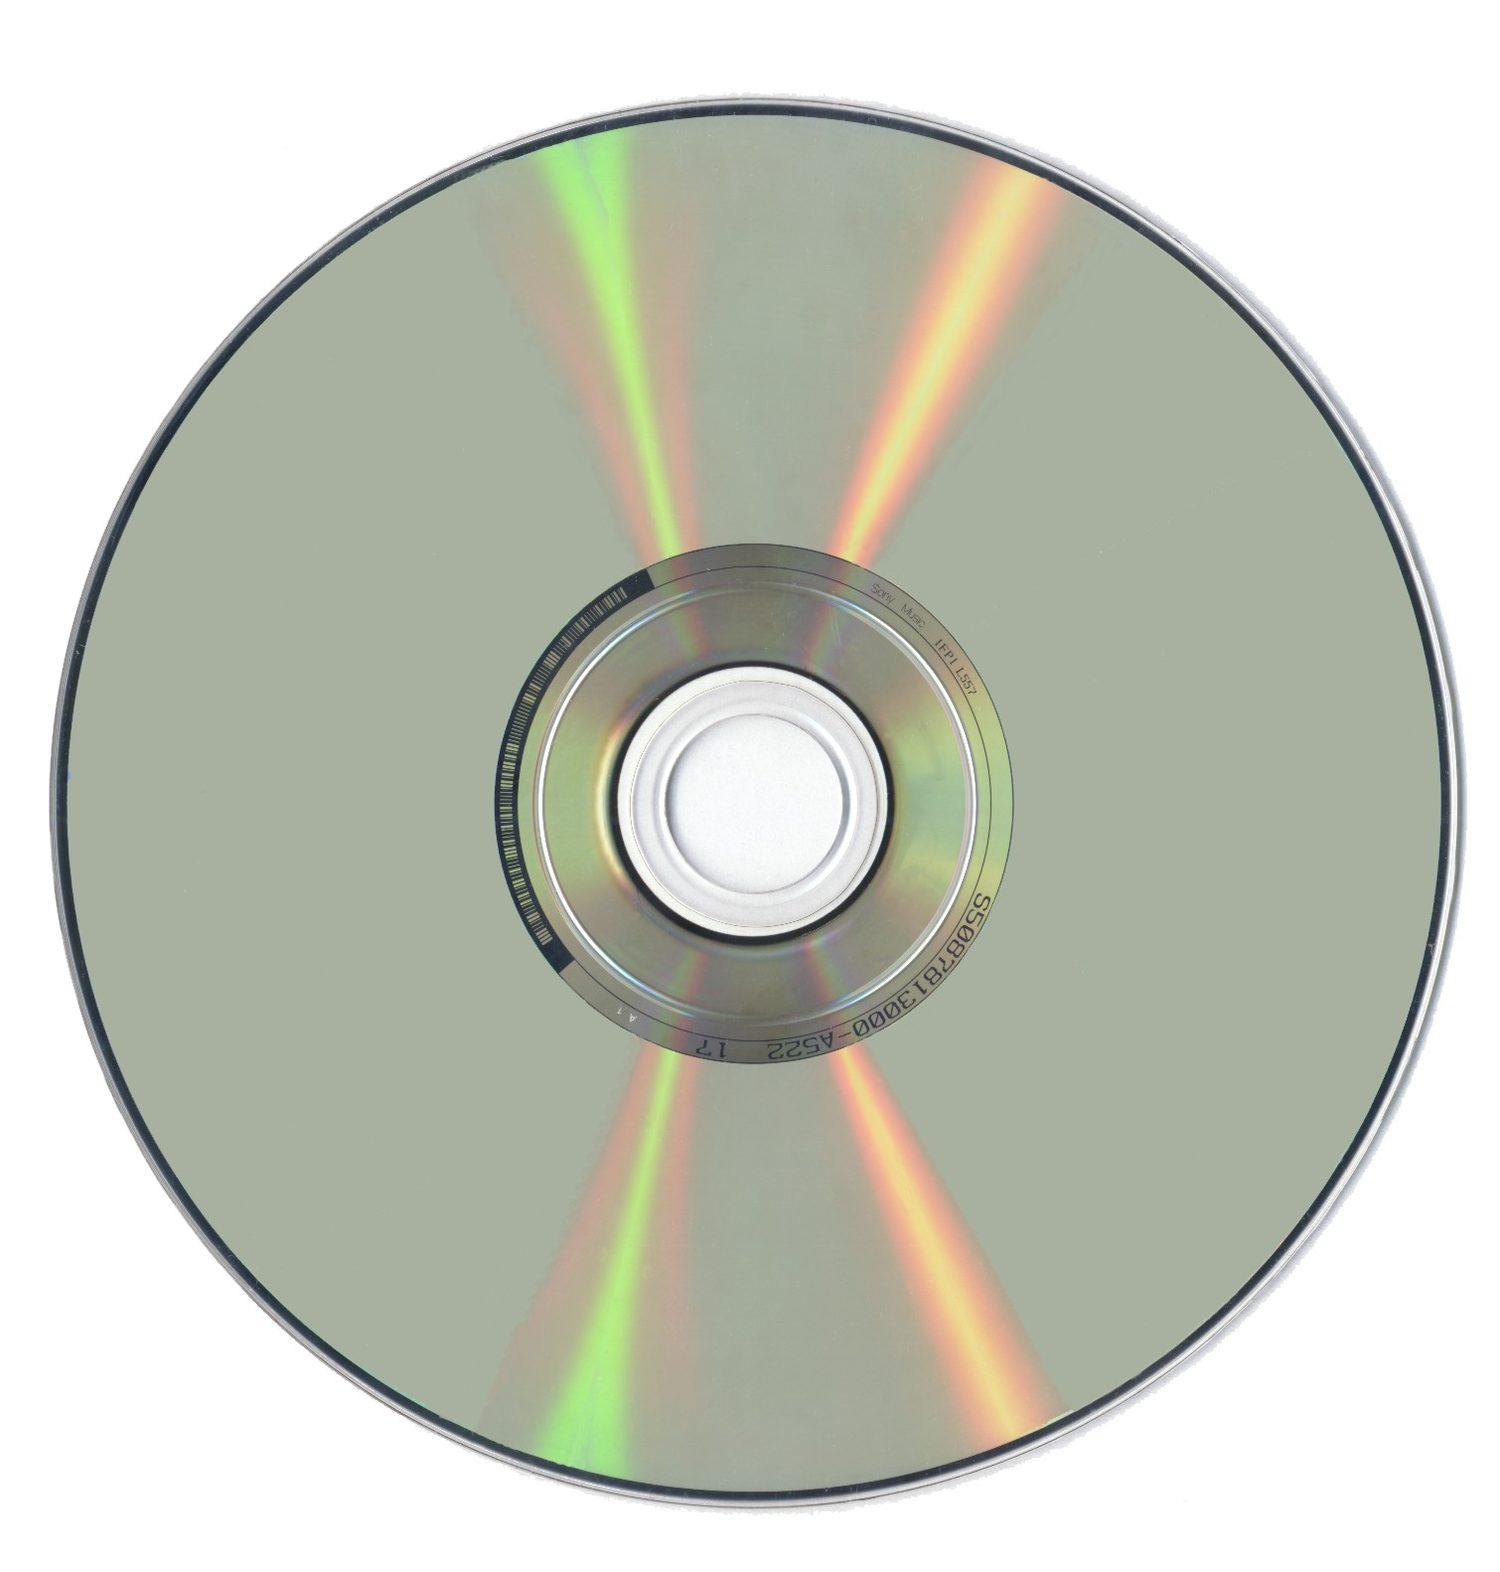
À l'intérieur d'un disque dur (HDD) : le disque brillant tourne et le bras lit les données magnétiséesLa bande magnétique stocke les données sur une longue bande magnétique ; elle est peu coûteuse pour les grandes sauvegardesUn support optique tel qu'un CD ou DVD : un laser lit les marques sur sa surface brillanteUn disque dur solide (SSD) stocke des données dans des puces mémoire flash et n'a pas de pièces mobilesUne clé USB stocke des données dans une mémoire flash et ne possède aucune pièce mobileLe stockage forme une hiérarchie : les registres et le cache sont les plus rapides mais les plus petits ; le stockage secondaire est le plus lent mais le plus grand
Explorer
Dispositif et laboratoire de stockage
Classez les exemples informatiques selon leur rôle dans un système.
Lorsque la RAM est pleine, l'ordinateur peut utiliser une partie du stockage secondaire comme RAM supplémentaire factice. C'est ce qu'on appelle la mémoire virtuelle 虚拟内存.
Les données qui ne sont pas nécessaires immédiatement sont déplacées hors de la RAM vers le disque, ce qui libère de l'espace dans la RAM pour d'autres programmes. Cela permet d'exécuter plus de programmes que la RAM seule ne pourrait contenir. C'est plus lent, car le stockage secondaire est beaucoup plus lent que la RAM.
Lorsque la RAM est pleine, les données inutilisées sont déplacées vers le disque pour libérer de la RAM — plus lent, mais cela permet d'exécuter plus de programmes
• Le stockage primaire est directement accès par l'unité centrale de traitement • Incluant le rôle de : – mémoire vive (RAM) – mémoire morte (ROM) • Incluant pourquoi un ordinateur a besoin des deux RAM et ROM, et la différence entre eux
2 Comprendre ce qu'est le stockage secondaire
• Le stockage secondaire n'est pas directement accès par l'unité centrale de traitement et est nécessaire pour le stockage plus permanent des données
3 Décrire le fonctionnement du stockage magnétique, optique et à état solide (mémoire flash) et donner des exemples de chacun
• Le stockage magnétique utilise des plateaux divisés en pistes et secteurs. Les données sont lues et écrites à l'aide d'électroaimants. Incluant disque dur (HDD) • Le stockage optique utilise des lasers pour créer et lire des alvéoles et des landes. Incluant : CD, DVD et Blu-ray • Le stockage à état solide (mémoire flash) utilise la technologie NAND ou NOR. Des transistors sont utilisés comme portes de contrôle et portes flottantes. Incluant : disque à semi-conducteurs (SSD), carte SD et clé USB
4 Décrire ce que signifie la mémoire virtuelle, comment elle est créée et utilisée, et pourquoi elle est nécessaire
• Des pages de données sont transférées entre la RAM et la mémoire virtuelle selon les besoins
5 Comprendre ce que signifie le stockage en nuage (cloud storage)
• Le stockage en nuage peut être accédé à distance par rapport au stockage local des données
6 Expliquer les avantages et inconvénients du stockage de données dans le cloud par rapport au stockage local
• Des serveurs physiques et du matériel de stockage sont nécessaires pour stocker des données dans un cloud storage
Source : Programme Cambridge International
Le stockage cloud 云存储 conserve vos données sur des serveurs physiques distants, accessibles via Internet, au lieu de les conserver sur votre propre appareil.
Avantages : y accéder depuis n'importe où et sur n'importe quel appareil ; aucun matériel de stockage local à acheter ou entretenir ; partage facile de fichiers et sauvegarde automatique aisée.
Inconvénients : nécessite une connexion Internet fonctionnelle ; coût d'abonnement continu ; sécurité et confidentialité dépendent du fournisseur ; vous dépendez de la disponibilité et de la pérennité de ce fournisseur.
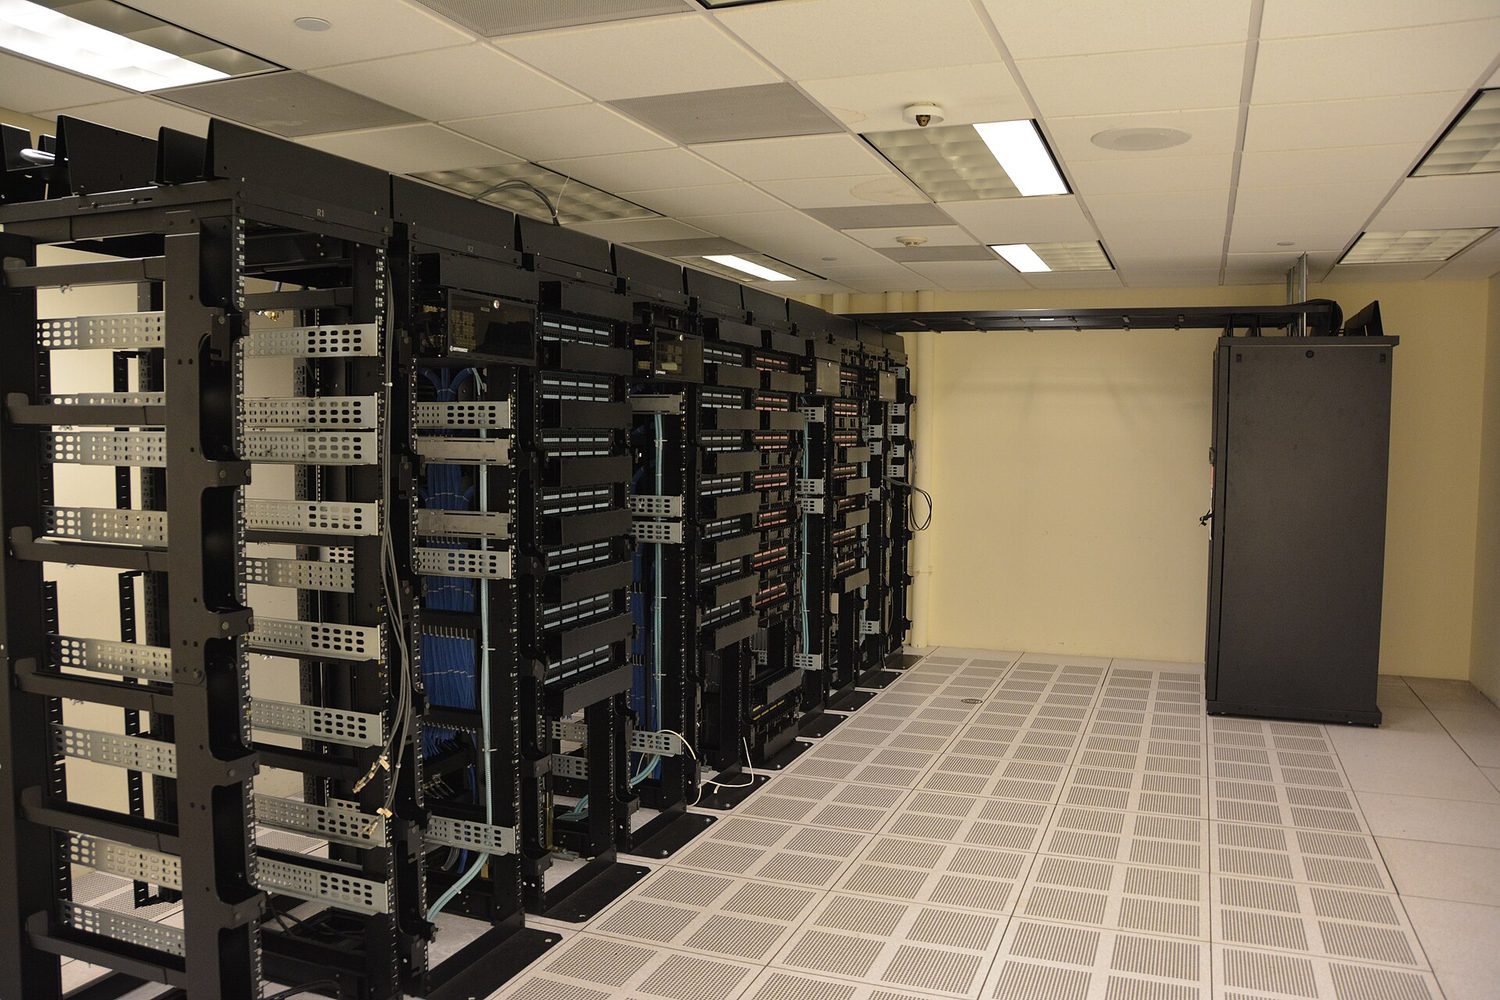
Bancs de serveurs de centre de données : le stockage cloud conserve vos fichiers sur des serveurs distants auxquels vous accédez via le réseau
1 Comprendre qu'un ordinateur a besoin d'une carte interface réseau (NIC) pour accéder à un réseau
2 Comprendre ce que signifie, et quel est l'objectif, d'une adresse MAC (Media Access Control), y compris sa structure
• Une carte interface réseau se voit attribuer une adresse MAC lors de sa fabrication • Les adresses MAC sont généralement écrites en hexadécimal • Les adresses MAC sont créées à partir du code constructeur et du code de série
3 (a) Comprendre ce que signifie, et quel est l'objectif, d'une adresse IP (Internet Protocol) (b) Comprendre qu'il existe différents types d'adresses IP
• Une adresse IP est allouée par le réseau et peut être statique ou dynamique • Inclure les caractéristiques et différences entre IPv4 et IPv6
4 Décrire le rôle d'un routeur dans un réseau
• Un routeur envoie des données vers une destination spécifique sur un réseau • Un routeur peut attribuer des adresses IP • Un routeur peut connecter un réseau local à Internet
Source : Programme Cambridge International
Carte réseau (NIC)
Une carte réseau 网络接口卡 (NIC) est le matériel qui permet à un appareil de se connecter à un réseau et d'envoyer et recevoir des données. Chaque NIC possède une adresse MAC intégrée.
Adresse MAC et adresse IP
Une adresse MAC (media access control 介质访问控制 address) est un numéro qui identifie un appareil physique unique. Elle est définie par le fabricant et ne change normalement pas. Elle est écrite en hexadécimal.
Une adresse IP (internet protocol 网际协议 address) est un numéro qui identifie un appareil sur un réseau. Elle est attribuée par le réseau et peut changer.
Ainsi, une adresse MAC reste attachée à l'appareil, tandis qu'une adresse IP dépend du réseau utilisé par l'appareil.
Il existe deux versions des adresses IP. IPv4 est sur 32 bits, écrit sous la forme de quatre nombres décimaux 0–255 (par exemple 192.168.0.1) ; la nouvelle version IPv6 est sur 128 bits, écrite sous la forme de huit groupes d'hexadécimaux séparés par des deux-points, offrant énormément d'adresses. Une adresse est également soit statique 静态 (fixe, définie manuellement et ne change jamais) soit dynamique 动态 (attribuée par le routeau/réseau à chaque fois que l'appareil se connecte, donc elle peut changer).
Routeur
Un routeur 路由器 connecte différents réseaux entre eux — par exemple, votre réseau domestique à Internet. Il lit l'adresse IP dans chaque paquet et le transmet vers le bon réseau.
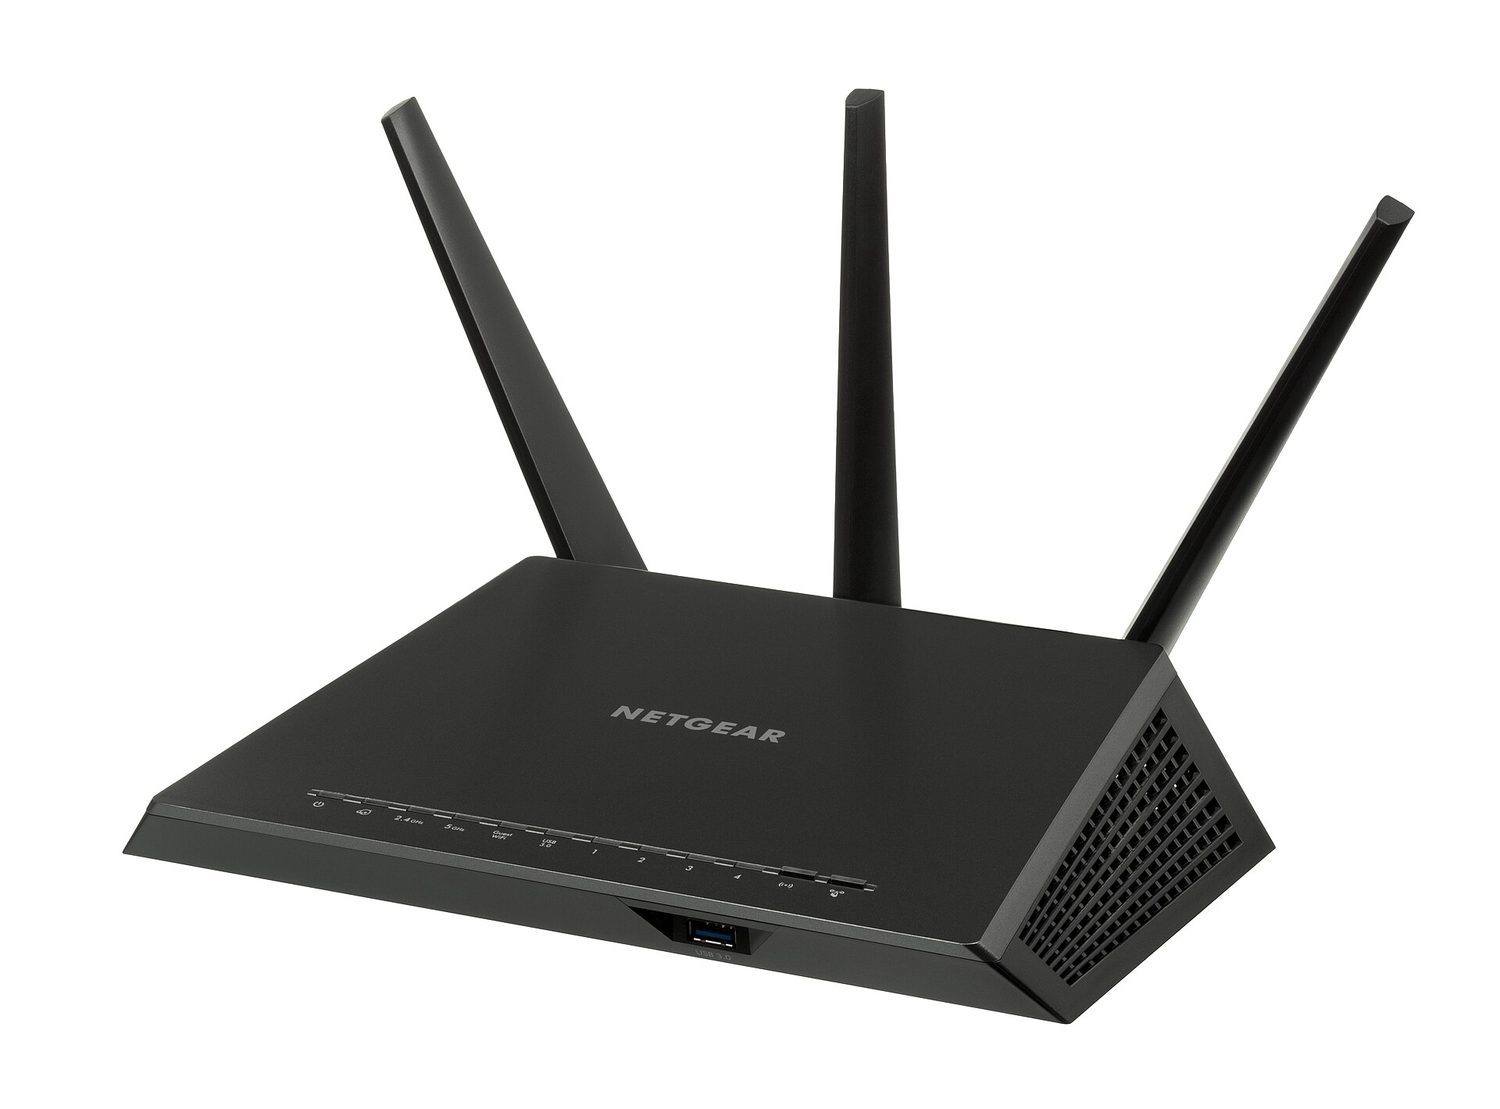
Un routeur Wi-Fi : le matériel réseau achemine les paquets entre les appareils et Internet plus large
Explorer
Lab de routage réseau
Suivez les données depuis un appareil à travers le matériel réseau et les protocoles.
Apprenez le cycle fetch–decode–execute et les registres spéciaux : le program counter contient l'adresse de l'instruction suivante, le MAR/MDR transportent l'adresse/données, et le accumulator contient le résultat de l'ALU.
La performance du CPU s'améliore avec davantage de cores, une cache plus grande et une clock speed plus élevée.
La RAM est volatile (elle perd ses données sans alimentation) et contient les programmes en cours d'utilisation ; la ROM est non-volatile et en lecture seule (les instructions de démarrage).
Associez les types de stockage secondaire : magnétique (HDD, bande), optique (CD/DVD, lu par un laser), à état solide (SSD, USB, flash — sans pièces mobiles).
Une adresse MAC identifie l'appareil physique et ne change normalement pas ; une adresse IP est attribuée par le réseau et peut changer.
Un système informatique est composé de deux parties qui travaillent ensemble.
Le matériel est les parties physiques ; le logiciel est les programmes
Le matériel 硬件 est les parties physiques 物理 de l'ordinateur — les composants que vous pouvez toucher. Exemples : le CPU, la mémoire, le clavier, l'écran et le disque dur.
Le logiciel 软件 est les programmes 程序 qui contrôlent l'ordinateur et disent au matériel quoi faire.
Le matériel ne peut rien faire d'utilisable tout seul. Le logiciel a besoin de matériel pour s'exécuter. Les deux sont nécessaires.
La carte mère et les pièces qui lui sont rattachées constituent le matériel — les composants physiques que vous pouvez toucherUn système d'exploitation est un logiciel — les programmes qui disent au matériel quoi faire
1 Décrire la différence entre les logiciels système et les logiciels applicatifs et donner des exemples de chacun
• Les logiciels système fournissent les services dont l'ordinateur a besoin, notamment le système d'exploitation et les logiciels utilitaires • Les logiciels applicatifs fournissent les services dont l'utilisateur a besoin
2 Décrire le rôle et les fonctions de base d'un système d'exploitation
• Y compris : – gestion des fichiers – gestion des interruptions – fourniture d'une interface – gestion des périphériques et pilotes – gestion de la mémoire – gestion du multitâche – fourniture d'une plateforme pour exécuter des applications – sécurité système – gestion des comptes utilisateurs
3 Comprendre comment le matériel, le micrologiciel et le système d'exploitation sont nécessaires pour exécuter des logiciels applicatifs
• Les applications s'exécutent sur le système d'exploitation • Le système d'exploitation s'exécute sur le micrologiciel • Le chargeur initial (firmware) s'exécute sur le matériel
4 Décrire le rôle et le fonctionnement des interruptions
• Y compris : – la génération d'une interruption – son traitement via une routine de service d'interruption – ce qui se produit en conséquence • Les interruptions logicielles incluent la division par zéro et deux processus tentant d'accéder au même emplacement mémoire • Les interruptions matérielles incluent l'appui sur une touche du clavier et le déplacement de la souris
Source : Programme Cambridge International
Le logiciel est divisé en deux types.
Le logiciel se divise en system software (qui fait tourner l'ordinateur) et application software (qui permet à l'utilisateur d'accomplir une tâche)
System software
Le system software 系统软件 contrôle l'ordinateur lui-même et fournit une base pour que d'autres programmes puissent s'y exécuter. Exemples :
operating system 操作系统 (voir ci-dessous) ;
compiler 编译器 et linker 链接器 (outils qui transforment les programmes en une forme exécutable par l'ordinateur) ;
device driver 设备驱动程序 — logiciel qui permet au système d'exploitation de contrôler un composant matériel ;
utility software 实用程序 — petits outils qui entretiennent l'ordinateur (par exemple anti-virus, sauvegarde, nettoyage de disque).
Sous le système d'exploitation se trouve le firmware 固件 – logiciel stocké définitivement sur ROM ou flash qui s'exécute dès que l'ordinateur est allumé. Le BIOS et le bootloader 引导程序 sont du firmware : ils testent le matériel puis chargent le système d'exploitation. Ainsi, les couches s'empilent hardware → firmware → operating system → application software, chacune s'exécutant sur la couche inférieure.
Logiciel d'application
Le application software 应用软件 permet à l'utilisateur d'accomplir une tâche utile. Exemples :
word processing 文字处理 software (rédaction de documents) ;
spreadsheet 电子表格 software (travail avec des nombres dans une grille) ;
database management system 数据库管理系统 (stockage et recherche de données) ;
providing a user interface/prəˈvaɪdɪŋ ə ˈjuːzə ˈɪntəfeɪs/
用户界面
yòng hù jiè miàn
managing peripherals/ˈmænɪdʒɪŋ pəˈrɪfərəlz/
外围设备
wài wéi shè bèi
managing multitasking/ˈmænɪdʒɪŋ ˈmʌltitæskɪŋ/
多任务处理
duō rèn wù chǔ lǐ
providing a platform/prəˈvaɪdɪŋ ə ˈplætfɔːm/
平台
píng tái
processor/ˈprəʊsesə/
处理器
chǔ lǐ qì
4.1
Le système d'exploitation
Un système d'exploitation (OS) est le principal système logiciel. Il contrôle tout l'ordinateur et permet au matériel, au logiciel applicatif et à l'utilisateur de travailler ensemble. Sans OS, l'ordinateur est très difficile à utiliser.
Le système d'exploitation se situe entre le matériel et le logiciel applicatif/utilisateur, leur permettant de travailler ensemble
L'OS remplit de nombreux rôles :
gérer les fichiers — sauvegarder, ouvrir, nommer, déplacer et supprimer des fichiers ;
gérer les interruptions (voir ci-dessous) ;
fournir une interface utilisateur 用户界面 afin que l'utilisateur puisse contrôler l'ordinateur ;
gérer la mémoire — décider ce qui est conservé dans la RAM et où ;
gérer les périphériques 外围设备和 leurs pilotes — contrôler des appareils comme les imprimantes ;
gérer le multitasking 多任务处理 — permettre à plusieurs programmes de s'exécuter simultanément ;
fournir une plateforme 平台 pour exécuter le logiciel applicatif ;
gérer la sécurité — comptes utilisateurs, mots de passe et droits d'accès.
Une interruption 中断 est un signal envoyé au processeur 处理器 pour lui indiquer qu'il doit prêter attention à quelque chose maintenant.
Une interruption peut provenir de trois sources :
matériel — par exemple une touche est pressée, ou une imprimante manque de papier ;
logiciel — par exemple un programme essaie de diviser par zéro ;
l'utilisateur — par exemple l'utilisateur appuie sur une touche "annuler".
Lorsqu'une interruption arrive, le processeur stoppe ce qu'il est en train de faire, sauvegarde son emplacement, et traite (gère) l'interruption. Une fois celle-ci traitée, il retourne à ce qu'il faisait auparavant. Cela permet à l'ordinateur de réagir rapidement aux événements importants.
Lors d'une interruption, le CPU sauvegarde son emplacement, exécute le routine de service d'interruption, puis restaure son emplacement et continue
Explorer
Comment le CPU gère une interruption
Étape par étape d'une interruption. Le CPU pause ce qu'il fait, traite l'événement urgent, puis reprend exactement là où il s'était arrêté — c'est ainsi qu'un processeur gère simultanément le clavier, l'imprimante et la minuterie.
1 Expliquer ce que signifie un langage de haut niveau et un langage de bas niveau, y compris les avantages et inconvénients de chacun
• Les avantages et inconvénients incluent : – facilité de lecture et d'écriture du code, par exemple le langage de bas niveau est difficile à lire – facilité de débogage du code – indépendance de la machine – manipulation directe du matériel
2 Comprendre que le langage assembleur est une forme de langage de bas niveau utilisant des mnémoniques, et qu'un assembleur est nécessaire pour traduire un programme en langage assembleur en code machine
3 Décrire le fonctionnement d'un compilateur et d'un interpréteur, y compris la traduction du langage de haut niveau par chacun et la signalisation des erreurs
• Un compilateur traduit tout le code en une fois avant de l'exécuter, produisant un fichier exécutable • Un interpréteur traduit et exécute le code ligne par ligne • Un compilateur fournit un rapport d'erreurs pour l'ensemble du code si des erreurs sont détectées • Un interpréteur arrête l'exécution lorsqu'une erreur est trouvée
4 Expliquer les avantages et inconvénients d'un compilateur et d'un interpréteur
• Inclure la compréhension selon laquelle un interpréteur est principalement utilisé lors du développement d'un programme et un compilateur est utilisé pour traduire le programme final
5 Expliquer le rôle d'un IDE dans l'écriture de code de programme et les fonctions courantes fournies par les IDE
• Y compris : – éditeurs de code – environnement d'exécution – traducteurs – diagnostics d'erreur – complétion automatique – correction automatique – mise en forme automatique
Source : Programme Cambridge International
Tous les ordinateurs traitent les données en utilisant le central processing unit 中央处理器 (CPU). Pour faire travailler le CPU, les gens écrivent des programs dans un programming language 编程语言. Il existe deux sortes.
High-level languages
Un langage de haut niveau 高级语言 est écrit avec des mots qui ressemblent un peu à l'anglais (par exemple Python). Il permet :
d'être facile à lire, écrire et corriger par les humains;
d'être indépendant de l'ordinateur — le même programme peut s'exécuter sur différents types d'ordinateurs.
Langages de bas niveau
Un langage de bas niveau 低级语言 est proche de ce que le matériel utilise réellement. Il comprend :
le code machine 机器码 — instructions écrites en binaire (0 et 1), exécutées directement par le CPU;
le langage assembleur 汇编语言 — code machine écrit avec des codes mots courts (mnémoniques) au lieu du binaire.
Un langage de bas niveau est lié à un type de CPU spécifique 特定的, donc un programme écrit pour un CPU donné peut ne pas s'exécuter sur un autre. Il est utilisé lorsque le programmeur a besoin d'un contrôle total du matériel ou d'un code très rapide et compact.
Les langages de haut niveau sont proches du langage humain et fonctionnent sur n'importe quel ordinateur ; les langages de bas niveau (assembleur et code machine) sont proches du matériel et liés à un type de CPU spécifique
Explorer
Laboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Le CPU ne peut exécuter que du code machine. Un programme en langage de haut niveau doit d'abord être converti en code machine. Le logiciel qui effectue cette conversion est un traducteur 翻译程序. Il existe trois types : un compilateur et un interpréteur (pour le code de haut niveau), et un assembleur (pour le code de bas niveau).
Compilateur
Un compilateur traduit le programme entier en code machine avant son exécution. Une fois traduits, les codes machines peuvent être exécutés plusieurs fois sans avoir besoin de recompiler.
la traduction a lieu une seule fois, en intégralité;
il signale toutes les erreurs regroupées, à la fin de la traduction;
le programme final s'exécute rapidement et ne nécessite pas la présence du compilateur pour tourner.
Interprète
Un interpréteur 解释器 traduit et exécute le programme ligne par ligne.
il s'arrête à la première erreur rencontrée, ce qui facilite le débogage;
le programme s'exécute plus lentement, car il est traduit à chaque lancement;
l'interpréteur doit être présent à chaque exécution du programme.
Compilateur
Interpréteur
Traduit
tout le programme d'un coup
une ligne à la fois
Erreurs
toutes signalées à la fin
s'arrête à la première erreur
Vitesse du programme final
plus rapide
plus lent
Nécessaire pour exécuter ensuite ?
non
oui
Utilisez un compilateur lorsque vous souhaitez distribuer un programme final rapide. Utilisez un interpréteur lors de l'écriture et du test d'un programme pour repérer facilement les erreurs.
Assembleur
Un assembleur 汇编器 traduit un programme en langage assembleur de bas niveau (écrit avec des mnémoniques comme LDA, ADD) en code machine. Chaque mnémotechnique devient une instruction machine — une traduction directe un-à-un, contrairement à un compilateur ou un interpréteur qui traitent du code de haut niveau.
Un compilateur traduit le programme entier une fois en code machine ; un interpréteur traduit et exécute ligne par ligne
Exemple résolu. Une équipe écrit un programme. Durant le développement, elle souhaite identifier et corriger rapidement les erreurs ; lors du déploiement, elle veut que les clients l'exécutent vite sans voir le code source. Quel traducteur convient à chaque étape ? Pour le développement, utilisez un interpréteur : il traduit et exécute ligne par ligne et s'arrête à la première erreur, facilitant ainsi la localisation des fautes. Pour le déploiement, utilisez un compilateur : il traduit le programme entier une fois en code machine, qui s'exécute ensuite rapidement sans traducteur présent, et le client reçoit uniquement le fichier exécutable et non le code source. Les deux ne sont pas rivaux — nommez la phase et donnez la raison, car dire simplement « un compilateur est plus rapide » ne rapporte aucun point.
integrated development environment/ˈɪntɪɡreɪtɪd dɪˈveləpmənt enˈvaɪrənmənt/
集成开发环境
jí chéng kāi fā huán jìng
code editor/kəʊd ˈedɪtə/
代码编辑器
dài mǎ biān jí qì
run time environment/rʌn taɪm enˈvaɪrənmənt/
运行时环境
yùn xíng shí huán jìng
error diagnostics/ˈerə ˌdaɪəɡˈnɒstɪks/
错误诊断
cuò wù zhěn duàn
auto-completion/ˈɔːtəʊ kəmˈpliːʃn/
自动补全
zì dòng bǔ quán
4.2
Environnement de développement intégré (IDE)
Un environnement de développement intégré 集成开发环境 (IDE) est un logiciel qui aide à écrire des programmes. Il regroupe divers outils utiles dans une même interface :
non éditeur de code 代码编辑器 — pour taper votre programme;
non environnement d'exécution 运行时环境 — pour lancer le programme et le tester;
non traducteur — un compilateur ou un interpréteur pour convertir votre code en code machine;
le diagnostic d'erreurs 错误诊断 — messages aidant à trouver et comprendre les fautes;
l'auto-complétion 自动补全 et l'auto-correction 自动纠错 — l'IDE complète ou corrige le code au fur et à mesure de la frappe;
le joli affichage 美化打印 — mise en forme propre avec couleurs et retraits pour faciliter la lecture.
Code source dans un éditeur : un IDE combine éditeur, débogueur et outils d'exécution dans un seul endroit
Le matériel (Hardware) désigne les composants physiques ; le logiciel (Software) désigne les programmes. Le logiciel système fait fonctionner l'ordinateur (Système d'exploitation, pilotes, utilitaires) ; le logiciel applicatif effectue une tâche pour l'utilisateur.
Un compilateur traduit le programme entier d'un coup (le programme final s'exécute vite et toutes les erreurs sont signalées à la fin) ; un interpréteur traduit ligne par ligne (il s'arrête à la première erreur, s'exécute plus lentement et est requis à chaque lancement).
Les langages de haut niveau sont proches de l'anglais et fonctionnent sur tout ordinateur ; les langages de bas niveau (assembleur, code machine) sont liés à un type de CPU spécifique.
Une interruption (interrupt) est un signal qui force le CPU à s'arrêter, sauvegarder sa position, traiter l'événement, puis reprendre là où il était arrêté.
Apprenez les rôles du système d'exploitation : gestion des fichiers, de la mémoire, des périphériques, du multitâche, de la sécurité et de l'interface utilisateur.
1 Comprendre la différence entre Internet et le World Wide Web
• Internet est l'infrastructure • Le World Wide Web est l'ensemble des sites web et pages web accessibles via Internet
2 Comprendre ce que signifie un URL (Uniform Resource Locator)
• Un URL est une adresse textuelle pour une page web ; il peut contenir le protocole, le nom de domaine et le nom de la page/web/fichier
3 Décrire le but et le fonctionnement du HTTP (Hypertext Transfer Protocol) et du HTTPS (Hypertext Transfer Protocol Secure)
4 Expliquer le but et les fonctions d'un navigateur web
• Le but principal d'un navigateur web est de rendre le langage HTML et d'afficher des pages web • Fonctions incluant : – sauvegarde des signets et favoris – enregistrement de l'historique utilisateur – utilisation de multiples onglets – stockage des cookies – fournir des outils de navigation – fournir une barre d'adresse
5 Décrire comment les pages web sont localisées, récupérées et affichées sur un appareil lorsque l'utilisateur saisit une URL
• Y compris le rôle de : – le navigateur web – les adresses IP – le serveur de noms de domaine (DNS) – le serveur web – HTML
6 Expliquer ce que signifient les cookies et comment ils sont utilisés, y compris les cookies de session et les cookies persistants
• Les cookies sont utilisés pour diverses fonctions, y compris : – sauvegarde des détails personnels – suivi des préférences utilisateur – maintien des articles dans un panier d'achat en ligne – stockage des identifiants de connexion
Source : Programme Cambridge International
Les gens confondent souvent ces deux termes, mais ils ne sont pas identiques.
L'Internet 互联网 est l'infrastructure 基础设施 — le vaste réseau mondial d'ordinateurs reliés par des câbles, routeurs et connexions.
Le World Wide Web 万维网 (WWW) est un ensemble de sites web 网站 et pages web consultés via Internet.
Ainsi, Internet est le réseau ; le Web est l'une des choses que vous utilisez sur ce réseau.
L'Internet est le réseau mondial ; le World Wide Web est l'une des choses que vous utilisez dessusUn routeur connecte votre réseau domestique à Internet et envoie les données au bon endroit
Une uniform resource locator 统一资源定位符 (URL) est une adresse textuelle pour une page web. Vous la tapez dans un navigateur web 网页浏览器 pour y accéder, par exemple https://www.example.com/index.html.
Une URL se compose de trois parties : le protocole, le nom de domaine et le chemin vers la page sur le serveur
Lorsque vous tapez une URL et appuyez sur Entrée, plusieurs étapes se produisent :
Le navigateur a besoin de l'adresse IP 网际协议地址 du site, mais une URL utilise un nom, pas un numéro.
Le navigateur interroge un service de noms de domaine 域名服务 (DNS) — un système stockant l'adresse IP pour chaque adresse web.
Le DNS trouve l'adresse IP correspondante et la renvoie au navigateur.
Le navigateur utilise l'adresse IP pour contacter le serveur web 网页服务器 stockant la page.
Le serveur web envoie le HTML de la page au navigateur.
Le navigateur transforme le HTML en page et l'affiche.
Le navigateur demande à un DNS l'adresse IP du site, puis sollicite la page du serveur web, qui renvoie le HTML
Si le DNS ne possède pas l'adresse, il interroge un autre serveur DNS jusqu'à ce qu'elle soit trouvée.
Un centre de données rempli de serveurs : des ordinateurs puissants qui stockent des sites web et vous les envoient
Exemple résolu. Analysez l'URL https://www.example.com/books/index.html. https est le protocole, l'ensemble de règles servant à transférer la page (le s indique que le transfert est chiffré). www.example.com est le nom de domaine, identifiant le serveur web et converti en adresse IP par un serveur DNS. /books/index.html est le chemin et nom de fichier de la ressource stockée sur ce serveur. Nommez chaque partie avec sa fonction : une réponse disant « la première partie » et « la dernière partie » décrit l'URL sans jamais l'expliquer.
Explorer
Que se passe-t-il lorsque vous chargez une page web
Étape par étape. L'adresse web n'est qu'un nom — DNS la convertit en adresse IP avant que le navigateur puisse demander la page au bon serveur.
5.1
Cookies
Un cookie est un petit fichier texte qu'un site stocke sur votre appareil. Il permet au site de se souvenir de certaines informations vous concernant. Il en existe deux types.
Un cookie est un petit fichier texte stocké sur votre ordinateur
Type
Gardé après fermeture du navigateur ?
Utilisé pour
Cookie de session 会话 cookie
non — supprimé à la fermeture du navigateur
données temporaires, ex. articles dans un panier d'achat
Cookie persistant 持久 cookie
oui — sauvegardé sur l'appareil
reconnaissance entre les visites
Les cookies servent à :
sauvegarder des informations personnelles pour éviter de les retaper (comme la connexion ou l'adresse);
suivre les préférences utilisateurs 用户偏好, comme la langue ou les intérêts, afin que le site puisse suggérer du contenu adapté.
1 Comprendre le concept de monnaie numérique et comment les monnaies numériques sont utilisées
• Une monnaie numérique n'existe que sous forme électronique
2 Comprendre le processus de blockchain et comment il est utilisé pour suivre les transactions de monnaie numérique
• La blockchain, sous sa forme de base, est un registre numérique, c'est-à-dire une série chronologique de registres qui ne peuvent pas être modifiés
Source : Programme Cambridge International
Une monnaie numérique 数字货币 est de l'argent existant uniquement sous forme électronique 电子形式. Il n'y a ni pièces ni billets. Elle est stockée et transférée entre personnes via des ordinateurs, et peut servir à payer des biens en ligne.
Un problème avec l'argent numérique est la confiance : comment empêcher quelqu'un de dépenser la même monnaie deux fois ou de modifier les registres ? La blockchain résout ce problème.
Une blockchain 区块链 est un registre numérique 数字账本 — un registre partagé de chaque transaction 交易. Le registre est copié sur de nombreux ordinateurs, de sorte qu'aucune personne unique ne le contrôle et qu'il est très difficile à modifier.
Les transactions sont conservées dans des blocs reliés en chaîne. Chaque bloc contient :
les données 数据 de la transaction (qui a payé qui, et combien);
une horodatage 时间戳 (la date et l'heure);
une valeur de hachage 哈希值 — un code spécial calculé à partir du contenu du bloc.
Chaque bloc stocke également le hachage du bloc précédent. Si quelqu'un modifie un ancien bloc, son hachage change, il ne correspond donc plus au bloc suivant. Cela brise la chaîne et le changement est immédiatement détecté. C'est ainsi que la blockchain suit les transactions en toute sécurité.
Chaque bloc stocke le hachage du bloc précédent, reliant les blocs ; modifier un bloc brise la chaîne
Explorer
Hachage derrière une blockchain
Un hachage est unidirectionnel et un petit changement à l'entrée modifie beaucoup de la sortie — une blockchain relie ces hachages pour que toute altération soit évidente.
distributed denial of service/ˈdɪstrɪbjuːtɪd dɪˈnaɪəl ɒv ˈsɜːvɪs/
分布式拒绝服务
fēn bù shì jù jué fú wù
hacking/ˈhækɪŋ/
黑客攻击
hēi kè gōng jī
5.3
Menaces de cybersécurité
Programme
Les candidats doivent être capables de :
Notes et orientations
1 Décrire les processus impliqués dans, et l'objectif de réaliser, une gamme de menaces de cybersécurité
• Y compris : – attaque brute-force – interception de données – attaque DDoS (Distributed Denial of Service) – piratage – malveillance (virus, ver, cheval de Troie, spyware, adware, ransomware) – pharming – hameçonnage (phishing) – ingénierie sociale
2 Expliquer comment une gamme de solutions sont utilisées pour aider à protéger les données contre les menaces de sécurité
• Y compris : – niveaux d'accès – anti-malveillance, y compris antivirus et antispyware – authentification (nom d'utilisateur et mot de passe, biométrie, vérification en deux étapes) – automatisation des mises à jour logicielles – vérification de l'orthographe et du ton des communications – vérification de l'URL attachée à un lien – pare-feu – paramètres de confidentialité – serveurs proxy – protocole de sécurité SSL (Secure Socket Layer)
Source : Programme Cambridge International
La cybersécurité 网络安全 signifie protéger les ordinateurs, les réseaux et les données contre les attaques. Vous devez connaître ces menaces.
Menace
Ce que c'est
attaque par force brute 暴力破解
essayer de nombreux mots de passe très rapidement jusqu'à ce que le bon soit trouvé
interception de données 数据拦截
« espionner » pour voler des données pendant leur transit sur un réseau
attaque par déni de service distribué 分布式拒绝服务 (DDoS)
inonder un serveur de tant de requêtes qu'il ne peut pas répondre, ce qui rend le site web indisponible
piratage informatique 黑客攻击
accéder à un système informatique sans autorisation
malware 恶意软件
logiciel nuisible (voir le tableau ci-dessous)
pharming 域名欺骗
un code secret vous redirige vers un site web fake même lorsque vous tapez l'adresse correcte
hameçonnage 网络钓鱼
faux e-mails ou messages qui vous trompent pour vous faire révéler des informations privées
ingénierie sociale 社会工程
tromper une personne (et non un ordinateur) pour qu'elle viole la sécurité, par exemple en se faisant passer pour le patron
Types de malwares
Le malware est tout logiciel conçu pour nuire à un ordinateur. Les principaux types sont :
Malware
Ce qu'il fait
virus 病毒
s'attache à un fichier et se copie lorsque le fichier est ouvert ; peut supprimer ou endommager des données
ver 蠕虫
se copie sur un réseau tout seul, sans avoir besoin qu'un fichier soit ouvert
cheval de Troie 特洛伊木马
se fait passer pour un logiciel utile, mais nuit à l'ordinateur une fois installé
logiciel espion 间谍软件
enregistre secrètement vos actions, telles que les touches que vous appuyez
logiciel publicitaire 广告软件
inonde l'utilisateur de publicités indésirables
ransomware 勒索软件
verrouille vos fichiers et exige un paiement pour les déverrouiller
Impact des menaces
Ces attaques peuvent voler des données personnelles, supprimer ou modifier des fichiers, empêcher un service de fonctionner, coûter de l'argent et faire perdre aux utilisateurs confiance dans une entreprise. Par exemple, une attaque DDoS peut rendre une boutique en ligne inutilisable, entraînant une perte de ventes.
Un cadenas : la cybersécurité verrouille les données et les systèmes contre les malwares, le hameçonnage et les accès non autorisés
Vous pouvez protéger les données en utilisant ces méthodes.
niveaux d'accès 访问权限 — chaque utilisateur ne peut voir ou modifier que les données dont il a besoin, rien de plus.
anti-malware 反恶意软件 logiciels, y compris anti-virus 杀毒软件 et anti-spyware 反间谍软件 — scanne et supprime les logiciels nuisibles.
authentification 身份验证 — prouver votre identité avant d'accéder. Les méthodes incluent :
biométrie 生物识别 (empreinte digitale ou visage),
non mot de passe 密码,
authentification à deux étapes 两步验证 (un code envoyé à votre téléphone ainsi qu'un mot de passe).
automatisation des mises à jour logicielles — les mises à jour corrigent automatiquement les points faibles (bug) du logiciel.
vérifier l'orthographe et le ton des messages — une mauvaise orthographe ou un ton étrange et urgent peut indiquer qu'un message est fake (hameçonnage).
vérifier l'URL attachée à un lien — une adresse web incorrecte ou étrange vous met en garde contre un lien dangereux.
pare-feu 防火墙 — vérifie les données entrantes et sortantes d'un réseau et bloque tout ce qui n'est pas autorisé.
paramètres de confidentialité 隐私设置 — contrôlent qui peut voir vos informations en ligne.
Un pare-feu se situe entre Internet public et votre réseau, vérifiant chaque connexion et bloquant tout trafic non autorisé
serveur proxy 代理服务器 — se place entre l'utilisateur et Internet, masquant l'adresse IP de l'utilisateur et filtrant le contenu dangereux.
Explorer
Chiffrement avec une clé
Changer le décalage — c'est la clé. Chaque lettre glisse de ce nombre de places pour former le chiffré, et la même clé le fait revenir. C'est le chiffrement symétrique.
L'Internet est le réseau mondial (l'infrastructure) ; le World Wide Web est les pages que vous consultez dessus — ne pas confondre les deux.
Apprenez comment une page se charge : le navigateur demande à un DNS l'adresse IP du site, puis demande la page au serveur web, qui retourne le HTML.
Associez les types de malwares : virus (s'attache à un fichier), ver (se propage tout seul sur un réseau), cheval de Troie (se fait passer pour utile), logiciel espion, ransomware.
Associez chaque menace à une défense : hameçonnage/pharming → vérifier l'URL ; force brute → mots de passe forts + authentification à deux étapes ; interception → chiffrement ; piratage/DDoS → un pare-feu.
Un cookie de session est supprimé lorsque vous fermez le navigateur ; un cookie persistant est enregistré pour vous reconnaître entre les visites.
1 Décrire comment les capteurs, les microprocesseurs et les actionneurs peuvent être utilisés conjointement pour créer des systèmes automatisés
2 Décrire les avantages et inconvénients d'un système automatisé utilisé pour un scénario donné
• Y compris des scénarios provenant de : – industrie – transport – agriculture – météo – jeu vidéo – éclairage – science
Source : Programme Cambridge International
Un système automatisé 自动化系统 est un mélange de logiciels et de matériel qui capte et répond aux données dans son environnement 环境, sans besoin d'intervention humaine 人工干预. En d'autres termes, il fonctionne tout seul.
Exemples de systèmes automatisés :
un système de chauffage central 中央供暖;
un processus chimique 化学过程 dans une usine;
une serre 温室 (pour cultiver des plantes);
une barrière de parking 停车场道闸.
Capteurs, microprocesseurs et actionneurs
Trois parties travaillent ensemble dans un système automatisé.
Partie
Rôle
capteur 传感器
mesure une grandeur physique (telle que la température ou la lumière) et envoie les données
microprocesseur 微处理器
compare les données avec des valeurs stockées et prend des décisions
actionneur 执行器
reçoit un signal et provoque un mouvement ou une action (comme ouvrir une vanne)
Le cycle fonctionne comme ceci :
Le capteur envoie des données au microprocesseur.
Le microprocesseur compare ces données avec des valeurs stockées 存储值 et prend une décision.
Le microprocesseur envoie des signaux aux actionneurs pour prendre des mesures.
Par exemple, dans une serre : un capteur de température lit la chaleur ; le microprocesseur le compare à la valeur souhaitée ; s'il fait trop chaud, le microprocesseur signale à un actionneur d'ouvrir une fenêtre.
Un capteur alimente le microprocesseur, qui compare la lecture avec une valeur stockée et signale à un actionneur ; la boucle se répète ensuite
Le programme mentionne de nombreux types de capteurs 传感器类型, chacun lisant une grandeur physique – par exemple un accéléromètre 加速度计 (mouvement ou inclinaison), un capteur d'humidité 湿度 (eau dans l'air), et un capteur de proximité 接近 (un objet proche) :
Capteur
Mesure
Utilisation typique
température
chaleur
fours, serres, chauffage
lumière
luminosité
éclairages automatiques, caméras
pression
force sur une surface
tapis d'alarme, écrans tactiles
infra-rouge / proximité
un objet proche
portes automatiques, capteurs de stationnement
acoustique (son)
niveau sonore
moniteurs de bruit
humidité / humidité
eau dans l'air ou le sol
serres, irrigation
gaz
présence d'un gaz
alarmes de fumée et CO
pH
acidité
piscines, aquariums
accéléromètre
mouvement ou inclinaison
téléphones, déclencheurs de coussins gonflables
champ magnétique
magnétisme
contacts de porte, boussoles
débit / niveau
écoulement de fluide ou profondeur
tuyaux, réservoirs
Pour choisir un capteur pour un scénario donné, choisissez celui qui lit la bonne grandeur physique : un aquarium nécessite des capteurs de pH et de température ; une porte automatique nécessite un capteur infra-rouge / proximité.
Avantages et inconvénients
Les systèmes automatisés sont utilisés dans de nombreuses situations, telles que l'industrie, les transports, l'agriculture 农业 (culture), la météo (collecte de données), les jeux vidéo et l'éclairage.
Les avantages et inconvénients des systèmes automatisésUn drone caméra : il peut voler tout seul le long d'une trajectoire définie pour collecter des données
Avantages
Inconvénients
travaillent jour et nuit, sans repos
coûtent cher à acheter et à mettre en place
plus rapides et plus réguliers consistent que les humains
peuvent tomber en panne et nécessitent une réparation experte
peuvent travailler dans des endroits dangereux pour les humains
peuvent remplacer les emplois humains
moins d'erreurs humaines
ne peuvent pas facilement réagir à une situation pour laquelle ils n'ont pas été conçus
Exemple résolu. Décrivez comment une serre automatique maintient la température à 25 °C. Un capteur de température mesure en continu la température et envoie sa lecture, convertie en numérique par un CNA, au microprocesseur. Le microprocesseur compare cette lecture avec la valeur stockée de 25 °C. Si la température est supérieure, le microprocesseur signale à un actionneur d'ouvrir une fenêtre ou d'allumer un ventilateur ; si elle est inférieure, il allume un chauffage. L'ensemble de la boucle se répète continuellement. Deux points sont presque toujours attribués aux mots-clés « compare avec une valeur stockée (préréglée) » et « le processus se répète » — une description qui s'arrête à « le capteur dit à l'ordinateur » les fait manquer.
Explorer
Une boucle de commande automatisée
Tournez autour de la boucle. Un système automatisé détecte, compare avec une cible, puis agit — et comme l'action change ce qu'il détecte, il se corrige constamment sans humain nécessaire.
• La robotique est une branche de l'informatique qui intègre la conception, la construction et l'exploitation de robots • Exemples incluent l'équipement d'usine, les robots domestiques et les drones
2 Décrire les caractéristiques d'un robot
• Y compris : – une structure mécanique ou un cadre – des composants électriques, tels que des capteurs, des microprocesseurs et des actionneurs – programmable
3 Comprendre les rôles que les robots peuvent remplir et décrire les avantages et inconvénients de leur utilisation
• Les robots peuvent être utilisés dans divers domaines, y compris : – industrie – transport – agriculture – médecine – milieu domestique – divertissement
Source : Programme Cambridge International
Robotique 机器人技术 is the branch of technology that deals with the design, building and operation of robots 机器人.
Un robot possède ces caractéristiques :
une structure physique 物理结构 (un corps mécanique 机械的, tel que des bras) ;
des composants électriques 电子元件 (moteurs, capteurs et câblage) ;
des instructions programmables 可编程指令 — il suit un programme qui peut être modifié.
Ce que font les robots
Les robots peuvent remplir de nombreux rôles, par exemple :
équipement d'usine 工厂设备 — construire des voitures, souder, déplacer des pièces lourdes ;
appareils ménagers 家用电器 — comme un aspirateur robot vacuum cleaner 吸尘器.
Un bras robotique industriel. Il suit un programme et peut être reprogrammé pour effectuer une nouvelle tâche.Un robot aspirateur : un robot domestique qui se déplace automatiquement pour nettoyer le sol
Avantages
Inconvénients
effectuent des tâches ennuyeuses ou dangereuses
coûteux à acheter et à entretenir
travaillent vite et avec précision
peuvent remplacer des travailleurs humains
ne se fatiguent ni ne s'ennuient
un robot présente un manque de prise de décision autonome 缺乏独立决策 — il ne fait que ce pour quoi il est programmé
Une limite essentielle du robot est qu'il ne peut pas penser seul. Il ne peut pas prendre ses propres décisions lorsqu'un événement inattendu survient.
Explorer
Laboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
1 Comprendre ce que signifie l'intelligence artificielle (IA)
• L'IA est une branche de l'informatique traitant de la simulation de comportements intelligents par les ordinateurs
2 Décrire les principales caractéristiques de l'IA en tant que collection de données et les règles pour utiliser ces données, la capacité de raisonner, et elle peut inclure la capacité d'apprendre et de s'adapter
3 Expliquer le fonctionnement de base et les composants des systèmes d'IA pour simuler un comportement intelligent
• Limité à : – systèmes experts – apprentissage automatique • Les systèmes experts ont une base de connaissances, une base de règles, un moteur d'inférence et une interface • L'apprentissage automatique est le fait qu'un programme ait la capacité d'adapter automatiquement ses propres processus et/ou ses données
Source : Programme Cambridge International
Intelligence artificielle 人工智能 (IA) is the simulation 模拟 of human intelligence by computer systems. Cela signifie qu'un ordinateur effectue des tâches nécessitant normalement la pensée humaine.
Caractéristiques de l'IA
Les systèmes d'IA possèdent généralement ces fonctionnalités :
ils collectent des données et les règles 规则 pour utiliser ces données ;
ils ont la capacité de raisonner 推理 (résoudre des problèmes en utilisant les règles) ;
ils ont la capacité de tirer des conclusions 得出结论, qui peuvent être approximatives 近似的 (une meilleure estimation) ou définies 确定的 (certaines) ;
ils ont la capacité d'apprendre 学习 à partir de données ;
ils ont la capacité de s'adapter 适应 — de modifier leur comportement selon les nouvelles données reçues.
Un système d'IA collecte des données, applique des règles, agit, puis apprend et s'améliore
Exemples d'IA
systèmes experts 专家系统 — logiciels qui donnent des conseils comme un expert humain (par exemple, aider un médecin à poser un diagnostic) ;
traitement du langage naturel 自然语言处理 — compréhension de la parole ou du texte humain ;
voitures autonomes 自动驾驶汽车.
Une voiture autonome : des capteurs sur la voiture permettent à un ordinateur de la diriger sans conducteur
À l'intérieur d'un système expert
Un système expert 专家系统 stocke l'expertise humaine et raisonne à partir de celle-ci. Il comprend quatre parties :
une base de connaissances 知识库 – les faits stockés sur le sujet ;
une base de règles 规则库 – les règles « si… alors… » qu'appliquerait un expert humain ;
non moteur d'inférence 推理引擎 – applique les règles aux faits pour aboutir à une conclusion ;
une interface utilisateur 用户界面 – pose des questions à l'utilisateur et affiche le résultat.
L'interface collecte les faits auprès de l'utilisateur ; le moteur d'inférence applique la base de règles à la base de connaissances ; et le système produit un diagnostic ou une probabilité — utilisé pour aider un médecin à diagnostiquer une maladie ou pour détecter une panne automobile.
Apprentissage automatique
Apprentissage automatique 机器学习 is a program that improves its own performance through experience, sans être explicitement reprogrammé. Il trouve des modèles dans les données et s'adapte : un moteur de recherche devient meilleur pour classer les résultats, un assistant vocal reconnaît plus précisément les commandes vocales, et un aspirateur robot apprend progressivement l'aménagement d'une pièce.
IA étendue, générale et forte
L'IA étendue effectue une seule tâche (toute l'IA actuelle) ; l'IA générale pourrait effectuer n'importe quelle tâche humaine ; l'IA forte serait consciente d'elle-même — aucune n'existe encore
Type
Ce que cela signifie
IA étendue 弱人工智能
ne peut effectuer qu'une seule tâche ou un petit ensemble de tâches (par exemple, un programme d'échecs). Toute l'IA actuelle est une IA étendue.
IA générale 通用人工智能
pourrait effectuer n'importe quelle tâche qu'un humain peut faire, en passant d'une tâche à une autre très différente.
IA forte 强人工智能
penserait et serait consciente comme un véritable esprit humain. Cela n'existe pas encore.
Explorer
Laboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Apprendre la boucle de contrôle : un capteur mesure une grandeur → le microprocesseur la compare à une valeur stockée → un actionneur exécute une action ; ensuite la boucle se répète.
Ne pas confondre les composants : un capteur envoie des données vers l'intérieur ; un actionneur provoque un mouvement vers l'extérieur.
Un robot suit des instructions programmables et ne peut pas prendre ses propres décisions lorsqu'un événement inattendu survient.
IA simule la pensée humaine : elle collecte des données et des règles, raisonne, tire des conclusions, et peut apprendre et s'adapter.
Connaître les niveaux d'IA : étendues (une seule tâche ; toute l'IA actuelle), générale (n'importe quelle tâche humaine), forte (consciente d'elle-même ; n'existe pas encore).
7
Conception d'algorithmes et résolution de problèmes
1 Comprendre le cycle de développement de programme, limité à : analyse, conception, codage et test
• Y compris l'identification de chaque étape et l'exécution de ces tâches pour chaque étape : – analyse : abstraction, décomposition du problème, identification du problème et des exigences – conception : décomposition, diagrammes de structure, organigrammes, pseudocode – codage : écriture de code de programme et tests itératifs – test : test du code de programme à l'aide de données de test
2 (a) Comprendre que chaque système informatique est composé de sous-systèmes, qui sont constitués de sous-systèmes supplémentaires (b) Comprendre comment un problème peut être décomposé en ses parties constitutives
(c) Utiliser différentes méthodes pour concevoir et construire une solution à un problème
• Y compris : – diagrammes de structure – organigrammes – pseudocode
3 Expliquer le but d'un algorithme donné
• Y compris : – énoncer le but d'un algorithme – décrire les processus impliqués dans un algorithme
4 Comprendre les méthodes standards de solution
• Limité à : – recherche linéaire – tri bulle – addition – comptage – recherche des valeurs maximales, minimales et moyennes
5 (a) Comprendre la nécessité d'effectuer des vérifications de validation sur les données d'entrée et les différents types de vérification de validation
• Y compris : – contrôle de plage – contrôle de longueur – contrôle de type – contrôle de présence – contrôle de format – chiffre de contrôle
(b) Comprendre la nécessité d'effectuer des contrôles de vérification sur les données d'entrée et les différents types de contrôle de vérification
• Y compris : – contrôle visuel – contrôle par double saisie
6 Suggérer et appliquer des données de test appropriées
• Limité à : – normal – anormal – extrême – aux limites • Les données extrêmes sont la valeur acceptable la plus grande/la plus petite • Les données aux limites sont la valeur acceptable la plus grande/la plus petite et la valeur rejetée correspondante la plus petite/la plus grande
7 Remplir une table de traçage pour documenter un exécutable à sec d'un algorithme
• Y compris, à chaque étape d'un algorithme : – variables – sorties – invites utilisateur
8 Identifier les erreurs dans des algorithmes donnés et suggérer des moyens de corriger ces erreurs
9 Rédiger et modifier des algorithmes pour des problèmes ou des scénarios donnés, en utilisant : du pseudocode, du code programme et des organigrammes
• La précision est requise lors de la rédaction des algorithmes, ex. x > y est acceptable mais x is greater than y ne l'est pas • Voir la section 4 pour les symboles d'organigramme • Voir la section 4 pour le pseudocode
Source : Programme Cambridge International
7.1
Cycle de développement logiciel
Le cycle de développement logiciel 程序开发生命周期 is the set of stages used to make a program. There are four stages.
Le logiciel est écrit par des programmeurs, qui suivent le cycle de développement
Étape
Ce que vous faites
analyse 分析
étudier le problème et déterminer ce qui est nécessaire
conception 设计
planifier comment fonctionnera le programme
codage 编码
écrire le code du programme et le tester au fur et à mesure
test 测试
exécuter le programme terminé avec des données de test pour trouver des erreurs
Les quatre étapes du développement de programmes ; le test renvoie vers la conception pour corriger et affinerUn organigramme de programme énonce les étapes et les décisions d'un programme pendant la phase de conception
Analyse
En analyse, vous comprenez le problème. Deux compétences clés aident :
abstraction 抽象 — conserver uniquement les détails importants et ignorer le reste ;
décomposition 分解 — diviser un grand problème en petites parties plus faciles à gérer.
Conception
En conception, vous planifiez la solution, souvent en utilisant la décomposition. Vous pouvez représenter les parties sous forme de sous-systèmes 子系统 dans un diagramme structurel 结构图 (un diagramme qui divise un système en petites boîtes).
Codage et test
En codage, vous écrivez le code du programme. Vous utilisez un test itératif 迭代测试 — testez de petites parties encore et encore au fur et à mesure de leur construction. En test, vous exécutez l'ensemble du programme avec des données de test 测试数据 pour vérifier qu'il fonctionne correctement.
program development life cycle/ˈprəʊɡræm dɪˈveləpmənt laɪf ˈsaɪkl/
程序开发生命周期
chéng xù kāi fā shēng mìng zhōu qī
analysis/əˈnæləsɪs/
分析
fēn xī
design/dɪˈzaɪn/
设计
shè jì
coding/ˈkəʊdɪŋ/
编码
biān mǎ
testing/ˈtestɪŋ/
测试
cè shì
abstraction/əbˈstrækʃn/
抽象
chōu xiàng
decomposition/ˌdiːkɒmpəˈzɪʃn/
分解
fēn jiě
sub-systems/sʌb ˈsɪstəmz/
子系统
zi xì tǒng
structure diagram/ˈstrʌktʃə ˈdaɪəɡræm/
结构图
jié gòu tú
iterative testing/ˈɪtərətɪv ˈtestɪŋ/
迭代测试
dié dài cè shì
flowchart/ˈfləʊtʃɑːt/
流程图
liú chéng tú
7.2
Outils de conception
Vous pouvez planifier une solution de trois manières principales.
non diagramme structurel — montre les parties d'un système et comment elles s'emboîtent ;
non organigramme 流程图 — un diagramme utilisant des boîtes et des flèches pour montrer les étapes dans l'ordre ;
pseudo-code 伪代码 — étapes écrites en anglais simple, semblable à du code (pas un vrai langage).
Un organigramme pour l'algorithme de somme, utilisant les symboles standards (début/fin, entrée/sortie, traitement, décision)
7.3
Algorithmes
Tri à bulles, passe par passe
Un algorithme 算法 is a set of steps, in the right order, that solves a problem. Every algorithm can be split into three parts :
entrée 输入 — les données qui entrent ;
traitement 处理 — le travail effectué sur les données ;
sortie 输出 — le résultat qui sort.
Cela s'appelle la décomposition en entrées, traitements et sorties. Par exemple, pour « trouver la moyenne de trois notes » : les entrées sont les trois notes ; le traitement consiste à les additionner et à diviser par 3 ; la sortie est la moyenne.
Tout algorithme se décompose en entrée, traitement et sortie — ici, trouver la moyenne de trois notes
Lorsqu'une donnée est saisie, vous la vérifiez pour réduire les erreurs.
La validation vérifie que les données sont sensées et respectent les règles. Elle ne peut pas vérifier que les données sont vraies, seulement qu'elles sont autorisées.
Contrôle de validation
Ce qu'il vérifie
contrôle de plage 范围检查
la valeur est comprise entre une valeur minimale et maximale autorisée
contrôle de longueur 长度检查
le nombre de caractères est autorisé (ex. mot de passe ≥ 8)
contrôle de type 类型检查
les données sont du bon type (ex. un nombre, pas des lettres)
contrôle de présence 存在性检查
quelque chose a effectivement été saisi (non laissé vide)
format check 格式检查
les données suivent le bon format (ex. une date au format jj/mm/aaaa)
check digit 校验码
un chiffre supplémentaire confirme qu'un numéro a été saisi correctement
Verification 核实 vérifie que les données ont été copiées ou saisies correctement (aucune erreur de frappe). Deux méthodes :
visual check 目视检查 — une personne compare les données saisies avec l'original ;
double entry 双重输入 — les données sont saisies deux fois et les deux copies sont comparées.
déterminer ce que fait un algorithme en le suivant avec des données données.
Exemple : tracez cet algorithme avec l'entrée 5.
INPUT N
Total ← 0
FOR I ← 1 TO N
    Total ← Total + I
NEXT I
OUTPUT Total
i
total
OUTPUT
1
1
2
3
3
6
4
10
5
15
15
Le tableau de traçage montre que l'algorithme additionne 1 à n. Avec l'entrée 5, la sortie est 15.
Worked example. Tracez cet algorithme et donnez la sortie.
X ← 20
Count ← 0
WHILE X > 1
    X ← DIV(X, 2)
    Count ← Count + 1
ENDWHILE
OUTPUT Count
DIV ne donne que la partie entière d'une division. Prenez une ligne par passage : x devient 10 (count 1), puis 5 (count 2), puis 2 (count 3), puis 1 (count 4). Maintenant x > 1 est faux, donc la boucle s'arrête et la sortie est 4. Deux habitudes protègent ces points : testez la condition avant chaque passage plutôt qu'après, et écrivez une nouvelle ligne pour chaque passage — essayer de garder les valeurs en tête est ce qui fait échouer les traces.
Explorer
Une table de traçage
Parcourez la boucle et remplissez la table de traçage, une ligne par passage.
Une recherche linéaire 线性查找 vérifie chaque élément d'une liste, un par un, jusqu'à ce qu'il trouve la valeur souhaitée ou atteigne la fin.
Found ← FALSE
FOR I ← 0 TO 9
    IF List[I] = SearchValue
      THEN
        Found ← TRUE
    ENDIF
NEXT I
OUTPUT Found
La recherche linéaire vérifie chaque élément à tour de rôle depuis le début jusqu'à trouver la valeur
Tri à bulles
Un bubble sort 冒泡排序 met une liste en ordre. Il compare chaque paire d'éléments côte à côte et les échange s'ils sont dans le mauvais ordre. Il répète cela jusqu'à ce qu'aucun échange ne soit nécessaire.
FOR I ← 0 TO 8
    IF List[I] > List[I + 1]
      THEN
        Temp ← List[I]
        List[I] ← List[I + 1]
        List[I + 1] ← Temp
    ENDIF
NEXT I
Le tri à bulles compare chaque paire côte à côte et les échange si elles sont dans le désordre, en répétant jusqu'à ce qu'elles soient triées
Totaliser et compter
totalling 求和 — continuer à ajouter des valeurs à un total cumulatif (Total ← Total + Value).
counting 计数 — ajouter 1 à un compteur à chaque fois qu'un événement se produit (Count ← Count + 1).
Maximum, minimum and average
pour trouver le maximum 最大值 : conserver la plus grande valeur vue jusqu'à présent.
pour trouver le minimum 最小值 : conserver la plus petite valeur vue jusqu'à présent.
pour trouver la moyenne 平均值 : diviser le total par le nombre de valeurs.
Total ← 0
FOR I ← 0 TO 9
    Total ← Total + List[I]
NEXT I
Average ← Total / 10
OUTPUT Average
Apprenez les quatre étapes du cycle de vie : analyse → conception → codage → test. Abstraction conserve uniquement les détails importants ; décomposition divise un problème en parties plus petites.
Validation vérifie que les données sont cohérentes (vérifications de plage, longueur, type, présence, format) ; verification vérifie qu'elles ont été correctement copiées (visual check ou double entry).
Apprenez les quatre types de données de test : normale (accepté), abnormal (rejeté), extreme (la plus grande/la plus petite encore autorisée), boundary (les valeurs de part et d'autre d'une limite).
Pour comprendre ce qu'un algorithme fait, remplissez une trace table — notez la valeur de chaque variable à chaque étape.
Connaissez les algorithmes standards : recherche linéaire (vérifier chaque élément tour à tour) et bubble sort (échanger les paires côte à côte jusqu'à ce qu'aucun échange ne soit nécessaire).
3 Comprendre et utiliser les entrées et les sorties
4 (a) Comprendre et utiliser le concept de séquence
(b) Comprendre et utiliser le concept de sélection
• Y compris : – instructions IF – instructions CASE
(c) Comprendre et utiliser le concept d'itération
• Y compris : – boucles contrôlées par compteur – boucles à précondition – boucles à postcondition
(d) Comprendre et utiliser les concepts d'accumulation et de comptage
(e) Comprendre et utiliser le concept de gestion des chaînes
• Y compris : – longueur – sous-chaîne – majuscules – minuscules • Le premier caractère de la chaîne peut être à la position zéro ou un
(f) Comprendre et utiliser les opérateurs arithmétiques, relationnels et logiques
• Arithmétiques, limités à : – + – – – / – * – ^ (élévé à la puissance) – MOD – DIV • Relationnels, limités à : – = – < – <= – > – >= – <> (différent de) • Logiques, limités à : – AND – OR – NOT
5 Comprendre et utiliser les instructions imbriquées
• Y compris la sélection imbriquée et l'itération imbriquée • Les candidats ne seront pas tenus d'écrire plus de trois niveaux d'instructions imbriquées
6 (a) Comprendre ce que signifient les procédures, les fonctions et les paramètres (b) Définir et utiliser des procédures et des fonctions, avec ou sans paramètres (c) Comprendre et utiliser les variables locales et globales
• Les procédures et les fonctions peuvent avoir jusqu'à trois paramètres
7 Comprendre et utiliser les routines de bibliothèque
• Y compris : – MOD – DIV – ROUND – RANDOM
8 Comprendre comment créer un programme maintenable
• Y compris l'utilisation appropriée de : – identifiants significatifs – la fonction de commentaires fournie par le langage de programmation – procédures et fonctions – commentaire pertinent et approprié de la syntaxe • Utiliser des identifiants significatifs pour : – variables – constantes – tableaux – procédures et fonctions
Source : Programme Cambridge International
Une variable 变量 est un espace nommé qui contient une valeur qui peut changer pendant l'exécution du programme. Un constante 常量 est un espace nommé dont la valeur est fixe et ne change pas.
Une variable est un espace nommé dont la valeur peut changerVariables et constantes sont des espaces nommés pour des valeurs, définis dans le code du programme
Vous devez les déclarer 声明 (donner leur nom et leur type) avant utilisation :
DECLARE Score : INTEGER
DECLARE Name : STRING
CONSTANT Pi ← 3.142
Pendant l'exécution d'un programme, ses variables sont stockées dans la mémoire de l'ordinateur (RAM)
Utilisez une constante pour une valeur qui ne change jamais (comme Pi), afin qu'elle soit définie à un seul endroit et facile à lire.
Explorer
Variables et affectation
Parcourez les lignes et regardez chaque variable prendre sa nouvelle valeur.
Chaque programme est construit à partir de trois structures de contrôle.
Les trois structures de contrôle : la séquence exécute les étapes dans l'ordre, la sélection choisit une branche, l'itération répète un corps
Séquence
Séquence 顺序 signifie que les étapes s'exécutent les unes après les autres, dans l'ordre, de haut en bas.
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT Area
Sélection
Sélection 选择 choisit quelles étapes exécuter, selon une condition. Utilisez une instruction IF, ou une instruction CASE lorsqu'il y a plusieurs choix.
IF Score >= 50
  THEN
    OUTPUT "Pass"
  ELSE
    OUTPUT "Fail"
ENDIF
CASE OF Grade
    'A' : OUTPUT "Excellent"
    'B' : OUTPUT "Good"
    OTHERWISE OUTPUT "Keep trying"
ENDCASE
Itération
Itération 迭代 (une boucle 循环) répète des étapes. Il existe trois sortes.
Une count-controlled loop 计数循环 répète un nombre fixe de fois :
FOR I ← 1 TO 5
    OUTPUT "Hello"
NEXT I
Une pre-condition loop 前测循环 vérifie la condition avant chaque répétition, elle peut donc s'exécuter zéro fois :
WHILE Answer <> "stop" DO
    INPUT Answer
ENDWHILE
Une post-condition loop 后测循环 vérifie la condition après chaque répétition, elle s'exécute donc toujours au moins une fois :
REPEAT
    INPUT Password
UNTIL Password = "secret"
Une boucle précondition (WHILE) teste avant le corps, elle peut donc s'exécuter zéro fois ; une boucle postcondition (REPEAT) teste après, elle s'exécute donc au moins une fois
Explorer
Comment une structure IF … ELSE IF décide
Les conditions sont testées de haut en bas ; la PREMIÈRE qui est vraie s'exécute et les autres sont ignorées. Faites glisser la note et regardez quelle branche s'allume.
Explorer
Sélection
Modifiez la valeur et observez quelle branche s'exécute — la sélection en action.
totalling 求和 — continuer à ajouter des valeurs à un total cumulatif : Total ← Total + Value.
counting 计数 — ajouter 1 à un compteur à chaque fois : Count ← Count + 1.
Un compteur augmente de 1 ; un total construit une somme cumuléeUne table de traçage suit un passage par passage une boucle de totalisation et de comptage
Total ← 0
FOR I ← 1 TO 10
    INPUT Mark
    Total ← Total + Mark
NEXT I
OUTPUT Total
Worked example. Un programme doit lire 5 notes, puis afficher le total et la moyenne.
Total ← 0
FOR I ← 1 TO 5
    INPUT Mark
    Total ← Total + Mark
NEXT I
Average ← Total / 5
OUTPUT Total, Average
Deux lignes transportent les notes. Total ← 0 doit être placé avant la boucle : si vous le mettez à l'intérieur, le total est réinitialisé à chaque passage, donc le programme n'affiche que la dernière note. Et Average ← Total / 5 doit être placé après la boucle, car le total n'est pas complet tant que toutes les notes n'ont pas été ajoutées. Initialiser avant, calculer après — cet ordonnancement est ce que la question teste réellement.
(Le premier caractère peut être compté comme position 0 ou position 1, selon le langage.)
Explorer
SUBSTRING : prendre une partie d'une chaîne
Le premier caractère est à la position 1. SUBSTRING(Mot, Début, Longueur) prend Length caractères commençant à Start — faites glisser les deux poignées et lisez l'appel qu'il construit.
Une routine de bibliothèque 库程序 est un morceau de code prêt à l'emploi que vous pouvez utiliser. Vous devez connaître celles-ci :
Routine
Ce qu'elle fait
MOD
donne le reste d'une division
DIV
donne la partie entière d'une division
ROUND
arrondit un nombre réel au nombre de décimales spécifié
RANDOM
donne un nombre aléatoire
8.1
Écrire un programme maintenable
Un programme maintenable 可维护的 est facile à lire et à modifier pour les autres. Pour en créer un :
utilisez des identifiants significatifs 有意义的标识符 — des noms clairs pour les variables, constantes, tableaux, procédures et fonctions (totalScore, pas x) ;
ajoutez des commentaires 注释 pour expliquer ce que font certaines parties du code ;
utilisez des procédures et des fonctions pour diviser le travail en petits blocs.
8.2
Tableaux
Programme
Les candidats doivent être capables de :
Notes et orientations
1 Déclarer et utiliser des tableaux à une dimension (1D) et à deux dimensions (2D)
2 Comprendre l'utilisation des tableaux
• Y compris l'utilisation de variables comme indices dans les tableaux
3 Écrire des valeurs dans un tableau et lire des valeurs à partir d'un tableau en utilisant l'itération
• Le premier indice peut être zéro ou un • Y compris l'itération imbriquée
Source : Programme Cambridge International
Un tableau 数组 est une seule variable qui contient plusieurs valeurs du même type, identifiées par un indice 索引 (un numéro de position).
Tableaux à une dimension
Un tableau à une dimension (1D) 一维数组 est comme une liste unique.
Un tableau 2D est un tableau ; chaque valeur est identifiée par deux indices, [ligne, colonne]
Vous lisez un tableau 2D avec une boucle à l'intérieur d'une boucle (itération imbriquée).
Explorer
Tableaux
Choisissez une ligne et une colonne pour lire une cellule. Les tableaux de Cambridge comptent à partir de 1, et un élément en 2D s'écrit avec UNE paire de crochets — Grid[2, 3].
1 Comprendre l'objectif du stockage des données dans un fichier utilisé par un programme
2 Ouvrir, fermer et utiliser un fichier pour la lecture et l'écriture
• Y compris : – lire et écrire des éléments de données individuels – lire et écrire une ligne de texte
Source : Programme Cambridge International
Un programme peut stocker des données dans un fichier 文件 afin qu'il soit conservé après l'arrêt du programme. Vous devez ouvrir le fichier, l'utiliser, puis le fermer.
OPENFILE "data.txt" FOR WRITE
WRITEFILE "data.txt", "Hello"
CLOSEFILE "data.txt"

OPENFILE "data.txt" FOR READ
READFILE "data.txt", Line
CLOSEFILE "data.txt"
Vous pouvez lire et écrire des éléments de données individuels ou une ligne entière de texte. Fermez toujours un fichier lorsque vous avez terminé avec lui.
Une variable peut changer pendant l'exécution du programme ; une constante est fixe. Apprenez les cinq types de données : entier, réel, caractère, chaîne, booléen.
Tout programme est construit à partir de trois structures : séquence, sélection (IF / CASE), et itération (boucles).
Une boucle WHILE teste avant le corps, donc elle peut s'exécuter zéro fois ; une boucle REPEAT … UNTIL teste après, donc elle s'exécute toujours au moins une fois.
MOD donne le reste et DIV la partie entière d'une division : 17 MOD 5 est 2, 17 DIV 5 est 3.
Une fonction retourne une valeur ; une procédure ne le fait pas. Une variable locale fonctionne uniquement à l'intérieur de son bloc ; une globale fonctionne partout.
3 Comprendre la fonction d'une clé primaire et identifier une clé primaire appropriée pour une table de base de données donnée
4 Lire, comprendre et compléter des scripts SQL (Structured Query Language) pour interroger des données stockées dans une table de base de données unique
• Limité à : – SELECT – FROM – WHERE – ORDER BY DESCENDING – ORDER BY ASCENDING – SUM – COUNT – AND – OR • Identification de la sortie donnée par une instruction SQL qui interrogera le contenu donné d'une table de base de données
Source : Programme Cambridge International
9.1
Qu'est-ce qu'une base de données ?
Une base de données 数据库 est un stockage organisé de données, conçu pour faciliter la recherche, le tri et la mise à jour. Au niveau IGCSE, vous travaillez avec une base de données à table unique 单表数据库 — toutes les données sont contenues dans une seule table.
Un catalogue de cartes de bibliothèque est une base de données sur papier — des enregistrements que vous pouvez rechercher et trier par indiceLes grandes bases de données modernes sont stockées sur des serveurs dans des centres de données
Une clé primaire 主键 est un champ qui contient une valeur unique 唯一的 pour chaque enregistrement. Aucun enregistrement ne peut avoir la même clé primaire, ce qui permet d'identifier exactement un enregistrement.
Dans le tableau ci-dessus, StudentID est une bonne clé primaire car chaque élève a un numéro différent. Un champ comme FormClass serait une mauvaise clé primaire, car de nombreux élèves partagent la même classe.
9.5
Validation dans une base de données
Lorsque des données sont saisies dans une base de données, des validations 验证 vérifient qu'elles sont sensées — par exemple un contrôle de plage sur un champ âge, ou un contrôle de présence pour s'assurer qu'un champ n'est pas laissé vide. (Vous avez vu ces contrôles dans le sujet 7.)
Une vérification de plage accepte des valeurs sensées et rejette les autres
Structured Query Language 结构化查询语言 (SQL) est un langage utilisé pour interroger 查询 une base de données — pour extraire les enregistrements souhaités. Vous devez comprendre et compléter des scripts SQL.
SELECT, FROM et WHERE
SELECT indique quels champs afficher.
FROM indique quelle table utiliser.
WHERE fournit une condition 条件, afin que seuls les enregistrements correspondants soient affichés.
SELECT sélectionne les champs, FROM nomme la table, WHERE définit la condition
SELECT FirstName, FormClass
FROM Student
WHERE FeesPaid = TRUE;
Cela affiche le prénom et la classe de chaque élève qui a payé ses frais.
Utilisez * pour sélectionner tous les champs :
SELECT *
FROM Student
WHERE FormClass = '10A';
ORDER BY
ORDER BY trie les résultats. Utilisez ASC pour un ordre croissant 升序 (le plus petit d'abord, A→Z) ou DESC pour un ordre décroissant 降序 (le plus grand d'abord, Z→A).
SELECT FirstName, DateOfBirth
FROM Student
ORDER BY DateOfBirth ASC;
AND et OR
Joignez les conditions avec AND (les deux doivent être vraies) ou OR (au moins l'une doit être vraie).
SELECT FirstName
FROM Student
WHERE FormClass = '10A' AND FeesPaid = FALSE;
SUM et COUNT
SUM additionne les valeurs d'un champ numérique.
COUNT compte combien d'enregistrements correspondent.
SELECT COUNT(StudentID)
FROM Student
WHERE FeesPaid = FALSE;
Ceci compte combien d'élèves n'ont pas payé. SUM fonctionne de la même manière mais additionne un champ numérique au lieu de compter les lignes.
Calculer la sortie
Pour trouver la sortie d'un script SQL, lisez-le dans cet ordre :
FROM — quelle table ;
WHERE — ne garder que les enregistrements correspondant à la condition ;
SELECT — n'afficher que les champs choisis ;
ORDER BY — ranger les résultats par ordre.
Lisez une requête SQL dans cet ordre : FROM (quelle table), WHERE (quelles lignes), SELECT (quels champs), ORDER BY (trier)
En suivant ces étapes, vous pouvez noter exactement quelles lignes et quelles colonnes la requête retourne.
Exemple résolu. Une table Book a les champs Title, Author, Price et InStock. Écrivez une requête affichant le titre et le prix de chaque livre d'Orwell disponible, du moins cher au plus cher.
SELECT Title, Price
FROM Book
WHERE Author = 'Orwell' AND InStock = TRUE
ORDER BY Price ASC;
Construisez-la dans l'ordre de lecture : FROM nomme la table ; WHERE garde seulement les enregistrements correspondants, et comme il y a deux conditions, ils ont besoin de AND ; SELECT n'affiche que les deux champs demandés ; ORDER BY … ASC les trie. Les valeurs textuelles vont entre des guillemets, et seuls les champs demandés par la question appartiennent à SELECT - ajouter Author simplement parce que vous l'avez filtrée est le moyen le plus courant de perdre une marque ici.
Explorer
SELECT … WHERE
Parcourez une requête : WHERE filtre les lignes, SELECT choisit les colonnes.
1 Identifier et utiliser les symboles standards pour les portes logiques
• Voir la section 4 pour les symboles des portes logiques
2 Définir et comprendre les fonctions des portes logiques
• Incluant : – NON – ET – OU – NAND – NOR – XOR (EOR) – la sortie binaire produite à partir de toutes les entrées binaires possibles • NON est une porte à une seule entrée • Toutes les autres portes sont limitées à deux entrées
3 (a) Utiliser des portes logiques pour créer des circuits logiques donnés à partir d'une : (i) énoncé de problème (ii) expression logique (iii) table de vérité (b) Remplir une table de vérité à partir d'une : (i) énoncé de problème (ii) expression logique (iii) circuit logique
• Les circuits doivent être dessinés pour l'énoncé donné, sans simplification • Les circuits logiques seront limités à un maximum de trois entrées et une sortie • Un exemple de table de vérité avec trois entrées, à compléter : A B C Sortie | 0 0 0 | 0 0 1 | 0 1 0 | 0 1 1 | 1 0 0 | 1 0 1 | 1 1 0 | 1 1 1
(c) Rédiger une expression logique à partir d'une : (i) énoncé de problème (ii) circuit logique (iii) table de vérité
Source : Programme Cambridge International
10.1
Qu'est-ce que la logique booléenne ?
La logique booléenne 布尔逻辑 travaille avec des valeurs qui sont soit vraie soit fausse. En électronique, elles sont représentées par 1 (vrai) et 0 (faux). Une porte logique 逻辑门 prend une ou plusieurs de ces entrées et produit une seule sortie, selon une règle fixe.
Une table de vérité 真值表 répertorie tous les ensembles d'entrées possibles et la sortie pour chacun. On la construit en écrivant toutes les combinaisons d'entrées.
Les portes logiques sont constituées de circuits électroniques comme celui-ci, où chaque porte active des 1 et des 0
10.2
Les six portes logiques
Un circuit logique en action : l'additionneur semi
Vous devez connaître six portes. NOT a une entrée ; toutes les autres ont deux entrées (A et B).
Les six portes logiques. Un petit cercle sur la sortie signifie que le résultat est inversé (NOT, NAND, NOR)Une puce logique réelle : on y trouve des portes logiques comme celles de cette page
Porte NOT
La porte NOT 非门 inverse l'entrée. La sortie est 1 lorsque l'entrée est 0.
A
Sortie
0
1
1
0
Porte AND
La porte AND 与门 donne une sortie 1 uniquement si les deux entrées valent 1.
ET ne produit 1 que si les deux entrées valent 1
A
B
Sortie
0
0
0
0
1
0
1
0
0
1
1
1
Porte OR
La porte OR 或门 donne une sortie 1 lorsque au moins une entrée vaut 1.
OU produit 1 si l'une des entrées vaut 1
A
B
Sortie
0
0
0
0
1
1
1
0
1
1
1
1
Porte NAND
La porte NAND 与非门 est un AND suivi d'un NOT. La sortie est l'inverse de celle du AND.
A
B
Sortie
0
0
1
0
1
1
1
0
1
1
1
0
Porte NOR
La porte NOR 或非门 est un OR suivi d'un NOT. La sortie est l'inverse de celle du OR.
A
B
Sortie
0
0
1
0
1
0
1
0
0
1
1
0
Porte XOR
La porte XOR 异或门 (OR exclusif) donne une sortie 1 lorsque les entrées sont différentes.
A
B
Sortie
0
0
0
0
1
1
1
0
1
1
1
0
Explorer
Les portes logiques
Changez les entrées et choisissez une porte pour voir sa sortie — AND, OR, NOT, NAND, NOR, XOR.
Une expression logique 逻辑表达式 écrit un circuit à l'aide de lettres et de mots de portes. Voici la manière habituelle d'écrire les portes :
Porte
En mots
NON A
NON A
A ET B
A ET B
A OU B
A OU B
Par exemple, l'expression (A AND B) OR (NOT C) signifie : faire A ET B, faire NON C, puis mettre ensemble les deux résultats par un OU.
L'expression X = (A ET B) OU (NON C) dessinée sous forme de circuit logique
Explorer
Tables de vérité
Construisez la table de vérité pour AND, OR, XOR et NOT — la logique derrière chaque expression.
10.4
Circuits logiques
Un circuit logique 逻辑电路 relie des portes entre elles pour accomplir une tâche. La sortie d'une porte peut devenir l'entrée d'une autre. Au IGCSE, un circuit compte jusqu'à trois entrées et une sortie.
Construire le circuit pour X = (A ET B) OU C — la sortie de la porte AND alimente la porte OR
Vous devez être capable de passer d'une forme à quatre formes différentes :
non énoncé de problème 问题陈述 (une description en mots),
une expression logique,
un circuit logique,
une table de vérité.
D'un énoncé de problème à un circuit
Lisez l'énoncé et identifiez les conditions et les mots logiques (and, or, not). Par exemple :
Une alarme (X) se déclenche lorsque la porte est ouverte (A) ET que le système est allumé (B).
C'est X = A AND B, donc vous dessinez une porte AND avec les entrées A et B.
Remplir une table de vérité à partir d'un circuit ou d'une expression
Pour remplir une table de vérité :
Écrivez toutes les combinaisons d'entrées. Pour trois entrées, il y a 8 lignes (de 000 à 111).
Calculez la sortie de chaque porte dans l'ordre, colonne par colonne.
La dernière colonne est la sortie finale.
Trois entrées donnent huit lignes : chaque combinaison comptée en binaire
A
B
C
A ET B
(A ET B) OU C
0
0
0
0
0
0
0
1
0
1
0
1
0
0
0
0
1
1
0
1
1
0
0
0
0
1
0
1
0
1
1
1
0
1
1
1
1
1
1
1
Ajouter une colonne intermédiaire de "travail" pour chaque porte rend la sortie finale facile à remplir. Dessinez toujours le circuit exactement tel qu'il est dit dans l'énoncé, sans le simplifier.
Exemple résolu. Complétez la table de vérité pour X = (A AND B) OR (NOT C) pour la ligne A = 1, B = 0, C = 0. Travaillez à partir des parenthèses vers l'extérieur, une porte à la fois. D'abord A AND B = 1 ET 0 = 0, car AND nécessite que les deux entrées soient 1. Ensuite NOT C = NON 0 = 1. Enfin, mettez ensemble les deux résultats par un OU : 0 OU 1 = 1. Donc X = 1. Donnez à chaque porte intermédiaire sa propre colonne plutôt que de tenter de calculer toute l'expression en une seule étape : avec trois entrées, il y a $2^3 = 8$ lignes, et ces colonnes intermédiaires sont là que les points de la méthode s'appliquent même si la réponse finale manque.
Apprenez les six portes et leurs tables de vérité : NOT, AND, OR, NAND (NON ET), NOR (NON OR), XOR (sortie 1 lorsque les entrées sont différentes).
Construisez une table de vérité avec toutes les lignes d'entrées (2 entrées → 4 lignes, 3 entrées → 8), en comptant en binaire, et ajoutez une colonne de travail pour chaque porte.
Transformez un énoncé de problème en expression logique en identifiant les mots AND / OR / NOT, puis dessinez-le exactement tel qu'il est écrit — ne le simplifiez pas.
NAND et NOR donnent la sortie inverse de AND et OR ; un petit cercle sur la sortie d'une porte signifie que le résultat est inversé.