Códigos de caracteres — ASCII y Unicode
Introducido| English | Significado |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | Unicode |
| character set/ˈkærɪktə set/ | character set |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | encoding |
| code point/kəʊd pɔɪnt/ | code point |
| UTF-8/ˌjuː tiː ˈef eɪt/ | codificación UTF-8 |
El correo electrónico que llegó como basura
- A lo largo de la década de 1990, un mensaje escrito en Varsovia y leído en Tokio a menudo llegaba como una pared de sin sentido. Ambas computadoras almacenaban ocho bits por carácter. Simplemente no coincidían sobre el significado de los primeros 128 patrones.
- La página de código de Polonia colocaba las letras polacas allí. La de Japón colocaba sus propios caracteres allí. Nada se corrompió durante el tránsito: los bytes llegaron intactos y se leyeron contra una tabla diferente.
- La solución fue dejar de tener tablas por país y asignar un número a cada carácter en cada sistema de escritura, para siempre. Eso es Unicode (统一码), y es la razón por la cual el emoji que envías llega como la misma imagen.
- Esta lección explica cómo el texto se convierte en números: conjuntos de caracteres (字符集), ASCII, Unicode y los codificadores que los almacenan.
Un conjunto de caracteres asigna un número a cada carácter
- Una computadora no almacena letras, solo números. Un conjunto de caracteres es el conjunto de caracteres que puede representar una computadora, cada uno con su propio código binario.
- El número de un carácter es su punto de código (码点).
Aes 65,aes 97, y el dígito0es 48. - El punto de código no es el significado del carácter; es una etiqueta acordada. El texto es legible solo porque ambas máquinas utilizan el mismo conjunto de caracteres.
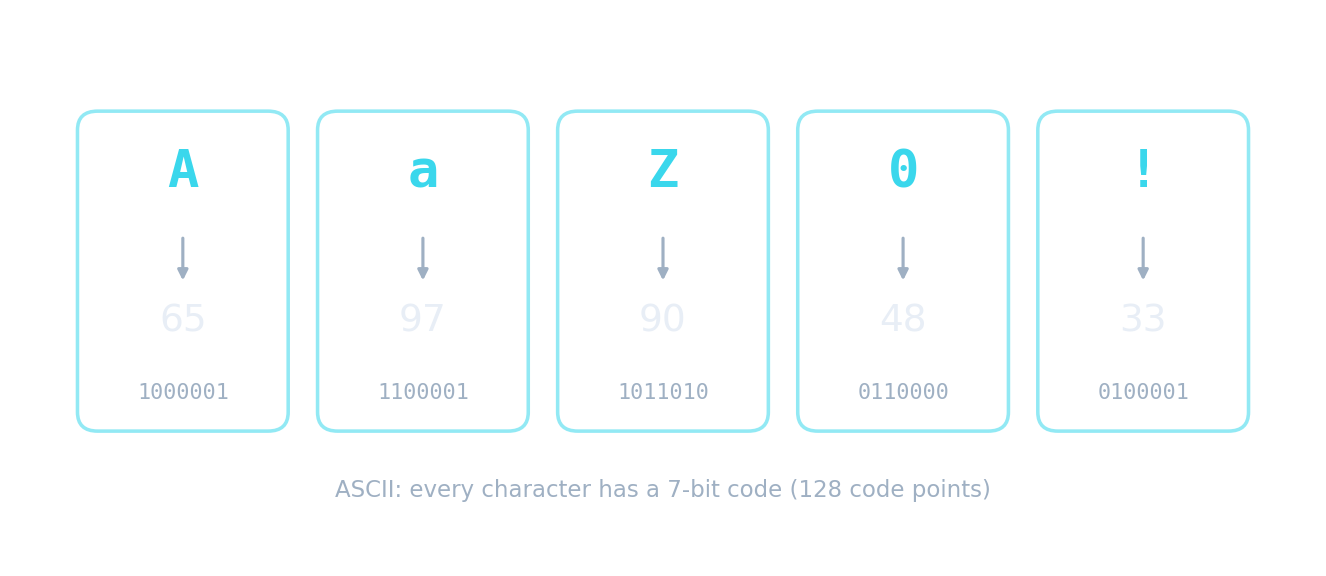
La letra es la imagen; el byte es el número
Un carácter se almacena como un número
Cada carácter tiene un código numérico: 'A' es 65. Invierte los bits para ver ese código en binario y hexadecimal, exactamente como lo guarda el ordenador.
Un conjunto de caracteres como ASCII define:
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Un conjunto de caracteres asigna a cada carácter un número (su punto de código), que es lo que realmente almacena el ordenador.
ASCII
- ASCII (ASCII码), el Código Americano Estándar para Intercambio de Información, utiliza 7 bits, lo que da $2^7 = 128$ puntos de código: las letras latinas básicas, dígitos, puntuación y 32 códigos de control como el retorno de carro.
- ASCII extendido utiliza 8 bits, dando 256 puntos de código. Los primeros 128 son idénticos a ASCII; los últimos 128 varían según la región, lo cual es exactamente lo que rompió ese correo electrónico.
- Nunca se te pedirá memorizar un código, pero sí se te pedirán los conteos: 7 bits, 128; 8 bits, 256.
¿Cuántos puntos de código diferentes tiene ASCII de 7 bits?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
7 bits dan $2^7 = 128$ puntos de código.
¿Cuántos puntos de código diferentes tiene ASCII extendido?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Ocho bits dan $2^{8} = 256$. Los $128$ inferiores coinciden con ASCII estándar de 7-bits; los $128$ superiores varían según la región.
Unicode
- Unicode es un conjunto de caracteres universal: un punto de código para casi cada carácter en cada sistema de escritura vivo o muerto, además de símbolos y emojis, más de 149.000 de ellos.
- El punto de código es independiente de cómo se almacena. Un codificador (编码) convierte un punto de código en bytes.
- UTF-8 (UTF-8编码) usa de 1 a 4 bytes por carácter y es compatible con ASCII: los primeros 128 puntos de código ocupan un byte, idéntico a ASCII. UTF-16 usa 2 o 4 bytes; UTF-32 usa fijos 4.
¿Qué afirmación es cierta sobre UTF-8?
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
UTF-8 es una codificación Unicode de longitud variable (1–4 bytes); sus primeros 128 puntos de código coinciden con ASCII, por lo que el texto ASCII normal es válido UTF-8.
¿Cuál es la relación entre Unicode y UTF-8?
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
El conjunto asigna los números; la codificación decide cuántos bytes ocupa cada número. UTF-16 y UTF-32 son otras codificaciones del mismo conjunto.
Ejemplo resuelto: comparar ASCII y Unicode
- Da una ventaja y una desventaja de usar Unicode en lugar de ASCII. [2]
- Ventaja: Unicode representa muchos más caracteres, por lo que el texto en cualquier sistema de escritura, chino, árabe, griego y emojis puede almacenarse, y un solo documento puede mezclar idiomas; los archivos son portátiles porque no hay una página de código por país de la que discordar.
- Desventaja: para texto solo en inglés, un archivo de Unicode suele ser más grande, porque un carácter puede ocupar más de un byte.
- Se necesitan ambas partes. "Tiene más caracteres" solo vale una marca de dos.
Una ventaja clave de Unicode sobre ASCII es que:
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Unicode cubre casi todos los sistemas de escritura, además de símbolos y emojis — mucho más allá del conjunto básico de inglés de ASCII.
Para texto solo en inglés, un archivo Unicode suele ser más grande que el mismo texto en ASCII.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Las codificaciones Unicode pueden usar más bytes por carácter, por lo que el texto en inglés normal suele ser más grande que en ASCII de 7 bits — el compromiso por la cobertura universal.
¿Cuáles son ventajas de Unicode sobre ASCII? Selecciona todas las que correspondan.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
El tamaño es el compromiso, no una ventaja: para texto en inglés normal, un archivo Unicode suele ser más grande.
Ejemplo resuelto: el tamaño de un archivo de texto
- Un mensaje de 500 caracteres se almacena en ASCII extendido. ¿Cuál es el tamaño del archivo en bytes?
- ASCII extendido usa 8 bits, un byte, por carácter, así que $500 \times 1 = 500$ bytes, o $500 \times 8 = 4000$ bits.
- ¿El mismo mensaje en UTF-32? Cuatro bytes por carácter, así que 2000 bytes.
- Muestra los bits por carácter, multiplica, luego convierte una sola vez. Mezclar bits y bytes a mitad de camino es la pérdida habitual de marcas.
Un mensaje de 500 caracteres se almacena en ASCII extendido. ¿Cuántos bytes necesita (ignorando cualquier encabezado)?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Ocho bits, un byte, por carácter: $500 \times 1 = 500$ bytes, o $4000$ bits. En UTF-32 el mismo texto necesita $2000$ bytes.
Leer un carácter en binario y hexadecimal
- Como un punto de código es simplemente un número, se convierte como cualquier otro.
Aes 65, que es0100 0001en binario y41en hexadecimal. - Dos patrones útiles: los dígitos del
0al9van desde 48, y las minúsculas están 32 más que las mayúsculas, por lo quea(97) esA(65) más 32. Esa diferencia es un solo bit. - Una pregunta que te da
A= 65 y pideEquiere $65 + 4 = 69$, no una tabla memorizada.
El código ASCII de A es 65. ¿Cuál es el código ASCII de E?
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Las letras son consecutivas, así que E está cuatro posiciones después de A. No hay nada que memorizar más allá de un valor ancla.
Marcas que se escapan
- ASCII tiene 7 bits y 128 puntos de código; ASCII extendido tiene 8 bits y 256. No escribas 8 bits para ASCII plano.
- Unicode es un conjunto de caracteres; UTF-8 es un codificador de este. No son dos conjuntos rivales.
- UTF-8 tiene longitud variable, de 1 a 4 bytes, no siempre un byte ni siempre cuatro.
- La desventaja de Unicode es el tamaño del archivo para inglés plano, no "es más lento" o "es más difícil de leer".
Lo has logrado
- Un conjunto de caracteres da a cada carácter un punto de código; el texto son números más un acuerdo sobre cómo leerlos.
- ASCII: 7 bits, 128 puntos de código, solo inglés · ASCII extendido: 8 bits, 256, la mitad superior varía según la región.
- Unicode: un punto de código para cada sistema de escritura y emoji, almacenado mediante un codificador; UTF-8 tiene de 1 a 4 bytes y es compatible con ASCII.
- Unicode gana caracteres, portabilidad e idiomas mixtos; cuesta tamaño de archivo en texto de inglés plano.