La asignatura de Ciencias de la Computación IGCSE (0478) abarca diez temas en dos exámenes: representación de datos, transmisión de datos, hardware, software, internet, tecnologías automatizadas y emergentes, diseño de algoritmos, programación, bases de datos y lógica booleana.
El Paper 1 es teórico y se califica sobre el uso de vocabulario preciso —la diferencia entre RAM y ROM, un compilador y un intérprete, validación y verificación. Son preguntas de definición y una paráfrasis suele no ser suficiente para obtenerlos.
El Paper 2 es de resolución de problemas y programación, donde los puntos se otorgan a un método de trabajo: tablas de trazado, pseudocódigo y código que funcionaría realmente. Domina primero las bases numéricas seguras y la aritmética binaria —aparecen por sí mismas y también dentro de la transmisión de datos, la lógica y el hardware.
Un ordenador solo puede funcionar con dos estados: encendido y apagado. Se escriben como 1 y 0. Un sistema que utiliza solo dos dígitos se llama binario (base 2).
Los ordenadores representan todos los datos —números, texto, sonido e imágenes— como cadenas binarias de 0s y 1s
Cada tipo de dato —números, texto, sonido e imágenes— debe convertirse a binario antes de que un ordenador pueda usarlo. El ordenador procesa este binario utilizando puertas lógicas, y lo almacena en registros (pequeños y rápidos depósitos dentro del procesador).
Un microprocesador contiene millones de transistores diminutos, cada uno es un interruptor que está encendido (1) o apagado (0) —la base física del binario
1 Comprender cómo y por qué los ordenadores utilizan el binario para representar todo tipo de datos
• Cualquier tipo de dato debe convertirse a binario para ser procesado por un ordenador • Los datos se procesan mediante puertas lógicas y se almacenan en registros
2 (a) Comprender los sistemas numéricos decimal, binario y hexadecimal (b) Convertir entre (i) decimales positivos y binarios positivos (ii) decimales positivos y hexadecimales positivos (iii) hexadecimales positivos y binarios positivos
• El sistema decimal es una base 10 • El sistema binario es una base 2 • El sistema hexadecimal es una base 16 • Se utilizarán únicamente valores enteros • Conversiones en ambas direcciones, p. ej., de decimal a binario o de binario a decimal • Longitud máxima del número binario de 16 bits
3 Comprender cómo y por qué se utiliza el hexadecimal como un método beneficioso para la representación de datos
• Deben identificarse las áreas dentro de la informática en las que se utiliza el hexadecimal • El hexadecimal es más fácil de comprender para los seres humanos que el binario, ya que es una representación más corta del mismo
4 (a) Sumar dos enteros binarios positivos de 8 bits (b) Comprender el concepto de desbordamiento (overflow) y por qué ocurre en la suma binaria
• Se producirá un error de desbordamiento si el valor es mayor que 255 en un registro de 8 bits • Un ordenador o dispositivo tiene un límite predefinido que puede representar o almacenar, por ejemplo, 16 bits • Se produce un error de desbordamiento cuando se debe devolver un valor fuera de este límite
5 Realizar un corrimiento lógico binario sobre un entero binario positivo de 8 bits y comprender el efecto que esto tiene sobre el entero binario positivo
• Realizar corrimientos lógicos a la izquierda • Realizar corrimientos lógicos a la derecha • Realizar múltiples corrimientos • Los bits desplazados desde el extremo del registro se pierden y se introducen ceros en el extremo opuesto del registro • El entero binario positivo se multiplica o divide según el desplazamiento realizado • Se pierden el/los bit(s) más significativo(s) o menos significativo(s)
6 Utilizar el sistema numérico de complemento a dos para representar enteros binarios positivos y negativos de 8 bits
• Convertir un entero binario o decimal positivo a un entero de 8 bits en complemento a dos y viceversa • Convertir un entero binario o decimal negativo a un entero de 8 bits en complemento a dos y viceversa
Fuente: Plan de estudios Cambridge International
Contando en binario: 0 a 15
Un sistema numérico es una forma de escribir números usando un conjunto fijo de dígitos. Necesitas conocer tres de ellos.
Sistema
Base
Dígitos usados
Decimal
10
0–9
Binario
2
0 y 1
Hexadecimal
16
0–9 luego A–F
decimal es el sistema de conteo normal (también llamado decimal).
binario usa solo 0 y 1.
hexadecimal usa dieciséis dígitos: 0–9, luego A, B, C, D, E, F equivalen a 10, 11, 12, 13, 14, 15.
La base te dice cuántos dígitos diferentes usa un sistema.
Valor posicional
Cada columna de un número tiene un valor posicional. En binario, los valores se duplican de derecha a izquierda. Para un número de 8 bits son:
128 64 32 16 8 4 2 1
Una tabla de valor posicional de 8 bits: los 1s están debajo de los valores que se suman para dar 150
Un bit es un único 0 o 1. Ocho bits forman un byte. Cuatro bits (la mitad de un byte) son un nibble.
Conversión entre sistemas numéricos
Decimal → binario. Escribe los valores posicionales. Coloca un 1 debajo de cada valor que necesites para que sumen tu número; coloca 0 debajo del resto.
Ejemplo: cambia el decimal 150 a binario. $150 = 128 + 16 + 4 + 2$.
128 64 32 16 8 4 2 1
  1  0  0  1 0 1 1 0
Entonces $150$ = 10010110.
Binario → decimal. Suma los valores posicionales donde hay un 1. 10010110$= 128 + 16 + 4 + 2 = 150$.
Hexadecimal → binario. Cambia cada dígito hexadecimal por su propio grupo de 4 bits (un nibble).
Ejemplo: hex F08. $F = 1111$, $0 = 0000$, $8 = 1000$, así que F08 = 1111 0000 1000.
Cada dígito hexadecimal mapea a su propio nibble de 4 bits —F08 = 1111 0000 1000
Binario → hexadecimal. Agrupa los bits en nibbles de 4, comenzando desde la derecha. Convierte cada nibble a un dígito hexadecimal.
Decimal → hexadecimal. La forma fácil es cambiar primero a binario, luego binario a hex.
Esta tabla ayuda con las letras hex:
Decimal
Binario
Hexadecimal
10
1010
A
11
1011
B
12
1100
C
13
1101
D
14
1110
E
15
1111
F
Las preguntas de Cambridge usan números binarios de hasta 16 bits de largo.
Ejercicio resuelto. Convierte el decimal 100 a binario de 8 bits, luego a hexadecimal.
$100 = 64 + 32 + 4$, así que el binario es 01100100. Al dividirlo en nibbles, 01100100$= 6$ y $4$, así que el hexadecimal es 64.
Por qué se usa hexadecimal
El hex es más corto que el binario y más fácil de leer y escribir para las personas. Un dígito hex reemplaza a 4 dígitos binarios, así que cometes menos errores. El valor no cambia —el hex es simplemente una forma más corta de mostrar el mismo binario.
Los científicos de la computación usan hex para:
Direcciones MAC y direcciones IPv6
Códigos de color en HTML (por ejemplo #FF0000 es rojo)
direcciones de memoria y códigos de error
Mostrar el contenido de la memoria (un "volcado de memoria")
Explorar
Binario, decimal y hexadecimal
Escriba un número y vea su representación en binario, decimal y hexadecimal — y cómo los valores posicionales lo construyen.
Sumando columna por columna; los acarreos se propagan hacia la izquierda. 118 + 48 = 166
Desbordamiento
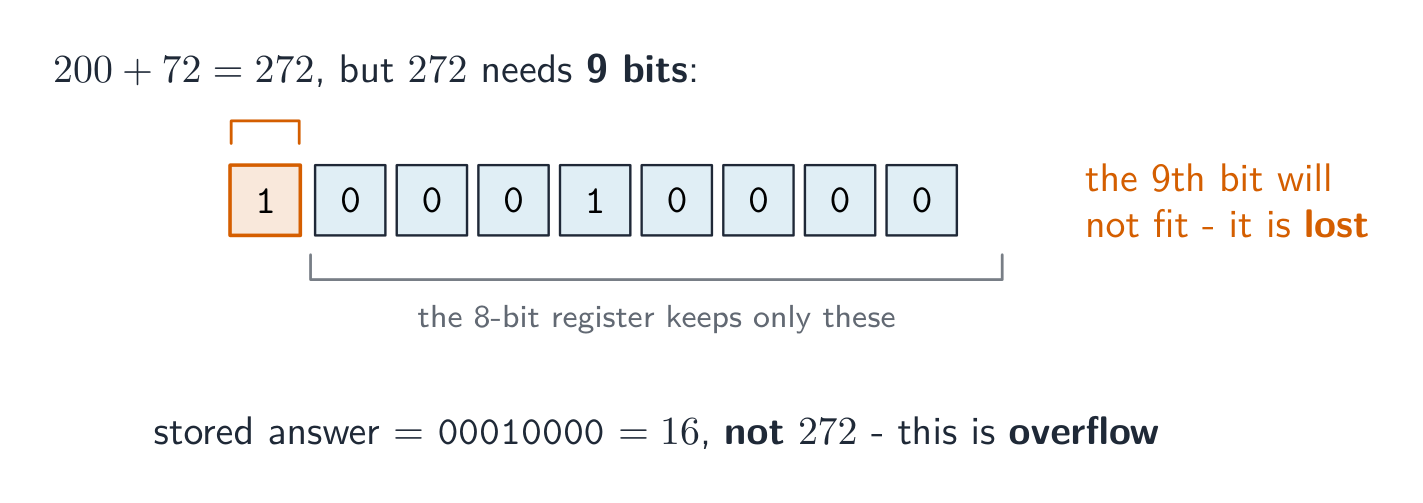
Un registro de 8 bits solo puede contener valores decimales de 0 a 255. Si una suma da un resultado superior a 255, la respuesta necesita un 9º bit. El registro no puede guardar este bit extra, así que se pierde. Esto se llama desbordamiento (un error de desbordamiento). Ocurre cuando un valor sale fuera del límite que el registro puede almacenar.
Ejemplo: 11001000 (200) $+$01001000 (72) $= 272$. En binario eso es 1 00010000, que necesita 9 bits. El 1 inicial no cabrá en 8 bits, así que la respuesta almacenada es incorrecta.
Sumar 200 y 72 necesita 9 bits, pero un registro de 8 bits descarta el noveno, así que la respuesta es incorrecta
Un corrimiento binario lógico mueve todos los bits a la izquierda o a la derecha un cierto número de posiciones.
Los bits que se mueven fuera del extremo del registro se pierden.
Se añaden ceros en el extremo vacío.
Un corrimiento a la izquierda multiplica el número por 2 por cada posición movida. Un corrimiento a la derecha lo divide por 2 por cada posición; los bits más a la derecha (los bits menos significativos) se pierden.
Ejemplo: corrimiento a la izquierda de 00110101 (53) en 2 posiciones.
Un corrimiento a la izquierda de 2: cada bit se mueve 2 posiciones a la izquierda, los bits superiores se pierden y los ceros llenan la derecha
El resultado es 11010100 (212), que es $53 \times 4$. Los dos bits más a la izquierda se perdieron y dos ceros entraron por la derecha. Si se empuja un 1 fuera del extremo, esa información se pierde para siempre.
1.1
Complemento a dos
Hasta ahora los números eran positivos. El complemento a dos permite que un registro de 8 bits contenga también números negativos.
En complemento a dos, el bit más a la izquierda (el bit más significativo, o MSB) tiene un valor posicional negativo:
-128 64 32 16 8 4 2 1
Si el MSB es 0, el número es positivo.
Si el MSB es 1, el número es negativo.
Para hacer un número positivo negativo: escribe el binario positivo, invierte cada bit (0↔1), luego añade 1.
Ejemplo: haz $-40$.
$+40$ = 00101000
invierte los bits = 11010111
añade 1 = 11011000
Entonces $-40$ = 11011000. Verifica sumando los valores posicionales: $-128 + 64 + 16 + 8 = -40$.
El bit más significativo vale −128, así que 11011000 = −128 + 64 + 16 + 8 = −40
Para leer un número en complemento a dos negativo, simplemente suma los valores posicionales (el MSB cuenta como $-128$). El rango de un número en complemento a dos de 8 bits es $-128$ a $+127$.
1.2
Representación de texto
Syllabus
Los candidatos deben ser capaces de:
Notas y orientación
1 Comprender cómo y por qué un ordenador representa el texto y el uso de los juegos de caracteres, incluido el código estándar americano para el intercambio de información (ASCII) y Unicode
• El texto se convierte en binario para ser procesado por un ordenador • Unicode permite una gama mayor de caracteres y símbolos que ASCII, incluyendo diferentes idiomas y emojis • Unicode requiere más bits por carácter que ASCII
2 Comprender cómo y por qué un ordenador representa el sonido, incluidos los efectos de la frecuencia de muestreo y la resolución de muestreo
• Una onda de sonido se muestrea para convertirlo en binario, que es procesado por un ordenador • La frecuencia de muestreo es el número de muestras tomadas en un segundo • La resolución de muestreo es el número de bits por muestra • La precisión de la grabación y el tamaño del archivo aumentan conforme aumentan la frecuencia y la resolución de muestreo
3 Comprender cómo y por qué un ordenador representa una imagen, incluidos los efectos de la resolución y la profundidad de color
• Una imagen es una serie de píxeles que se convierten en binario, que es procesado por un ordenador • La resolución es el número de píxeles en la imagen • La profundidad de color es el número de bits utilizados para representar cada color • El tamaño del archivo y la calidad de la imagen aumentan conforme aumentan la resolución y la profundidad de color
Fuente: Plan de estudios Cambridge International
Los ordenadores almacenan el texto asignando un número a cada carácter, luego almacenando ese número en binario. El conjunto de caracteres que un ordenador puede usar, junto con sus números, es un conjunto de caracteres.
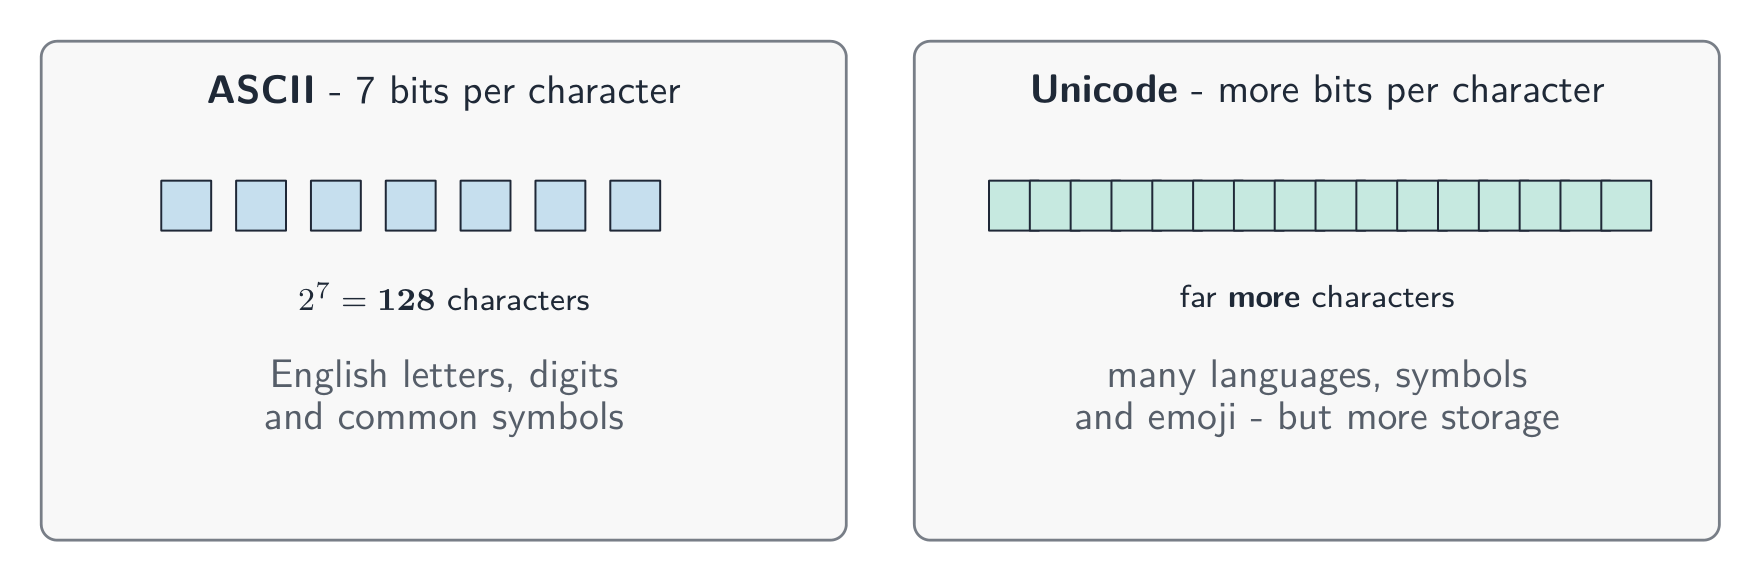
ASCII usa 7 bits por carácter, así que tiene 128 caracteres diferentes. Esto es suficiente para letras inglesas, dígitos y símbolos comunes.
Unicode usa más bits por carácter. Puede representar muchos más caracteres —muchos idiomas, además de símbolos y emojis.
Como Unicode tiene más caracteres, necesita más bits por carácter que ASCII, así que el mismo texto ocupa más almacenamiento.
ASCII usa 7 bits para 128 caracteres; Unicode usa más bits para muchos más caracteres pero requiere más almacenamiento
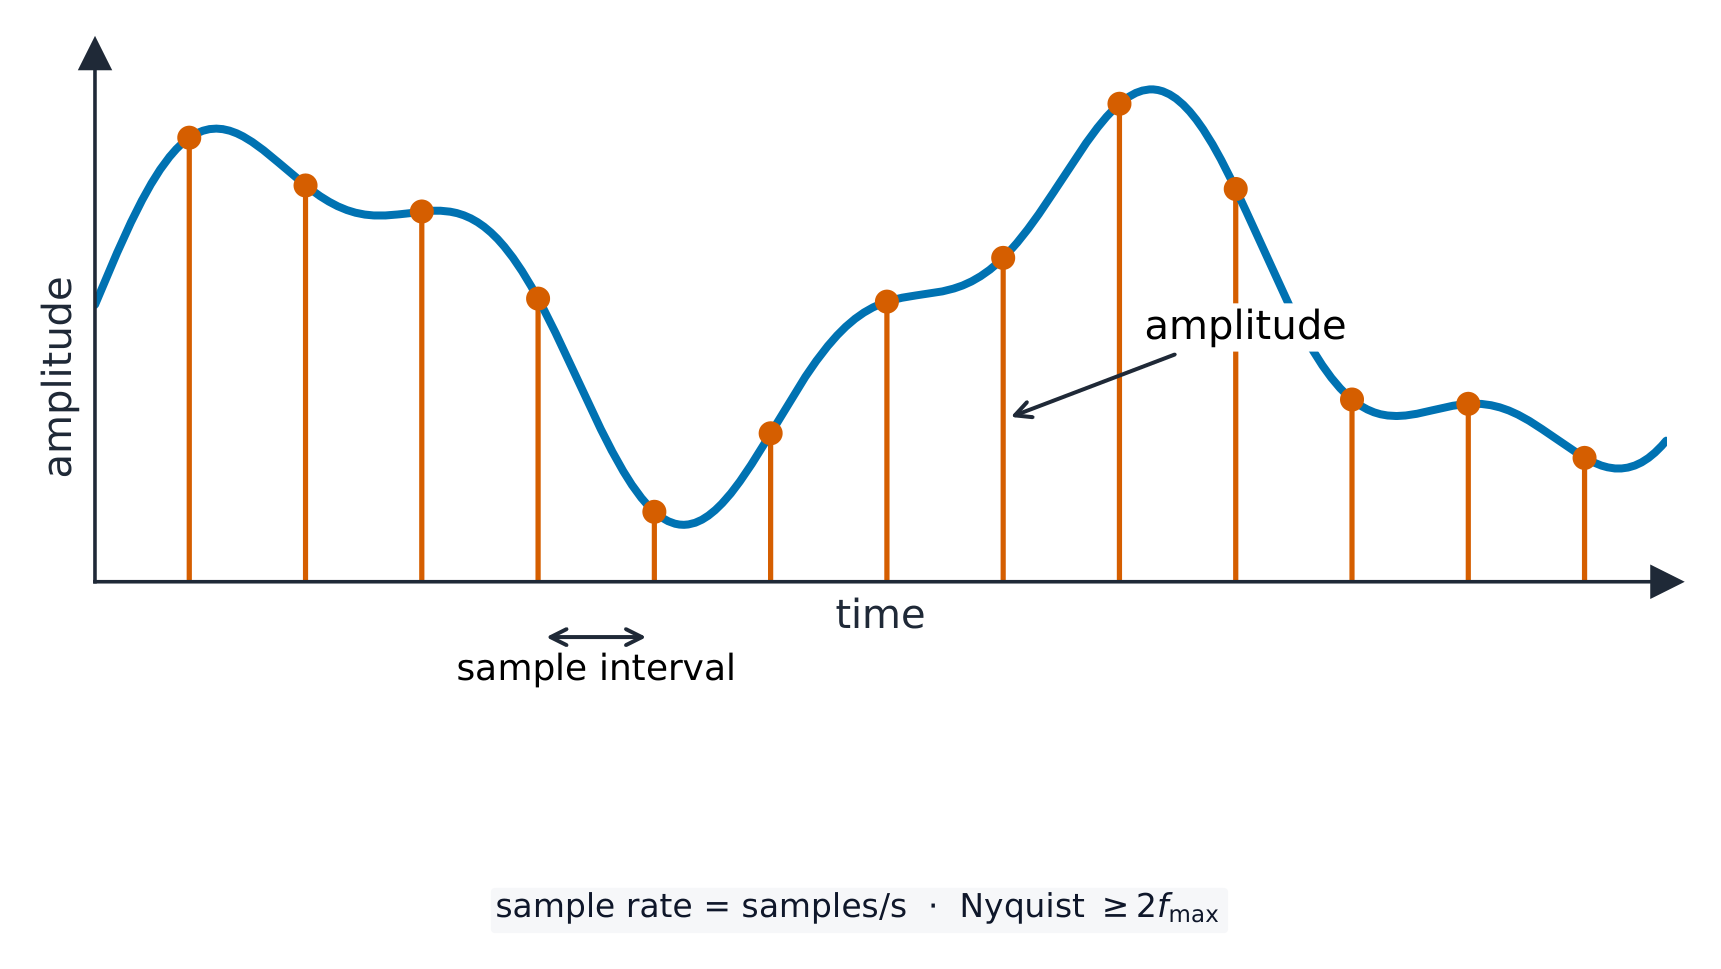
Una onda sonora es suave y siempre changing. Para almacenarla, el ordenador mide la altura de la onda en momentos regulares. Esto se llama muestreo, y cada medición es una muestra.
El muestreo registra la altura de la onda (amplitud) en momentos regulares
frecuencia de muestreo es el número de muestras tomadas cada segundo (medido en Hz).
resolución de muestreo es el número de bits usados para cada muestra. La altura de la onda en un punto de muestra es su amplitud.
Una frecuencia de muestreo más alta y una resolución de muestreo más alta dan una grabación más precisa, pero un archivo más grande.
Explorar
Representación del sonido
y = a sin(bt + c)
El sonido es una onda; el muestreo registra su altura muchas veces por segundo.
1 Entender cómo se mide el almacenamiento de datos
• Incluyendo: – bit – nibble – byte – kibibyte (KiB) – mebibyte (MiB) – gibibyte (GiB) – tebibyte (TiB) – pebibyte (PiB) – exbibyte (EiB) • La cantidad de la denominación anterior presente en el tamaño del almacenamiento de datos, ej.: – 8 bits en un byte – 1024 mebibytes en un gibibyte
2 Calcular el tamaño de archivo de una imagen y de un sonido, utilizando la información proporcionada
• Las respuestas deben darse en las unidades especificadas en la pregunta. Los cálculos deben utilizar la medida de 1024 y no de 1000 • La información proporcionada puede incluir: – resolución e profundidad de color de la imagen – frecuencia de muestreo, resolución y duración de la pista de sonido
3 Entender el propósito y la necesidad de la compresión de datos
• La compresión existe para reducir el tamaño del archivo • El impacto que esto tiene, ej.: – menor ancho de banda requerido – menos espacio de almacenamiento requerido – tiempo de transmisión más corto
4 Entender cómo se comprimen los archivos mediante métodos de compresión con pérdida y sin pérdida
• La compresión con pérdida reduce el tamaño del archivo eliminando permanentemente datos, ej.: reduciendo la resolución o la profundidad de color, reduciendo la frecuencia de muestreo o la resolución • La compresión sin pérdida reduce el tamaño del archivo sin pérdida permanente de datos, ej.: codificación por longitud de carrera (RLE)
Fuente: Plan de estudios Cambridge International
El almacenamiento de datos se mide en las unidades siguientes. Un nibble son 4 bits y un byte son 8 bits; desde el kibibyte hacia arriba, cada unidad es 1024 veces la anterior (porque $1024 = 2^{10}$, lo cual encaja con el binario).
Unidad
Equivale a
bit
un único 0 o 1
nibble
4 bits
byte
8 bits
kibibyte (KiB)
1024 bytes
mebibyte (MiB)
1024 KiB
gibibyte (GiB)
1024 MiB
tebibyte (TiB)
1024 GiB
pebibyte (PiB)
1024 TiB
exbibyte (EiB)
1024 PiB
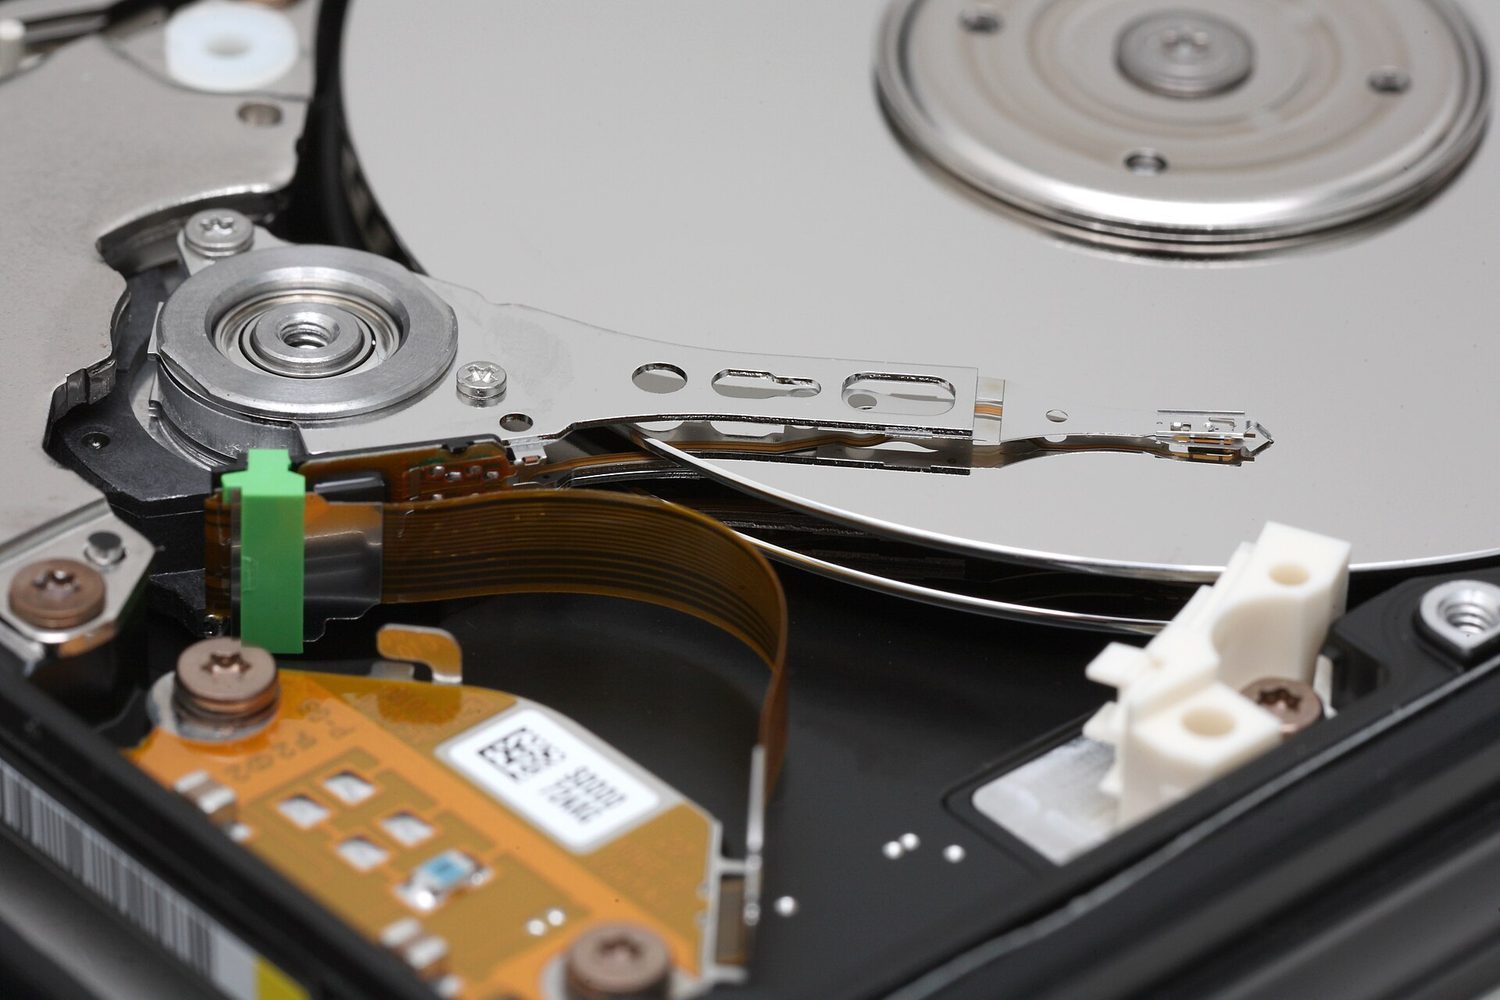
Platos de disco duro: el almacenamiento se mide en bytes —conocer el tamaño de archivo necesita ancho × alto × profundidad de color para imágenes
Tamaño de archivo de sonido (en bits) $=$ frecuencia de muestreo $\times$ resolución de muestreo $\times$ longitud en segundos.
Siempre divide por 1024 (no por 1000) para cambiar a KiB, MiB, etc. Da tu respuesta en la unidad que pida la pregunta.
Ejercicio resuelto. Un sonido se graba durante 30 segundos a una frecuencia de muestreo de 8,000 Hz con una resolución de muestreo de 16 bits. Encuentra el tamaño del archivo en kibibytes (KiB).
La compresión hace que un archivo sea más pequeño. Un archivo más pequeño:
usa menos espacio de almacenamiento,
necesita menos ancho de banda (la cantidad de datos que una conexión puede transportar),
tarda menos tiempo en enviarse (un tiempo de transmisión más corto).
Hay dos tipos.
Compresión sin pérdida
La compresión sin pérdida hace que el archivo sea más pequeño con ninguna pérdida permanente de datos. El archivo original se puede reconstruir exactamente.
Un método es el codificación por recurrencia (RLE). Reemplaza una secuencia de valores repetidos con una copia del valor y un conteo de cuántas veces se repite. Por ejemplo WWWWWWWW (8 blancos) se almacena como "8 W". Esto funciona bien cuando los datos tienen muchas repeticiones.
La codificación por recurrencia almacena cada secuencia una vez como un conteo y un valor
Compresión con pérdida
La compresión con pérdida hace que el archivo sea mucho más pequeño al eliminar permanentemente algunos datos. Los datos eliminados no se pueden recuperar. Por ejemplo:
reducir la resolución o la profundidad de color de una imagen,
reducir la frecuencia de muestreo o la resolución de muestreo de un sonido.
Usa compresión sin pérdida cuando debas mantener cada detalle (archivos de texto y programas). Usa compresión con pérdida para fotos, música y video, donde una pequeña pérdida de calidad vale un archivo mucho más pequeño.
Explorar
Codificación de longitud de corrida
Observe cómo los símbolos repetidos se comprimen en un conteo — compresión sin pérdida simple.
1.3
Consejos para el examen
Convierte decimal → binario restando los valores posicionales (128, 64, 32…); binario → decimal sumando los valores posicionales que contienen un 1.
Para convertir a hex, agrupa el binario en nibbles de 4 bits desde la derecha; cada nibble es exactamente un dígito hex.
El desbordamiento ocurre cuando un resultado necesita más bits de los que tiene el registro (un registro de 8 bits solo guarda 0–255), así que el bit extra se pierde.
Tamaño de archivo en bits: para una imagen, ancho × alto × profundidad de color; para sonido, frecuencia de muestreo × resolución × segundos. Divide por 8 para bytes, luego por 1024 para cada unidad mayor.
La compresión sin pérdida conserva cada bit (texto; codificación por recurrencia); la compresión con pérdida elimina datos permanentemente (fotos, música) para un archivo mucho más pequeño.
Transmisión de datos 数据传输 means moving data from one place to another — for example from your computer to a website, or from a phone to a printer.
Los datos a menudo viajan por un cable. Dos comunes se muestran a continuación.
Un cable Ethernet con conector RJ45, utilizado frecuentemente para transmitir datos en una red cableadaUn cable de fibra óptica transporta datos mediante pulsos de luz a lo largo de finas fibras de vidrio
Antes de ser enviado, los datos se dividen en piezas pequeñas y de tamaño igual llamadas paquetes 数据包. Cada paquete viaja por separado y se vuelven a ensamblar en el otro extremo.
Using packets has benefits:
si se pierde o daña un paquete, solo ese paquete se envía de nuevo, no todo el archivo;
los paquetes pueden tomar rutas diferentes, por lo que se puede evitar una ruta congestionada o rota;
muchos usuarios pueden compartir la misma conexión al mismo tiempo.
1 (a) Comprender que los datos se dividen en paquetes para su transmisión
(b) Describir la estructura de un paquete
• Un paquete de datos contiene una: – cabecera de paquete – carga útil – cola • La cabecera del paquete incluye las: – dirección de destino – número de paquete – dirección del emisor
(c) Describir el proceso de conmutación por paquetes
• Los datos se dividen en paquetes • Cada paquete puede tomar una ruta diferente • Un enrutador controla la ruta que sigue un paquete • Los paquetes pueden llegar desordenados • Una vez que llega el último paquete, los paquetes se reordenan
2 (a) Describir cómo se transmiten los datos de un dispositivo a otro utilizando diferentes métodos de transmisión de datos
Conmutación de paquetes 数据包交换 es la forma en que se envían los paquetes a través de una red.
Los routers reenvían paquetes, y diferentes paquetes pueden tomar rutas diferentes hacia el mismo receptor
Dispositivos especiales llamados routers 路由器 leen la cabecera de cada paquete y eligen la mejor ruta para él.
Cada paquete puede tomar su propia ruta, por lo que los paquetes pueden viajar por caminos diferentes.
Packets may arrive out of order.
Cuando el último paquete ha llegado, los paquetes se reordenan utilizando sus números de paquete.
Explorar
Cómo viajan los datos en paquetes
Recorrer el conmutación por paquetes. Dividir un archivo en paquetes con direcciones es la razón por la que solo se reenvía un paquete perdido, y por qué muchos usuarios pueden compartir la misma línea.
los bits pueden llegar en tiempos ligeramente diferentes por cables largos
Serial envía un bit tras otro a lo largo de un único cable. Paralelo envía varios bits al mismo tiempo a lo largo de varios cables, por lo que es más rápido en distancias cortas.
La transmisión serial envía un bit a la vez por un cable; la paralela envía varios bits a la vez por varios cables
Simplex, semidúplex y dúplex completo
These describe the direction data can travel.
Simplex es un solo sentido; semidúplex es ambos sentidos pero uno a la vez; dúplex completo es ambos sentidos a la vez
Método
Dirección
simplex 单工
una sola dirección (ej. ordenador → impresora)
semidúplex 半双工
ambas direcciones, pero solo una a la vez (ej. walkie-talkie)
dúplex completo 全双工
ambas direcciones al mismo tiempo (ej. llamada telefónica)
Elección de un método
La elección depende de la distancia, la velocidad necesaria, el costo y si los datos deben viajar en ambas direcciones al mismo tiempo.
El bus serie universal (USB) es una interfaz común (un punto de conexión) para conectar dispositivos a un ordenador.
Benefits:
el mismo conector es utilizado por muchos dispositivos (un único estándar);
el dispositivo se detecta automáticamente y se carga el controlador correcto;
transporta energía, por lo que puede cargar o alimentar un dispositivo;
el conector solo encaja en una dirección, por lo que es difícil enchufarlo incorrectamente.
Drawbacks:
el cable tiene una longitud limitada (unos pocos metros);
older USB versions are slower than newer ones;
las velocidades de transferencia pueden ser inferiores a las de otros tipos de conexión.
Algunos de los tipos de conectores USB. Todos utilizan el mismo estándar USB, por lo que los dispositivos se detectan automáticamente.
2.2
Por qué verificamos errores
Syllabus
Los candidatos deben ser capaces de:
Notas y orientación
1 Comprender la necesidad de verificar errores después de la transmisión de datos y cómo pueden producirse estos errores
• Los errores pueden ocurrir durante la transmisión de datos debido a interferencias, p. ej., pérdida de datos, ganancia de datos y cambio de datos
2 Describir los procesos implicados en cada uno de los siguientes métodos de detección de errores para detectar errores en los datos tras la transmisión: comprobación de paridad (impar y par), suma de control y comprobación por eco
• Incluye la comprobación de byte de paridad y bloque de paridad
3 Describir cómo se utiliza un dígito de verificación para detectar errores en la introducción de datos e identificar ejemplos de cuándo se usa un dígito de verificación, incluyendo números de libro estándar internacionales (ISBN) y códigos de barras
4 Describir cómo una solicitud automática de retransmisión (ARQ) puede utilizarse para establecer que los datos se reciben sin errores
• Incluye el uso de: – acuses de recibo positivos/negativos – tiempo de espera (timeout)
Fuente: Plan de estudios Cambridge International
Mientras viajan los datos, la interferencia puede alterarlos. Pueden ocurrir tres errores:
data loss — some bits do not arrive;
data gain — extra bits are added;
data change — some bits are flipped.
Por lo tanto, el receptor verifica si los datos llegaron correctamente.
Una comprobación de paridad añade un bit extra, el bit de paridad, a cada byte. Existen dos tipos:
Se añade un bit de paridad para que el número de 1s sea par (o impar)
paridad par — el número total de 1s en el byte (incluyendo el bit de paridad) debe ser par;
paridad impar — el número total de 1s debe ser impar.
Ejemplo (paridad par): los datos 1011001 tienen cuatro 1s, que ya es par, por lo que el bit de paridad es 0:
parity bit + data
    0        1011001
Para detectar un error: el receptor cuenta los 1s. Si se acordó paridad par, pero llega un byte con un número impar de 1s, ha ocurrido un error durante la transmisión.
Una comprobación de paridad no puede encontrar todos los errores. Si dos bits cambian, el conteo podría seguir pareciendo correcto.
Ejemplo resuelto. Un bit de paridad indica que se produjo un error, pero no dónde. Un bloque de paridad 奇偶校验块 puede localizar el bit exacto. Se envían varios bytes juntos, cada uno con un bit de paridad de fila, y un byte de paridad 奇偶校验字节 adicional en la parte inferior contiene un bit de paridad para cada columna. A continuación se utiliza paridad par y se invirtió un bit durante la transmisión. Encuéntralo.
La fila byte 3 rompe la paridad par, y la columna b3 rompe la paridad par. El bit invertido está donde se cruzan: byte 3, bit b3. Cambiarlo de nuevo de 1 a 0 repara los datos. Un único bit de paridad solo indica que ocurrió un error; un bloque de paridad indica exactamente dónde, por lo que el receptor incluso puede repararlo.
Suma de verificación
Una suma de verificación es un valor calculado a partir de todos los datos antes del envío. El receptor vuelve a calcular la suma de verificación a partir de los datos recibidos. Si los dos valores no coinciden, ha ocurrido un error y se reenvían los datos.
Verificación por eco
En una comprobación por eco, el receptor envía los datos de vuelta al remitente. El remitente los compara con los originales. Si difieren, ocurrió un error. (Esto requiere que los datos se envíen dos veces, por lo que es lento.)
Petición automática de retransmisión (ARQ)
Automatic Repeat reQuest 自动重传请求 (ARQ) uses messages called acknowledgements 确认.
El receptor envía un acuse de recibo positivo si un paquete llegó correctamente, o un acuse de recibo negativo si no lo hizo.
El remitente inicia un temporizador de tiempo de espera. Si no llega una confirmación positiva a tiempo, el remitente vuelve a enviar el paquete.
Dígito de control
Un dígito de control es un dígito extra colocado al final de un número, calculado a partir de los demás dígitos. Se utiliza para detectar errores cuando un número se introduce manualmente.
Cuando se introduce el número, se vuelve a calcular el dígito de control y se compara. Puede detectar:
an incorrect digit entered,
un error de transposición (dos dígitos intercambiados, p. ej., 21 escrito como 12),
un dígito omitido o un dígito extra añadido,
un error fonético (un dígito que suena similar, p. ej., 13 y 30).
Los dígitos de control se utilizan en códigos de barras e ISBNs (números de libro).
Explorar
Laboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
1 Comprender la necesidad y el propósito del cifrado al transmitir datos
2 Comprender cómo se cifran los datos mediante cifrado simétrico y asimétrico
• El cifrado asimétrico incluye el uso de claves pública y privada
Fuente: Plan de estudios Cambridge International
Por qué necesitamos cifrado
La cifrado enmaraña los datos para que no puedan entenderse si son interceptados por la persona equivocada. Los datos legibles se denominan texto claro; después del cifrado se convierten en texto cifrado.
El cifrado no evita que los datos sean interceptados. Solo evita que los datos sean comprendidos.
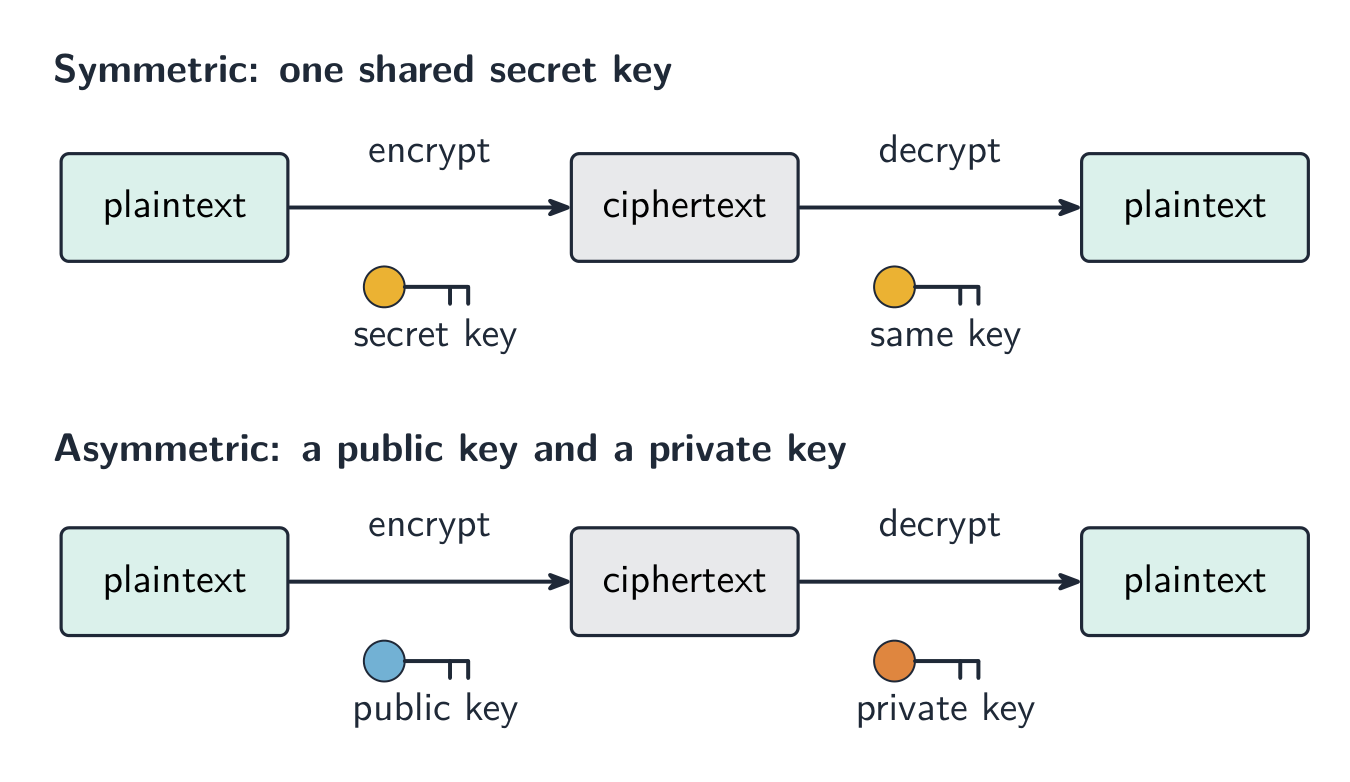
Cifrado simétrico
El cifrado simétrico utiliza una única clave para cifrar y descifrar los datos. El remitente y el receptor deben compartir esta misma clave secreta. El riesgo es que la clave en sí pueda ser robada durante el intercambio.
Cifrado asimétrico
Cifrado asimétrico 非对称加密 uses two different keys:
una clave pública que cualquiera puede tener, utilizada para cifrar;
una clave privada que se mantiene en secreto, utilizada para descifrar.
Los datos cifrados con la clave pública solo pueden descifrarse con la clave privada correspondiente, por lo que la clave nunca tiene que compartirse. Esto es más seguro que compartir una única clave secreta.
Simétrico usa una clave compartida; asimétrico usa una clave pública para cifrar y una clave privada para descifrar
Explorar
El cifrado César
Desplace cada letra para cifrar un mensaje — la idea más simple de un cifrado y su clave.
Los datos se envían en paquetes (una cabecera con las direcciones y el número de paquete, una carga útil y un trailer). Los paquetes pueden tomar rutas diferentes y llegar fuera de orden, luego se reordenan según sus números de paquete.
Relacionar los tipos de transmisión: serie (un bit a la vez, bueno para largas distancias) frente a paralelo (varios bits a la vez, cortas distancias); simplex / semidúplex / dúplex completo describen la dirección.
Un único bit de paridad solo indica que ocurrió un error; un bloque de paridad localiza el bit exacto incorrecto: la fila y la columna que fallan ambas.
Aprende los métodos de detección de errores y qué hace cada uno: comprobación de paridad, suma de verificación, comprobación por eco, ARQ y dígito de control (para números introducidos manualmente).
El cifrado simétrico utiliza una única clave compartida; el asimétrico utiliza una clave pública para cifrar y una privada para descifrar, por lo que nunca se comparte una clave secreta.
1 (a) Comprender el papel de la unidad central de procesamiento (CPU) en una computadora
• La CPU procesa instrucciones y datos que se introducen en la computadora para que el resultado pueda ser enviado a la salida
(b) Comprender qué se entiende por un microprocesador
• Un microprocesador es un tipo de circuito integrado en un solo chip
2 (a) Comprender el propósito de los componentes de una CPU, en una computadora con arquitectura Von Neumann
• Incluyendo: – unidades: unidad aritmética lógica (ALU) y unidad de control (CU) – registros: contador de programa (PC), registro de dirección de memoria (MAR), registro de datos de memoria (MDR), registro de instrucción actual (CIR) y acumulador (ACC) – buses: bus de direcciones, bus de datos y bus de control
(b) Describir el proceso del ciclo de búsqueda-decodificación-ejecución (FDE), incluyendo el papel de cada componente en el proceso
• Cómo se obtienen las instrucciones y los datos de la memoria de acceso aleatorio (RAM) hacia la CPU, cómo se procesan utilizando cada componente y cómo se ejecutan posteriormente • Almacenamiento de datos y direcciones en registros específicos • Uso de buses para transmitir datos, direcciones y señales • Uso de unidades para obtener, decodificar y ejecutar datos e instrucciones
3 Comprender qué se entiende por núcleo, caché y reloj en una CPU y explicar cómo pueden afectar el rendimiento de una CPU
• El número de núcleos, el tamaño de la caché y la velocidad del reloj pueden afectar el rendimiento de una CPU
4 Comprender el propósito y uso de un conjunto de instrucciones para una CPU
• Un conjunto de instrucciones es una lista de todos los comandos que puede procesar una CPU, y los comandos son código máquina
5 Describir el propósito y las características de un sistema embebido e identificar dispositivos en los que se utilizan comúnmente
• Un sistema embebido se utiliza para realizar funciones dedicadas. Por ejemplo, en electrodomésticos, automóviles, sistemas de seguridad, sistemas de iluminación o máquinas expendedoras. Esto difiere de una computadora de propósito general que se utiliza para realizar muchas funciones diferentes. Por ejemplo, en una computadora personal (PC) o una laptop
Fuente: Plan de estudios Cambridge International
El ciclo de búsqueda-decodificación-ejecución
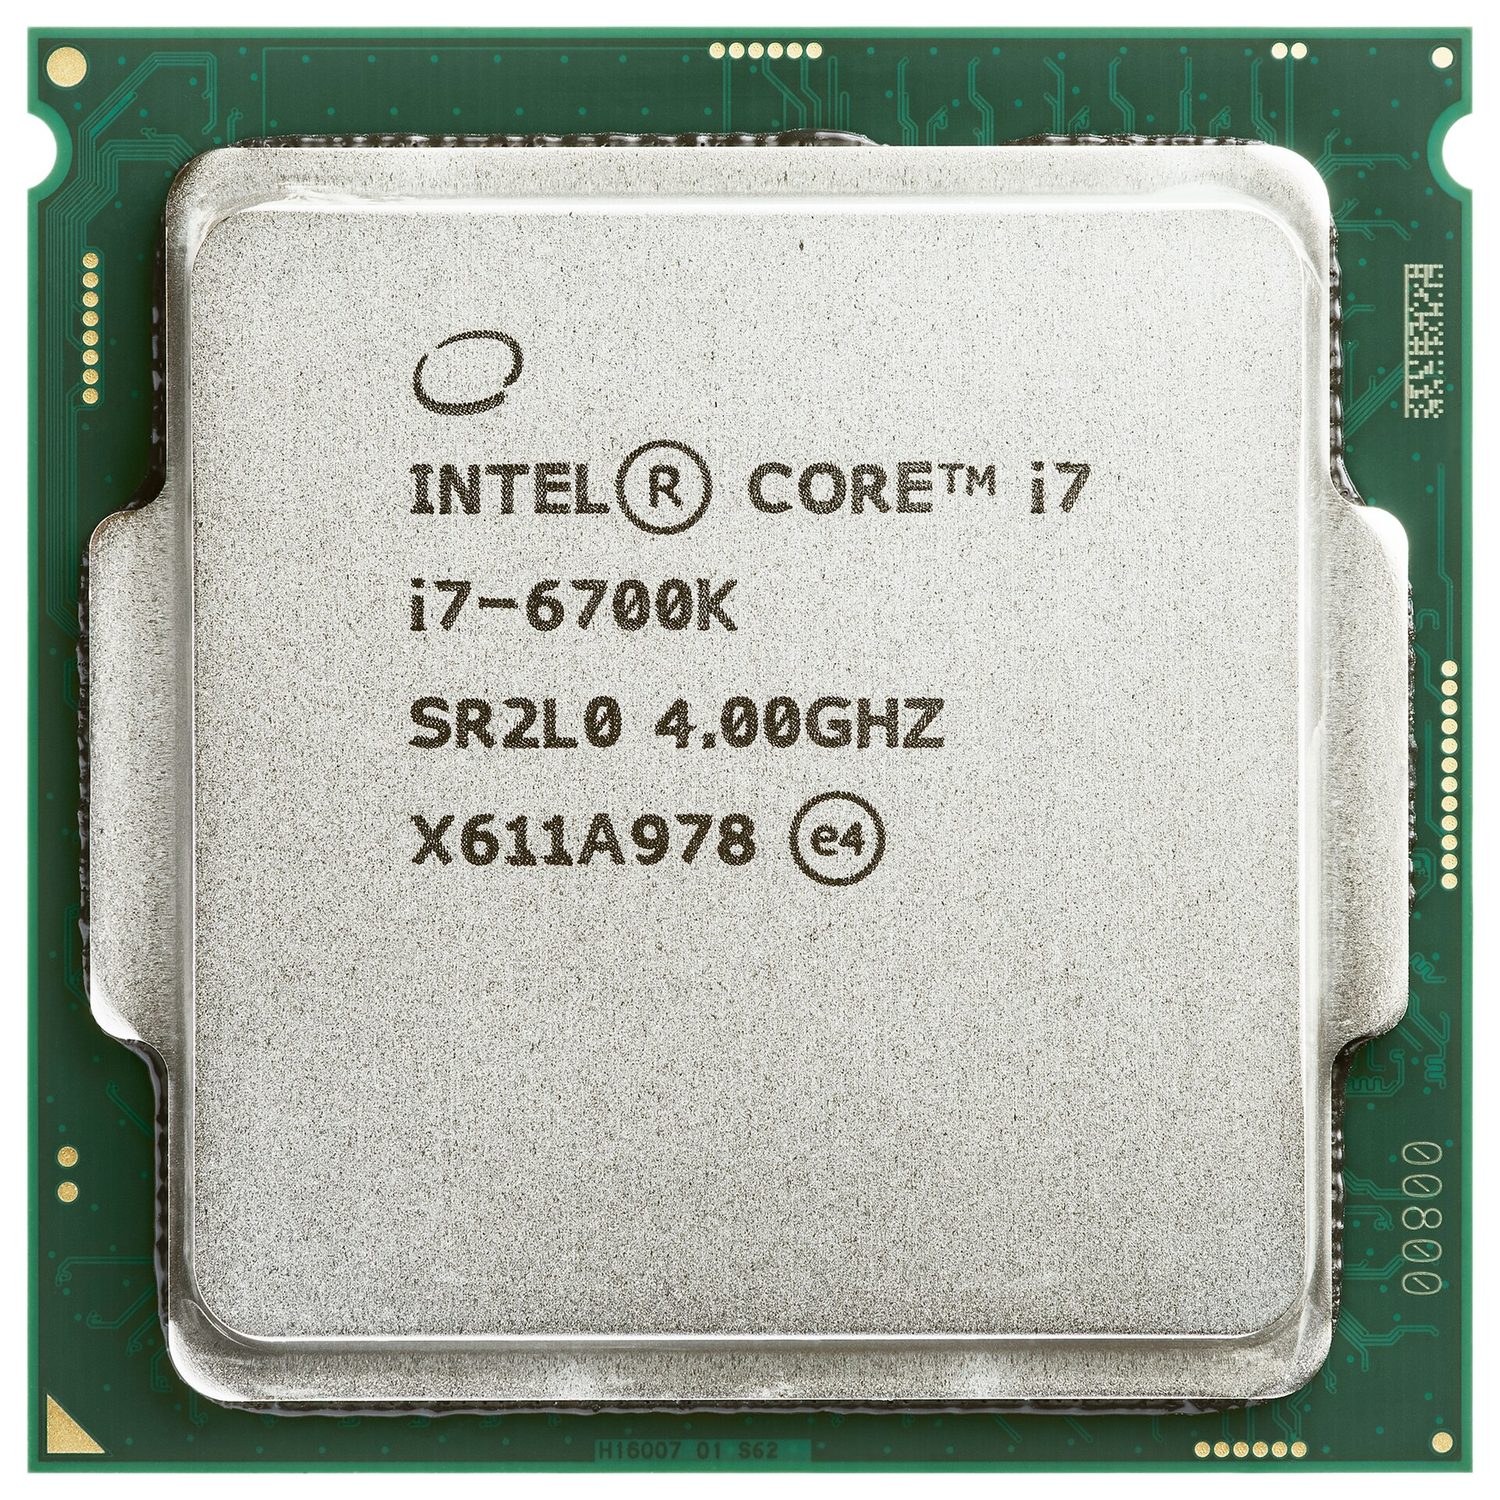
La unidad central de procesamiento 中央处理器 (CPU) es la parte del ordenador que procesa datos y ejecuta instrucciones 指令. Ejecuta programas repitiendo un ciclo, millones de veces por segundo.
Una unidad central de procesamiento (CPU): el chip que procesa datos y ejecuta las instrucciones
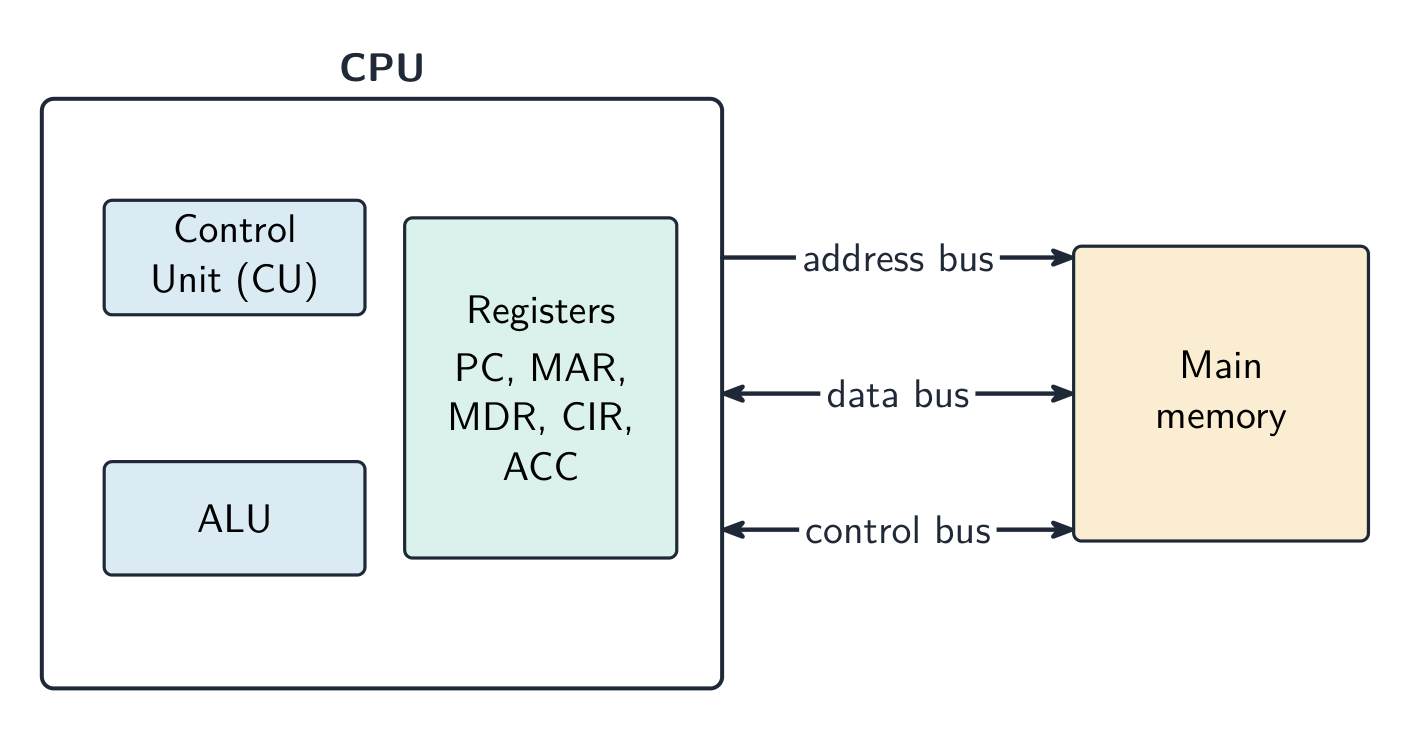
Partes de la CPU
Parte
Función
unidad aritmético-lógica 算术逻辑单元 (ALU)
realiza cálculos (suma, resta) y operaciones lógicas (comparación)
unidad de control 控制单元 (CU)
envía señales de control para gestionar todas las partes y decirles qué hacer
registros 寄存器
almacenamientos muy pequeños y muy rápidos que guardan una pieza de datos a la vez
Las partes están unidas por buses 总线 — conjuntos de cables que transportan información:
el bus de direcciones 地址总线 transporta direcciones de memoria (en una sola dirección);
el bus de datos 数据总线 transporta datos e instrucciones (en ambas direcciones);
el bus de control 控制总线 transporta señales de control.
La CPU contiene la unidad de control, la ALU y los registros; tres buses la conectan a la memoria principal
Registros especiales
Estos registros se utilizan durante el ciclo de búsqueda-ejecución.
Registro
Propósito
contador de programa 程序计数器 (PC)
guarda la dirección de la siguiente instrucción
registro de dirección de memoria 内存地址寄存器 (MAR)
guarda la dirección a la que se debe leer o escribir
registro de datos de memoria 内存数据寄存器 (MDR)
guarda el dato o la instrucción acabada de buscar
registro de instrucción actual 当前指令寄存器 (CIR)
guarda la instrucción que se está ejecutando ahora mismo
acumulador 累加器 (ACC)
guarda el resultado de los cálculos de la ALU
El ciclo de búsqueda-ejecución
El ciclo de búsqueda-ejecución 取指执行周期 tiene tres etapas, que se repiten una y otra vez:
Búsqueda — la instrucción se copia desde la memoria 内存 hacia la CPU (usando el PC, MAR y MDR). A continuación, el PC aumenta en 1.
Decodificación — la unidad de control determina lo que significa la instrucción.
Ejecución — se lleva a cabo la instrucción (la ALU puede realizar un cálculo, con el resultado yéndose al acumulador).
El procesador repite tres etapas: busca la instrucción, la decodifica y luego la ejecuta
Memoria caché
La cache 高速缓存 es una pequeña cantidad de memoria muy rápida dentro o cerca de la CPU. Almacena datos e instrucciones que la CPU utiliza frecuentemente. La CPU puede leer de la caché mucho más rápido que de la memoria principal, por lo que el ordenador funciona más rápido.
Factores que afectan al rendimiento de la CPU
Característica
Efecto
número de núcleos 核心
cada núcleo puede ejecutar instrucciones por sí solo, por lo que más núcleos pueden realizar más trabajo al mismo tiempo
tamaño de la caché
una caché mayor almacena más datos listos para la CPU, por lo que esta espera menos
velocidad de reloj 时钟速度
el número de ciclos por segundo; una velocidad de reloj mayor ejecuta más instrucciones por segundo
Ejemplo resuelto. Dos ordenadores son idénticos excepto que A tiene una CPU mononúcleo de 3.0 GHz con 2 MB de caché, y B tiene una CPU de cuatro núcleos de 2.4 GHz con 8 MB de caché. ¿Cuál es mejor para la edición de vídeo y por qué? La edición de vídeo se divide en muchas tareas que pueden ejecutarse simultáneamente, por lo que los cuatro núcleos de B pueden procesar varios flujos en paralelo mientras que A solo puede trabajar en uno a la vez. Además, la caché más grande de B mantiene los datos de uso frecuente más cerca de la CPU, por lo que necesita buscar en la RAM con menor frecuencia. B es la mejor opción, aunque A tenga una velocidad de reloj mayor. Nunca respondas basándote únicamente en la velocidad de reloj: pondera núcleos, caché y velocidad de reloj juntos, y vincula cada uno a la tarea que se está realizando.
Sistemas embebidos
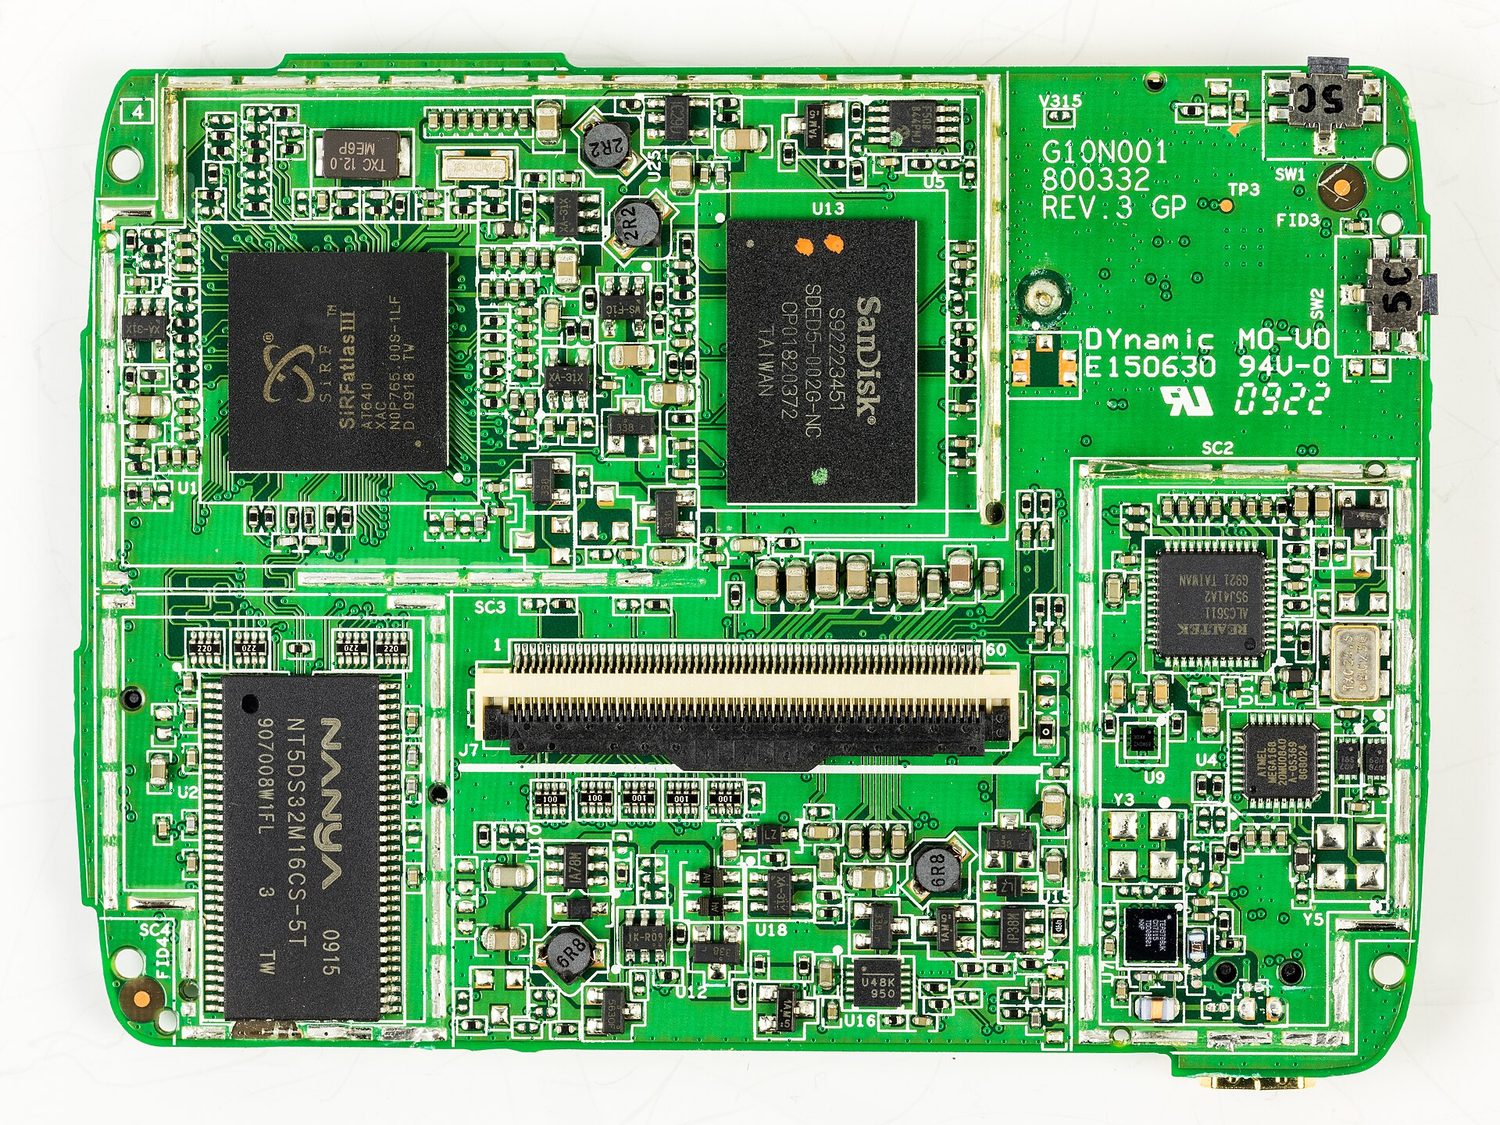
Un sistema embebido 嵌入式系统 es una computadora pequeña construida dentro de un dispositivo más grande para realizar una tarea fija. Está dedicado a esa tarea, suele ser pequeño y de bajo costo, y no tiene sistema operativo general. Ejemplos: una lavadora, un microondas, un decodificador.
La placa base dentro de un sistema de navegación satelital: un sistema embebido es una computadora pequeña y dedicada como esta, integrada en un dispositivo para realizar una tarea fija
Explorar
El ciclo de búsqueda-ejecución
Toca alrededor del bucle que la CPU repite miles de millones de veces por segundo: busca la instrucción, decodifica su significado, la ejecuta y luego vuelve a hacerlo todo.
3 (a) Comprender qué se entiende por sensor y los propósitos de los sensores
• Limitado a: – acústico – acelerómetro – flujo – gas – humedad – infrarrojo – nivel – luz – campo magnético – humedad del suelo – pH – presión – proximidad – temperatura
(b) Identificar el tipo de datos capturados por cada sensor y comprender cuándo se usaría cada uno, incluyendo la selección del sensor más adecuado para un contexto dado
Fuente: Plan de estudios Cambridge International
Un dispositivo de entrada envía datos hacia adentro del ordenador.
Dispositivo
Cómo funciona
lector de códigos de barras 条形码扫描器
proyecta luz sobre las barras y lee el patrón reflejado
lector de códigos QR 二维码扫描器
una cámara lee un patrón cuadrado de bloques blanco y negro
teclado
al presionar una tecla se envía un código para ese carácter
ratón óptico 光电鼠标
una luz y un sensor rastrean el movimiento sobre una superficie
micrófono
convierte ondas de sonido en una señal eléctrica
cámara digital
una lente enfoca la luz sobre un sensor que registra píxeles
sensores 传感器
miden una magnitud física (como temperatura o luz) y la envían como datos
pantalla táctil 触摸屏
detecta dónde tocas la pantalla con tu dedo
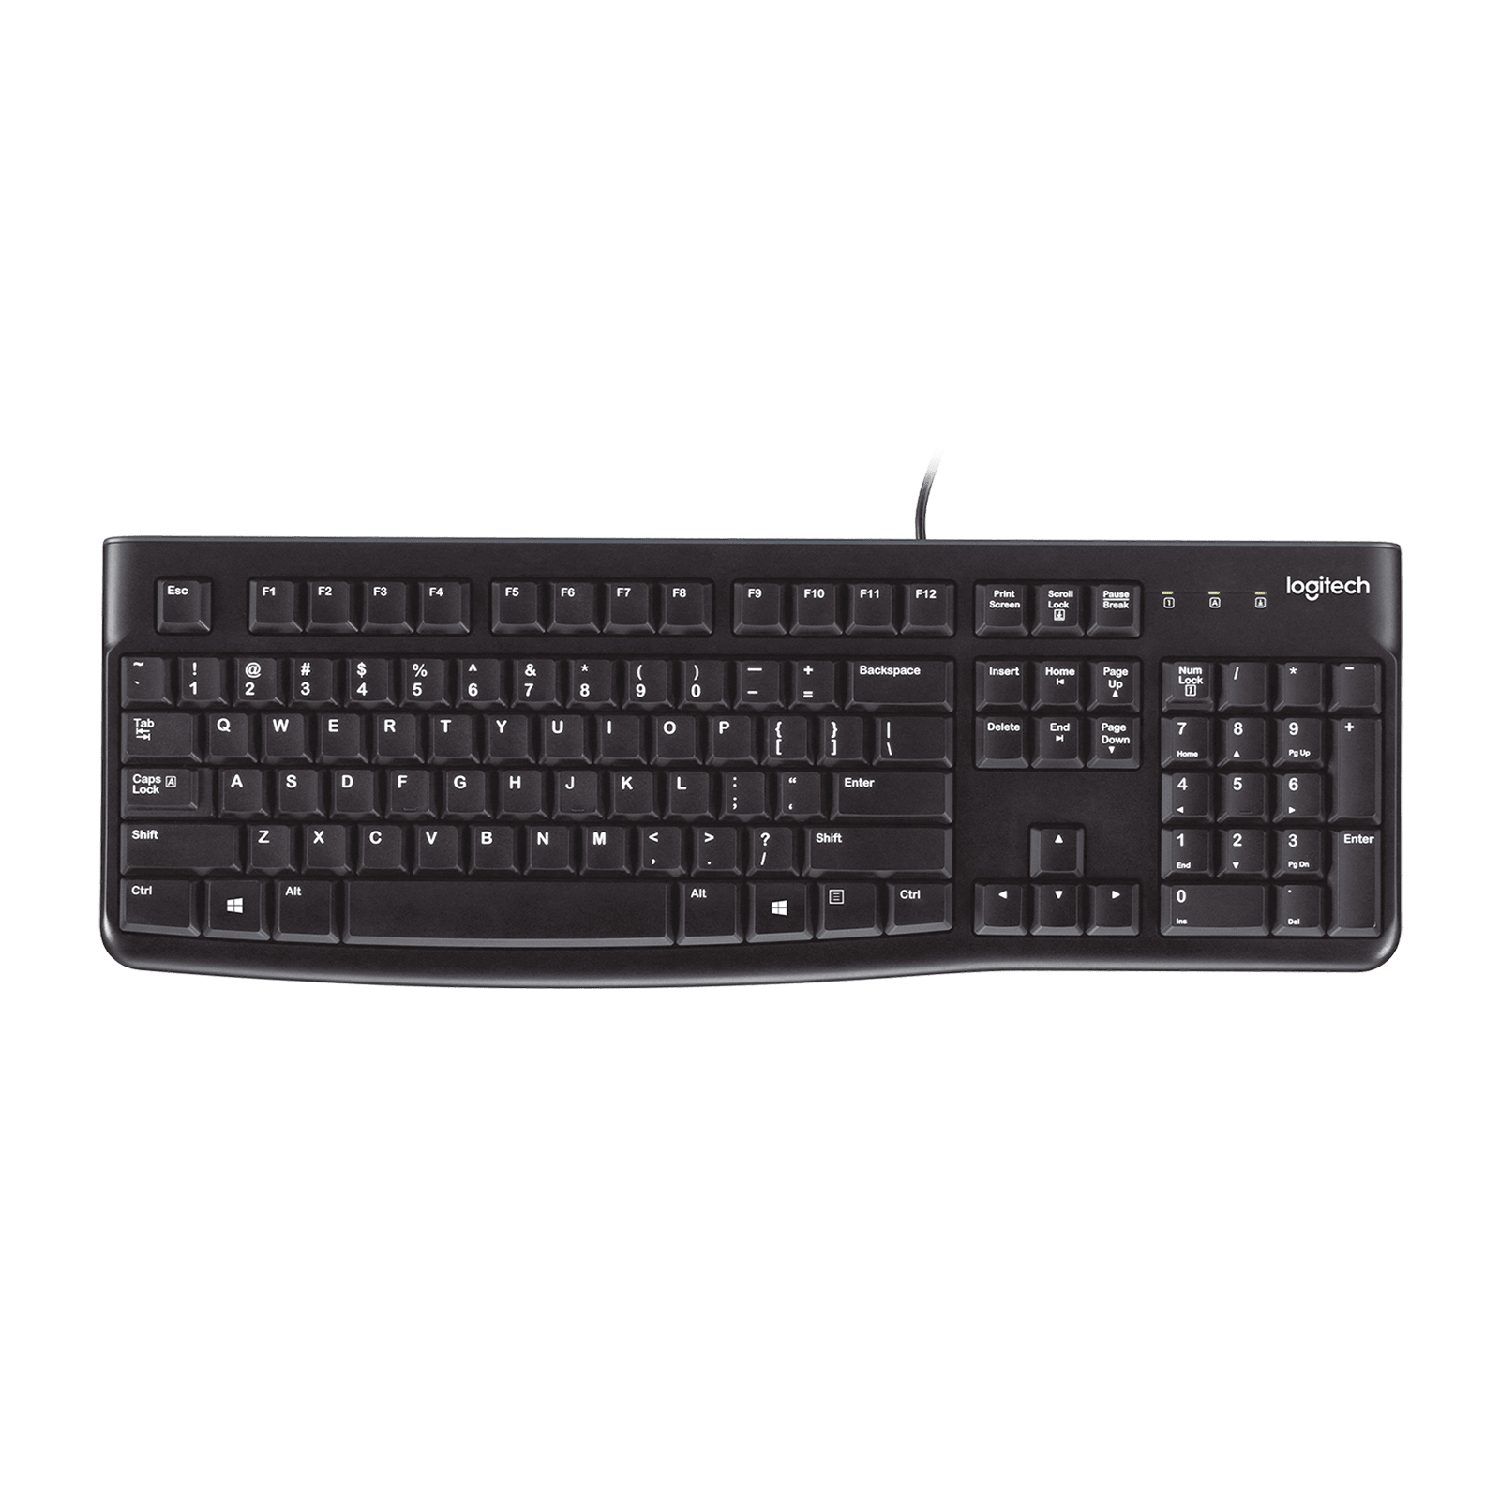
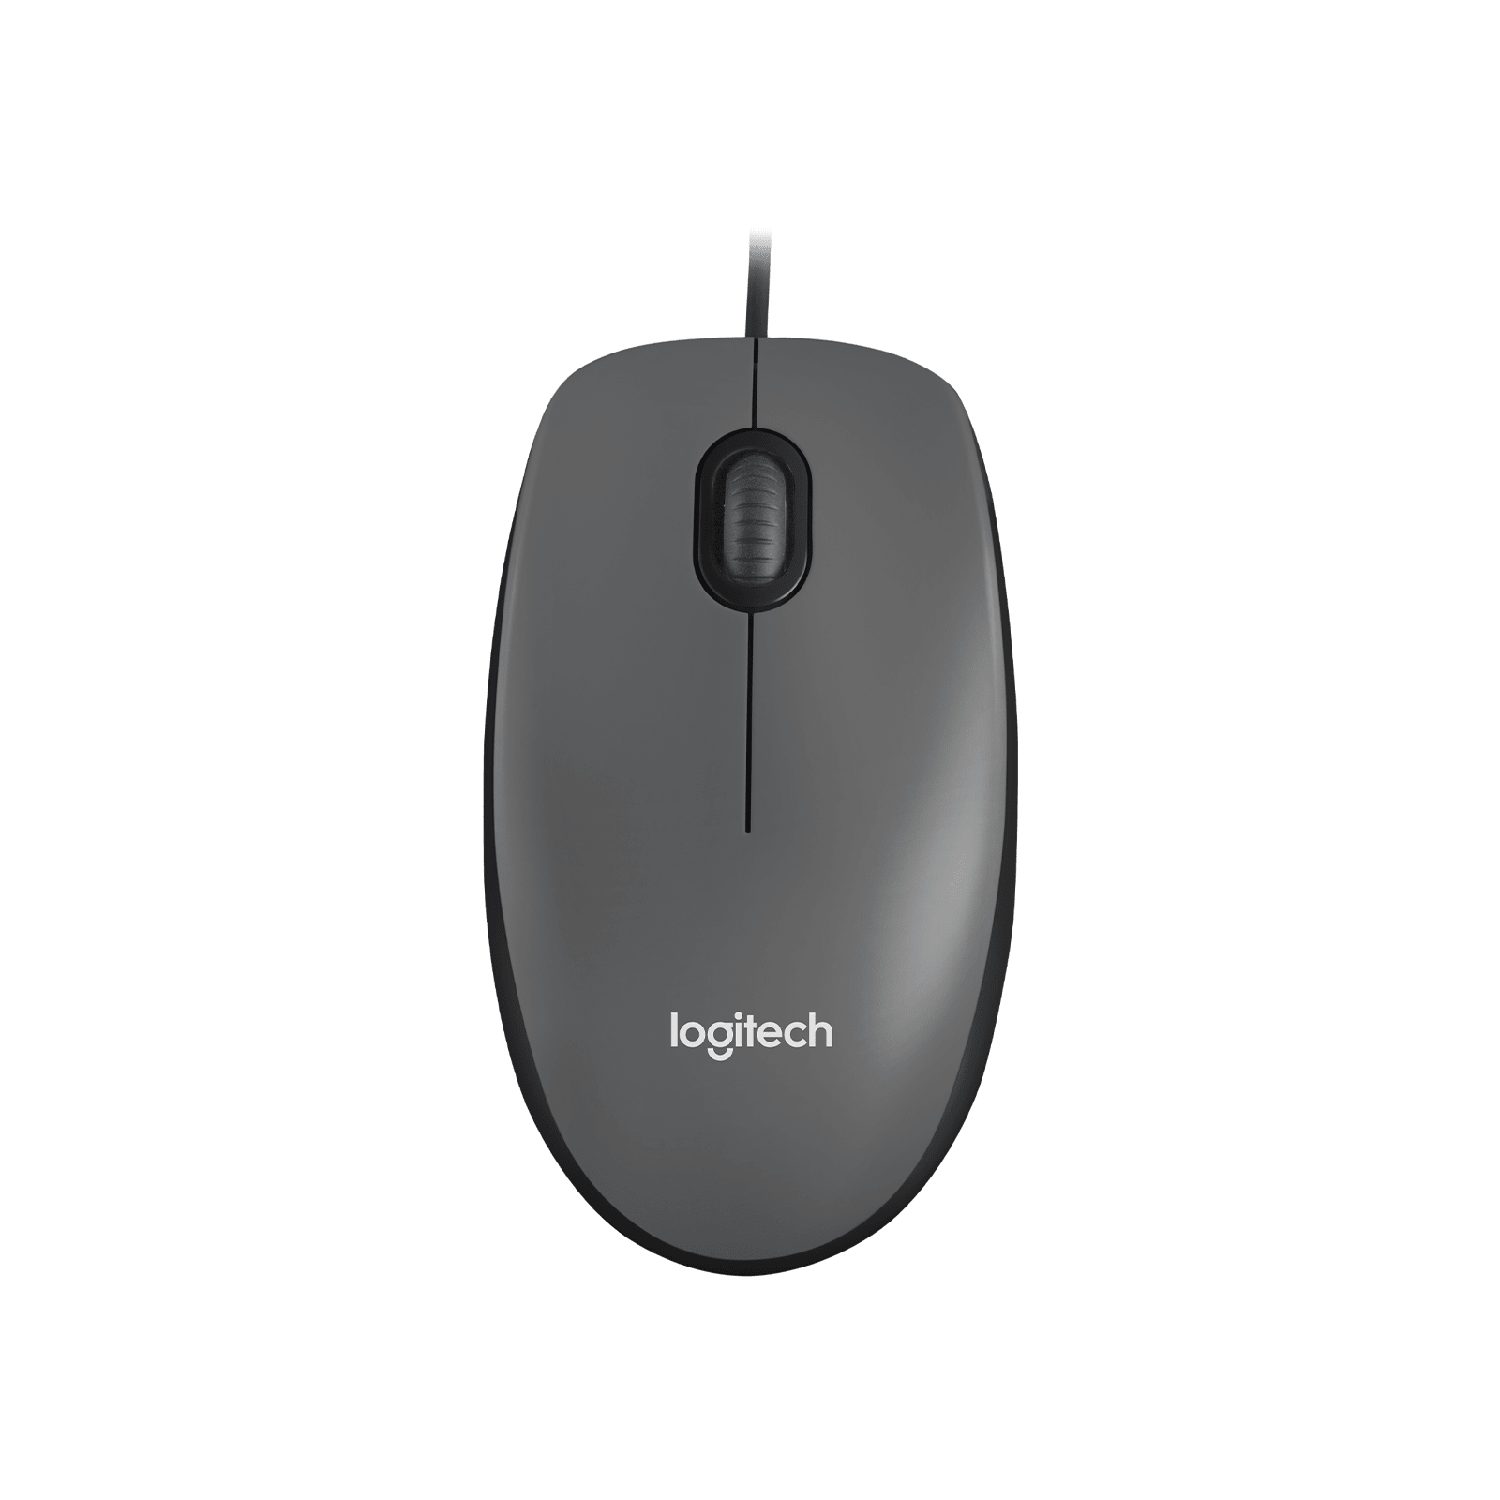
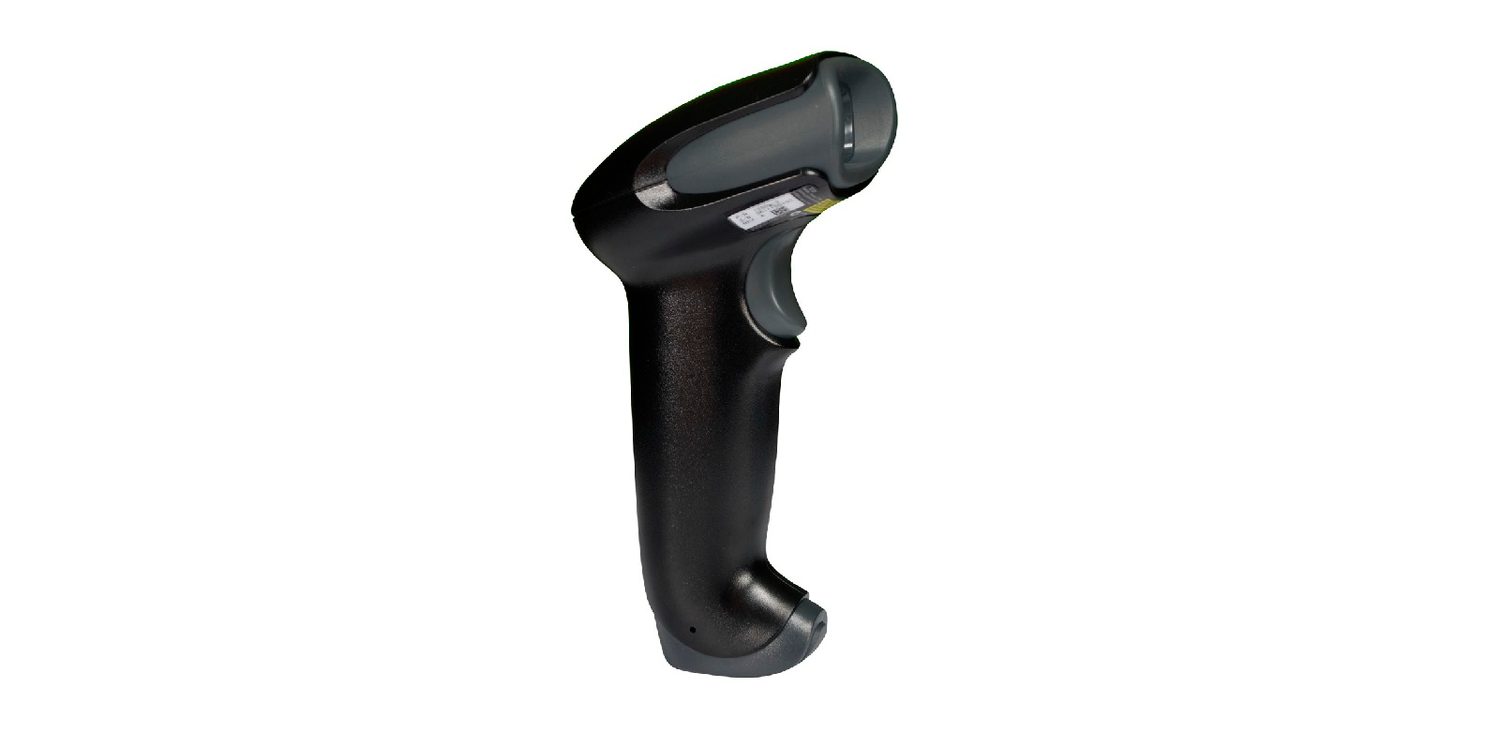
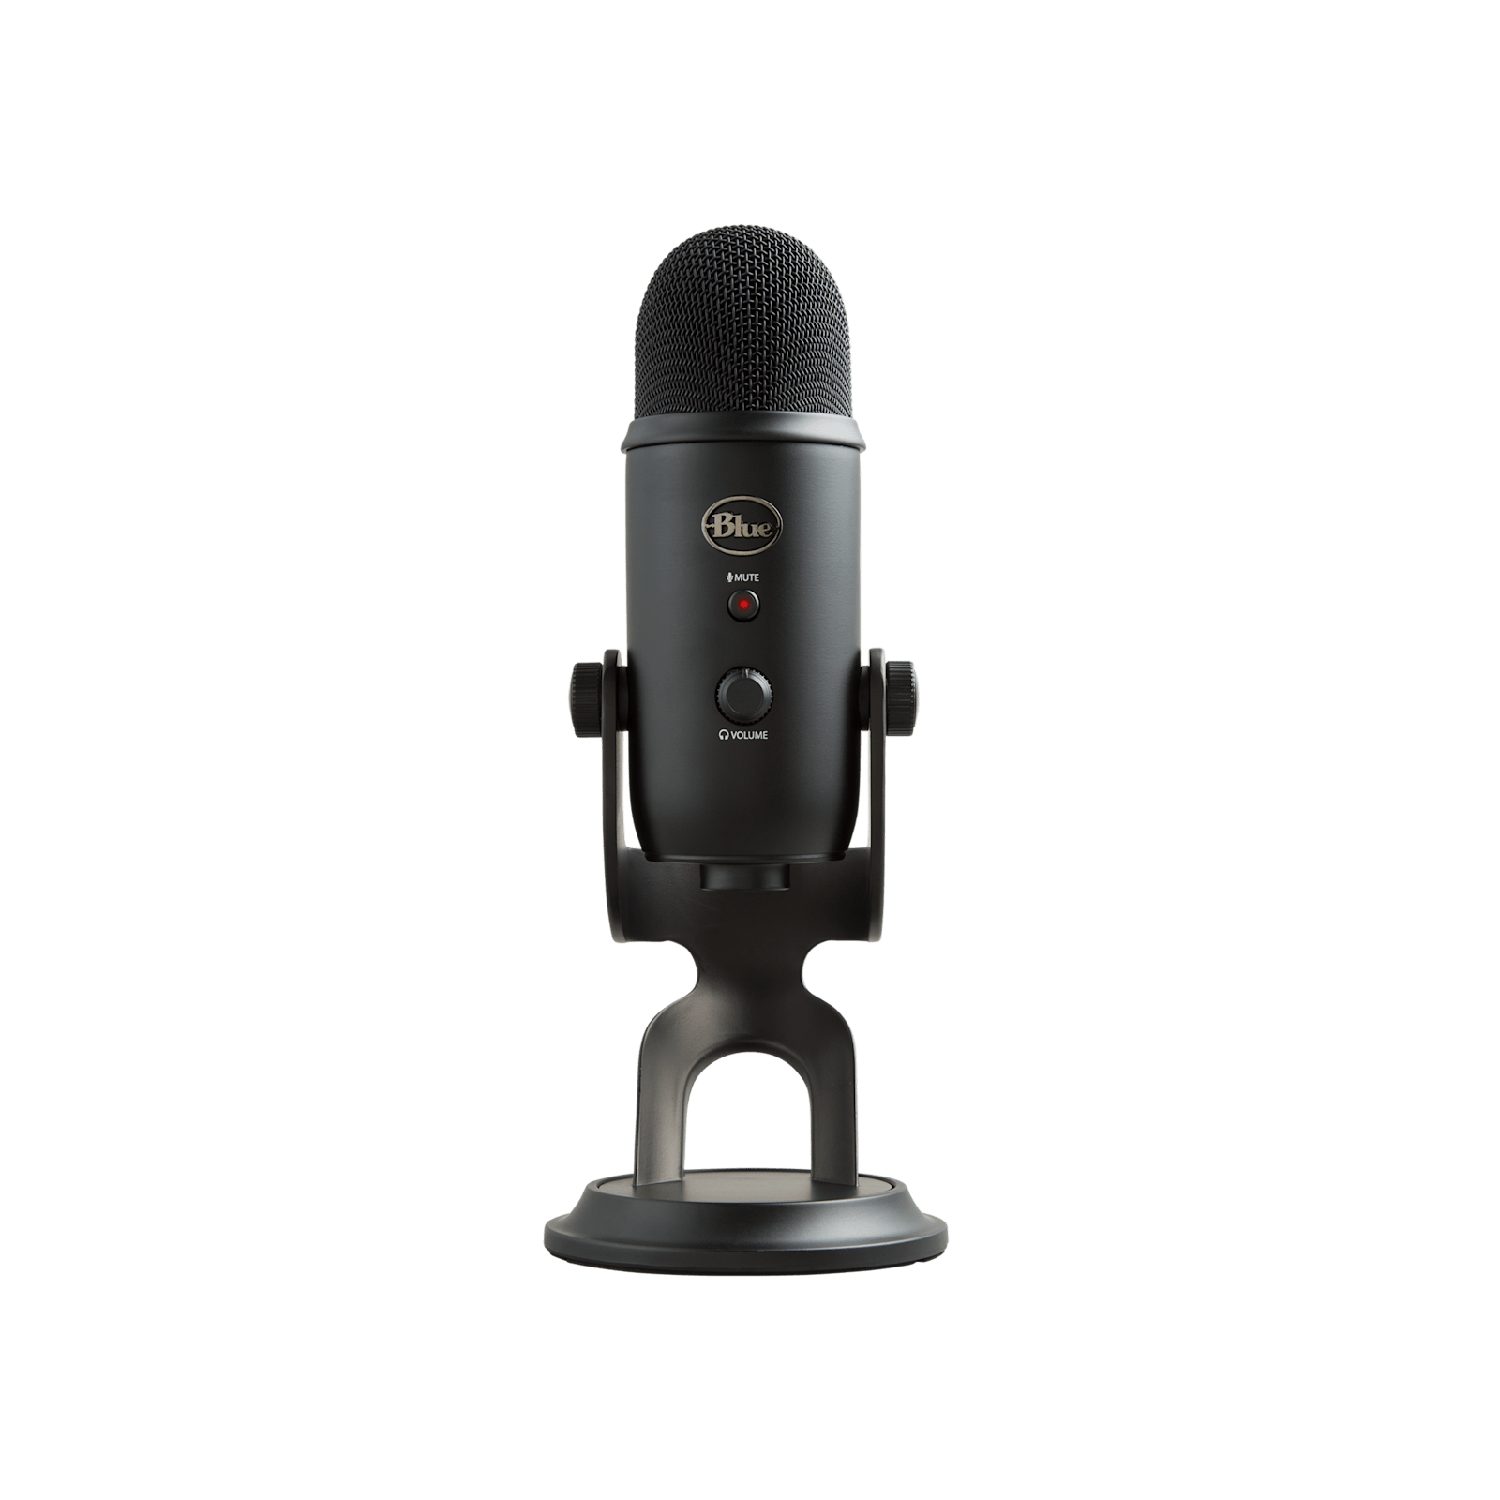
Un teclado: cada pulsación de tecla envía un código para ese carácterUn ratón óptico: una luz y un sensor rastrean su movimiento sobre el escritorioUn escáner de mesa plana: proyecta luz sobre una página para copiarla al ordenadorUn lector de códigos de barras lee el patrón de barras y lo envía al ordenadorUna cámara digital: una lente enfoca la luz sobre un sensor que registra los píxelesUn micrófono convierte ondas de sonido en una señal eléctricaUn sensor mide una magnitud física (aquí, la temperatura) y la envía como datos
Una pantalla táctil puede funcionar de tres formas:
resistiva 电阻式 — dos capas se presionan juntas donde tocas;
capacitiva 电容式 — detecta la carga eléctrica diminuta de tu dedo;
infrarroja 红外线 — tu dedo interrumpe una rejilla de haces de luz.
Una pantalla táctil detecta dónde tocas con tu dedo
Explorar
Laboratorio de dispositivos y almacenamiento
Clasificar ejemplos computacionales según la función que cumplen en un sistema.
Un dispositivo de salida envía datos hacia afuera del ordenador hacia el usuario.
Dispositivo
Cómo funciona
actuador 执行器
convierte una señal eléctrica en movimiento (por ejemplo, un motor o una válvula)
pantalla LCD/LED
muestra imágenes usando una cuadrícula de puntos diminutos coloreados
proyector 投影仪
proyecta una imagen ampliada sobre una pared o pantalla
impresora de inyección de tinta 喷墨打印机
rocía gotas diminutas de tinta sobre papel
impresora láser 激光打印机
usa un láser y polvo (tóner) fijado sobre papel por calor
impresora 3D
construye un objeto sólido capa por capa
altavoz 扬声器
convierte una señal eléctrica en sonido
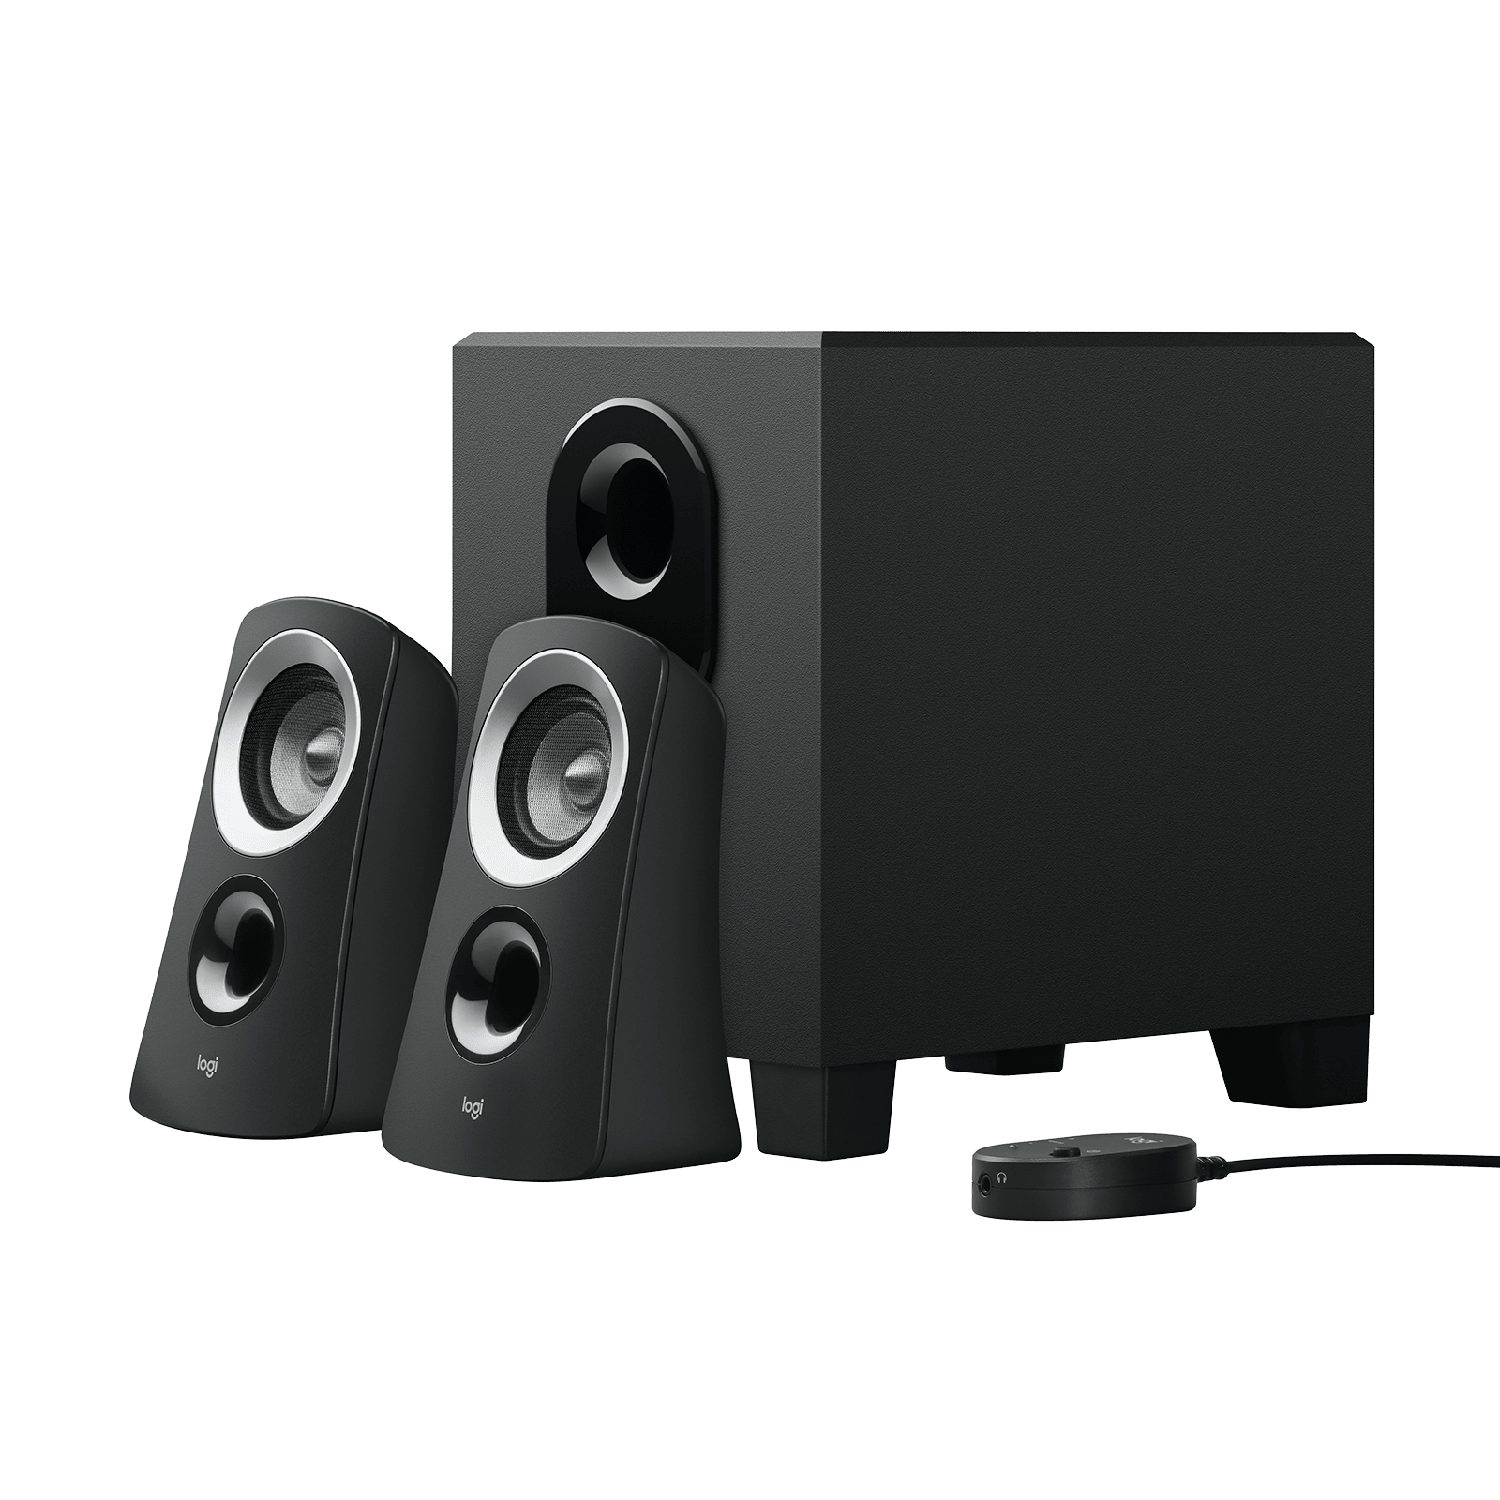
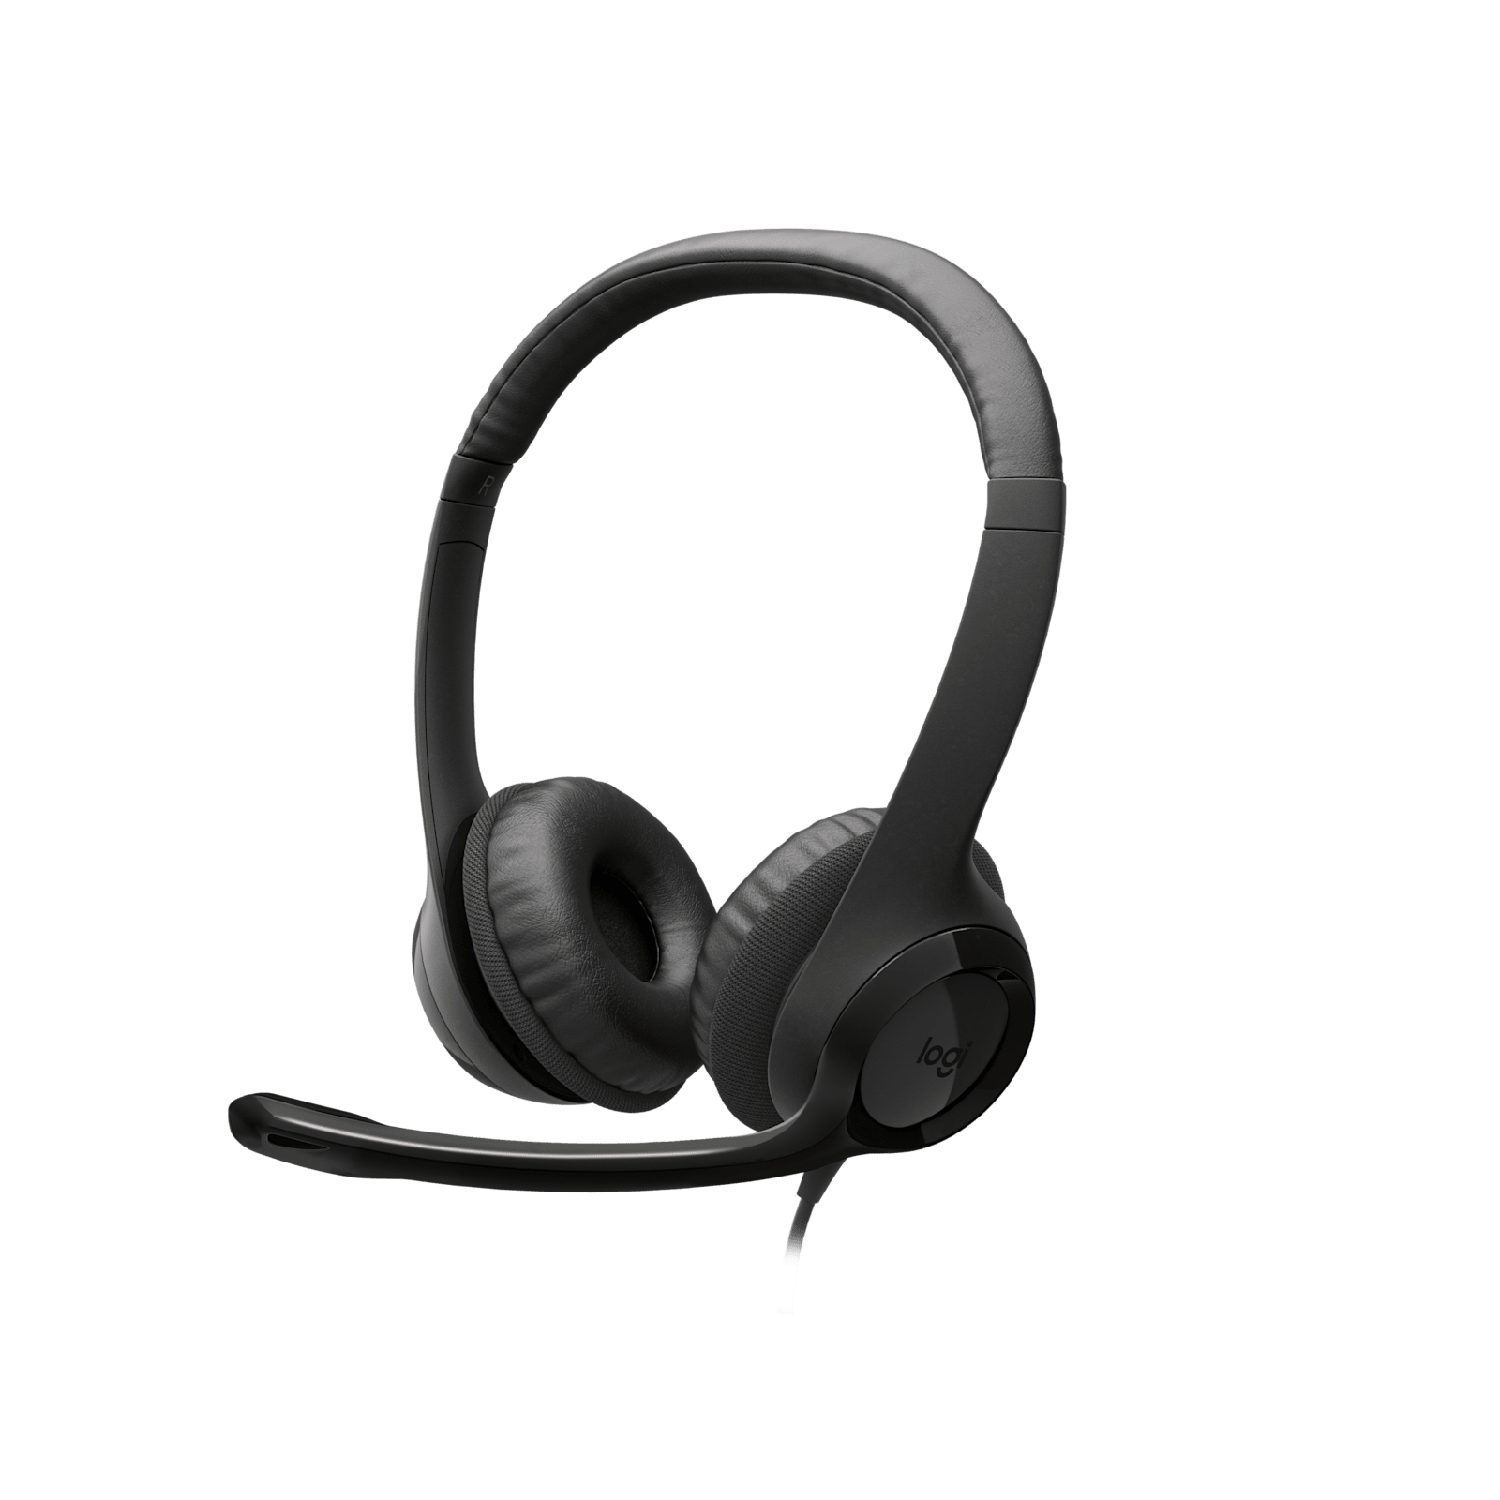
Una impresora de inyección de tinta rocía gotas diminutas de tinta sobre el papelUna impresora láser usa un láser y polvo (tóner) fijado sobre papel por calorUna impresora 3D construye un objeto sólido capa por capaUn monitor LCD/LED muestra imágenes usando una cuadrícula de puntos diminutos coloreadosUn altavoz convierte una señal eléctrica en sonidoLos auriculares convierten una señal eléctrica en sonido para un único oyenteUn actuador como un motor convierte una señal eléctrica en movimiento
1 Comprender el significado de almacenamiento primario
• El almacenamiento primario es accedido directamente por la CPU • Incluye el rol de: – memoria de acceso aleatorio (RAM) – memoria de solo lectura (ROM) • Incluye por qué una computadora necesita tanto RAM como ROM, y las diferencias entre ellas
2 Comprender el significado de almacenamiento secundario
• El almacenamiento secundario no es accedido directamente por la CPU y es necesario para el almacenamiento más permanente de los datos
3 Describir el funcionamiento del almacenamiento magnético, óptico y de estado sólido (memoria flash), y dar ejemplos de cada uno
• El almacenamiento magnético utiliza platos que están divididos en pistas y sectores. Los datos se leen y escriben utilizando electroimanes. Incluye disco duro (HDD) • El almacenamiento óptico utiliza láseres para crear y leer surcos y llanuras. Incluye: CD, DVD y Blu-ray • El almacenamiento de estado sólido (memoria flash) utiliza tecnología NAND o NOR. Se utilizan transistores como compuertas de control y compuertas flotantes. Incluye: unidad de estado sólido (SSD), tarjeta SD y memoria USB
4 Describir qué se entiende por memoria virtual, cómo se crea y utiliza, y por qué es necesaria
• Las páginas de datos se transfieren entre la RAM y la memoria virtual según sea necesario
5 Comprender el significado de almacenamiento en la nube
• El almacenamiento en la nube puede accederse de forma remota en comparación con el almacenamiento local de datos
6 Explicar las ventajas y desventajas de almacenar datos en la nube en comparación con su almacenamiento local
• Se necesitan servidores físicos y almacenamiento para guardar datos en el almacenamiento en la nube
Fuente: Plan de estudios Cambridge International
El almacenamiento primario 主存储器 es la memoria que la CPU puede usar directamente. Hay dos tipos.
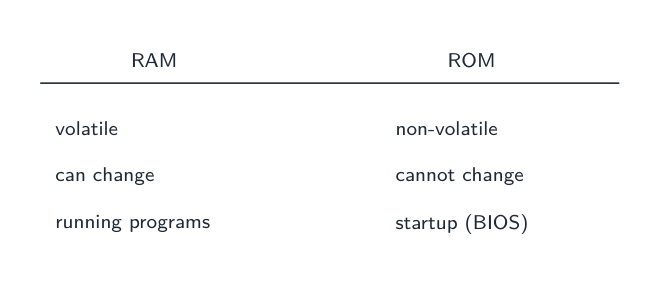
La RAM es volátil y guarda programas en ejecución; la ROM es no volátil y de solo lectura
RAM
ROM
Nombre completo
memoria de acceso aleatorio 随机存取存储器
memoria de solo lectura 只读存储器
Lectura/escritura
lectura y escritura
solo lectura
¿Guarda los datos sin energía?
no — es volátil 易失性
sí — es no volátil 非易失性
Guarda
programas y datos en uso ahora
instrucciones de arranque (cómo iniciar el ordenador)
Ambos son necesarios: la ROM le dice al ordenador cómo arrancar, y luego la RAM guarda los programas que ejecutas.
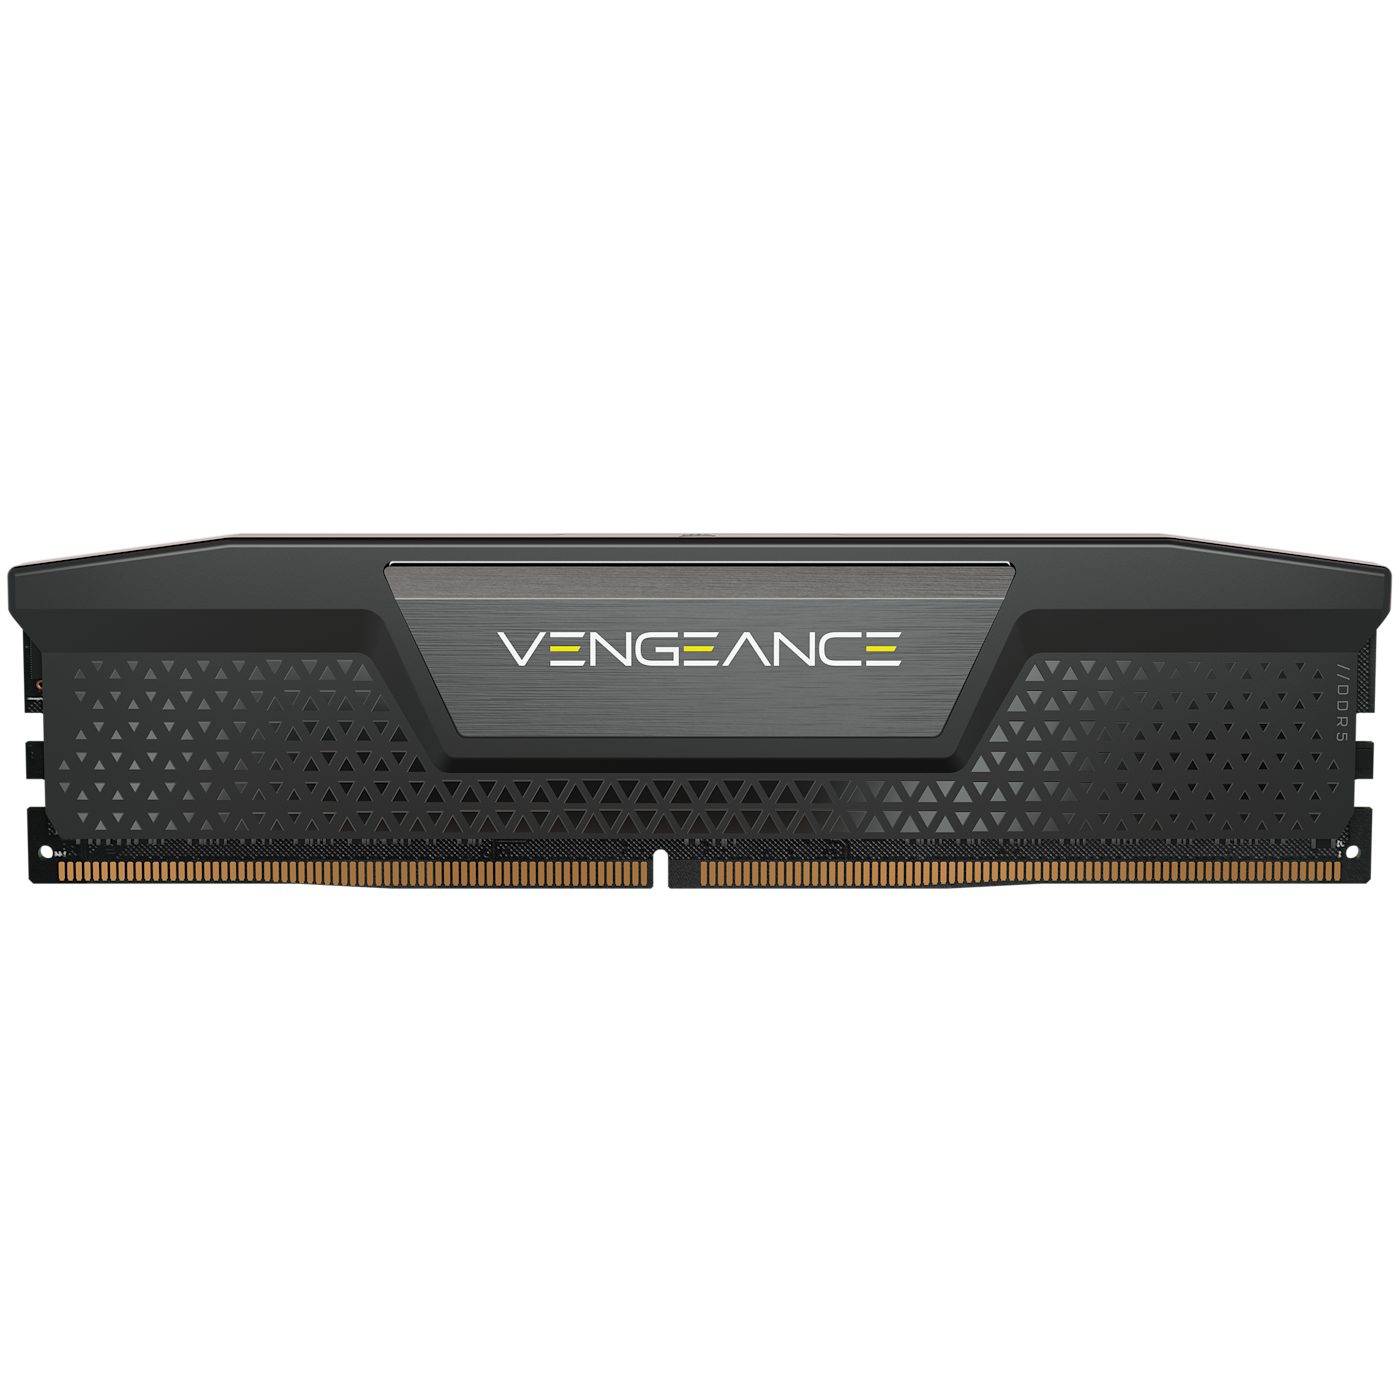
Un módulo de RAM (memoria de acceso aleatorio): guarda los programas y datos en uso ahora
El almacenamiento secundario 辅助存储器 mantiene los datos permanentemente, incluso cuando la energía está apagada. Es no volátil y se usa para almacenamiento a largo plazo. Hay tres tipos.
Tipo
Cómo almacena datos
Ejemplos
almacenamiento magnético 磁存储
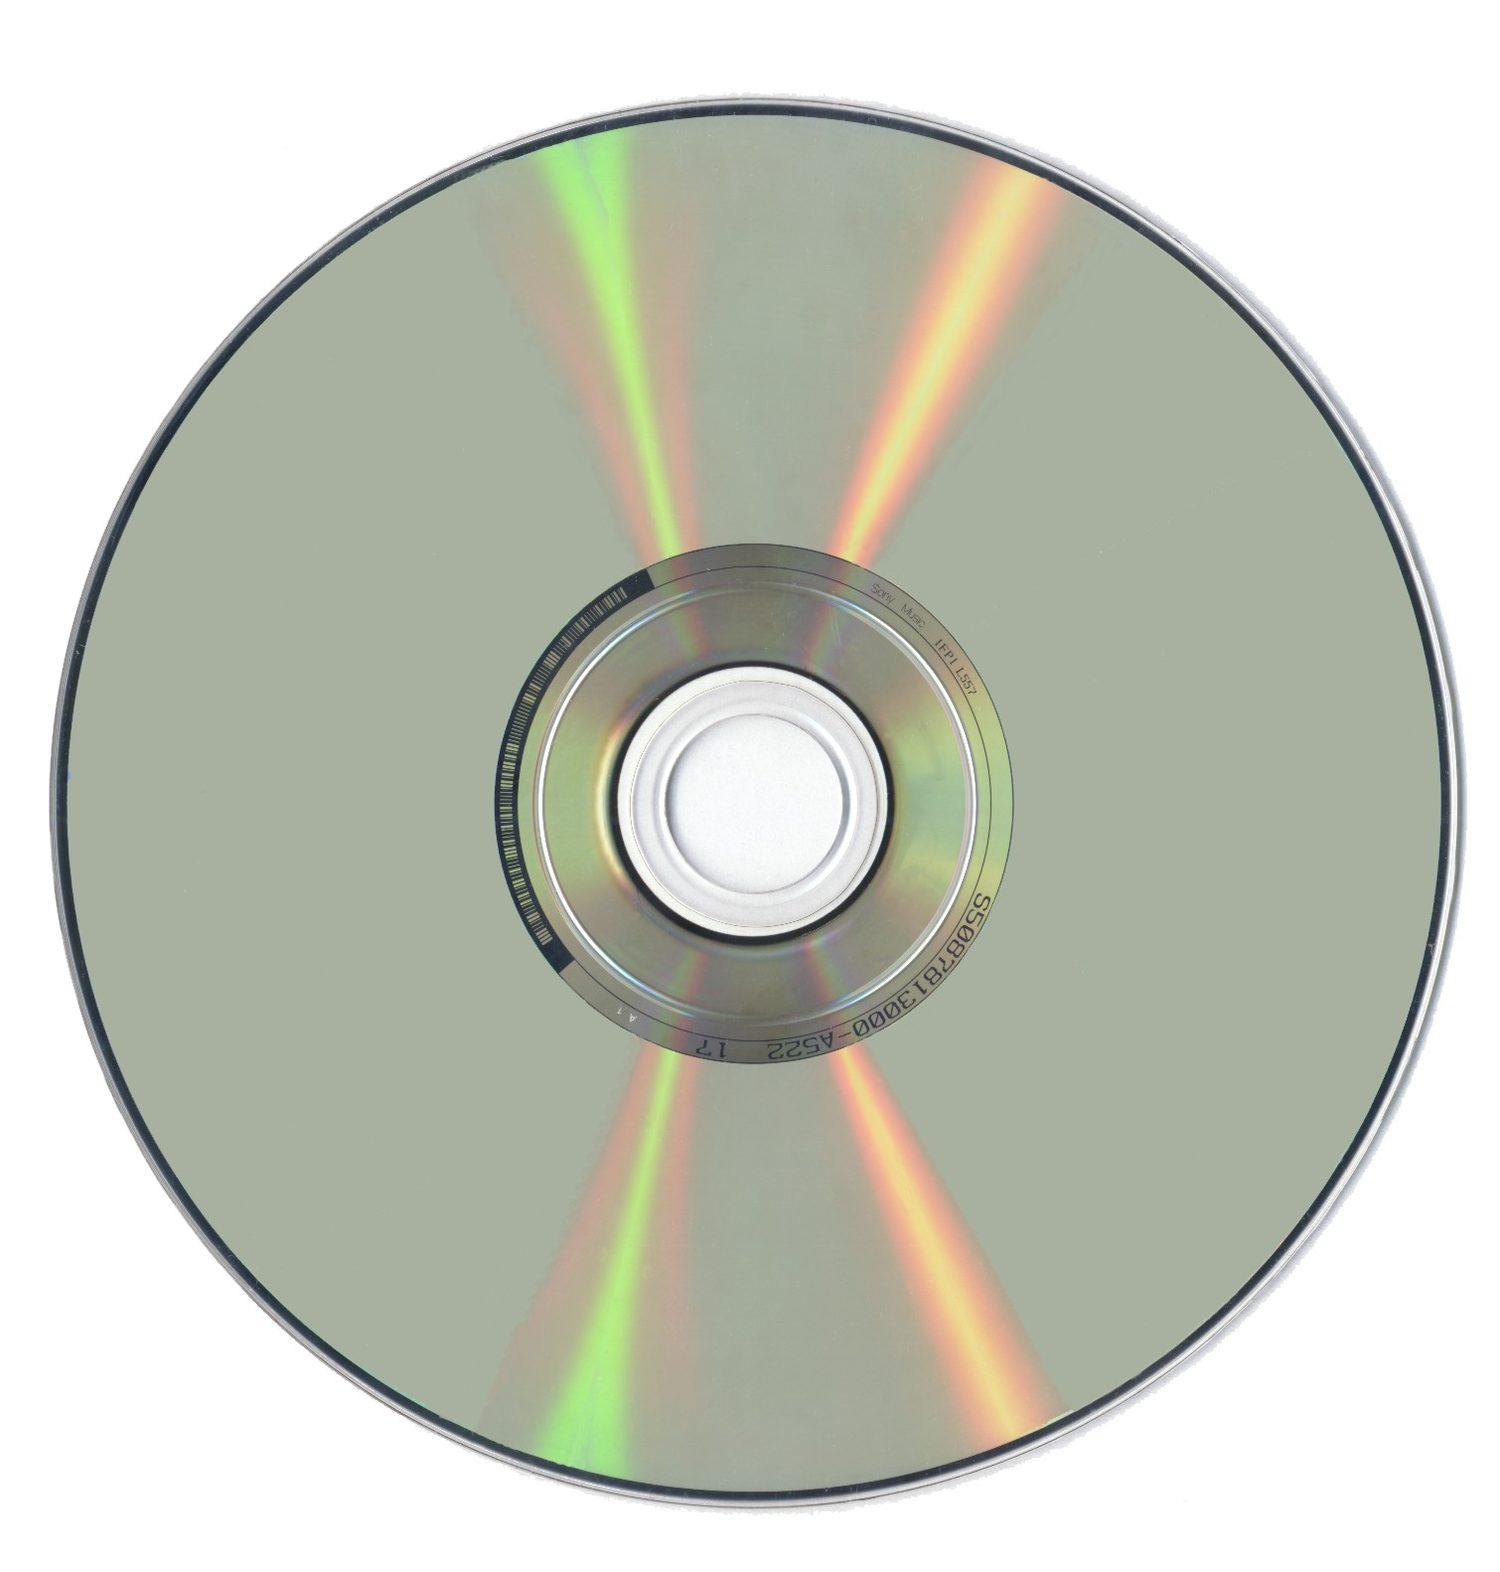
los datos se almacenan como puntos magnetizados en discos giratorios
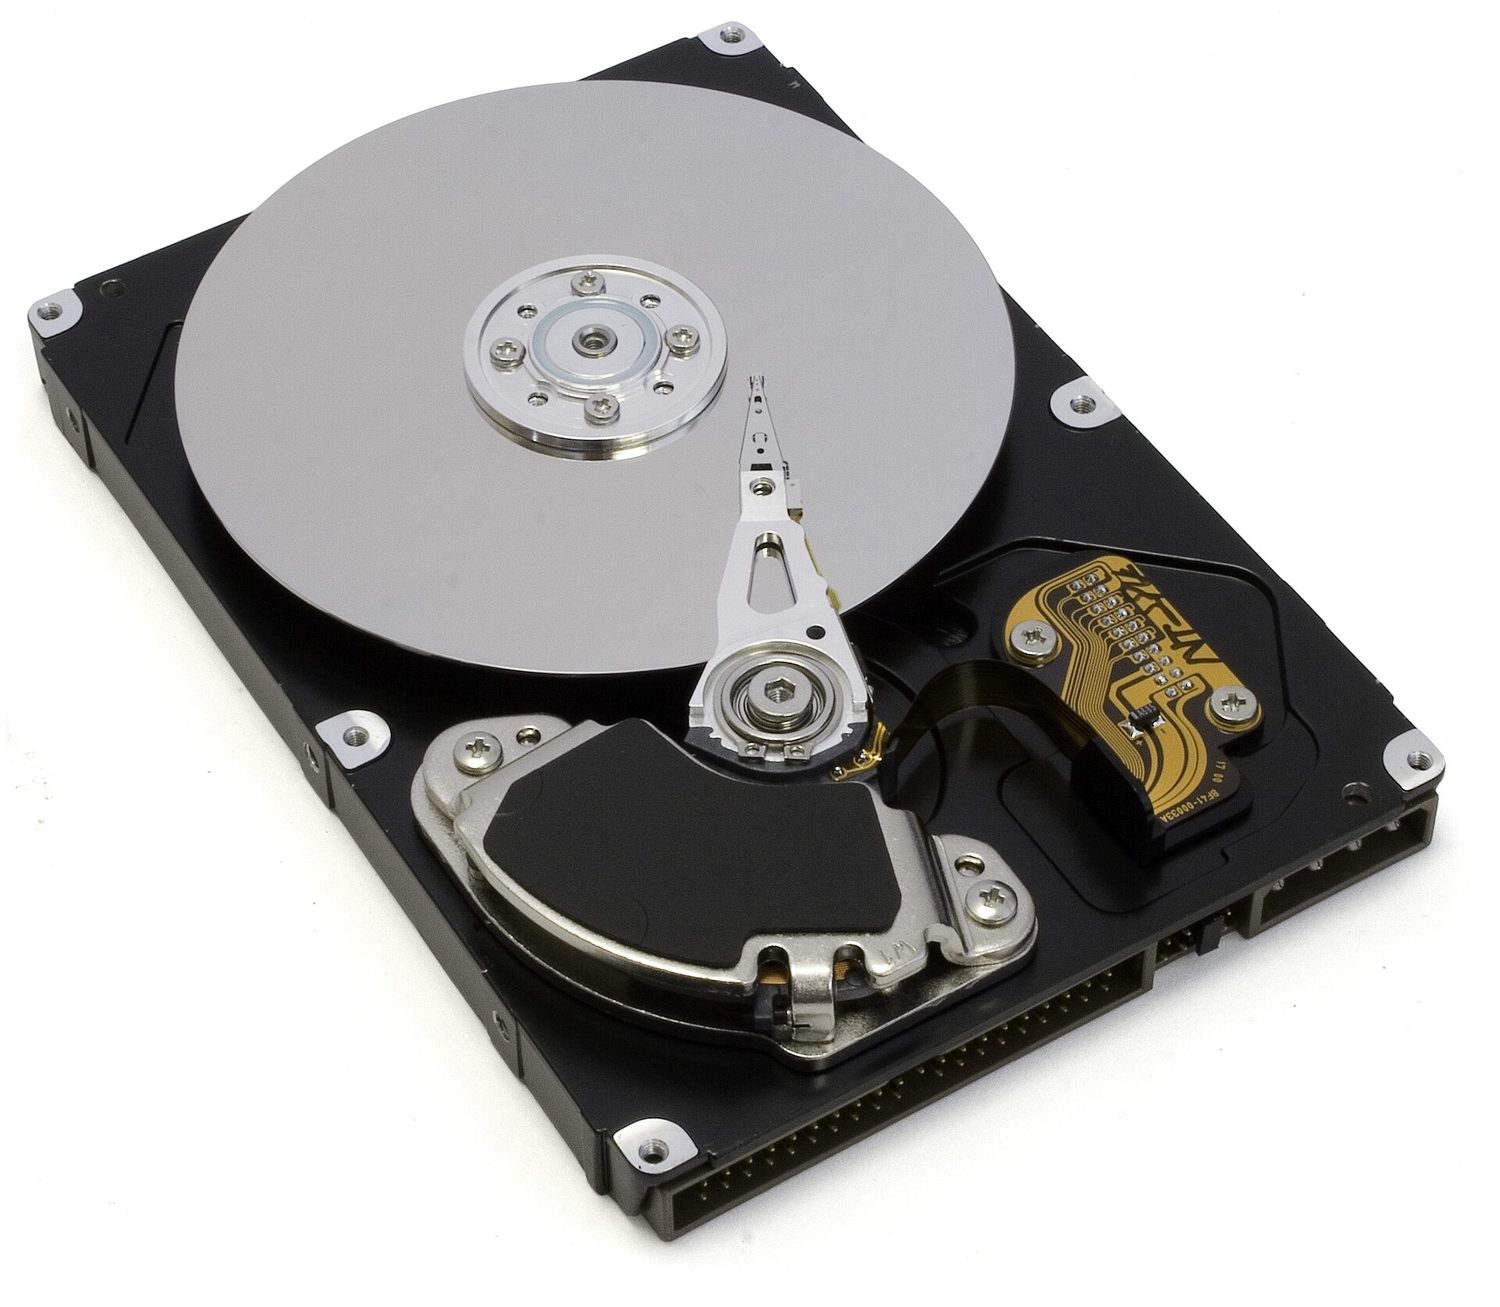
disco duro (HDD), cinta magnética
almacenamiento óptico 光存储
los datos se almacenan como marcas leídas por un láser
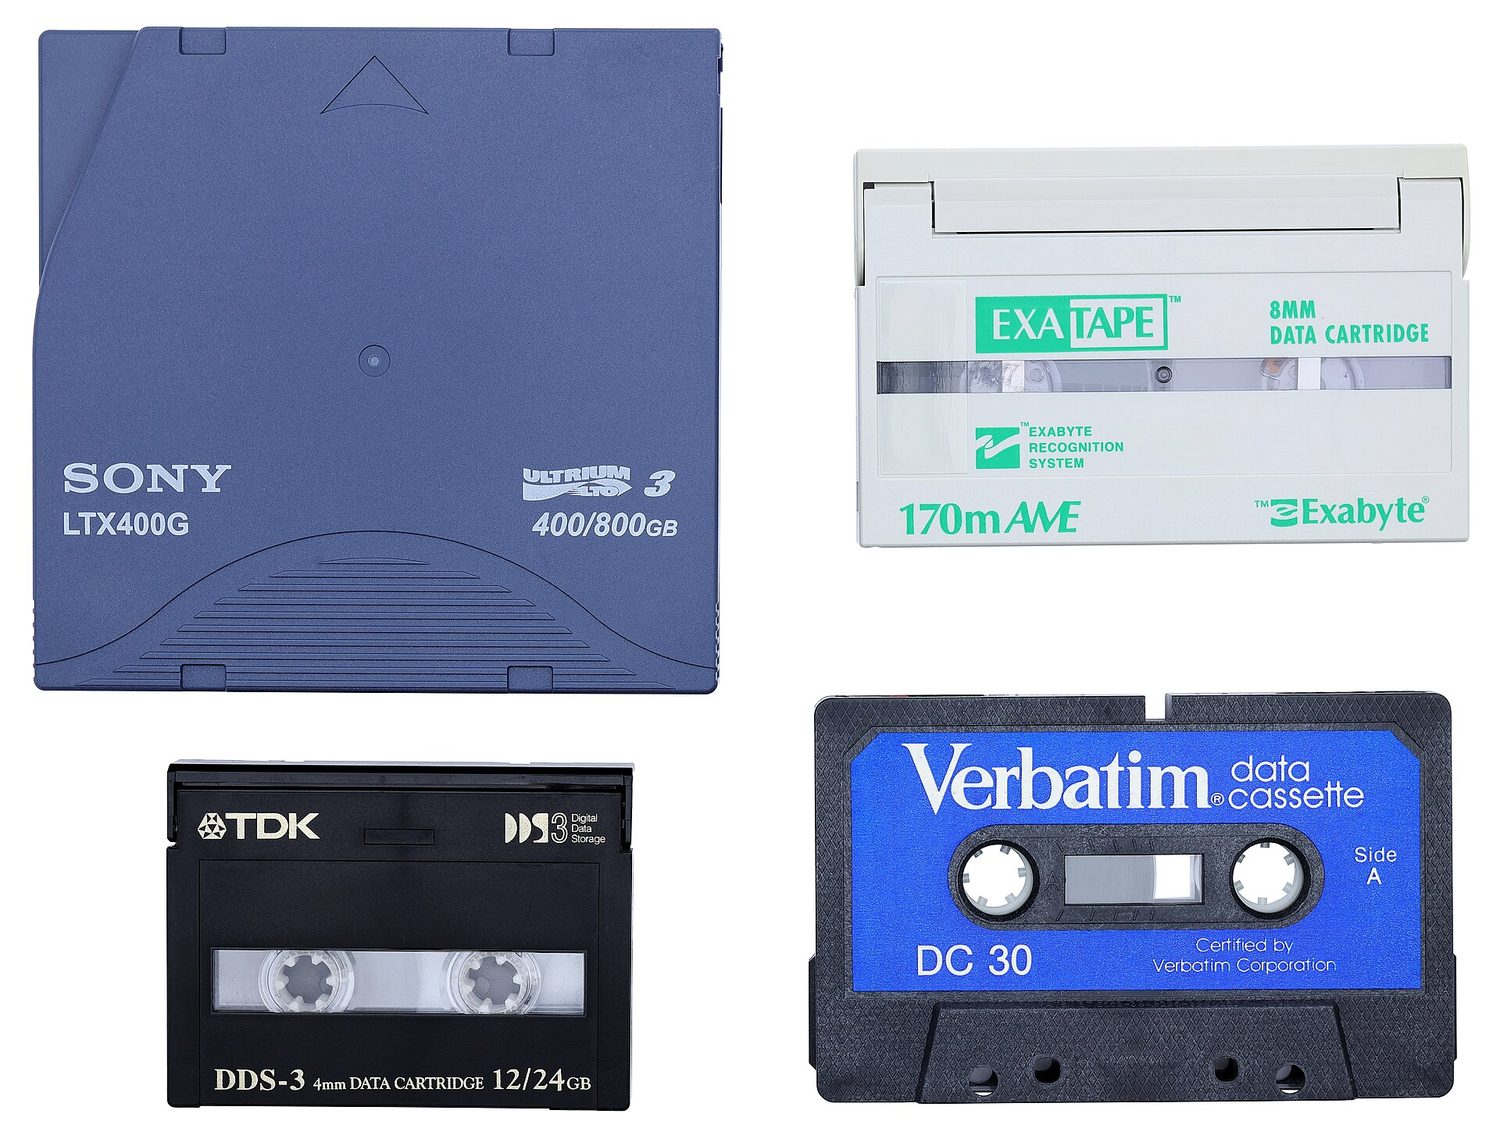
CD, DVD, Blu-ray
almacenamiento de estado sólido 固态存储
los datos se almacenan en memoria flash 闪存, sin piezas móviles
SSD, pendrive USB, tarjeta de memoria
Interior de un disco duro (HDD): el disco brillante gira y el brazo lee los datos magnetizadosLa cinta magnética almacena datos en una larga tira magnética; es económica para respaldos grandesUn disco óptico como un CD o DVD: un láser lee las marcas en su superficie brillanteUn SSD (disco de estado sólido) almacena datos en chips de memoria flash y no tiene piezas móvilesUn pendrive USB almacena datos en memoria flash y no tiene piezas móvilesEl almacenamiento forma una jerarquía: los registros y la caché son los más rápidos pero los más pequeños; el almacenamiento secundario es el más lento pero el más grande
Explorar
Laboratorio de dispositivos y almacenamiento
Clasificar ejemplos computacionales según la función que cumplen en un sistema.
Cuando la RAM se llena, el ordenador puede usar parte del almacenamiento secundario como RAM extra ficticia. Esto se llama memoria virtual 虚拟内存.
Los datos que no se necesitan en este momento se mueven fuera de la RAM hacia el disco, lo que libera espacio en la RAM para otros programas. Esto permite ejecutar más programas de los que la RAM sola podría contener. Es más lento, porque el almacenamiento secundario es mucho más lento que la RAM.
Cuando la RAM está llena, los datos no utilizados se mueven al disco para liberar RAM — más lento, pero permite que se ejecuten más programas
1 Comprender el significado de almacenamiento primario
• El almacenamiento primario es accedido directamente por la CPU • Incluye el rol de: – memoria de acceso aleatorio (RAM) – memoria de solo lectura (ROM) • Incluye por qué una computadora necesita tanto RAM como ROM, y las diferencias entre ellas
2 Comprender el significado de almacenamiento secundario
• El almacenamiento secundario no es accedido directamente por la CPU y es necesario para el almacenamiento más permanente de los datos
3 Describir el funcionamiento del almacenamiento magnético, óptico y de estado sólido (memoria flash), y dar ejemplos de cada uno
• El almacenamiento magnético utiliza platos que están divididos en pistas y sectores. Los datos se leen y escriben utilizando electroimanes. Incluye disco duro (HDD) • El almacenamiento óptico utiliza láseres para crear y leer surcos y llanuras. Incluye: CD, DVD y Blu-ray • El almacenamiento de estado sólido (memoria flash) utiliza tecnología NAND o NOR. Se utilizan transistores como compuertas de control y compuertas flotantes. Incluye: unidad de estado sólido (SSD), tarjeta SD y memoria USB
4 Describir qué se entiende por memoria virtual, cómo se crea y utiliza, y por qué es necesaria
• Las páginas de datos se transfieren entre la RAM y la memoria virtual según sea necesario
5 Comprender el significado de almacenamiento en la nube
• El almacenamiento en la nube puede accederse de forma remota en comparación con el almacenamiento local de datos
6 Explicar las ventajas y desventajas de almacenar datos en la nube en comparación con su almacenamiento local
• Se necesitan servidores físicos y almacenamiento para guardar datos en el almacenamiento en la nube
Fuente: Plan de estudios Cambridge International
El almacenamiento en la nube 云存储 guarda tus datos en servidores físicos remotos, accesibles a través de internet, en lugar de en tu propio dispositivo.
Ventajas: acceso desde cualquier lugar y cualquier dispositivo; no hay necesidad de comprar ni mantener hardware de almacenamiento local; fácil compartir archivos y realizar copias de seguridad automáticamente.
Desventajas: requiere una conexión a internet funcional; coste de suscripción continuo; la seguridad y la privacidad dependen del proveedor; dependes de que ese proveedor permanezca disponible y en operación.
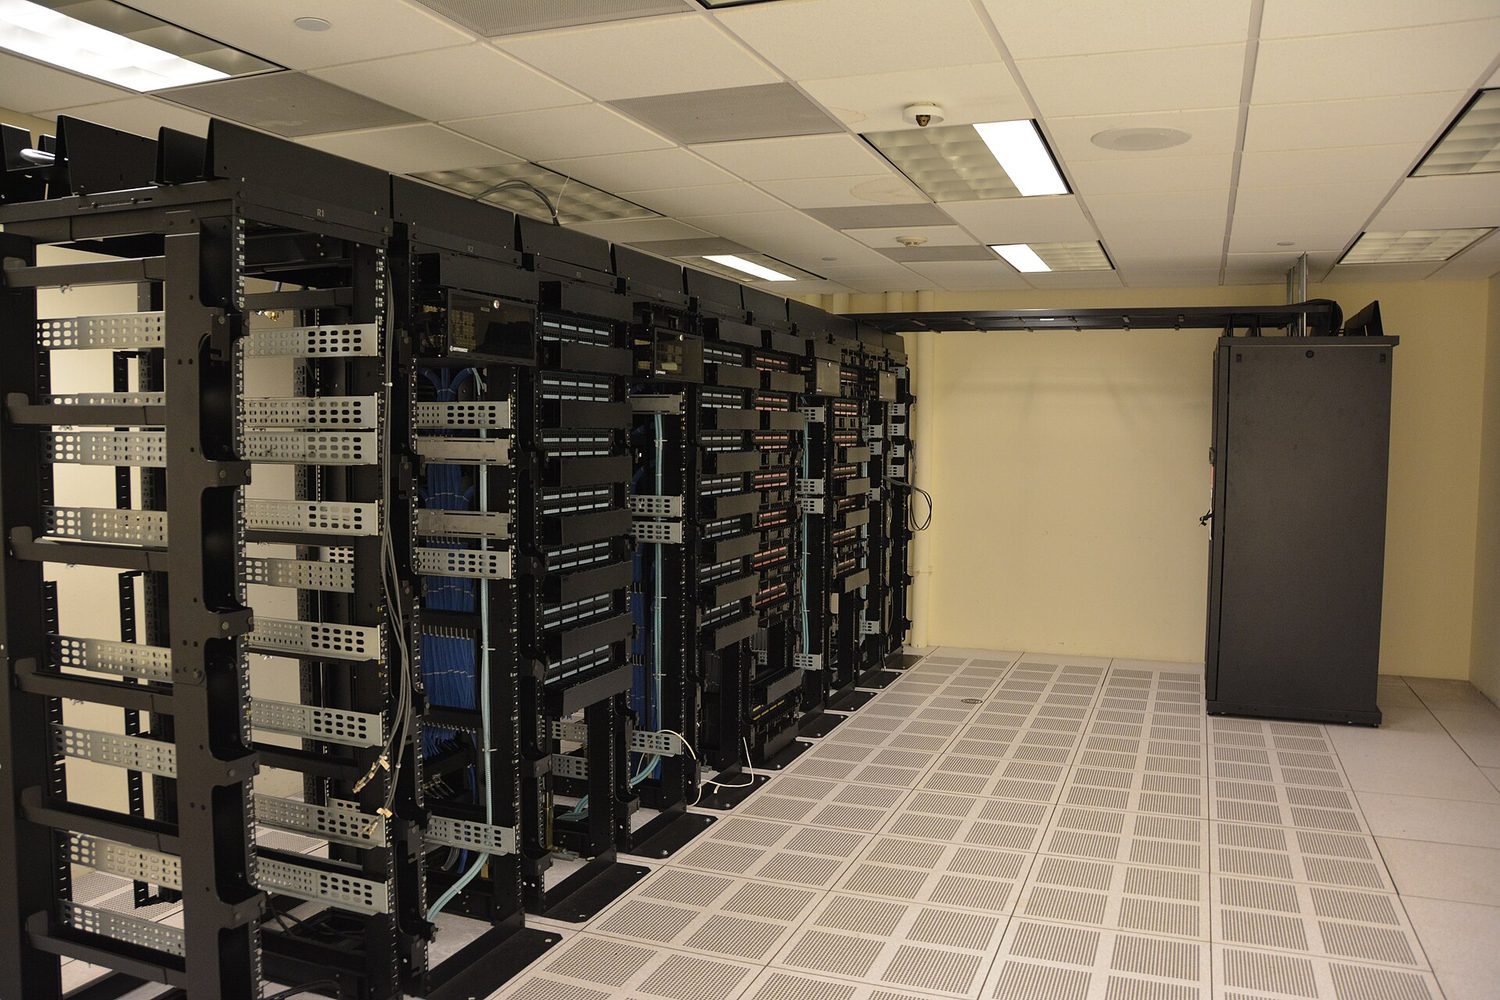
Gabinetes de servidores de centro de datos: el almacenamiento en la nube guarda tus archivos en servidores remotos a los que accedes a través de la red
1 Entender que un ordenador necesita una tarjeta de interfaz de red (NIC) para acceder a una red
2 Entender el significado y la función de una dirección de control de acceso al medio (MAC), incluyendo su estructura
• A una tarjeta de interfaz de red se le asigna una dirección MAC en el momento de la fabricación • Las direcciones MAC se escriben habitualmente en hexadecimal • Las direcciones MAC se crean utilizando el código del fabricante y el código de serie
3 (a) Entender el significado y la función de una dirección de protocolo de Internet (IP) (b) Entender que existen diferentes tipos de direcciones IP
• Una dirección IP es asignada por la red y puede ser estática o dinámica • Incluir las características y diferencias entre IPv4 e IPv6
4 Describir el papel de un router en una red
• Un router envía datos a un destino específico en una red • Un router puede asignar direcciones IP • Un router puede conectar una red local a Internet
Fuente: Plan de estudios Cambridge International
Tarjeta de interfaz de red (NIC)
Una tarjeta de interfaz de red 网络接口卡 (NIC) es el hardware que permite a un dispositivo unirse a una red y enviar y recibir datos. Cada NIC tiene una dirección MAC incorporada.
Dirección MAC e IP
Una dirección MAC (media access control 介质访问 control address) es un número que identifica un dispositivo físico. Lo establece el fabricante y normalmente no cambia. Se escribe en hexadecimal.
Una dirección IP (internet protocol 网际协议 address) es un número que identifica un dispositivo en una red. La asigna la red y puede cambiar.
Por lo tanto, una dirección MAC permanece con el dispositivo, mientras que una dirección IP depende de la red que esté utilizando el dispositivo.
Existen dos versiones de dirección IP. IPv4 es de 32 bits, escrito como cuatro números decimales 0–255 (por ejemplo 192.168.0.1); el más reciente IPv6 es de 128 bits, escrito como ocho grupos de hexadecimales separados por dos puntos, permitiendo una cantidad enorme de direcciones. Una dirección también puede ser estática 静态 (fija, establecida manualmente y que nunca cambia) o dinámica 动态 (asignada por el router/red cada vez que el dispositivo se conecta, por lo que puede cambiar).
Enrutador (Router)
Un enrutador 路由器 conecta diferentes redes entre sí — por ejemplo, tu red doméstica con internet. Lee la dirección IP de cada paquete y lo reenvía hacia la red correcta.
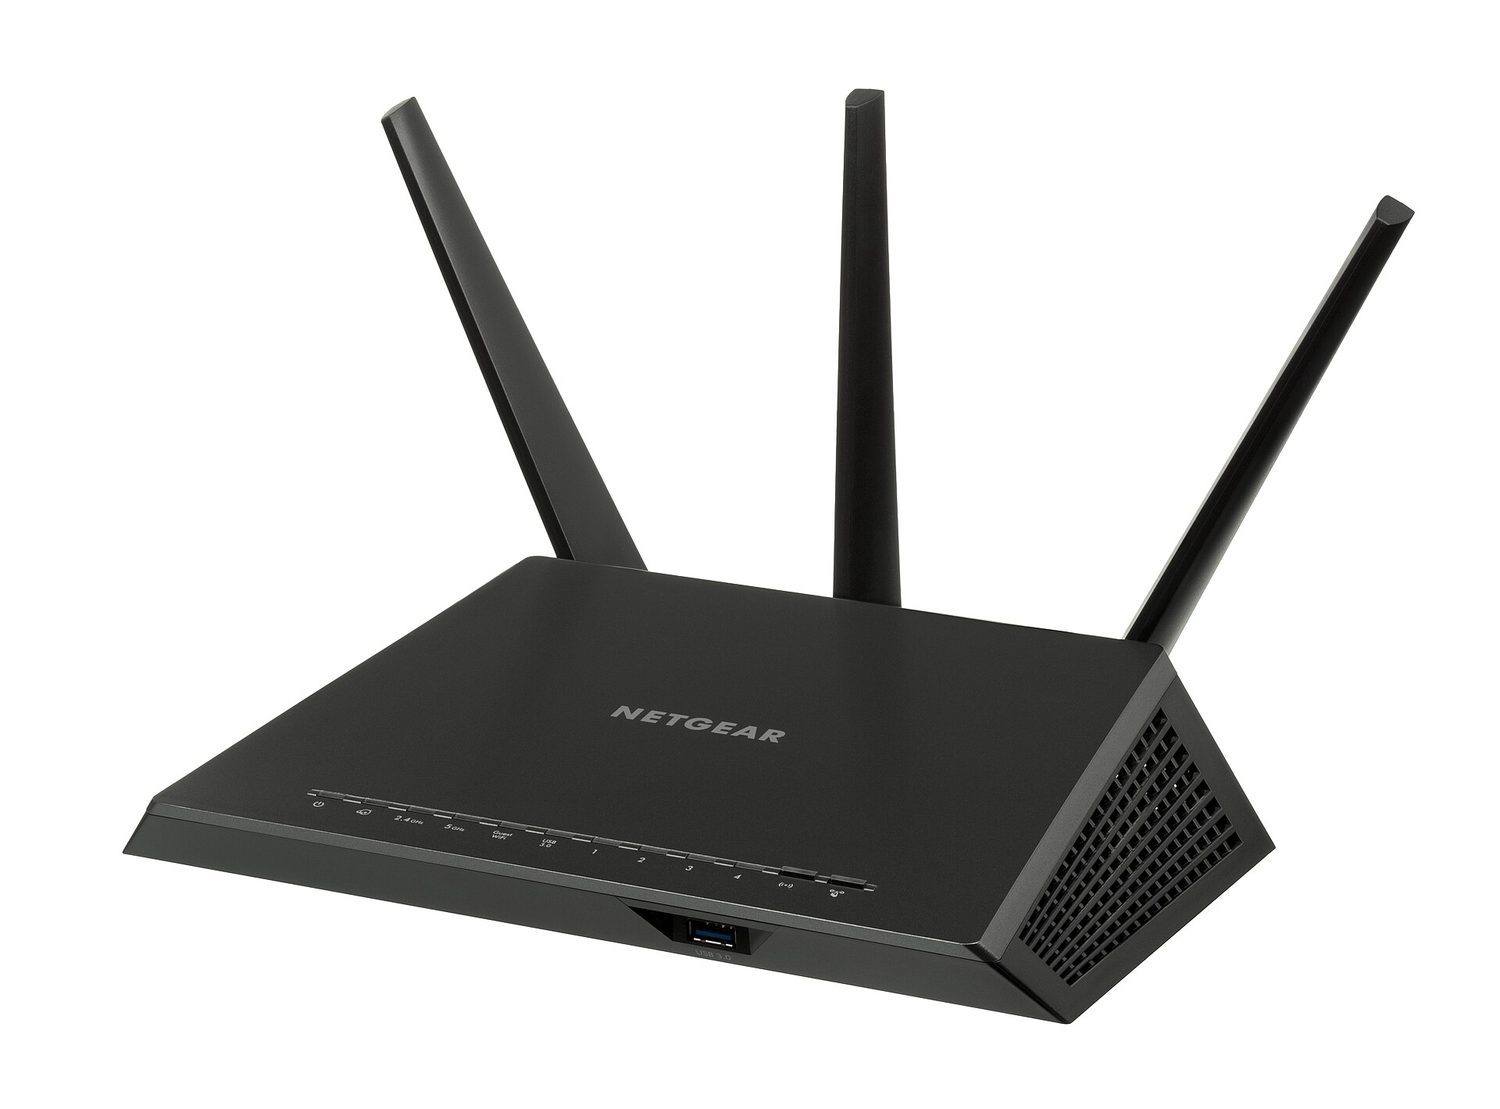
Un router Wi-Fi: el hardware de red reenvía paquetes entre dispositivos y la red más amplia de Internet
Explorar
Laboratorio de rutas de red
Seguir los datos de un dispositivo a través del hardware de red y los protocolos.
Aprende el ciclo de búsqueda-decodificación-ejecución y los registros especiales: el contador de programa guarda la dirección de la siguiente instrucción, el MAR/MDR transportan la dirección/datos, y el acumulador guarda el resultado de la ALU.
El rendimiento de la CPU mejora con más núcleos, una caché más grande y una velocidad de reloj mayor.
La RAM es volátil (pierde sus datos sin energía) y guarda programas en uso; la ROM es no volátil y de solo lectura (las instrucciones de arranque).
Asocia los tipos de almacenamiento secundario: magnético (HDD, cinta), óptico (CD/DVD, leído por láser), estado sólido (SSD, USB, flash — sin piezas móviles).
Una dirección MAC identifica el dispositivo físico y no cambia normalmente; una dirección IP es asignada por la red y puede cambiar.
Un sistema informático está formado por dos partes que trabajan juntas.
El hardware son las partes físicas; el software son los programas
Hardware 硬件 es la parte física 物理的 del ordenador — las partes que se pueden tocar. Ejemplos: la CPU, la memoria, el teclado, la pantalla y el disco duro.
Software 软件 es el conjunto de programas 程序 que controlan el ordenador y dicen al hardware qué hacer.
El hardware no puede hacer nada útil por sí solo. El software necesita hardware para ejecutarse. Ambos son necesarios.
La placa base y las piezas unidas a ella son hardware — las partes físicas que se pueden tocarUn sistema operativo es software — los programas que dicen al hardware qué hacer
1 Describir la diferencia entre el software del sistema y el software de aplicación, y proporcionar ejemplos de cada uno
• El software del sistema proporciona los servicios que necesita el ordenador, incluido el sistema operativo y el software de utilidad • El software de aplicación proporciona los servicios que necesita el usuario
2 Describir el papel y las funciones básicas de un sistema operativo
• Incluyendo: – gestión de archivos – gestión de interrupciones – proporcionación de una interfaz – gestión de periféricos y controladores – gestión de memoria – gestión de multitarea – proporcionación de una plataforma para ejecutar aplicaciones – provisión de seguridad del sistema – gestión de cuentas de usuario
3 Entender cómo se requieren hardware, firmware y un sistema operativo para ejecutar software de aplicación
• Las aplicaciones se ejecutan sobre el sistema operativo • El sistema operativo se ejecuta sobre el firmware • El bootloader (firmware) se ejecuta sobre el hardware
4 Describir el papel y el funcionamiento de las interrupciones
• Incluyendo: – cómo se genera una interrupción – cómo se gestiona mediante una rutina de servicio de interrupciones – qué sucede como resultado de las interrupciones • Las interrupciones por software incluyen la división por cero y dos procesos intentando acceder a la misma ubicación de memoria • Las interrupciones por hardware incluyen presionar una tecla en el teclado y mover el ratón
Fuente: Plan de estudios Cambridge International
El software se divide en dos tipos.
El software se divide en software de sistema (hace funcionar el ordenador) y software de aplicación (permite al usuario realizar una tarea)
Software de sistema
El software de sistema 系统 software controla el propio ordenador y proporciona una base sobre la cual ejecutar otros programas. Ejemplos:
sistema operativo 操作系统 (ver más abajo);
compilador 编译器 y enlazador 链接器 (herramientas que convierten los programas en un formato que el ordenador puede ejecutar);
controlador de dispositivo 设备驱动程序 — software que permite al sistema operativo controlar un componente de hardware;
software de utilidad 实用程序 — herramientas pequeñas que cuidan del ordenador (por ejemplo, antivirus, copias de seguridad, limpieza de discos).
Debajo del sistema operativo se encuentra el firmware 固件 — software almacenado permanentemente en ROM o flash que se ejecuta en el momento en que el ordenador se enciende. El BIOS y el bootloader 引导 program son firmware: comprueban el hardware y luego cargan el sistema operativo. Por lo tanto, las capas se apilan hardware → firmware → sistema operativo → software de aplicación, cada una ejecutándose sobre la capa inferior.
Software de aplicación
El software de aplicación 应用软件 permite al usuario realizar una tarea útil. Ejemplos:
software de procesamiento de textos 文字处理 (escritura de documentos);
software de hoja de cálculo 电子表格 (trabajo con números en una cuadrícula);
sistema de gestión de bases de datos 数据库管理系统 (almacenamiento y búsqueda de datos);
navegador web 网页浏览器 (visualización de páginas web).
providing a user interface/prəˈvaɪdɪŋ ə ˈjuːzə ˈɪntəfeɪs/
用户界面
yòng hù jiè miàn
managing peripherals/ˈmænɪdʒɪŋ pəˈrɪfərəlz/
外围设备
wài wéi shè bèi
managing multitasking/ˈmænɪdʒɪŋ ˈmʌltitæskɪŋ/
多任务处理
duō rèn wù chǔ lǐ
providing a platform/prəˈvaɪdɪŋ ə ˈplætfɔːm/
平台
píng tái
4.1
El sistema operativo
Un sistema operativo (SO) es el principal software de sistema. Controla todo el ordenador y permite que el hardware, el software de aplicación y el usuario trabajen juntos. Sin un SO, el ordenador es muy difícil de usar.
El sistema operativo se sitúa entre el hardware y el software de aplicación y el usuario, permitiendo que trabajen juntos
El OS tiene muchos roles:
gestión de archivos — guardar, abrir, nombrar, mover y eliminar archivos;
manejo de interrupciones (ver más abajo);
proporcionar una interfaz de usuario 用户界面 para que el usuario pueda controlar el ordenador;
gestión de la memoria — decidir qué se mantiene en RAM y dónde;
gestión de periféricos 外围设备和 sus controladores — controlar dispositivos como impresoras;
gestión de la multitarea 多任务处理 — permitir que varios programas se ejecuten simultáneamente;
proporcionar una plataforma 平台 para ejecutar software de aplicación;
gestión de la seguridad — cuentas de usuario, contraseñas y permisos de acceso.
4.1
Interrupciones
Una interrupción 中断 es una señal enviada al procesador 处理器 para indicarle que algo necesita atención inmediata.
Una interrupción puede provenir de tres fuentes:
hardware — por ejemplo, se presiona una tecla, o una impresora se queda sin papel;
software — por ejemplo, un programa intenta dividir por cero;
el usuario — por ejemplo, el usuario presiona una tecla "cancelar".
Cuando llega una interrupción, el procesador detiene lo que está haciendo, guarda su posición y atendiendo (resolviendo) la interrupción. Cuando esto está hecho, vuelve a lo que estaba haciendo antes. Esto permite que el ordenador reaccione rápidamente a eventos importantes.
En una interrupción, la CPU guarda su posición, ejecuta la rutina de servicio de interrupciones, luego restaura su posición y continúa
Explorar
Cómo la CPU maneja una interrupción
Paso a paso de una interrupción. La CPU pausa lo que está haciendo, atiende el evento urgente, luego continúa exactamente donde se detuvo — así es como un procesador gestiona simultáneamente el teclado, la impresora y el temporizador.
central processing unit/ˈsentrəl ˈprəʊsesɪŋ ˈjuːnɪt/
中央处理器
zhōng yāng chǔ lǐ qì
programming language/ˈprəʊɡræmɪŋ ˈlæŋɡwɪdʒ/
编程语言
biān chéng yǔ yán
high-level language/haɪ ˈlevl ˈlæŋɡwɪdʒ/
高级语言
gāo jí yǔ yán
low-level language/ləʊ ˈlevl ˈlæŋɡwɪdʒ/
低级语言
dī jí yǔ yán
machine code/məˈʃiːn kəʊd/
机器码
jī qì mǎ
assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/
汇编语言
huì biān yǔ yán
specific/spəˈsɪfɪk/
特定的
tè dìng de
translator/trænˈsleɪtə/
翻译程序
fān yì chéng xù
4.2
Lenguajes de programación
Syllabus
Los candidatos deben ser capaces de:
Notas y orientación
1 Explicar qué se entiende por lenguaje de alto nivel y un lenguaje de bajo nivel, incluyendo las ventajas e inconvenientes de cada uno
• Las ventajas e inconvenientes incluyen: – facilidad para leer y escribir código, p. ej., el lenguaje de bajo nivel es difícil de leer; – facilidad para depurar código; – independencia de la máquina; – manipulación directa del hardware
2 Entender que el lenguaje ensamblador es una forma de lenguaje de bajo nivel que utiliza mnemotécnicos, y que se necesita un ensamblador para traducir un programa en lenguaje ensamblador a código máquina
3 Describir el funcionamiento de un compilador y un intérprete, incluyendo cómo cada uno traduce un lenguaje de alto nivel y cómo se informan los errores
• Un compilador traduce todo el código de una vez antes de ejecutarlo, produciendo un archivo ejecutable • Un intérprete traduce y ejecuta el código línea por línea • Un compilador proporciona un informe de errores para todo el código si se detectan errores • Un intérprete detiene la ejecución cuando encuentra un error
4 Explicar las ventajas e inconvenientes de un compilador y un intérprete
• Incluye la comprensión de que un intérprete se utiliza principalmente durante el desarrollo de un programa y un compilador se utiliza para traducir el programa final
5 Explicar el papel de un IDE en la escritura de código de programas y las funciones comunes que ofrecen los IDEs
• Incluyendo: – editores de código; – entorno de tiempo de ejecución; – traductores; – diagnósticos de errores; – autocompletado; – autocorrección; – formateo automático (prettyprint)
Fuente: Plan de estudios Cambridge International
Todos los ordenadores procesan datos utilizando la unidad central de procesamiento 中央处理器 (CPU). Para hacer que la CPU realice trabajo, las personas escriben programas en un lenguaje de programación 编程语言. Hay dos clases.
Lenguajes de alto nivel
Un lenguaje de alto nivel 高级语言 se escribe en palabras que se parecen un poco al inglés (por ejemplo Python). Es:
fácil para las personas leer, escribir y corregir;
independiente del ordenador — el mismo programa puede ejecutarse en diferentes tipos de ordenadores.
Lenguajes de bajo nivel
Un lenguaje de bajo nivel 低级语言 está cerca de lo que el hardware utiliza realmente. Incluye:
código máquina 机器码 — instrucciones escritas en binario (0s y 1s), que la CPU ejecuta directamente;
lenguaje ensamblador 汇编语言 — código máquina escrito con códigos de palabras cortas (mnemotecnias) en lugar de binario.
Un lenguaje de bajo nivel se relaciona con el tipo específico 特定的 de CPU, por lo que un programa escrito para una CPU puede no ejecutarse en otra. Se utiliza cuando el programador necesita control total del hardware o código muy rápido y pequeño.
Los lenguajes de alto nivel están cerca del lenguaje humano y se ejecutan en cualquier ordenador; los lenguajes de bajo nivel (ensamblador y código máquina) están cerca del hardware y vinculados a un tipo específico de CPU
Explorar
Laboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
La CPU solo puede ejecutar código máquina. Un programa de alto nivel debe convertirse primero en código máquina. El software que hace esto es un traductor 翻译程序. Hay tres tipos: un compilador y un intérprete (para código de alto nivel), y un ensamblador (para código de bajo nivel).
Compilador
Un compilador traduce el entero programa en código máquina antes de ser ejecutado. Después de traducirse, el código máquina puede ejecutarse muchas veces sin necesidad de volver a traducirlo.
la traducción ocurre una sola vez, en su totalidad;
informa de todos los errores juntos, al final de la traducción;
el programa terminado se ejecuta rápido y no necesita el compilador para correr.
Intérprete
Un intérprete 解释器 traduce y ejecuta el programa una línea a la vez.
se detiene en el primer error que encuentra, lo cual ayuda durante las pruebas;
el programa se ejecuta más lento, porque se traduce cada vez que corre;
el intérprete debe estar presente cada vez que el programa se ejecuta.
Compilador
Intérprete
Traduce
el programa completo de una vez
una línea a la vez
Errores
todos reportados al final
se detiene en el primer error
Velocidad del programa final
más rápido
más lento
¿Necesitado para ejecutar después?
no
sí
Utilice un compilador cuando desee compartir un programa finalizado y rápido. Utilice un intérprete cuando esté escribiendo y probando un programa y desee encontrar errores fácilmente.
Ensamblador
Un ensamblador 汇编器 traduce un programa de lenguaje ensamblador de bajo nivel (escrito en mnemotecnias como LDA, ADD) en código máquina. Cada mnemotecnia se convierte en una instrucción de máquina — una traducción directa uno a uno, a diferencia de un compilador o intérprete, que trabajan con código de alto nivel.
Un compilador traduce el programa entero una vez en código máquina; un intérprete traduce y ejecuta una línea a la vez
Ejemplo resuelto. Un equipo está escribiendo un programa. Durante su desarrollo quieren encontrar y corregir errores rápidamente; cuando lo lancen, quieren que los clientes lo ejecuten rápido sin ver el código fuente. ¿Qué traductor se adapta a cada etapa? Durante el desarrollo, use un intérprete: traduce y ejecuta una línea a la vez y se detiene en el primer error, por lo que es fácil localizar un mistake. Para lanzarlo, use un compilador: traduce el programa entero una vez en código máquina, que luego se ejecuta rápidamente sin ningún traductor presente, y el cliente recibe solo el ejecutable en lugar del código fuente. Los dos no son rivales - nombre la etapa y dé la razón, ya que "un compilador es más rápido" por sí solo no otorga puntos.
integrated development environment/ˈɪntɪɡreɪtɪd dɪˈveləpmənt enˈvaɪrənmənt/
集成开发环境
jí chéng kāi fā huán jìng
code editor/kəʊd ˈedɪtə/
代码编辑器
dài mǎ biān jí qì
run time environment/rʌn taɪm enˈvaɪrənmənt/
运行时环境
yùn xíng shí huán jìng
error diagnostics/ˈerə ˌdaɪəɡˈnɒstɪks/
错误诊断
cuò wù zhěn duàn
auto-completion/ˈɔːtəʊ kəmˈpliːʃn/
自动补全
zì dòng bǔ quán
auto-correction/ˈɔːtəʊ kəˈrekʃn/
自动纠错
zì dòng jiū cuò
prettyprinting/ˈpretɪprɪntɪŋ/
美化打印
měi huà dǎ yìn
user interface/ˈjuːzə ˈɪntəfeɪs/
用户界面
yòng hù jiè miàn
peripherals/pəˈrɪfərəlz/
外围设备
wài wéi shè bèi
multitasking/ˈmʌltitæskɪŋ/
多任务处理
duō rèn wù chǔ lǐ
platform/ˈplætfɔːm/
平台
píng tái
4.2
Entorno de desarrollo integrado (IDE)
Un entorno de desarrollo integrado 集成开发环境 (IDE) es un software que le ayuda a escribir programas. Reúne muchas herramientas útiles en un solo lugar:
un editor de código 代码编辑器 — para escribir su programa;
un entorno de ejecución 运行时环境 — para ejecutar el programa y probarlo;
un traductor — un compilador o intérprete para convertir su código en código máquina;
diagnóstico de errores 错误诊断 — mensajes que ayudan a encontrar y comprender los errores;
autocompletado 自动补全 y autocorrección 自动纠错 — el IDE completa o corrige el código mientras escribe;
impresión formateada 美化打印 — presentación del código de forma ordenada con colores e indentación para que sea fácil de leer.
Código fuente en un editor: un IDE combina editor, depurador y herramientas de ejecución en un solo lugar
4.2
Consejos para el examen
El hardware son las partes físicas; el software son los programas. El software de sistema hace funcionar el ordenador (SO, controladores, utilidades); el software de aplicación realiza una tarea para el usuario.
Un compilador traduce el programa completo de una vez (el programa finalizado se ejecuta rápido y todos los errores se reportan al final); un intérprete traduce línea por línea (se detiene en el primer error, se ejecuta más lento y es necesario cada vez).
Los lenguajes de alto nivel están cerca del inglés y se ejecutan en cualquier ordenador; los lenguajes de bajo nivel (ensamblador, código máquina) están vinculados a un tipo específico de CPU.
Una interrupción es una señal que hace que la CPU se detenga, guarde su posición, atienda el evento y luego continúe desde donde lo dejó.
Aprenda los roles del sistema operativo: gestión de archivos, memoria, periféricos, multitarea, seguridad e interfaz de usuario.
1 Entender la diferencia entre la internet y la World Wide Web
• La internet es la infraestructura • La World Wide Web es el conjunto de sitios web y páginas web accesibles mediante la internet
2 Entender qué se entiende por un uniform resource locator (URL)
• Un URL es una dirección basada en texto para una página web; puede contener el protocolo, el nombre de dominio y el nombre de la página/web o archivo
3 Describir el propósito y funcionamiento del hypertext transfer protocol (HTTP) y del hypertext transfer protocol secure (HTTPS)
4 Explicar el propósito y las funciones de un navegador web
• El propósito principal de un navegador web es renderizar el lenguaje de marcado de hipertexto (HTML) y mostrar páginas web • Las funciones incluyen: – guardar marcadores y favoritos – registrar el historial del usuario – permitir el uso de varias pestañas – almacenar cookies – proporcionar herramientas de navegación – proporcionar una barra de direcciones
5 Describir cómo se localizan, recuperan y muestran las páginas web en un dispositivo cuando un usuario introduce un URL
• Incluyendo el papel de: – el navegador web – las direcciones IP – el servidor de nombres de dominio (DNS) – el servidor web – HTML
6 Explicar qué se entiende por cookies y cómo se utilizan, incluidas las cookies de sesión y las cookies persistentes
• Las cookies se utilizan para funciones, entre otras: – guardar datos personales – rastrear las preferencias del usuario – mantener artículos en un carrito de compras en línea – almacenar detalles de inicio de sesión
Fuente: Plan de estudios Cambridge International
A menudo se confunden estos dos términos, pero no son lo mismo.
El internet 互联网 es la infraestructura 基础设施 — la enorme red mundial de computadoras y los cables, enrutadores y conexiones que las unen.
La World Wide Web (WWW) 万维网 es una colección de sitios web 网站 y páginas web que visualizas utilizando internet.
Así que el internet es la red; la web es una de las cosas que usas sobre esa red.
El internet es la red mundial; la World Wide Web es una de las cosas que usas sobre ellaUn enrutador une tu red doméstica a internet y envía datos al lugar correcto
Un uniform resource locator 统一资源定位符 (URL) es una dirección basada en texto para una página web. La escribes en un navegador web 网页浏览器 para visitar una página, por ejemplo https://www.example.com/index.html.
Una URL tiene tres partes: el protocolo, el nombre de dominio y la ruta hacia la página en el servidor
Un navegador web es el programa que utilizas para ver páginas web. Sus funciones incluyen:
renderizar 渲染 el lenguaje de marcado de hipertexto 超文本标记语言 (HTML) — convertir el código de la página en lo que ves;
mostrar páginas web en la pantalla;
gestionar cómo se presenta una página web — su diseño, texto e imágenes.
5.1
Cómo llega una página web hasta ti
Cuando escribes una URL y presionas Enter, ocurren varios pasos:
El navegador necesita la dirección IP 网际协议地址 del sitio web, pero una URL usa un nombre, no un número.
El navegador consulta un servicio de nombres de dominio 域名服务 (DNS) — un sistema que almacena la dirección IP para cada dirección web.
El DNS encuentra la dirección IP coincidente y la devuelve al navegador.
El navegador usa la dirección IP para contactar al servidor web 网页服务器 que almacena la página.
El servidor web devuelve el HTML de la página al navegador.
El navegador convierte el HTML en la página y la muestra.
El navegador solicita a un DNS la dirección IP del sitio, luego solicita la página al servidor web, que devuelve el HTML
Si el DNS no tiene la dirección, consulta otro servidor DNS hasta encontrarla.
Un centro de datos lleno de servidores: computadoras potentes que almacenan sitios web y te los envían
Ejemplo resuelto. Desglosa la URL https://www.example.com/books/index.html. https es el protocolo, el conjunto de reglas utilizado para transferir la página (la s significa que la transferencia está cifrada). www.example.com es el nombre de dominio, que identifica al servidor web y que un servidor DNS convierte en una dirección IP. /books/index.html es la ruta de archivo y nombre de archivo del recurso almacenado en ese servidor. Nombra cada parte junto con su función: una respuesta que diga "la primera parte" y "la última parte" describe la URL sin explicarla nunca.
Explorar
Qué sucede al cargar una página web
Paso a paso. La dirección web es solo un nombre; DNS lo convierte en una dirección IP antes de que el navegador pueda solicitar la página al servidor correcto.
5.1
Cookies
Una cookie es un pequeño archivo de texto que un sitio web almacena en tu dispositivo. Permite que el sitio web recuerde cosas sobre ti. Hay dos tipos.
Una cookie es un pequeño archivo de texto almacenado en tu computadora
Tipo
¿Se mantiene al cerrar el navegador?
Se usa para
session 会话 cookie
no — se elimina al cerrar el navegador
datos a corto plazo, p. ej., artículos en una canasta de compras
persistent 持久 cookie
sí — se guarda en el dispositivo
recordarte entre visitas
Las cookies se utilizan para:
guardar datos personales para que no tengas que escribirlos nuevamente (como inicio de sesión o dirección);
rastrear preferencias de usuario 用户偏好, como tu idioma o las cosas que te gustan, para que el sitio pueda sugerir contenido.
1 Comprender el concepto de una moneda digital y cómo se utilizan las monedas digitales
• Una moneda digital es aquella que solo existe de forma electrónica
2 Comprender el proceso de la blockchain y cómo se utiliza para rastrear transacciones de moneda digital
• La blockchain, en su forma básica, es un libro contable digital, es decir, una serie cronologizada de registros que no pueden ser alterados
Fuente: Plan de estudios Cambridge International
Una moneda digital 数字货币 es dinero que existe solo en forma electrónica 电子形式. No hay monedas ni billetes. Se almacena y transfiere entre personas usando computadoras, y puede usarse para pagar cosas en línea.
Un problema con el dinero digital es la confianza: ¿cómo evitas que alguien gaste el mismo dinero dos veces, o cambie los registros? Blockchain soluciona esto.
Un blockchain 区块链 es un libro mayor digital 数字账本 — un registro compartido de cada transacción 交易. El registro se copia en muchas computadoras, por lo que ninguna persona individual lo controla y es muy difícil de modificar.
Las transacciones se mantienen en bloques unidos en una cadena. Cada bloque contiene:
los datos de la transacción (quién pagó a quién, y cuánto);
una marca temporal 时间戳 (la fecha y la hora);
un valor hash 哈希值 — un código especial calculado a partir del contenido del bloque.
Cada bloque también almacena el hash del bloque anterior. Si alguien cambia un bloque antiguo, su hash cambia, por lo que ya no coincide con el siguiente bloque. Esto rompe la cadena y el cambio se detecta de inmediato. Así es como blockchain rastrea las transacciones de forma segura.
Cada bloque almacena el hash del bloque anterior, encadenando los bloques; cambiar un bloque rompe la cadena
Explorar
Hashing detrás de una blockchain
Un hash es unidireccional y un pequeño cambio en la entrada invierte gran parte de la salida; una blockchain encadena estos hashes para que cualquier alteración sea evidente.
distributed denial of service/ˈdɪstrɪbjuːtɪd dɪˈnaɪəl ɒv ˈsɜːvɪs/
分布式拒绝服务
fēn bù shì jù jué fú wù
5.3
Amenazas de ciberseguridad
Syllabus
Los candidatos deben ser capaces de:
Notas y orientación
1 Describir los procesos implicados en, y el objetivo de llevar a cabo, una variedad de amenazas de ciberseguridad
• Incluyendo: – ataque de fuerza bruta – interceptación de datos – ataque de denegación de servicio distribuida (DDoS) – hacking – malware (virus, gusano, caballo de Troya, spyware, adware, ransomware) – pharming – phishing – ingeniería social
2 Explicar cómo se utilizan una variedad de soluciones para ayudar a mantener los datos seguros frente a amenazas de seguridad
• Incluyendo: – niveles de acceso – anti-malware, incluyendo antivirus y antispyware – autenticación (nombre de usuario y contraseña, biometría, verificación en dos pasos) – automatización de actualizaciones de software – revisión ortográfica y de tono de las comunicaciones – verificación de la URL asociada a un enlace – cortafuegos – configuraciones de privacidad – servidores proxy – protocolo de seguridad de capa de sockets seguros (SSL)
Fuente: Plan de estudios Cambridge International
Ciberseguridad 网络安全 significa mantener computadoras, redes y datos seguros contra ataques. Debes conocer estas amenazas.
Amenaza
Qué es
ataque de fuerza bruta 暴力破解
intentar muchas contraseñas muy rápidamente hasta encontrar la correcta
intercepción de datos 数据拦截
"escuchar" para robar datos mientras viajan a través de una red
ataque de denegación de servicio distribuido 分布式拒绝服务 (DDoS)
inundar un servidor con tantas solicitudes que no puede responder, haciendo que el sitio web caiga
hacking 黑客攻击
acceder a un sistema informático sin permiso
malware 恶意软件
software dañino (ver la tabla de abajo)
pharming 域名欺骗
un código secreto te redirige a un sitio falso incluso cuando escribes la dirección correcta
phishing 网络钓鱼
correos electrónicos o mensajes falsos que engañan para que des detalles privados
ingeniería social 社会工程
engañar a una persona (no a una computadora) para que vulneré la seguridad, p. ej., fingiendo ser el jefe
Tipos de malware
El malware es cualquier software diseñado para dañar una computadora. Los principales tipos son:
Malware
Qué hace
virus 病毒
se adhiere a un archivo y se copia a sí mismo cuando se abre el archivo; puede borrar o dañar datos
gusano 蠕虫
se copia a sí mismo a través de una red por cuenta propia, sin necesidad de que se abra un archivo
caballo de Troya 特洛伊木马
finge ser software útil, pero daña la computadora una vez instalado
spyware 间谍软件
registra secretamente lo que haces, como las teclas que presionas
adware 广告软件
te inunda con anuncios no deseados
ransomware 勒索软件
bloquea tus archivos y exige pago para desbloquearlos
Impacto de las amenazas
Estos ataques pueden robar datos personales, eliminar o modificar archivos, detener el funcionamiento de un servicio, costar dinero y hacer que los usuarios pierdan la confianza en una empresa. Por ejemplo, un ataque DDoS puede hacer que una tienda en línea sea inutilizable, perdiendo ventas.
Un candado: la ciberseguridad protege los datos y sistemas contra malware, phishing y acceso no autorizado
niveles de acceso 访问权限 — cada usuario solo puede ver o cambiar los datos que necesita, nada más.
software anti-malware 反恶意软件, incluido antivirus 杀毒软件 y anti-spyware 反间谍软件 — escanea y elimina software dañino.
autenticación 身份验证 — demostrar quién eres antes de obtener acceso. Los métodos incluyen:
biometría 生物识别 (huella dactilar o rostro),
una contraseña 密码,
verificación en dos pasos 两步验证 (un código enviado a tu teléfono además de una contraseña).
automatización de actualizaciones de software — las actualizaciones corrigen puntos débiles (errores) en el software automáticamente.
revisar la ortografía y el tono de los mensajes — mala ortografía o un tono extraño y urgente pueden indicar que un mensaje es falso (phishing).
revisar la URL asociada a un enlace — una dirección web incorrecta o extraña te advierte que el enlace no es seguro.
firewall 防火墙 — revisa los datos que entran y salen de una red y bloquea lo que no esté permitido.
configuraciones de privacidad 隐私设置 — controlan quién puede ver tu información en línea.
Un firewall se sitúa entre internet exterior y tu red, verificando cada conexión y bloqueando cualquier tráfico no permitido
servidor proxy 代理服务器 — se sitúa entre el usuario e internet, ocultando la dirección IP del usuario y filtrando contenido inseguro.
Explorar
Cifrado con clave
Cambiar el desplazamiento — esa es la clave. Cada letra se deslaza ese número de lugares para formar texto cifrado, y la misma clave lo deslaza hacia atrás. Ese es el cifrado simétrico.
El internet es la red mundial (la infraestructura); la World Wide Web son las páginas que visualizas sobre ella — no los confundas.
Aprende cómo se carga una página: el navegador consulta a un DNS la dirección IP del sitio, luego solicita la página al servidor web, que devuelve el HTML.
Asocia los tipos de malware: virus (se adhiere a un archivo), gusano (se extiende solo por la red), caballo de Troya (finge ser útil), spyware, ransomware.
Asocia cada amenaza con su defensa: phishing/pharming → revisar la URL; fuerza bruta → contraseñas fuertes + verificación en dos pasos; intercepción → cifrado; hacking/DDoS → un firewall.
Una cookie session se elimina al cerrar el navegador; una cookie persistent se guarda para recordarte entre visitas.
Un sistema automatizado es una combinación de software y hardware que detecta y responde a datos en su entorno, sin necesidad de intervención humana. En otras palabras, funciona por sí solo.
Ejemplos de sistemas automatizados:
un sistema de calefacción central;
un proceso químico en una fábrica;
un invernadero (para el cultivo de plantas);
una barrera de aparcamiento.
Sensores, microprocesadores y actuadores
Tres componentes trabajan conjuntamente en un sistema automatizado.
Parte
Función
sensor 传感器
mide una magnitud física (como la temperatura o la luz) y envía los datos
microprocesador 微处理器
compara los datos con valores almacenados y toma decisiones
actuador 执行器
recibe una señal y provoca movimiento o acción (como abrir una válvula)
El ciclo funciona de la siguiente manera:
El sensor envía datos al microprocesador.
El microprocesador compara estos datos con valores almacenados y toma una decisión.
El microprocesador envía señales a los actuadores para que tomen acción.
Por ejemplo, en un invernadero: un sensor de temperatura lee el calor; el microprocesador lo compara con el valor deseado; si hace demasiado calor, el microprocesador activa un actuador para abrir una ventana.
Un sensor alimenta al microprocesador, que compara la lectura con un valor almacenado y activa un actuador; luego el ciclo se repite
El programa denomina a muchos tipos de sensores, cada uno midiendo una magnitud física específica —por ejemplo, un acelerómetro (movimiento o inclinación), un sensor de humedad (agua en el aire) y un sensor de proximidad (un objeto cercano):
Sensor
Mide
Uso típico
temperatura
calor
hornos, invernaderos, calefacción
luz
brillo
luces automáticas, cámaras
presión
fuerza sobre una superficie
alfombras de alarma, pantallas táctiles
infrarrojos / proximidad
un objeto cercano
puertas automáticas, sensores de aparcamiento
acústico (sonido)
nivel de sonido
monitores de ruido
humedad / humedad del suelo
agua en el aire o en el suelo
invernaderos, riego
gas
presencia de gas
alarmas de humo y CO
pH
acidez
piscinas, acuarios
acelerómetro
movimiento o inclinación
teléfonos, activación de airbags
campo magnético
magnetismo
contactos de puerta, brújulas
flujo / nivel
flujo de fluido o profundidad
tuberías, depósitos
Para elegir un sensor para un escenario, seleccione aquel que mida la magnitud física correcta: un acuario necesita sensores de pH y temperatura; una puerta automática necesita un sensor infrarrojo/de proximidad.
Ventajas e inconvenientes
Los sistemas automatizados se utilizan en muchas situaciones, como la industria, el transporte, la agricultura (cultivo), meteorología (recopilación de datos), videojuegos e iluminación.
Las ventajas e inconvenientes de los sistemas automatizadosUn dron con cámara: puede volar solo a lo largo de una ruta establecida para recopilar datos
Ventajas
Desventajas
trabajan todo el día y toda la noche, sin descanso
cuestan mucho comprar y configurar
más rápidos y más consistentes que las personas
pueden averiarse y necesitar reparación experta
pueden trabajar en lugares inseguros para las personas
pueden reemplazar los empleos humanos
menos errores humanos
no pueden reaccionar fácilmente ante situaciones para las que no fueron diseñados
Ejemplo resuelto. Describa cómo un invernadero automático mantiene la temperatura a 25 °C. Un sensor de temperatura mide continuamente la temperatura y envía su lectura, convertida a digital por un conversor analógico-digital (ADC), al microprocesador. El microprocesador compara la lectura con el valor almacenado de 25 °C. Si la temperatura está por encima, el microprocesador activa un actuador para abrir una ventana o encender un ventilador; si está por debajo, enciende un calentador. Todo el ciclo se repite continuamente. Dos puntos casi siempre se asignan a las frases "compara con un valor almacenado (preestablecido)" y "el proceso se repite"; una descripción que se detiene en "el sensor le dice a la computadora" deja esos puntos fuera.
Explorar
Un bucle de control automatizado
Toca alrededor del bucle. Un sistema automatizado percibe, compara contra un objetivo y actúa —y como la acción cambia lo que percibe, se corrige a sí mismo sin necesidad de humanos.
• La robótica es una rama de la informática que incluye el diseño, la construcción y el funcionamiento de robots • Ejemplos incluyen equipos de fábrica, robots domésticos y drones
2 Describir las características de un robot
• Incluyendo: – una estructura mecánica o armazón – componentes eléctricos, como sensores, microprocesadores y actuadores – programable
3 Entender los roles que pueden desempeñar los robots y describir las ventajas e inconvenientes de su uso
• Los robots pueden utilizarse en áreas que incluyen: – industria – transporte – agricultura – medicina – entornos domésticos – entretenimiento
Fuente: Plan de estudios Cambridge International
La robótica es la rama de la tecnología que se ocupa del diseño, construcción y funcionamiento de los robots.
Un robot tiene estas características:
una estructura física (un cuerpo mecánico, como brazos robóticos);
componentes eléctricos (motores, sensores y cableado);
instrucciones programables — sigue un programa que puede modificarse.
Lo que hacen los robots
Los robots pueden desempeñar múltiples funciones, por ejemplo:
equipos de fábrica — construcción de automóviles, soldadura, manipulación de piezas pesadas;
electrodomésticos — como una aspiradora robótica.
Un brazo robótico industrial. Sigue un programa y puede ser reprogramado para realizar una nueva tarea.Una aspiradora robot: un robot doméstico que se desplaza solo para limpiar el suelo.
Ventajas
Desventajas
realizan trabajos aburridos o peligrosos
caras de comprar y mantener
trabajan rápida y exactamente
pueden reemplazar a los trabajadores humanos
no se cansan ni se aburren
carecen de capacidad de toma de decisiones independiente — solo hacen lo que están programados para hacer
Un límite clave de los robots es que no pueden pensar por sí mismos. No pueden tomar sus propias decisiones cuando ocurre algo inesperado.
Explorar
Laboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
1 Comprender lo que se entiende por inteligencia artificial (IA)
• La IA es una rama de la informática que trata con la simulación de comportamientos inteligentes mediante computadoras
2 Describir las características principales de la IA como la recopilación de datos y las reglas para utilizar esos datos, la capacidad de razonar, y puede incluir la capacidad de aprender y adaptarse
3 Explicar el funcionamiento básico y los componentes de los sistemas de IA para simular comportamiento inteligente
• Limitado a: – sistemas expertos – aprendizaje automático • Los sistemas expertos tienen una base de conocimiento, una base de reglas, un motor de inferencia y una interfaz • El aprendizaje automático es cuando un programa tiene la capacidad de adaptar automáticamente sus propios procesos y/o datos
Fuente: Plan de estudios Cambridge International
La inteligencia artificial (IA) es la simulación de la inteligencia humana mediante sistemas informáticos. Esto significa que una computadora realiza tareas que normalmente requieren pensamiento humano.
Características de la IA
Los sistemas de IA suelen tener estas características:
recopilan datos y las reglas para utilizar esos datos;
tienen la capacidad de razonar (deducir utilizando las reglas);
tienen la capacidad de extraer conclusiones, que pueden ser aproximadas (una mejor suposición) o definitivas (seguras);
tienen la capacidad de aprender de los datos;
tienen la capacidad de adaptarse — cambiar su comportamiento a medida que reciben nuevos datos.
Un sistema de IA recopila datos, aplica reglas, actúa, luego aprende y mejora a partir del resultado antes de recopilar más datos
Ejemplos de IA
sistemas expertos — software que da consejos como un experto humano (por ejemplo, ayudando a un médico con un diagnóstico);
procesamiento del lenguaje natural — comprensión del habla o texto humano;
coches autónomos.
Un coche autónomo: los sensores del vehículo permiten que una computadora lo dirija sin conductor.
Dentro de un sistema experto
Un sistema experto almacena el conocimiento humano y razona a partir de él. Tiene cuatro partes:
una base de conocimientos – los hechos almacenados sobre el tema;
una base de reglas – las reglas "si... entonces..." que aplicaría un experto humano;
un motor de inferencia – aplica las reglas a los hechos para llegar a una conclusión;
una interfaz de usuario – hace preguntas al usuario y muestra el resultado.
La interfaz recopila datos del usuario; el motor de inferencia ejecuta la base de reglas contra la base de conocimientos; y el sistema produce un diagnóstico o una probabilidad, como se utiliza para ayudar a un médico a diagnosticar una enfermedad o encontrar una falla en un automóvil.
Aprendizaje automático
El aprendizaje automático es un programa que mejora su propio rendimiento gracias a la experiencia, sin necesidad de ser reprogramado explícitamente. Encuentra patrones en los datos y se adapta: un buscador mejora en clasificar resultados, un asistente de voz reconoce comandos hablados con mayor precisión, y una aspiradora robótica aprende gradualmente la distribución de una habitación.
IA estrecha, general y fuerte
La IA estrecha realiza una tarea (toda la IA actual); la IA general podría realizar cualquier tarea humana; la IA fuerte sería consciente de sí misma — ninguna existe aún
Tipo
Significado
IA estrecha
puede realizar solo una tarea o un pequeño conjunto de tareas (por ejemplo, un programa de ajedrez). Toda la IA actual es IA estrecha.
IA general
podría realizar cualquier tarea que pueda hacer un humano, cambiando entre muchas tareas diferentes.
IA fuerte
pensaría y tendría conciencia como una mente humana real. Esto aún no existe.
Explorar
Laboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
Aprenda el bucle de control: un sensor mide una magnitud → el microprocesador la compara con un valor almacenado → un actuador toma acción; luego el ciclo se repite.
No confunda los componentes: un sensor envía datos hacia adentro; un actuador provoca movimiento hacia afuera.
Un robot sigue instrucciones programables y no puede tomar sus propias decisiones cuando ocurre algo inesperado.
La IA simula el pensamiento humano: recopila datos y reglas, razona, extrae conclusiones y puede aprender y adaptarse.
Conozca los niveles de IA: estrecha (una tarea; toda la IA actual), general (cualquier tarea humana), fuerte (consciente de sí misma; aún no existe).
1 Comprender el ciclo de vida del desarrollo de programas, limitado a: análisis, diseño, codificación y pruebas
• Incluyendo identificar cada etapa y realizar estas tareas para cada una: – análisis: abstracción, descomposición del problema, identificación del problema y los requisitos – diseño: descomposición, diagramas estructurales, diagramas de flujo, pseudocódigo – codificación: escritura de código de programa y pruebas iterativas – pruebas: prueba del código de programa utilizando datos de prueba
2 (a) Comprender que todo sistema informático está compuesto por sub-sistemas, que a su vez están compuestos por más sub-sistemas (b) Comprender cómo un problema puede descomponerse en sus partes componentes
5 (a) Comprender la necesidad de realizar comprobaciones de validación sobre los datos de entrada y los diferentes tipos de comprobación de validación
• Incluyendo: – comprobación de rango – comprobación de longitud – comprobación de tipo – comprobación de presencia – comprobación de formato – dígito de control
(b) Comprender la necesidad de realizar comprobaciones de verificación sobre los datos de entrada y los diferentes tipos de comprobación de verificación
• Incluyendo: – comprobación visual – comprobación de doble entrada
6 Sugerir y aplicar datos de prueba adecuados
• Limitado a: – normales – anómalos – extremos – de límite • Los datos extremos son el valor aceptable más grande/más pequeño • Los datos de límite son el valor aceptable más grande/más pequeño y el valor rechazado correspondiente más pequeño/más grande
7 Completar una tabla de seguimiento para documentar una ejecución en seco de un algoritmo
• Incluyendo, en cada paso de un algoritmo: – variables – salidas – indicaciones al usuario
8 Identificar errores en algoritmos dados y sugerir formas de corregir estos errores
9 Escribir y modificar algoritmos para problemas o escenarios dados, utilizando: pseudocódigo, código de programa y diagramas de flujo
• Se requiere precisión al escribir algoritmos, por ejemplo, x > y es aceptable pero x es mayor que y no lo es • Véase la sección 4 para los símbolos de los diagramas de flujo • Véase la sección 4 para el pseudocódigo
Fuente: Plan de estudios Cambridge International
7.1
El ciclo de vida del desarrollo de programas
El ciclo de vida del desarrollo de programas (程序开发生命周期) es el conjunto de etapas utilizadas para crear un programa. Existen cuatro etapas.
El software es escrito por programadores, quienes siguen el ciclo de vida del desarrollo
Etapa
Qué se hace
análisis 分析
estudiar el problema y determinar qué se necesita
diseño 设计
planificar cómo funcionará el programa
codificación 编码
escribir el código del programa y probarlo a medida que se avanza
pruebas 测试
ejecutar el programa terminado con datos de prueba para encontrar errores
Las cuatro etapas del desarrollo de programas; las pruebas retroalimentan para corregir y refinar el diseñoUn diagrama de flujo de un programa establece los pasos y decisiones durante la etapa de diseño
Análisis
En el análisis se comprende el problema. Dos habilidades clave ayudan:
abstracción 抽象 — conservar solo los detalles importantes e ignorar el resto;
descomposición 分解 — dividir un problema grande en partes más pequeñas y fáciles.
Diseño
En el diseño se planifica la solución, utilizando a menudo la descomposición. Se pueden mostrar las partes como sub-sistemas 子系统 en un diagrama de estructura 结构图 (un gráfico que divide un sistema en cajas más pequeñas).
Codificación y pruebas
En la codificación se escribe el código del programa. Se utiliza la prueba iterativa 迭代测试 — probar pequeñas partes repetidamente a medida que se construyen. En las pruebas se ejecuta todo el programa con datos de prueba 测试数据 para verificar que funcione.
program development life cycle/ˈprəʊɡræm dɪˈveləpmənt laɪf ˈsaɪkl/
程序开发生命周期
chéng xù kāi fā shēng mìng zhōu qī
analysis/əˈnæləsɪs/
分析
fēn xī
design/dɪˈzaɪn/
设计
shè jì
coding/ˈkəʊdɪŋ/
编码
biān mǎ
testing/ˈtestɪŋ/
测试
cè shì
abstraction/əbˈstrækʃn/
抽象
chōu xiàng
decomposition/ˌdiːkɒmpəˈzɪʃn/
分解
fēn jiě
sub-systems/sʌb ˈsɪstəmz/
子系统
zi xì tǒng
structure diagram/ˈstrʌktʃə ˈdaɪəɡræm/
结构图
jié gòu tú
iterative testing/ˈɪtərətɪv ˈtestɪŋ/
迭代测试
dié dài cè shì
test data/test ˈdeɪtə/
测试数据
cè shì shù jù
flowchart/ˈfləʊtʃɑːt/
流程图
liú chéng tú
7.2
Herramientas de diseño
Se puede planificar una solución de tres formas principales.
un diagrama de estructura — muestra las partes de un sistema y cómo se integran;
un diagrama de flujo 流程图 — un diagrama que usa cajas y flechas para mostrar los pasos en orden;
pseudocódigo 伪代码 — pasos escritos en inglés simple similar al código (no un lenguaje real).
Un diagrama de flujo para el algoritmo de suma, usando los símbolos estándar (inicio/fin, entrada/salida, proceso, decisión)
7.3
Algoritmos
Ordenamiento burbuja, paso a paso
Un algoritmo 算法 es un conjunto de pasos, en el orden correcto, que resuelve un problema. Todo algoritmo se puede dividir en tres partes:
entrada 输入 — los datos que entran;
procesamiento 处理 — el trabajo realizado sobre los datos;
salida 输出 — el resultado que sale.
Esto se llama descomposición en entradas, procesos y salidas. Por ejemplo, para "encontrar el promedio de tres notas": las entradas son las tres notas; el procesamiento es sumarlas y dividirlas entre 3; la salida es el promedio.
Cada algoritmo se descompone en entrada, procesamiento y salida — aquí, encontrando el promedio de tres notas
Cuando se ingresan datos, se verifican para reducir errores.
La validación 验证 verifica que los datos sean lógicos y sigan las reglas. No puede verificar que los datos sean verdaderos, solo que estén permitidos.
Verificación de validación
Qué verifica
verificación de rango 范围检查
el valor está entre un valor mínimo y máximo permitido
verificación de longitud 长度检查
el número de caracteres es permitido (ej. una contraseña ≥ 8)
verificación de tipo 类型检查
los datos son del tipo correcto (ej. un número, no letras)
verificación de presencia 存在性检查
algo ha sido realmente ingresado (no dejado en blanco)
verificación de formato 格式检查
los datos están en el patrón correcto (ej. una fecha como dd/mm/yyyy)
dígito de control 校验码
un dígito adicional confirma que un número fue ingresado correctamente
La verificación 核实 verifica que los datos fueron copiados o ingresados correctamente (sin errores mientras se tecleaban). Dos métodos:
verificación visual 目视检查 — una persona compara los datos tecleados con el original;
doble entrada 双重输入 — los datos se ingresan dos veces y se comparan las dos copias.
7.5
Tablas de trazado
Una tabla de trazado 追踪表 registra el valor de cada variable a medida que un algoritmo se ejecuta, paso a paso. Ayuda a:
Una tabla de trazado registra el valor de cada variable a medida que el programa se ejecuta
verificar que un algoritmo funciona correctamente;
averiguar qué hace un algoritmo siguiéndolo con datos dados.
Ejemplo: tracee este algoritmo con la entrada 5.
INPUT N
Total ← 0
FOR I ← 1 TO N
    Total ← Total + I
NEXT I
OUTPUT Total
i
total
OUTPUT
1
1
2
3
3
6
4
10
5
15
15
El trazado muestra que el algoritmo suma del 1 a n. Con la entrada 5, la salida es 15.
Ejemplo resuelto. Tracee este algoritmo y dé la salida.
X ← 20
Count ← 0
WHILE X > 1
    X ← DIV(X, 2)
    Count ← Count + 1
ENDWHILE
OUTPUT Count
DIV devuelve solo la parte de número entero de una división. Tome una fila por pasada: x se convierte en 10 (count 1), luego 5 (count 2), luego 2 (count 3), luego 1 (count 4). Ahora x > 1 es falso, así que el bucle se detiene y la salida es 4. Dos hábitos protegen estas calificaciones: probar la condición antes de cada pasada en lugar de después, y escribir una nueva fila para cada pasada — intentar retener los valores en su cabeza es lo que hace que los trazados fallen.
Explorar
Una tabla de seguimiento
Paso a paso por el bucle y complete la tabla de seguimiento, una fila por pasada.
Una búsqueda lineal 线性查找 revisa cada elemento de una lista, uno por uno, hasta que encuentra el valor deseado o llega al final.
Found ← FALSE
FOR I ← 0 TO 9
    IF List[I] = SearchValue
      THEN
        Found ← TRUE
    ENDIF
NEXT I
OUTPUT Found
La búsqueda lineal revisa cada elemento por turno desde el principio hasta que encuentra el valor
Ordenamiento burbuja
Un ordenamiento burbuja 冒泡排序 coloca una lista en orden. Compara cada par de elementos adyacentes y los intercambia si están en el orden incorrecto. Repite esto hasta que no se necesiten más intercambios.
FOR I ← 0 TO 8
    IF List[I] > List[I + 1]
      THEN
        Temp ← List[I]
        List[I] ← List[I + 1]
        List[I + 1] ← Temp
    ENDIF
NEXT I
El ordenamiento burbuja compara cada par adyacente y los intercambia si están fuera de orden, repitiendo hasta que esté ordenado
Sumatoria y conteo
sumatoria 求和 — seguir sumando valores a un total acumulado (Total ← Total + Value).
conteo 计数 — sumar 1 a un contador cada vez que ocurre algo (Count ← Count + 1).
Máximo, mínimo y promedio
para encontrar el máximo 最大值: guardar el valor más grande visto hasta ahora.
para encontrar el mínimo 最小值: guardar el valor más pequeño visto hasta ahora.
para encontrar el promedio 平均值: dividir el total por cuántos valores hay.
Total ← 0
FOR I ← 0 TO 9
    Total ← Total + List[I]
NEXT I
Average ← Total / 10
OUTPUT Average
Aprenda las cuatro etapas del ciclo de vida: análisis → diseño → codificación → pruebas. La abstracción conserva solo los detalles importantes; la descomposición divide un problema en partes más pequeñas.
La validación verifica que los datos sean lógicos (verificaciones de rango, longitud, tipo, presencia, formato); la verificación verifica que fueron copiados correctamente (una verificación visual o doble entrada).
Aprenda los cuatro tipos de datos de prueba: normal (aceptado), anormal (rechazado), extremo (el más grande/más pequeño aún permitido), límite/borde (los valores a ambos lados de un límite).
Para averiguar qué hace un algoritmo, complete una tabla de trazado — anote el valor de cada variable en cada paso.
Conozca los algoritmos estándar: búsqueda lineal (revisar cada elemento por turno) y ordenamiento burbuja (intercambiar pares adyacentes hasta que no se necesiten más intercambios).
3 Comprender y utilizar la entrada y salida de datos
4 (a) Comprender y utilizar el concepto de secuencia
(b) Comprender y utilizar el concepto de selección
• Incluye: – sentencias IF – sentencias CASE
(c) Comprender y utilizar el concepto de iteración
• Incluye: – bucles controlados por contador – bucles con precondición – bucles con postcondición
(d) Comprender y utilizar los conceptos de acumulación y conteo
(e) Comprender y utilizar el manejo de cadenas
• Incluye: – longitud – subcadena – mayúsculas – minúsculas • El primer carácter de la cadena puede estar en la posición cero o uno
(f) Comprender y utilizar operadores aritméticos, relacionales y lógicos
• Aritméticos, limitados a: – + – – – / – * – ^ (elevado a una potencia) – MOD – DIV • Relacionales, limitados a: – = – < – <= – > – >= – <> (distinto de) • Lógicos, limitados a: – AND – OR – NOT
5 Comprender y utilizar sentencias anidadas
• Incluye selección e iteración anidadas • No se requerirá que los candidatos escriban más de tres niveles de sentencias anidadas
6 (a) Comprender qué significan procedimientos, funciones y parámetros (b) Definir y utilizar procedimientos y funciones, con o sin parámetros (c) Comprender y utilizar variables locales y globales
• Los procedimientos y funciones pueden tener hasta tres parámetros
7 Comprender y utilizar rutinas de biblioteca
• Incluye: – MOD – DIV – ROUND – RANDOM
8 Comprender cómo crear un programa mantenible
• Incluye el uso adecuado de: – identificadores significativos – la función de comentarios proporcionada por el lenguaje de programación – procedimientos y funciones – comentarios relevantes y apropiados para la sintaxis • Utilizar identificadores significativos para: – variables – constantes – arreglos – procedimientos y funciones
Fuente: Plan de estudios Cambridge International
Una variable 变量 es un almacén con nombre que contiene un valor que puede cambiar mientras se ejecuta el programa. Una constante 常量 es un almacén con nombre cuyo valor está fijado y no cambia.
Una variable es un almacén con nombre cuyo valor puede cambiarLas variables y las constantes son almacenes con nombre para valores, definidos en el código del programa
Debes declararlas 声明 antes de usarlas (decir su nombre y tipo):
DECLARE Score : INTEGER
DECLARE Name : STRING
CONSTANT Pi ← 3.142
Mientras se ejecuta un programa, sus variables se almacenan en la memoria del ordenador (RAM)
Utiliza una constante para un valor que nunca cambia (como Pi), para que se defina en un solo lugar y sea fácil de leer.
Explorar
Variables y asignación
Paso a paso por las líneas y observe cómo cada variable toma su nuevo valor.
Todo programa se construye a partir de tres estructuras de control.
Las tres estructuras de control: la secuencia ejecuta los pasos en orden, la selección elige una rama y la iteración repite un cuerpo
Secuencia
La secuencia 顺序 significa que los pasos se ejecutan uno tras otro, en orden, de arriba hacia abajo.
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT Area
Selección
La selección 选择 decide qué pasos ejecutar, basándose en una condición. Usa una instrucción IF, o una instrucción CASE cuando hay muchas opciones.
IF Score >= 50
  THEN
    OUTPUT "Pass"
  ELSE
    OUTPUT "Fail"
ENDIF
CASE OF Grade
    'A' : OUTPUT "Excellent"
    'B' : OUTPUT "Good"
    OTHERWISE OUTPUT "Keep trying"
ENDCASE
Iteración
La iteración 迭代 (un bucle 循环) repite pasos. Hay tres tipos.
Un bucle controlado por contador 计数循环 repite un número fijo de veces:
FOR I ← 1 TO 5
    OUTPUT "Hello"
NEXT I
Un bucle de precondición 前测循环 verifica la condición antes de cada repetición, por lo que puede ejecutarse cero veces:
WHILE Answer <> "stop" DO
    INPUT Answer
ENDWHILE
Un bucle de poscondición 后测循环 verifica la condición después de cada repetición, por lo que siempre se ejecuta al menos una vez:
REPEAT
    INPUT Password
UNTIL Password = "secret"
Un bucle de precondición (WHILE) prueba antes del cuerpo, por lo que puede ejecutarse cero veces; un bucle de poscondición (REPEAT) prueba después, por lo que se ejecuta al menos una vez
Explorar
Cómo decide una escalera IF … ELSE IF
Las condiciones se prueban de arriba hacia abajo; la PRIMERA que es verdadera se ejecuta y las demás se omiten. Desliza la puntuación y observa qué rama se ilumina.
Explorar
Selección
Cambie el valor y observe qué rama se ejecuta — selección en acción.
Sumatoria 求和 — seguir sumando valores a un total acumulado: Total ← Total + Value.
Conteo 计数 — sumar 1 a un contador cada vez: Count ← Count + 1.
Un contador aumenta de 1 en 1; un total construye una suma acumuladaUna tabla de trazado sigue un bucle de sumatoria y conteo paso a paso
Total ← 0
FOR I ← 1 TO 10
    INPUT Mark
    Total ← Total + Mark
NEXT I
OUTPUT Total
Ejemplo resuelto. Un programa debe leer 5 notas, luego mostrar el total y el promedio.
Total ← 0
FOR I ← 1 TO 5
    INPUT Mark
    Total ← Total + Mark
NEXT I
Average ← Total / 5
OUTPUT Total, Average
Dos líneas manejan las notas. Total ← 0 debe estar antes del bucle: si se coloca dentro, el total se reinicia en cada pasada, por lo que el programa solo mostrará la última nota. Y Average ← Total / 5 debe estar después del bucle, porque el total no está completo hasta que se haya añadido cada nota. Inicializar antes, calcular después: ese orden es lo que realmente está probando la pregunta.
(El primer carácter puede contarse como posición 0 o posición 1, dependiendo del lenguaje).
Explorar
SUBSTRING: extraer parte de una cadena
El primer carácter está en la posición 1. SUBSTRING(Palabra, Inicio, Longitud) toma Longitud caracteres comenzando en Inicio — arrastra los dos mangos y lee la llamada que construye.
Un arreglo 2D es una tabla; cada valor se encuentra mediante dos índices, [fila, columna]
Se lee un arreglo 2D con un bucle dentro de otro bucle (iteración anidada).
Explorar
Arreglos
Seleccione una fila y una columna para leer una celda. Los arrays de Cambridge cuentan desde 1, y un elemento 2-D se escribe con UN par de corchetes — Grid[2, 3].
1 Comprender el propósito de almacenar datos en un archivo para su uso por parte de un programa
2 Abrir, cerrar y utilizar un archivo para la lectura y escritura
• Incluye: – lectura y escritura de elementos individuales de datos – lectura y escritura de una línea de texto
Fuente: Plan de estudios Cambridge International
Un programa puede almacenar datos en un archivo 文件 para que se conserven después de que el programa termine. Debes abrir el archivo, usarlo y luego cerrarlo.
OPENFILE "data.txt" FOR WRITE
WRITEFILE "data.txt", "Hello"
CLOSEFILE "data.txt"

OPENFILE "data.txt" FOR READ
READFILE "data.txt", Line
CLOSEFILE "data.txt"
Puedes leer y escribir elementos individuales de datos o una línea completa de texto. Siempre cierra un archivo cuando termines de usarlo.
Una variable puede cambiar mientras se ejecuta el programa; una constante es fija. Aprende los cinco tipos de datos: entero, real, char, string, Boolean.
Todo programa se construye a partir de tres estructuras: secuencia, selección (IF / CASE) e iteración (bucles).
Un bucle WHILE prueba antes del cuerpo, por lo que puede ejecutarse cero veces; un bucle REPEAT … UNTIL prueba después, por lo que siempre se ejecuta al menos una vez.
MOD da el resto y DIV la parte de número entero de una división: 17 MOD 5 es 2, 17 DIV 5 es 3.
Una función devuelve un valor; un procedimiento no. Una variable local solo funciona dentro de su bloque; una global funciona en cualquier lugar.
3 Entender el propósito de una clave primaria e identificar una clave primaria adecuada para una tabla de base de datos dada
4 Leer, comprender y completar scripts de lenguaje de consulta estructurado (SQL) para consultar datos almacenados en una única tabla de base de datos
• Limitado a: – SELECT – FROM – WHERE – ORDER BY DESCENDING – ORDER BY ASCENDING – SUM – COUNT – AND – OR • Identificación de la salida generada por una sentencia SQL que consultará los contenidos dados de una tabla de base de datos
Fuente: Plan de estudios Cambridge International
9.1
¿Qué es una base de datos?
Una base de datos 数据库 es un almacén organizado de datos, diseñado para que sea fácil buscar, ordenar y actualizar la información. En el IGCSE trabajas con una base de datos de una sola tabla 单表数据库 — toda la información se mantiene en una única tabla.
Un catálogo de tarjetas de biblioteca es una base de datos en papel — registros que puedes buscar y ordenar por índiceLas bases de datos modernas a gran escala se almacenan en servidores dentro de centros de datos
9.2
Registros y campos
Una tabla de base de datos está compuesta por registros y campos.
Un registro 记录 es una fila en la tabla — todos los datos sobre una misma entidad (por ejemplo, un estudiante).
Un campo 字段 es una columna en la tabla — un dato específico que posee cada registro (por ejemplo, "Nombre").
StudentID
FirstName
DateOfBirth
FormClass
FeesPaid
1
Amy
14/03/2009
10A
VERDADERO
2
Ben
02/11/2008
10B
FALSO
Aquí cada fila es un registro, y cada columna es un campo.
Cada fila es un registro y cada columna es un campo; la clave primaria (StudentID) es única para cada registro
9.3
Tipos de datos para los campos
Cada campo almacena un solo tipo de dato 数据类型. Debes elegir el tipo que mejor se adapte a los datos.
Tipos de campos: texto, número, fecha/hora y booleano
Una clave primaria 主键 es un campo que contiene un valor único 唯一的 para cada registro. Ningún par de registros puede tener la misma clave primaria, lo que permite identificar exactamente un registro.
En la tabla anterior, StudentID es una buena clave primaria porque cada estudiante tiene un número diferente. Un campo como FormClass sería una mala clave primaria, porque muchos estudiantes comparten el mismo curso.
9.5
Validación en una base de datos
Cuando se introducen datos en una base de datos, las comprobaciones de validación 验证 aseguran que sean coherentes — por ejemplo, una comprobación de rango en un campo de edad, o una comprobación de presencia para evitar dejar un campo vacío. (Viste estas comprobaciones en el tema 7.)
Una comprobación de rango acepta valores lógicos y rechaza el resto
El Lenguaje de consulta estructurado 结构化查询语言 (SQL) es un lenguaje utilizado para consultar 查询 una base de datos — para extraer los registros deseados. Debes comprender y completar scripts SQL.
SELECT, FROM y WHERE
SELECT indica qué campos mostrar.
FROM indica qué tabla utilizar.
WHERE establece una condición 条件, de modo que solo se muestran los registros coincidentes.
SELECT selecciona campos, FROM nombra la tabla, WHERE establece la condición
SELECT FirstName, FormClass
FROM Student
WHERE FeesPaid = TRUE;
Esto muestra el nombre y el curso de cada estudiante que ha pagado las cuotas.
Usa * para seleccionar todos los campos:
SELECT *
FROM Student
WHERE FormClass = '10A';
ORDER BY
ORDER BY ordena los resultados. Usa ASC para ascendente 升序 (menor primero, A→Z) o DESC para descendente 降序 (mayor primero, Z→A).
SELECT FirstName, DateOfBirth
FROM Student
ORDER BY DateOfBirth ASC;
AND y OR
Une condiciones con AND (ambas deben ser verdaderas) u OR (al menos una debe ser verdadera).
SELECT FirstName
FROM Student
WHERE FormClass = '10A' AND FeesPaid = FALSE;
SUM y COUNT
SUM suma los valores de un campo numérico.
COUNT cuenta cuántos registros coinciden.
SELECT COUNT(StudentID)
FROM Student
WHERE FeesPaid = FALSE;
Esto cuenta cuántos estudiantes no han pagado. SUM funciona de manera similar, pero suma un campo numérico en lugar de contar filas.
Calcular la salida
Para determinar la salida de un script SQL, léalo en este orden:
FROM — qué tabla;
WHERE — mantener solo los registros que cumplan la condición;
SELECT — mostrar solo los campos elegidos;
ORDER BY — poner los resultados en orden.
Lee una consulta SQL en este orden: FROM (qué tabla), WHERE (qué filas), SELECT (qué campos), ORDER BY (ordenar)
Siguiendo estos pasos, puedes escribir exactamente qué filas y columnas devuelve la consulta.
Ejemplo resuelto. Una tabla Book tiene los campos Title, Author, Price e InStock. Escribe una consulta que muestre el título y el precio de cada libro de Orwell que esté en stock, ordenado del más barato al más caro.
SELECT Title, Price
FROM Book
WHERE Author = 'Orwell' AND InStock = TRUE
ORDER BY Price ASC;
Constrúyela en el orden de lectura: FROM nombra la tabla; WHERE mantiene solo los registros coincidentes, y como hay dos condiciones requieren AND; SELECT muestra solo los dos campos solicitados; ORDER BY … ASC los ordena. Los valores de texto van entre comillas, y solo los campos que pide la pregunta deben estar en SELECT — añadir Author simplemente porque se filtró por él es la forma más común de perder puntos aquí.
Explorar
SELECT … WHERE
Paso a paso por una consulta: DONDE filtra filas, SELECCIONAR selecciona columnas.
1 Identificar y utilizar los símbolos estándar para puertas lógicas
• Consulte la sección 4 para los símbolos de las puertas lógicas
2 Definir y comprender las funciones de las puertas lógicas
• Incluyendo: – NOT (NO) – AND (Y) – OR (O) – NAND (NO Y) – NOR (NO O) – XOR (EOR, exclusiva OR) – la salida binaria producida a partir de todas las posibles entradas binarias • NOT es una puerta de entrada única • Todas las demás puertas están limitadas a dos entradas como máximo
3 (a) Utilizar puertas lógicas para crear circuitos lógicos dados a partir de: (i) un enunciado del problema (ii) una expresión lógica (iii) una tabla de verdad (b) Completar una tabla de verdad a partir de: (i) un enunciado del problema (ii) una expresión lógica (iii) un circuito lógico
• Los circuitos deben dibujarse según el enunciado proporcionado, sin simplificación • Los circuitos lógicos estarán limitados a un máximo de tres entradas y una salida • Ejemplo de tabla de verdad con tres entradas, para completar: A B C Salida | 0 0 0 | 0 0 1 | 0 1 0 | 0 1 1 | 1 0 0 | 1 0 1 | 1 1 0 | 1 1 1
(c) Escribir una expresión lógica a partir de: (i) un enunciado del problema (ii) un circuito lógico (iii) una tabla de verdad
Fuente: Plan de estudios Cambridge International
10.1
¿Qué es la lógica booleana?
La lógica booleana trabaja con valores que son verdaderos o falsos. En electrónica, estos se muestran como 1 (verdadero) y 0 (falso). Una puerta lógica toma una o más de estas entradas y da una salida, siguiendo una regla fija.
Una tabla de verdad lista cada posible conjunto de entradas y la salida correspondiente. Se construye escribiendo todas las combinaciones de entradas.
Las puertas lógicas están construidas a partir de circuitos electrónicos como este, donde cada puerta activa 1s y 0s
10.2
Las seis puertas lógicas
A logic circuit in action: the half adder
Debes conocer seis puertas. NOT tiene una entrada; todas las demás tienen dos entradas (A y B).
Las seis puertas lógicas. Un pequeño círculo en la salida significa que el resultado está invertido (NOT, NAND, NOR)Un chip lógico real: en su interior hay puertas lógicas como las de esta página
Puerta NOT
La puerta NOT invierte la entrada. La salida es 1 cuando la entrada es 0.
A
Salida
0
1
1
0
Puerta AND
La puerta AND da salida 1 solo cuando ambas entradas son 1.
AND genera 1 solo cuando ambas entradas son 1
A
B
Salida
0
0
0
0
1
0
1
0
0
1
1
1
Puerta OR
La puerta OR da salida 1 cuando al menos una entrada es 1.
OR emite 1 cuando cualquiera de sus entradas es 1
A
B
Salida
0
0
0
0
1
1
1
0
1
1
1
1
Puerta NAND
La puerta NAND es AND seguida de NOT. La salida es el opuesto de AND.
A
B
Salida
0
0
1
0
1
1
1
0
1
1
1
0
Puerta NOR
La puerta NOR es OR seguida de NOT. La salida es el opuesto de OR.
A
B
Salida
0
0
1
0
1
0
1
0
0
1
1
0
Puerta XOR
La puerta XOR (OR exclusivo) da salida 1 cuando las entradas son diferentes.
A
B
Salida
0
0
0
0
1
1
1
0
1
1
1
0
Explorar
Las puertas lógicas
Cambie las entradas y seleccione una puerta para ver su salida — AND, OR, NOT, NAND, NOR, XOR.
Una expresión lógica escribe un circuito utilizando letras y nombres de puertas. La forma habitual de escribir las puertas:
Puerta
En palabras
NOT A
NOT A
A AND B
A AND B
A OR B
A OR B
Por ejemplo, la expresión (A AND B) OR (NOT C) significa: haz A AND B, haz NOT C, luego haz OR de los dos resultados juntos.
The expression X = (A AND B) OR (NOT C) drawn as a logic circuit
Explorar
Tablas de verdad
Construya la tabla de verdad para AND, OR, XOR y NOT — la lógica detrás de cada expresión.
10.4
Circuitos lógicos
Un circuito lógico une puertas entre sí para realizar una tarea. La salida de una puerta puede convertirse en la entrada de otra. En IGCSE, un circuito tiene hasta tres entradas y una salida.
Construyendo el circuito para X = (A AND B) OR C — la salida de la puerta AND alimenta a la puerta OR
Debes ser capaz de moverte entre cuatro formas:
a problem statement 问题陈述 (a description in words),
a logic expression,
a logic circuit,
a truth table.
De un enunciado de problema a un circuito
Lee la afirmación y extrae las condiciones y las palabras lógicas (and, or, not). Por ejemplo:
Una alarma (X) suena cuando la puerta está abierta (A) Y el sistema está encendido (B).
Esto es X = A AND B, por lo que se dibuja una puerta AND con entradas A y B.
Completar una tabla de verdad a partir de un circuito o expresión
To fill in a truth table:
Escribe todas las combinaciones de entradas. Para tres entradas hay 8 filas (de 000 a 111).
Calcula la salida de cada puerta en orden, una columna a la vez.
The last column is the final output.
Tres entradas dan ocho filas: cada combinación contada en binario
A
B
C
A AND B
(A AND B) OR C
0
0
0
0
0
0
0
1
0
1
0
1
0
0
0
0
1
1
0
1
1
0
0
0
0
1
0
1
0
1
1
1
0
1
1
1
1
1
1
1
Agregar una columna intermedia de "trabajo" para cada puerta facilita completar la salida final. Dibuja siempre el circuito exactamente como dice la afirmación, sin simplificarlo.
Ejemplo resuelto. Completa la tabla de verdad para X = (A AND B) OR (NOT C) para la fila A = 1, B = 0, C = 0. Trabaja hacia afuera desde los paréntesis, una puerta a la vez. Primero A AND B = 1 AND 0 = 0, porque AND necesita que ambas entradas sean 1. Luego NOT C = NOT 0 = 1. Finalmente, realiza la operación OR con los dos resultados: 0 OR 1 = 1. Así que X = 1. Asigna a cada puerta intermedia su propia columna en lugar de intentar hacer toda la expresión en un solo paso: con tres entradas hay $2^3 = 8$ filas, y esas columnas intermedias son donde se otorgan los puntos por el método incluso si la respuesta final falla.
Aprende las seis puertas y sus tablas de verdad: NOT, AND, OR, NAND (NOT AND), NOR (NOT OR), XOR (salida 1 cuando las entradas son diferentes).
Construye una tabla de verdad con todas las filas de entrada (2 entradas → 4 filas, 3 entradas → 8), contando en binario, y añade una columna de trabajo para cada puerta.
Convierte una declaración de problema en una expresión lógica seleccionando las palabras AND / OR / NOT, luego dibújala exactamente como está escrita — no la simplifiques.
NAND y NOR dan la salida opuesta a AND y OR; un pequeño círculo en la salida de una puerta indica que el resultado está invertido.