| English | 释义 | 拼音 |
|---|---|---|
| file organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | 文件组织 | wén jiàn zǔ zhī |
| access method/ˈækses ˈmeθəd/ | 访问方式 | fǎng wèn fāng shì |
| serial file/ˈsɪərɪəl faɪl/ | 串行文件 | chuàn xíng wén jiàn |
| sequential file/siːˈkwenʃl faɪl/ | 顺序文件 | shùn xù wén jiàn |
| key field/kiː fiːld/ | 键字段 | jiàn zì duàn |
| direct access/daɪˈrekt ˈækses/ | 直接存取 | zhí jiē cún qǔ |
| sequential access/siːˈkwenʃl ˈækses/ | 顺序存取 | shùn xù cún qǔ |
| random file/ˈrændəm faɪl/ | 随机文件 | suí jī wén jiàn |
银行的夜间批处理为什么要跑一整夜
- 直到 1980 年代,银行的账户还住在磁带上。磁带只能从一头读到另一头,所以当天的交易要连夜排序,整个主文件从头到尾读一遍来应用它们。
- 下午在中途想查某位客户的余额,答案是:明天才有。决定银行能提供什么的,是文件的组织方式,而不是计算机的速度。
- 磁盘让另一种组织成为可能:根据记录的键算出它在哪里,然后跳过去。这就是取款机能在一秒内回答的原因。
- 这一课讲文件组织(file organisation)、两种访问方式(access method),以及怎样从程序主要做什么出发来选择。
三种组织方式
- 串行文件(serial file)按记录加入的顺序保存,不排序。追加很快;查找意味着从头读起。用于日志和审计轨迹。
- 顺序文件(sequential file)按键字段(key field)排序保存记录。查找更快,因为可以提前停止或二分查找;插入很慢,因为后面的记录必须移位。用于批量更新的主文件。
- 随机文件(random file,直接存取文件)把每条记录放在由它的记录键算出的位置上,通常用散列。按键查找非常快;按键顺序读取则不方便。用于大型查找表和客户账户。
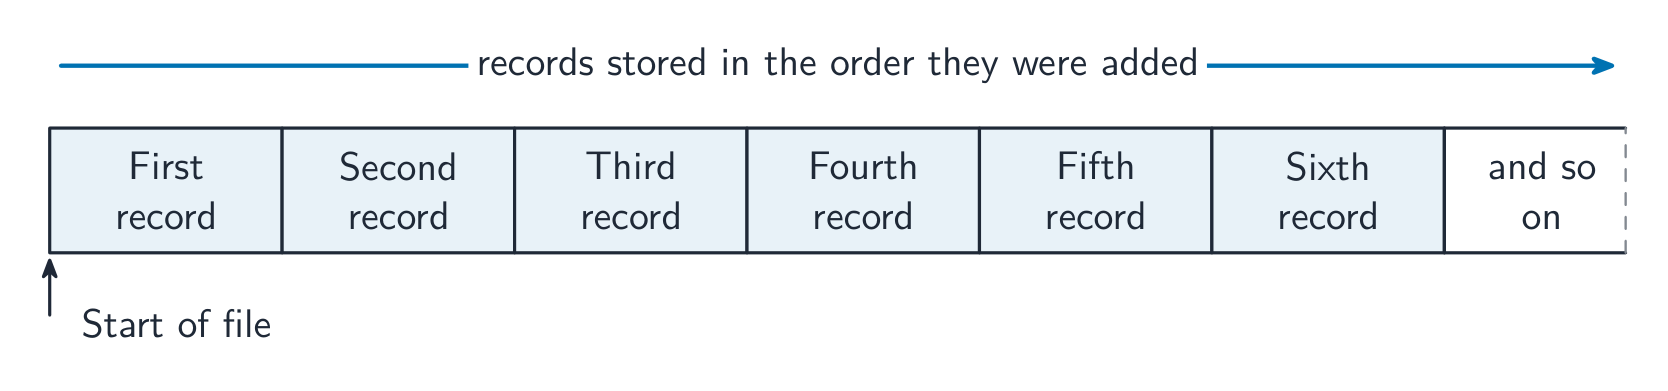
串行:到达的顺序,别无其他
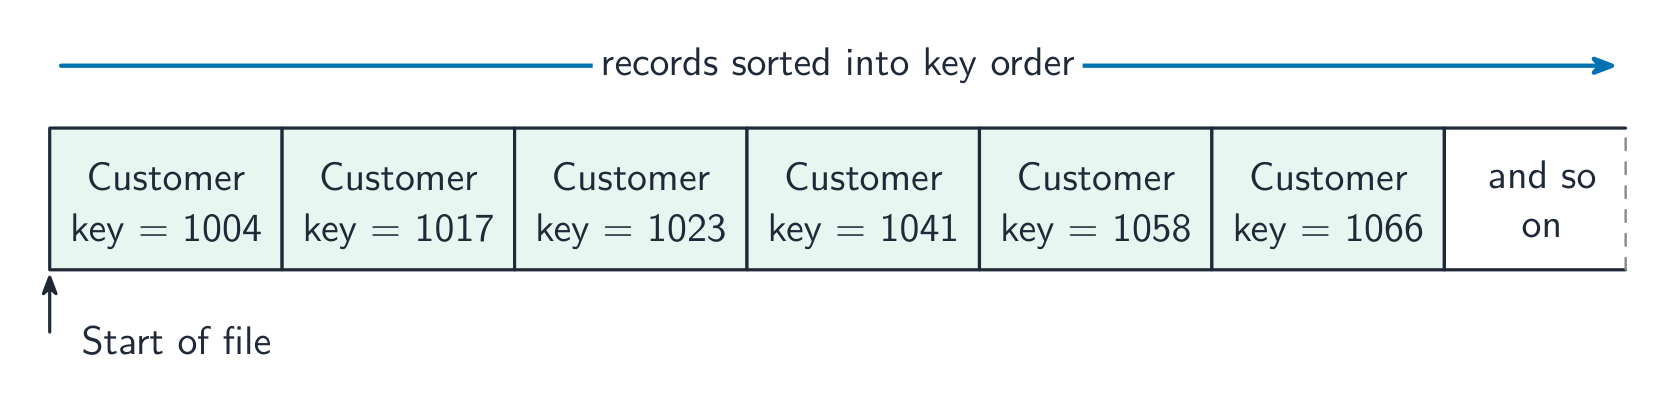
顺序:同样的记录,按键排列
两种访问方式
- 顺序存取(sequential access)从文件开头读到想要的记录。这是串行文件唯一允许的访问方式,也是顺序文件在批处理中被处理的方式。
- 直接存取(direct access)不读前面的内容,直接跳到已知位置。这是读随机文件的方式;当某个键的位置已知或已建索引时,顺序文件也可以被直接存取。
- 所以大纲的配对是:顺序存取用于串行和顺序文件;直接存取用于顺序和随机文件。
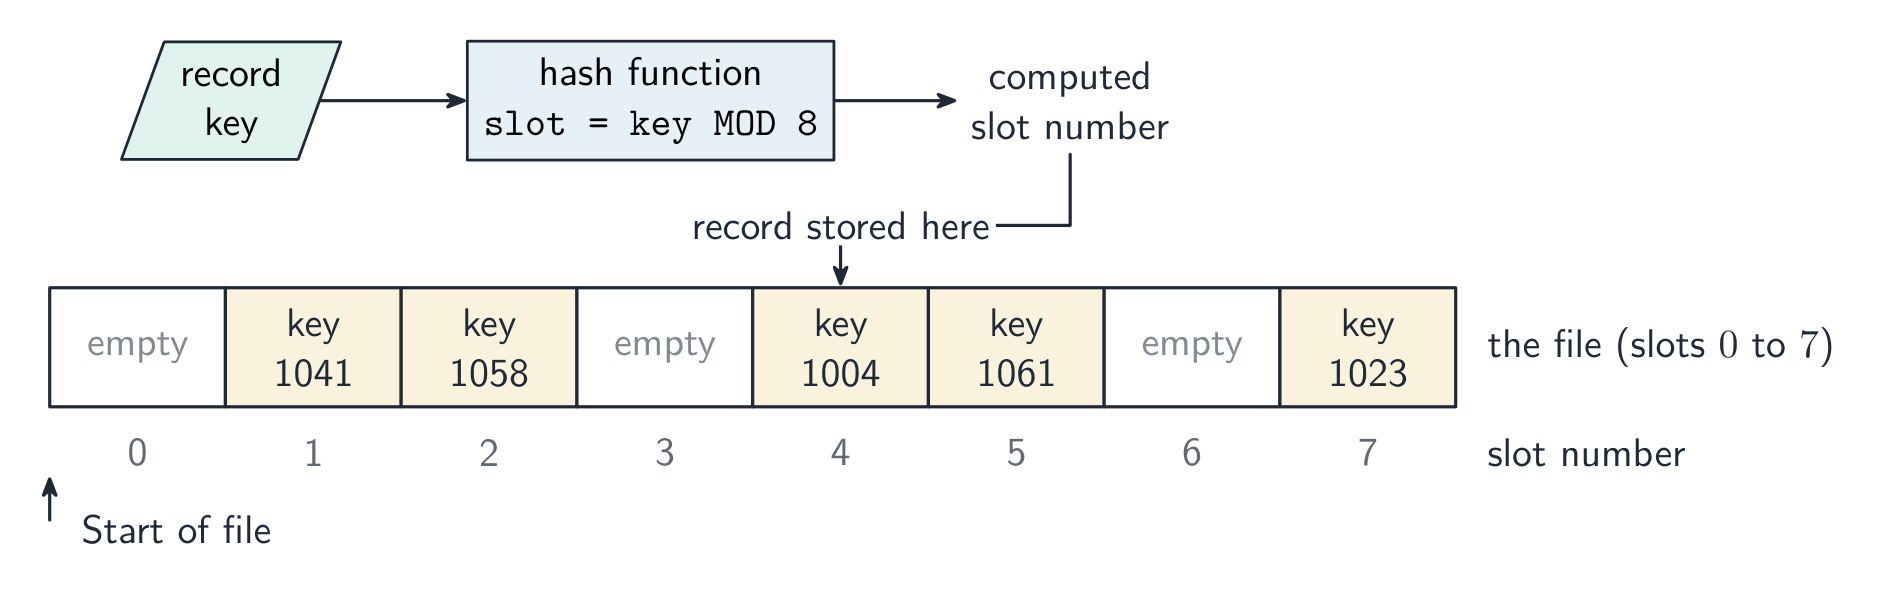
随机:键告诉你去哪里找
File access route
Follow a file from storage to program and back safely.
A serial file stores records:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Serial files keep records in arrival order — fast to append, slow to search. Sequential files are sorted by key.
Match each file organisation to how it stores records.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Serial = arrival order; sequential = sorted; random = hashed position; indexed-sequential = sorted + an index.
A random (direct-access) file places each record:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
A key is converted (often by a hash) to a position, so a single-key lookup is very fast.
What is the difference between a serial file and a sequential file?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Order of arrival versus sorted by key. That single difference is what makes a sequential file searchable early and slow to insert into.
例题:选择组织方式
- 一个工资程序每月按工号顺序把每条员工记录读一遍,生成工资单。用哪种组织和访问方式,为什么?
- 顺序组织加顺序存取:每条记录都要处理,所以到处跳没有任何好处;而按键顺序存储意味着工资单直接按顺序出来,不需要排序步骤。
- 取款机必须在一秒内按账号取出一个账户。 随机组织加直接存取:位置由账号算出,所以只需要恰好一次读取,而不是在几百万条中查找。
- 一台 Web 服务器每收到一个请求就往日志追加一行。 串行:只有追加要紧,而追加到末尾正是串行文件最快的事。
A sequential file can be read by sequential access and also by direct access.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Sequential access serves serial and sequential files; direct access serves sequential and random files. Only a serial file is limited to one method.
Put the steps of fetching one account from a random file in order.
难度 3/5 · 今日首次完成可获 200 金币及少量额外奖励
No searching happens at all: the key is turned into a position and read once. The final check catches a collision.
权衡对照
| 串行 | 顺序 | 随机 | |
|---|---|---|---|
| 记录的顺序 | 按加入顺序 | 按键排序 | 由键算出 |
| 添加记录 | 快,追加 | 慢,记录要移位 | 快,只要槽位空着 |
| 查找一条记录 | 慢,要全读 | 较快,可提前停止 | 最快,一次读取 |
| 按键顺序读取 | 需要排序 | 天然有序 | 需要排序 |
- 正确答案总是从主导操作论证:这个程序做得最多的是什么?
Sequential file organisation is well suited to processing every record in turn.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Direct access suits looking up a single record.
Match each situation to the file organisation that suits it.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Append only, process everything in order, or look one record up: the dominant operation picks the organisation.
例题:论证一次改动
- 一家图书馆的图书文件是串行的。查找一本书很慢。提出一项改动并论证。
- 重组为随机文件,把 ISBN 散列成地址,于是查找变成一次直接读取,而不是扫描整个文件。
- 如果图书馆还要按书名顺序打印目录,按书名的顺序组织能兼顾两者:目录不需要排序,查找也能提前停止或二分。
- 说出组织方式、说出访问方式,并把两者都与题目提到的某个操作绑定。
To produce reports in key order, the best file organisation is:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
A sequential file is already in key order, so reading it sequentially gives an in-order report.
A file organisation is chosen by looking at the program's ____ operation.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Every organisation is fast at something and slow at something else, so the operation done most often decides.
键必须是什么样的,以及散列为什么会出问题
- 直接访问需要一个键,而这个键必须对某一条记录是唯一的。姓不是键;客户编号才是。
- 散列用一次计算把那个键变成记录地址,所以不管文件多大,一次读取就能找到记录。
- 两个不同的键可能散列到同一个地址。这就是冲突,它不是算法的缺陷:一旦可能的键比地址多,冲突就不可避免。
- 评分标准里给出的解决办法是溢出区,或者在该地址存一个指针,指向共用该地址的记录链。所以一次冲突的代价是多一次读取,而不是丢失记录。
- 于是诚实的对比是:散列在文件装满之前给出接近常数的访问时间,而随着冲突累积性能会下降。顺序访问从不下降,但它本来就不快。
Two records hash to the same address. Which are true? Select 所有 that apply.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Nothing is lost; a collision costs one extra read. It is unavoidable in principle, because there are always more possible keys than addresses.
容易丢掉的分
- 串行是到达顺序;顺序是按键排序。它们不是同义词,而考试考的正是这个区别。
- 组织是记录怎样排布;访问是程序怎样到达其中一条。题目会点名其一。
- 顺序文件支持两种访问方式;串行文件只支持顺序存取。
- 从主导操作论证,不要说"它更快"。要说更快在哪里、为什么。
你掌握了
- 串行:按加入顺序、追加快、查找慢、用于日志 · 顺序:按键字段排序,适合批处理和按序输出 · 随机:位置由记录键算出,一次读取找到记录
- 顺序存取从开头读起;直接存取跳到某个位置
- 顺序存取服务于串行和顺序文件;直接存取服务于顺序和随机文件
- 从主导操作选择:处理全部、查一条,还是只追加