So sánh các thuật toán và ADTs trong thuật toán
Đã giới thiệu| English | Ý nghĩa |
|---|---|
| Big-O/bɪɡ əʊ/ | ký hiệu Big-O |
| time complexity/taɪm kəmˈpleksɪti/ | độ phức tạp thời gian |
| space complexity/speɪs kəmˈpleksɪti/ | độ phức tạp không gian |
| depth-first/depθ fɜːst/ | du sâu trước |
| breadth-first/bredθ fɜːst/ | du rộng trước |
| binary tree/ˈbaɪnəri triː/ | cây nhị phân |
Thuật toán sẽ tồn tại lâu hơn vũ trụ
- Một người bán hàng phải thăm 25 thành phố và trở về nhà theo lộ trình ngắn nhất. Thử mọi thứ tự đi và bạn sẽ thấy có khoảng $10^{23}$ cách sắp xếp. Một máy tính kiểm tra một tỷ cách mỗi giây sẽ mất ba triệu năm.
- Thêm một thành phố nữa và khối lượng công việc tăng gấp 25 lần. Đây không phải là vấn đề về máy tính cần nhanh hơn; đây là một phương pháp mà không bao giờ khả thi, dù ở tốc độ nào hay trên phần cứng nào.
- Việc biết trước điều này khi viết chương trình chính là mục đích của phân tích độ phức tạp. Đó là sự khác biệt giữa việc chọn đúng thuật toán và phát hiện ra, vài tháng sau, rằng thuật toán của bạn không thể mở rộng quy mô.
- Bài học này nói về độ phức tạp thời gian và không gian theo ký hiệu Big-O, cũng như cách các ADT định hình các thuật toán xây dựng trên chúng.
Độ phức tạp thời gian
- Độ phức tạp thời gian mô tả cách thời gian chạy tăng theo kích thước dữ liệu đầu vào $n$. Nó được viết bằng ký hiệu Big-O, chỉ giữ lại số hạng chủ đạo và loại bỏ hằng số.
- $O(1)$ hằng số, thời gian không phụ thuộc vào $n$. $O(\log n)$ logarit, như trong tìm kiếm nhị phân. $O(n)$ tuyến tính, như trong tìm kiếm tuyến tính. $O(n \log n)$, các thuật toán sắp xếp tốt. $O(n^2)$ bậc hai, như trong sắp xếp bong bóng và sắp xếp chèn.
- Lý do hằng số bị loại bỏ: chúng bị che khuất. Một thuật toán $O(n^2)$ có thể thắng thuật toán $O(n \log n)$ trong khoảng $n = 10$, nhưng đến $n = 10{,}000$ thì không hằng số nào cứu vãn được nó.
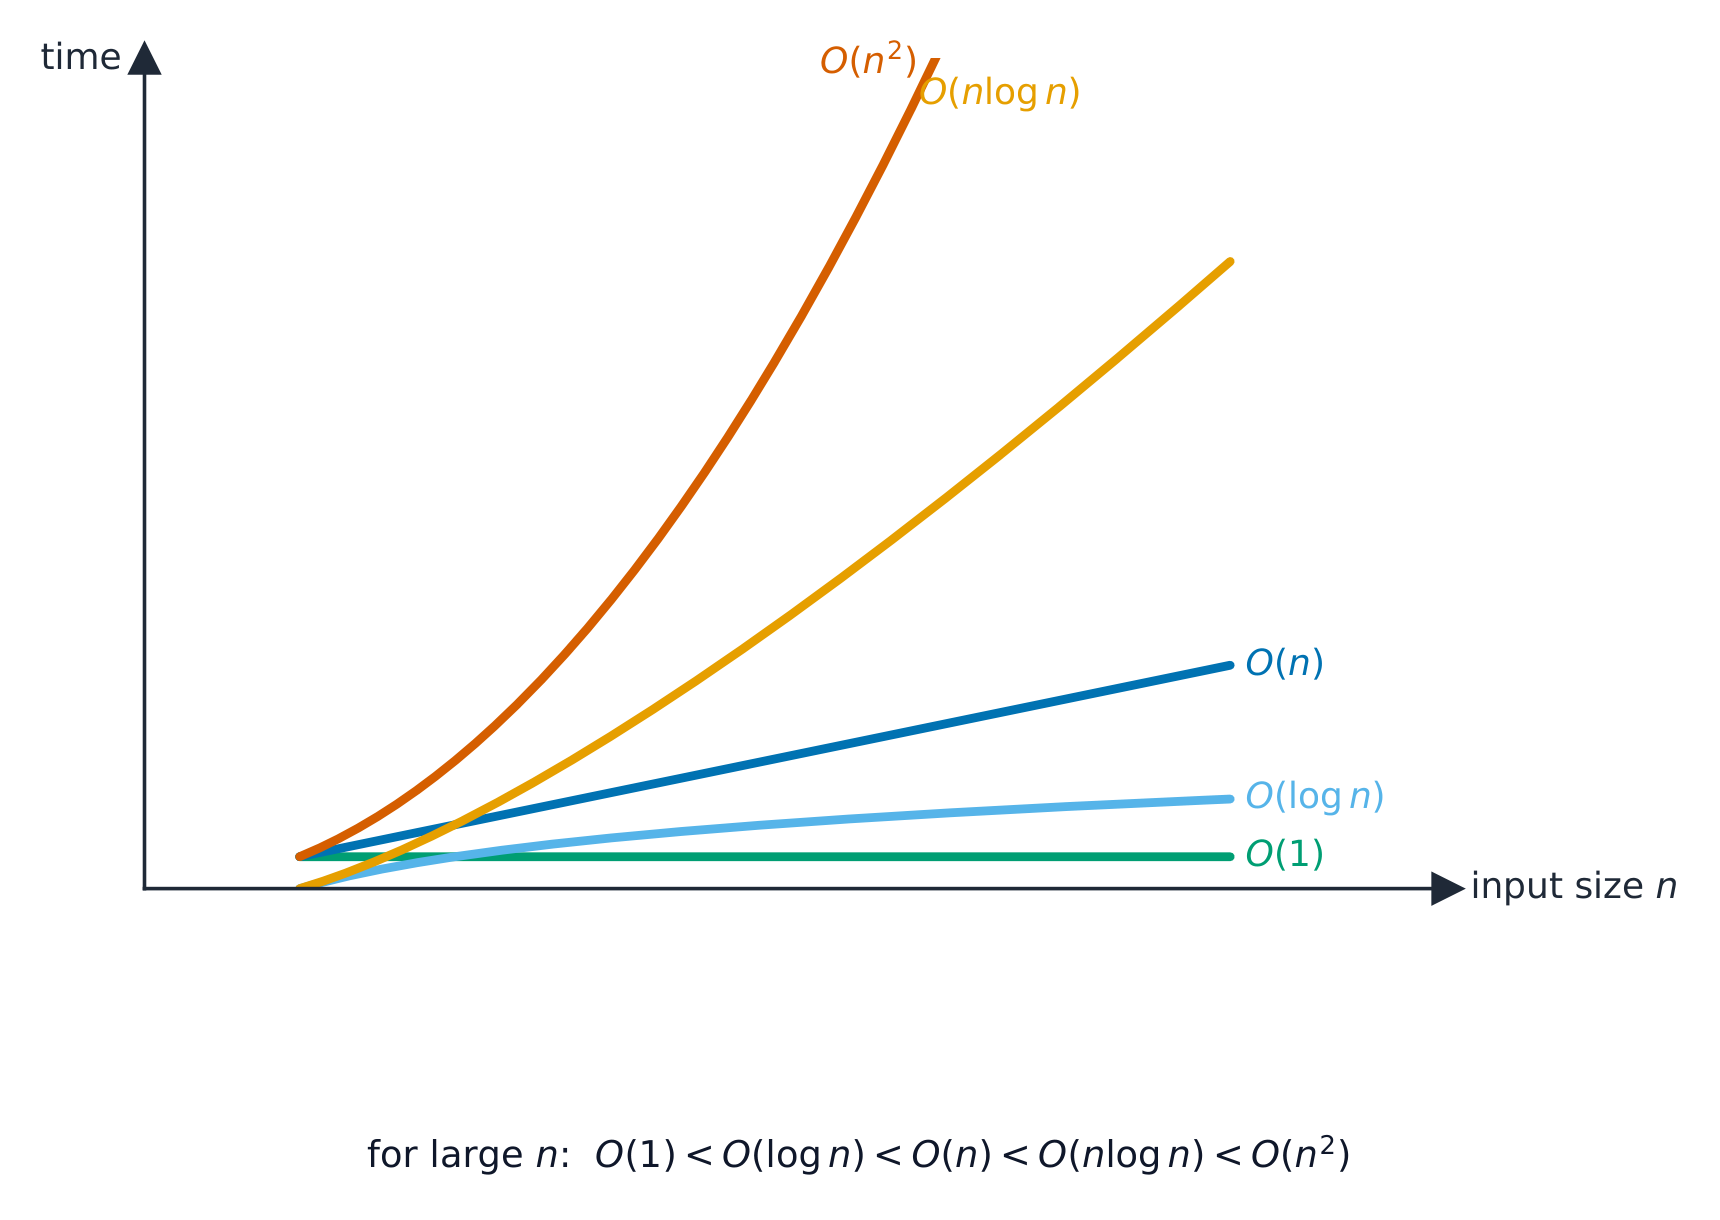
Các đường cong cắt nhau một lần, và sau đó thứ tự quyết định tất cả
Thời gian chạy tăng trưởng theo n như thế nào
Trượt n lên cao hơn và so sánh các đường cong: O(1) và O(log n) giữ gần như phẳng, O(n) tăng đều đặn, O(n²) bùng nổ. Đây là lý do tại sao Big-O — chứ không phải đồng hồ bấm giờ — là cách chúng ta so sánh các thuật toán trên đầu vào lớn.
Big-O nào mô tả binary search?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Giảm一半 phạm vi mỗi bước là logarit — O(log n).
Big-O nào mô tả bubble sort trong trường hợp xấu nhất?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Hai vòng lặp lồng nhau trên n phần tử tạo ra O(n²).
Khớp mỗi thuật toán với độ phức tạp thời gian của nó.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Linear search là O(n), binary search là O(log n), bubble sort là O(n²).
Ví dụ minh họa: dữ liệu đầu vào tăng gấp đôi làm gì
- Một thuật toán mất 4 giây trên 1,000 mục. Ước lượng thời gian thực hiện trên 2,000 mục nếu nó là $O(n)$, sau đó nếu nó là $O(n^2)$.
- $O(n)$: khi doubles $n$, thời gian cũng tăng gấp đôi, nên khoảng 8 giây.
- $O(n^2)$: nhân đôi $n$ bốn lần thời gian, nên khoảng 16 giây. Tại 10,000 mục, thời gian sẽ gấp 100 lần ban đầu, khoảng 400 giây.
- $O(\log n)$ chỉ thêm một bước, và $O(1)$ hoàn toàn không thay đổi. Hãy suy luận từ thứ tự, không phải từ công thức.
Một thuật toán O(n bình phương) mất 4 giây để xử lý 1,000 mục. Khoảng bao nhiêu giây sẽ cần thiết để xử lý 2,000?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Nhân đôi n làm quadruples thời gian của thuật toán O(n bình phương). Nhân đôi tương tự đối với thuật toán O(n) sẽ kéo dài từ 4 giây lên 8.
Độ phức tạp không gian
- Độ phức tạp không gian là lượng bộ nhớ bổ sung mà thuật toán cần, ngoài dữ liệu đầu vào bản thân nó.
- Sắp xếp bong bóng và sắp xếp chèn dùng $O(1)$ bộ nhớ bổ sung: chúng hoạt động nguyen tai loc, chỉ cần vài biến. Sắp xếp merge dùng $O(n)$, vì nó xây dựng mảng thứ hai.
- Đệ quy sử dụng bộ nhớ stack tỷ lệ thuận với độ sâu, vì mỗi cuộc gọi chưa hoàn thành đều giữ khung riêng của nó.
- Thường tồn tại sự đánh đổi giữa thời gian và bộ nhớ: lưu trữ kết quả để tránh tính toán lại, như kỹ thuật ghi nhớ (memoisation), mua tốc độ bằng không gian.
Những yếu tố khác quyết định sự lựa chọn
- Big-O nói về tốc độ tăng trưởng, không phải tốc độ tuyệt đối. Với một $n$ nhỏ, một thuật toán đơn giản $O(n^2)$ có thể vượt qua một thuật toán phức tạp $O(n \log n)$, và dễ viết đúng hơn.
- Tính bền vững quan trọng khi danh sách đã được sắp xếp theo một trường khác. Tính đơn giản quan trọng vì thuật toán đơn giản ít nơi ẩn giấu lỗi hơn.
- Câu trả lời trung thực cho "thuật toán nào" thường nêu cả thứ tự và điều kiện: thuật toán này, vì $n$ rất lớn và dữ liệu đến không được sắp xếp.
Thuật toán "in place":
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Các thuật toán in-place (như bubble và insertion sort) sắp xếp ngay trong mảng gốc, sử dụng không gian phụ hằng số.
Tại sao độ phức tạp không gian của bubble sort là O(1) dù nó sắp xếp một mảng gồm n phần tử?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Nó sắp xếp tại chỗ. Merge sort là O(n) vì nó xây dựng một mảng thứ hai, và chi phí đệ quy tỷ lệ với độ sâu của nó.
ADT bên trong thuật toán
- Các loại dữ liệu trừu tượng từ chủ đề 10 là động cơ mà thuật toán được xây dựng từ, và việc chọn một ADT sẽ định hình thuật toán.
- Một ngăn xếp mang lại tìm kiếm depth-first: đẩy các lân cận vào, lấy cái mới nhất, và cuộc tìm kiếm lao xuống một nhánh trước khi quay lại. Đệ quy sử dụng call stack cho chính xác mục đích này.
- Một hàng đợi mang lại tìm kiếm breadth-first: enqueue các lân cận, lấy cái cũ nhất, và cuộc tìm kiếm lan tỏa ra ngoài theo vòng tròn, đó là cách tìm đường đi ngắn nhất trong đồ thị không trọng số.
- Một cây nhị phân giữ giá trị theo thứ tự giúp việc tìm kiếm loại bỏ nửa số node còn lại ở mỗi bước, mang lại độ phức tạp $O(\log n)$ cho tìm kiếm nhị phân trên cấu trúc cũng có thể phát triển.
Câu nào sau đây về Big-O là đúng? Chọn tất cả các đáp án áp dụng.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Big-O nóiysis về giây; nó nói về sự tăng trưởng. Đó là lý do tại sao điểm giao cắt với một thuật toán đơn giản hơn tồn tại ở kích thước nhỏ.
Ví dụ minh họa: cùng một đồ thị, hai cuộc tìm kiếm
- Một mê cung được khám phá từ một lối vào. So sánh việc dùng ngăn xếp với dùng hàng đợi.
- Với ngăn xếp, đường đi vừa tìm thấy gần nhất được khám phá tiếp theo, nên cuộc tìm kiếm lao sâu xuống một tuyến đường cho đến khi gặp ngõ cụt, sau đó quay lại. Nó sử dụng bộ nhớ tỷ lệ với độ sâu của đường đi.
- Với hàng đợi, đường đi được tìm thấy lâu nhất được khám phá tiếp theo, nên cuộc tìm kiếm xem xét tất cả những gì cách một bước, sau đó tất cả những gì cách hai bước. Nó tìm thấy lối đi ngắn nhất trước tiên, nhưng giữ mọi vị trí ở khoảng cách hiện tại trong bộ nhớ.
- Hãy nêu tên ADT, tên thứ tự khám phá thu được, và hệ quả của nó.
A stack (LIFO) tự nhiên dẫn đến duyệt depth-first, trong khi queue (FIFO) dẫn đến duyệt breadth-first.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
ADT bạn chọn quyết định thứ tự tìm kiếm — stack đi sâu trước, queue khám phá từng mức.
Khớp mỗi ADT với việc tìm kiếm nó tạo ra và hệ quả của nó.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Mới nhất hay cũ nhất. Lựa chọn đơn lẻ này quyết định việc tìm kiếm sẽ đi sâu hay rộng.
Điểm số dễ mất
- Big-O mô tả tăng trưởng theo kích thước dữ liệu, không phải giây. "Nó rất nhanh" không phải là câu trả lời về độ phức tạp.
- Khi doubles dữ liệu đầu vào, thời gian tăng gấp đôi với một thuật toán $O(n)$ và tăng gấp bốn lần với một thuật toán $O(n^2)$. Hãy suy luận từ thứ tự.
- Độ phức tạp không gian là bộ nhớ bổ sung, do đó sắp xếp tại chỗ là $O(1)$ ngay cả khi mảng có kích thước $n$.
- Ngăn xếp cho duyệt theo chiều sâu, hàng đợi cho duyệt theo chiều rộng. Việc nhớ đúng cặp này là mấu chốt của nhiều câu hỏi.
Bạn đã nắm vững
- độ phức tạp thời gian trong Big-O mô tả sự tăng trưởng với $n$: $O(1)$, $O(\log n)$, $O(n)$, $O(n \log n)$, $O(n^2)$; các hằng số bị bỏ đi vì ở quy mô lớn thì thứ tự quyết định
- gấp đôi $n$ làm gấp đôi $O(n)$ và gấp bốn $O(n^2)$; điểm giao cắt với thuật toán "kém" hơn chỉ tồn tại đối với $n$ nhỏ
- độ phức tạp không gian là bộ nhớ bổ sung: sắp xếp tại chỗ là $O(1)$, merge sort là $O(n)$, và đệ quy tốn chi phí độ sâu ngăn xếp
- một ngăn xếp cho duyệt theo chiều sâu, một hàng đợi cho duyệt theo chiều rộng, và một cây nhị phân giảm nửa số nút còn lại ở mỗi bước