Khóa học này là gì và cách sử dụng nó
Đây là khóa học thứ mười hai trong Y khoa Đại học: dịch tễ học, thống kê sinh học và y học dựa trên bằng chứng (EBM) — bộ công cụ biến các câu hỏi lâm sàng thành số liệu và số liệu thành quyết định. Nó phù hợp với tài liệu thống kê UNI-BUS-05 đã xem xét nơi toán học có sự giao thoa.
Phạm vi giới hạn, nêu rõ một lần: đây là khóa nghiên cứu, không phải bằng y khoa; mọi dữ liệu dưới đây là tổng hợp hoặc được cấp phép mở, mỗi abstract được đánh giá là giả định, và không có gì ở đây cấp phép hay hướng dẫn điều trị.
- Các đơn vị 12.1–12.3 đo lường và so sánh: tần suất bệnh, thiết kế nghiên cứu, thiên kiến và nguyên nhân.
- Các đơn vị 12.4–12.6 định lượng: xét nghiệm chẩn đoán, suy luận, thử nghiệm và tổng quan.
- Đơn vị 12.7 áp dụng: đánh giá, độ chắc chắn, và bệnh nhân trước mặt bạn.
Thói quen EBM: hỏi theo PICO, đo lường theo rủi ro và tỷ lệ, quyết định bằng khoảng tin cậy chứ không phải nghi thức** — mọi phép tính dưới đây đều là tổng hợp, kiểm tra bằng máy, và là thứ bạn cần tính toán lại.
Đo lường bệnh tật: tỷ lệ mắc mới và tỷ lệ hiện có
Tại sao nó quan trọng. Trước bất kỳ so sánh nào, bệnh tật phải được đếm — và hai loại đếm kinh điển trả lời cho những câu hỏi khác nhau: tốc độ xuất hiện ca bệnh mới và số lượng ca bệnh tồn tại đồng thời.
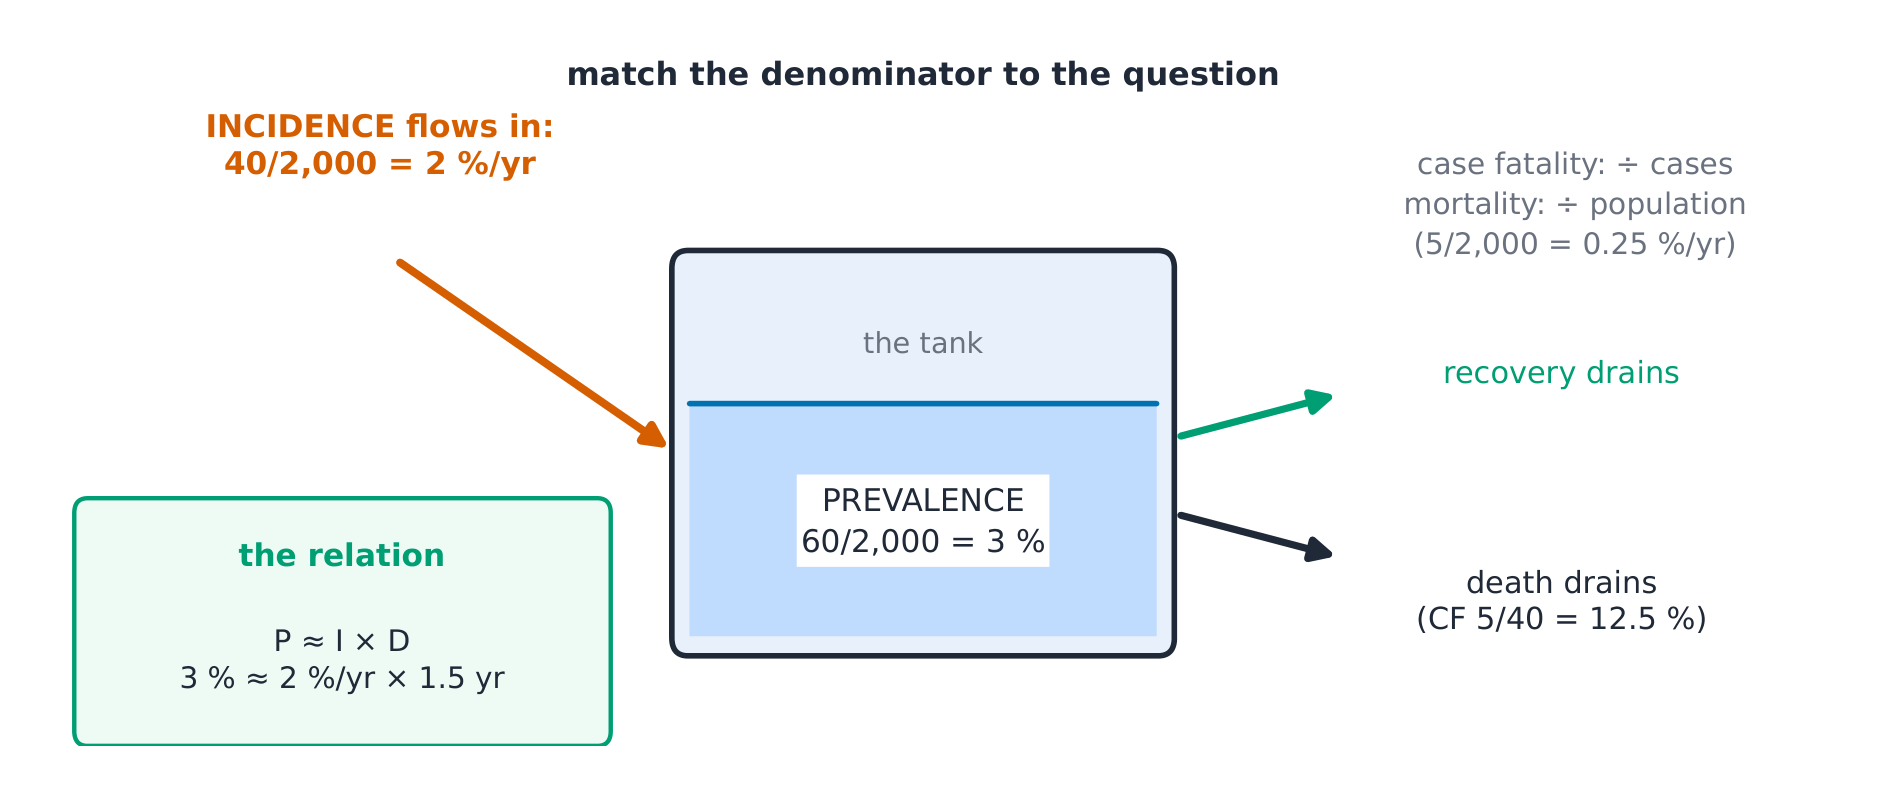
Khái niệm, kèm hình ảnh. Tỷ lệ mắc mới = số ca mới ÷ người đang ở nguy cơ ÷ thời gian; tỷ lệ hiện có = số ca đang có ÷ dân số tại một thời điểm ✓. Chúng liên kết: tỷ lệ hiện có ≈ tỷ lệ mắc mới × thời gian bệnh — các bệnh kéo dài sẽ tích lũy, trong khi bệnh ngắn ngủi biến mất giữa các lần khảo sát.
Sự dẫn xuất (tại sao chuẩn hóa tồn tại). Tỷ lệ thô trộn lẫn hai yếu tố: nguy cơ bệnh và cấu trúc tuổi của dân số. Một khu vực có nhiều người cao tuổi hơn có thể hiển thị tỷ lệ thô cao hơn với TỶ LỆ THEO ĐỘ TUỔI THẤP HƠN ✓. Chuẩn hóa trực tiếp áp dụng từng tỷ lệ theo độ tuổi của mỗi nhóm vào một dân số tiêu chuẩn và cộng lại — tổng giả lập này có thể so sánh vì cấu trúc tuổi giờ đây hoàn toàn giống nhau.
Ví dụ minh họa 1 — một thị trấn tổng hợp. 2,000 dân số, trong một năm, có 40 ca bệnh mới cases of a disease → incidence 40/2,000 = 2 % per year ✓. On survey day 60 người đang mắc bệnh → tỷ lệ hiện mắc điểm 60/2,000 = 3 % ✓. Kiểm tra mối liên hệ: 3 % ≈ 2 %/năm × 1.5 năm thời gian trung bình — các con số là nhất quán với nhau.
Worked example 2 — clinical link: mortality's three faces. (Fictional dataset) of the 40 new cases, 5 died within the year: case fatality 5/40 = 12.5 % ✓; the yearly deaths from this cause in the whole town were 5/2,000 = 0.25 % (cause-specific mortality rate); and if the town recorded 20 deaths from all causes that year, this disease caused 5/20 = 25 % of them (proportional tỷ lệ tử vong). Cùng một số ca tử vong, ba mẫu số khác nhau, ba câu hỏi khác nhau.
Lỗi thường gặp. Gọi tỷ lệ hiện mắc là tỷ lệ (nó là tỷ lệ phần trăm — không có đơn vị thời gian). So sánh tỷ lệ thô giữa các quần thể có cấu trúc tuổi khác nhau (hồi quy trước). Đọc tỷ lệ chết do bệnh như tử vong (mẫu số là ca bệnh, không phải người). đơn vị thời gian). So sánh tỷ suất thô giữa các quần thể có cấu trúc độ tuổi khác nhau (chuẩn hóa trước). Đọc sai tỷ lệ tử vong của bệnh nhân thành tỷ lệ tử vong (thực tế, mẫu số là số ca bệnh, không phải số người).
Tóm tắt. Tỷ lệ mắc mới = ca mới/người có nguy cơ/thời gian; tỷ lệ hiện mắc = ca đang mắc/dân số; P ≈ I × D; hồi quy điều chỉnh cấu trúc tuổi; tỷ lệ chết do bệnh (ca bệnh), tử vong theo nguyên nhân cụ thể (dân số), tử vong tương đối (tất cả ca tử vong) — hãy khớp mẫu số với câu hỏi.
Thiết kế nghiên cứu
Tầm quan trọng. Mọi câu hỏi lâm sàng đều có những thiết kế phù hợp để trả lời, và những thiết kế không thể — việc chọn thiết kế chính là việc bạn sẽ phải đối mặt với loại thiên lệch nào. và những thiết kế không thể — việc chọn thiết kế chính là việc bạn sẽ phải đối mặt với loại thiên lệch nào. sẽ phải đối mặt với.
Ý tưởng, kèm hình ảnh. Thang bậc: thử nghiệm ngẫu nhiên (thí nghiệm) → hệ cohort (theo dõi cả nhóm tiếp xúc và không tiếp xúc về phía trước) → trường-học (nhìn ngược lại từ kết quả) → cắt ngang (một khung hình duy nhất) → sinh thái (tính theo nhóm, không cá nhân) ✓. từ kết quả) → cắt ngang (một khung hình duy nhất) → sinh thái (tính theo nhóm, không cá nhân) ✓.
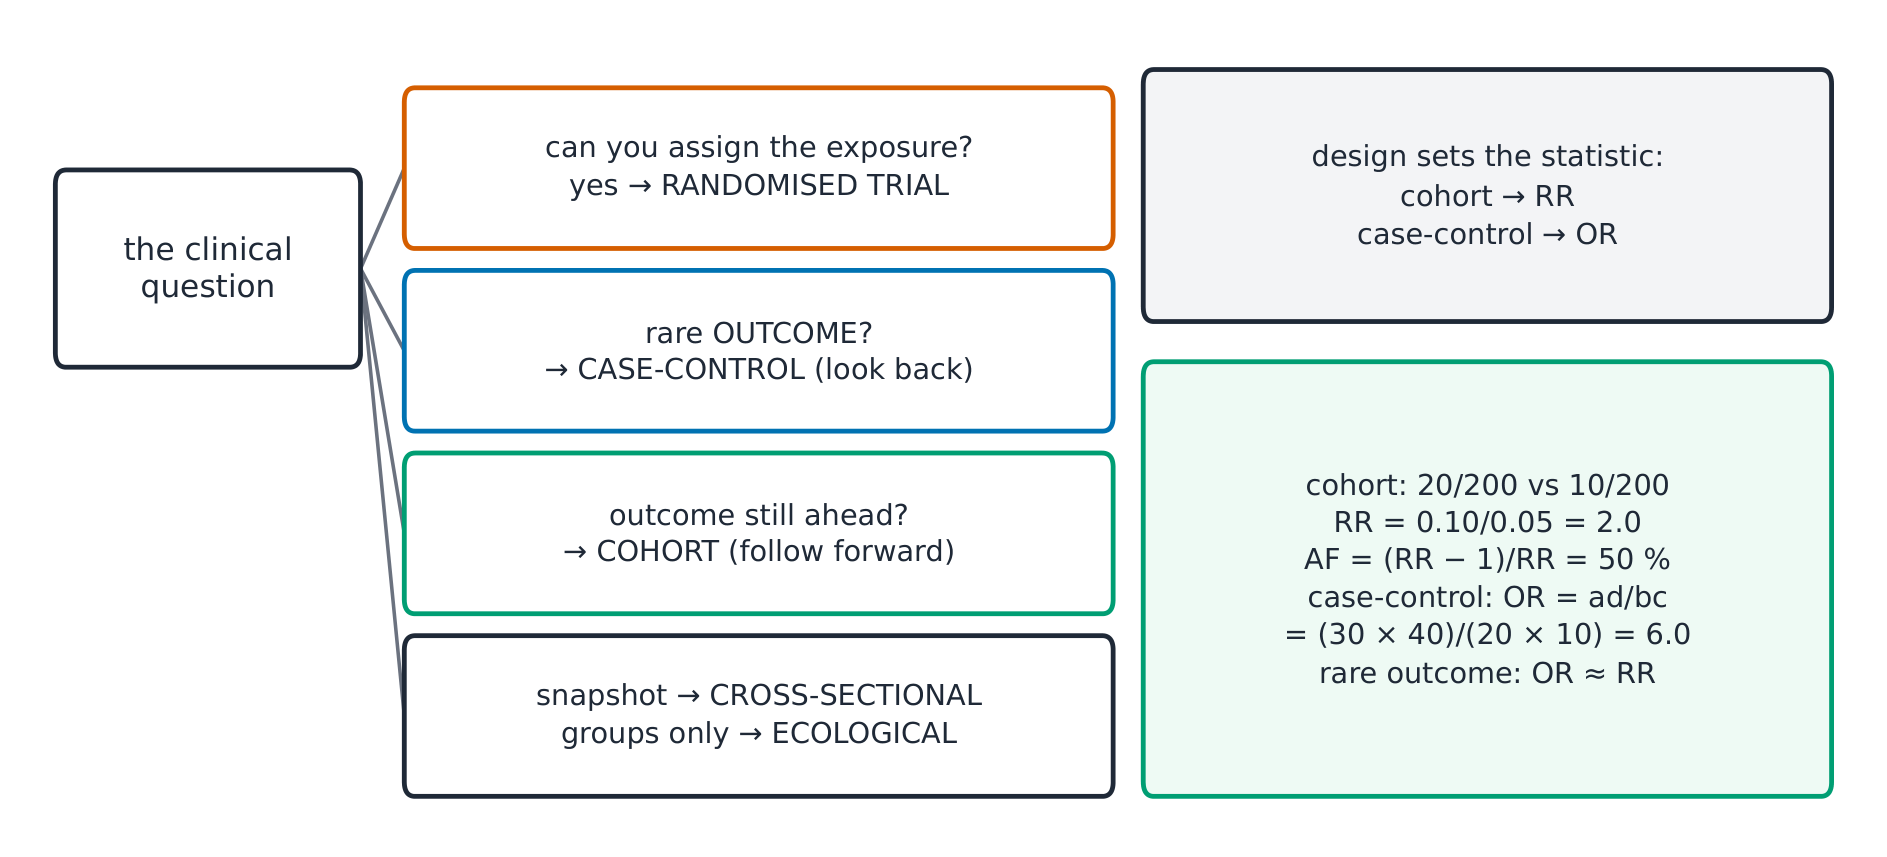
Sự suy diễn (tại sao RR thuộc về hệ cohort và OR thuộc về học trường-học). Một cohort samples by EXPOSURE, so risks in each arm are estimable: relative risk $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. A case-control samples by OUTCOME, so the "risk" in each arm is an artefact of the sampling ratio — only the odds ratio $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ is valid ✓. The design dictates the statistic, not preference.
Worked example 1 — one synthetic cohort. Exposed 200, 20 events; unexposed 200, 10 events: risks 0.10 vs 0.05 → $RR = 2.0$ ✓, attributable fraction among exposed $(RR-1)/RR = 50\ \%$ ✓ — the exposed group's events theo các giả định.
Ví dụ minh họa 2 — liên kết lâm sàng: bản sao phản chiếu của học trường-học. (Giả tưởng) 30 của 40 trường hợp tiếp xúc; 20 của 60 đối chứng tiếp xúc: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. Một kết quả hiếm khiến OR xấp xỉ RR — một con số, hai thiết kế, và việc lấy mẫu quyết định cái nào là hợp lệ.
Lỗi thường gặp. Tính RR từ nghiên cứu trường hợp - đối chứng (mẫu số do nhà nghiên cứu chọn, không phải tìm thấy). Đọc tỷ lệ odds ngang dòng như nguyên nhân (tiếp xúc và kết quả xảy ra đồng thời). Đồng nhất hóa "hướng tới tương lai" với "tốt hơn" (nghiên cứu hướng tới tương lai vẫn còn yếu tố gây nhiễu; chỉ có phân ngẫu nhiên mới cân bằng các yếu tố chưa biết). Tóm tắt. Thử nghiệm → nghiên cứu theo dõi (RR) → nghiên cứu trường hợp - đối chứng (OR) → ngang dòng →
một biến thứ ba (biến gây nhiễu), và mối liên hệ không có nguyên nhân. Xác định đúng cơ chế thất bại là một nửa của việc đánh giá phản biện. ecological; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; cohort samples by exposure, case-control by outcome; rare-disease OR ≈ RR; attributable fraction $(RR-1)/RR$.
Bias, confounding and causation
Yếu tố gây nhiễu nằm trên đường đi sau — phân tầng sẽ làm mất mối liên hệ giả tạo a third variable (confounding), and by association without cause. Naming the failure mode is half of critical appraisal.
The idea, with a picture. Bias is systematic error in design or đo lường: sai lệch chọn mẫu (ai được đưa vào), sai lệch thông tin/hồi tưởng (điều gì được nhớ lại hoặc ghi chép). Yếu tố gây nhiễu là một biến số thứ ba liên quan đến cả yếu tố phơi nhiễm và kết quả, giả vờ là nguyên nhân ✓.
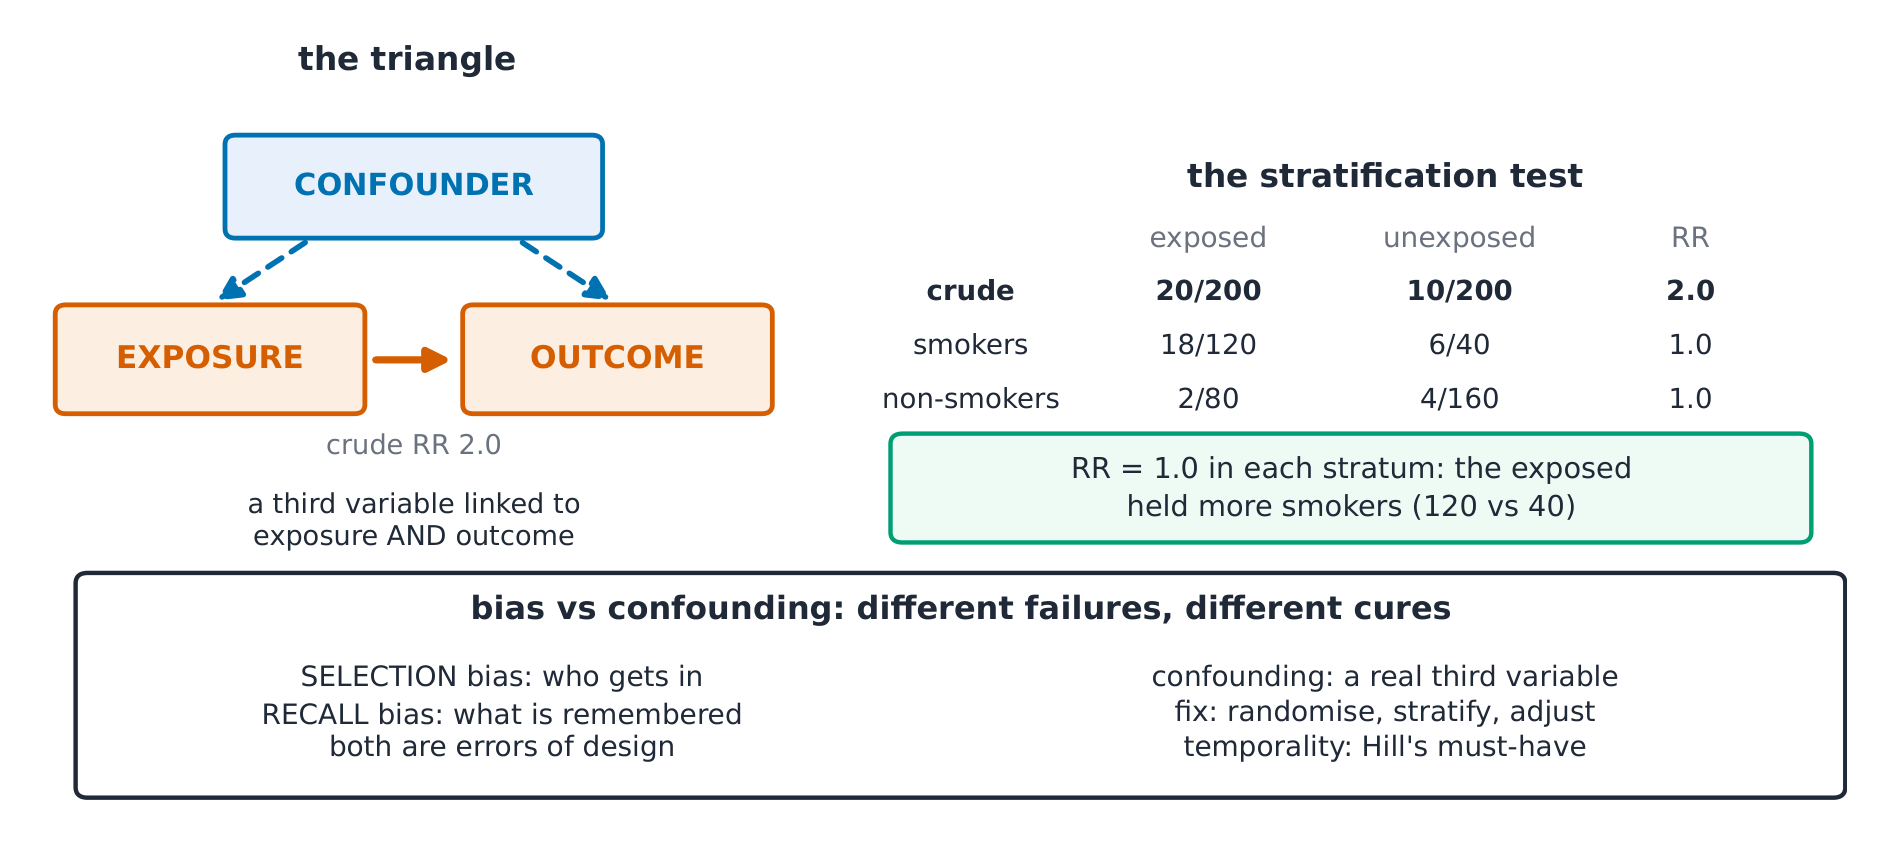
Sự suy diễn (tại sao phân tầng là bằng chứng). Nếu một biến thứ ba là nguyên nhân thực sự, mối liên hệ sẽ biến mất trong các tầng mà nó không đổi: $RR$ 2.0 thô, nhưng trong nhóm không hút thuốc $RR$ 1.0 và trong nhóm hút thuốc $RR$ 1.0 → hút thuốc là yếu tố gây nhiễu ✓. Nếu mối liên hệ vẫn tồn tại trong các tầng (ví dụ 2.0 và 1.9), tiếp xúc vẫn giữ tín hiệu riêng của nó. Randomisation ngăn ngừa gây nhiễu về mặt triển vọng bằng cách cân bằng cả những yếu tố chưa biết ✓.
Ví dụ minh họa 1 — bảng phân tầng. (Giả định) thô: có tiếp xúc 20/200 sự kiện so với không tiếp xúc 10/200 → RR 2.0. Phân tầng theo hút thuốc: không hút thuốc 6/100 so với 3/100 (RR 2.0 ✓ bên trong), hút thuốc 14/100 so với 7/100 (RR 2.0) — mối liên hệ vẫn còn sau phân tầng: hút thuốc KHÔNG phải là yếu tố gây nhiễu ở đây; tín hiệu của tiếp xúc vẫn rõ ràng. Bây giờ hãy đưa cùng một bảng thô bảng phân chia khác — nhóm phơi nhiễm: 120 người hút thuốc (18 sự kiện) và 80 người không hút thuốc (2 sự kiện); không tiếp xúc: 40 người hút thuốc (6 sự kiện) và 160 người không hút thuốc (4 sự kiện). Nguy cơ ở người hút thuốc là 15 % ở cả hai nhóm và người không hút thuốc là 2.5 % ở cả hai, nên RR là 1.0 bên trong mỗi tầng: nhóm có tiếp xúc chỉ đơn giản là có nhiều người hút thuốc hơn, và hút thuốc ĐÃ là yếu tố gây nhiễu ✓. Một bảng thô, hai kết luận — chỉ có các tầng mới phân biệt được chúng.
Ví dụ minh họa 2 — liên kết lâm sàng: các câu hỏi đánh giá. (Giả thuyết tóm tắt) "người uống cà phê có nguy cơ gấp đôi": hãy hỏi ai đã được nghiên cứu (lựa chọn), tiếp xúc được đo lường như thế nào (nhớ lại — bệnh nhân mắc bệnh) nhớ lại khác nhau), và một biến gây nhiễu cần có dạng như thế nào (liên quan đến cà phê VÀ với kết quả, ví dụ như hút thuốc). Quan điểm của Bradford Hill — thứ tự thời gian trước, sau đó là độ mạnh, tính nhất quán, mối quan hệ liều-đáp ứng, tính hợp lý — chuyển tiêu đề thành danh sách kiểm tra ✓.
Lỗi thường gặp. Coi nhầm biến gây nhiễu và thiên lệch đo lường là một vấn đề (biến gây nhiễu là sự pha trộn các hiệu ứng qua một biến thứ ba, được giải quyết bằng cách phân ngẫu nhiên, phân lớp hoặc điều chỉnh; thiên lệch chọn mẫu và thông tin là sai sót về đối tượng nghiên cứu và cách thức đo lường, mà không phân tích nào khắc phục hoàn toàn). Kỳ vọng rằng dữ liệu lớn sẽ giải quyết vấn đề biến gây nhiễu (thêm độ chính xác xung quanh một ước lượng bị thiên lệch). Yêu cầu mọi quan điểm của Hill (chúng là quan điểm, không phải bảng điểm; thứ tự thời gian là yếu tố bắt buộc duy nhất).
Tóm tắt. Thiên lệch = sai số hệ thống (chọn mẫu, thông tin/hồi tưởng); biến gây nhiễu = biến thứ ba nằm trên cả hai đường đi; phép thử phân lớp thu hẹp mối liên kết nếu có biến gây nhiễu; phân ngẫu nhiên cân bằng các yếu tố chưa biết; các quan điểm của Hill với thứ tự thời gian đặt lên đầu. góc nhìn với tính thời điểm trước tiên.
Các xét nghiệm chẩn đoán
độ nhạy và độ đặc hiệu thuộc về xét nghiệm, nhưng giá trị dự báo thuộc về độ nhạy và độ đặc hiệu thuộc về xét nghiệm, nhưng giá trị dự báo thuộc về quần thể đang sử dụng nó. Hiểu sai điều này là lỗi định lượng phổ biến nhất lỗi trong suy luận lâm sàng.
Khái niệm, kèm hình ảnh. 2×2: độ nhạy = a/(a+c) (bị bệnh, kết quả dương tính); độ đặc hiệu = d/(b+d) (khỏe mạnh, kết quả âm tính); PPV = a/(a+b), NPV = d/(c+d) — và cây tần số tự nhiên giải thích tại sao độ prevalence di chuyển các giá trị tiên lượng ✓.

Sự suy diễn (tại sao tỷ lệ mắc bệnh chi phối PPV). PPV = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. Với Se = Sp = 90 %: ở tỷ lệ mắc bệnh 10 %, PPV = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — ngay cả một xét nghiệm tuyệt vời cũng trở thành việc lật đồng xu trong phòng khám có prevalence thấp. Cánh giả dương tính phát triển tỷ lệ với đa số người khỏe mạnh. nhóm đối chứng tương ứng với đa số khỏe mạnh.
Ví dụ minh họa 1 — cây tần suất tự nhiên (tổng hợp). 1,000 người, khỏe mạnh → 10 âm tính thật, 100 dương tính giả ✓. PPV = 90/10 = 900 %; khỏe → 810 âm tính thật, 90 dương tính giả ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. Same test at prevalence 1 %: 9 TP vs 99 FP → PPV 9/108 = 8.3 % ✓ — một cây, hai thế giới.
Ví dụ minh họa 2 — liên kết lâm sàng: tỷ số khả năng di chuyển. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: kết quả dương tính nhân xác suất trước xét nghiệm lên gấp 9 lần bất kể tỷ lệ mắc bệnh của phòng khám. Xác suất trước xét nghiệm 1:9 (10 %) → xác suất sau xét nghiệm 9:9 = 1:1 → xác suất 50 % — cùng PPV đó, được tính toán chỉ trong một dòng. Tỷ số khả năng (LRs) là dạng di động của xét nghiệm; giá trị dự báo mang tính địa phương.
Lỗi thường gặp. Trích dẫn độ nhạy là "xét nghiệm đúng 90 %" (thực tế là đúng với 90 % các ca BỆNH — ví dụ về điều gì đó). Áp dụng PPV trong sách giáo khoa cho một phòng khám có tỷ lệ mắc bệnh khác. Nhầm lẫn hai cột (độ nhạy đọc dọc theo cột bệnh nhân; độ đặc hiệu dọc theo cột người khỏe mạnh).
Tóm tắt. Se = a/(a+c), Sp = d/(b+d) — thuộc tính của xét nghiệm; PPV/NPV — thuộc tính dân số, thay đổi theo tỷ lệ mắc bệnh; cây tần suất tự nhiên giúp làm rõ ràng; $LR+ = Se/(1-Sp)$ nhân xác suất thuận tiện (0.9/0.1 = 9); 50 % PPV tại 10 % tỷ lệ mắc bệnh dù Se = Sp = 90 %.
Suy luận thống kê cho dữ liệu lâm sàng
Tại sao quan trọng. Suy luận là cách mẫu đại diện cho quần thể — và việc hiểu sai p-value và khoảng tin cậy là những lỗi đặc trưng của văn học hiện đại.
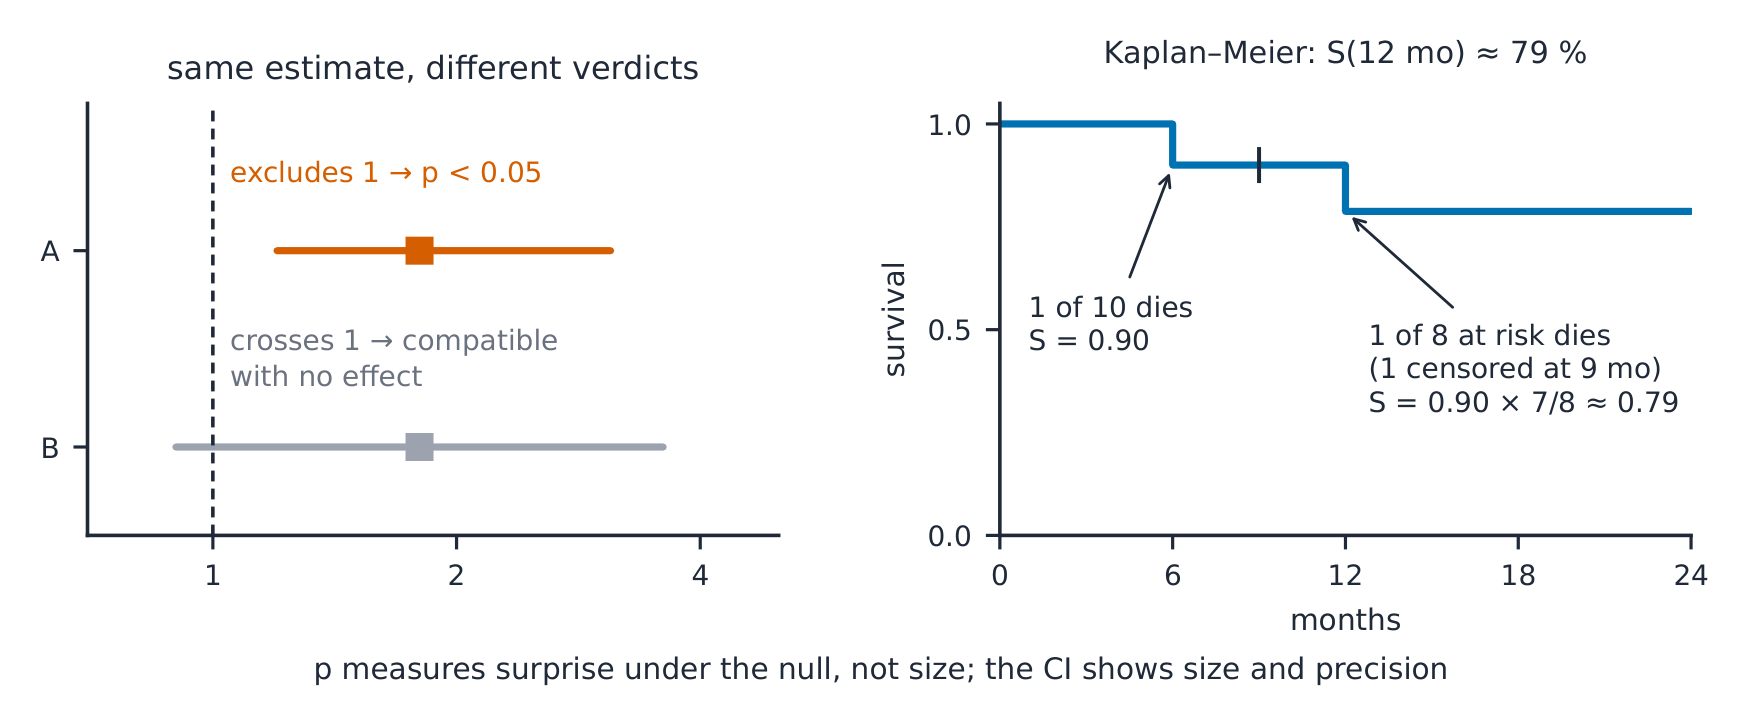
Ý tưởng, kèm hình ảnh. Một khoảng tin cậy 95 % là dải giá trị thực phù hợp với dữ liệu ở mức đó; một p-value P là xác suất của dữ liệu ít nhất cực đoan như vậy GIẢ SỬ giả thuyết không đúng ✓. CI tóm tắt kích thước và độ chính xác; p-value chỉ tóm tắt sự ngạc nhiên.
Sự suy diễn (tại sao bài kiểm tra tuân theo loại dữ liệu). Đếm theo nhóm → χ²; hai trung bình (phân bố chuẩn tương đối) → t-test (khi mỗi hàng được đo hai lần); nhiều trung bình → ANOVA; lệch/tỷ lệ nhỏ → thứ hạng (phi tham số) các phương án thay thế; hai biến đo lường liên tục → tương quan (Pearson, hoặc Spearman cho thứ hạng) ✓. Thang đo đo lường quyết định loại kiểm định — việc chọn sau khi xem kết quả sẽ dẫn đến câu hỏi sai. đối với cấp bậc) ✓. Việc chọn thang đo trước khi thử nghiệm — quyết định sau khi nhìn thấy kết quả sẽ dẫn đến câu hỏi sai lầm.
Ví dụ minh họa 1 — đọc một khoảng. (Bảng tóm tắt giả định) RR 1.8, 95 % CI 1.2–3.1: khoảng này không chứa 1, nên dữ liệu không phù hợp với "không có tác động" ở mức ý nghĩa này (p < 0.05 được thỏa mãn); độ rộng của khoảng chỉ ra ước lượng không chính xác nhưng luôn cao hơn 1 ✓. RR 1.8 với CI 0.9–3.6 cho biết ngược lại — cùng giá trị điểm ước lượng, nhưng kết luận khác nhau, và chỉ có khoảng tin cậy mới cho bạn biết điều đó.
Ví dụ minh họa 2 — liên hệ lâm sàng: phép tính Kaplan–Meier. (Dữ liệu tổng hợp) 10 bệnh nhân tham gia nghiên cứu; tại tháng 6 có 1 sự kiện trong số 10 người còn nguy cơ: $S = 9/10 = 0.90$; tại tháng 12 có 1 sự kiện trong số 8 người vẫn còn nguy cơ (một người bị censoring): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. Thời gian sống trung vị là thời điểm đường cong cắt qua 50 %; censoring loại bỏ người khỏi mẫu số, chứ không phải khỏi logic của ước lượng. tương thích với việc không có sự khác biệt — thiếu bằng chứng ≠ bằng chứng về sự vắng mặt).
Lỗi thường gặp. "p > 0.05 có nghĩa là không có sự khác biệt" (thực tế nó có nghĩa là dữ liệu phù hợp với giả thuyết không có sự khác biệt — thiếu bằng chứng ≠ bằng chứng về sự vắng mặt). một thuộc tính của quy trình, áp dụng vào ước lượng của mẫu này). Việc chọn kiểm định sau khi thấy cái nào cho p < 95. a property of the procedure, applied to this sample's estimate). Choosing the test after seeing which gives p < 0.05.
Tóm tắt. CI = khoảng tin cậy, thể hiện kích thước và độ chính xác; p-value = P(dữ liệu cực đoan như thế | giả thuyết không); không bao giờ "chứng minh" hay "không có tác dụng" chỉ từ p; χ²/t/ANOVA/rank/correlation được chọn theo loại dữ liệu; đường cong Kaplan–Meier – nhân (1 − sự kiện/người đang theo dõi); trung vị = 50 % vượt qua.
Thử nghiệm lâm sàng và tổng quan hệ thống
Tại sao điều này quan trọng. Thử nghiệm là máy móc chứng minh và tổng quan là bộ phận lắp ráp — thuật ngữ (ngẫu nhiên hóa, che giấu, ITT, NNT) là những gì mọi bản tóm tắt và biểu đồ rừng đều giả định bạn đã biết.
Khái niệm, với hình ảnh. Cột sống của thử nghiệm: tiêu chí tuyển → ngẫu nhiên hóa (giao bằng chance, phân bổ ẩn) → che giấu (người tham gia, bác sĩ, người đánh giá kết quả) → phân tích theo ý định điều trị (phân tích như đã ngẫu nhiên hóa, tất cả đều được tính) ✓. Tổng quan gộp vào biểu đồ rừng: hình vuông (kích thước = trọng số), đường (CI), kim cương (gộp), và sự dị biệt $I^2$ ✓.
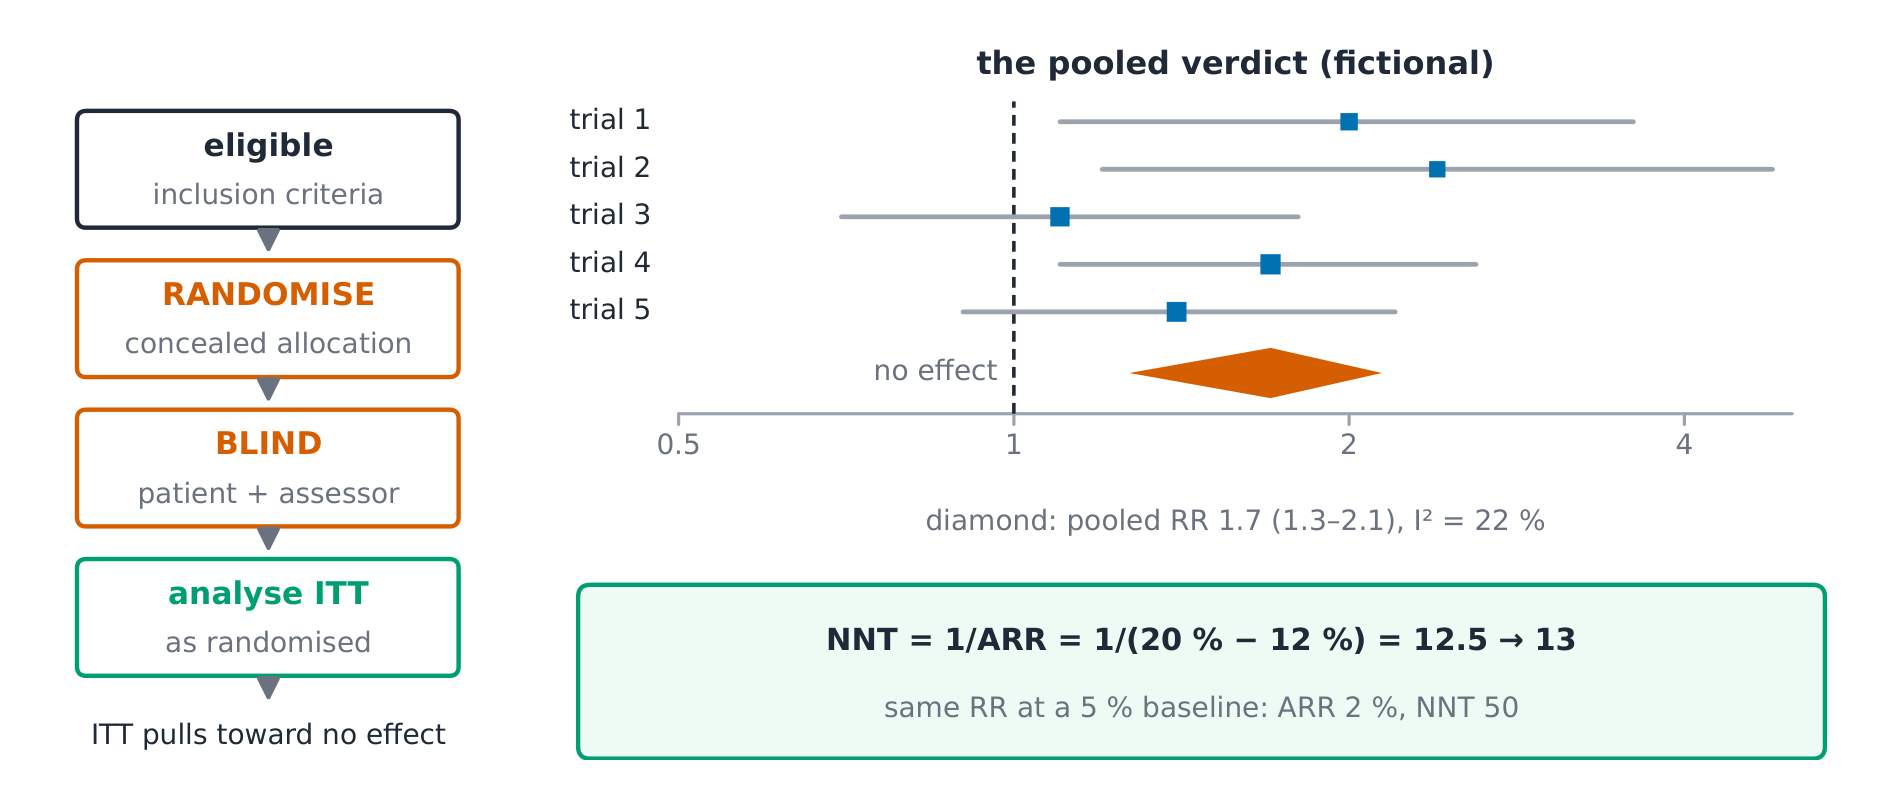
Sự suy diễn (tại sao NNT là kích thước lâm sàng của hiệu ứng). NNT = $1/ARR$: tỷ lệ biến cố nhóm đối chứng 20 %, nhóm điều trị 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13 người được điều trị cho một người được lợi ✓. NNT chuyển đổi một tỷ lệ trừu tượng thành khối lượng công việc — và mẫu số của nó (ARR) thu nhỏ khi nguy cơ nền giảm, đó là lý do tại sao kết quả thử nghiệm không áp dụng trực tiếp sang các phòng khám có nguy cơ thấp hơn mà không thay đổi.
Ví dụ minh họa 1 — Logic ITT. (Thử nghiệm giả định) 20 % nhóm đối chứng so với 12 % nhóm điều trị: ARR 8 %, NNT 13 ✓. Nếu 30 % trong nhóm điều trị ngừng phân bổ sớm, ITT vẫn tính họ là được điều trị — làm giảm hiệu quả apparent về phía giá trị trung lập — vì câu hỏi là CHÍNH SÁCH phân bổ, không phải sinh học của người tuân thủ ✓. Phân tích theo giao thức trả lời một câu hỏi khác và kế thừa thiên lệch tuân thủ. question and inherits adherence bias.
Worked example 2 — clinical link: reading the diamond. (Fictional forest) five trials, individual RRs 1.1–2.4 with wide CIs, pooled RR 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: the diamond sits right of 1 and its interval Cùng một hình kim cương nếu có 1 sẽ gợi ý "tại sao các thí nghiệm The same diamond with $I^2 = 78\ \%$ would prompt "why do these trials nhóm; che giấu cân bằng kỳ vọng — một thử nghiệm có thể có cả hai hoặc chỉ một). Đọc phân tích theo giao thức như phân tích trung thực (nó phá vỡ bảo vệ của phân ngẫu nhiên). Coi kim cương gộp là chân lý dù độ dị biệt cao.
Tóm tắt. Phân ngẫu nhiên (che giấu) → Che giấu → Phân tích theo phân ngẫu nhiên (ITT, Đọc theo phác đồ như phân tích trung thực (vì nó phá vỡ bảo vệ của ngẫu nhiên hóa). Coi hình kim cương gộp là chân lý dù có độ dị thể cao. Tóm tắt. Ngẫu nhiên hóa (ẩn giấu) → che mắt → phân tích theo ngẫu nhiên hóa (ITT, heterogeneity.
Summary. Randomise (concealed) → blind → analyse as randomised (ITT, dilutes toward null); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); forest: vuông có trọng số, kim cương gộp, $I^2$ bất đồng; cơ sở y tế thấp Thu nhỏ ARR và mở rộng NNT.
Đánh giá phản biện và áp dụng bằng chứng
Tầm quan trọng. Bằng chứng chỉ trở thành y học tại giường bệnh: sau khi được đánh giá về tính hợp lệ, định lượng mức độ quan trọng, và phù hợp với bệnh nhân trước bạn. Đơn vị này là sự tổng kết của toàn bộ khóa học.
Ý tưởng, kèm hình ảnh. Cột sống đánh giá: PICO (dân số, can thiệp, so sánh, kết quả) định khung → tính hợp lệ (kết quả có bị thiên lệch?) → quy mô (lớn đến mức nào, chính xác ra sao?) → khả năng áp dụng (bệnh nhân của tôi có giống dân số đã nghiên cứu không?) ✓. Xếp hạng độ tin cậy (GRADE): bằng chứng từ thử nghiệm ngẫu nhiên bắt đầu ở mức cao và bằng chứng quan sát ở mức thấp; hạ cấp do nguy cơ thiên lệch, không nhất quán, gián tiếp, thiếu chính xác hoặc thiên lệch xuất bản; nâng cấp do hiệu ứng lớn hoặc gradient liều-đáp ứng ✓. Thang xếp hạng thể hiện mức độ dễ bị thiên lệch trung bình, chứ không phải sự đúng đắn của từng nghiên cứu — một thử nghiệm kém chất lượng có thể gây hiểu sai nhiều hơn một nghiên cứu cohort tốt
 Sự thiết lập (tại sao thứ bậc lại là tiên quyết, không phải phán quyết). Các thiết kế
khác nhau trong việc kiểm soát TYPICAL bias: phân ngẫu nhiên cân bằng các yếu tố gây nhiễu đã đo lường và chưa đo lường; cohort mang theo yếu tố gây nhiễu; case-control bổ sung thiên lệch hồi nhớ ✓. Nhưng thứ bậc xếp hạng loại thiết kế, còn phán quyết thuộc về nghiên cứu cụ thể đang xem xét — một thử nghiệm nhỏ, không mù, phân tích theo phác đồ có thể đáng ít tin cậy hơn một nghiên cứu cohort lớn, đăng ký trước, với điều chỉnh propensity. GRADE tồn tại đúng vì loại thiết kế chỉ là thử nghiệm có thể ít đáng tin cậy hơn một nhóm tiền đăng ký lớn với điều chỉnh xu hướng. GRADE tồn tại chính xác vì phân loại thiết kế chỉ là điểm bắt đầu.
Ví dụ minh họa 1 — một bản tóm tắt giả định trong năm câu hỏi. (Giả định) "Ngẫu nhiên hóa, mù đôi, n = 400; RR 0.75 (0.60–0.94)": độ tin cậy — ngẫu nhiên hóa và mù ✓; quy mô — giảm tương đối 25 %, khoảng loại trừ 1; tính áp dụng địa phương — bệnh nhân giống tôi có được tuyển chọn (tuổi, mức độ nghiêm trọng, dùng chung thuốc)?; kết quả — liên quan đến bệnh nhân hay là giá trị thay thế?; mức độ chắc chắn — có đặc điểm nào làm giảm cấp độ không? Năm câu hỏi, một phán quyết có cấu trúc ✓.
Ví dụ minh họa 2 — liên kết lâm sàng: chuyển giao NNT. (Giả định) a thử nghiệm ở bệnh nặng (mức nền 20 %, ARR 8 %, NNT 13); bệnh nhân của tôi bệnh viện chạy ở mức nền 5 %: với cùng mức giảm nguy cơ tương đối thì ARR tương ứng với $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. Hiệu ứng tương đối có thể di chuyển; gánh nặng tuyệt đối — khối lượng công việc và phép toán lợi ích-hại — mang tính địa phương.
Lỗi thường gặp. Chỉ đánh giá về độ tin cậy (một hiệu ứng hợp lệ nhưng quá nhỏ vẫn vô dụng: quy mô và độ chính xác quyết định tầm quan trọng). Xếp hạng theo tên tạp chí hoặc nhãn thiết kế duy nhất (GRADE bắt đầu từ đó và di chuyển cùng các lỗi của bằng chứng). Áp dụng trung bình nhóm cho bệnh nhân mà đặc điểm xác định của họ là một tiêu chuẩn loại trừ.
Tóm tắt. PICO → độ tin cậy → quy mô → tính áp dụng; GRADE: bắt đầu từ thiết kế, giảm cấp do thiên lệch/mâu thuẫn/gián tiếp/độ chính xác thấp, nâng cấp cho hiệu ứng lớn; sơ đồ là tiền đề, không phải phán quyết; hiệu ứng tương đối du lịch, lợi ích tuyệt đối (ARR, NNT) mang tính cục bộ — hãy tính lại trước khi áp dụng.