รหัสตัวอักษร — ASCII และ Unicode
แนะนำใหม่| English | ความหมาย |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | ยูนิโค้ด |
| character set/ˈkærɪktə set/ | ชุดตัวอักษร |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | การเข้ารหัส |
| code point/kəʊd pɔɪnt/ | จุดรหัส |
| UTF-8/ˌjuː tiː ˈef eɪt/ | UTF-8 |
อีเมลที่ปรากฏเป็นข้อความไร้ความหมาย
- ในช่วงทศวรรษ 1990 ข้อความที่พิมพ์ในวอร์ซอว์และอ่านในโตเกียว มักปรากฏเป็นกำแพงของข้อความไร้ความหมาย ทั้งสองคอมพิวเตอร์เก็บข้อมูล 8 บิตต่อหนึ่งตัวอักษร พวกเขาเพียงแต่ไม่ตรงกันเกี่ยวกับความหมายของ 128 ลวดลายบนสุด
- โค้ดเพจของโปแลนด์จัดตัวอักษรโปแลนด์ไว้ที่นั่น โค้ดเพจของญี่ปุ่นจัดตัวอักษรของตัวเองไว้ที่นั่น ไม่มีอะไรเสียหายระหว่างการส่ง: байต์มาถึงสมบูรณ์และถูกอ่านโดยอ้างอิงตารางอื่น
- วิธีแก้ไขคือการหยุดการใช้ตารางแยกตามประเทศและมอบ รหัส ให้กับ ทุก ตัวอักษรใน ทุก ระบบเขียน เพื่อถาวร นั่นคือ Unicode และนั่นคือเหตุผลว่าทำไม emoji ที่คุณส่งถึงจะปรากฏเป็นภาพเดิม
- บทเรียนนี้คือวิธีที่ข้อความกลายเป็นตัวเลข: ชุดตัวอักษร (character sets), ASCII, Unicode และการเข้ารหัสที่ใช้เก็บข้อมูลเหล่านั้น
ชุดตัวอักษรให้รหัสกับแต่ละตัวอักษร
- คอมพิวเตอร์ไม่เก็บตัวอักษร มีเพียงตัวเลข ชุดตัวอักษร คือชุดของตัวอักษรที่คอมพิวเตอร์สามารถแทนค่าได้ โดยแต่ละตัวมีรหัสไบนารีของตัวเอง
- ตัวเลขแทนหนึ่งตัวอักษรเรียกว่า code point.
Aคือ 65,aคือ 97, และเลข0คือ 48. - Code point ไม่ใช่ความหมายของตัวอักษร แต่เป็นฉลากที่ตกลงกันไว้ ข้อความอ่านได้ก็เพราะเครื่องทั้งสองใช้ชุดตัวอักษรเดียวกัน
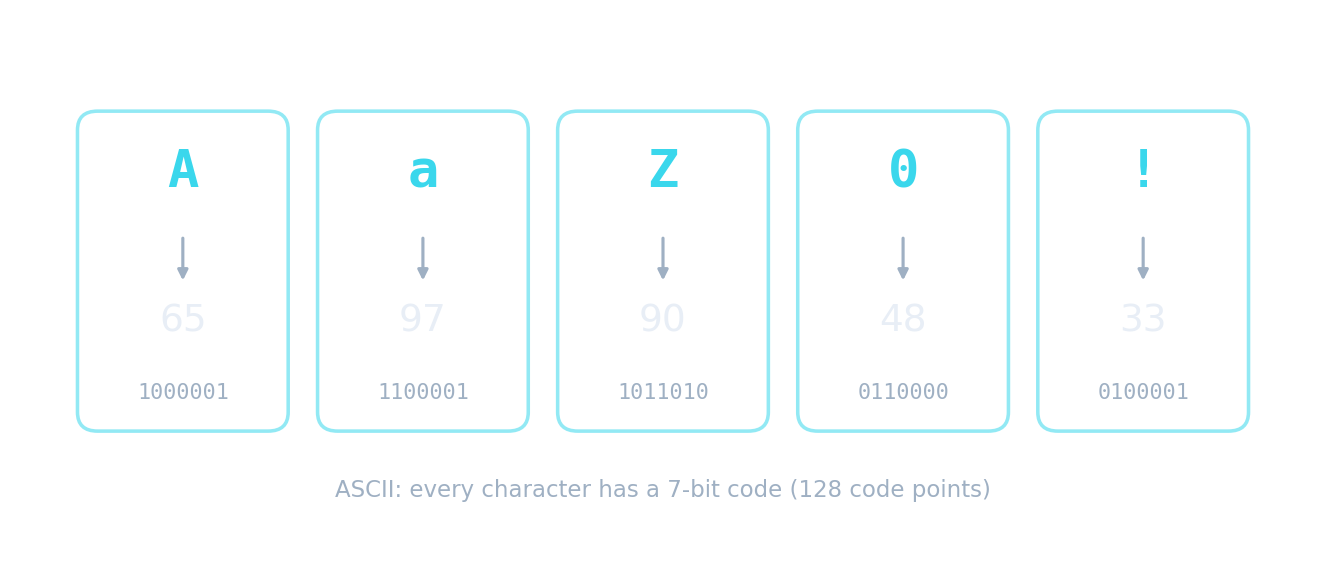
ตัวอักษรคือภาพ; байต์คือตัวเลข
ตัวอักษรถูกจัดเก็บในฐานะตัวเลข
แต่ละตัวอักษรมีรหัสเลข — 'A' คือ 65 พลิกบิตเพื่อดูรหัสนี้ในรูปแบบเลขฐานสองและหกสิบหนึ่ง ตามที่คอมพิวเตอร์จัดเก็บจริง
ชุดตัวอักษรอย่าง ASCII นิยาม:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
ชุดตัวอักษรจับคู่แต่ละตัวอักษรกับตัวเลข (จุดรหัสของมัน) ซึ่งเป็นสิ่งที่คอมพิวเตอร์จัดเก็บจริง
ASCII
- ASCII American Standard Code for Information Interchange ใช้ 7 บิต ทำให้ได้ $2^7 = 128$ code points: ตัวอักษรลาตินพื้นฐาน เลข symbol และ 32 control codes เช่น carriage return
- Extended ASCII ใช้ 8 บิต ทำให้ได้ 256 code points 128 ต่ำสุดเหมือนกันกับ ASCII ส่วน 128 สูงสุดแตกต่างกันไปตามภูมิภาค ซึ่งนี่แหละที่ทำให้อีเมลนั้นพัง
- คุณไม่เคยต้องท่องจำโค้ด แต่คุณต้องตอบเรื่องจำนวน: 7 บิต = 128; 8 บิต = 256
7-bit ASCII มีจุดรหัสที่แตกต่างกันทั้งหมดกี่จุด?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
7 บิตให้ $2^7 = 128$ จุดรหัส
extended ASCII มีจุดรหัสที่แตกต่างกันทั้งหมดกี่จุด?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
8 บิตให้ 2^8 = 256 128 ตัวแรกตรงกับ plain 7-bit ASCII; 128 ตัวหลังแตกต่างกันไปตามภูมิภาค
Unicode
- Unicode เป็นชุดตัวอักษรสากล: code point เดียวสำหรับเกือบทุกตัวอักษรในทุกภาษาที่ยังมีชีวิตอยู่หรือสิ้นสูญ รวมถึงสัญลักษณ์และ emoji มากกว่า 149,000 ตัว
- Code point แยกจากวิธีการเก็บข้อมูล Encoding เปลี่ยน code point ให้เป็น байต์
- UTF-8 UTF-8 ใช้ 1 เพื่อ 4 ไบต์ต่อตัวอักษร และเป็น ASCII-compatible: 128 code point แรกมีขนาด 1 ไบต์ เหมือนกับ ASCII พอดี. UTF-16 ใช้ 2 หรือ 4 ไบต์; UTF-32 ใช้ 4 แบบคงที่.
ข้อใดถูกต้องเกี่ยวกับ UTF-8?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
UTF-8 เป็นรูปแบบการเข้ารหัส Unicode แบบความยาวแปรผัน (1–4 ไบต์); ตัวแทนรหัสแรก 128 ตัวตรงกันกับ ASCII ดังนั้นข้อความ ASCII ธรรมดาจึงเป็น UTF-8 ที่ถูกต้อง
ความสัมพันธ์ระหว่าง Unicode และ UTF-8 คืออะไร?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
ชุดกำหนดหมายเลข; การเข้ารหัสตัดสินใจว่าแต่ละเลขใช้จำนวนไบต์เท่าใด UTF-16 และ UTF-32 เป็นการเข้ารหัสอื่น ๆ ของชุดเดียวกัน
ตัวอย่างวิธีทำ: เปรียบเทียบ ASCII และ Unicode
- ให้ข้อดีหนึ่งข้อและข้อเสียหนึ่งข้อของการใช้ Unicode แทน ASCII [2]
- ข้อดี: Unicode แทนค่าตัวอักษรได้มากกว่ามาก ดังนั้นข้อความ在任何ภาษา เช่น จีน อารับ กreek และ emoji สามารถเก็บได้ และเอกสารเดียวสามารถผสมภาษาได้ ไฟล์พกพาได้ง่ายเพราะไม่มีโค้ดเพจแยกตามประเทศที่ต้องขัดแย้งกัน
- ข้อเสีย: สำหรับข้อความภาษาอังกฤษล้วน ไฟล์ Unicode มักจะ ใหญ่กว่า เพราะตัวอักษรหนึ่งอาจต้องใช้มากกว่า 1 байต์
- ต้องตอบทั้งสองส่วน "มีตัวอักษรมากขึ้น" เพียงอย่างเดียวได้คะแนน 1 จาก 2
ข้อดีสำคัญ的一点ของ Unicode เมื่อเทียบกับ ASCII คือ:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Unicode ครอบคลุมเกือบทุกระบบเขียน plus symbols และ emoji — กว้างกว่าชุดภาษาอังกฤษพื้นฐานของ ASCII มาก
สำหรับข้อความภาษาอังกฤษเท่านั้น ไฟล์ Unicode มักจะมีขนาดใหญ่กว่าข้อความเดียวกันใน ASCII
Difficulty 1/5 · 100 coins + a small bonus on first completion today
การเข้ารหัส Unicode สามารถใช้ nhiều bytes ต่อ character ได้ ดังนั้นข้อความภาษาอังกฤษธรรมดาจึงมักมีขนาดใหญ่กว่าใน 7-bit ASCII — ซึ่งเป็นค่าแลกเปลี่ยนสำหรับการครอบคลุมสากล
ข้อใดเป็นข้อดีของ Unicode เมื่อเทียบกับ ASCII? เลือก ทั้งหมด ที่ถูกต้อง
Difficulty 2/5 · 140 coins + a small bonus on first completion today
ขนาดคือค่าแลกเปลี่ยน ไม่ใช่ประโยชน์: สำหรับข้อความภาษาอังกฤษธรรมดา ไฟล์ Unicode มักจะมีขนาดใหญ่กว่า
ตัวอย่างวิธีทำ: ขนาดไฟล์ข้อความ
- ข้อความขนาด 500 ตัวอักษรถูกเก็บใน Extended ASCII ไฟล์มีขนาดใหญ่เท่าใดในหน่วย байต์?
- Extended ASCII ใช้ 8 บิต หรือ 1 байต์ ต่อตัวอักษร ดังนั้น $500 \times 1 = 500$ байต์ หรือ $500 \times 8 = 4000$ บิต
- ข้อความเดียวกันใน UTF-32? 4 байต์ต่อตัวอักษร ดังนั้น 2000 байต์
- แสดงบิตต่อตัวอักษร คูณ แล้วแปลงหน่วยครั้งเดียว การสลับระหว่างบิตและбайต์กึ่งกลางทางเป็นสาเหตุทั่วไปของการสูญเสียคะแนน
ข้อความ 500 ตัวอักษรถูกเก็บใน extended ASCII ต้องใช้จำนวน多少个 bytes (ovable header)
Difficulty 2/5 · 140 coins + a small bonus on first completion today
แปดบิต, หนึ่งไบต์, ต่อ character: 500 x 1 = 500 bytes, หรือ 4000 bits. ใน UTF-32 ข้อความเดียวกันต้องการ 2000 bytes
อ่านตัวอักษรในรูปแบบไบนารีและเฮกซ์
- เนื่องจาก code point เป็นเพียงตัวเลข มันจึงแปลงได้เหมือนตัวเลขอื่นๆ
Aคือ 65 ซึ่งเป็น0100 0001ในรูปแบบไบนารีและ41ในรูปแบบเฮกซ์ - ลวดลายที่มีประโยชน์สองอย่าง: เลข
0ถึง9เริ่มตั้งแต่ 48 และตัวพิมพ์เล็กมีค่ามากกว่าตัวพิมพ์ใหญ่ 32 ดังนั้นa(97) คือA(65) บวก 32 ความต่างนี้เป็นบิตเดียว - คำถามที่ให้
A= 65 และขอEต้องการ $65 + 4 = 69$ ไม่ใช่การท่องจำตาราง
ASCII code สำหรับ A คือ 65. ASCII code สำหรับ E คืออะไร?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
ตัวอักษรเรียงต่อกัน ดังนั้น E อยู่ห่างจาก A สี่ตำแหน่ง ไม่ต้องจำอะไรนอกจาก anchor value เดียว
คะแนนที่หลุดหายไป
- ASCII คือ 7 บิตและ 128 code points; Extended ASCII คือ 8 บิตและ 256 อย่าเขียน 8 บิตสำหรับ ASCII ธรรมดา
- Unicode คือ ชุดตัวอักษร; UTF-8 คือ encoding ของมัน มันไม่ใช่สองชุดที่แข่งกัน
- UTF-8 มีความยาวแปรผัน 1 ถึง 4 байต์ ไม่ใช่เสมอ 1 байต์และไม่เสมอ 4 байต์
- ข้อเสียของ Unicode คือ ขนาดไฟล์ สำหรับภาษาอังกฤษล้วน ไม่ใช่ "ช้ากว่า" หรือ "อ่านยากกว่า"
คุณเข้าใจแล้ว
- ชุดตัวอักษร ให้ code point กับแต่ละตัวอักษร; ข้อความคือตัวเลข плюсข้อตกลงในการอ่านมัน
- ASCII: 7 บิต, 128 code points, ภาษาอังกฤษเท่านั้น · extended ASCII: 8 บิต, 256, ส่วนบนสุดแตกต่างกันตามภูมิภาค
- Unicode: code point เดียวสำหรับทุกภาษาและ emoji เก็บโดย encoding; UTF-8 คือ 1 ถึง 4 байต์และ ASCII-compatible
- Unicode เพิ่มตัวอักษร ความพกพาได้ และรองรับภาษาผสม; แต่เพิ่มขนาดไฟล์สำหรับข้อความภาษาอังกฤษล้วน