Коды символов — ASCII и Unicode
Введено| English | Значение |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | Unicode |
| character set/ˈkærɪktə set/ | набор символов |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | кодирование |
| code point/kəʊd pɔɪnt/ | точка кода |
| UTF-8/ˌjuː tiː ˈef eɪt/ | UTF-8 |
Письмо, которое пришло как набор бессмысленных символов
- На протяжении 1990-х годов сообщение, набранное в Варшаве и прочитанное в Токио, часто приходило стеной непонятных символов. Оба компьютера хранили по восемь бит на символ. Они просто по-разному трактовали значения верхних 128 шаблонов.
- Кодировка Польши помещала польские буквы туда. Кодировка Японии размещала там свои символы. Ничего не было повреждено при передаче: байты прибыли целыми, но были прочитаны по другой таблице.
- Исправлением стало отказ от таблиц для каждой страны и присвоение каждому символу в каждом алфавите одного номера навсегда. Это Юникод, именно поэтому эмодзи, который вы отправляете, отображается одинаково у всех получателей.
- Этот урок о том, как текст превращается в числа: наборы символов, ASCII, Юникод и кодировки, которые их хранят.
Набор символов присваивает каждому символу номер
- Компьютер хранит не буквы, а только числа. Набор символов — это совокупность символов, которые компьютер может представлять, каждый со своим собственным двоичным кодом.
- Номер для одного символа называется его точкой кода.
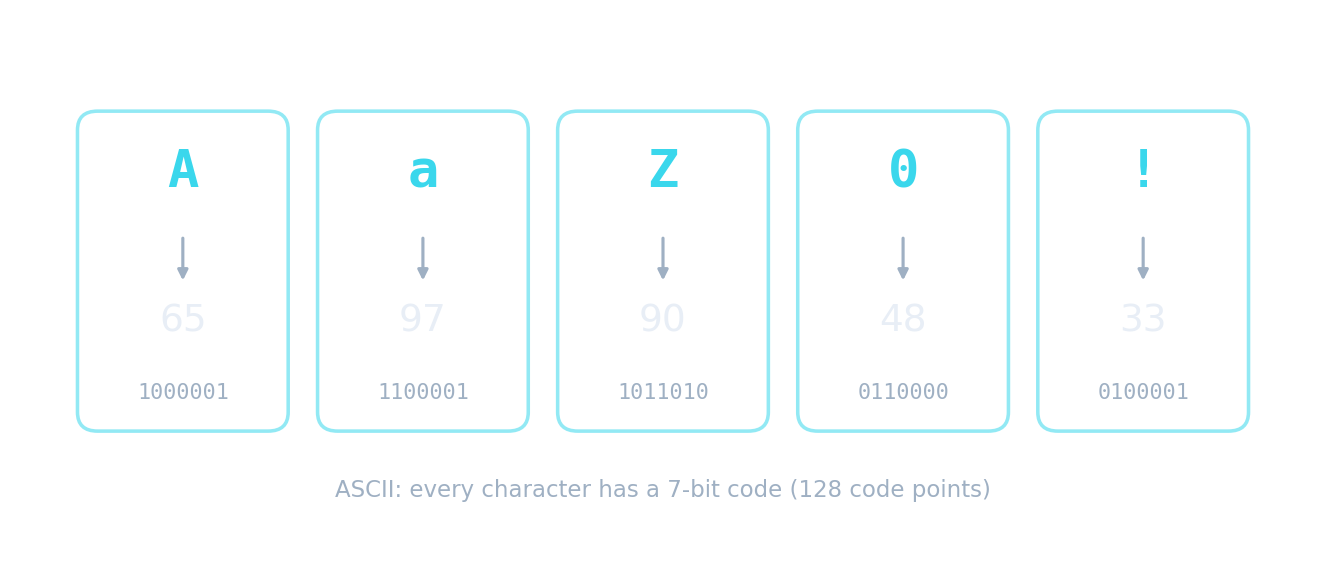
Aравен 65,aравен 97,0для цифры — 48. - Точка кода не означает значение символа; это согласованный ярлык. Текст читаем только потому, что обе машины используют один и тот же набор символов.
Буква — это изображение, байт — это число
Символ хранится в виде числа
У каждого символа есть номер кода — 'A' это 65. Инвертируйте биты, чтобы увидеть этот код в двоичной и шестнадцатеричной системах, точно так, как компьютер его хранит.
Набор символов, такой как ASCII, определяет:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Набор символов сопоставляет каждому символу число (его код-точку), которое и хранится в компьютере на самом деле.
ASCII
- ASCII (Американский стандартный код обмена информацией) использует 7 бит, давая $2^7 = 128$ точек кода: базовые латинские буквы, цифры, знаки пунктуации и 32 управляющих кода, таких как возврат каретки.
- Расширенное ASCII использует 8 бит, давая 256 точек кода. Нижние 128 идентичны обычному ASCII; верхние 128 различаются в зависимости от региона, что и привело к поломке того письма.
- От вас не требуется заучивать коды, но требуются подсчеты: 7 бит → 128; 8 бит → 256.
Сколько различных код-точек имеет 7-битный ASCII?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
7 бит дают $2^7 = 128$ код-точек.
Сколько различных код-точек имеет расширенный ASCII?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Восьмибитные данные обеспечивают 2^8 = 256. Нижние 128 совпадают с обычным 7-битным ASCII; верхние 128 различаются в зависимости от региона.
Юникод
- Unicode — универсальный набор символов: по одному кодовому значению для почти каждого символа в каждом существующем или устаревшем алфавите, а также для символов и эмодзи, всего более 149,000 из них.
- Точка кода отделена от способа хранения. Кодировка преобразует точку кода в байты.
- UTF-8 UTF-8 использует от 1 до 4 байт на символ и совместим с ASCII: первые 128 кодовых значений занимают один байт и идентичны ASCII. UTF-16 использует 2 или 4 байт; UTF-32 использует фиксированные 4.
Что верно для UTF-8?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
UTF-8 — это кодировка Юникода переменной длины (1–4 байта); её первые 128 кодовых точек совпадают с ASCII, поэтому обычный текст ASCII является валидным UTF-8.
Какова связь между Юникодом и UTF-8?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Набор присваивает номера; кодировка решает, сколько байт занимает каждый номер. UTF-16 и UTF-32 — другие кодировки того же набора.
Разобранный пример: сравнение ASCII и Юникода
- Назовите одно преимущество и одно недостаток использования Юникода вместо ASCII. [2]
- Преимущество: Юникод представляет значительно больше символов, поэтому текст на любом алфавите (китайском, арабском, греческом), а также эмодзи могут быть сохранены, и в одном документе можно смешивать языки; файлы портативны, так как нет региональных кодировок, вызывающих разногласия.
- Недостаток: для текста только на английском файлу Юникода обычно требуется больший размер, поскольку один символ может занимать больше одного байта.
- Нужны обе части. Фраза «представляет больше символов» сама по себе дает один балл из двух.
Ключевое преимущество Юникода перед ASCII заключается в том, что он:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Юникод охватывает почти все письменности, а также символы и эмодзи — значительно шире, чем базовый английский набор ASCII.
Для текста только на английском файл в формате Юникод обычно больше, чем тот же текст в ASCII.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Кодировки Юникода могут использовать больше байтов на символ, поэтому обычный английский текст обычно больше, чем в 7-битном ASCII — это компромисс ради универсального покрытия.
Какие преимущества Юникода перед ASCII? Выберите все подходящие варианты.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Размер — это компромисс, а не преимущество: для простого английского файла в Юникоде обычно больше.
Разобранный пример: размер текстового файла
- Сообщение из 500 символов хранится в расширенном ASCII. Каков размер файла в байтах?
- Расширенный ASCII использует 8 бит, то есть 1 байт на символ, поэтому $500 \times 1 = 500$ байт, или $500 \times 8 = 4000$ бит.
- То же самое сообщение в UTF-32? Четыре байта на символ, итого 2000 байт.
- Покажите биты на символ, умножьте, затем переведите один раз. Смешивание битов и байтов посередине решения — типичная причина потери балла.
Сообщение из 500 символов хранится в расширенном ASCII. Сколько байтов оно займет (без учета заголовка)?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Восемь бит, один байт на символ: 500 x 1 = 500 байт, или 4000 бит. В UTF-32 тот же текст требует 2000 байтов.
Чтение символа в двоичном и шестнадцатеричном виде
- Поскольку точка кода — это просто число, она конвертируется как любое другое.
Aравно 65, что составляет0100 0001в двоичной системе и41в шестнадцатеричной. - Два полезных паттерна: цифры
0–9начинаются с 48, а строчные буквы на 32 больше заглавных, поэтомуa(97) =A(65) + 32. Эта разница соответствует одному биту. - Вопрос, в котором дано
A= 65 и просят найтиE, требует ответа $65 + 4 = 69$, а не заученной таблицы.
Код ASCII для A равен 65. Каков код ASCII для E?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Буквы идут подряд, поэтому E находится через четыре позиции после A. Запоминать нужно только одно опорное значение.
Потерянные баллы
- ASCII — это 7 бит и 128 точек кода; расширенный ASCII — 8 бит и 256. Не пишите 8 бит для обычного ASCII.
- Юникод — это набор символов; UTF-8 — это его кодировка. Они не являются конкурирующими наборами.
- UTF-8 переменной длины, 1–4 байта, а не всегда один байт и не всегда четыре.
- Недостаток Юникода заключается в размере файла для простого английского текста, а не в том, что он «работает медленнее» или «труднее читается».
Вы поняли
- Набор символов присваивает каждому символу точку кода; текст — это числа плюс соглашение о том, как их читать
- ASCII: 7 бит, 128 точек кода, только английский · расширенный ASCII: 8 бит, 256, верхняя половина варьируется по регионам
- Юникод: одна точка кода для каждого алфавита и эмодзи, хранение через кодировку; UTF-8 занимает 1–4 байта и совместим с ASCII
- Unicode добавляет символы, переносимость и поддержку смешанных языков; это увеличивает размер файла при простом английском тексте