RISC, CISC and pipelining
Introduzido| English | Significado |
|---|---|
| CISC/sɪsk/ | conjunto de instruções complexo |
| RISC/rɪsk/ | conjunto de instruções reduzido |
| pipelining/ˈpaɪplaɪnɪŋ/ | pipelining |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | taxonomia de Flynn |
| register/ˈredʒɪstə/ | registro |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| hazard/ˈhæzəd/ | perigo |
| SIMD/ˈsɪmdiː/ | SIMD |
| MIMD/ˈmɪmdiː/ | MIMD |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | paralelismo maciço |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | supercomputadores |
O telefone no seu bolso não roda Intel
- Por trinta anos, os processadores mais rápidos eram os mais complicados: adicione instruções, e cada uma faz mais trabalho. A Intel construiu um império nisso.
- Então, uma pequena empresa britânica colocou um processador deliberadamente simples em um telefone. Menos instruções, todas do mesmo comprimento, quase nenhuma tocando memória. Não podia fazer tanto por instrução, e venceu de qualquer forma.
- Venceu porque instruções simples e uniformes podem ser sobrepostas, e sobreposição vale mais que complexidade.
- Esta aula aborda CISC e RISC, pipelining, as quatro arquiteturas da taxonomia de Flynn e os limites de calor e velocidade do processador.
CISC e RISC
- Uma CISC, Computador com Conjunto de Instruções Complexo, tem muitas, muitas vezes complexas instruções: uma pode realizar vários acessos à memória e operações. Elas têm comprimento variável, então a decodificação é intrincada. Faz mais por instrução, no hardware. Exemplo: Intel x86.
- Um RISC, Computador com Conjunto Reduzido de Instruções, possui um pequeno conjunto de instruções simples, cada uma realizando uma operação básica, todas de comprimento fixo e decodificação rápida. Apenas carregar e armazenar acessam memória; tudo else é de registrador para registrador. Exemplo: ARM.
- Programas RISC são maiores, mas cada instrução é rápida e previsível, o que é exatamente o que um pipeline precisa.
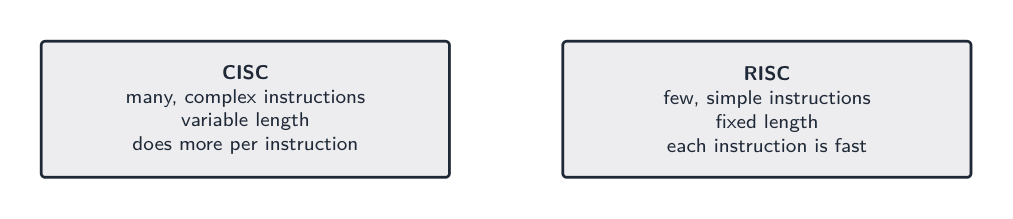
Mais por instrução, ou mais rápido e previsível por instrução
A RISC processor is characterised by:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
RISC keeps instructions few, simple and fixed-length (usually 1 cycle); CISC has many complex variable-length ones.
As diferenças que o exame quer
| Característica | CISC | RISC |
|---|---|---|
| conjunto de instruções | muitos, complexos | poucos, simples |
| comprimento da instrução | variável | fixo |
| acesso à memória | muitas instruções podem acessar memória | apenas load e store |
| registradores | fewer | many |
| ciclos por instrução | varia | geralmente um |
| pipeline | mais difícil | natural |
- Chips modernos da Intel traduzem suas instruções CISC em micro-operações RISC-like mais simples internamente, que é a evidência mais clara de qual projeto venceu a disputa.
Match each term to its description.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
RISC = simple + fixed-length + load/store; CISC = complex + variable-length; pipelining overlaps stages for speed.
In a RISC processor, the only instructions that access memory are load and ____.
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Everything else is register to register. That restriction is what makes instructions fixed-length, uniform in timing and easy to pipeline.
Pipelining
- Uma pipeline processa instruções em etapas sobrepostas, como uma linha de montagem: busca, decodificação, execução na ALU, acesso à memória, gravação final.
- Cada estágio trabalha em uma instrução diferente ao mesmo tempo, então assim que o pipeline estiver cheio, uma instrução é concluída por ciclo.
- Não torna nenhuma única instrução mais rápida. Aumenta a taxa de transferência: mais instruções terminam por segundo.
- As instruções RISC de comprimento fixo e simples fazem com que cada etapa leve o mesmo tempo, é por isso que pipelines RISC funcionam limpa e CISC não.
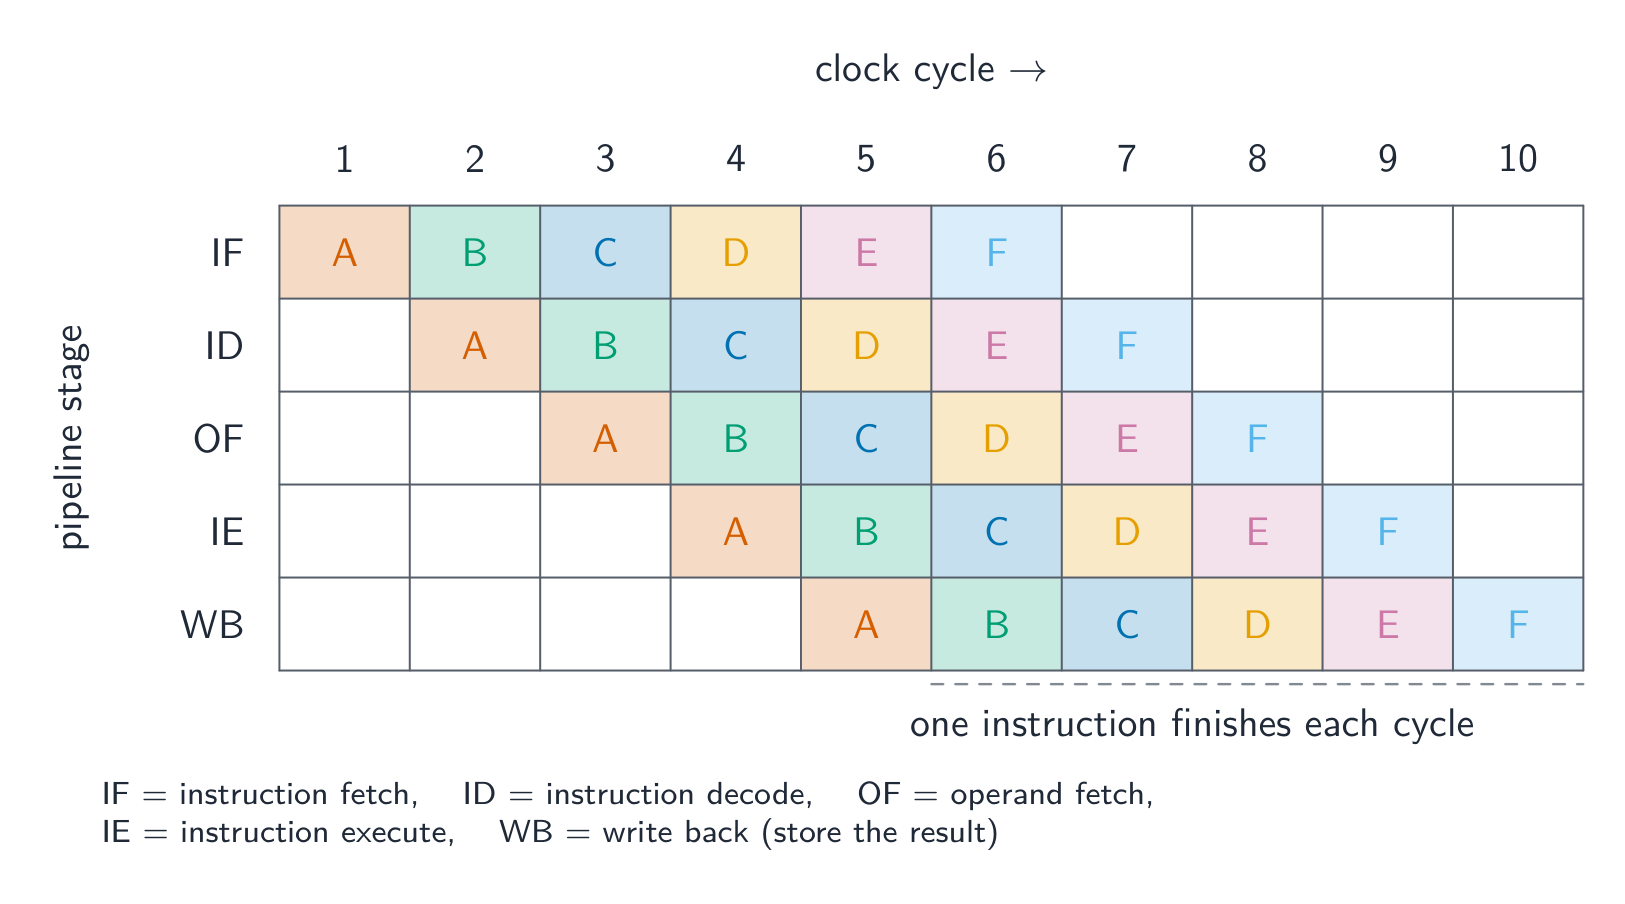
Seis instruções em voo, uma terminando a cada ciclo
How pipelining fills up
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap.
When a pipeline is full, it completes about:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Overlapping the stages means a new instruction finishes each cycle once the pipeline is full.
Pipelining speeds up a processor by:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Stages of different instructions run at the same time.
Exemplo resolvido: por que pipelining é mais rápido
- Um pipeline de cinco estágios executa a um ciclo por estágio. Explique por que é mais rápido do que executar instruções uma após a outra.
- Sem pipeline, cada instrução ocupa o processador por todos os cinco estágios, então uma termina a cada cinco ciclos.
- Com pipeline, a unidade de busca inicia a próxima instrução enquanto a atual ainda está sendo decodificada, então cinco instruções estão em andamento ao mesmo tempo e, assim que cheio, uma completa a cada ciclo.
- Nenhuma instrução individual é executada mais rápido; a taxa de transferência aumenta cerca de cinco vezes. Diga isso explicitamente: é a marca mais frequentemente perdida.
What does pipelining actually improve?
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Stages overlap, so five instructions are in progress at once and one completes per cycle. No individual instruction is executed any faster.
Hazards (Atrasos/Perigos)
- Um hazard interrompe a pipeline. Um hazard de dados ocorre quando uma instrução precisa de um resultado que a anterior ainda não produziu, exigindo espera.
- Um control hazard ocorre em um branch: até que o branch seja resolvido, o processador não sabe qual instrução buscar next.
- Ambos desperdiçam ciclos, é por isso que processadores preveem branches e encaminham resultados entre estágios.
A data hazard stalls the pipeline when an instruction needs a result that is not ready yet; a control hazard comes from a branch changing which instruction runs next.
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Hazards force the pipeline to stall (or flush), which is why they reduce the ideal one-per-cycle throughput.
Match each pipeline hazard to what causes it.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Both stall the pipeline and waste cycles, which is why processors forward results between stages and predict branches.
Taxonomia de Flynn
- A taxonomia de Flynn classifica computadores pelo número de fluxos de instruções e fluxos de dados que possuem.
- SISD: um stream de instrução, um stream de dados, um núcleo único tradicional.
- SIMD: uma instrução opera em muitos itens de dados simultaneamente. É uma unidade vetorial de GPU ou CPU, adequada para imagens, vídeo e matrizes científicas.
- MISD: várias operações sobre os mesmos dados; raro e majoritariamente teórico. MIMD: muitos processadores executam instruções diferentes sobre dados diferentes, caracterizando uma CPU multicore ou cluster, sendo o modelo mais geral.
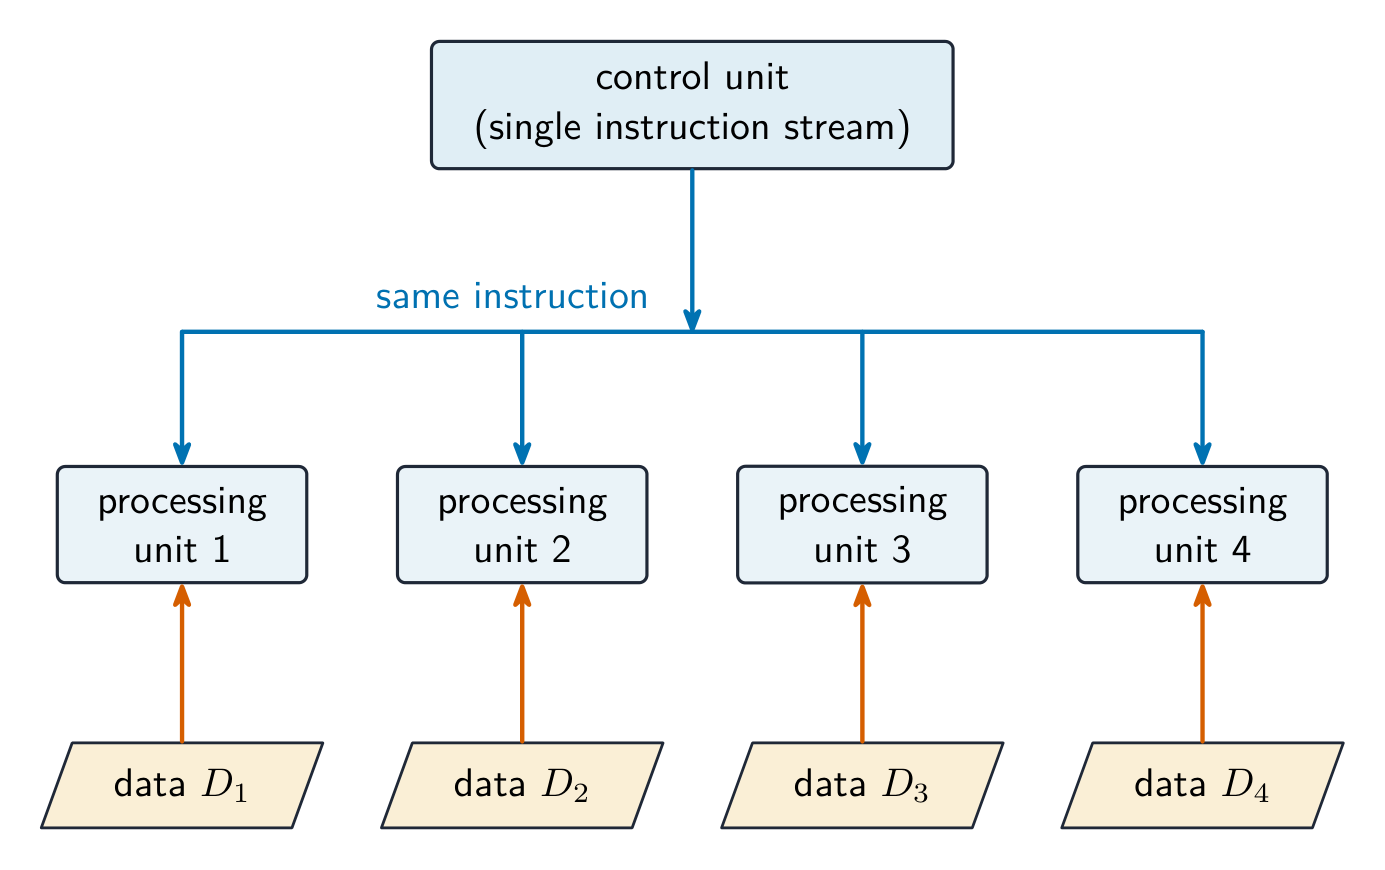
Uma instrução, muitos itens de dados
Which describe SIMD? Select todos that apply.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Different programs on different data is MIMD, the multi-core case. SIMD is one instruction stream over many data streams.
Computadores massivamente paralelos
- Um sistema massivamente paralelo utiliza milhares de processadores conectados por rede rápida, cada um com sua própria memória, trocando dados via mensagens em vez de compartilhar memória.
- É MIMD, e precisa de software escrito especialmente, porque o programador deve dividir o problema e gerenciar a comunicação.
- É assim que funcionam os maiores supercomputadores: simulação climática, treinamento de machine learning e astrofísica operam dessa forma.
A massively parallel computer's processors share one block of memory.
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Each processor has its own memory, and they exchange data by messages over a fast network. That distributed memory is what the term means.
Exemplo resolvido: posicionar a máquina
- Uma placa de vídeo aplica o mesmo ajuste de brilho a dois milhões de pixels. SIMD: uma instrução, muitos itens de dados, que é exatamente para o que milhares de núcleos pequenos da GPU são construídos.
- Um laptop de quatro núcleos roda um navegador, um compilador e um player de música ao mesmo tempo. MIMD: instruções diferentes em dados diferentes, um stream por núcleo.
- Um centro meteorológico divide a atmosfera em uma grade através de dez mil processadores, cada um com sua própria memória, passando valores de fronteira como mensagens. Massivamente parallel, que é uma forma de MIMD.
- Nomeie a categoria, depois justifique com o número de streams de instrução e dados.
Marcas que escapam
- Pipelining eleva a taxa de transferência; não encurta nenhuma instrução individual. Diga isso.
- Em RISC, apenas load e store tocam memória. Esse único fato explica o comprimento fixo, os muitos registradores e o pipeline limpo.
- SIMD é uma instrução em muitos dados; MIMD é muitas instruções em muitos dados. Conte os streams antes de responder.
- Massivamente parallel significa milhares de processadores com memória distribuída e passagem de mensagens, não apenas "um computador rápido".
Entendeu?
- CISC: muitas instruções complexas de comprimento variável, mais por instrução · RISC: poucas instruções simples de comprimento fixo, apenas load e store, muitos registradores, um ciclo cada
- Um pipeline sobrepõe busca, decodificação, execução, memória e write-back, então uma instrução completa por ciclo assim que cheio: maior taxa de transferência, não instruções mais rápidas; data e control hazards estancam-no
- Flynn: SISD, SIMD (uma GPU), MISD, MIMD (multi-core)
- massivamente parallel: milhares de processadores, memória distribuída, passagem de mensagens, MIMD, usado por supercomputadores