O que este curso é e como usá-lo
Esta é a décima segunda unidade de University Medicine: epidemiologia, bioestatística e medicina baseada em evidências (MBE) — a caixa de ferramentas que transforma questões clínicas em números e números em decisões. Alinha-se ao material de estatísticas UNI-BUS-05 revisado, onde a matemática se sobrepõe.
Limite de escopo, declarado uma vez: curso de estudo, não diploma médico; cada conjunto de dados abaixo é sintético ou licenciado abertamente, cada resumo avaliado é fictício, e nada aqui licencia ou orienta tratamento.
- Unidades 12.1–12.3 medem e comparam: frequência de doenças, desenhos de estudo, viés e causalidade.
- Unidades 12.4–12.6 quantificam: testes diagnósticos, inferência, ensaios e revisões.
- Unidade 12.7 aplica: avaliação, certeza e o paciente diante de você.
O hábito da EBM: faça perguntas em PICO, meça riscos e razões, decida com intervalos e não rituais** — cada cálculo abaixo é sintético, verificado por máquina e algo que você recalcula.
Medindo doenças: incidência e prevalência
Por que importa. Antes de qualquer comparação, a doença deve ser contada — e os dois contadores clássicos respondem a perguntas diferentes: a rapidez com que novos casos aparecem, e quantos existem simultaneamente.
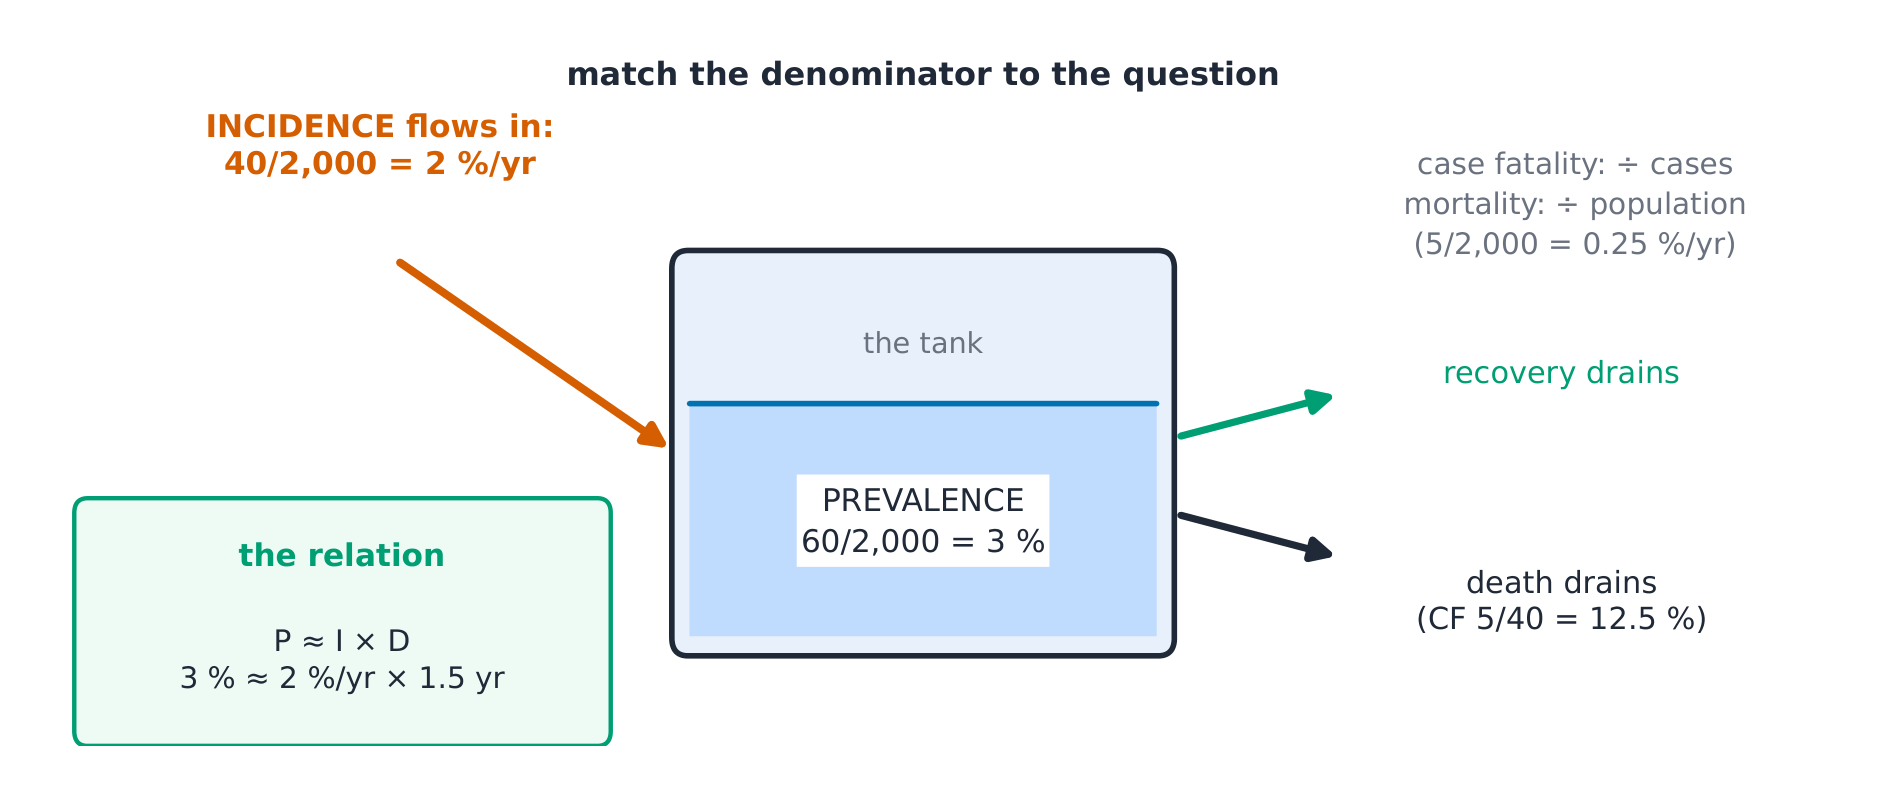
A ideia, com uma imagem. Incidência = novos casos ÷ pessoas em risco ÷ tempo; prevalência = casos existentes ÷ população em um instante ✓. Elas estão ligadas: prevalência ≈ incidência × duração — doenças longas se acumulam, breves desaparecem entre levantamentos.
A derivação (por que a padronização existe). Taxas brutas misturam dois efeitos: risco de doença e estrutura etária da população. Um distrito com mais residentes idosos pode mostrar uma taxa bruta maior com taxas específicas por idade MENORES ✓. A padronização direta aplica as taxas específicas por idade de cada grupo a uma população padrão e soma — o total artificial é comparável porque a composição etária agora é idêntica.
Exemplo resolvido 1 — uma cidade sintética. 2,000 habitantes, um ano, 40 novos casos de uma doença → incidência 40/2,000 = 2 % ao ano ✓. No dia do levantamento 60 pessoas com a doença → prevalência pontual 60/2,000 = 3 % ✓. Verifique o link: 3 % ≈ 2 %/ano × 1.5 anos de duração média — os números são consistentes sistema.
Worked example 2 — clinical link: mortality's three faces. (Fictional dataset) of the 40 new cases, 5 died within the year: case fatality 5/40 = 12.5 % ✓; the yearly deaths from this cause in the whole town were 5/2,000 = 0.25 % (cause-specific mortality rate); and if the town recorded 20 deaths from all causes that year, this disease caused 5/20 = 25 % of them (proportional mortalidade). Mesmos óbitos, três denominadores, três perguntas diferentes.
Erros comuns. Chamar prevalência de taxa (é uma proporção — sem unidade de tempo). Comparar taxas brutas entre populações com estruturas etárias diferentes (padronize primeiro). Ler a taxa de letalidade como mortalidade (o denominador são casos, não pessoas). denominador são casos, não pessoas).
Resumo. Incidência = novos/expostos/tempo; prevalência = existentes/população; P ≈ I × D; padronização ajusta a composição etária; taxa de letalidade (casos), mortalidade específica por causa (população), mortalidade proporcional (todos os óbitos) — corresponda o denominador à pergunta.
Desenhos de estudo
Por que importa. Cada questão clínica tem desenhos que respondem bem e desenhos que não podem — escolher o desenho é escolher quais vieses você lutarão.
A ideia, com uma imagem. A escada: ensaio aleatorizado (experimento) → coorte (seguem expostos e não expostos para frente) → caso-controle (olham para trás do desfecho) → transversal (uma única foto) → ecológico (grupos, não indivíduos) ✓.
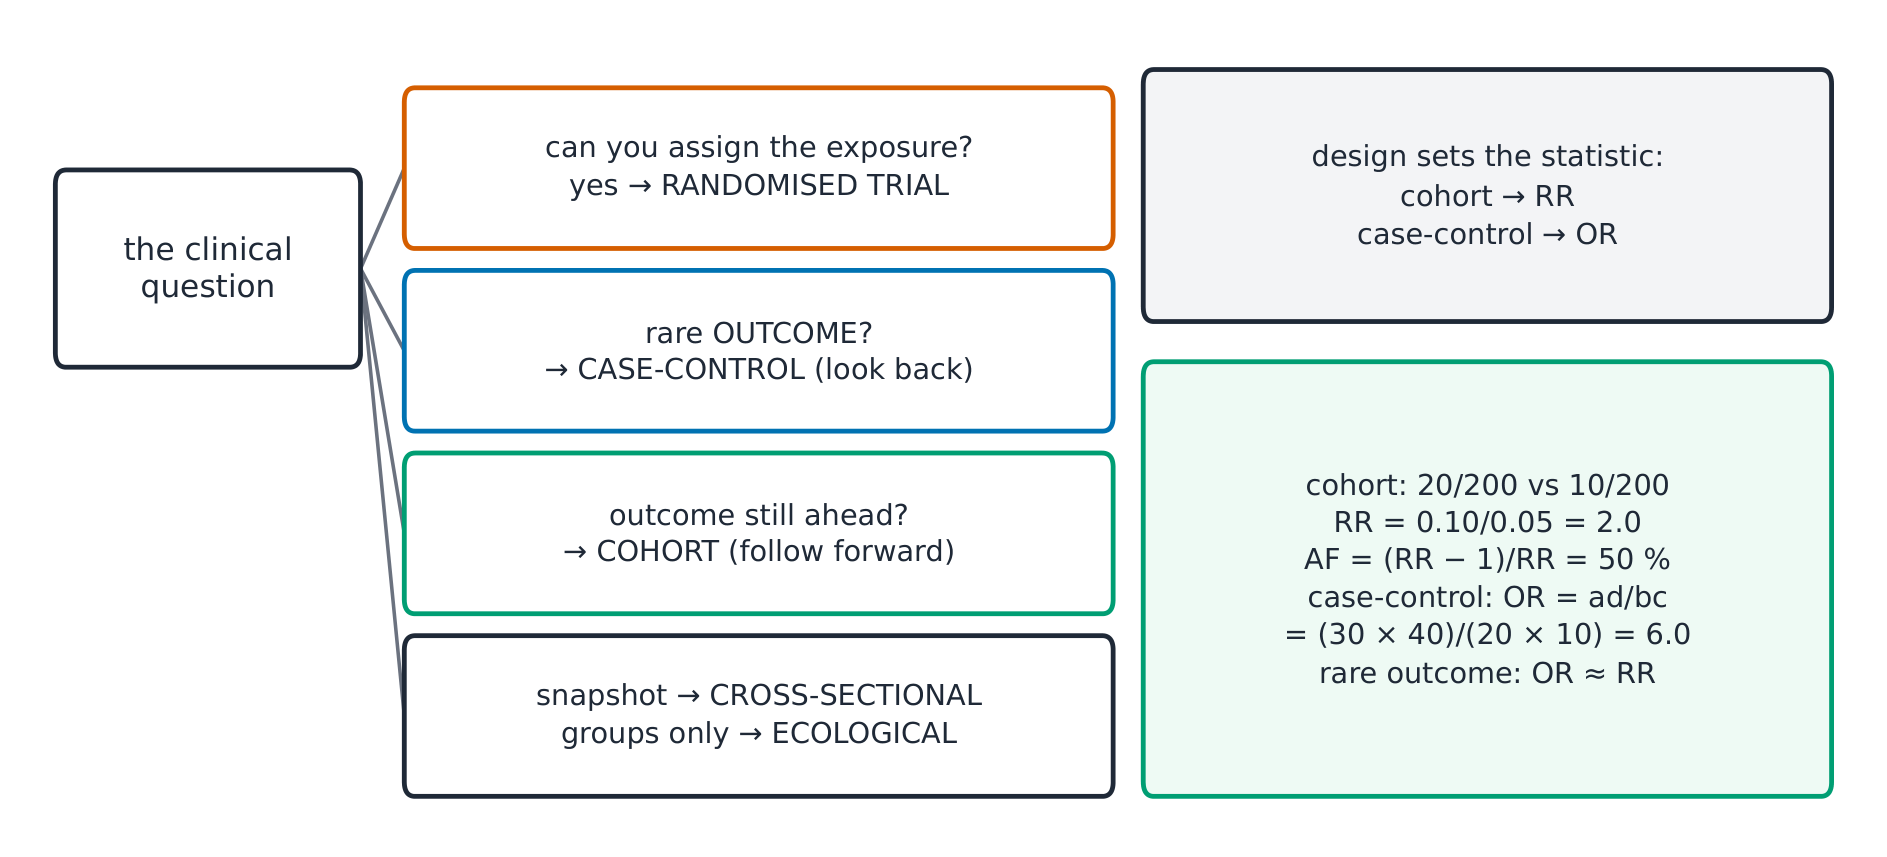
A derivação (por que RR pertence às coortes e OR aos casos-controles). Uma amostras de coorte por EXPOSIÇÃO, assim riscos em cada braço são estimáveis: relativa risco** $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. Uma amostra caso-controle por DESENFRETO, então o "risco" em cada braço é um artefato da proporção de amostragem — apenas a razão de chances $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ é válido ✓. O delineamento determina a estatística, não a preferência.
Worked example 1 — one synthetic cohort. Exposed 200, 20 events; não exposto 200, 10 eventos: riscos 0.10 vs 0.05 → $RR = 2.0$ ✓, atribuível Exemplo resolvido $(RR-1)/RR = 50\ \%$ — vínculo clínico: o espelho caso-controle. (Fictício) são metade "devido à" exposição sob as suposições.
Exemplo resolvido 2 — vínculo clínico: o espelho caso-controle. (Fictício) 30 de 40 casos expostos; 20 de 60 controles expostos: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. Um desfecho raro torna OR aproximado RR — um número, dois delineamentos, e a amostragem decide qual é legal.
Erros comuns. Calcular RR de um estudo caso-controle (os denominadores são escolhidas pelo pesquisador, não encontradas). Interpretar odds transversais como causalidade (exposição e desfecho são simultâneos). Igualar "prospectivo" a "melhor" (uma coorte prospectiva ainda confunde; apenas a randomização equilibra as incertezas). Resumo. Ensaio → coorte (RR) → caso-controle (OR) → transversal →
Resumo. Ensaio → coorte (RR) → caso-controle (OR) → transversal → ecológico; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; coortes amostram por exposição, caso-controle por desfeito; doença rara OR ≈ RR; fração atribuível $(RR-1)/RR$.
Vieses, confusão e causalidade
de uma terceira variável (confundimento) e por associação sem causa. Identificar o modo de falha é metade da avaliação crítica. A ideia, com um exemplo visual. Vício é erro sistemático no desenho ou
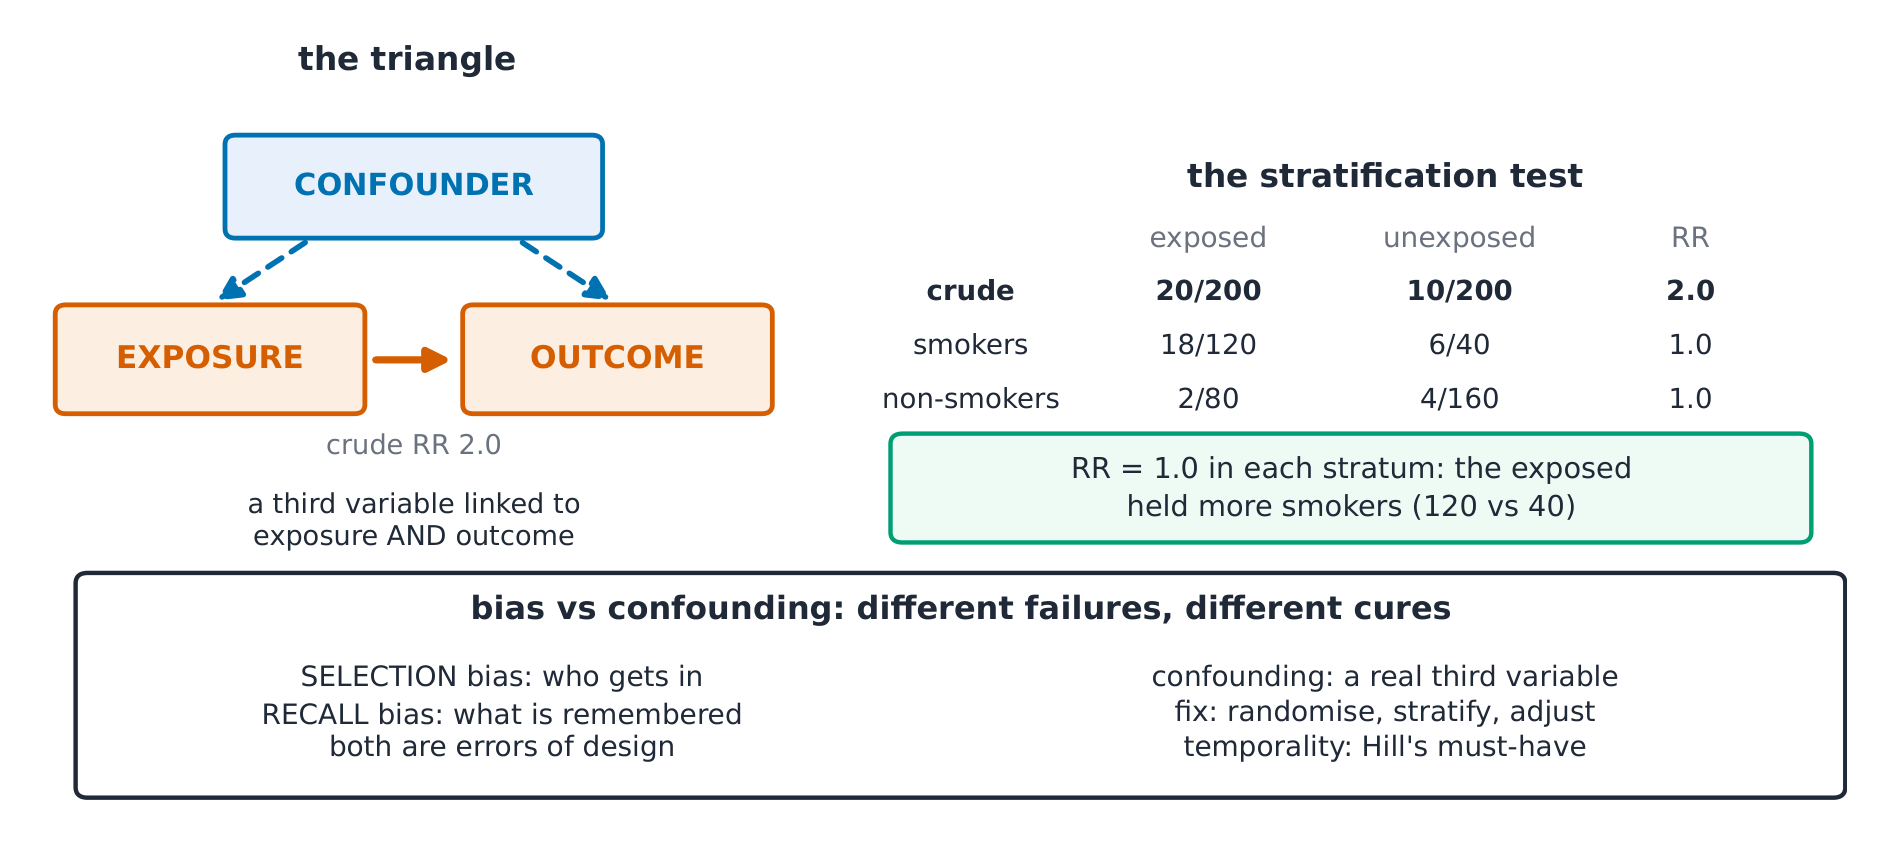
na medição: vício de seleção (quem entra), vício de informação/memória (o que é lembrado ou registrado). Confundimento é uma terceira variável ligada à exposição e ao desfecho que simula ser a causa ✓. O confundidor está no caminho indireto — estratifique e a associação espúria desaparece
 A derivação (por que a estratificação é a prova). Se uma terceira variável é
o verdadeiro motor, a associação deve desaparecer dentro das estratas em que ela é o verdadeiro motor, a associação deve desaparecer dentro dos estratos onde ela é constante: bruto $RR$ 2.0, mas entre não fumadores $RR$ 1.0 e entre fumadores $RR$ 1.0 → tabagismo foi o confundidor ✓. Se a associação persiste dentro das estratos (digamos 2.0 e 1.9), a exposição mantém seu próprio sinal. A randomização evita o confounding prospectivamente ao equilibrar até mesmo as incógnitas ✓.
Exemplo resolvido 1 — a tabela estratificada. (Sintético) bruto: expostos 20/200 eventos vs não expostos 10/200 → RR 2.0. Estratifique por tabagismo: não fumadores 6/100 vs 3/100 (RR 2.0 ✓ dentro), fumadores 14/100 vs 7/100 (RR 2.0) — a associação sobrevive à estratificação: tabagismo NÃO foi o confundidor aqui; o sinal da exposição se destaca. Agora aplique a mesma tabela bruta uma divisão diferente — expostos: 120 fumadores (18 eventos) e 80 não fumadores (2 eventos); não expostos: 40 fumadores (6 eventos) e 160 não fumadores (4 eventos). O risco dos fumadores é de 15 % em ambos os braços e dos não fumadores de 2.5 % em ambos, então o RR é de 1.0 dentro de cada estrato: o grupo exposto simplesmente continha mais fumadores, e tabagismo FOI o confundidor ✓. Uma única tabela bruta, dois vereditos — apenas os estratos podem distingui-los.
Exemplo resolvido 2 — vínculo clínico: as questões de avaliação. (Fictício resumo) "bebedores de café tinham o dobro do risco": pergunte quem foi estudado (seleção), como a exposição foi medida (memória — pacientes com doença lembram-se de forma diferente), e como um confundidor deveria se apresentar (associado ao café E ao desfecho, como tabagismo). Visões de Bradford Hill — temporalidade primeiro, depois força, consistência, relação dose-resposta, pontos de vista — temporalidade primeiro, depois força, consistência, relação dose-resposta, plausibilidade — transforme um título em uma lista de verificação ✓.
Erros comuns. Tratar confusão e viés de medição como um único problema (a confusão é a mistura de efeitos por uma terceira variável, corrigida por randomização, estratificação ou ajuste; seleção e informação viés são erros em quem é estudado e como as coisas são medidas, que nenhuma análise corrige completamente). Esperar que big data cure a confusão (mais precisão ao redor de uma estimativa enviesada). Exigir todos os pontos de Hill (são perspectivas, não um placar; temporalidade é o único não negociável).
Resumo. Viés = erro sistemático (seleção, informação/memória); confundidor = terceira variável em ambos os caminhos; o teste de estratificação anula a associação se houver confusão; a randomização equilibra o desconhecido; pontos de Hill com temporalidade primeiro. pontos de vista com temporalidade primeiro.
Testes diagnósticos
sensibilidade e especificidade pertencem ao teste, mas valores preditivos pertencem à população que o utiliza. Interpretar mal isso é o erro quantitativo mais comum no raciocínio clínico. erro no raciocínio clínico.
A ideia, com uma imagem. A 2×2: sensibilidade = a/(a+c) (doente, teste positivo); especificidade = d/(b+d) (saudável, teste negativo); PPV = a/(a+b), NPV = d/(c+d) — e a frequência natural árvore mostra por que a prevalência altera os valores preditivos ✓.

A dedução (por que a prevalência impulsiona o VPP). VPP = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. Com Se = Sp = 90 %: na prevalência 10 %, VPP = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — mesmo um excelente teste é como jogar moeda em uma clínica com baixa prevalência. O ramo de falso-positivo escala com a maioria saudável.
Exemplo resolvido 1 — a árvore de frequência natural (sintética). 1,000 pessoas, prevalência de 10 %: 100 doentes → 90 verdadeiros positivos, 10 falsos negativos; 900 saudáveis → 810 verdadeiros negativos, 90 falsos positivos ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. Mesmo teste na prevalência de 1 %: 9 VP vs 99 FP → PPV 9/108 = 8.3 % ✓ — uma árvore, dois cenários.
Exemplo resolvido 2 — vínculo clínico: a razão de verossimilhança viaja. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: um resultado positivo multiplica as odds pré-teste em 9 vezes, independentemente da prevalência da clínica. Odds pré-teste 1:9 (10 %) → pós-teste 9:9 = 1:1 → probabilidade de 50 % — o mesmo PPV, derivado em uma linha. Razões de verossimilhança (RVs) são a forma portátil do teste; os valores preditivos são locais.
Erros comuns. Citar sensibilidade como "o teste está certo em 90 %" (ele está certo em relação a 90 % dos DOENTES — diga sobre quais). Aplicar um PPV de livro-texto a uma clínica com prevalência diferente. Confundir as duas colunas (sensibilidade lê-se verticalmente na coluna dos doentes; especificidade verticalmente na coluna dos saudáveis).
Resumo. Se = a/(a+c), Sp = d/(b+d) — testar propriedades; PPV/NPV — propriedades populacionais, variam com a prevalência; árvores de frequência natural tornam isso visível; $LR+ = Se/(1-Sp)$ multiplica odds portavelmente (0.9/0.1 = 9); 50 % PPV em 10 % de prevalência apesar de Se = Sp = 90 %.
Inferência estatística para dados clínicos
Por que importa. A inferência é como uma amostra fala sobre uma população — e a leitura incorreta de valores-p e intervalos de confiança são os erros marcantes da literatura moderna.
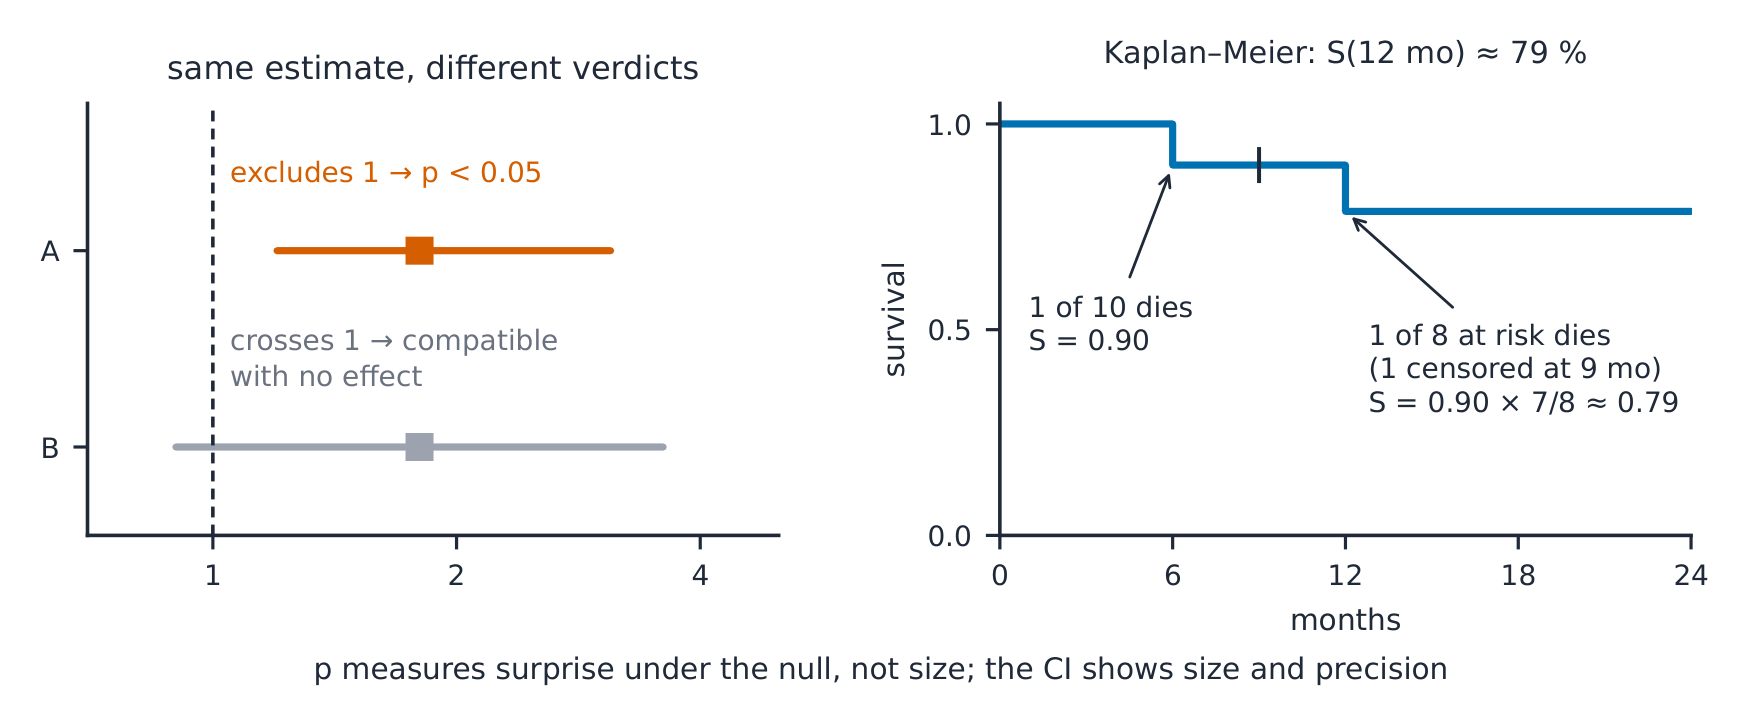
A ideia, com uma imagem. Um intervalo de confiança de 95 % é o intervalo de valores verdadeiros compatíveis com os dados naquele nível; um valor-p P é a probabilidade de obter dados pelo menos tão extremos SE a hipótese nula for verdadeira ✓. O IC resume magnitude e precisão; o valor-p apenas resume a surpresa.
A derivação (por que o teste segue o tipo de dado). Contagens por grupo → χ²; duas médias (normal-ish) → teste-t (pareado quando cada linha é medida duas vezes); várias médias → ANOVA; assimétrico/pouca amostra → ranks (alternativas não paramétricas) alternativas; duas medidas contínuas → correlação (Pearson, ou Spearman para ranks) ✓. A escala de medição decide o teste — decidir depois de olhar os resultados convida à pergunta errada.
Exemplo resolvido 1 — leitura de um intervalo. (Abstracto fictício) RR 1.8, IC 95 % CI 1.2–3.1: o intervalo exclui 1, logo os dados são incompatíveis com "sem efeito" neste nível (p < 0.05 segue); a amplitude indica que a estimativa é imprecisa, mas consistentemente superior a 1 ✓. Um RR 1.8 com IC 0.9–3.6 sugere o oposto — mesma estimativa pontual, veredito diferente, e apenas o intervalo informa sobre isso.
Exemplo resolvido 2 — vínculo clínico: a aritmética de Kaplan–Meier. (Sintético) 10 pacientes inscritos; aos 6 meses, 1 evento entre 10 em risco: $S = 9/10 = 0.90$; aos 12 meses, 1 evento entre os 8 ainda em risco (um censurado): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. A mediana de sobrevivência é o tempo em que a curva cruza 50 %; o censoramento retira pessoas do denominador, não da lógica da estimativa.
Erros comuns. "p > 0.05 significa ausência de diferença" (significa que os dados são compatíveis com nenhuma diferença — ausência de evidência ≠ evidência de ausência). Interpretar o IC como uma probabilidade de 95 % de que a verdade esteja dentro dele (o intervalo é uma propriedade do procedimento, aplicada à estimativa desta amostra). Escolher o teste após observar qual resulta em p < 0.05.
Resumo. CI = verdades compatíveis, carrega magnitude e precisão; p-valor = P(dados tão extremos | nula); nunca "comprovado" ou "sem efeito" baseado apenas no p; χ²/t/ANOVA/posto/correlação escolhidos pelo tipo de dado; a curva de Kaplan–Meier multiplica (1 − eventos/risco); mediana = 50 % de cruzamento.
Ensaios clínicos e revisões sistemáticas
Por que importa. Ensaios são a máquina da prova e revisões são seu conjunto — o vocabulário (aleatorização, cegamento, ITT, NNT) é o que todo resumo e todo gráfico em floresta pressupõe que você conhece.
A ideia, com uma imagem. Eixo espinhal do ensaio: elegibilidade → aleatorização (atribuição por acaso, alocação oculta) → cegamento (participante, clínico, avaliador do desfecho) → análise por intenção de tratar (analisar conforme randomizado, todos contados) ✓. Revisões agrupam em um gráfico em floresta: quadrados (tamanho = peso), linhas (IC), losango (agrupado) e heterogeneidade $I^2$ ✓.
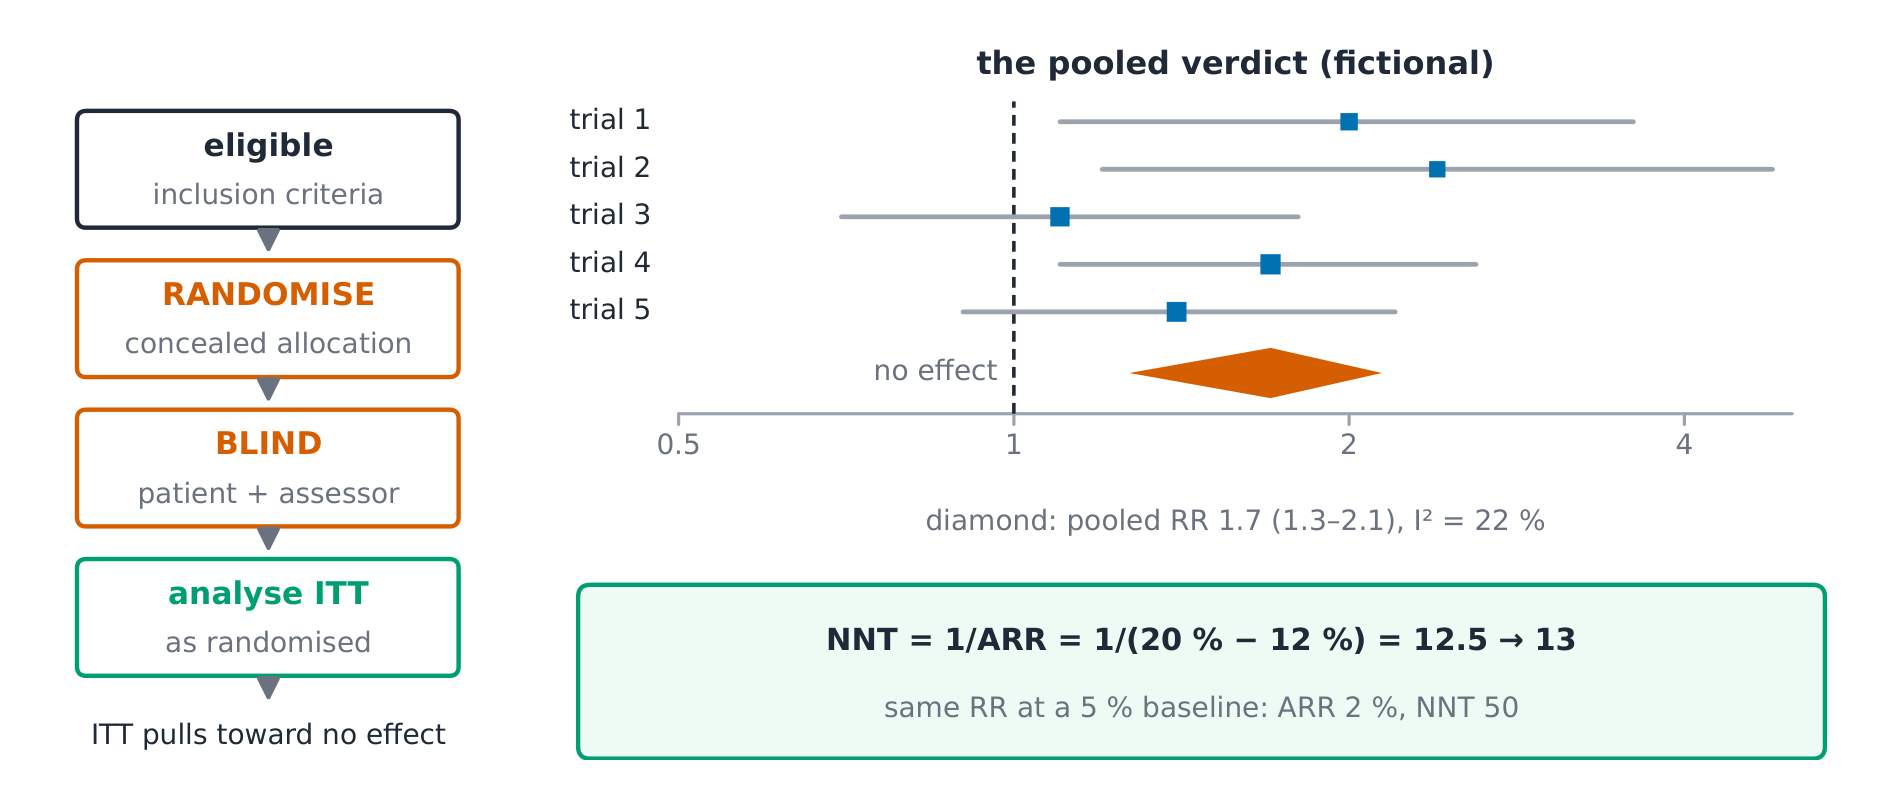
A derivação (por que NNT é o tamanho clínico do efeito). NNT = $1/ARR$: taxa de evento no controle 20 %, tratado 12 % → RRA 8 % → NNT = 1/0.08 = 12.5 → 13 pessoas tratadas para uma beneficiada ✓. NNT converte uma razão abstrata em carga de trabalho — e seu denominador (RRA) diminui à medida que o risco base cai, motivo pelo qual resultados de ensaios não se transferem para clínicas de menor risco sem ajustes.
Exemplo resolvido 1 — a lógica do TIT. (Ensaio fictício) 20 % controle vs 12 % tratado: RRA 8 %, NNT 13 ✓. Se 30 % do grupo tratado interromperam sua atribuição precocemente, a ITT ainda os conta como tratados — diluindo a aparente efeito em direção ao nulo — porque a questão é a POLÍTICA de alocação, não a biologia do aderente ✓. A análise por protocolo responde a uma questão diferente e herda o viés de adesão.
Exemplo resolvido 2 — vínculo clínico: leitura do losango. (Floresta fictícia) cinco ensaios, RRs individuais 1.1–2.4 com ICs amplos, RR pooled 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: o losango fica à direita de 1 e seu intervalo exclui 1, com baixa heterogeneidade — um efeito consistente entre cenários. O mesmo losango com $I^2 = 78\ \%$ geraria "por que esses ensaios discordam?" antes de qualquer pooling ser confiado.
Erros comuns. Igualar aleatorização a cegamento (a chance equilibra grupos; o cegamento equilibra expectativas — um ensaio pode ter apenas um). Ler a análise por protocolo como honesta (ela viola a proteção da aleatorização). Tratar o losango pooled como verdade absoluta apesar da alta heterogeneidade.
Resumo. Aleatorizar (oculto) → cegar → analisar conforme aleatorizado (ITT, dilui para o nulo); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); floresta: quadrados ponderados, losango pooled, discordância de $I^2$; clínicas de base baixa reduzem ARR e inflacionam NNT.
Avaliação crítica e aplicação da evidência
Por que importa. A evidência torna-se medicina apenas na cabeceira: avaliada para validade, adequadas à importância e compatíveis com o paciente em questão você. Esta unidade é a síntese do curso.
A ideia, com uma imagem. A espinha dorsal da avaliação: PICO (população, intervenção, comparação, desfecho) framing → validade (os resultados foram enviesados?) → tamanho (quão grande, quão preciso?) → aplicabilidade (meu paciente semelha à população estudada?) ✓. Classificação de certeza (GRADE): evidências randomizadas começam altas e as observacionais baixas; reduzir para risco de viés, inconsistência, indireção, imprecisão ou viés de publicação; aumentar para efeitos grandes ou gradiente dose-resposta ✓.

A derivação (por que a hierarquia é um pré-requisito, não um veredito). Desenhos diferem no controle TÍPICO de viés: a randomização equilibra confusores medidos e não medidos; coortes trazem confusão; caso-controle adiciona viés de memória ✓. Mas a hierarquia classifica a classe de desenho, enquanto o veredito pertence ao estudo em questão — um ensaio pequeno, sem cegamento, analisado por protocolo pode merecer menos confiança que uma grande coorte pré-registrada com ajuste de propensão. O GRADE existe justamente porque a classe de desenho é apenas o ponto de partida.
Exemplo resolvido 1 — um abstract fictício em cinco perguntas. (Fictício) "Randomizado, duplo-cego, n = 400; RR 0.75 (0.60–0.94)": validade — aleatorizado e duplo-cego ✓; magnitude — 25 % de redução relativa, intervalo exclui 1; aplicabilidade local — pacientes como os meus foram incluídos (idade, gravidade, medicamentos concomitantes)?; desfechos — relevantes para o paciente ou substitutos?; certeza — qualquer característica de desvalorização? Cinco perguntas, um veredito estruturado ✓.
Exemplo resolvido 2 — vínculo clínico: transferindo a NNT. (Fictício) um ensaio em doença grave (baseline 20 %, ARR 8 %, NNT 13); meu paciente tem clínica com baseline de 5 %: com a mesma redução de risco relativo, o ARR escala para $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. O efeito relativo pode ser transferido; o benefício absoluto — a carga de trabalho e a aritmética dano-benefício — é local.
Erros comuns. Avaliar apenas validade (efeito válido mas pequeno ainda é inútil: magnitude e precisão determinam relevância). Classificar por revista ou rótulo de desenho isoladamente (GRADE inicia aí e avança com as falhas da evidência do estudo). Aplicar médias grupais ao paciente cuja característica definidora era um critério de exclusão.
Resumo. PICO → validade → magnitude → aplicabilidade; GRADE: iniciar do desenho, desvalorizar por viés/inconsistência/indireção/imprecisão, valorizar por efeitos grandes; a pirâmide é uma premissa, não um veredito; efeitos relativos são transferíveis, benefícios absolutos (ARR, NNT) são locais — recalcule antes de aplicar.