| English | 의미 |
|---|---|
| stem-and-leaf/stem ænd liːf/ | 줄기잎도 |
| box-and-whisker/bɒks ænd ˈwɪskə/ | 상자수염그래프 |
| quartile/ˈkwɔːtaɪl/ | 사분위수 |
| histogram/ˈhɪstəɡræm/ | 히스토그램 |
| cumulative frequency/ˈkjuːmjʊlətɪv ˈfriːkwənsi/ | 누적빈도 |
| median/ˈmiːdiːən/ | 중位数 |
| interquartile range/ˌɪntəˈkwɔːtaɪl reɪndʒ/ | 사분위범위 |
| frequency density/ˈfriːkwənsi ˈdensɪti/ | 빈도밀도 |
| mean/miːn/ | 평균 |
| mode/məʊd/ | 최다값 |
| standard deviation/ˈstændəd ˌdiːvɪˈeɪʃn/ | 표준편차 |
| variance/ˈveərɪəns/ | 분산 |
| outlier/ˈaʊtlaɪə/ | 이단치 |
역사를 바꾼 그림
- 1854년 존 스노우는 런던의 콜레라 사망자 지도를 그려 한 물펌프 주변에 집단 발생 패턴을 발견했습니다. 그 그림은 생명을 구했습니다.
- 적절한 통계 도표 선택은 기술입니다. 원시 숫자 속에 숨겨진 패턴을 드러냅니다.
통계 도표
- 데이터 특성에 맞는 도표를 선택하세요:
- stem-and-leaf (값 유지, 형태 표시),
- box-and-whisker (최소값, 3개 사분위, 최대값),
- 히스토그램 (그룹화 데이터 — 막대 면적 = 빈도)
- 누적 빈도 (순차 합계 → 중앙값 및 사분위수).

누적 빈도 곡선: 전체의 절반에서 중앙값을, 사분의 일과 사분의 삼 지점에서 사분위를 읽으십시오
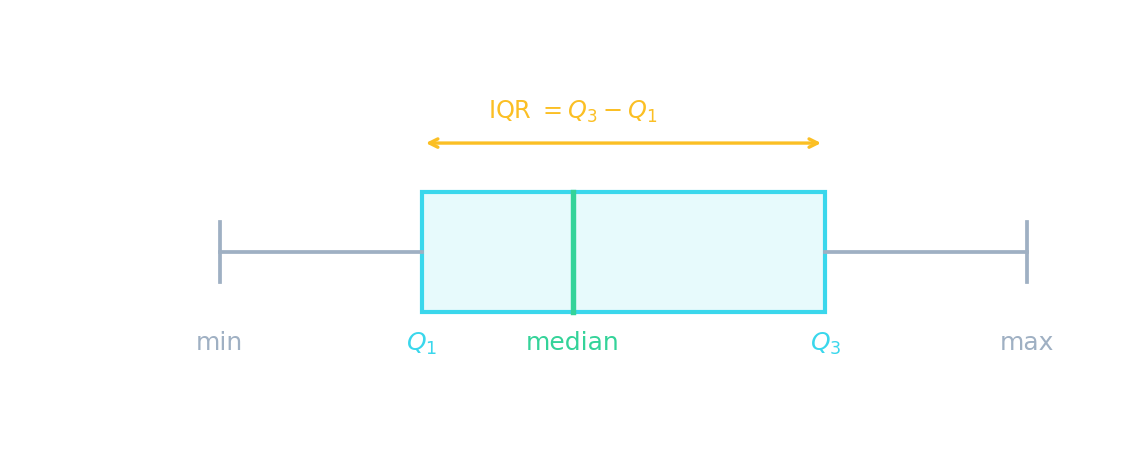
상자 수염 그림은 오개요를 보여줍니다; 상자는 사분위범위를 나타내며, IQR = Q₁ − Q₃입니다.
$= \dfrac{\text{frequency}}{\text{class width}}$
히스토그램 면적 = 빈도, 높이가 아닙니다. 계급 폭이 불균일할 때 세로축에는 빈도가 아닌 빈도 밀도를 표시합니다. 높고 좁은 막대보다 짧고 넓은 막대가 더 많은 데이터 포인트를 나타낼 수 있습니다.
Spread and the bell
P(−k < Z < k)
Spread is measured in standard deviations — about 68% of data lies within 1 sd, 95% within 2.
In a histogram of grouped data, the frequency is shown by each bar's:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
In a histogram, the area of each bar represents the frequency.
In a histogram with unequal class widths, the height of each bar equals the frequency.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
With unequal widths, the height shows frequency density (frequency/width), not frequency. The area represents frequency.
Match each statistical diagram to what it best shows.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
A box plot shows quartiles and spread; a histogram uses bar area for frequency; cumulative frequency gives the median/quartiles; stem-and-leaf keeps the data values.
평균 및 산포도
- 중심 경향성: 평균 $\bar{x} = \dfrac{\sum x}{n}$, 중앙값 (가운데 값), 최빈값 (가장 자주 나타나는 값).
- 산포도: 범위, 사분위범위, 그리고 표준편차 $\sigma = \sqrt{\dfrac{\sum x^2}{n} - \bar{x}^2}$.
- 분산 = $\sigma^2$.

벤 다이어그램: 겹치는 부분이 두 사건의 교집합입니다
For 10 values with Σx = 50, what is the mean?
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
Mean = Σx / n = 50 / 10 = 5.
For 10 values, Σx = 50 and Σx² = 300. What is the standard deviation? (√(Σx²/n − x̄²))
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
σ = √(300/10 − 5²) = √(30 − 25) = √5 ≈ 2.24.
For the data 2, 4, 4, 4, 5, 5, 7, 9, what is the median?
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
With 8 values, the median is the average of the 4th and 5th: (4 + 5)/2 = 4.5.
If the standard deviation is 3, what is the variance?
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
Variance = σ² = 3² = 9.
worked example — 표준편차
- 데이터: 2, 4, 4, 4, 5, 5, 7, 9. $n = 8$, $\sum x = 40$, $\sum x^2 = 232$.
- 평균 $\bar{x} = \dfrac{40}{8} = 5$.
- 분산 $= \dfrac{232}{8} - 5^2 = 29 - 25 = 4$.
- 표준편차 $\sigma = \sqrt{4} = 2$.
적절한 평균 선택
- 평균: 모든 데이터를 사용하지만, 이상치에 영향을 받음.
- 중위수: 이상치의 영향을 받지 않아 치우친 데이터(예: 소득)에 적합함.
- 최빈값: 범주형 데이터에 유용함(가장 인기 있는 색상, 가장 흔한 신발 사이즈).
- 줄기-잎 그래프, 상자수염그래프, 누적 빈도 그래프를 사용하여 데이터를 표시하고 변동성(분포)을 측정하십시오.
이해했습니다
- 그래프: 줄기-잎, 상자그래프, 히스토그램(면적 = 빈도), 누적 빈도
- 평균: 평균, 중위수, 최빈값; 분포: 범위, IQR, 표준편차
- $\sigma = \sqrt{\dfrac{\sum x^2}{n} - \bar{x}^2}$, 그리고 분산 $= \sigma^2$