| English | 의미 |
|---|---|
| SQL/ˌes kjuː ˈel/ | SQL |
| Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ | 데이터 정의 언어 |
| Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ | 데이터 조작 언어 |
| INNER JOIN/ˈɪnə dʒɔɪn/ | 내부 결합 |
| aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ | 집계 함수 |
조부모 세대의 프로그래머들도 사용했던 언어
- 1974년 IBM 연구원 두 명은 Codd의 테이블을 위한 쿼리 언어를 설계하여 SEQUEL(Structured English Query Language)이라고 명명했습니다. 이름은 SQL로 줄여졌으며, 이 언어는 지금까지 사라지지 않고继续使用하고 있습니다.
- 50년이 지난 지금, 당신이 이용하는 모든 은행, 항공사, 병원, 웹사이트는 이 언어 위에서 작동합니다. 오늘
SELECT을 타이핑하는 학생은 자신의 부모가 태어나기 전에 프로그래머가 썼던 동일한 문장을 쓰고 있습니다. - 이 언어는 두 부분으로 나뉘며, 시험에서는 either를 읽거나 both를 쓰는 능력을 묻습니다: 구조를 구축하는 Data Definition Language(DDL) 와 데이터를 채우며 변경하고 질문하는 Data Manipulation Language(DML) 입니다.
- 이 수업은 시 syllabus에 포함된 SQL의 하위 집합이며, 문장별로 정리되어 각 문장이 차지하는 점수도 명시되어 있습니다.
DDL과 DML
- DBMS는 DDL을 통해 데이터베이스의 구조에 대한 모든 생성 및 수정 작업을 수행합니다: 데이터베이스 생성, 테이블 생성 및 수정, 키 추가 등.
- DML을 통해 데이터에 대한 모든 쿼리 및 유지보수 작업을 수행합니다: 행 선택, 삽입, 업데이트, 삭제 등.
- SQL은 이 둘 모두에 대한 산업 표준입니다. 문장을 올바른 category로 분류하는 것은 흔한 1점 문제입니다:
CREATE TABLE은 DDL이며,SELECT은 DML입니다.
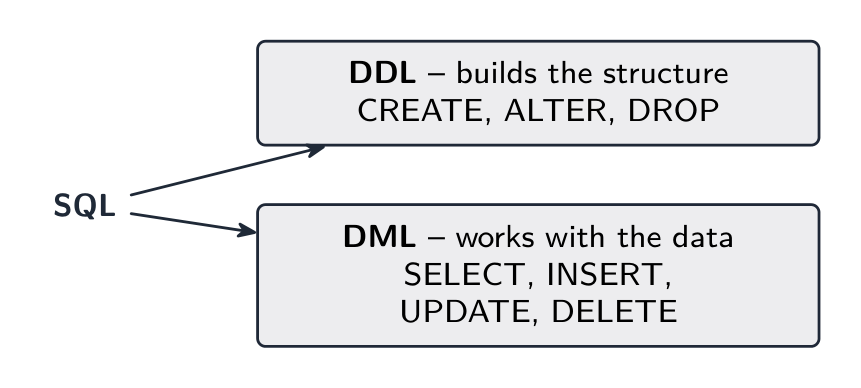
한쪽에는 구조, 다른 쪽에는 데이터
다음 중 Data Definition Language (DDL)의 일부는 무엇인가?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
DDL은 구조를 변경합니다 (CREATE, ALTER, DROP). SELECT/INSERT/UPDATE/DELETE는 DML(데이터 조작)입니다.
DDL은 구조를 정의(예: CREATE TABLE)하고, DML은 내부의 데이터를 조작(SELECT, INSERT, UPDATE, DELETE)합니다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
정의 vs 조작: DDL이 테이블 형태를 만들고, DML이 행을 읽거나 변경합니다.
DDL: 구조 만들기
CREATE DATABASE Shop;

CREATE TABLE CUSTOMER (
  CustomerID INTEGER,
  Name VARCHAR(50),
  Town VARCHAR(30),
  Joined DATE,
  Active BOOLEAN,
  PRIMARY KEY (CustomerID)
);

ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
- syllabus에 있는 데이터 타입:
CHARACTER(고정 길이 문자열),VARCHAR(n)(최대 n개의 문자),BOOLEAN,INTEGER,REAL,DATE,TIME. PRIMARY KEY (field)은 키를 정의합니다;ALTER TABLE … ADD은 기존 테이블에 속성을 추가합니다.
각 데이터 항목에 맞는 SQL 데이터 타입을 매칭하시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
두 가지 상태, 가변 길이 텍스트, 소수점 숫자, 달력 날짜입니다. INTEGER는 정수 카운트에, TIME은 시간대에 사용됩니다.
worked example: 외래 키가 있는 두 개의 테이블
ORDERS테이블을 생성하는 SQL을 작성하시오.此处OrderID을 primary key로,CustomerID를CUSTOMER에 대한 foreign key로, 그리고OrderDate를 추가하시오.
CREATE TABLE ORDERS (
  OrderID INTEGER,
  CustomerID INTEGER,
  OrderDate DATE,
  PRIMARY KEY (OrderID),
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
- 배점 요소: 이름이 포함된
CREATE TABLE; 적절한 타입을 가진 각 속성;PRIMARY KEY; 테이블 및 필드를 지칭하는FOREIGN KEY … REFERENCES.
DML: SELECT로 질문하기
SELECT Name, Town
FROM CUSTOMER
WHERE Town = 'London'
ORDER BY Name ASC;
SELECT은 출력할 필드를 나열하며(전체 필드는*),FROM은 테이블명을指定,WHERE은 조건에 부합하는 행만 남기고,ORDER BY은 결과를 정렬하며,ASC또는DESC를 사용합니다.- 문자열은 단일 따옴표로 감싸야 합니다; 숫자는 그렇지 않습니다. 비교 연산자:
=,<,>,<=,>=,<>; 조건은AND,OR,NOT로 연결됩니다;LIKE 'A%'는 A로 시작하는 텍스트와 일치하며;BETWEEN 10 AND 20은 범위를 제공합니다.

WHERE 구문을 통과한 행만 결과집합에 도달합니다
테이블에서 데이터를 가져오는 SQL 키워드는 무엇인가? (단어 하나)
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
SELECT는 가져올 필드를 나열하고; FROM는 테이블 이름을 명시합니다.
SELECT 문장의 WHERE 절은:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
WHERE는 조건에 따라 행을 필터링하고; ORDER BY는 정렬하며; SELECT 목록은 열을 선택합니다.
worked example: 쿼리 작성
- 맨체스터에 거주하는 모든 active 고객의 이름과 이메일 주소를 출력하는 SQL 스크립트를 쓰되, 이름 순서(알파벳순)로 정렬하시오.
SELECT Name, Email
FROM CUSTOMER
WHERE Town = 'Manchester' AND Active = TRUE
ORDER BY Name;
- 각 항목 1점:
SELECT后面的正确字段;FROM后面的正确表名;WHERE양쪽 조건과 단일 따옴표 안의 문자열 포함;ORDER BY Name. 문제에서 제시한 정확한 테이블명 및 필드명을 사용하십시오.
SELECT文의 절들을 작성한 순서대로 배치하십시오.
난이도 3/5 · 200 코인 + 오늘 첫 완료 시 소액 보너스
필드, 테이블, 필터, 정렬. ORDER BY는 항상 마지막에 오며, 문장은 세미콜론(;)으로 끝납니다.
두 개의 테이블: INNER JOIN
SELECT CUSTOMER.Name, ORDERS.OrderDate
FROM CUSTOMER INNER JOIN ORDERS
  ON CUSTOMER.CustomerID = ORDERS.CustomerID
WHERE ORDERS.OrderDate >= '2024-01-01';
- INNER JOIN은 한 테이블의 외래 키가 다른 테이블의 primary key와 일치할 때 두 테이블의 행을 결합하며, 이는
ONclause에서 명시됩니다. - 두 테이블에서 동일한 이름이 나타날 경우 필드 앞에 테이블명을 붙입니다. 시yllabus는 최대 두 테이블에 대한 쿼리를 요구합니다.
INNER JOIN으로 두 테이블을 연결(stitch)
외래 키가 primary key와 일치하는 행을 매칭합니다 — 여기서는 Orders.CustomerID = Customer.CustomerID — 각 매칭 쌍을 하나의 더 넓은 행으로 결합합니다.
INNER JOIN은 다음에 사용됩니다:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
JOIN은 관계(보통 외래키가 주외래키와 일치)에 기반하여 두 테이블을 결합합니다.
집계 함수 및 GROUP BY
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDERS
GROUP BY CustomerID;

SELECT AVG(Price) FROM PRODUCT;
SELECT SUM(Quantity) FROM ORDER_LINE WHERE OrderID = 1042;
- 집계 함수는 여러 행을 하나의 값으로 요약합니다:
COUNT行数,SUM합계,AVG평균. GROUP BY는 필드의 값마다 한 줄의 요약 행을 생성합니다: 고객 별 주문 수. 이것이 없으면 집계가 전체 표에 대해 수행됩니다.
COUNT(*)이 반환하는 것은 무엇입니까?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
COUNT(*)는 행을 세고; SUM/AVG/MIN/MAX은 다른 집계 함수입니다.
각 고객이 주문한 건수를 출력하려면 다음 중 적용되는 것을 모두 선택하십시오: 선택 모든 해당 항목.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
주문 테이블에서 고객마다 한 그룹씩 행을 세십시오. 정렬은 선택 사항입니다.
데이터 변경: INSERT, UPDATE, DELETE
INSERT INTO CUSTOMER (CustomerID, Name, Town, Joined, Active)
VALUES (101, 'Ada Lovelace', 'London', '2024-03-01', TRUE);

UPDATE CUSTOMER SET Town = 'Bristol' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
INSERT INTO … VALUES는 행을 추가합니다: 필드를 나열한 후 같은 순서로 값을 나열합니다.UPDATE … SET … WHERE는 일치하는 행을 변경합니다.DELETE FROM … WHERE는 제거합니다.- 항상
UPDATE와DELETE에WHERE구문을 제공해야 합니다. 그렇지 않으면 변화가 표의 모든 행에 적용됩니다.
WHERE절 없이 UPDATE 또는 DELETE를 실행하면 어떻게 됩니까?
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
WHERE가 없으면 연산이 모든 행에 영향을 미치므로 — 이는 흔하고 위험한 실수입니다.
각 DML 문장을 그것이 수행하는 작업과 매칭하십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
SELECT는 읽기; INSERT는 추가; UPDATE는 변경; DELETE는 제거 — 네 가지 핵심 DML 동사입니다.
worked example: 문장 읽기
SELECT Name
FROM CUSTOMER INNER JOIN ORDERS
  ON CUSTOMER.CustomerID = ORDERS.CustomerID
WHERE OrderDate = '2024-05-01'
ORDER BY Name DESC;
- 이 스크립트의 출력을 명시하십시오. 2024년 5월 1일에 주문을 한 모든 고객의 성명, 해당 주문마다 한 줄씩, 역알파벳 순서로.
- 실행 순서대로 읽으세요: 고객 ID로 테이블을 join하고 해당 날짜의 행을 유지하며, 이름을 출력하고 내림차순 정렬합니다. 그 날 두 건의 주문을 한 고객은 두 번 나타납니다.
놓칠 수 있는 점
- 단일 인용부호 안의 문자열, 표시 없는 숫자:
Town = 'London',CustomerID = 101. ORDER BY는WHERE뒤에 오며; join에는ON구문이 필요하며; 모든 문장은 세미콜론으로 끝납니다.COUNT(*)는 행을 카운트하며, 고유 값이 아닙니다; 그룹별 질문에는GROUP BY이 필요합니다.CREATE,ALTER및PRIMARY KEY는 DDL;SELECT,INSERT,UPDATE,DELETE는 DML입니다. 문제에서 제시한 정확한 명칭을 사용하십시오.
이해했습니다
- DDL은 구조를 생성하고 변경합니다:
CREATE DATABASE,CREATE TABLE와 타입이 지정된 속성,PRIMARY KEY,FOREIGN KEY … REFERENCES,ALTER TABLE … ADD· DML은 데이터를 조작합니다 - 유형:
CHARACTER,VARCHAR(n),BOOLEAN,INTEGER,REAL,DATE,TIME SELECT fields FROM table WHERE condition ORDER BY field; 두 개의 테이블에 대해INNER JOIN … ON; 한 행당 그룹별로COUNT,SUM,AVG및GROUP BY사용INSERT INTO … VALUES,UPDATE … SET … WHERE,DELETE FROM … WHERE: 업데이트나 삭제 시에는 반드시WHERE가 필요합니다