이 과정의 내용과 활용 방법
이는 University Medicine의 열두 번째 과정: 역학, 생물통계학 및 증거기반의학(EBM) — 임상 질문을 수치로 변환하고 수치를 결정으로 전환하는 도구입니다. 검토된 UNI-BUS-05 통계 자료와 일치하며, 가상입니다. 여기서 어떤 내용도 치료나 치료 지침을 허가하거나 안내하지 않습니다.
범위 제한, 한 번 명시: 연구 과정이지 의과 학위는 아닙니다. 아래 모든 사례는 가상이며, 여기에는 치료 허가나 가이드가 없습니다. 아래 데이터셋이 합성이거나 공개 라이선스인 경우, 평가된 각 초록은 편향 및 인과관계 측정 및 비교에 사용됩니다.
- 단위 12.1–12.3는 측정 및 비교: 질병 빈도, 연구 설계, 편향 및 인과관계입니다.
- 단원 12.4–12.6의 정량화: 진단 검사, 추론, 시험 및 평가.
- Unit 12.7 applies: appraisal, certainty, and the patient in front of you.
EBM 습관: PICO로 질문하고, 위험 및 비율로 측정하며, 의례가 아닌 간격으로 결정한다 — 아래 모든 계산은 합성된, 기계 검증된 결과이며, 당신이 다시 계산해 볼 수 있는 내용이다.
질병 측정: 발병률과 유병률
중요성. 비교하기 전에는 먼저 질병을 세어야 하며, 두 가지 고전적 계수는 서로 다른 질문에 답한다: 새로운 사례가 얼마나 빠르게 나타나는지, 그리고 동시에 존재하는 사례 수는 얼마인지.
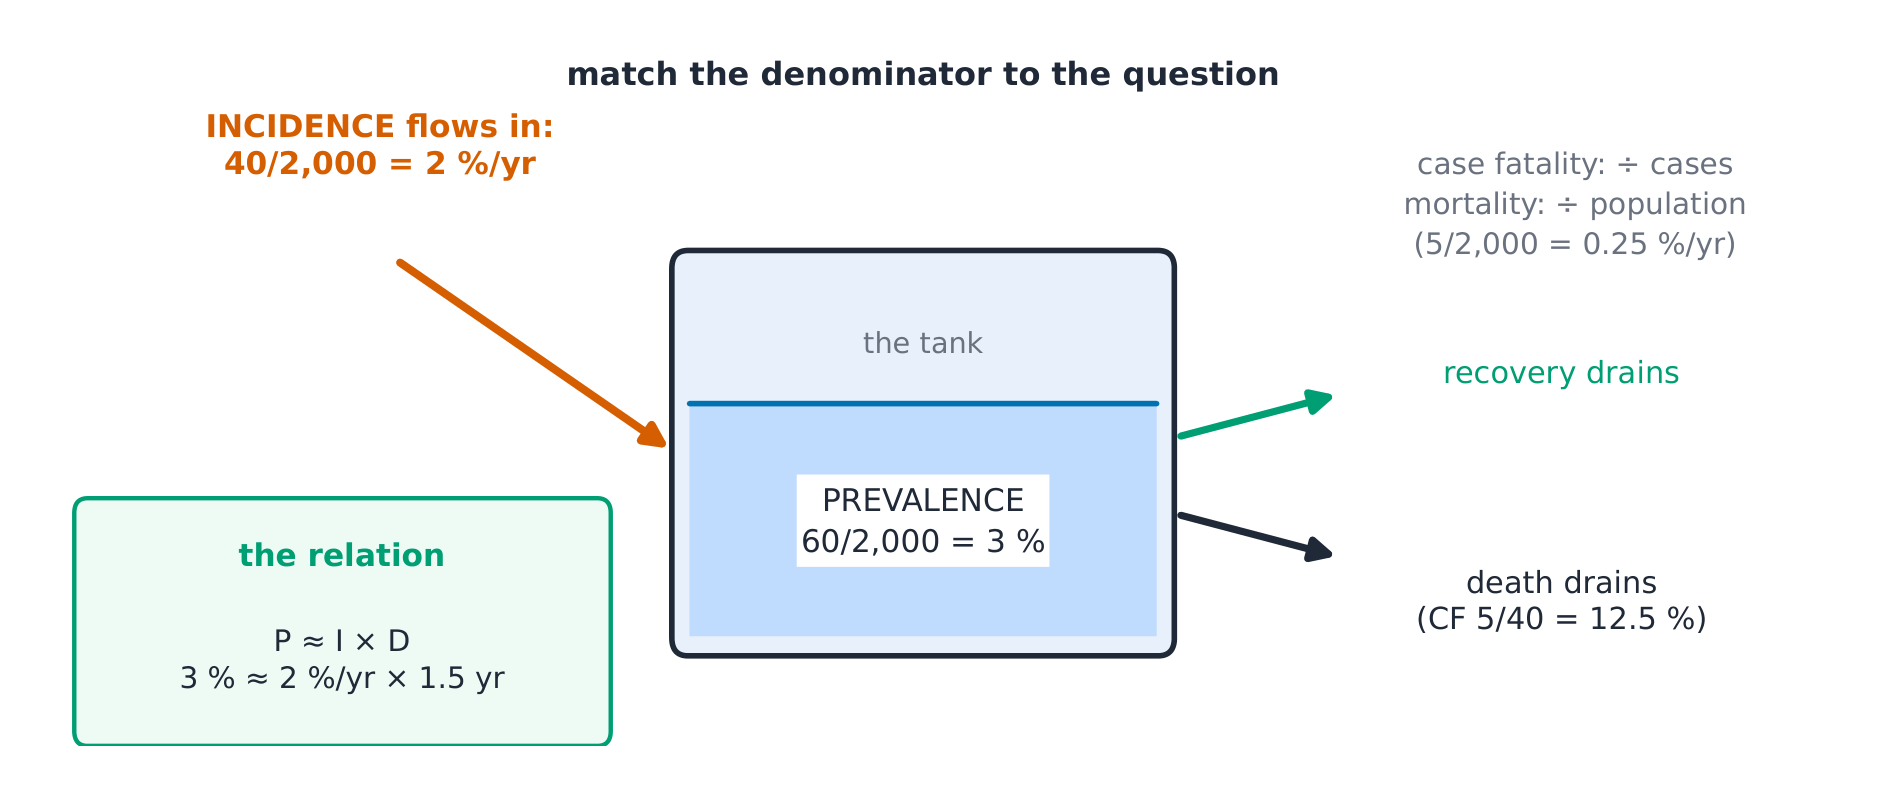
개념과 그림. 발병률 = 신규 사례 ÷ 위험군 인구 ÷ 시간; 유병률 = 특정 시점의 기존 사례 ÷ 해당 인구 ✓. 두 지표는 연결되어 있다: 유병률 ≈ 발병률 × 기간 — 장기 질환은 쌓이고 단기 질환은 조사 사이에 사라진다. 발병률이 탱크를 채우고, 치료와 사망이 빼면 유병률은 물 높이 도출 과정 (표준화가 존재하는 이유). 표준 rates는 두 가지 효과를 섞는다: 질병 위험과 인구 연령 구조. 노령 인구가 많은 지역은
 연령별 rates가 낮음에도 더 높은 표준 rates를 보일 수 있다 ✓.
직접 표준화는 각 집단의 연령별 rates를 하나의 표준 인구에 적용하여 합산한다 — 나비율이 동일하므로 가상의 총합은 비교 가능하다. 영향: 질병 위험 및 인구 연령 구조. 노령 인구가 더 많은 지역은 낮은 연령별 특이율에도 불구하고 높은 원시율이 나타날 수 있습니다 ✓. 직접 표준화는 각 집단의 연령별 특이율을 하나의 표준 인구에 적용하여 합산합니다. 나이가 섞인 비율이 이제 동일하기 때문에 가상의 총계는 비교 가능합니다. 표준 집단 및 합계 — 인공 총합은 비교 가능함 왜냐하면 연령 구성이 이제 동일하기 때문임.
연습 예시 1 — 인공 도시. 2,000 거주자, 1년, 40 신규 신규 질병 발생 → 발병률 40/2,000 = 2 % per year ✓. 조사일 현재 60 명이 해당 질환을 보유하고 있음 → 시점 유병율 60/2,000 = 3 % ✓. 검증: 3 % ≈ 2 %/year × 1.5 years 평균 지속 기간 — 숫자들은 일관된 시스템입니다.
해설 예 2 — 임상적 연결: 사망률의 세 가지 면모. (가상의 dataset) of the 40 new cases, 5 died within the year: case fatality 5/40 = 12.5 % ✓; 이 해로 전체 도시에서 이 원인으로 인한 사망자는 5/2,000 = 0.25 % (원인별 사망률); 또한 해당 해 전 원인에 의한 사망이 20 명 기록될 경우, 이 질환은 그 중 5/20 = 25 %를 차지함 (비례사망률). 같은 사망자 수, 세 가지 분모, 세 가지 다른 질문. mortality). Same deaths, three denominators, three different questions.
질병별 사망률(인구), 비례적 사망률(모든 사망) — 매칭되는 structures (standardise first). Reading case fatality as mortality (the denominator is cases, not people). denominator is cases, not people).
요약. 발병률 = 신규/위험군/시간; 유병율 = 기존/인구; P ≈ I × D; 표준화는 연령 구성 조정; 발생사망률(발생사례), 원인별 사망률(인구), 비례사망률(전체 사망) — 질문에 맞는 분모 선택. 코호트(노출군 및 비노출군을 앞으로 추적) → 사례 대조군(뒤로 looking) 원인별 사망률(집단), 비례 사망률(모든 사망) — match the denominator to the question.
연구 설계
중요성. 모든 임상 질문에는 이를 잘 답할 수 있는 연구 설계가 존재하며, 반대로 그렇지 못한 설계도 있습니다. 연구 설계를 선택한다는 것은 어떤 편향을 대립하게 될지를 선택하는 것입니다.
개념 및 시각 자료. 계단식: 무작위화 시험(실험) → 유도 과정(RR이 코호트에 속하고 OR이 사례 대조군에 속하는 이유). A 희귀 질환 또는 결과 → 사례-대조군; 일반적인 결과에 대한 노출이 선행되어 측정됨 → 코호트; 두 가지 질문을 동시에 다룸 → 실험 유래 (RR이 코호트에, OR이 사례-대조군에 속하는 이유). A
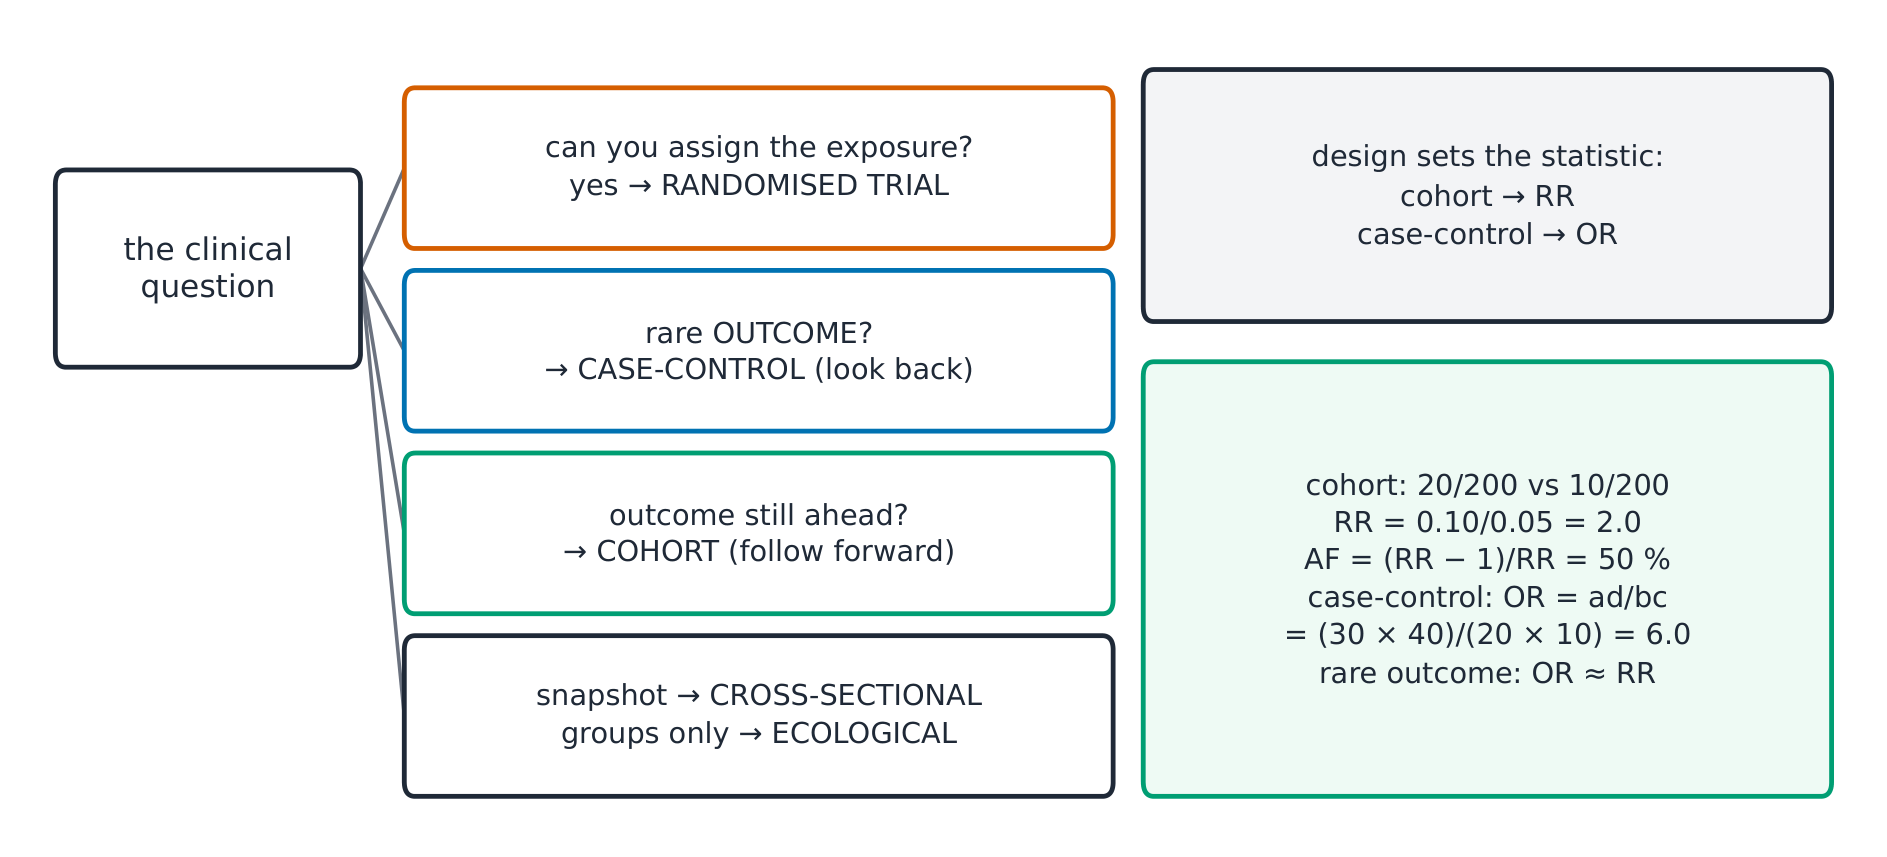
유도 과정 (RR이 코호트에, OR이 사례-대조에 속하는 이유). A 유효합니다 ✓. 연구 설계가 통계량을 결정하며, 선호도가 아닙니다. 위험** $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. 사례 대 조군 표본은 결과에 의해 결정되므로 각 군의 "위험"은 표본 비율에 따른 인위적 현상입니다. 오직 비율비(OR) $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$만이 타당합니다 ✓. 설계가 통계를 결정하지 선호도가 아닙니다.
Worked example 1 — one synthetic cohort. Exposed 200, 20 events; unexposed 200, 10 events: risks 0.10 vs 0.05 → $RR = 2.0$ ✓, attributable fraction among exposed $(RR-1)/RR = 50\ \%$ ✓ — the exposed group's events 가정하에 노출군의 사건 중 절반이 "노출로 인한" 것입니다.
해설 예제 2 — 임상 연결: 사례 대 조군 거울. (가상) 30의 40 사례에서 노출됨; 20의 60 대조군에서 노출됨: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. 드문 결과에서는 OR이 RR을 근사합니다 — 한 개의 수치를 두 가지 설계 중 하나를 선택하며, 표본 추출이 합법적 여부를 결정합니다.
자주 하는 실수. 사례-대조 연구에서 RR을 계산할 때(분모는 연구자가 선택하며 발견되는 것이 아닙니다). 교차단면 비율비를 "전향적"으로 "더 나은" 것으로 읽는 것은 (전향적 코호트도 혼란 요인을 완전히 제거하지 않으며, 무작위 배정만 미지의 요인을 균형 있게 만듭니다). "전향적"이 "더 나은 것"과 동일하다고 간주함 (전향적 코호트 연구도 혼란 요인을 완전히 제거하지 못하며, 무작위 배정만이 미지의 요인을 균형 있게 만듭니다). 무작위 배정만 미지의 요인을 균형 있게 만듭니다. 무작위 배분은 미지 변수를 균형함).
요약. Trial → 코호트(RR) → 사례-대조(OR) → 교차 surveys → ecological; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; cohort samples by 세 번째 변수(혼란 요인) 및 원인이 없는_passion에 의한 연관성으로 인해 발생합니다. 실패 모드를 명명하는 것이 비판적 평가의 반을 차지합니다. fraction $(RR-1)/RR$.
편향, 혼란 요인과 인과관계
중요성. 숫자는 세 가지 방식으로 거짓말을 합니다: 체계적으로(편향), 제3 변수를 통해(혼란 요인), 그리고 원인이 없는 상관관계로. 실패 모드를 명명하는 것이 비판적 평가의 반입니다. 세 번째 변수(혼란 요인) 및 원인이 없는_passion에 의한 연관성으로 인해 발생합니다. 실패 모드를 명명하는 것이 비판적 평가의 반을 차지합니다. 반을 차지합니다.
개념과 그림. 편향(Bias) 은 설계 또는 수행에서의 체계적 오류입니다. 측정: 선정 편향 (누가 포함되는가), 정보/기억 편향 (무엇이 기억되거나 기록되는가). 혼란은 노출과 결과 모두에 연관된 세 번째 변수로, 원인인 척 위장하는 현상 ✓.
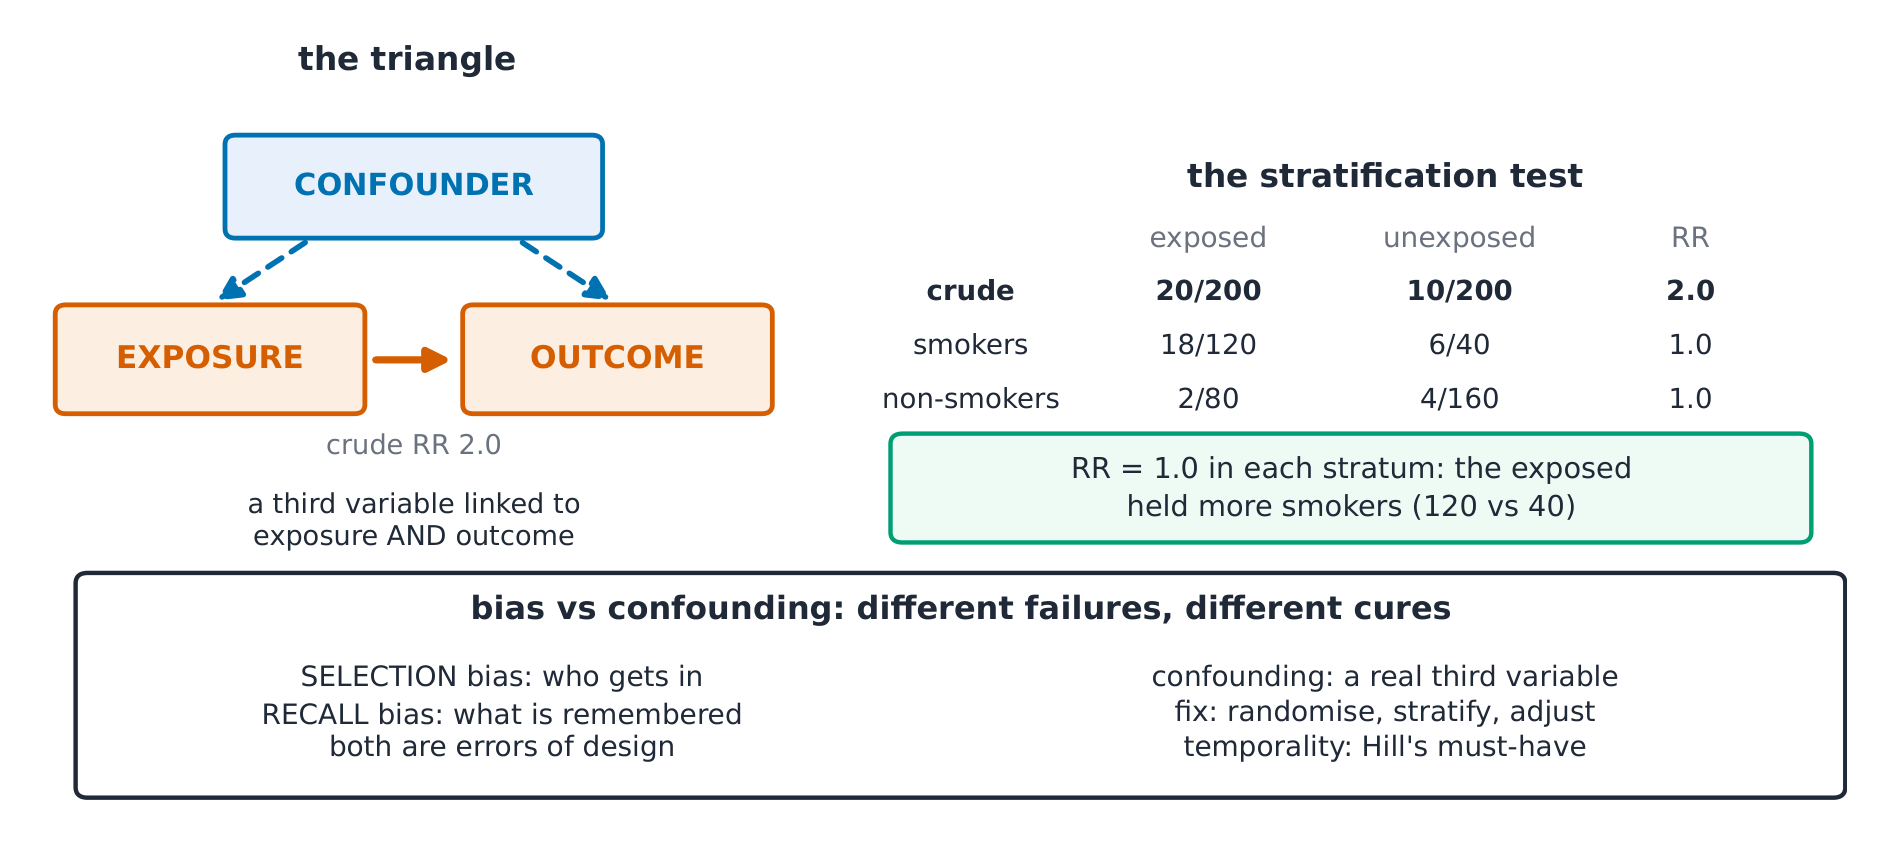
도출 과정(왜 계층 분석이 증명인가). 제3 변수가 진짜 원인이라면, 해당 변수가 일정하게 존재하는 계층 내부에서는 그_passion이 사라져야 한다. 일정하다: 원시적 $RR$ 2.0, 그러나 비흡연자 $RR$ 1.0 및 흡연자 $RR$ 1.0 → smoking was the confounder ✓. If the association persists within strata (say 2.0 and 1.9), the exposure keeps its own signal. Randomisation prevents confounding prospectively by balancing even the unknowns ✓.
Worked example 1 — the stratified table. (Synthetic) crude: exposed 20/200 events vs unexposed 10/200 → RR 2.0. Stratify by smoking: non-smokers 6/100 vs 3/100 (RR 2.0 ✓ inside), smokers 14/100 vs 7/100 (RR 2.0) — the association survives stratification: smoking was NOT the confounder here; the exposure's signal stands. Now give the same crude table a different split — exposed: 120 smokers (18 events) and 80 non-smokers (2 events); unexposed: 40 smokers (6 events) and 160 non-smokers (4 events). Smokers' risk is 15 % in both arms and non-smokers' 2.5 % in both, so RR is 1.0 inside each stratum: the exposed group simply held more smokers, and smoking WAS the confounder ✓. One crude table, two verdicts — only the strata can tell them apart.
Worked example 2 — clinical link: the appraisal questions. (Fictional (추상적) "커피를 마시는 사람들이 두 배 더 높은 위험"이라는 문장을 볼 때, 실제로 누구를 대상으로 연구했는지 묻기 (선정) 노출이 어떻게 측정되었는지(회상 — 질환을 가진 환자가), 및 혼란변수가 어떤 형태여야 하는지 파악하기 어떻게 다르게 기억하는지), 그리고 혼란변수가 어떤 조건을 충족해야 하는지 이해하기 (커피와 Outcome, 즉 흡연과 같은 결과에 모두 관련됨). 브래드포드 힐의 관점 — 우선성, 강도, 일관성, 용량-반응 관계, 타당성 — 이 순서대로 headline을 체크리스트로 전환합니다 ✓. 타당성 — 헤드라인을 체크리스트로 변환하기 ✓.
대용량이 혼란 변수를 해결해 줄 것이라 기대함 (편향된 추정치 주변의 정밀도만 높아질 뿐임). 힐의 모든 관점을 요구함 (이것들은 점수표가 아닌 관점이므로, 우선성이 유일한 비타협 조건임). 요약. 편향 = 체계적 오차(선택, 정보/회상); 혼란 변수 = 두 경로 상에 존재하는 제3변수; 계층화 테스트는 혼란 변수가 있을 때_pass_를 붕괴시킵니다; 무작위할당은 미지 요인을 균등하게 배분하며, 힐의 관점은 우선성을 가장 먼저 고려합니다. 무작위할당, 계층화 또는 보정을 통해; 선정 및 정보 편향은 연구 대상과 측정 방식의 오류이며, 이는 어떤 분석으로도 완전히 수정되지 않는다). 혼란변성을 해결해 줄 것으로 기대하는 대규모 데이터(편향된 estimate). Demanding every Hill viewpoint (they are viewpoints, not a scorecard; temporality is the only non-negotiable).
요약. 편향 = 체계적 오류(선정, 정보/회상); 혼란변수 = 양쪽 경로에 존재하는 제3 변수; 계층화 검정은 혼란변성이 있을 경우 the association if confounded; randomisation balances the unknowns; Hill's 시간적 우선성을 갖는 관점들.
진단 검사
중요성. 검사의 수치는 검사 자체의 속성만은 아님 — 민감도와 특이도는 검사 자체의 속성이지만, 예측력은 인구에 속한다. 이를 오해하는 것이 임상 추론에서 가장 흔한 정량적 오류이다.
그림으로 보는 개념. 2×2: 민감도 = a/(a+c) (질병 유무, 검사 양성); 특이도 = d/(b+d) (건강, 검사 음성); 양적예측력(PPV) = a/(a+b), 음적예측력(NPV) = d/(c+d) — 자연 빈도 수열은 왜 유병률이 예측력을 움직이는지 보여줍니다 ✓. 민감도와 특이도는 열에 위치하고, 예측력은 행에 위치합니다 — 유병률이 행의 너비를 결정합니다

유병률이 양성예측값(PPV)을 결정하는 이유의 유도 과정. PPV = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. Sensitivity(Se)와 Specificity(Sp)가 모두 90 %일 때, 유병률이 10 %인 경우 PPV = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — 어떤 최고의 검사라도 저유병률clinic에서는 동전 던지기와 같아진다. 위양성 비율은 건강한 대다수층에 비례하여 확대된다. 건강한 대다수와 함께 팔 눈금에 포함된다.
해설 예제 1 — 자연빈도 트리(합성 데이터). 1,000 명 중, prevalence 10 %: 100 diseased → 90 true positives, 10 false negatives; 900 건강 → 810 진음성, 90 위양성 ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. 유병률 1 %에서 동일한 검사: 9 TP vs 99 FP → PPV 9/108 = 8.3 % ✓ — 한 개의 나무, 두 가지 세계.
해설 예제 2 — 임상적 연결: 확률비(Likelihood Ratio)는 이동 가능하다. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: 양성 결과 시 전-test 확률을 9배 증가시킨다.clinic의 유병률과 무관하게. 전-test 확률 1:9 (10 %) → 후-test 9:9 = 1:1 → 확률 50 % — 일행으로 도출된 동일한 PPV. 확률비 (LRs)는 검사의 휴대 가능한 형태이며, 예측값은 지역적 특성에 의존한다.
자주 하는 실수. 민감도를 "검사가 90 % 맞다"고 인용함 (실제로는 right about 90 % of the DISEASED — say of what). Applying a textbook PPV to 유병률이 다른 진료소. 두 열을 혼동하면(감수성은 병든 열 아래로; 특이도는 건강한 열 아래로 읽음). 요약. Se = a/(a+c), Sp = d/(b+d) — 검사 특성; PPV/NPV —
요약. Se = a/(a+c), Sp = d/(b+d) — 검사 특성; PPV/NPV — 인구 특성으로 적용하면, 유병률과 함께 이동해야 함; 자연 빈도 나무는 이를 visible; $LR+ = Se/(1-Sp)$ multiplies odds portably (0.9/0.1 = 9); 50 % PPV 유병률 10 %에서도 Sensitivity = Specificity = 90 %임에도 불구하고.
임상 데이터를 위한 통계적 추론
중요성. 추론은 표본이 모집단을 어떻게 설명하는지에 대한 것— p-값과 신뢰구간의 오해는 현대 문헌에서 나타나는 전형적인 오류입니다. 현대 문헌.
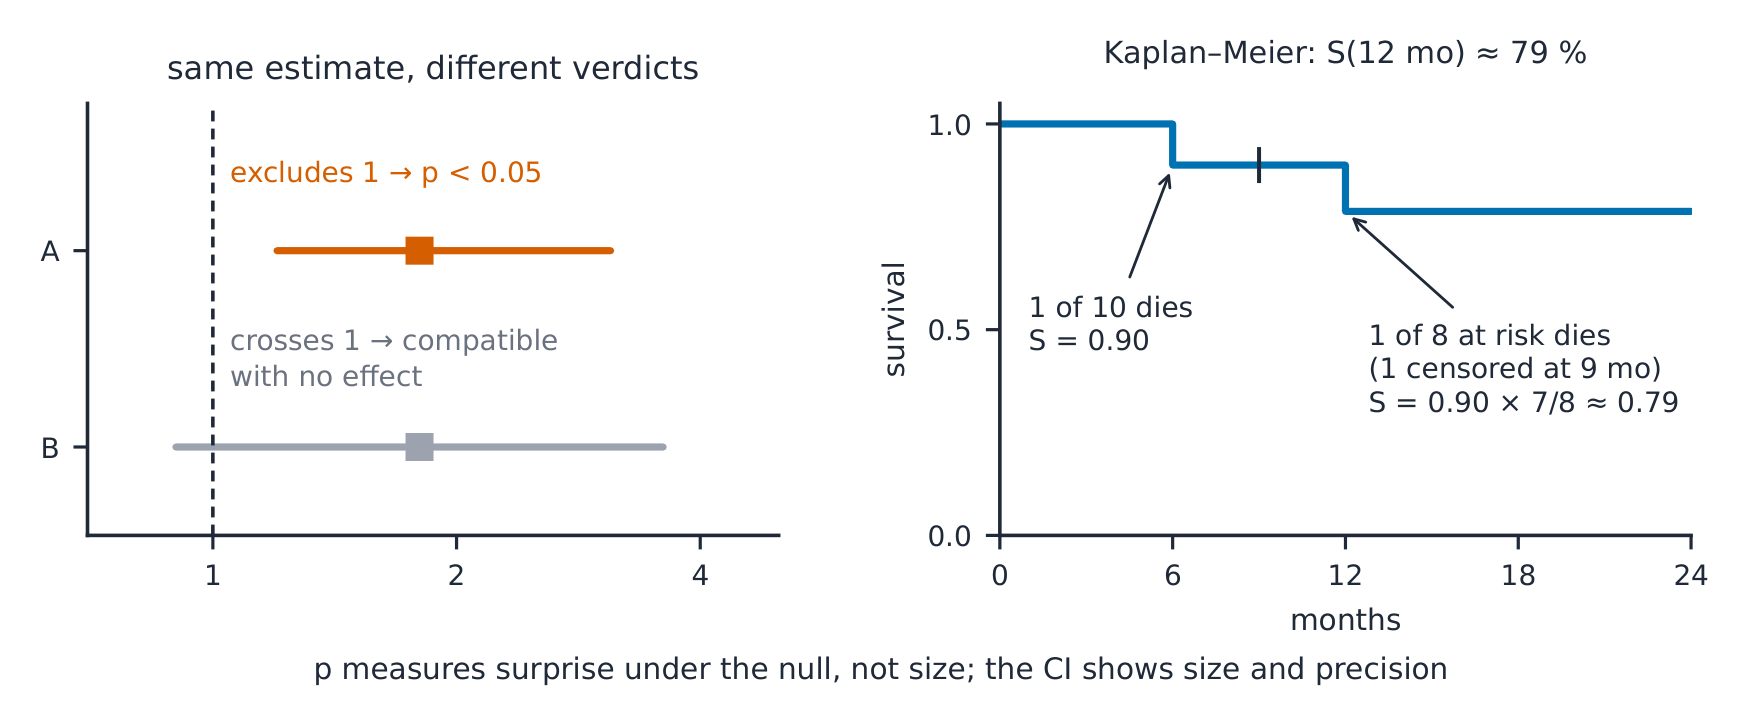
개념 및 시각 자료. 95% 신뢰구간은 해당 수준에서 데이터와 양립 가능한 실제 값의 범위를 의미하며, p-값 P는 귀무가설이 참일 경우, 이보다 더 극단적인 결과를 얻을 확률입니다 ✓. 신뢰구간은 효과 크기와 정밀도를 요약하고, p-값은 오직 놀라움 정도를 요약합니다. P값은 귀무가설이 참일 경우, 이보다 극단적인 데이터가 나올 확률임 ✓. 신뢰구간(CI)은 크기와 정밀도를 요약하고, p-value만은 신뢰구간은 추정치의 크기와 정밀도를 담고; 생존 곡선은 사건 발생 시 하강하며, 종결 간격에서 급락함 구간은 추정치의 크기와 정밀도를 포함하며, 생존 곡선은 사건 발생 시 계단식 하강하고 censoring 간격에서 급락합니다
 도출 과정(왜 검사가 해당 데이터 유형을 따르는가). 그룹별 계수 →
The derivation (why the test follows the data type). Counts by group → χ²; two means (normal-ish) → t-test (paired when each row is measured twice); several means → ANOVA; skewed/small-n → rank (non-parametric) alternatives; two continuous measurements → correlation (Pearson, or Spearman 순위( ranks)에 대한 ✓. 측정 척도는 검정을 결정하며, 결과를 본 후에 결정을 내리는 것은 잘못된 질문을 유도합니다.
풀이 예시 1 — 한 구간 읽기. (가상의 추상) RR 1.8, 95 % CI 1.2–3.1: 이 구간은 1를 포함하지 않으므로, 데이터는 "영향 없음"과 이 수준에서 불일치함을 의미합니다 (p < 0.05 따름); 폭은 추정치가 불확실하지만 consistently above 1임을 나타냅니다 ✓. RR 1.8와 CI 0.9–3.6은 반대 결론을 내립니다 — 동일한 점 추정치이지만 다른 판정이며, 오직 구간만이 그 정보를 알려줍니다.
풀이 예시 2 — 임상적 연결: 카플란-마이어 산술. (합성) 10 명의 환자가 참여; 6개월 시점에 위험군 10 중 1명의 사건 발생: $S = 9/10 = 0.90$; 12개월 중 1 사건이 STILL AT RISK인 8명 중 하나 censoring됨): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. 중앙 생존 기간은 곡선이 50 %를 지나는 시간입니다. censoring은 분모에서 인원을 제거하는 것이 아니라, 추정 논리에서 제외하는 것입니다. 추정의 논리에서 유래하지 않음.
자주 하는 실수. "p > 0.05는 차이가 없다" (차이가 없다는 뜻이 아니라, 데이터는 차이에 부합할 수 있음을 의미합니다 — 증거의 부재 ≠ 부재의 증거). 차이가 없다는 것과 일치함 — 증거의 부재 ≠ 부재의 증거). CI를 진리가 구간 내에 있을 확률이 95%로 해석하는 것 (구간은 절차 자체의 속성이며, 이 표본의 추정에 적용됨). 선택 시 p < 0.05가 되는 것을 확인한 후 검정을 수행함.
요약. CI = 부합 가능한 참값의 범위, 크기 및 정밀도를 포함; p-value = p(이러한 극단적 결과 | 영가설); p값만으로 "증명"되거나 "효과 없음"을 단정할 수 없습니다; χ²/t/ANOVA/순위/상관관계는 데이터 유형에 따라 선택됩니다; 카플란-마이어 곡선-은 곱합니다 (1 − 사건수/위험 노출)입니다; 중위는 50 %를 초과하는 시점입니다.
임상시험 및 체계적 고찰
중요성. 시험은 증거의 장치이며, 고찰은 그 조립체입니다. 조립 — 어휘(무작위 배정, 블라인딩, ITT, NNT)는 모든 요약과 포레스트 플롯이 이미 알고 있다고 가정하는 내용입니다.
개념과 그림. 시험의 뼈대: 적합성 → 무작위 배정 (우연에 의한 배정, 할당 은폐) → 블라인딩(참여자, 임상 의사, 결과 평가자) → intent to treat 분석으로 진행 (무작위로 배정된 대로 분석, 모두 포함) ✓. 고찰은 포레스트 플롯에 통합됩니다: 사각형(크기 = 가중치), 선(CI), 마름모(통합) 및 이질성이 나타납니다. $I^2$ ✓.
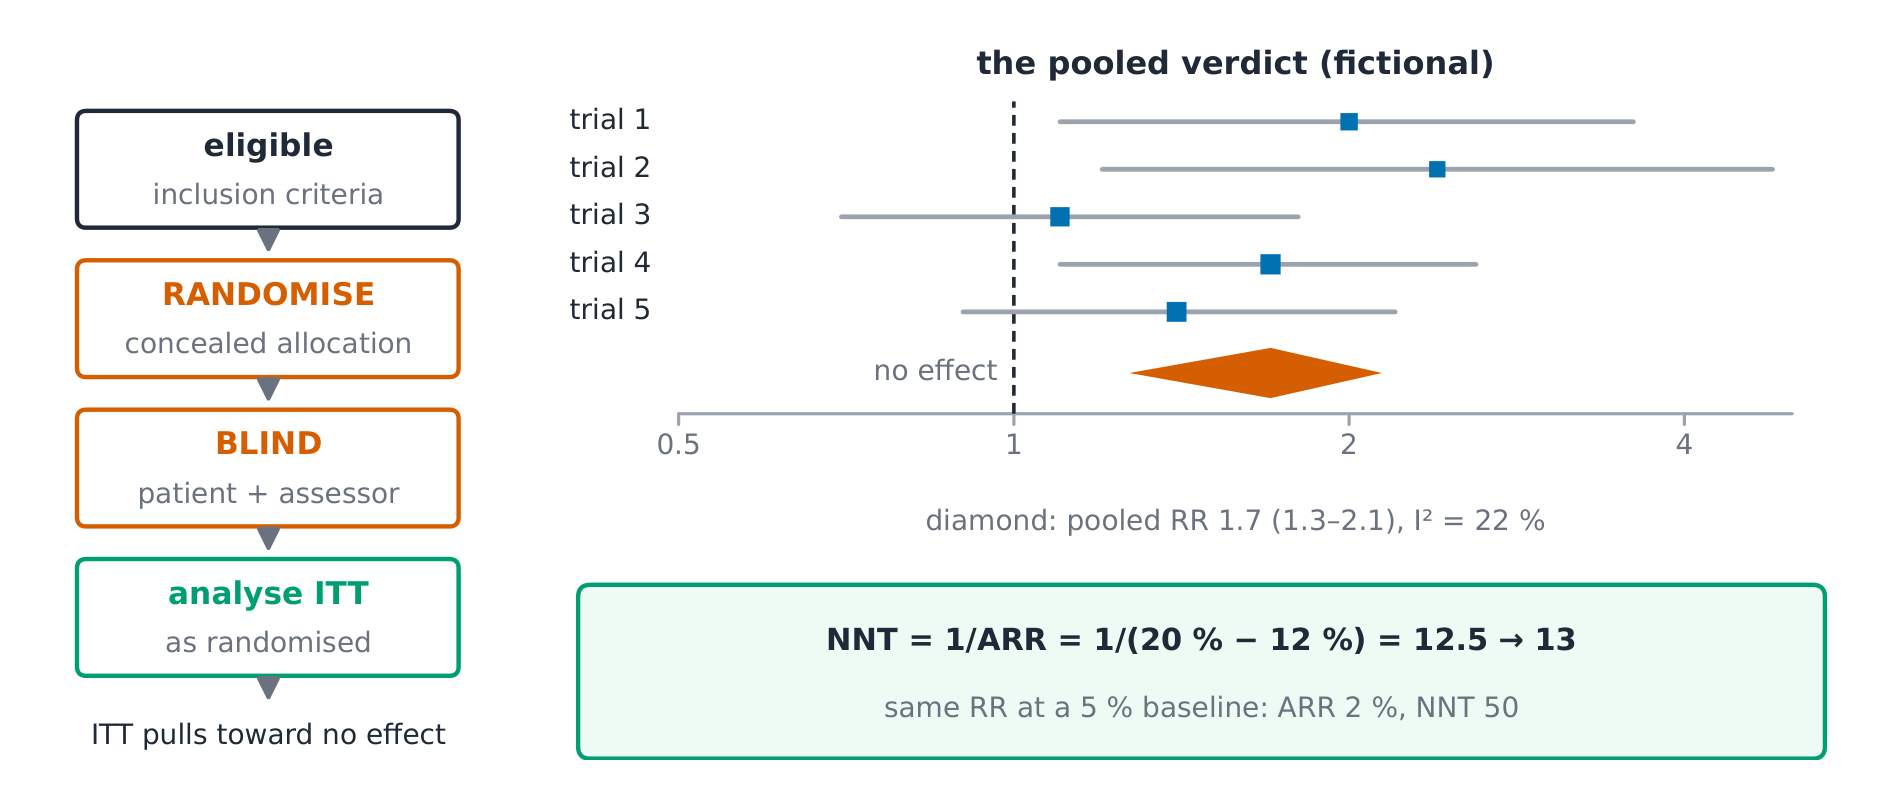
도출 과정(NNT가 효과의 임상적 크기를 의미하는 이유). NNT = $1/ARR$: 대조군 사건률 20 %, 치료군 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13명을 치료해야 한 명이_method를 얻습니다 ✓. NNT는 추상적 비율을 작업량으로 변환하며, 분모(ARR)는 기본 위험도가 낮아질수록 감소하므로, 이는 임상시험 결과가 위험도가 낮은 진료소로 그대로 적용되지 않는 이유입니다. 위험도가 낮은 진료소에 그대로 적용되지 않습니다.
해설 예시 1 — ITT 논리. (가상의 임상시험) 20 % 대조군 vs 12 % 치료군: ARR 8 %, NNT 13 ✓. 치료군이 30 % 조기에 배정에서 이탈했다면, ITT(의도치료 분석)는 여전히 그들을 치료군으로 분류하여 — 무효가치(null value)로 향하는 가시적 효과를 희석함 — 배정의 정책(policy)이 문제일 뿐 adherence의 생리학이 아니기 때문입니다 ✓. 프로토콜 분석(per-protocol)은 다른 질문을 답하며, adherence 편향(adherence bias)을 물려받습니다. 할당 시기가 앞선 경우에도 ITT는 여전히 치료군으로 분류하여 세팅함 — 겉보기 효과가 영(Null)에 수렴하게 만듦 — 할당의 정책(POLICY) 자체가 문제이기 때문에, 자주 하는 실수. 무작위 배정을 블라인딩과 혼동함(무작위는 집단을 균형 잡히게 하고, 블라인딩은 기대를 균형 잡힘 — 연구는 둘 중 하나만 가질 수 있음). 프로토콜 분석을 정직한 분석으로 여김(무작위 배정의 보호를 깨뜨림). 높은 이질성에도 불구하고 합산 다이아몬드를 절대적 진리로 취급함. 질문하고 따름 편향을 계승함.
작업 예시 2 — 임상 연결: 다이아몬드 읽기. (가상의 숲) 5개 시험, 개별 RR 1.1–2.4, 넓은 CIs, 합산 RR 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: 다이아몬드가 1 오른쪽에 위치하고 그 구간이 1을 제외하며 이질성이 낮음 — 환경 간 일관된 효과임. 동일한 다이아몬드에 $I^2 = 78\ \%$이 포함된다면 "왜 이 시험들이 서로 다르나?"라는 질문이 합산 전 신뢰할 수 있음.
자주 하는 실수. 무작위 배분과 블라인딩을 동일시함(무작위는 집단; 블라인딩은 기대치를 균형 있게 함 — 한 시험은 이 두 가지 중 하나만 가질 수 있음). per-protocol 분석을 정직한 분석으로 간주함(이는 무작위화의 보호를 깨뜨립니다). 높은 이질성에도 불구하고 합산 다이아몬드를 진리로 취급함. 요약. 무작위화(감추기) → 블라인딩 → 무작위화대로 분석(ITT,
요약. 무작위화(숨김) → 블라인딩 → 무작위화된 대로 분석(ITT, 영(Null)에 수렴하게 함); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); 포레스트: 제곱형 가중, 다이아몬드 합산, $I^2$ 불일치; 저기준 클리닉 중재, 비교, 결과) 프레임 → 타당성(결과에
비판적 평가 및 증거 적용
왜 중요한가. 증거는 침상에서 비로소 의학이 됩니다: 타당성이 검증되고, 중요도가 측정되며, 환자에게 적합하게 평가되어야 합니다. 그리고 당신 앞의 환자와 연결됩니다. 이 단원은 해당 과정의 종합입니다. 편향이 있었는가?) → 크기(얼마나 크고 정확했는가?) → 적용 가능성(내 환자에게
개념과 그림. 평가의 척도: PICO(인구집단, 개입, 비교군, 결과) 프레임워크 → 타당성(결과에 편향이 있었는가?) → 크기(크기는 얼마나 정밀한가?) → 적용 가능성(내 환자가 연구 대상 인구집단을 대표하는가?) ✓. 확신 등급(GRADE): 무작위 배정된 증거는 높게 시작하고 관측 연구는 낮게 시작합니다; 편향 위험, 일관성 부족, 간접성, 불확실성 또는 출판 편향으로 하향 조정하며, 큰 효과나 용량-반응 경향이 있을 때 상향 조정합니다 ✓. 중재, 비교, 결과) framing → 타당성 (결과에 편향이 있었는가?) → 크기 (얼마나 크고 정밀한가?) → 적용 가능성 (내 환자에게도 연구 대상 인구에 유사한가? ✓. 확신 등급(GRADE): 무작위화 증거는 초기에 높고 관측 연구 증거는 낮으며, 편향 위험으로 하향 조정됨, 편향, 일관성 부족, 간접성, 불확실성 또는 출판 편향; 큰 효과 또는 용량-반응 경향이 있을 때 상향 조정됨 ✓. 큰 효과 또는 용량-반응 기울기가 있는 경우 ✓.
 *피라미드는 각 연구의 진리가 아니라 평균적인 편향 취약성을 순위화한 것입니다. flawed trial(결함이 있는 시험)이 좋은 코호트보다 더 오도를 줄 수 있습니다.
계층 구조의 도출 (왜 계층 구조가 최종 결론이 아닌 사전 판단 기준인가). 설계마다 TYPICAL(일반적인) 편향 통제 수준이 다릅니다: 무작위 배정은 측정된 및 미측정 교란 요인을 균형 있게 만듭니다; 코호트는 교란 요인을 내포합니다; 경우-대조 연구는 회상 편향을 추가합니다 ✓. 그러나 계층 구조는 설계 유형을 등급 매기는 것이지, 개별 연구에 대한 최종 판정은 아닙니다. 작은 크기의 비맹검, 프로토콜 기반 분석이 수행된 무작위 배정 시험보다 큰 크기의 사전 등록 코호트 연구가 더 높은 신뢰를 받을 수 있습니다. TYPICAL 편향 통제 방식이 다름: 무작위화는 교란 요인을 균형을 맞추고, 측정된 및 미측정 교란 요인을 조절함; 코호트 연구는 교란 요인이 존재하며, 사례-대조 연구는 추가되는 회상 편향 ✓. 그러나 계층은 연구 설계를 분류하는 등급이며, 판단은 해당 연구의 소견에 속함 — 작고 blinding이 없으며 프로토콜 분석을 수행한 시험은 사전 등록된 대형 코호트보다 신뢰도가 낮을 수 있으며, GRADE가 존재하는 이유는 바로 설계 유형이 시작점에 불과하기 때문입니다. 시작점과 함께.
해설 예시 1 — 가상의 초록 5문. (가상) "무작위 배정, 이중 블라인드, n = 400; RR 0.75 (0.60–0.94)": 타당성 — 무작위 배정 및 블라인딩 ✓; 크기 — 25 % 상대 감소, 신뢰구간이 포함하지 않음 1; 국소적 적용 가능성 — 내 환자와 유사한 환자가 참여했는가(연령, 질환 중증도, 복용 약품)?; 결과 — 환자 중심적 결과인가 아니면 대안 지표?; 확신도 — 하향 조정 요인이 있는가? 5문의 구조화된 판단 ✓.
해설 예시 2 — 임상 연결: NNT의 전파. (가상) a 중증 질환 시 trial(기저값 20 %, ARR 8 %, NNT 13); 내 환자의 임상은 기저값 5 % 수준이다: 동일한 상대 위험 감소를 적용하면 ARR는 scale이 $8\ \% \times 5/20 = 2\ \%$ → NNT 50로 확장됨 ✓. 상대적 효과는 전파될 수 있으나, 절대적 부담 — 업무량과 해-편익 산술식 — 은 현지의 상황이다.
Common mistakes. Appraising only for validity (a valid but tiny effect is still useless: size and precision decide importance). Grading by journal 결함을 따라 이동함). 집단 평균을 핵심 특징이 배제 기준이었던 환자에게 적용함. flaws). Applying group averages to the patient whose defining feature was an exclusion criterion.
요약. PICO → 타당성 → 크기 → 적용 가능성; GRADE: 설계에서 시작하여 편향/일관성 부족/간접성/정밀도 부족으로 하향 조정, 큰 효과로 상향 조정; 피라미드는 사전 정보이지 판단이 아님; 상대적 효과 설계, 편향/일관성 부족/간접성/불확실성에 따른 하향 조정, 큰 효과 시 상향 조정; 피라미드는 사전 판단이지 판단 그 자체는 아님; 상대적 효과 거시적 효과에 대해; 피라미드는 사전의 판단이 아닌 결과이며, 상대적 효과를 나타냅니다. 이동 시 절대 편익(ARR, NNT)은 현지에 국한되므로 적용 전에 다시 계산해야 합니다.