このコースとは何か、および使い方は
これは大学医学コースの第12回:疫学、 生物統計学およびエビデンスベースド・メディシン(EBM)— 臨床的質問を数値に変換し、数値から意思決定へとつなげるツールキットです。 評価されたUNI-BUS-05統計教材と整合しており、数学的な内容が重なっています。 以下のデータセットは合成データまたはオープンライセンスであるため、各要約は架空であり、いかなる治療の許容や指針も提供しません。
範囲の制限(一回のみ記載): 学術課程であり、医学学位ではありません。以下のすべての 以下のデータセットは合成またはオープンライセンスであり、すべての抽象評価は 架空であり、これにより治療を許可または指導するものではない。
- Units 12.1–12.3 measure and compare: disease frequency, study designs, EBMの習慣:PICOで問い、リスクと比率で測定し、儀式ではなく信頼区間で決定する — 以下の計算はすべて合成データであり、機械による検証済みで、再計算可能なものです。
- 単位12.4–12.6は定量する:診断検査、推論、試験およびレビュー。
- 単位12.7を適用する:評価、確実性、および眼前の患者。
EBMの習慣:PICOで問い、リスクと比で測定し、儀礼ではなく 間隔で判断する — 以下のすべての計算は合成であり、 機械検証済みであり、あなたが再計算すべきものである。
疾病の測定:発現率と流行率
重要性。 比較を行う前に、疾病を数える必要がある — そして、 2つの古典的なカウントは異なる質問に答える:新規症例の出現速度、 一度に存在する数
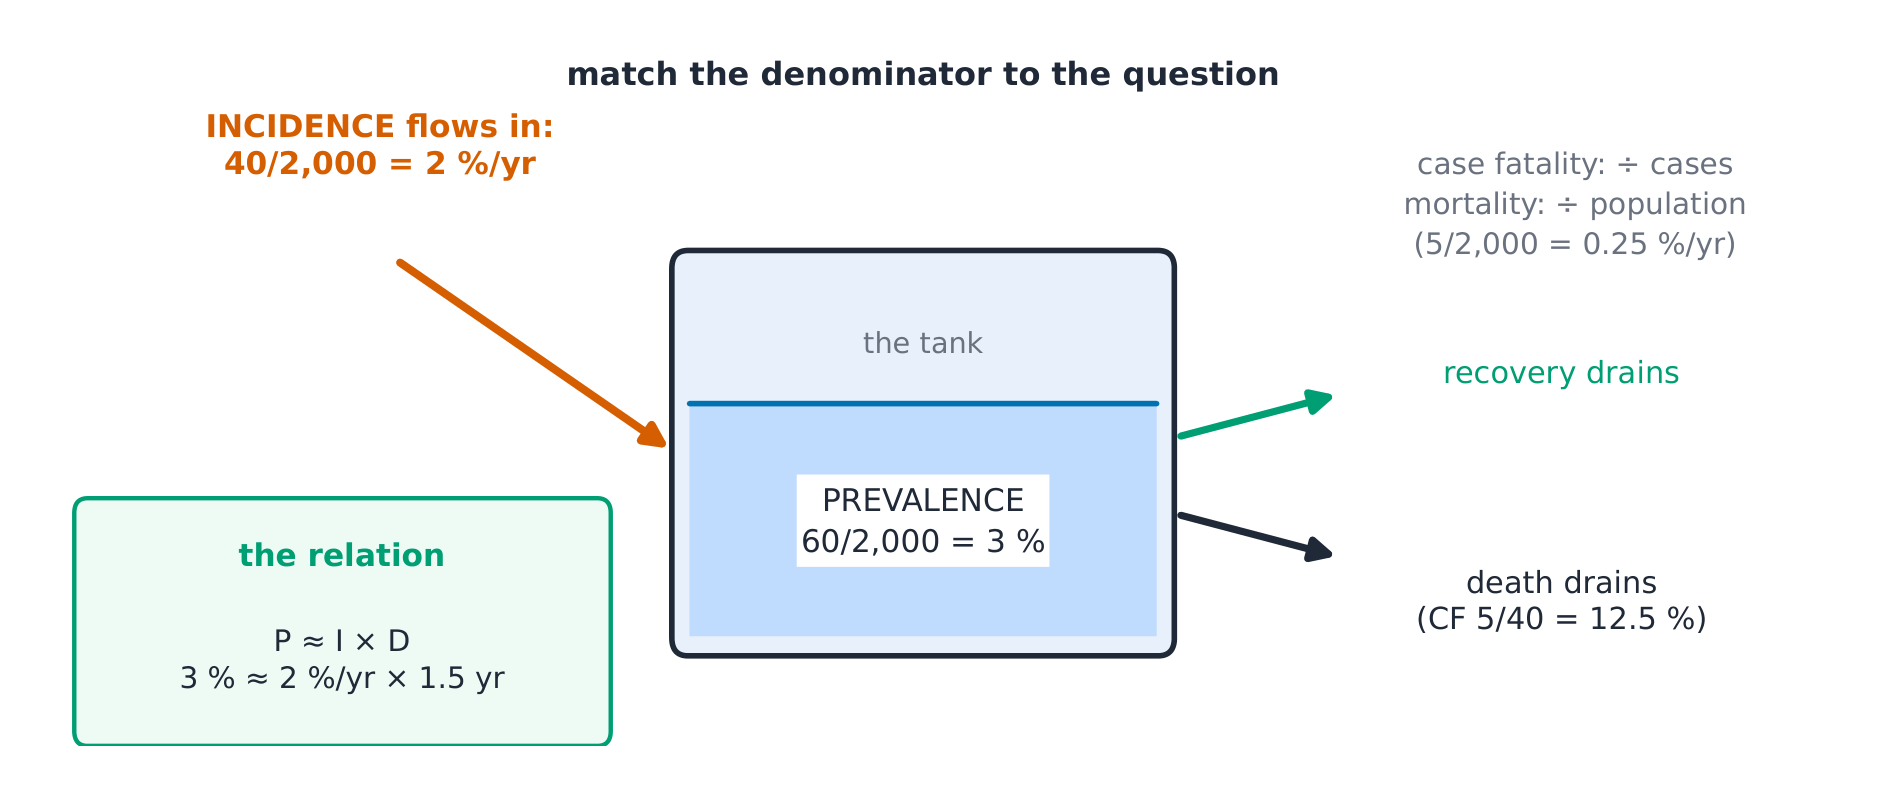
概念、図付き。 発症率=新規症例 ÷ 対象者 リスク × 時間;患病率=既存症例 ÷ 時点での人口 ✓。これらは関連している:患病率 ≈ 発症率 × 病期 — 長期の疾患 は蓄積し、短期の疾患は調査間に消滅する。
**標準化の導出(なぜ標準化が必要か)。**粗率には2つの 要因が混在する:疾病リスクと人口の年齢構成。高齢者が多い地区では、年齢別死亡率が低いにもかかわらず粗率が高くなる場合がある ✓。 高齢住民は年齢別率を低くても、粗 ratesが高くなる可能性がある ✓。 直接標準化では、各集団の年齢別率を一つの 標準人口に適用して合計する — 人工的な総数は比較可能である之所以に 年齢構成が同一になるからである。
1 % ≈ 2,000 %/年 × 40年の平均期間 — この数値体系は整合性がある。 疾病の症例 → 発症率 40/2,000 = 2 % /年 ✓。調査当日 60 人が疾病を有している → 時点患病率 60/2,000 = 3 % ✓。関連を確認: 3 % ✓;この原因による全町の年間死亡数は 2/1.5 = システム。
** worked example 2 — 臨床的関連:死亡率の三つの側面。**(架空の データセット)の 40 新規症例のうち、5 が年内に死亡した:症例致死率 5/40 = 12.5 % ✓;この原因による全町の年間死亡数は 5/2,000 = 0.25 % (cause-specific mortality rate); and if the town recorded 20 deaths from all causes that year, this disease caused 5/20 = 25 % of them (proportional mortality). Same deaths, three denominators, three different questions.
** 一般的な間違い。** 患病率を rate と呼ぶこと(それは比率であり、時間単位を持たない)。年齢構成が異なる集団間で粗 ratesを比較すること。 time unit). Comparing crude rates across populations with different age 構造(まず標準化を行う)。症例死亡率を死亡数として読み取る(この 分母は人ではなく症例である)。
要約。 発症率=新発症例/リスク群/時間;有病率=既存症例/人口; P ≈ I × D;標準化は年齢構成を揃える;症例死亡率(症例), 死因別死亡率(人口)、全死因に対する割合(全死亡数)— 質問に 合う分母を選ぶこと。
研究デザイン
重要性。 各臨床問題には、適切に回答できるデザインと、 できないデザインがある — デザインの選択は、どのバイアスと戦うかを決めることに他ならない。 概念と図示。 ラダー:無作為割付試験(実験)→
コホート研究(曝露群と非曝露群を前方追跡)→ 症例対照研究(結果から後方視察)→ 横断調査(単一のスナップショット)→ 生態学的研究(個人ではなく集団)✓。 希少疾患・結果 → 症例対照研究;一般的な結果に対して先行する曝露測定 → コホート研究;両方の問いを同時に解決 → 試験 結果から)→ 横断研究(単一スナップショット)→ 生態学的研究(個人ではなく集団) 個体)✓。
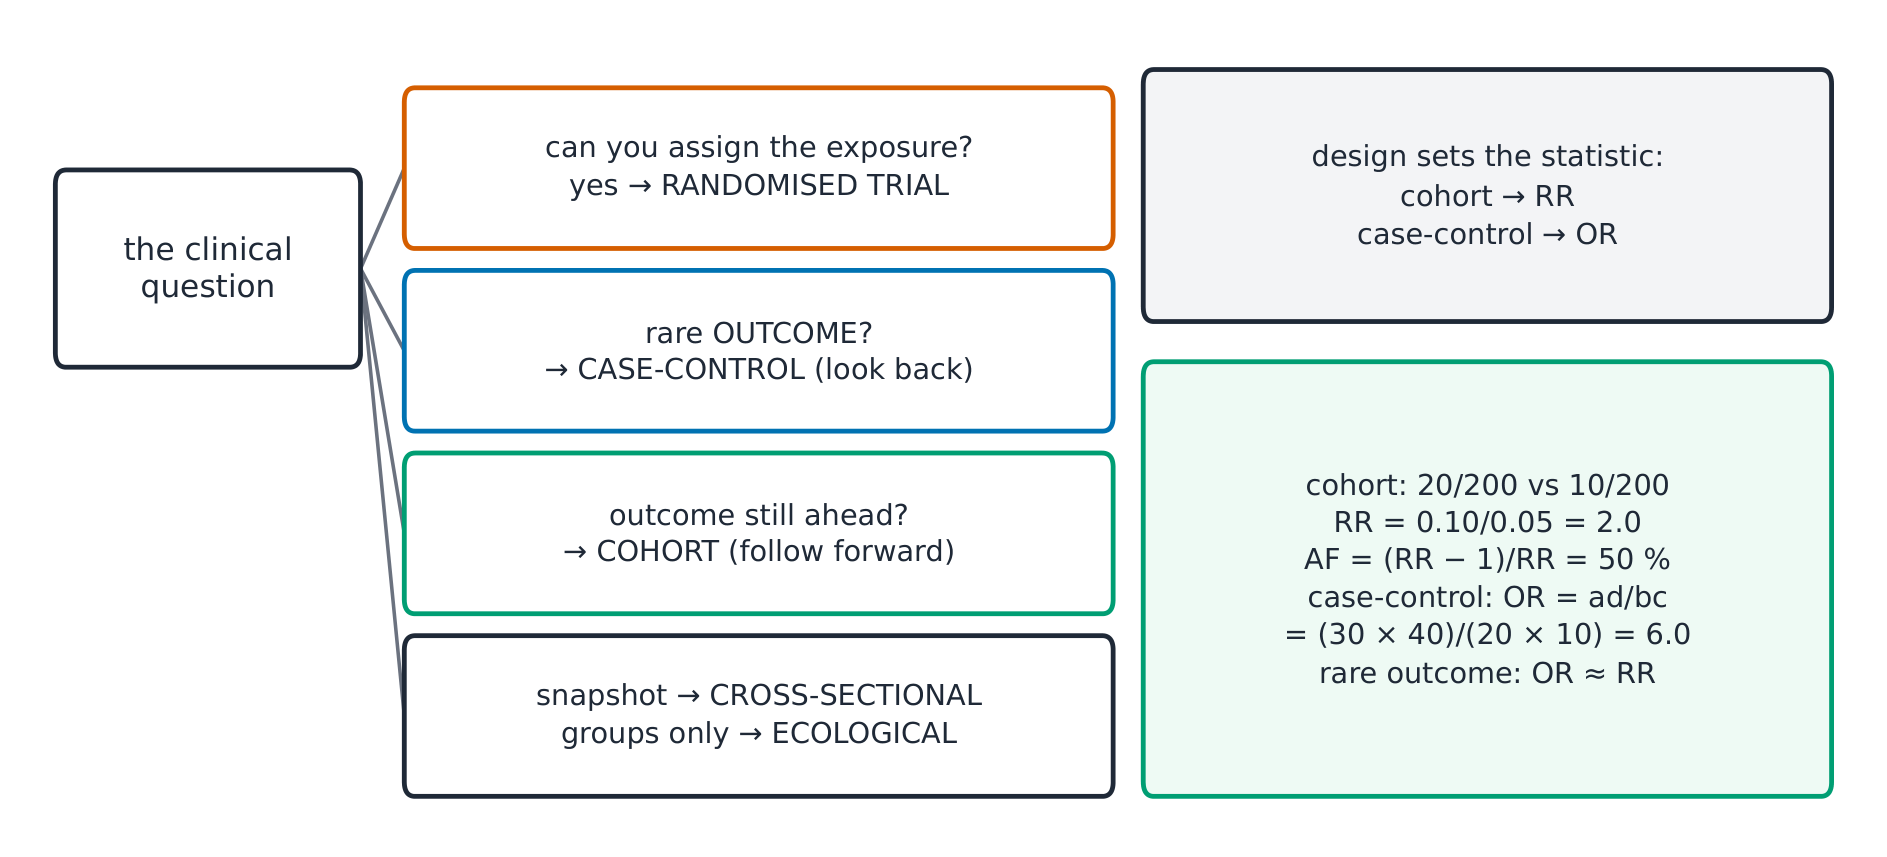
導出(なぜRRはコホート研究に、ORは症例対照研究に該当するか)。 A cohort samples by EXPOSURE, so risks in each arm are estimable: relative risk $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. A case-control samples by OUTCOME, so the "risk" in each arm is an artefact of the sampling ratio — only the odds ratio $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ is 妥当 ✓。統計量は嗜好ではなく、研究設計によって決定される。
計算例 1 — 合成コホート1つ。 曝露者 200、事象 20; 非曝露者 200、事象 10:リスク 0.10 vs 0.05 → $RR = 2.0$ ✓、寄与 率(曝露群)は $(RR-1)/RR = 50\ \%$ ✓ — 曝露群の事象 が「曝露によるもの」であるのは仮定の下で半分である。
計算例 2 — 臨床的関連:症例対照研究の鏡。 (架空) 30 of 40 cases exposed; 20 of 60 controls exposed: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. A rare outcome makes OR approximate RR — one number, 2つのデザイン、およびサンプリングがどの指標が合法的かを決める。
一般的な誤り。 症例対照研究から RR を算出すること(分母は 研究者によって選ばれるものであり、発見されるものではない)。横断調査のオッズ比を因果関係として読み解くこと(曝露と結果が同時である)。等置すること 「順追跡」を「より良い」とみなすこと(順追跡コホートでも交絡は残る;不確実な要素をバランスさせるのは無作為化のみ)。 交絡因子は後方経路に位置し、層別解析を行えば偽の関連は消失する randomisation balances the unknowns).
まとめ。 試験 → コホート(RR)→ 症例対照研究(OR)→ 横断調査 → 生態学的研究;$RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$;コホートサンプルは 曝露に基づき、症例対照研究は結果に基づいて抽出されます;希病性における OR ≈ RR;寄与 率 $(RR-1)/RR$ 。
バイアス、交絡および因果
重要性。 数字は3つの方法で嘘をつく:系統的に(バイアス)、 第3の変数を通じて(交絡)、そして原因のない相関によって。名称を付ける 失敗モードは批判的評価の半分である。
概念、図付き。 バイアスとは設計や測定における系統的誤差である: 選択バイアス(誰が対象になるか)、情報・想起バイアス(何が記憶されたり記録されたりするか)。 混在因子とは、曝露と結果の両方に関連する第3の変数であり、真の原因であるかのように振る舞う ✓。 混在因子は後方の経路に位置する — 層別化を行えば、偽の関連は崩壊する
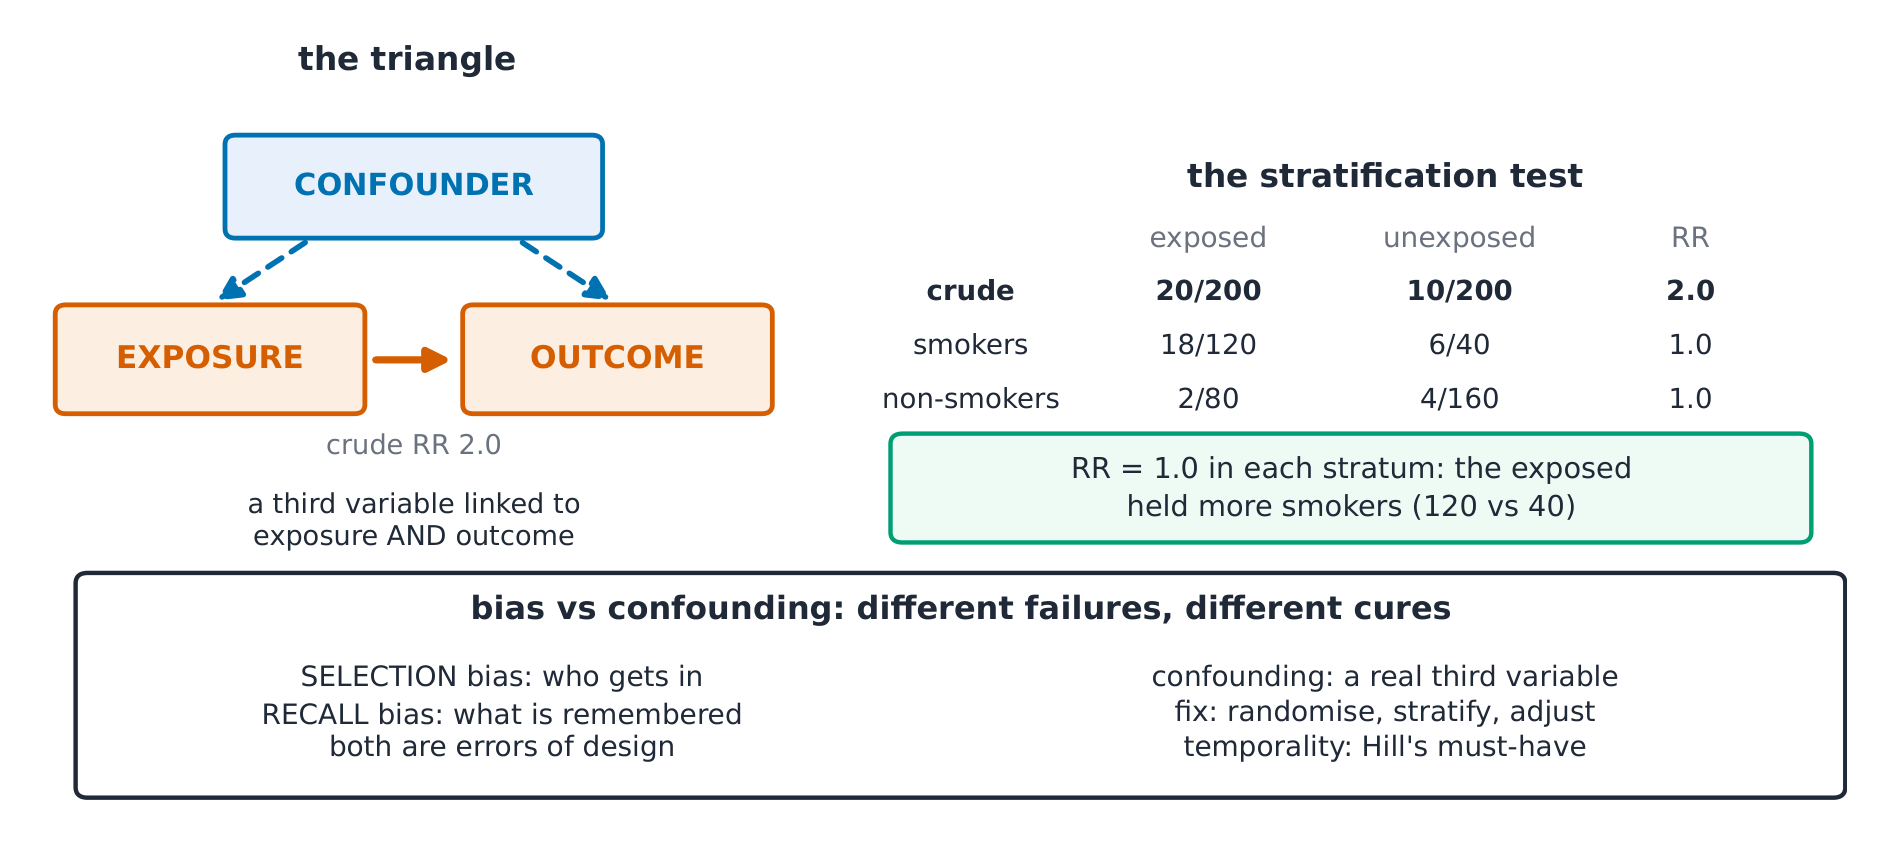
The derivation (why stratification is the proof). If a third variable is the true driver, the association should vanish inside strata where it is constant: crude $RR$ 2.0, but within non-smokers $RR$ 1.0 and within smokers $RR$ 1.0 → smoking was the confounder ✓. If the association persists within strata (say 2.0 and 1.9), the exposure keeps its own signal. Randomisation prevents confounding prospectively by balancing even the unknowns ✓.
Worked example 1 — the stratified table. (Synthetic) crude: exposed 20/200 events vs unexposed 10/200 → RR 2.0. Stratify by smoking: non-smokers 6/100 vs 3/100 (RR 2.0 ✓ inside), smokers 14/100 vs 7/100 (RR 2.0) — 層別化後でも関連は維持される:たばこは要因混在ではなかった ここでの混在因子ではありません;曝露のシグナルが立っています。次に同じ粗表に異なる分割を適用します — 曝露群:120 喫煙者(18 事象)と 80 非喫煙者(2 事象);非曝露群:40 喫煙者(6 事象)と 160 非喫煙者(4 事象)。喫煙者のリスクは両群ともに 15 %であり 非喫煙者の2.5%が両群で同一であるため、各層内でのRRは1.0となる: 曝露群には単に喫煙者が多く含まれており、喫煙こそが交絡因子であった✓。 一つの粗表で二つの結論——それらを区別できるのは層分解のみである。
演習例2 — 臨床的関連:評価質問。(架空の abstract) "coffee drinkers had twice the risk": ask who was studied 選択バイアス)、曝露の測定方法(回想バイアス — 疾病患者は 記憶が異なる)、および交絡因子がどのような特徴を持つべきか( コーヒーと結果の両方に関連するもの、例えば喫煙など)。ブラッドフォード・ヒルの 観点 — 時系列を最優先し、次に強さ、一貫性、用量反応関係、 妥当性 — これらは見出しをチェックリストに変換する✓。
一般的な誤り。 交絡と測定バイアスを同一个の問題として扱う(交絡は第三変数による効果の混在であり、無作為化、層分解、または調整によって是正される;選択バイアスと情報バイアスは対象者選定や測定方法における誤りであり、どの解析でも完全に修復できない)。 大データが交絡を解決すると期待すること(バイアスを含む推定量の精度向上のみ)。ヒルのすべての観点を要求すること(これらは観点であり、採点表ではない;時系列のみが不可避である)。 まとめ。 バイアス=系統的誤差(選択、情報/回想); 交絡因子=両方の経路にある第三変数;層分解テストは収束する。 分析で完全に修復されます) 大規模データで要因混在を解決できると期待すること(バイアスを含む推定値の周囲の精度向上のみを期待すること) ヒルのすべての見解を要求すること(それらは見解であり、チェックリストではない;時系列的順序だけが絶対条件である) まとめ。 バイアス=系統的誤差(選択バイアス、情報・回想バイアス);
要因混在=両方の経路にある第三の変数;層別化テストは破綻する 負;PPV = a/(a+b)、NPV = d/(c+d) — 自然頻度 関連付けが混同される場合;無作為化は不明な要因を均等にする;ヒルの 時間的順序を最優先とする観点。
診断検査
重要性。 検査の数値は検査自体の特性のみではありません—— 感度と特異度は検査に属しますが、予測値は その検査を用いる集団に属します。これを誤読することは、臨床推論における最も一般的な定量的 誤りです。
概念と図解。 2×2: 感度 = a/(a+c)(有病、陽性); 特異度 = d/(b+d)(健常、陰性); PPV = a/(a+b), NPV = d/(c+d) — 自然頻度ツリーは、なぜ prevalence が予測値に影響するかを示しています ✓。 感度と特異度は列にあり、予測値は行にあります — prevalence が行の幅を決定します 木図はなぜ prevalence が予測値を動かすのかを示している ✓ tree shows why prevalence moves the predictive values ✓.
 側は健常者の多数派に対して拡大します。
The derivation (why prevalence drives PPV). PPV = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. With Se = Sp = 90 %: at prevalence 10 %, PPV = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — even an 群は健康な多数派に合わせて拡大する。 arm scales with the healthy majority.
Worked example 1 — the natural-frequency tree (synthetic). 1,000 people, 罹患率10%: 100 患者 → 90 真陽性, 10 偽陰性; 900 健康者 → 810 真陰性, 90 偽陽性 ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. 罹患率1%で同一の検査を行う場合: 9 TP vs 99 FP → PPV 9/108 = 8.3 % ✓ — 一つの木、二つの世界。
** worked example 2 — 臨床的関連:Likelihood ratioは移動する。** $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: 陽性結果は前検验オッズを Clinicの流行率に関わらず9倍にする。前検验オッズ 1:9 (10 %) → 後検验 9:9 = 1:1 → 確率 50 % — 同一のPPVが一行で導かれる。Likelihood ratios(LRs)は テストの携帯可能な形式であり、predictive valuesは局所的である。
よくある間違い。 Sensitivityを「テストが90%正しい」と引用する(これは DISEASEDの90%について正しい——例えば何について)。異なる流行率のClinicに教科書のPPVを適用する。 二つの列を混同する(Sensitivityはdiseased列を下に見ます;specificityはhealthy列を下に見ます)。 まとめ。 Se = a/(a+c), Sp = d/(b+d) — テストの性質;PPV/NPV —
まとめ. Se = a/(a+c), Sp = d/(b+d) — 検査特性; PPV/NPV — 集団特性であり、罹患率に伴って変動する; 自然頻度ツリーはこれを視覚的に 示す; $LR+ = Se/(1-Sp)$ はオッズを簡便に倍増させる (0.9/0.1 = 9); 50 % のPPV が、Se = Sp = 90 % にもかかわらず、罹患率10 % で得られる。
臨床データのための統計的推論
重要性. 推論とは、標本が集団について何を語るかという手法であり、 Pは、帰無仮説が成立している場合において、少なくともこの程度極端なデータの確率です。 現代の文献における基礎である。
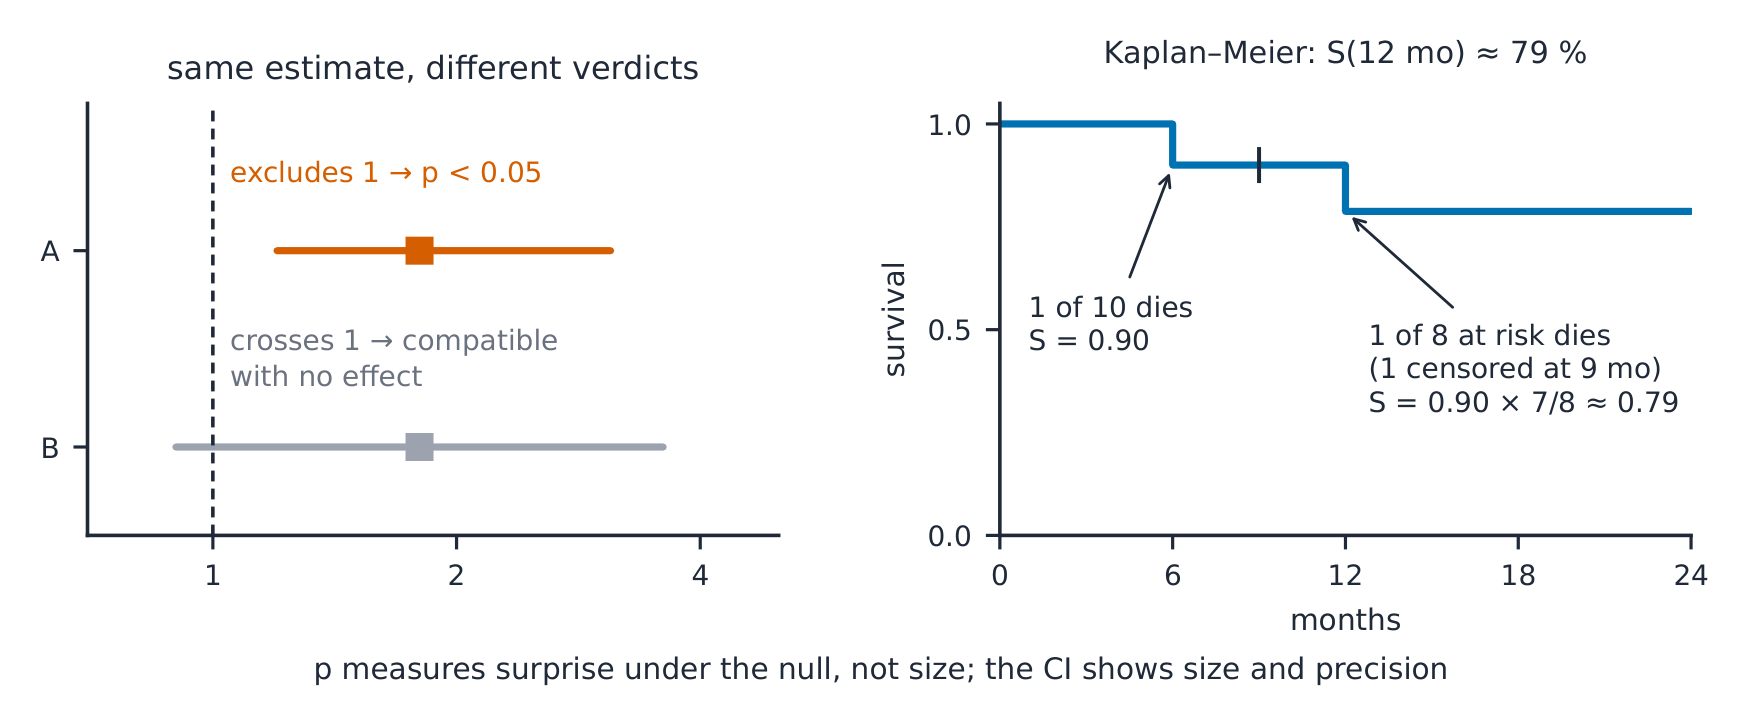
概念と図解. 95 % 信頼区間とは、 その水準でデータと整合する真の値の範囲であり、p値 P is the probability of data at least this extreme IF the null hypothesis 真であった ✓。信頼区間は推定値の大きさと精度を要約し、p値のみ 驚き(有意性)を要約する。
導出(なぜその検定がデータ型に従うか)。 群ごとのカウント → χ²; two means (normal-ish) → t-test (paired when each row is measured twice); several means → ANOVA; skewed/small-n → rank (non-parametric) 代替案;2つの連続変数 → 相関(ピアソン、または Spearman 順位用)✓。測定スケールが検定を決定する — 結果を見てから 決断すると、不適切な質問を誘発する。
解例 1 — 信頼区間の読み方。 (架空のアブストラクト)RR 1.8, 95 % CI 1.2–3.1:区間が 1 を除外しているため、このレベルではデータは "無効果" と整合しない(p < 0.05 が従う);幅は推定値が 不正確であるが、常に 1 より高いことを示す ✓。 RR 1.8 に CI 0.9–3.6 がある場合、 逆の結論となる — 同じ点推定値でも異なる判定であり、区間だけが 判断を与える。
解例 2 — 臨床的関連:Kaplan–Meier の計算。 (合成データ)10 症例が登録され、6 か月目に 10 人のリスク人群中で 1 件の事象が発生: $S = 9/10 = 0.90$; at 12 months 1 event among the 8 still at risk (one censored): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. Median survival is the time the curve crosses 50 %; censoring removes people from the denominator, 推計の論理に基づくものではない。
一般的な誤り。「p > 0.05 は差がないことを意味する」(これはデータが 差がないことと整合的であることを意味する—証拠の欠如≠欠如の証拠)。 信頼区間を真値がその中に含まれる確率が95 %であるとして解釈する(区間は 手法のプロパティであり、このサンプルの推計に適用される)。選択 p < 0.05 を示す方を見つけてから検定を行う。
要約。 CI = 整合的な真値、大きさや精度を含む;p値 = P(この程度極端なデータ | 帰無仮説);p値だけで「証明された」または「効果なし」とは言えない。 χ²/t/分散分析/順位/相関はデータタイプによって選択され、カプラン・マイヤー曲線—乗算 (1 − 事象/対象外);中央値 = 50 % の交差点。
臨床試験とシステマティックレビュー
重要性。 試験は証明の装置であり、レビューはその 組み立てである—用語(無作為化、ブラインド、ITT、NNT)はすべての 抄録およびフォレストプロットがあなたが知っていることを前提としている。
概念と図。 試験の骨格:適格性 → 無作為化 (偶然による割り当て、割り当ての隠蔽) → ブラインド化 (参加者、 医師、結果評価者) → 意向治療分析による解析 (無作為化通り解析、全員カウント済み) ✓。レビューはフォレストプロットに統合: 四角形 (サイズ=重み)、線 (CI)、ダイヤモンド (統合)、および異質性 $I^2$ ✓.
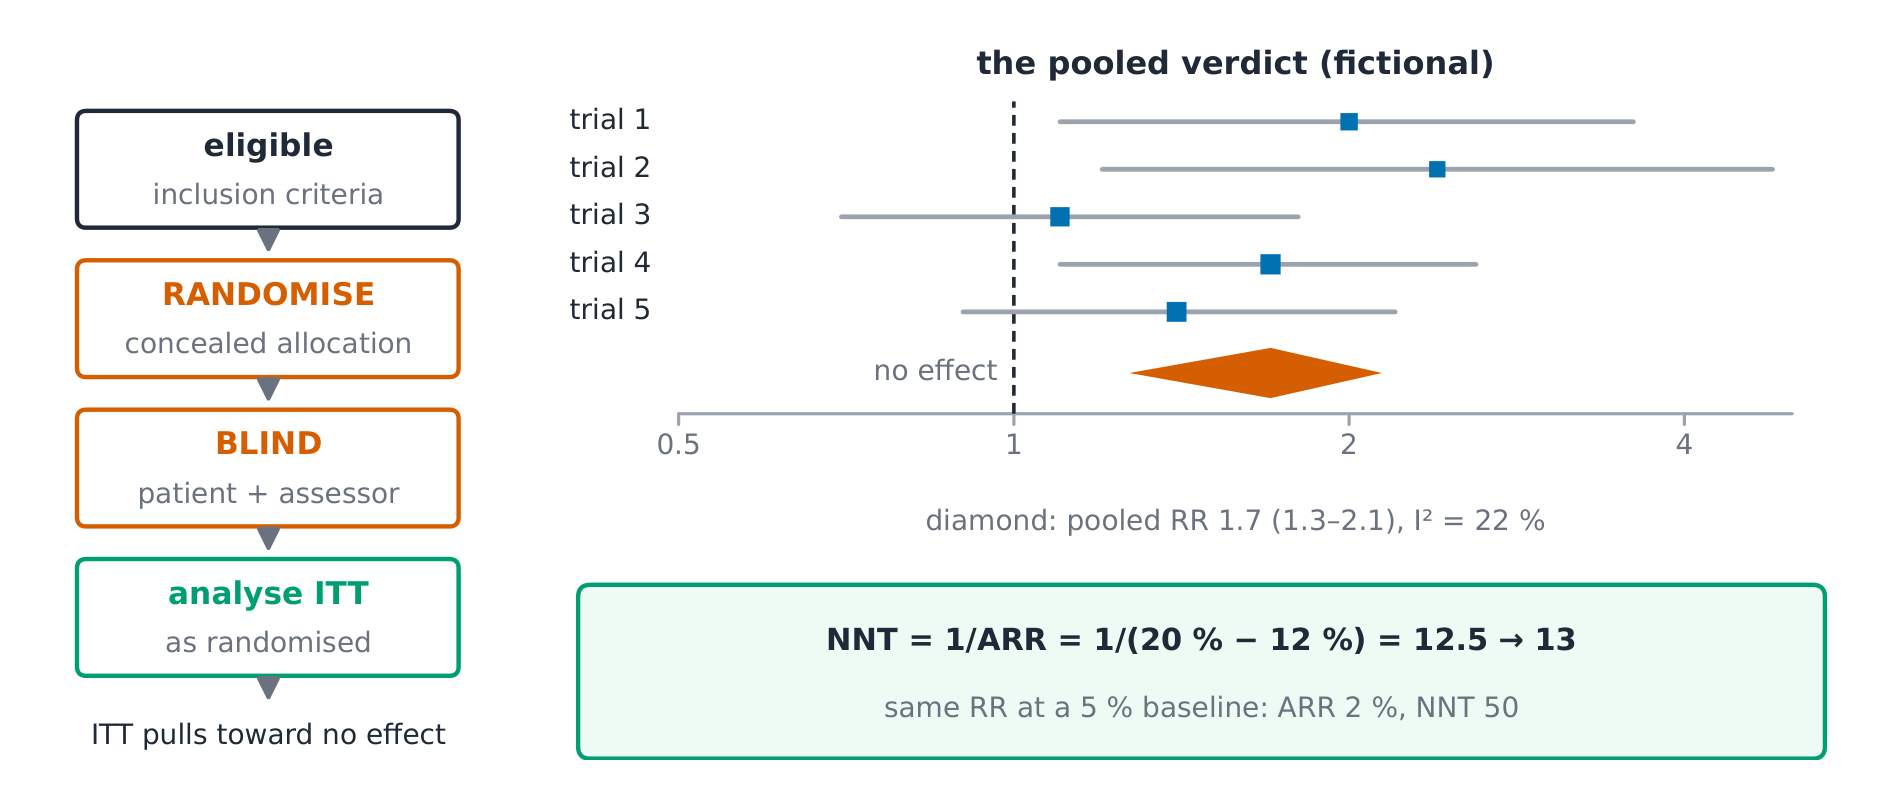
導出(なぜNNTが臨床的効果サイズとなるか)。 NNT = $1/ARR$: 対照群イベント率 20 %, 治療群 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13人に治療することで1人が受益 ✓。NNTは 抽象的な比率を業務量に変換し、その分母(ARR)が ベースラインリスクの低下に伴い縮小するため、 試験結果が低リスクの診療所にそのまま適用されない理由である。
計算例 1 — ITTの論理。 (架空の試験) 20 % 対照 vs 12 % 治療: ARR 8 %, NNT 13 ✓。30 % の治療群が割り当てを 早期に中断した場合でも、ITTでは依然として「治療済み」としてカウントする — 見かけ上の 効果がゼロ方向に希釈される — 質問は服従者の生物学ではなく、割り当てという「政策」だからである ✓。プロトコル順分析は異なる質問に答え、服従バイアスを引き継ぐ。 question and inherits adherence bias.
計算例 2 — 臨床的関連:ダイヤモンドの読み方。 (架空の フォレスト) 5つの試験、個別RR 1.1–2.4 で広い信頼区間、統合RR 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: ダイヤモンドは 1 の右側に位置し、その区間は 1 を除外しており、異質性が低い — 多様な環境で一貫した効果があることを示す。 同じダイヤモンドに $I^2 = 78\ \%$ が含まれる場合、統合の信頼性を確認する前に「なぜこれらの試験は一致しないのか?」と問われる。 disagree?" before any pooling is trusted.
一般的な間違い。 無作為化と盲検を同一視すること(無作為化はグループ間の偶然の均衡を保ち、盲検は期待値の均衡を保つ — 試験はどちらか一方のみを含むこともある)。 グループ化;盲法は期待値を調整する(単独でも可能)。 プロトコル分析を誠実な分析として扱う(無作為化の 保護を破る)。高い異質性にもかかわらず、統合されたダイヤモンドを真実とする。 異質性。
要約。 無作為化(隠蔽)→ ブラインド → 無作為化通り解析(ITT、 帰無仮説方向に希釈);NNT = 1/ARR(20 % → 12 %: ARR 8 %, NNT 13);フォレスト: 四角形加重、ダイヤモンド統合、$I^2$ の不一致;低ベースラインClinicは ARRを縮小し、NNTを増大させる。
批判的評価と証拠の適用
重要性。 証拠がベッドサイドで医学となるまでには、有効性の観点から評価され、 その規模が重要度に応じて判断され、目の前の患者に適合する必要がある。この単元はコース全体の統合である。 概念と図。 評価の骨組み:PICO(対象集団、介入、比較、結果)の枠組み → 有効性(結果に
バイアスがあったか?) → 規模(どの程度大きく、どの程度正確か?) → 適用可能性(私の患者が研究対象集団に類似しているか?) ✓。確度付与(GRADE):無作為化試験の証拠は当初高く、観察研究の証拠は当初低い;バイアスリスク、不整合性、間接性、不正確さ、または出版バイアスのため降格;大きな効果や用量反応勾配がある場合、昇格 ✓。 ピラミッドは各研究の真実ではなく、平均的なバイアスへの感受性をランク付けしたものであり、不良な試験の方が良好なコホートより誤解を招くことがある **導出(なぜ階層が判決ではなく事前分布なのか)。設計 対象集団と類似しているか?)✓。確度評価(GRADE):無作為化 エビデンスは高品質で、観察研究は低品質から始まり、バイアスリスク、 不整合、間接性、不精細さ、または出版バイアスにより降格する; 大きな効果や用量反応勾配がある場合は昇格する ✓。

**導出(なぜ階層が事前推定であり、結論ではないのか)。設計 典型的バイアス制御で異なる:ランダム化は混在因子を調整する 測定済みおよび未測定のもの;コホート研究には混在因子が含まれるが、症例対照法では追加される 想起バイアス ✓。しかし、階層は研究デザインクラスを評価し、最終的な判断 対象となる個別の研究に属する — 小規模でブラインド化されていない、プロトコール分析に基づく 試験よりも、大規模で事前登録されたコホート研究( 傾向スコア調整付き)の方が信頼に値する可能性がある。GRADEが存在するのは、まさにデザインクラスが単なる 出発点に過ぎないからである。
** worked example 1 — 架空の要旨を5つの質問で検証する。** (架空) "無作為化、二重盲検、n = 400; RR 0.75 (0.60–0.94)": 妥当性— 25 を除外しているか;地域的適用性 — 私のような患者が登録されたか(年齢、重症度、 1; 局所適用性—同様の患者(年齢、重症度、 併用薬)が登録されたか?; 成果指標—患者にとって意味あるものか、代替指標か?; 確度— 降格要素はあるか? 5つの質問による構造化された判断 ✓。
クリニックでのベースラインは 2 % である:同じ相対リスク減少率を用いれば、絶対リスク差は 重症疾患での試験(ベースライン 20 %, ARR 8 %, NNT 13); 自らの患者の クリニックのベースラインが 5 %の場合: 相対リスク低下率が同じであれば ARR は $8\ \% \times 5/20 = 2\ \%$ → NNT 50 に換算される ✓。相対効果は ** 一般的な間違い。** 妥当性のみを評価する(妥当だが非常に小さい効果 —局所的である。
一般的な誤り。 妥当性のみを評価すること(妥当だが極めて小さい効果)。 なお、無意味である:サイズと精度が重要さを決定する)。ジャーナルによる評価 またはデザインラベルのみ(GRADEはそこから始まり、証拠の欠陥とともに移動する)。 患者の定義的特徴であった除外基準にグループ平均を適用すること。 除外基準。
要約。 PICO → 妥当性 → サイズ → 適用性;GRADE:デザインから始め、バイアス/一貫性の欠如/間接性/不正確さにより降格し、大きな効果で昇格する;ピラミドは予備的な判断であり、最終的な結論ではない;相対効果は移り変わるが、絶対的利益(ARR、NNT)は局所的である—適用前に再計算すること。 バイアス/一貫性の欠如/間接性/不正確さにより降格し、大きな効果で昇格する;ピラミドは予備的な判断であり、最終的な結論ではない;相対効果は移り変わるが、絶対的利益(ARR、NNT)は局所的である—適用前に再計算すること。 大きな効果で昇格する;ピラミドは予備的な判断であり、最終的な結論ではない;相対効果は移り変わるが、絶対的利益(ARR、NNT)は局所的である—適用前に再計算すること。 移り変わるが、絶対的利益(ARR、NNT)は局所的である—適用前に再計算すること。