השוואת אלגוריתמים ומבני נתונים מופשטים (ADTs) באלגוריתמים
הוצג| English | משמעות |
|---|---|
| Big-O/bɪɡ əʊ/ | סימול Big-O |
| time complexity/taɪm kəmˈpleksɪti/ | מורכבות זמן |
| space complexity/speɪs kəmˈpleksɪti/ | מורכבות מרחב |
| depth-first/depθ fɜːst/ | עומק-תחילה |
| breadth-first/bredθ fɜːst/ | רוחב-תחילה |
| binary tree/ˈbaɪnəri triː/ | עץ בינארי |
האלגוריתם שישרוד את היקום
- פרוס שירותים חייב לבקר ב-25 ערים ולהחזיר לביתו בדרך הקצרה ביותר. ניסוי כל סדר אפשרי מוביל לכ-$10^{23}$ סידורים. מכונה שבודקת מיליארד סידורים בשנייה תימשך שלושה מיליון שנים.
- הוספת עיר נוספת מכפילה את העבודה ב-25. זו לא מחשב שצריך להיות מהיר יותר; זו גישה שלא יכולה לעולם לעבוד, בכל מהירות, על כל חומרה.
- ידיעה לפני כתיבת התוכנית היא מה שניתוח המורכבות מיועד לה. זה ההבדל בין בחירת אלגוריתם לבין גילוי, חודשים מאוחר יותר, שהשל שלך אינו נשקל.
- שיעור זה הוא על Big-OO בזמן ובמרחב, ואופן ש-ADTs מעצבים את האלגוריתמים הבנויים עליהם.
מורכבות זמנית
- מורכבות זמנית מתארת כיצד זמן הריצה גדל בהתאם לגודל הקלט $n$. היא נכתבת בסימון Big-O, שמציג רק את האיבר הדומיננטי ומסיר קבועים.
- $O(1)$ קבוע, הזמן אינו תלוי כלל ב-$n$. $O(\log n)$ לוגריתמי, כמו בחיפוש בינארי. $O(n)$ ליניארי, כמו בחיפוש ליניארי. $O(n \log n)$, המיון הטוב. $O(n^2)$ ריבועי, כמו במיון בועה ובמיון הכנסה.
- הסיבה להורדת קבועים: הם מאבדים חשיבות. אלגוריתם $O(n^2)$ עשוי לעלות על אלגוריתם $O(n \log n)$ עבור $n = 10$, אך ב-$n = 10{,}000$ שום דבר בקשר לקבועים לא יוכל להציל אותו.
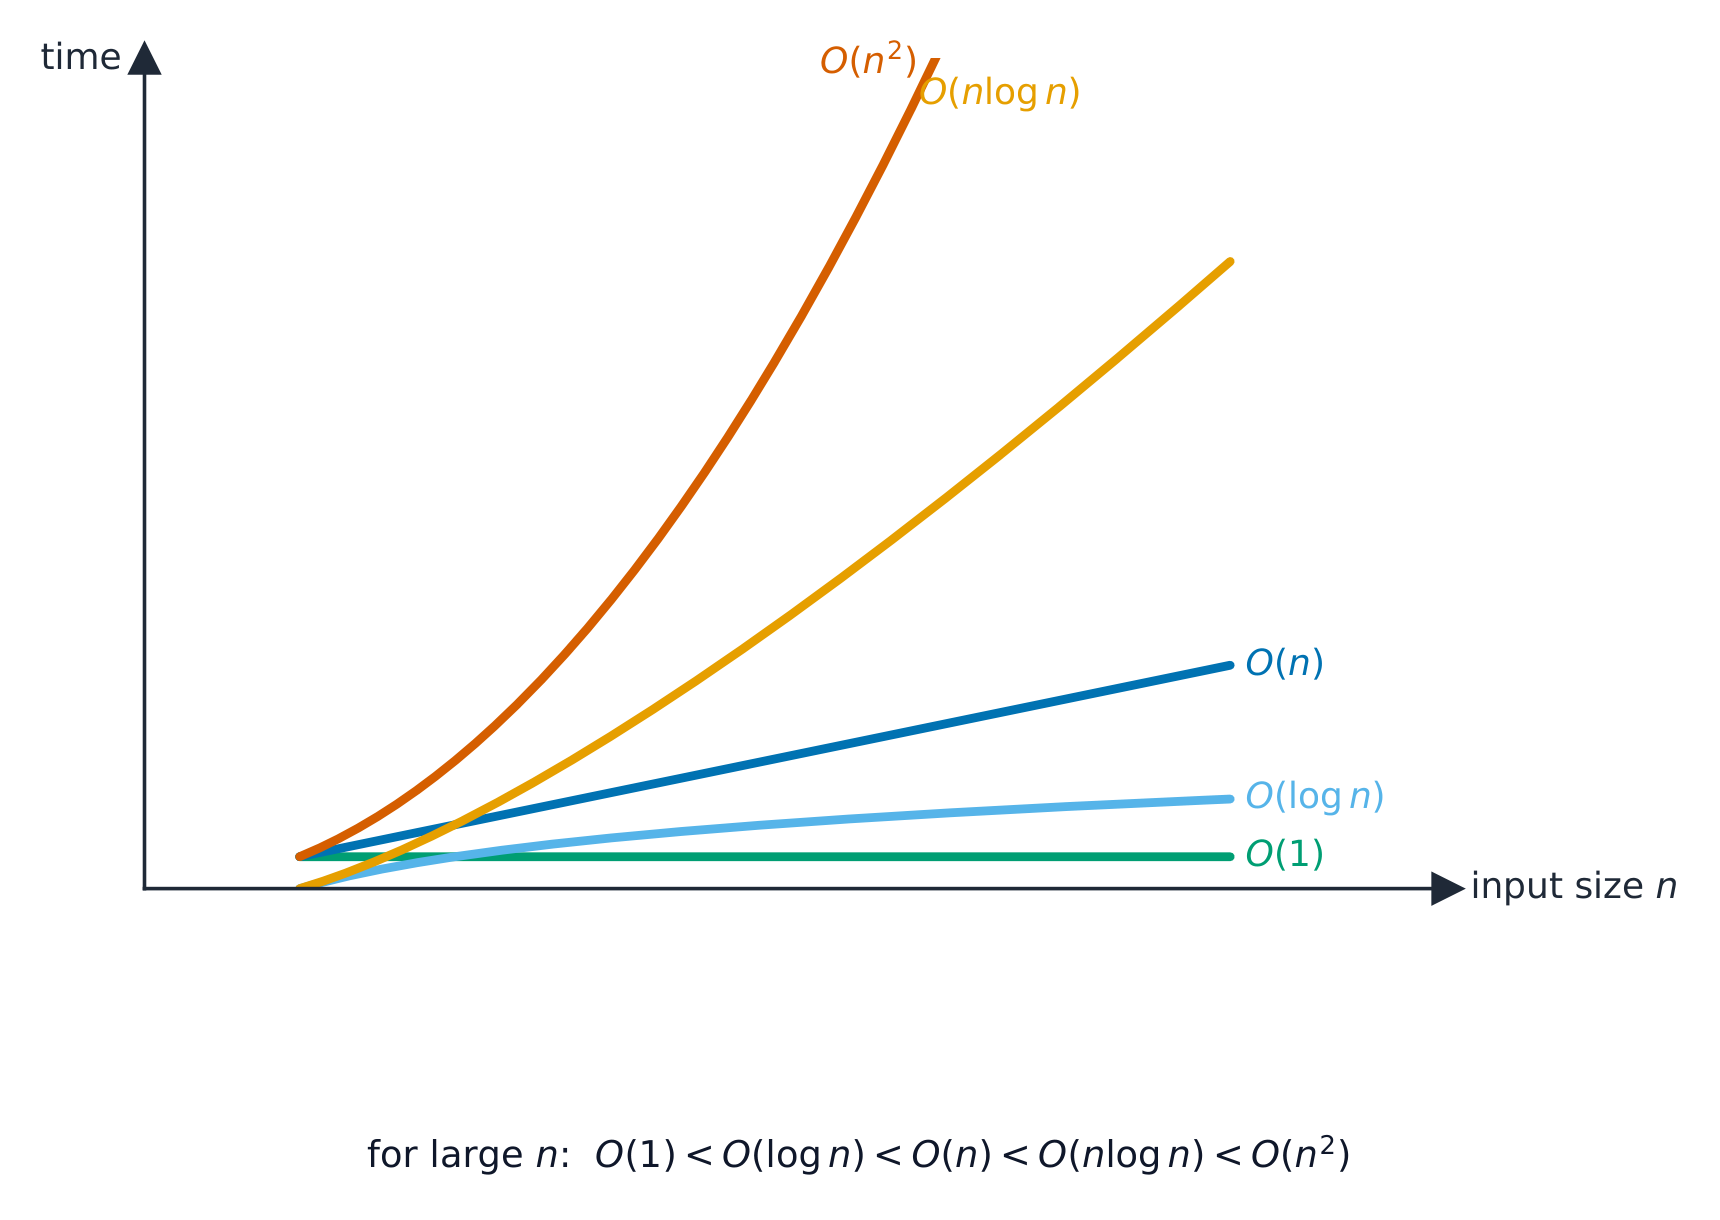
העקומים נחתכים פעם אחת, ואחרי כך הסדר קובע הכל
כיצד זמן הרצה גדל עם גודל n
הזזו את ציר ה-n כלפי מעלה והשוו בין העקומות: O(1) ו-O(log n) נשארים כמעט שטוחים, O(n) עולה באופן רציף, ו-O(n²) מתפוצץ. זוהי הסיבה לכך ש-Big-O — ולא סופר זמן בפועל — הוא הכלי להשוואת אלגוריתמים על קלט גדול.
איזה סימון Big-O מתאר חיפוש בינארי?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
חילווק הטווח בכל שלב הוא לוגריتمي — O(log n).
איזה סימון Big-O מתאר מיון בועות במקרה הגרוע ביותר?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
שני לולאות מקוננות על פני n אלמנטים נותנות O(n²).
התאמו כל אלגוריתם למורכבות הזמן שלו.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
חיפוש ליניארי הוא O(n), חיפוש בינארי הוא O(log n), ומיון בועות הוא O(n²).
דוגמה פתורה: מה קורה כשמשלמים את הקלט
- אלגוריתם לוקח 4 שניות עבור 1,000 פריטים. העריך את הזמן עבור 2,000 פריטים אם האלגוריתם הוא $O(n)$, ולאחר מכן אם הוא $O(n^2)$.
- $O(n)$: השלמת $n$ משלמת את הזמן, אז כ-8 שניות.
- $O(n^2)$: השלמת $n$ מארבע פי את הזמן, אז כ-16 שניות. ב-10,000 פריטים זה יהיה פי 100 מהמקורי, כ-400 שניות.
- $O(\log n)$ יוסיף רק שלב אחד, ו-$O(1)$ לא ישתנה כלל. חשב לפי הסדר, לא לפי נוסחה.
אלגוריתם בעל מורכבות O(n squared) לוקח 4 שניות על 1,000 פריטים. בקירוב, כמה שניות ייקח לו על 2,000?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
הכפלת n מארבע פעמים את זמן הרצה של אלגוריתם O(n squared). אותה הכפלה הייתה גורמת לאלגוריתם O(n) לעבור מ-4 שניות ל-8.
מורכבות זיכרון
- מורכבות זיכרון היא הזיכרון הנוסף שהאלגוריתם צריך, מעבר לקלט עצמו.
- מיון בועות ומיון הכנסה משתמשים ב-$O(1)$ זיכרון נוסף: הם עובדים במקום, וצריכים רק מספר בודד של משתנים. מיון מיזוג משתמש ב-$O(n)$, שכן הוא בונה מערך שני.
- רקורסיה משתמשת בזיכרון סטק proportionale ל-עומק שלה, כי כל קריאה שלא הושלמה שומרת את הפרימה שלה.
- לעיתים קרובות יש מערכת גישוי בין זמן לזיכרון: אחסון תוצאות כדי למנוע חישוב מחדש, כפי שעושה ממוזציה, קונה מהירות על חשבון זיכרון.
מה עוד קובע את הבחירה
- Big-O עוסק בצמיחה, ולא במהירות מוחלטת. עבור $n$ קטן, אלגוריתם פשוט $O(n^2)$ יכול להפגין ביצועים טובים יותר מאלגוריתם מורכב $O(n \log n)$, וכן הוא קל יותר לכתיבה נכונה.
- יציבות חשובה כאשר רשימה מסודרת כבר לפי שדה אחר. פשיטות חשובה כי לאלגוריתם פשוט יש פחות מקומות להסתיר בהם באג.
- התשובה הכנה לשאלה "איזה אלגוריתם" לעיתים קרובות מייfera גם את הסדר וגם את התנאים: זה, כי $n$ גדול והנתונים מגיעים לא מסודרים.
מיון "in place":
Difficulty 1/5 · 100 coins + a small bonus on first completion today
אלגוריתמי in-place (כמו מיון בועות ומיון השחזור) מבצעים מיון בתוך המערך המקורי, תוך שימוש במרחב נוסף קבוע.
מדוע מורכבות המרחב של מיון בועות היא O(1) גם שהוא מסדר מערך של n פריטים?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
הוא ממוין מקומית. מיזוג (Merge sort) הוא O(n) משום שהוא בונה מערך נוסף, והריקורסיה דורשת זיכרון פרופורציונלי לעומק.
סוגי נתונים מ추적 בתוך אלגוריתמים
- סוגי הנתונים המ추ت from topic 10 הם הבסיס שממנו בונים אלגוריתמים, ובחירה באחד מהם מעצבת את האלגוריתם.
- ערימה (stack) מאפשרת חיפש בעומק: דוחפים את השכנים, לוקחים את האחרון שהווסף, והחיפש צולל לאורך מסלול אחד לפני שחוזר. רקורסיה משתמשת בערימת הקריאות בדיוק עבור מטרה זו.
- תור (queue) מאפשר חיפש רחב: מדחסים את השכנים לתור, לוקחים את הישן ביותר, והחיפש מתפשט החוצה בטבעות, וזהו המנגנון הממצא את הדרך הקצרה ביותר בגרף שאינו משוקל.
- עץ בינארי שומר על ערכים בסדר כך שחיפוש יפסל מחצית מהצמתים הנותרים בכל שלב, ומניב את $O(\log n)$ לחיפש בינארי על מבנה שיכול גם לגדול.
אילו טענות על Big-O הן נכונות? סמן את כולן החלופות הרלוונטיות.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Big-O אינו אומר כלום בשניות; מדובר בצמיחה. לכן קיים נקודת חצייה עם אלגוריתם פשוט יותר בגדלים קטנים.
דוגמה פותרת: אותו גרף, שני חיפושים
- מבוכה נחקרת מכניסה אחת. השוו בין השימוש בערימה לבין השימוש בתור.
- עם ערימה, המסלול שנמצא לאחרונה הוא זה שנחקר קודם לכן, ולכן החיפש חודר לעומק לאורך מסלול אחד עד למפגש סתימה, ואז חוזר אחורה. הוא משתמש בזיכרון פרופורציונלי לעומק המסלול.
- עם תור, המסלול שנמצא הראשון הוא זה שנחקר קודם לכן, ולכן החיפוש בודק כל מה שמרחק של צעד אחד, ולאחר מכן כל מה שמרחק של שני צעדים. הוא מוצא את הדרך הקצרה תחילה, אך שומר בכל הזיכרון כל המיקום במרחק הנוכחי.
- קראו את שם סוג הנתונים, קראו את הסדר הנגזר מהחקירה, וקראו את ההשלכה.
ערובה (LIFO) מניעה באופן טבעי תנועה בעומק, בעוד תור (FIFO) מניעה חיפוש רחב.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
ה-ADT שתבחר קובע את סדר החיפוש — ערובה חודרת עמוק קודם, תור חוקר ברמה אחת ואחת.
התאם כל ADT לחיפוש שנוצר ולתוצאה שלו.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
האחרון שנכנס ראשון יוצא, או הראשון שנכנס ראשון יוצא. בחירה זו יחידה קובעת האם החיפוש יהיה בעומק או רחב.
סימונים נופלים מהיד
- Big-O מתאר גידול בהתאם לגודל הקלט, לא שניות. "זה מהיר" אינו תשובה להסתכלות על מורכבות.
- הכפלת הקלט כופלת זמן של $O(n)$ וכופלת ארבע פעמים זמן של $O(n^2)$. יש להסיק זאת מהסדר הגדילה.
- מורכבות מקום היא הזיכרון הנוסף, ולכן מיון in-place הוא $O(1)$ גם אם גודל המערך הוא $n$.
- ערימה נותנת חיפש בעומק, תור נותן חיפש רחב. קבלת הזוג הזה בסדר הנכון היא עניין של שלם מספר שאלות.
הבנתך מושלמת
- מורכבות זמן ב-Big-O מתארת גידול בהתאם ל$n$: $O(1)$, $O(\log n)$, $O(n)$, $O(n \log n)$, $O(n^2)$; קבועים מוותרים כי בקנה מידה גדול הסדר הוא הקובע
- הכפלת $n$ כופלת $O(n)$ וכופלת ארבע פעמים $O(n^2)$; נקודת החיתוך עם אלגוריתם "פחות טוב" קיימת רק עבור קלט קטן $n$
- מורכבות מקום היא הזיכרון הנוסף: מיונים in place הם $O(1)$, merge sort הוא $O(n)$, ורקורסיה דורשת עומק ערימה
- ערימה נותנת חיפש בעומק, תור נותן חיפש רחב, ועץ בינארי מחצית את הצמתים הנותרים בכל שלב