מה הקורס הזה הוא, וכיצד להשתמש בו
זהו הקורס השנים עשר ברפואה אוניברסיטאית: אפידמיולוגיה, biostatistics and evidence-based medicine (EBM) — כלי העבודה שממיר שאלות קליניות למספרים ומספרים ל החלטות. הוא מקביל לחומר UNI-BUS-05 בסטטיסטיקה שנבדק שבו המתמטיקה חופפת.
גבול היקף, מצוין פעם אחת: קורס לימודים, לא תואר רפואי; כל הנתונים למטה הם סינתטיים או מורשים לשימוש פתוח, כל תקציר מוערך הוא דיוני, ואין כאן רשות או הדרכה לטיפול.
- יחידות 12.1–12.3 מודדות ומשוות: תדירות מחלה, עיצובי מחקר, הטיות וסיבתיות.
- יחידות 12.4–12.6 כמותיות: בדיקות אבחנת, מסקנות, ניסויים וסקירות.
- יחידה 12.7 מיושמת: הערכה, ודאות והמטופל שמולך.
רגל EBM: שאלו לפי PICO, מדדו סיכונים ומשוונו, החלטו באמצעות רווחים לא טקסים — כל החישוב למטה הוא סינתטי, נבדק על ידי מכונה, ודבר שתחזר לחשב.
מדידת מחלה: תחלואה ותפוצה
מדוע זה חשוב. לפני כל השוואה, יש לספור מחלות — והספירה הקלאסית הזוגית עונה לשאלות שונות: כמה מהר מקרים חדשים מופיעים, וכמה קיימים בו-זמנית.
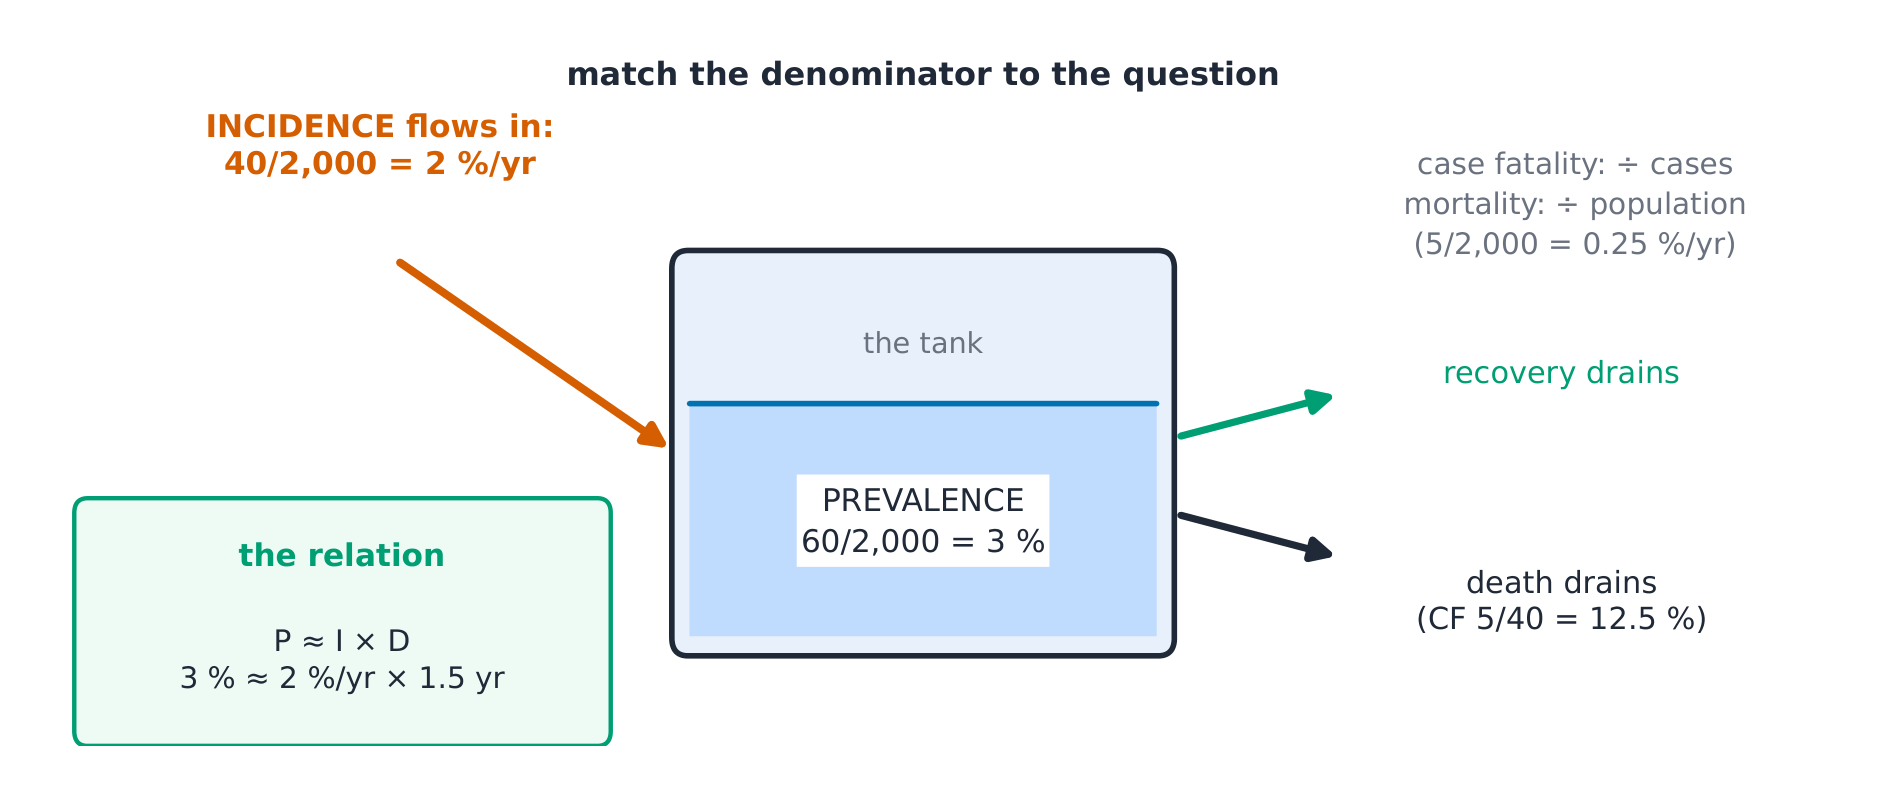
הרעיון, עם איור. תחלואה = מקרים חדשים ÷ אנשים בסיכון ÷ זמן; תפוצה = מקרים קיימים ÷ אוכלוסיה ברגע תת-רגעי ✓. הן קשורות: תפוצה ≈ תחלואה × משך מחלה — מחלות ארוכות צוברות, קצרות נעלמות בין סקירות. תחלואה ממלאת את המכל; ריפוי ותמותה מרוקנים אותו — התפוצה היא מפלס המים
 הגזירה (למה קיים הסטנדרטיזציה). קצבים גסים מערבלים שני
אפקטים: סיכון למחלה ומבנה גיל האוכלוסייה. אזור עם יותר תושבים מבוגרים יכול להראות קצב גבוה יותר עם קצבי תת-גיל נמוכים יותר ✓. סטנדרטיזציה ישירה מיישמת את קצבי התת-הגיל של כל קבוצה לאוכלוסייה סטנדרטית אחת וחוסמת — הסך הכל המלאכותי ניתן להשוואה כי אוכלוסיות סטנדרטיות וסכומים — הסך המלא המלאכותי הוא ניסיוני מכיוון ש- התערובת הגילית היא כעת זהה.
דוגמה מופעלת 1 — עיר סינתטית. 2,000 תושבים, שנה אחת, 40 מקרים חדשים מקרים של מחלה → הדבקה 40/2,000 = 2 % בשנה ✓. ביום הסקר 60 אנשים סבלו מהמחלה → התפשטות נקודתית 60/2,000 = 3 % ✓. בדוק את הקשר: 3 % ≈ 2 %/שנה × 1.5 שנים ממוצע משך מחלה — המספרים הם מערכת יציבה.
דוגמה מופעלת 2 — קשר קליני: שלוש פני המוות. (נתונים בדיוניים) dataset) of the 40 new cases, 5 died within the year: case fatality 5/40 = 12.5 % ✓; מספר המתים בשנה מסיבה זו בכל העיר היו 5/2,000 = 0.25 % (שיעור תמותה ספציפי לסיבה); ואם העיר דיווחה על 20 מתים מ- כל הסיבות בשנה זו, מחלה זו גרמה ל-5/20 = 25 % מהם (מפרופורציה אותם מתים, שלושה מכנים, שלוש שאלות שונות.
טעויות נפוצות. כינוי התפשטות כשיעור (זו proportion – אין יחידת זמן). השוואת שיעורים גסים בין אוכלוסיות בעלות מבנה גיל שונה (יש לסטנדרטית קודם). קריאת שיעור תמותה מקרי כתמותה (המכנה הוא מקרים, לא אנשים). סיכום. Incidence = חדשים/בסיכון/זמן; Prevalence = קיימים/אוכלוסייה;
P ≈ I × D; סטנדרטיזציה תיקן את התערובת הגילית; שיעור תמותה מקרי (מקרים), תמותה ספציפית לסיבה (אוכלוסייה), תמותה פרופורציונלית (כל המתים) – התאימו את המכנה לשאלה. המכנה לשאלה.
עיצובי מחקר
למה זה חשוב. לכל שאלה קלינית יש עיצובים שמשיבים עליה היטב, ועיצובים שאינם יכולים — בחירת העיצוב היא בחירה של אילו סטייות תצטרכו להתמודד. ועיצובים שלא יכולים — בחירת העיצוב היא בחירה של אילו סטייות תצטרכו להתמודד. ותצטרכו להתמודד.
הרעיון, עם תמונה. הסולם: ניסוי מקרי (ניסוי) → קורט (מעקב אחרי חשופים ולא-חשופים קדימה) → מקרה-בקרה (מבט לאחור מתוצאה) → צולחת (תמונה אחת) → אקולוגי (קבוצות, לא פרטים) ✓.
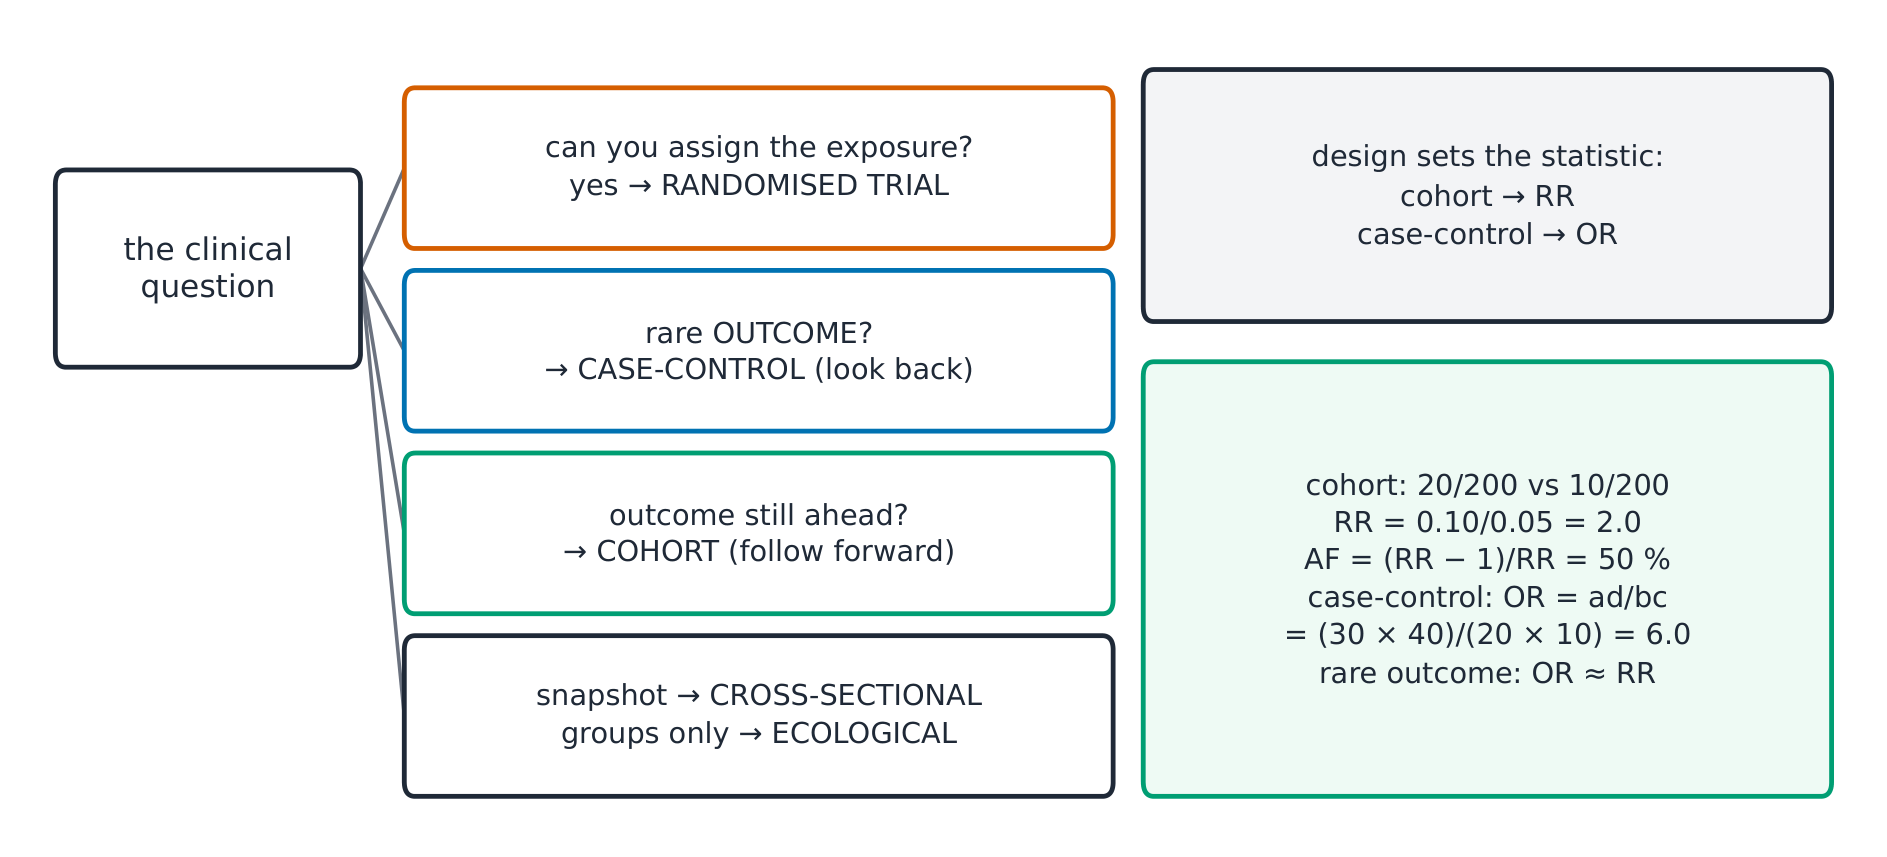
הגזירה (למה RR משתייך לקורטים ו-OR למקרה-בקרה). קורט cohort samples by EXPOSURE, so risks in each arm are estimable: relative risk $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. A case-control samples by OUTCOME, so the "risk" in each arm is an artefact of the sampling ratio — only the odds ratio $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ is valid ✓. The design dictates the statistic, not preference.
Worked example 1 — one synthetic cohort. Exposed 200, 20 events; unexposed 200, 10 events: risks 0.10 vs 0.05 → $RR = 2.0$ ✓, attributable שבר בקרב החשופים $(RR-1)/RR = 50\ \%$ ✓ — אירועי קבוצת החשופים הם חצי "עקב" החשיפה בהנחות.
דוגמה מפורטת 2 — קישור קליני: המראה המקרה-שליטה. (דמיוני) 30 מ-40 מקרים חשופים; 20 מ-60 בקרות חשופות: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. תוצאה נדירה גורמת ל-OH לקרוב ל-RR — מספר אחד, שני עיצובים, והדגימה קובעת איזה חוקי.
טעויות נפוצות. חישוב RR ממחקר מקרה-בקרה (המכנים נבחרים על ידי החוקר, ולא מתקבלים). קריאת אודדס רצף כגורם סיבתי (חשיפה ותוצאה הן בו זמנית). שוויון "פרוספקטיבי" עם "טוב יותר" (קוהורט פרוסקטיבי עדיין מעורבל; רק הקצאה אקראית מאזנת את הלא ידוע).
סיכום. ניסוי → קוהורט (RR) → מחקר מקרה-בקרה (OR) → רצף → אקולוגי; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; דגימות קוהורט לפי חשיפה, מחקר מקרה-בקרה לפי תוצאה; OR למחלה נדירה ≈ RR; שבר תלותי $(RR-1)/RR$.
טיעון, מעורבות וסיבתיות
למה זה חשוב. מספרים משקרים בשלושה דרכים: באופן שיטתי (טיעון), דרך משתנה שלישי (מעורבות), ובדרך קשר ללא סיבה. כינוי מצב הכשל הוא חצי מהערך הביקורתי.
הרעיון, עם תמונה. טיעון הוא שגיאה שיטתית בעיצוב או במדידה: טיעון בחירה (מי נכנס), טיעון מידע/זיכרון (מה נשמר או נרשם). מעורבות היא משתנה שלישי הקשור ל כל החשיפה והתוצאה המציגה עצמה כגורם סיבתי ✓.
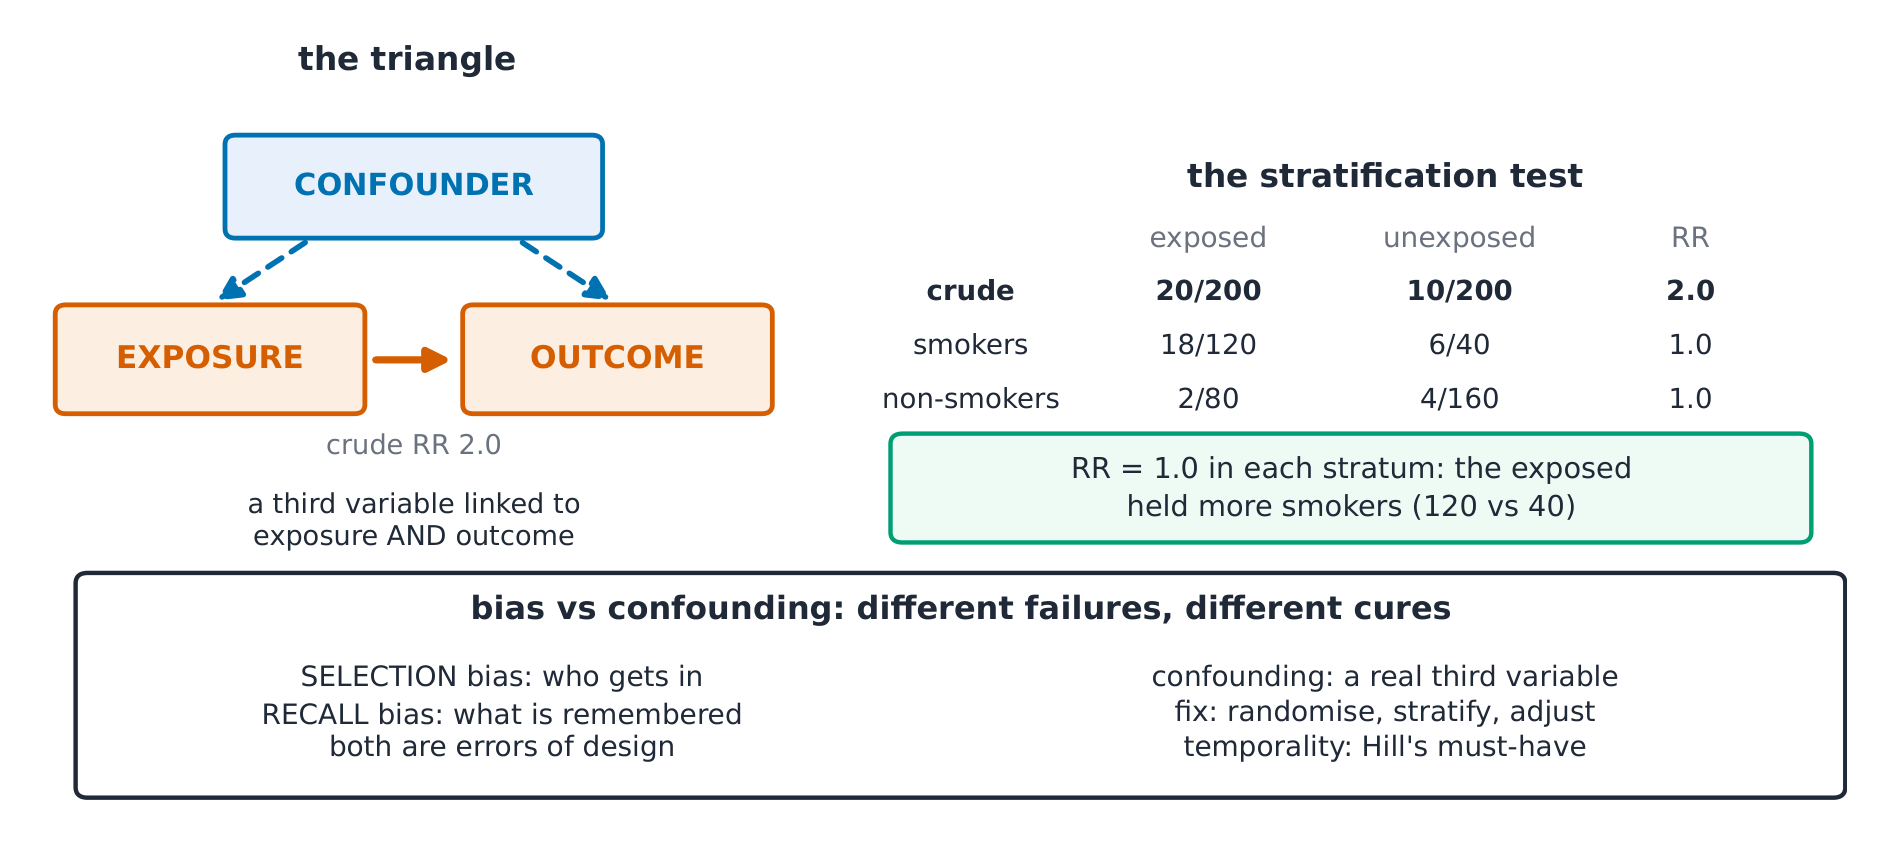
המסקק (למה השכבה היא ההוכיח). אם משתנה שלישי הוא הגורם האמיתי, הקשר אמור להיעלם בתוך שכבות שבהן הוא קבוע: גס $RR$ 2.0, אך בתוך לא-מעשנים $RR$ 1.0 ובתוך מעשנים $RR$ 1.0 → עישון היה משנה הבלעה ✓. אם הקשר נשמר בתוך שכבות (למשל 2.0 ו1.9), החשיפה שומרת על האות שלה. אקראיזציה מונעת היבלה פרוספקטיבית על ידי איזון גם של המשתנים הלא ידועים ✓.
דוגמה מופרשת 1 — הטבלה השכבתית. (סינתטית) גס: חשופים 20/200 מקרים לעומת לא-חשופים 10/200 → RR 2.0. שכבת לפי עישון: לא-מעשנים 6/100 לעומת 3/100 (RR 2.0 ✓ בתוך), מעשנים 14/100 לעומת 7/100 (RR 2.0) — הקשר שומר על עצמו לאחר השכבה: העישון לא היה גורם היבלה כאן; אות החשיפה עומד. כעת תן לטבלה הגסה אותה חלוקה אחרת — חשופים: 120 מעשנים (18 מקרים) ו80 לא-מעשנים (2 מקרים); לא-חשופים: 40 מעשנים (6 מקרים) ו160 לא-מעשנים (4 מקרים). הסיכון במעשנים הוא 15 % בשני הזרמים ו אחוזי לא מעשנים 2.5 בשתי הקבוצות, כך ש-RR הוא 1.0 בתוך כל שכבה: ה החשופים פשוט הכילה יותר מעשנים, ועישון WAS גורם היבלה ✓. טבלה גסה אחת, שתי פסקאות — רק השכבות יכולות להבחין ביניהן.
דוגמה מופרשת 2 — קשר קליני: שאלות ההערכה. (בדיוני תקציר) "שתיים בעלי סיכון פי שניים": שאל מי נכלל בלמידה (בחירה), איך נמדדה החשיפה (זיכרון — מטופלים עם מחלה זוכרים אחרת), ומה שמשנה הבלעה צריכה להיראות כמו (קשורה לקפה AND לקוטר, כמו עישון). נקודות מבט של ברדפורד היל — תחילה זמן, אחר כך חוזקה, עקביות, תגובה למינון, סבירות — הופכים כותרת לרשימת ביקורת ✓.
טעויות נפוצות. טיפול בהבלעה ובטיית מדידה כאחד בעיה (הבלעה היא התערבבות השפעות דרך משתנה שלישי, פותרת על ידי אקראיזציה, שכבתיות או התאמה; בחירה ומידע טיית מדידה הן שגיאות במי שנחקר וכיצד הדברים נמדדים, שלא כל ניתוח מתקן במלואו). לצפות שהנתונים הגדולים יפתרו את ההבלעה (דיוק מוגבר סביב הערכה מוטעת). דרישה לכל נקודת מבט של היל (הן נקודות מבט, לא כרטיס נקודות; הזמן הוא היחיד שאין לוותר עליו).
סיכום. טיית מדידה = שגיאה שיטתית (בחירה, מידע/זיכרון); משנה הבלעה = משתנה שלישי בשני מסלולים; בדיקת השכבתיות מאפסת את הקשר אם יש הבלעה; אקראיזציה מאזנת את הלא ידוע; נקודות נקודות מבט עם תחלוקת זמן ראשונה.
בדיקות אבחנתיות
למה זה חשוב. המספרים של בדיקה אינם תכונות שלה בלבד — רגישות וספציפיות שייכות לבדיקה, אך ערכים נבויים שייכים לאוכלוסייה המשתמשת בה. טעות בקריאה זו היא השכיחה ביותר בכמותי שגיאה בסיכום קליני.
הרעיון, עם תמונה. ה-2×2: רגישות = a/(a+c) (חולה, תוצאת בדיקה חיובית); ספציפיות = d/(b+d) (בריא, תוצאת בדיקה שלילית); PPV = a/(a+b), NPV = d/(c+d) — ועץ התדירות הטבעית מראה מדוע ההפרבליות משנה את הערכים המנבאים ✓.

הגזירה (למה ההפרבליות דורשת את ה-PPV). PPV = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. כאשר Se = Sp = 90 %: בהפרבליות 10 %, ה-PPV = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — גם בדיקה מצוינת היא זריקת מטבע בקליניקה בעלת הפרבליות נמוכה. הזרוע של החיוביים השוואיים מתרחבת יחד עם הרוב הבריא.
דוגמה פתורה 1 — עץ התדירות הטבעית (סינתטי). 1,000 אנשים, הפרבליות 10 %: 100 חולים → 90 חיוביים אמיתיים, 10 שליליים שגויים; 900 בריאים → 810 שליליים אמיתיים, 90 חיוביים שגויים ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. אותה בדיקה בהפרבליות 1 %: 9 TP מול 99 FP → PPV 9/108 = 8.3 % ✓ — עץ אחד, עולמות שניים.
דוגמה פתורה 2 — קשר קליני: יחס האפשרויות נוסע. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: תוצאה חיובית כופלת את הא odds לפני הבדיקה by 9 whatever the clinic's prevalence. Pre-test odds 1:9 (10 %) → post-test הבדיקה 9:9 = 1:1 → הסתברות 50 % — אותו PPV, גזור בשורה אחת. יחסי אפשרויות (LRs) הם הצורה הנשיאתית של הבדיקה; הערכים המנבאים הם מקומיים.
טעויות נפוצות. ציון רגישות כ"הבדיקה נכונה ב-90 %" (זה לא נכון ל-90% מהחולים — נניח, למשל, ממה). שימוש ב-PPV טקסטואלי ל מרכז רפואי עם תפוצה שונה. בלבול בין העמודות (רגישות נקראת בעמודת החולים; ספציפיות בעמודת הבריאים).
סיכום. Se = a/(a+c), Sp = d/(b+d) — מאפייני המבחן; PPV/NPV — מאפייני אוכלוסייה, משתנים בהתאם לתפוצה; עצים בתדירות טבעית הופכים את זה לנראה; $LR+ = Se/(1-Sp)$ מכפיל סיכויים בצורה ניידת (0.9/0.1 = 9); 50 % PPV על רקע תפוצה של 10% למרות Se = Sp = 90%.
היסק סטטיסטי לנתונים קליניים
למה זה חשוב. ההסק היא האופן שבו דגימה מדברת על האוכלוסייה — ושגיאות קריאה שגויות של ערכי p ומוצרים סבירות הן השגיאות האופייניות של הספרות המודרנית.
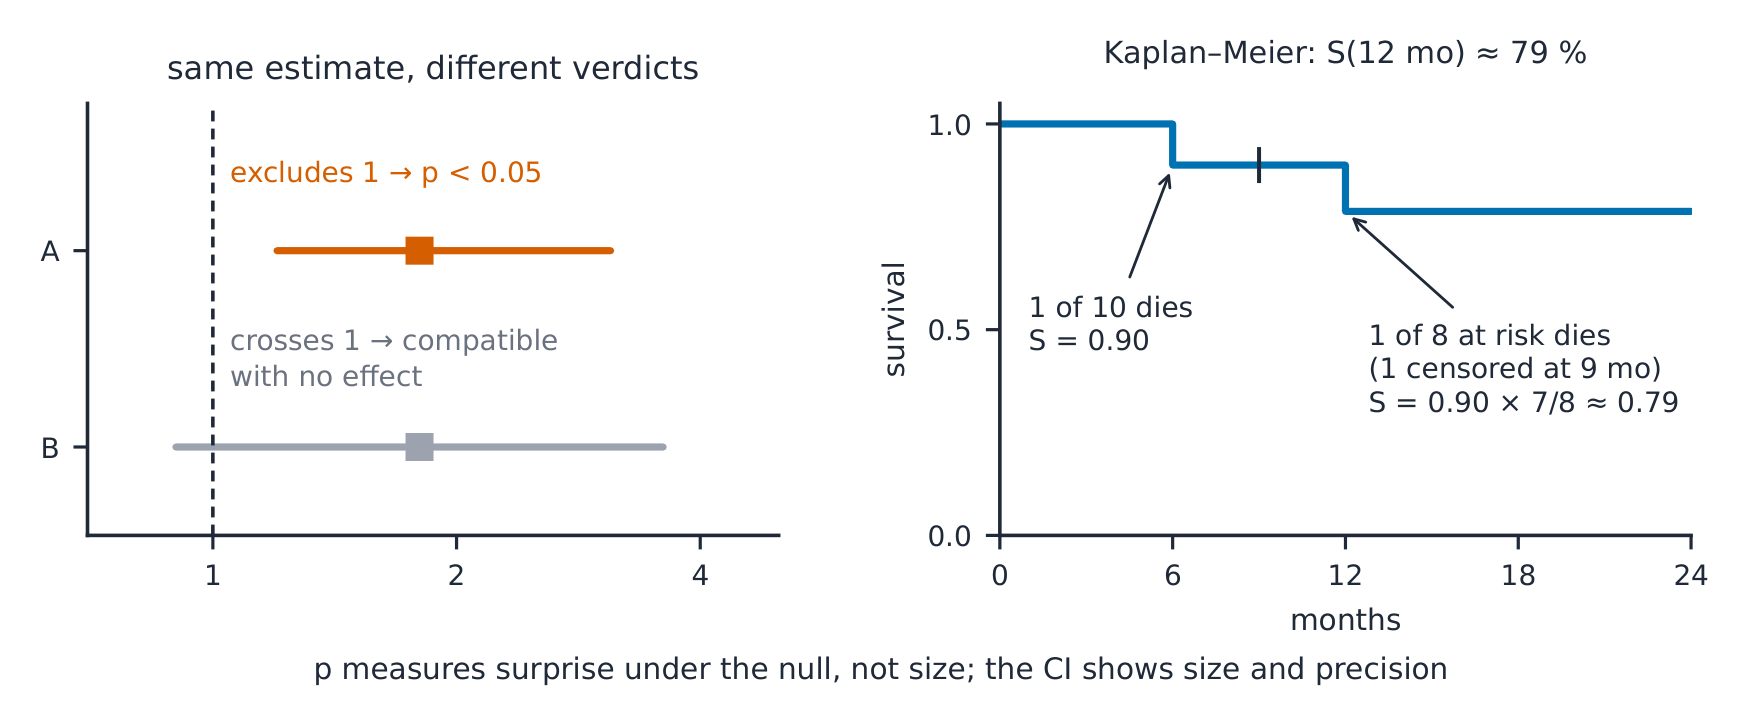
הרעיון, עם איור. מוצר סבירות של 95% הוא הטווח של ערכים אמיתיים התואמים לנתונים ברמה זו; ערך p P הוא הסבירות לקבל נתונים אלו או חריגים יותר אם הנחת האפס הייתה נכונה ✓. מוצר הסבירות מסכם גודל ודיוק; ערך p רק מסכם הפתעה.
הגזירה (למה הבדיקה עוקבת אחרי סוג הנתונים). ספירות לפי קבוצה → χ²; שתי ממוצעים (קרובים לנורמלי) → בדיקת t (מוצעת כאשר כל שורה נמדדת שתי פעמים); מספר ממוצעים → ANOVA; פונדמנטלי/גודל דגימה קטן → דירוג (לא פרמטרי) חלופיות; שתי מדידות רציפות → קורלציה (פירסון, או ספירמן לדירוגים) ✓. קנה המידה קובע את המבחן — החלטה לאחר בדיקת התוצאות מעודדת השאלה הלא נכונה.
דוגמה פתורה 1 — קריאת מרווח אחד. (סיכום בדיוני מדומה) RR 1.8, 95 % CI 1.2–3.1: המרווח אינו כולל 1, ולכן הנתונים אינם תואמים "אין אפקט" ברמה זו (p < 0.05 נובע); הרוחב מצביע על כך שההערכה אינה מדויקת אך עולה באופן עקבי מעל 1 ✓. RR 1.8 עם CI 0.9–3.6 מציע הפך גמור — אותו הערכה נקודתית, מסקנה שונה, והמרווח בלבד מספק את המידע.
דוגמה פתורה 2 — קשר קליני: האריתמטיקה של Kaplan–Meier. (סינתטי) 10 חולים נכללו; ב-6 חודשים 1 אירוע מתוך 10 בסיכון: $S = 9/10 = 0.90$; ב-12 חודשים 1 אירוע מתוך ה-8 שנותרו בסיכון (אחד נצנץ): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. הישרדות ממוצעת היא הזמן שהעקומה חוצה 50 %; צנזורה מסירה אנשים מהמכנה, ולא מהלוגיקה של ההערכה עצמה.
שגיאות נפוצות. "p > 0.05 משמעו שאין הבדל" (זה אומר שהנתונים compatible with no difference — absence of evidence ≠ evidence of absence). Reading the CI as a 95 % probability the truth lies inside (the interval is תכונה של השיטה, הנוגעת להערכת הדוגמה הספציפית זו). בחירת הבדיקה לאחר ראיית מה נותן p < 0.05.
סיכום. CI = תחומי סמך, משקף גודל ומדויקות; ערך p = P(נתונים אלו או קיצוניים יותר | הנחה אפסית); לעולם לא "הוכח" או "אין אפקט" מתוך ערך p בלבד; χ²/t/ANOVA/rank/correlation נבחר לפי סוג הנתונים; העקומה של קפלן-מייר- מכפלת (1 − אירועים/בסיכון); ממוצע = 50 % חוצה.
ניסויים קליניים וסקירות מערכתיות
למה זה חשוב. ניסויים הם מנגנון ההוכחה וסקירות הן ה הרכבה שלהן — המילון (הקצאה אקראית, עיוורון, ITT, NNT) הוא מה שכל תקציר וכל פלט פורסט מניח שהיידע.
הרעיון, עם איור. עמוד השדרות של ניסוי: התאמות → הקצאה אקראית (הקצה באמצעות מזל, הסתרת הקצאה) → עיוורון (משתתף, רופא, מעריך תוצאות) → ניתוח לפי כוונה לטיפול (ניתוח כפי שהוקצה, כולם נספרו) ✓. סקירות מצטרפות לפלט פורסט: ריבועים (גודל = משקל), קווים (CI), יהלום (מצטבר), והטרוגניות $I^2$ ✓.
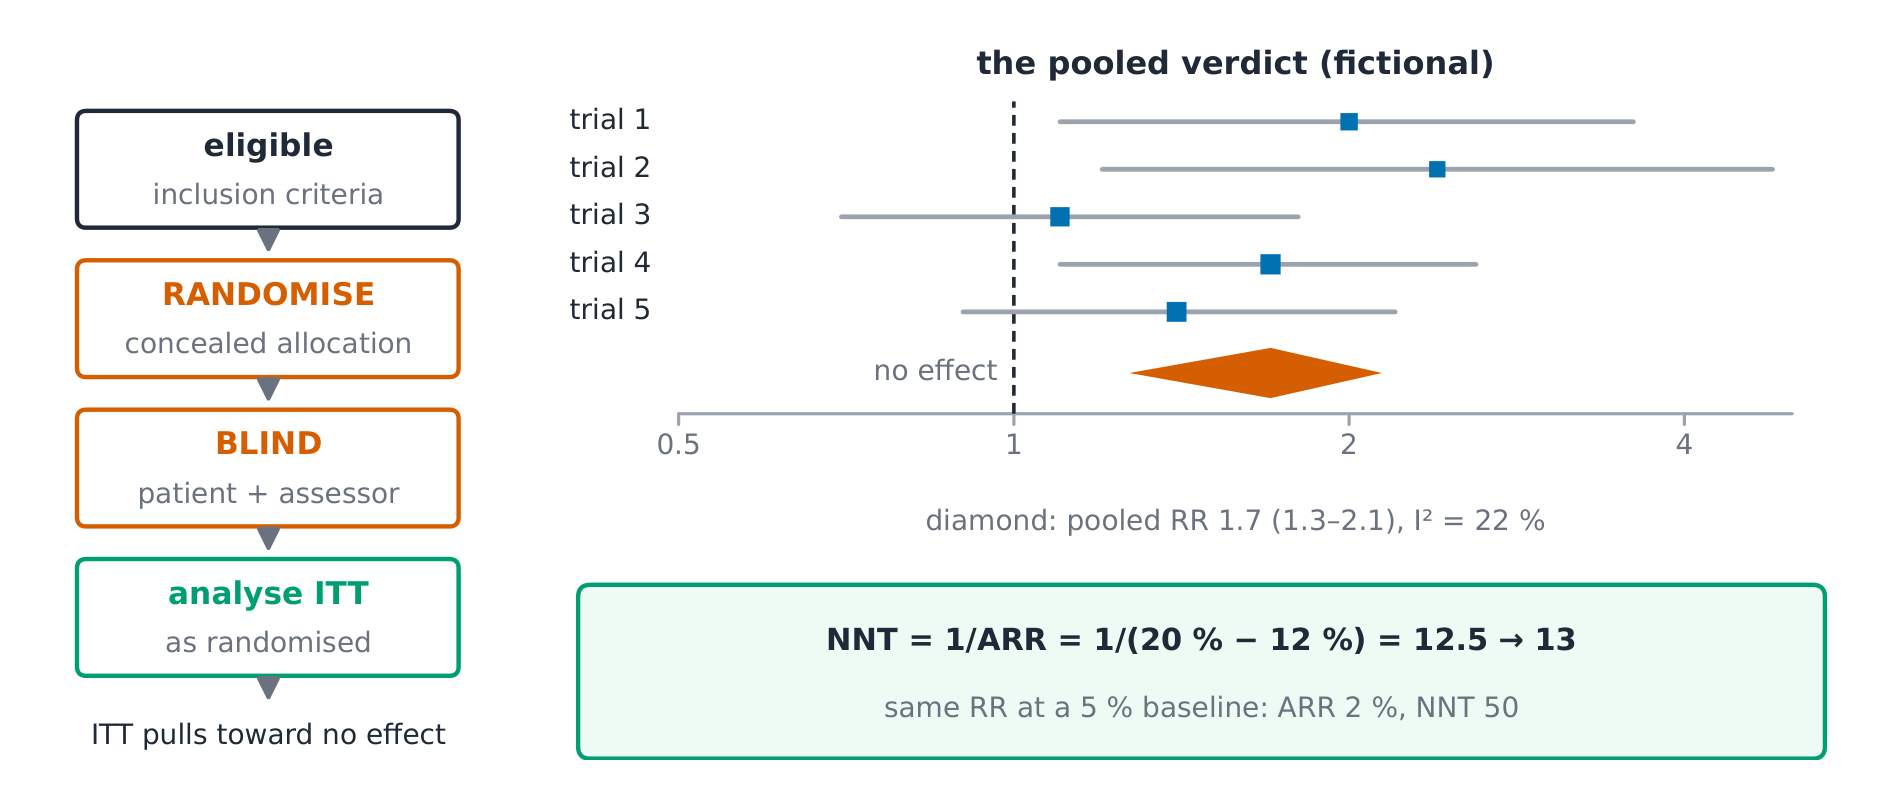
הגזירה (למה NNT הוא הגודל הקליני של אפקט). NNT = $1/ARR$: שיער אירוע בקבוצת ביקורת 20 %, מטופלים 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13 אנשים מטופלים כדי אחד ייהנה מהשורה ✓. NNT ממיר יחס מופשט לעומס עבודה — והמכנה שלו (ARR) קטן ככל שהסיכון הבסיסי יורד, ולכן תוצאות ניסויים אינן עוברות ל קליניקות בעלות סיכון נמוך ללא שינוי.
דוגמה מופרשת 1 — לוגיקת ITT. (בית דין בדיוני) 20 % בקבוצת הבקרה לעומת 12 % במערכת הטיפול: ARR 8 %, NNT 13 ✓. אם 30 % ממערכת הטיפול הפסיקו להמשיך בהטלה מוקדם, בניתוח ITT עדיין נחשבים כמעורבים בטיפול — מה שמדלול את האפקט הנראה כלפי האפס — משום שהשאלה היא על פוליטיקת ההטלה, ולא על הביולוגיה של העדים המאמינים ✓. ניתוח לפי פרוטוקול עונה לשאלה אחרת ועובר חריגה של טעות עובדות.
דוגמה פתורה 2 — קשר קליני: קריאת היהלום. (יצירה ייעוץ) חמישה ניסויים, RRs פרטיים 1.1–2.4 עם CIs רחבים, RR מצטבר 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: היהלום יושב מימין ל-1 והמרווח שלו אותו יהלום עם 1 יגרום לשאול "מדוע מחקרים אלו מתנגשים?" לפני שאפשר לסמוך על צירוף נתונים. היהלום אותו עם $I^2 = 78\ \%$ יגרום לשאלה "מדוע ניסויים קריאת ניתוח לפי פרוטוקול כניתוח כנה (הוא שובר את ההגנה של ההטלה האקראית). התנהגות כמוצד לגבי היהלום המצטבר למרות תנודתיות גבוהה.
סיכום. הטל (מוסתר) → עיוור → ניתוח כהטלה (ITT, קבוצות; עיוורון מאזן ציפיות — ניסוי יכול להיות עם אחד מהם בלבד). קריאה לפי הפרוטוקול כניתוח כנה (זה מפר את ההגנה של האקראיות). טיפול בהיהלום המאוחד כדת ומשפט למרות התבוננות גבוהה. סיכום. האקראי (מוסתר) → עיוור → ניתוח כהאקראי (ITT,
Summary. Randomise (concealed) → blind → analyse as randomised (ITT, dilutes toward null); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); forest: squares weighted, diamond pooled, $I^2$ disagreement; low-baseline clinics צמצם ARR והגדל NNT.
ביקורת קריטית והחלת עדויות
למה זה חשוב. עדות הופכת למרפא רק לרגל המיטה: נבדקת מבחינת תקפותה, מודדת לפי חשיבותה, ומותאמת למטופל שולך לפניך. יחידה זו מהווה את סינתוז הקורס.
הרעיון, עם תמונה. עמוד השדרה של הביקורת: PICO (אוכלוסייה, התערבות, השוואה, תוצאה) כמסגרת → תקפות (האם התוצאות מעוותות?) → גודל (כמה גדול, כמה מדויק?) → רלוונטיות (האם המטופל שלך דומה לאוכלוסייה שנבדקה?) ✓. דירוג ודאות (GRADE): עדות אקראית מתחילה בגבוה ועדות צפייה נמוכות; הורדה עבור סיכון ל עיוותים, אי-התאמה, אי-עקיבות, חוסר דיוק או עיוות פרסום; העלאה לעבור אפקטים גדולים או גרדיאנט תלות-תגובה ✓.

המסקר (למה ההיררכיה היא סברת ראשון, לא פסק דיני). עיצובים differ in their TYPICAL bias control: randomisation balances confounders נמדדים ואינם נמדדים; קהילות נושאות משתנים מעכבים; מחקרי מקרה-בוקרת מוסיפים עיוות זיכרון ✓. אך ההיררכיה מדרגת את סוג העיצוב, בעוד שהפסק משתייך למחקר עצמו — ניסוי קטן, שאינו עיוור, שנבדק באנליזה לפי הפרוטוקול עשוי לזכות בפחות אמון ממחקר קהילתי גדול, שנרשם לפני תחילתו, עם התאמת נטייה. GRADE קיים בדיוק כי סוג העיצוב הוא רק נקודת ההתחלה.
דוגמה מופרשת 1 — סיכום עיוני בדמיון של חמישה שאלות. (בדמיון) "הקצאה אקראית, כפולה-עיוורון, n = 400; RR 0.75 (0.60–0.94)": תוקף — הקצאה אקראית ועיוורון ✓; גודל — הפחתה יחסית של 25 %, המרווח אינו כולל 1; רלוונטיות מקומית — האם מטופלים כמו שלי נכללו (גיל, חומרה, תרופות משולבות)?; תוצאות — רלוונטיות למטופל או סובסטטיטיביות? ודאות — האם קיימות מאפייני הורדה? חמישה שאלות, פסק דין מבנה אחד ✓.
Worked example 2 — clinical link: transplanting the NNT. (Fictional) a trial in severe disease (baseline 20 %, ARR 8 %, NNT 13); my patient's clinic runs at 5 % baseline: with the same relative risk reduction the ARR scales to $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. The relative effect may — הם מקומיים. שגיאות נפוצות. הערכה רק לגבי תוקף (אפקט תקף אך זעיר
נותר חסר שימוש: גודל ודיוק קובעים חשיבות). דירוג לפי כתב עת או תווית עיצוב בלבד (GRADE מתחיל מכאן ומתקדם בהתאם לפגמים של העדויות). יישום ממוצעי קבוצה למטופל שמאפיין המגדיר אותו היה קריטריון לשילוב. סיכום. PICO → תוקף → גודל → רלוונטיות; GRADE: להתחיל מהעיצוב, להוריד דירוג בגלל טיח/אי-התאמה/עקיפות/חוסר דיוק, להעלות
קליניים** — תקשורת, הסברה ואתיקה. design, downgrade for bias/inconsistency/indirectness/imprecision, upgrade לשפיעות גדולות; הפירמידה היא הנחה קדומה, לא פסק דין; השפעות יחסיות מסע, תועלות מוחלטות (ARR, NNT) הן מקומיות — יש לחשב מחדש לפני היישום.