Sorting algorithms
Introduit| English | Sens |
|---|---|
| bubble sort/ˈbʌbl sɔːt/ | tri à bulles |
| insertion sort/ɪnˈsɜːʃn sɔːt/ | tri par insertion |
| in place/ɪn pleɪs/ | en place |
| stable/ˈsteɪbl/ | stable |
Le tri qui est lent intentionnellement
- Chaque bibliothèque sérieuse trie avec un algorithme que les examens ne vous demandent pas d'écrire. Le tri à bulles et le tri par insertion sont tous deux $O(n^2)$, et les deux sont battus par n'importe quel bon tri sur une grande liste.
- Ils figurent au programme de toute façon, et pour une bonne raison : ils sont assez courts pour être tracés à la main, et tracer l'un d'eux est la meilleure façon d'apprendre ce qu'un tri fait réellement à un tableau.
- Il existe aussi un cas réel pour le tri par insertion. Sur une liste petite ou presque triée, il est véritablement le plus rapide qui soit, et les bibliothèques réelles basculent dessus pour exactement ces raisons.
- Cette leçon porte sur le tri à bulles (冒泡排序) et le tri par insertion (插入排序) : les algorithmes, leur comportement et là où chacun l'emporte.
Tri bulle
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            swap A[i], A[i + 1]
            swapped ← TRUE
        ENDIF
    NEXT i
    IF NOT swapped THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
- Chaque passe compare des paires adjacentes et échange celles qui sont hors ordre, de sorte que la plus grande valeur restante « remonte à la bulle » vers la fin.
- Après la passe $k$, les derniers $k$ éléments sont définitifs, c'est pourquoi la boucle intérieure s'arrête à $n - \text{pass}$.
- Le drapeau
swappedlui permet de s'arrêter précocement : si une passe entière ne produit aucun échange, la liste est triée.
Tri par insertion
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]                 // shift right
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key                      // drop it in
NEXT i
- Il construit une section triée à l'avant, qui grandit d'un élément à chaque fois. Chaque nouvel élément est mis de côté comme
key, les éléments plus grands sont déplacés vers la droite pour créer un espace, et la clé est insérée à cet endroit. - C'est ainsi que la plupart des gens trient un jeu de cartes, ce qui est l'analogie attendue par les examens.
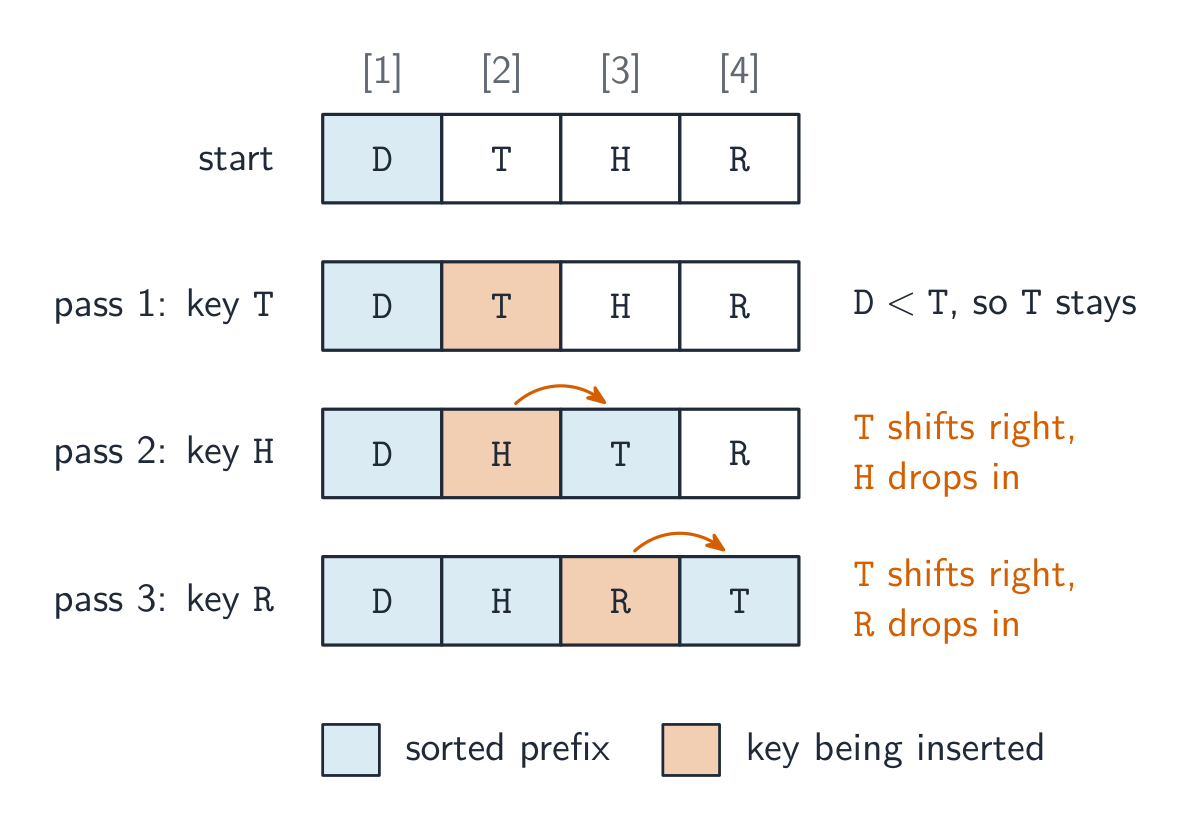
La partie gauche est triée, la partie droite est intacte, et la frontière se déplace vers la droite
Algorithmes de tri
compare adjacent, swap if needed
Step through a bubble sort: each pass floats the largest value to the end.
Bubble sort works by:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Each pass swaps adjacent pairs, "bubbling" the largest element to the end.
The average/worst-case time complexity of bubble sort is:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Two nested loops over n elements give O(n²); the best case (already sorted) is O(n) with the early exit.
Exemple résolu : tracer une passe
- Tracez la première passe d'un tri à bulles sur 5, 3, 8, 1.
- Comparez 5 et 3 : hors ordre, échange, donnant 3, 5, 8, 1. Comparez 5 et 8 : dans l'ordre, pas d'échange. Comparez 8 et 1 : échange, donnant 3, 5, 1, 8.
- Après une passe, la plus grande valeur, 8, est dans sa position finale, et une comparaison de moins par passe peut être omise dès maintenant.
- Maintenant tracez la troisième étape du tri par insertion sur 3, 5, 8, 1. La clé est 1. Déplacez 8, 5 et 3 d'une place vers la droite, puis placez 1 au début : 1, 3, 5, 8. Montrez le tableau après chaque étape ; c'est là que se trouvent les points.
Insertion sort builds the sorted result by:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
It grows a sorted prefix on the left, shifting larger elements right to drop each key into place.
How does insertion sort place each new element?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Holding the key aside and shifting is what distinguishes it from bubble sort's repeated adjacent swaps.
Performances
| bulles | insertion | |
|---|---|---|
| meilleur cas | $O(n)$, une passe sans échanges | $O(n)$, déjà trié, pas de déplacements |
| moyenne et pire | $O(n^2)$ | $O(n^2)$ |
| mémoire supplémentaire | $O(1)$, in place (原地) | $O(1)$, in place |
| stable | oui | oui, stable (稳定) |
- In place signifie qu'il ne nécessite qu'une quantité constante de mémoire supplémentaire, triant directement dans le tableau. Stable signifie que deux valeurs égales conservent leur ordre relatif initial, ce qui est important lorsqu'une liste a déjà été triée selon un autre champ.
- Tous deux atteignent $O(n)$ sur des données déjà triées, mais seulement si le tri à bulles a le drapeau
swapped. Sans lui, il effectue toujours tous les passages.
After the first pass of a bubble sort on 5, 3, 8, 1, what is the array? Write the four numbers separated by commas.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
5 and 3 swap, 5 and 8 do not, 8 and 1 swap. The largest value has reached the end, so the next pass can be one comparison shorter.
Exemple résolu : quel tri, et pourquoi
- Une liste de 200,000 enregistrements doit être triée à partir de zéro. Ni l'un ni l'autre : les deux sont $O(n^2)$, il est donc nécessaire d'effectuer un tri par fusion ou un tri rapide à $O(n \log n)$. Précisez-le plutôt que de choisir le moins mauvais.
- Une liste triée de 10,000 gagne 5 nouveaux enregistrements à la fin et doit être triée à nouveau. Tri par insertion : les données sont presque triées, donc chaque nouvelle clé ne se déplace que sur une courte distance et elle approche $O(n)$.
- Un exemple pédagogique doit être tracé à la main sur papier. Tri à bulles : c'est le plus simple à suivre, c'est son usage principal restant.
- Justifiez à partir de l'état des données et de la taille, pas d'une préférence générale.
Match each sorting idea to what it means.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Bubble swaps neighbours, insertion grows a sorted prefix; both are O(n²) worst-case; stability is about equal-key order.
Insertion sort runs close to O(n) on small or nearly-sorted arrays, because few elements need to be shifted.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
On nearly-sorted data each new item is already almost in place — which is why insertion sort beats fancier sorts on small inputs.
Which are true of both bubble sort and insertion sort? Select tout that apply.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
On a large unsorted list an O(n log n) sort wins decisively. Saying so is the right answer, not choosing the least bad of the two.
Pourquoi une seule passe ne suffit pas
- Les deux triers effectuent des passes répétées, et l'examen les distingue par ce qu'une passe atteint et par quand ils s'arrêtent.
- Une passe de tri à bulles compare des paires adjacentes et les échange, donc une passe transporte le plus grand élément restant à sa place définitive. Le tri complet nécessite $n - 1$ passes.
- Une passe de tri par insertion prend l'élément suivant et le replique dans la partie déjà triée, donc après $k$ passes, les premiers $k$ éléments sont triés entre eux mais pas encore dans leur position finale.
- Le tri à bulles peut être amélioré avec un drapeau : si une passe ne produit aucun échange, la liste est déjà triée et l'algorithme s'arrête. Sur des données presque triées, cela le réduit à une seule passe.
- Sans le drapeau, les deux sont $n^2$ dans le cas le plus défavorable, ce qui explique pourquoi l'un ou l'autre est un mauvais choix pour un grand fichier et pourquoi l'examen porte sur de petits fichiers.
A sorted list of 10,000 records gains 5 new records at the end. Which sort suits re-sorting it?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Nearly sorted data is exactly insertion sort's best case, approaching O(n). Real libraries switch to it for this reason.
Match each sort to what one pass achieves.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
That difference is what a trace question is really testing. A bubble-sort flag also lets it stop early on nearly-sorted data, which insertion sort handles well anyway.
Pièges qui font perdre des points
- Le tri à bulles compare des paires adjacentes. Une réponse qui compare un élément avec tous les autres décrit un algorithme différent.
- La boucle intérieure se raccourcit à chaque passe, car la fin du tableau est déjà définitive. Expliquez pourquoi.
- Le tri par insertion décale les éléments vers la droite pour créer un espace ; il n'échange pas de manière répétée. Cette distinction est le cœur de l'algorithme.
- Les deux sont $O(n^2)$ en moyenne et au pire, et $O(n)$ au mieux. Donnez le cas avec la complexité.
Vous avez compris
- tri à bulles : passes répétées comparant des paires adjacentes et échangeant, la plus grande remontant à la bulle vers la fin, boucle intérieure se raccourcissant à chaque passe, avec un drapeau
swappedpour sortie anticipée - tri par insertion : faire croître une section triée à l'avant, mettant chaque clé de côté, décalant les éléments plus grands vers la droite et plaçant la clé dans l'espace
- les deux sont $O(n^2)$ en moyenne et au pire, $O(n)$ au mieux, in place et stable
- le tri par insertion l'emporte véritablement sur les listes petites ou presque triées ; pour une grande liste non triée, ni l'un ni l'autre n'est la bonne réponse