| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer la compréhension des méthodes de recherche linéaire et de recherche binaire | Écrire un algorithme pour implémenter une recherche linéaire Écrire un algorithme pour implémenter une recherche binaire Les conditions nécessaires à l'utilisation d'une recherche binaire Comment la performance d'une recherche binaire varie selon le nombre d'éléments de données |
| Montrer la compréhension des méthodes de tri par insertion et de tri à bulles | Écrire un algorithme pour implémenter un tri par insertion Écrire un algorithme pour implémenter un tri à bulles La performance d'une routine de tri peut dépendre de l'ordre initial des données et du nombre d'éléments de données |
| Montrer la compréhension et utiliser les Types de Données Abstraits (ADT) | Écrire des algorithmes pour trouver un élément dans chacun des suivants : liste chaînée, arbre binaire Écrire des algorithmes pour insérer un élément dans chacun des suivants : pile, file d'attente, liste chaînée, arbre binaire Écrire des algorithmes pour supprimer un élément de chacun des suivants : pile, file d'attente, liste chaînée Montrer la compréhension qu'un graphe est un exemple d'ADT. Décrire les caractéristiques principales d'un graphe et justifier son utilisation pour une situation donnée. Les candidats ne seront pas tenus d'écrire du code pour une structure de graphe |
| Montrer comment il est possible d'implémenter des ADTs à partir d'un autre ADT | Décrire les ADTs suivants et démontrer comment ils peuvent être implémentés à partir de types intégrés appropriés ou d'autres ADTs : pile, file d'attente, liste chaînée, dictionnaire, arbre binaire |
| Montrer la compréhension que différents algorithmes effectuant la même tâche peuvent être comparés en utilisant des critères (p. ex., temps nécessaire pour terminer la tâche et mémoire utilisée) | Incluant l'utilisation de la notation Big O pour spécifier la complexité temporelle et spatiale |
Pensée computationnelle et résolution de problèmes
Informatique A-Level · Sujet 19
 15:33
Recherche & Tri
Un annuaire téléphonique avec un million de noms. Si vous les vérifiez un par un, vous pouvez faire un million de comparaisons. Mais vous connaissez déjà l'astuce : ouvrez-le dans le…
Narration en anglais · sous-titres en anglais et en 中文 au choix
19.1
Algorithmes de recherche
Programme
Source : Programme Cambridge International
Une recherche trouve une valeur cible dans une collection (souvent un tableau) et renvoie sa position ou « introuvable ».
Recherche linéaire
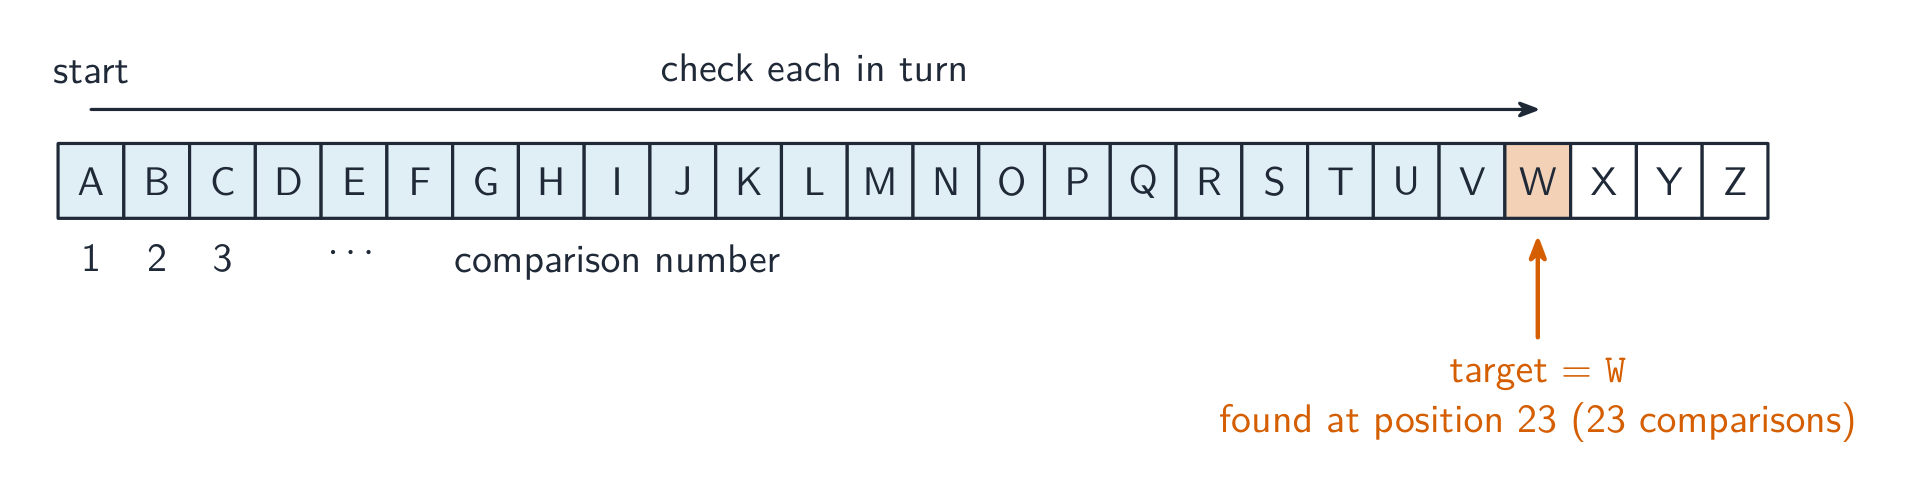
Une recherche linéaire parcourt du début à la fin, comparant chaque élément avec la cible :
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Aucune préparation n'est nécessaire : elle fonctionne donc sur n'importe quelle liste. Dans le pire des cas, O($n$) (cible à la fin ou absente) ; dans le meilleur des cas, 1 comparaison. Utilisez-la pour des données non triées ou de petites listes. (La valeur -1 renvoyée est une valeur sentinelle : une position impossible qui signifie « introuvable » ; le programme appelant teste IF result = -1.)
La version de l'examen. Paper 3 vous demande de compléter une recherche linéaire écrite avec un indicateur et une boucle WHILE, et Paper 4 d'écrire une fonction qui retourne l'index ou un compteur. Tous deux ressemblent à ceci :
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
Pour s'arrêter à la première correspondance au lieu de cela, utilisez une boucle WHILE Index <= 100 AND NOT Found qui définit Found ← TRUE et mémorise l'index. Les points sont pour la boucle sur chaque élément, la comparaison, et ce qui est retourné lorsque la valeur est absente.
Recherche binaire
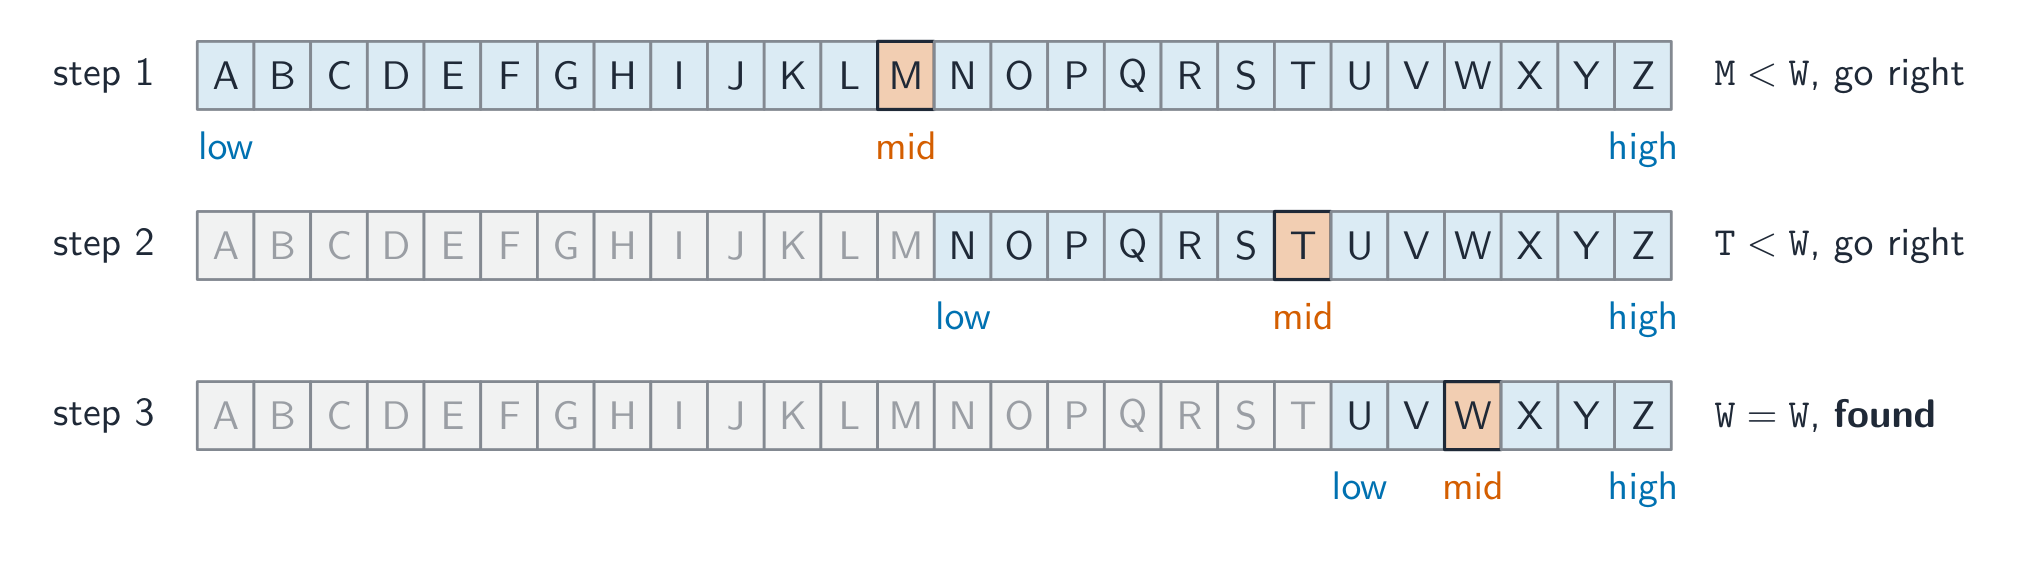
Une recherche binaire nécessite que les données soient triées. Regardez l'élément central ; s'il correspond à la cible, c'est terminé ; s'il est plus petit, cherchez dans la moitié gauche, sinon dans la moitié droite — divisant par deux l'intervalle à chaque étape :
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Cas le plus défavorable O($\log_{2} n$) — pour un million d'éléments, environ 20 comparaisons. Beaucoup plus rapide que la recherche linéaire sur de grands tableaux triés, mais vous devez d'abord trier (un coût ponctuel O($n \log n$)), ce qui vaut le coup si vous recherchez de nombreuses fois.
« Indiquez la condition nécessaire à une recherche dichotomique. » Les données doivent être ordonnées (triées par ordre croissant ou décroissant selon la clé recherchée). « Décrivez comment effectuer une recherche dichotomique » (trois points) : (1) trouvez l'élément du milieu de la liste (ou de la plage courante) et comparez-le à la cible ; (2) s'il correspond, la recherche s'arrête ; si la cible est plus petite, recommencez dans la moitié inférieure, si elle est plus grande, dans la moitié supérieure ; (3) continuez à diviser la plage par deux jusqu'à trouver l'élément ou obtenir une plage vide, ce qui signifie qu'il est absent.
La version de l'examen, avec les bornes et un indicateur, est celle à reproduire lorsque l'on vous demande de compléter l'algorithme :
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
Exemple corrigé (suivi d'une recherche dichotomique). Names[0:9] contient Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo. Suivez la version de l'examen pour Target = "Ivy", puis pour Target = "Cat", en donnant Lower, Upper et MiddleIndex à chaque étape.
Pour « Ivy » :
| Lower | Upper | MiddleIndex | Names[MiddleIndex] | Résultat |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy, donc Lower ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy, donc Lower ← 8 |
| 8 | 9 | 8 | Ivy | Found ← TRUE |
Le résultat affiché est 8, après trois comparaisons. Pour « Cat » : milieu 4 (Eva > Cat, Upper ← 3) ; milieu 1 (Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat, Upper ← 2). À présent, Lower (3) est supérieur à Upper (2), donc la boucle s'arrête et « Not found » est affiché après quatre comparaisons, le pire des cas pour dix éléments ($\lceil\log_2 10\rceil = 4$). DIV arrondit à l'entier inférieur : le milieu de 0 et 9 est donc 4, et non 4.5 ou 5. Les chaînes sont comparées dans l'ordre alphabétique (selon le code des caractères).
« Expliquez comment la performance varie selon le nombre d'éléments. » Chaque comparaison divise par deux le nombre d'éléments restants ; le nombre maximal de comparaisons est donc d'environ $\log_{2} n$ : doubler la taille de la liste n'ajoute qu'une comparaison. Il s'agit de O($\log n$). « Comparez la recherche linéaire et la recherche dichotomique » : une recherche linéaire nécessite jusqu'à $n$ comparaisons (O($n$)) et, en moyenne, la moitié de ce nombre, mais fonctionne sur des données non triées ; une recherche dichotomique nécessite au maximum $\log_{2} n$ comparaisons (O($\log n$)) et est beaucoup plus rapide pour les grandes listes, mais les données doivent d'abord être triées et permettre un accès direct à l'élément du milieu (un tableau plutôt qu'une liste chaînée). Pour $1000$ éléments : $1000$ contre $10$ comparaisons.
Explorer
Recherche linéaire vs binaire
Recherchez une valeur. La recherche dichotomique divise la liste par deux à chaque étape (uniquement sur des données triées) ; la recherche linéaire vérifie un par un.
Vocabulaire
Entrainer
| English | Français |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | tri par insertion |
| bubble sort/ˈbʌbl sɔːt/ | tri à bulles |
| binary search/ˈbaɪnəri sɜːtʃ/ | recherche dichotomique |
| array/əˈreɪ/ | tableau |
| linear search/ˈlɪnɪə sɜːtʃ/ | recherche linéaire |
19.1
Algorithmes de tri
Tri à bulles
Un tri à bulles parcourt le tableau à plusieurs reprises, en échangeant les paires adjacentes qui ne sont pas dans l'ordre, de sorte que le plus grand élément remonte à la fin à chaque passage :
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Cas optimal O($n$) (déjà trié, avec sortie anticipée) ; moyen/mauvais cas O($n^{2}$). Simple mais lent pour de grands $n$.
Tri par insertion
Un tri par insertion construit un préfixe trié depuis la gauche, insérant chaque nouvel élément à sa place correcte en décalant les éléments plus grands vers la droite :
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Meilleur cas O($n$) (déjà trié) ; pire cas O($n^{2}$). Efficace pour les tableaux petits ou presque triés. Il trie en place et est stable (conserve l'ordre des éléments égaux).
Suivi d'un tri
Une tâche courante consiste à montrer le tableau après chaque passe externe. Pour [D, T, H, R] avec le tri par insertion : passe 1 (clé T) pas de changement ; passe 2 (clé H) → [D, H, T, R] ; passe 3 (clé R) → [D, H, R, T].
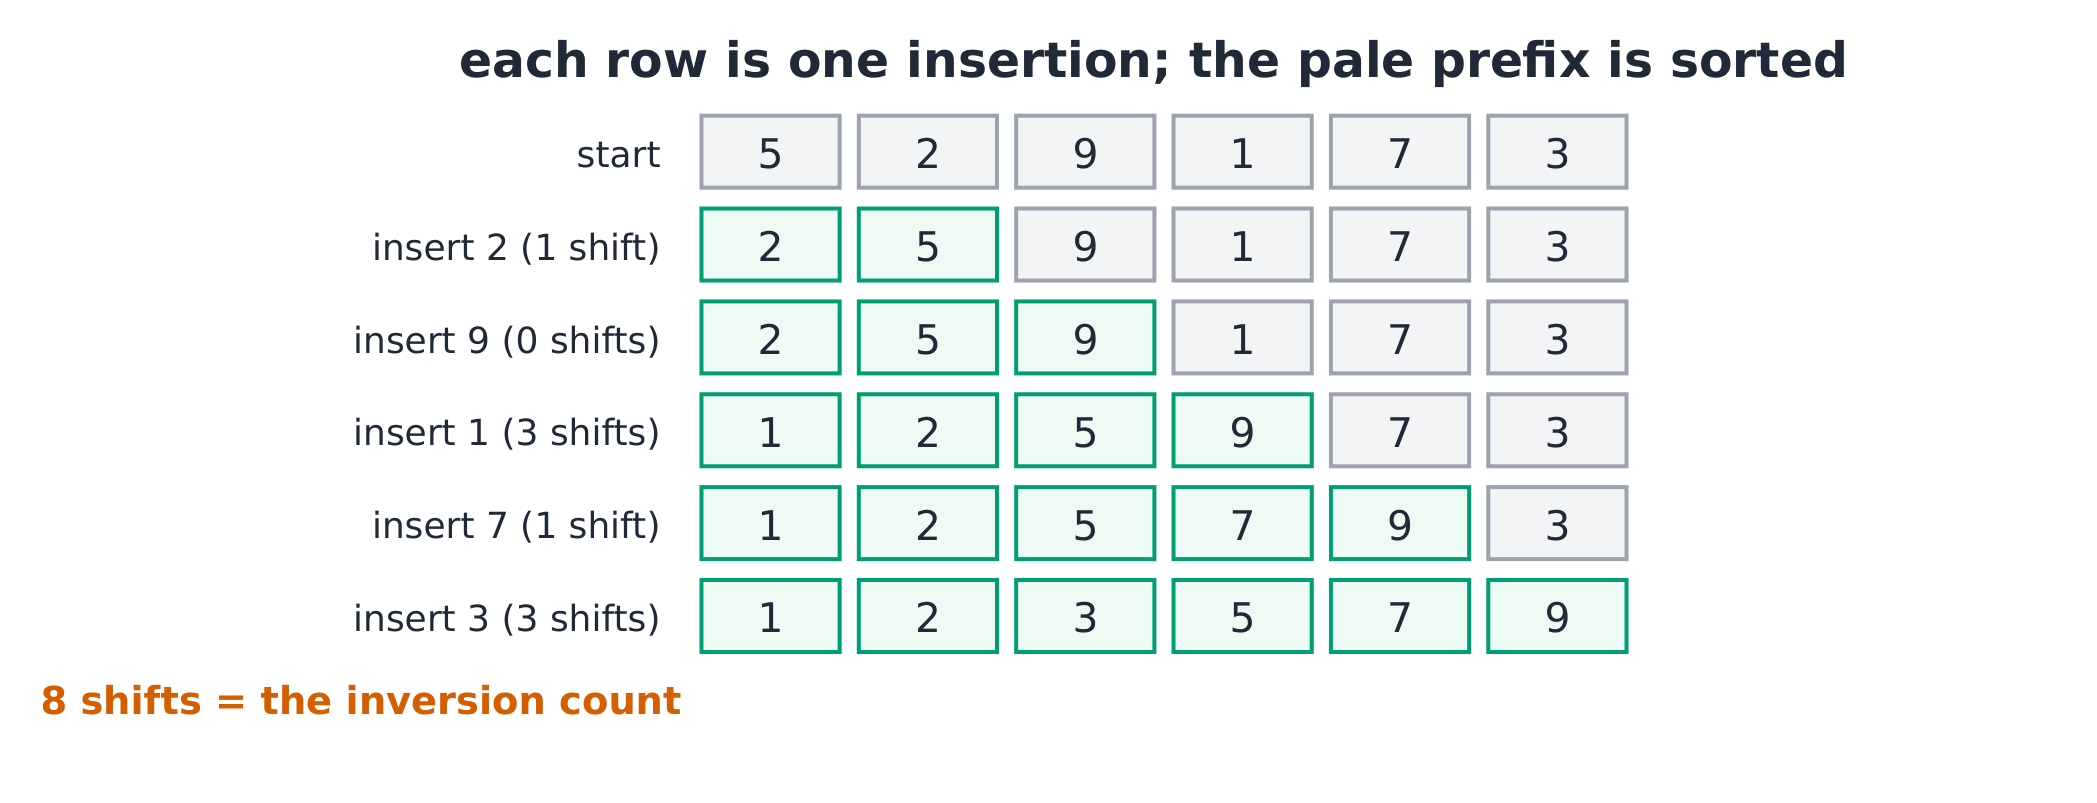
La dérivation (le comptage des inversions). Une inversion est un
Le même tableau évolue différemment avec un tri à bulles : le passage 1 compare D/T (aucun échange), T/H (échange) et T/R (échange), ce qui donne [D, H, R, T] avec le plus grand élément à la fin ; le passage 2 ne fait aucun échange, donc l'indicateur arrête le tri. Montrez le tableau entier après chaque passage et comptez les comparaisons si demandé : $3$ au passage 1 et $2$ au passage 2 (la version ci-dessus s'arrête une place plus tôt à chaque passage), soit $5$ au total.
Écrire un tri à partir de zéro. Pour répondre à « Écrivez un pseudocode qui trie DataArray[1:1000] par ordre croissant », fournissez un tri à bulles complet avec indicateur d'arrêt anticipé, ou un tri par insertion, avec les déclarations et l'indentation nécessaires ; l'un ou l'autre obtient tous les points s'il fonctionne pour toutes les entrées :
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
Pour l'ordre décroissant, remplacez > par < ; pour trier des enregistrements ou un tableau à 2 dimensions selon un champ, comparez ce champ mais échangez l'enregistrement entier (ou toutes les colonnes). Si l'on vous demande d'écrire un tri par insertion « qui effectue la même tâche » qu'un tri à bulles donné, conservez le même nom de tableau et le même ordre, puis reproduisez le tri par insertion ci-dessus en inversant la comparaison si l'ordre est décroissant.
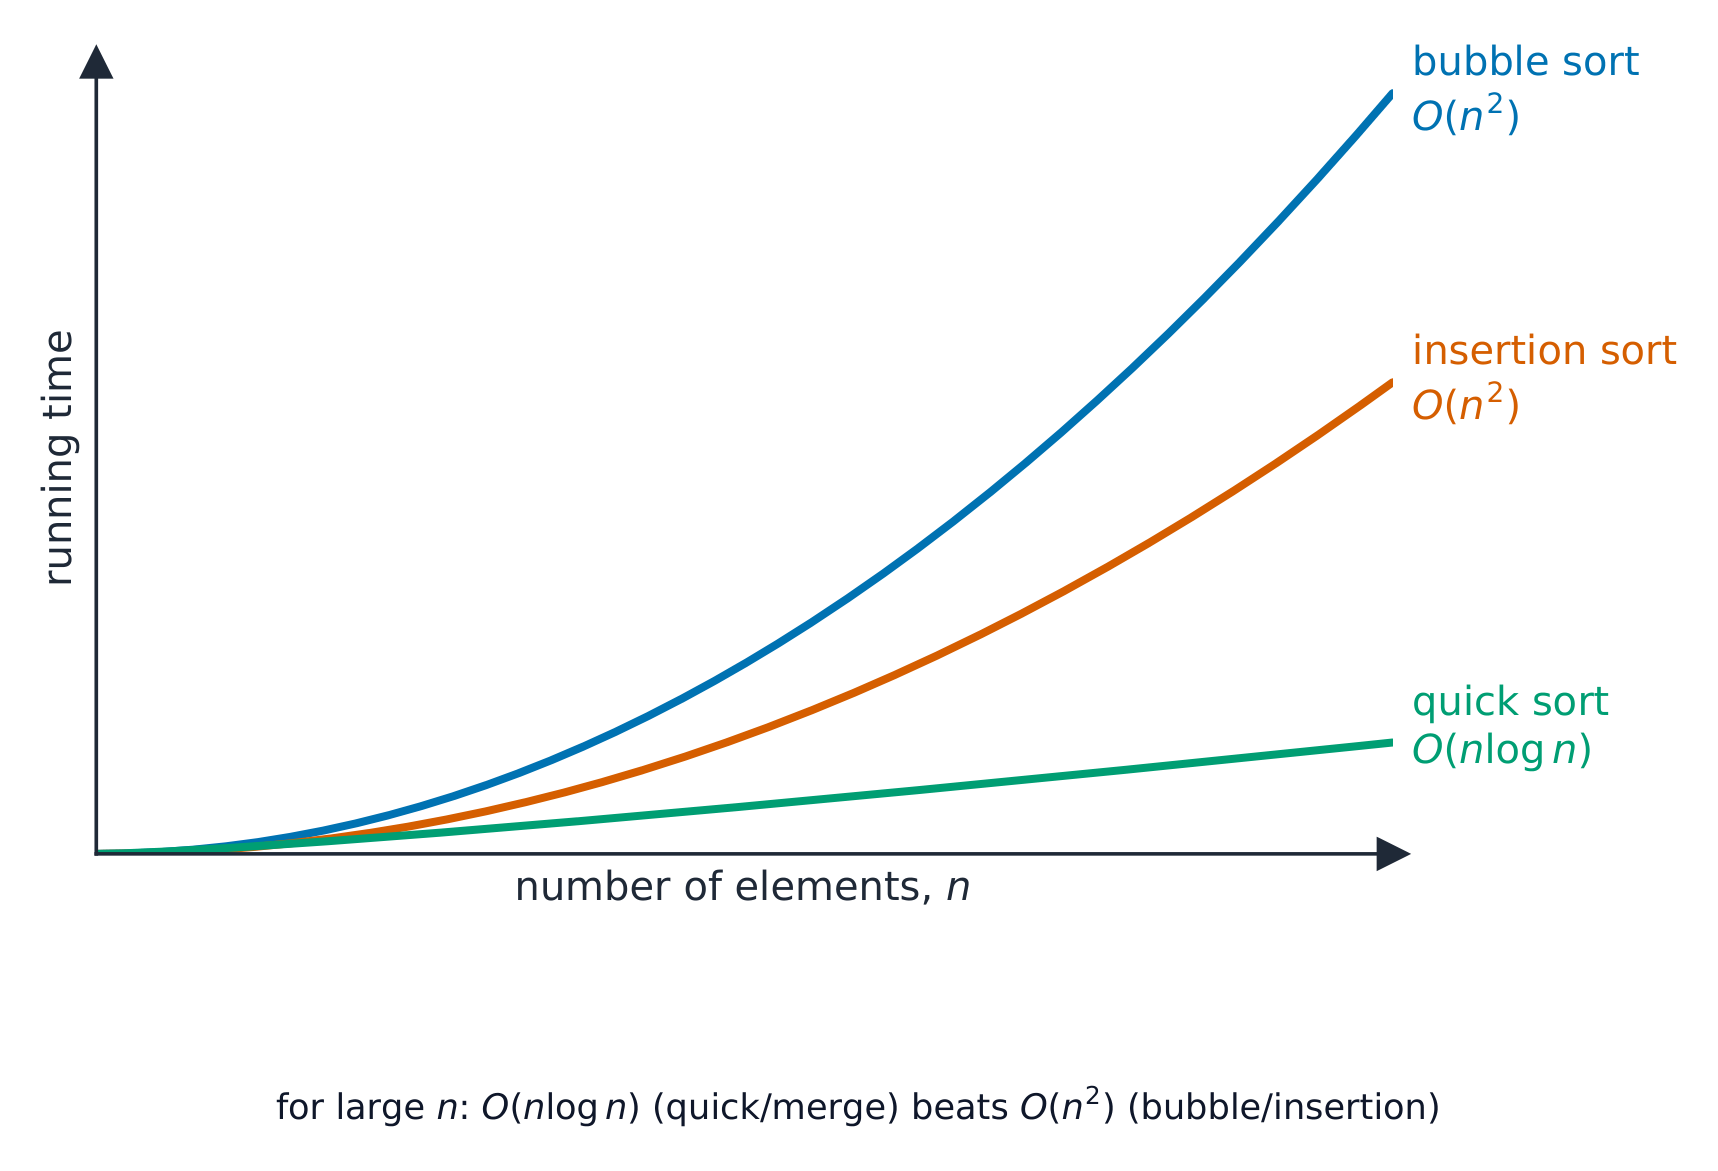
« Décrivez deux façons dont les données influent sur la performance d'un tri » (deux points). (1) Le nombre d'éléments : un tri en $O(n^{2})$ prend quatre fois plus de temps lorsque le nombre d'éléments double. (2) Le degré auquel les données sont déjà ordonnées : un tri à bulles avec indicateur, ou un tri par insertion, se termine en un seul passage sur des données déjà triées ($O(n)$) et effectue le plus de travail sur des données en ordre inverse ; le nombre d'échanges dépend du nombre de paires désordonnées. (Sont également acceptés : l'étendue ou le nombre de valeurs répétées, et le fait que les éléments soient de grands enregistrements coûteux à déplacer.) Le tri à bulles et le tri par insertion sont tous deux en O($n^{2}$) dans les cas moyen et le pire, et en O($n$) dans le meilleur cas ; le tri rapide et le tri fusion sont en O($n \log n$), ce qui explique leur utilisation pour de grandes quantités de données.
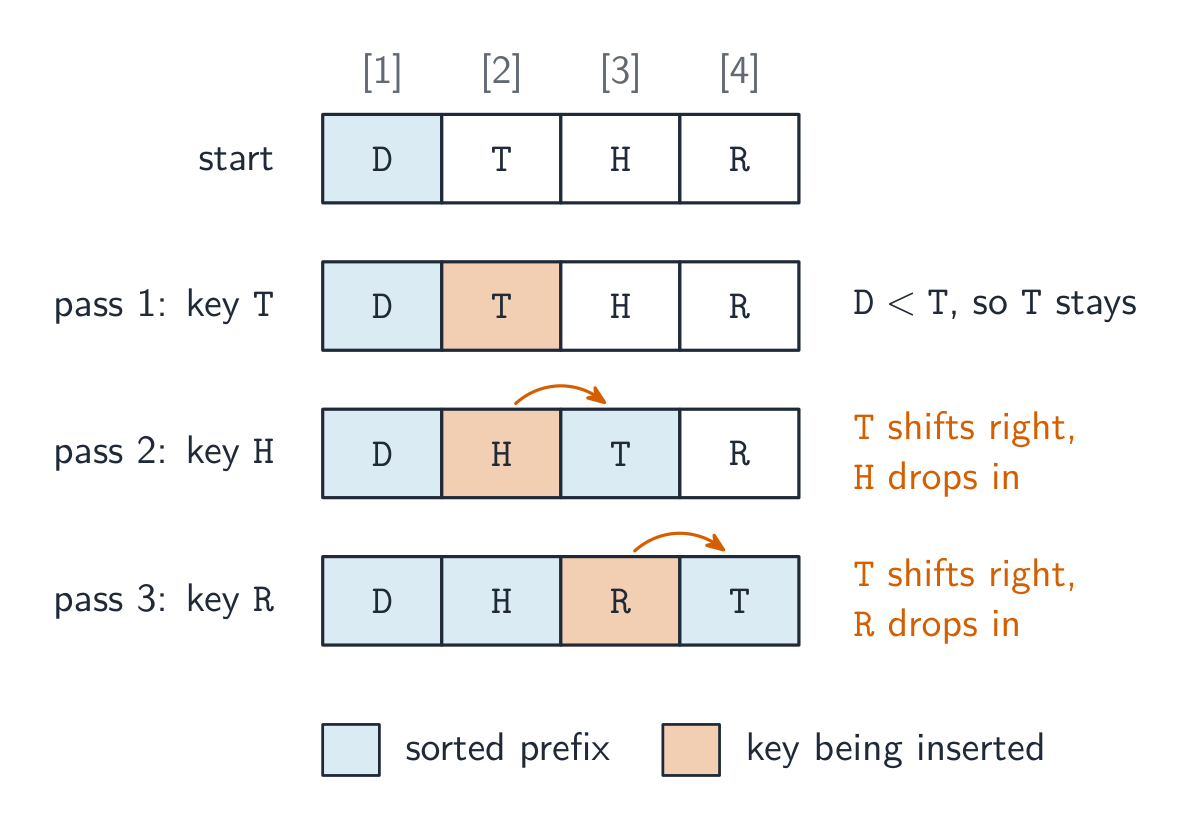
[D, T, H, R], déplaçant chaque clé à sa place passage par passage
Explorer
Regardez un tri s'exécuter
Parcourez un tri et observez les barres se ranger dans l'ordre — comment fonctionne un algorithme de tri, étape par étape.
Vocabulaire
Entrainer
| English | Français |
|---|---|
| stable/ˈsteɪbl/ | stable |
19.1
ADT dans les algorithmes
Les Types de Données Abstraits (TDA) de la Topic 10 apparaissent au sein de nombreux algorithmes : une pile pilote la traversal en profondeur et l'annulation ; une file pilote la traversal en largeur et l'ordre d'impression ; une liste chaînée permet à la donnée de croître et de décroître.
Les TDA peuvent être construits à partir d'autres TDA, pas seulement à partir de tableaux : une file à partir de deux piles ; une pile à partir d'une liste chaînée (push = ajouter une tête de nœud) ; une file à partir d'une liste chaînée avec des pointeurs de tête et de queue ; un arbre binaire à partir de nœuds avec deux pointeurs d'enfants ; un dictionnaire stocke des paires clé→valeur (souvent sur une table de hachage). Empiler ces couches de cette manière sépare les préoccupations — l'algorithme utilisant le TDA n'a pas besoin de savoir comment il est construit.
Les ADT que l'examen vous demande de décrire et d'implémenter
Pile (last in, first out) : les éléments sont ajoutés (pushed) et retirés (popped) à la même extrémité, le sommet ; un pointeur TopOfStack garde l'index de l'élément du sommet. Implémenté avec un tableau et ce seul pointeur : push vérifie que la pile n'est pas pleine, incrémente le pointeur et stocke l'élément ; pop vérifie qu'elle n'est pas vide, retourne l'élément du sommet et décrémente le pointeur.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
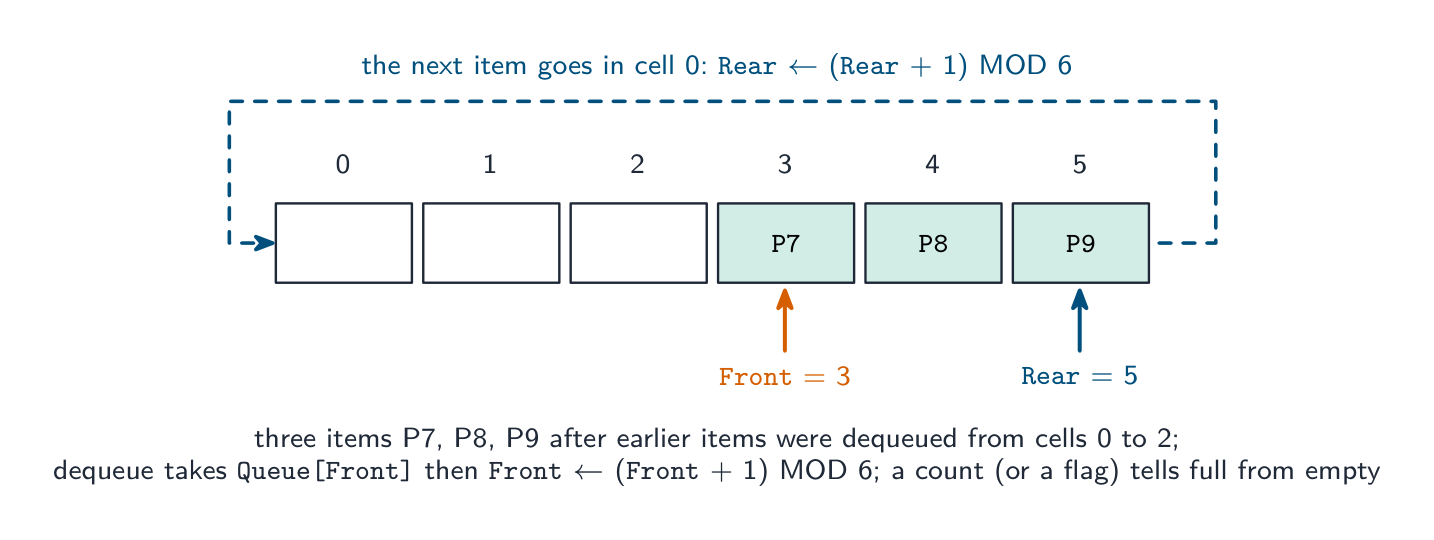
File (premier entré, premier sorti) : les éléments rejoignent à l'arrière (enqueue) et partent de l'avant (dequeue) ; deux pointeurs et un compteur. Dans une file linéaire, le pointeur avant glisse le long du tableau jusqu'à ce que l'espace au début soit gaspillé ; une file circulaire fait tourner les deux pointeurs autour de MOD, réutilisant ainsi chaque cellule.
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
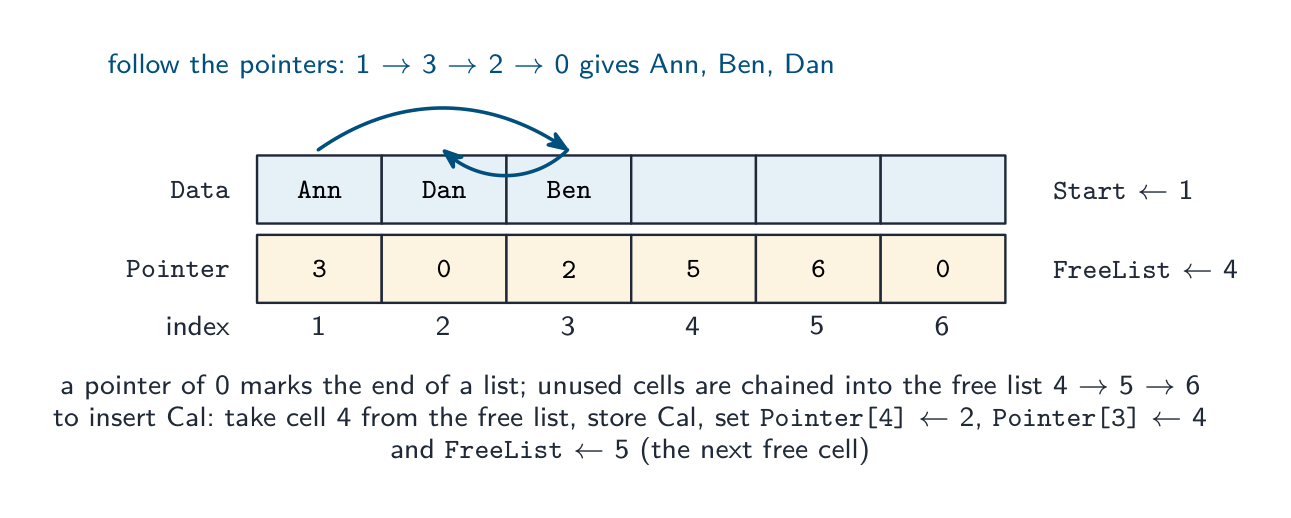
Liste chaînée : une séquence de nœuds, chacun contenant un élément de données et un pointeur vers le nœud suivant ; un pointeur de départ désigne le premier nœud et un pointeur nul (0 ou $-1$) termine la liste. Dans une implémentation par tableau, deux tableaux parallèles contiennent les données et les pointeurs, et les cellules inutilisées sont enchaînées dans une liste libre afin qu'une insertion sache où placer le nouveau nœud.
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Pour insérer dans une liste ordonnée : prenez la première cellule libre (NewNode ← FreeList, FreeList ← Pointer[FreeList]), stockez l'élément, puis parcourez la liste avec un pointeur Previous et Current jusqu'à Data[Current] > Item ou la fin ; définissez Pointer[NewNode] ← Current et Pointer[Previous] ← NewNode (ou Start ← NewNode si cela va en premier). Pour supprimer, relier le nœud précédent au-delà de celui supprimé et retourner la cellule à la liste libre.
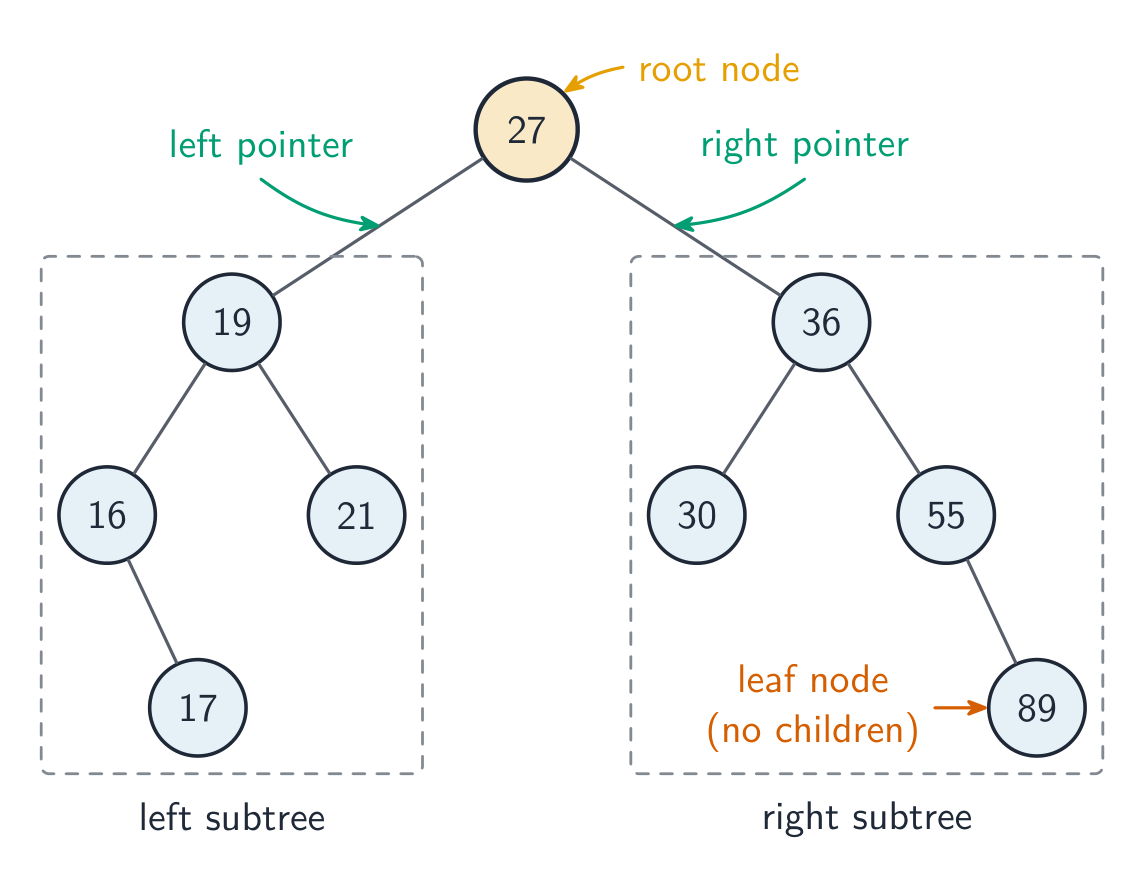
Arbre binaire : un nœud racine, chaque nœud contenant des données, un pointeur gauche vers un sous-arbre de valeurs plus petites et un pointeur droit vers un sous-arbre de valeurs plus grandes. Implémenté comme un tableau 2D (ou trois tableaux 1D) Tree[Index, 0..2] pour le pointeur gauche, les données, le pointeur droit, avec un pointeur racine et un pointeur next-free.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
Pour insérer : stockez l'élément dans le prochain nœud libre avec les deux pointeurs $-1$ ; si l'arbre est vide, faites-en la racine ; sinon, descendez depuis la racine, allez à gauche ou à droite par comparaison, jusqu'à ce que le pointeur que vous suivriez soit $-1$, et définissez ce pointeur vers le nouveau nœud. Un ADT à partir d'un autre ADT : une pile est une liste chaînée où push et pop fonctionnent tous deux au début ; une file est une liste chaînée avec un pointeur de départ et un pointeur de fin ; une file peut être faite à partir de deux piles (push sur l'une, pop de l'autre, tout déplacer quand la seconde est vide) ; les nœuds d'un arbre binaire sont des enregistrements ou objets liés par des pointeurs, donc il est construit à partir d'une structure de liste de nœuds. Dites quelles opérations du nouveau ADT correspondent à quelles opérations de l'ancien.
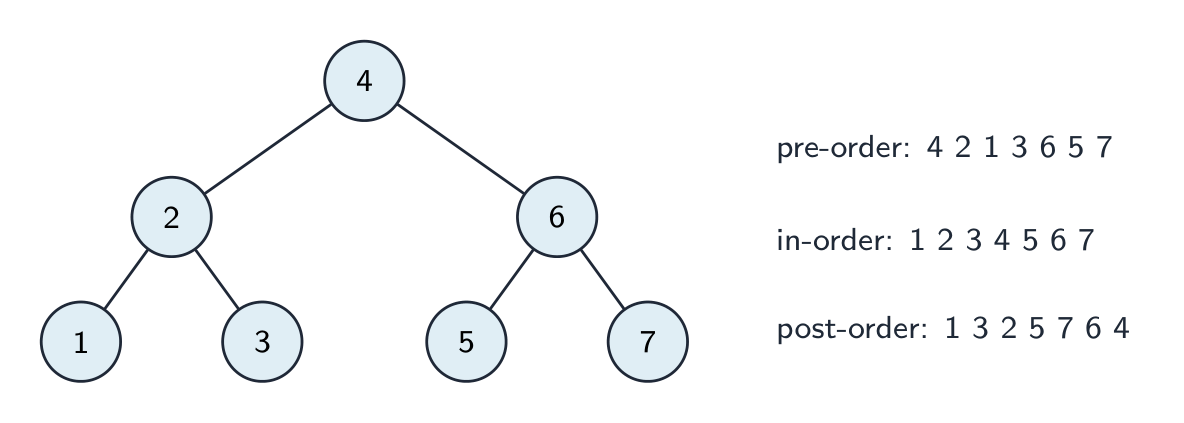
La première figure montre un arbre binaire de recherche : chaque nœud possède au maximum deux nœuds enfants, les valeurs inférieures à celle d'un nœud sont placées à sa gauche et les valeurs supérieures à sa droite. La seconde figure montre les trois façons de parcourir un arbre.
Vocabulaire
Entrainer
| English | Français |
|---|---|
| linked list/lɪŋkt lɪst/ | liste chaînée |
| in place/ɪn pleɪs/ | en place |
| stack/stæk/ | pile |
| queue/kjuː/ | fichier |
| node/nəʊd/ | nœud |
| pointers/ˈpɔɪntəz/ | pointeurs |
| binary tree/ˈbaɪnəri triː/ | arbre binaire |
| dictionary/ˈdɪkʃənəri/ | dictionnaire |
| circular queue/ˈsɜːkjʊlə kjuː/ | file circulaire |
| free list/friː lɪst/ | liste libre |
| time complexity/taɪm kəmˈpleksɪti/ | complexité temporelle |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | notation du grand O |
| space complexity/speɪs kəmˈpleksɪti/ | complexité spatiale |
19.1
Comparaison des algorithmes
Complexité temporelle
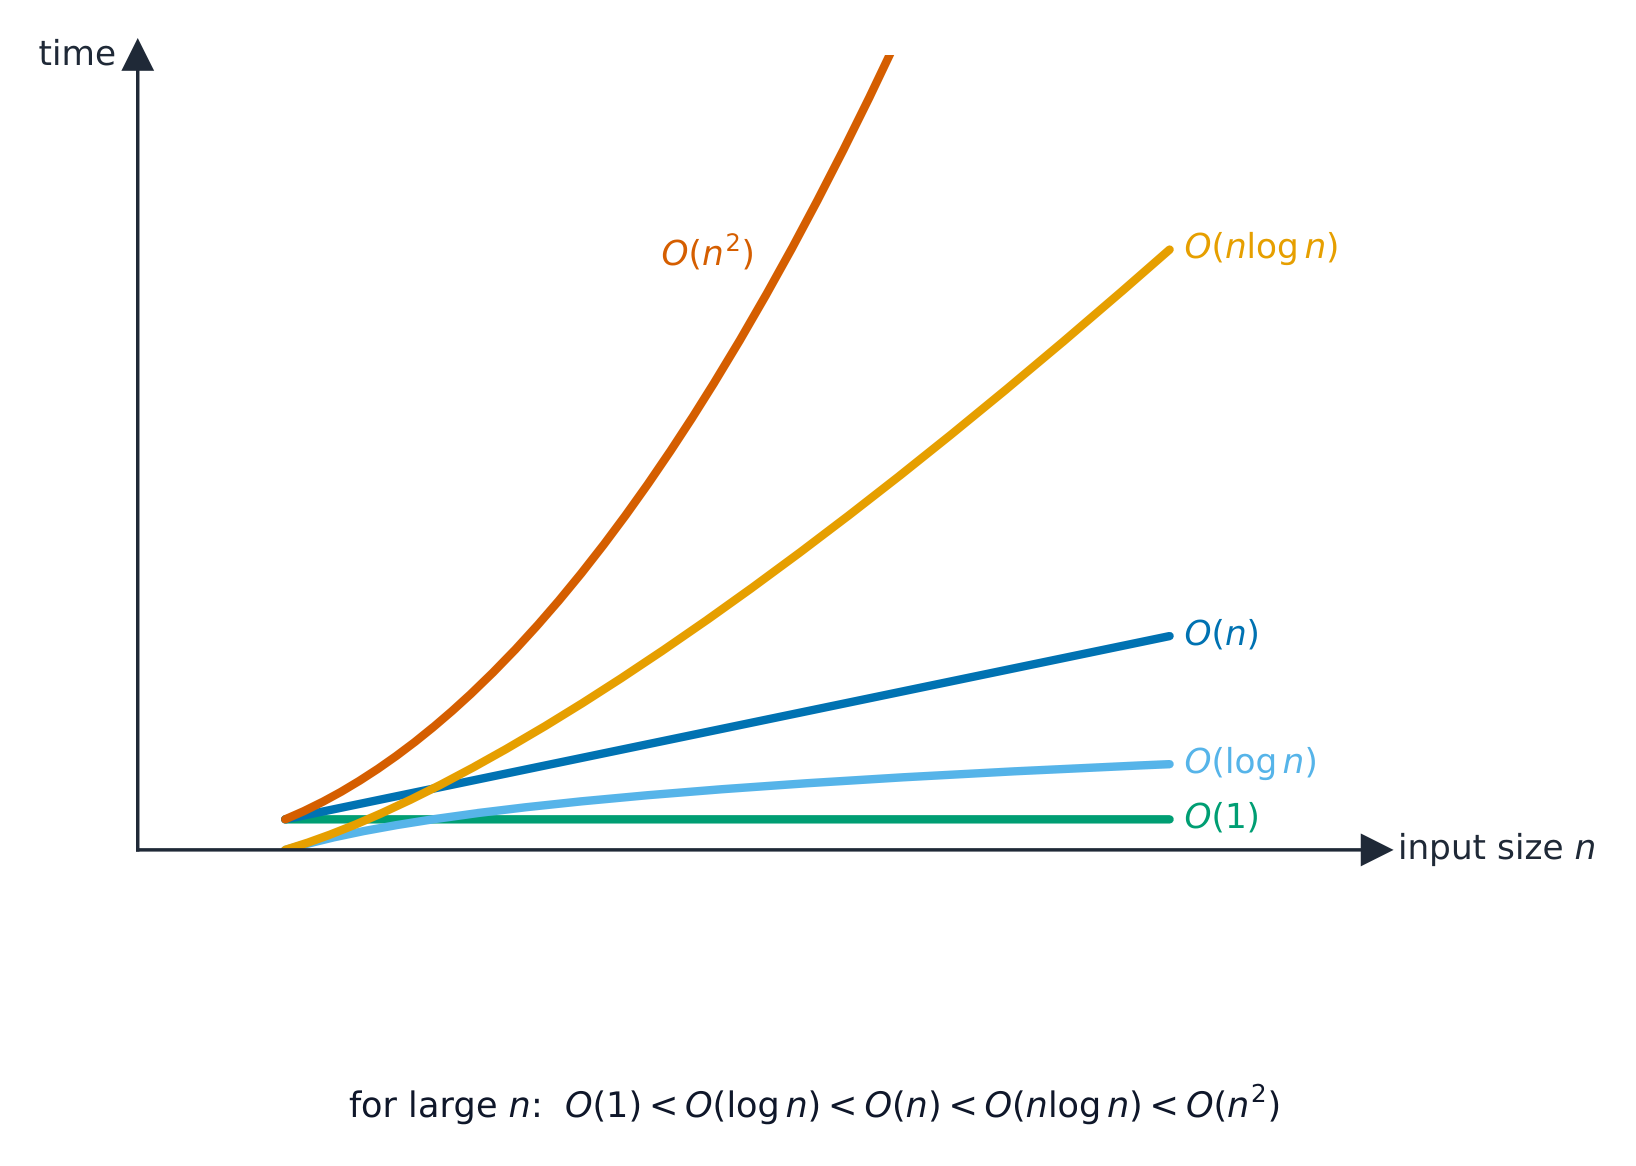
La complexité temporelle mesure comment le temps d'exécution augmente avec la taille de l'entrée $n$, notée en notation Grand OO (le terme dominant) : O(1) constant, O($\log n$) recherche binaire, O($n$) recherche linéaire, O($n \log n$) bons tris, O($n^{2}$) tri à bulles/tri par insertion. Un ordre inférieur est meilleur à grande échelle, même si un autre algorithme est plus rapide pour de petites $n$.
Pour rendre cela concret : pour trier un million d'éléments, un tri $O(n \log n)$ se termine en une fraction de seconde, tandis qu'un tri $O(n^{2})$ peut prendre des minutes.
Exemple résolu. Une liste triée contient $1000$ éléments. Combien de comparaisons chaque recherche nécessite-t-elle dans le pire cas ?
Une recherche linéaire vérifie les éléments un par un, donc elle peut nécessiter jusqu'à $1000$ comparaisons — c'est $O(n)$. Une recherche binaire réduit la liste de moitié à chaque étape, donc elle nécessite au maximum $\lceil \log_2 1000 \rceil = 10$ comparaisons — c'est $O(\log n)$. Doubler la liste à $2000$ éléments ajoute seulement un comparaison à la recherche binaire, mais jusqu'à un autre $1000$ à la recherche linéaire — c'est pourquoi l'ordre de croissance, pas la vitesse brute, décide du gagnant à grande échelle.
Décrire un ordre de complexité. O(1) : le temps est constant, indépendamment du nombre d'éléments (empiler un élément, lire un élément d'un tableau). O($\log n$) : le temps augmente selon le logarithme du nombre d'éléments ; doubler les données n'ajoute donc qu'un nombre fixe d'étapes (recherche dichotomique). O($n$) : le temps augmente proportionnellement au nombre d'éléments (recherche linéaire, un parcours de liste). O($n \log n$) : un peu moins bon que linéaire (tris efficaces). O($n^{2}$) : le temps augmente selon le carré du nombre d'éléments : doubler les données quadruple donc le temps (tri à bulles et tri par insertion). À « Indiquez le grand O d'une recherche dichotomique de Names[0:99] », répondez $O(\log n)$, puis décrivez sa signification comme ci-dessus ; le grand O mesure l'évolution du temps ou de la mémoire, et non le temps réel.
Exemple corrigé (ordre de complexité d'un morceau de code). Indiquez la complexité temporelle de chaque fragment, où n est le nombre d'éléments.
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A est en $O(n^{2})$ : l'instruction interne s'exécute $n$ fois pour chacun des $n$ passages externes, soit $n \times n$ fois au total. B est en $O(\log n)$ : $n$ est divisé par deux à chaque passage, donc la boucle s'exécute environ $\log_2 n$ fois (pour $n = 64$, six passages). C est en $O(n)$ : deux boucles successives prennent $n + n = 2n$ étapes, et les constantes sont supprimées. Règle : les boucles imbriquées se multiplient, les boucles successives s'additionnent, et seul le terme qui croît le plus vite est conservé ; ainsi, $3n^{2} + 5n + 2$ est en $O(n^{2})$.
Complexité spatiale
La complexité spatiale est la mémoire supplémentaire nécessaire. Les tris à bulles et par insertion utilisent O(1) supplémentaire (en place) ; le tri fusion utilise O($n$) ; la récursion utilise de la mémoire de pile proportionnelle à sa profondeur. Il existe souvent un compromis temps-mémoire.
Autres critères
Simplicité (plus facile à coder et à maintenir), stabilité et adaptativité (plus rapide sur des données presque triées). Le bon algorithme dépend des données et des contraintes.
Explorer
La croissance du temps d'exécution avec n
Faites glisser n vers le haut et comparez les courbes : O(1) et O(log n) restent presque plats, O(n) monte régulièrement, O(n²) explose. C'est pourquoi le Big-O — et non un chronomètre — est la manière dont nous comparons les algorithmes sur de grandes entrées.
Explorer
Croissance en notation Big-O
Changez la taille de l'entrée n et comparez la vitesse à laquelle le travail de chaque algorithme augmente — l'idée derrière la complexité temporelle.
19.2
Récursivité
Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer la compréhension de la récursivité | Caractéristiques essentielles de la récursivité Comment la récursivité est exprimée dans un langage de programmation Écrire et tracer des algorithmes récursifs Quand l'utilisation de la récursivité est bénéfique |
| Avoir conscience de ce qu'un compilateur doit faire pour traduire du code de programmation récursif | Utilisation des piles et du déroulement |
Source : Programme Cambridge International

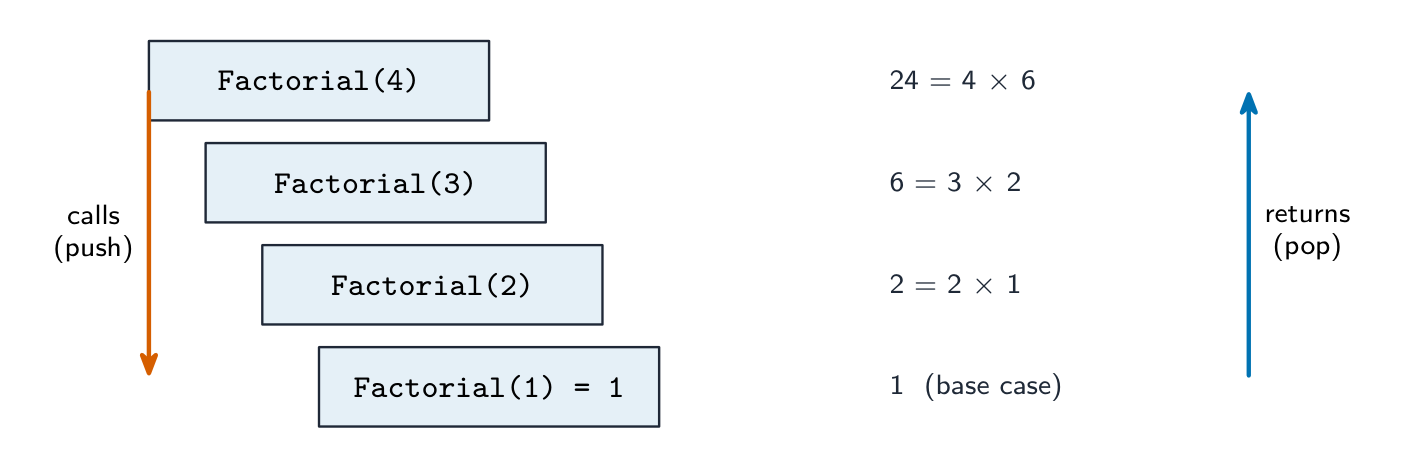
Les algorithmes récursifs utilisent la récurrence : la routine s'appelle elle-même avec une version plus petite du même problème, jusqu'à ce qu'un cas de base arrête la chaîne. Elle a deux parties : le cas de base (assez petit pour être résolu directement — sans lui, la récursion ne s'arrêterait jamais) et le cas récursif (réduire l'entrée et s'appeler elle-même).
Factorielle :
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
La récurrence est naturelle pour les problèmes auto-similaires : les arbres, le diviser pour régner (recherche binaire, tri fusion) et les données imbriquées. Lorsqu'elle est mal adaptée, une boucle est généralement plus propre.
« Décrivez ce que signifie la récursivité » (deux points). Une fonction ou une procédure définie en fonction d'elle-même : elle s'appelle elle-même dans son propre corps, chaque fois avec une version plus petite du problème, jusqu'à atteindre un cas de base. « Indiquez trois caractéristiques essentielles de la récursivité » : (1) un cas de base (condition d'arrêt) qui renvoie une valeur sans nouvel appel ; (2) un cas général dans lequel la routine s'appelle elle-même ; (3) chaque appel rapproche le problème du cas de base (le paramètre est réduit), afin que la récursion se termine. Certains barèmes de correction ajoutent : les valeurs sont renvoyées lors du dépilement des appels.
« Décrivez quand l'utilisation de la récursivité est avantageuse et donnez un exemple. » Lorsque le problème est naturellement défini à partir de versions plus petites de lui-même, de sorte que la solution récursive est plus courte, plus claire et plus proche de la définition mathématique qu'une boucle : une factorielle ou un nombre de Fibonacci, une recherche dichotomique, le parcours d'un arbre binaire, un tri fusion ou un tri rapide, et le traitement de structures imbriquées telles que des dossiers dans des dossiers. C'est un mauvais choix lorsque la profondeur est importante (la pile peut déborder) ou lorsqu'un même sous-problème est calculé de nombreuses fois (Fibonacci naïf).
Tracé d'un appel récursif
Pour Factorial(4) : les appels descendent jusqu'à Factorial(1)=1, puis le déroulement multiplie vers le haut : 2*1=2, 3*2=6, 4*6=24. Résultat final 24. Suivez chaque appel en attente sur une pile.
Exemple corrigé. La fonction ci-dessous est donnée sans explication. Tracez Unknown(3, 5) et indiquez sa sortie et sa valeur de retour.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Appel 1 : $X = 3, Y = 5$ : $3 < 5$, sortie 8, appel Unknown(4, 4). Appel 2 : $4 < 4$ est faux, retour 0. Déroulement : l'appel 1 retourne $0 + 1 = 1$. Sortie 8, valeur de retour 1. Écrivez le tracé sous forme de tableau avec une ligne par appel (paramètres, condition, sortie, ce qu'il retourne), et effectuez les retours depuis l'appel le plus profond vers le haut : c'est-à-dire le déroulement que cherche le barème.
Exemple corrigé (Fibonacci). Fib(n) retourne n lorsque n < 2, sinon Fib(n - 1) + Fib(n - 2). Trouvez Fib(5).
Fib(5) = Fib(4) + Fib(3) ; Fib(4) = Fib(3) + Fib(2) ; Fib(3) = Fib(2) + Fib(1) ; Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Donc Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. Le cas de base est atteint beaucoup de fois (Fib(2) est calculé trois fois), c'est pourquoi cette version est lente : elle effectue 15 appels pour $n = 5$ et double approximativement le nombre d'appels pour chaque augmentation de $n$.
Conversion de la récursivité en itération. Chaque routine récursive peut être réécrite avec une boucle, ce qui utilise moins de mémoire et est plus rapide : conservez un résultat accumulé et boulez du cas de base vers le haut. Factorielle sous forme de boucle :
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Interpellé pour convertir un tri par insertion ou une recherche récursive en une version itérative, remplacez l'appel à soi-même par une boucle sur l'index que la récursivité parcourait, et transformez le cas de base en condition de sortie de boucle.
Risques
- récursion infinie si le cas de base est manqué — plantage avec une débordement de pile.
- forte consommation de mémoire pour une récursivité profonde.
- lente si elle répète des travaux (Fibonacci naïf est exponentiel — utilisez une boucle ou la mémorisation).
Explorer
La récursivité se déroule depuis les feuilles vers le haut
Parcourir fib(4) dans l'ordre où les appels se terminent réellement : les feuilles (cas de base) se résolvent d'abord, puis chaque parent combine ses enfants. Remarquez que fib(2) est calculé deux fois — ce travail répété explique pourquoi la récursivité naïve est lente.
Vocabulaire
Entrainer
| English | Français |
|---|---|
| recursion/rɪˈkɜːʃn/ | récursivité |
| factorial/fækˈtɔːrɪəl/ | factorielle |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | diviser pour régner |
| general case/ˈdʒenərəl keɪs/ | cas général |
| parameters/pəˈræmɪtəz/ | paramètres |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | débordement de pile |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | mémorisation |
| local variables/ˈləʊkl ˈveərɪəblz/ | variables locales |
| stack frame/stæk freɪm/ | trame de pile |
| return address/rɪˈtɜːn əˈdres/ | adresse de retour |
19.2
Ce que fait le compilateur pour le code récursif
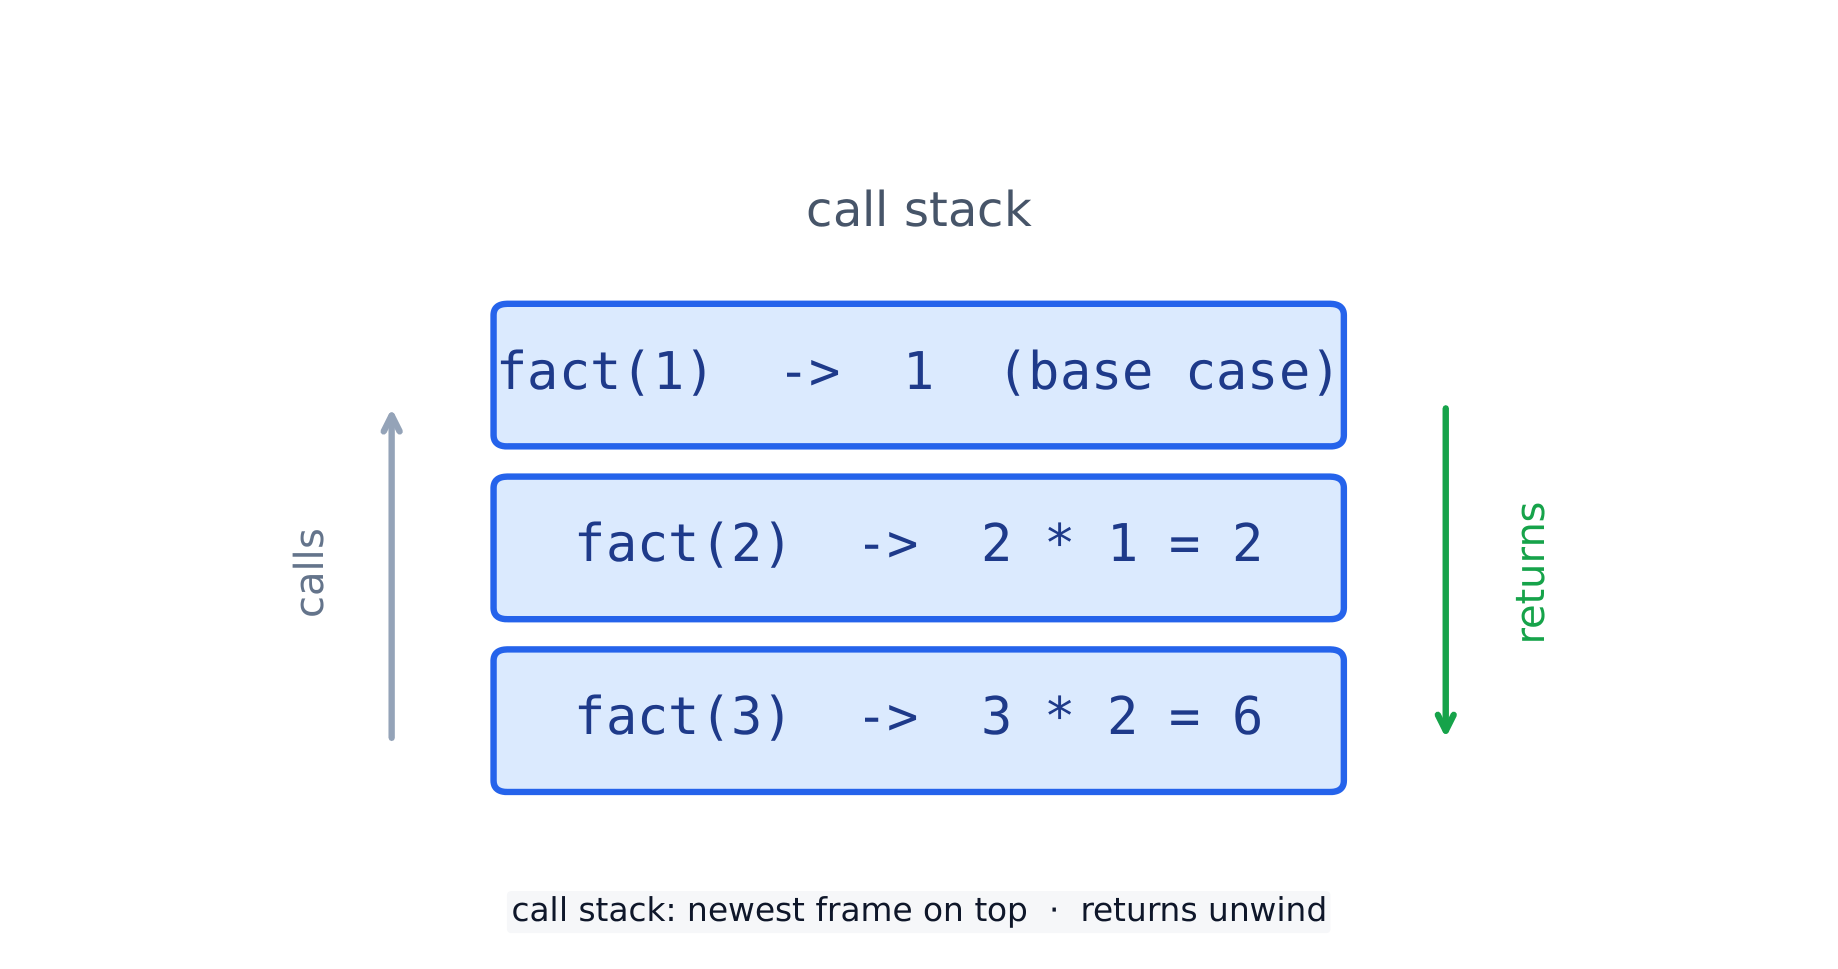
La récursion nécessite que chaque appel possède sa propre copie de ses paramètres et de ses variables locales. Le compilateur conserve ces données sur la pile d'appels. Pour chaque appel, il empile un cadre de pile contenant les paramètres, les variables locales et l'adresse de retour (endroit où reprendre dans l'appelant). Lorsque la fonction retourne, la valeur de retour est transmise, le cadre est retiré, et le contrôle reprend à l'adresse de retour.
Comme chaque appel possède son propre cadre, les appels récursifs n'écrasent pas leurs variables respectives. La pile peut devenir volumineuse lorsque la récursion est profonde, ce qui explique qu'elle puisse déborder. C'est le même mécanisme d'appel et de retour que pour les appels ordinaires non récursifs : il n'existe pas de « mécanisme de récursion » particulier.
« Expliquez pourquoi une pile convient à l'implémentation de la récursivité » (trois points). Chaque appel récursif doit enregistrer son adresse de retour, ses paramètres et ses variables locales, et les appels se terminent dans l'ordre inverse de celui dans lequel ils ont été effectués (le dernier appel est le premier à se terminer). C'est précisément le fonctionnement dernier entré, premier sorti d'une pile : chaque nouvel appel empile un cadre et chaque retour dépile le cadre le plus récent, rétablissant l'état de l'appelant et lui indiquant où reprendre. C'est le rôle du compilateur lorsqu'il traduit du code récursif : il génère l'empilement d'un cadre à chaque appel et son dépilement à chaque retour ; les cadres sont dépilés à mesure que les résultats sont renvoyés.
Vocabulaire
Entrainer
| English | Français |
|---|---|
| call stack/kɔːl stæk/ | pile d'appels |
| base case/beɪs keɪs/ | cas de base |
| recursive case/rɪˈkɜːsɪv keɪs/ | cas récursif |
19.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| recherche linéaire | vérifier chaque item à tour de rôle depuis le début jusqu'à ce que la cible soit trouvée ou la fin atteinte |
| recherche binaire | comparer répétitivement la cible avec l'élément central d'une liste triée et éliminer la moitié qui ne peut pas la contenir |
| tri à bulles | passer répétitivement à travers la liste, échanger les éléments adjacents qui sont dans le mauvais ordre, jusqu'à ce qu'un passage ne fasse aucun échange |
| tri par insertion | prendre chaque élément successivement et l'insérer à sa place correcte parmi les éléments déjà triés |
| type de données abstrait | un ensemble de données et les opérations qui peuvent y être effectuées, défini indépendamment de la manière dont il est stocké |
| pile | une structure dernier entré, premier sorti avec push et pop en haut |
| file | une structure premier entré, premier sorti avec des éléments ajoutés à l'arrière et retirés à l'avant |
| liste chaînée | une séquence de nœuds, chacun contenant des données et un pointeur vers le nœud suivant, avec un pointeur de départ |
| arbre binaire | des nœuds contenant chacun des données et des pointeurs vers un sous-arbre gauche de valeurs inférieures et un sous-arbre droit de valeurs supérieures |
| notation Big O | une façon de classifier le temps (ou la mémoire) nécessaire par un algorithme selon sa croissance avec la taille de l'entrée |
| récursivité | une routine qui s'appelle elle-même avec une version plus petite du problème jusqu'à ce qu'un cas de base arrête les appels |
| cas de base | la condition selon laquelle une routine récursive retourne sans s'appeler elle-même |
| déroulement | les retours d'une chaîne d'appels récursifs, du dernier appel au premier, alors que les trames de pile sont retirées |
19.2
Conseils d'examen
- Recherches : la recherche linéaire ne nécessite aucun ordre et O($n$) ; la recherche binaire nécessite un tableau trié, divise par deux à chaque étape et est en O($\log n$). Connaître les deux algorithmes par cœur, y compris les bornes et le drapeau.
- Tries : tri à bulles avec indicateur d'échange, tri par insertion avec une clé qui décale les éléments plus grands vers la droite ; tous deux en O($n^{2}$) dans le pire des cas, O($n$) sur des données déjà triées. Les performances dépendent du nombre d'éléments et de leur degré de tri.
- Les implémentations de TDA sont une gestion de pointeurs : un pointeur supérieur ; avant, arrière et compteur avec MOD ; début, pointeurs et liste libre ; racine avec pointeurs gauche et droit. Toujours vérifier les états plein et vide.
- Le grand O décrit l'évolution : constante, logarithmique, linéaire, quadratique. Pour une recherche dichotomique, dites « doubler les données ajoute une comparaison ».
- Récursivité : cas de base, cas général, progression vers le cas de base ; bénéfique lorsque le problème est défini en termes de lui-même ; une pile contient les adresses de retour et les variables car les appels retournent dans l'ordre inverse. Tracez avec un tableau et déroulez depuis l'appel le plus profond.
Erreurs courantes
- Écrire $O(2n)$ ou $O(n^{2} + n)$ : supprimez les constantes et les termes de moindre ordre pour obtenir $O(n)$ et $O(n^{2})$.
- Calculer l'indice du milieu sous la forme $(Lower + Upper) / 2$ lors d'un suivi : la version de l'examen utilise
DIV, donc arrondissez à l'entier inférieur. - Utiliser une recherche binaire sur des données non triées, ou sur une liste chaînée ; et définir
Lower ← MiddleIndexau lieu deMiddleIndex + 1, ce qui boucle indéfiniment. - Une boucle intérieure de tri à bulles qui parcourt toute le tableau à chaque passe, ou un échange sans variable temporaire.
- Un push ou enqueue qui ne teste pas l'état plein, ou un pop ou dequeue qui ne teste pas l'état vide.
- Déplacer le pointeur avant de la file sans MOD dans une file circulaire, ou considérer front = rear comme signifiant toujours vide.
- Insérer dans une liste chaînée en décalant le contenu du tableau ; seuls les pointeurs changent.
- Une fonction récursive sans cas de base, ou dont l'appel récursif ne rend pas le problème plus petit.
- Tracer un appel récursif mais oublier d'ajouter le travail en attente sur le chemin retour.
- Répondre à « pourquoi une pile » par « parce qu'elle est rapide » ; la raison est l'ordre dernier entré, premier sorti des retours.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.