| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer la compréhension de la manière dont les graphes peuvent être utilisés pour faciliter l'Intelligence Artificielle (IA) | But et structure d'un graphe Utiliser l'algorithme A* et l'algorithme de Dijkstra pour effectuer des recherches sur un graphe Les candidats ne seront pas tenus d'écrire des algorithmes pour configurer, accéder ou effectuer des recherches sur des graphes |
| Montrer la compréhension de la manière dont les réseaux neuronaux artificiels ont contribué à l'apprentissage automatique | |
| Montrer la compréhension de l'Deep Learning, de l'Apprentissage Automatique et de l'Apprentissage par Renforcement et des raisons d'utiliser ces méthodes. | Comprendre les catégories d'apprentissage automatique, y compris l'apprentissage supervisé, l'apprentissage non supervisé |
| Montrer la compréhension de la rétropropagation des erreurs et des méthodes de régression en apprentissage automatique |
Intelligence artificielle (IA)
Informatique A-Level · Sujet 18
 13:12
Ce qu'est l'IA
Personne n'a jamais écrit les règles pour distinguer un chat d'un chien. Aucun programmeur ne s'est assis et tapé « si cela a des oreilles pointues et des moustaches ». Et pourtant votre téléphone le fait…
Narration en anglais · Sous-titres anglais + 中文 incrustés
18.1
Qu'est-ce que l'IA

Programme
Source : Programme Cambridge International
Intelligence artificielle 人工智能 (IA) crée des systèmes capables d'accomplir des tâches normalement réservées à l'intelligence humaine — reconnaissance de la parole et des images, traduction, jeux, conduite automobile, génération de texte. La plupart des IA modernes utilisent l'apprentissage automatique 机器学习 — algorithmes apprenant des modèles à partir de données plutôt que programmés étape par étape. À l'intérieur, l'apprentissage profond 深度学习, utilisant des réseaux de neurones 神经网络 à multiples couches, domine depuis les années 2010.
Un robot humanoïde 人形机器人 intègre plusieurs de ces capacités dans un seul corps : il utilise l'IA pour voir des visages, comprendre la parole et bouger son visage et ses bras de manière réaliste.

Explorer
Laboratoire de type d'apprentissage IA
Classez les exemples d'IA selon le type d'apprentissage ou la préoccupation impliquée.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | 人形机器人 | rén xíng jī qì rén |
18.1
Graphes en IA

De nombreux problèmes d'IA reposent sur un graphe 图 — des nœuds 节点 (états, lieux) reliés par des arêtes 边 (mouvements, relations).
- recherche de chemin : les routes forment un graphe ; l'itinéraire le plus court est une recherche dans le graphe (algorithme de Dijkstra, algorithme A*).
- jeux vidéo : chaque position du plateau est un nœud, chaque coup une arête ; minimax 极小化极大 avec élagage alpha-bêta explore l'arbre de jeu.
- recherche dans l'espace des états : un problème de planification consiste à passer d'un état à l'autre en appliquant des opérateurs pour atteindre un but.
- représentation des connaissances : un réseau sémantique 语义网络 a des concepts comme nœuds et des relations comme arêtes (« chien EST-UN animal ») ; un graphe de connaissances 知识图谱 stocke des faits sur le monde pour les moteurs de recherche et assistants.
Les outils standards pour naviguer dans les graphes incluent la recherche en largeur 广度优先搜索 et la recherche en profondeur 深度优先搜索.
« Décrivez la finalité et la structure d'un graphe dans un système IA. » Finalité : représenter un problème sous forme d'ensemble d'états (ou lieux) et des mouvements possibles entre eux, afin qu'un algorithme puisse le parcourir pour trouver une solution, comme le chemin le plus court ou le moins cher, ou le meilleur mouvement suivant. Structure : ensemble de nœuds (sommets), chacun représentant un état, un lieu ou un objet, reliés par des arêtes représentant les connexions entre eux ; chaque arête peut porter un poids (coût, distance ou temps), et les arêtes peuvent être orientées (sens unique) ou non orientées. « Expliquez l'utilisation des graphes pour faciliter l'IA » : le graphe est le modèle sur lequel s'exécutent les algorithmes de recherche de l'IA : A* et l'algorithme de Dijkstra trouvent des chemins optimaux (navigation, routage), les positions de jeu forment un arbre exploré pour trouver le meilleur coup, et les connaissances stockées sous forme de graphe permettent au système de raisonner sur la manière dont les faits sont liés.
 Le graphe utilisé ci-dessous : les chiffres sur les arêtes sont les vraies distances ; les chiffres rouges sont l'estimation heuristique 启发式 de chaque nœud indiquant la distance restante vers le but, utilisée uniquement par A*
Algorithme de Dijkstra. Il trouve la distance la plus courte du point de départ à chaque nœud. Tenez un tableau des meilleures distances trouvées jusqu'à présent vers chaque nœud (départ 0, tous les autres infini). Prenez répétitivement le nœud non visité ayant la distance la plus petite, marquez-le comme visité, et pour chaque voisin vérifiez si passer par ce nœud donne une distance plus courte ; si oui, mettez à jour et enregistrez d'où il vient. Arrêtez-vous lorsque tous les nœuds sont visités (ou la cible atteinte).
Exemple résolu. Trouvez les distances les plus courtes de H vers tous les autres nœuds dans le graphe ci-dessus.
| étape | visite | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| début | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
Distances minimales : A 4, B 3, D 8, C 9, G 10, et le chemin vers G est H–A–D–G (lire les étiquettes « venu de » à l'envers). À l'étape 3, A offre à D une distance de $4 + 4 = 8$, meilleure que les 9 trouvés via B, donc D est mis à jour ; à l'étape 5, C pourrait atteindre G à $9 + 3 = 12$, pire que 10, donc rien ne change. Montrer ces comparaisons constitue le « calcul » demandé par la question.
Algorithme A*. Dijkstra explore dans toutes les directions. A* ajoute une heuristique $h$, une estimation de la distance restant à parcourir, et expandit toujours le nœud ayant la plus petite $f = g + h$, où $g$ est la distance parcourue jusqu'à présent. Avec une heuristique raisonnable (ne jamais surestimer), il trouve le même chemin le plus court tout en explorant beaucoup moins de nœuds, c'est pourquoi les GPS et les jeux l'utilisent. L'examen fournit $h$ pour chaque nœud et un tableau à remplir.
Exemple résolu. Trouvez un chemin de H à G avec A*, en montrant le calcul.
| nœud expandi | $g$ jusqu'à présent | $h$ | $f = g + h$ | voisins ajoutés (nœud : $g$, $h$, $f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B (ex æquo avec A ; l'un ou l'autre) | 3 | 6 | 9 | D via B : 9, 2, 11 |
| A | 4 | 5 | 9 | C : 9, 3, 12 ; D via A : 8, 2, 10 (meilleur que 11, garder) |
| D | 8 | 2 | 10 | G : 10, 0, 10 ; C via D : 9 (pas meilleur) |
| G | 10 | 0 | 10 | but atteint |
Chemin H–A–D–G, longueur 10, identique à celui de Dijkstra, mais C n'a jamais été expandi. Chaque fois qu'un nœud est atteint par un deuxième itinéraire, gardez la plus petite $g$ ; la recherche se termine lorsque le but est le nœud ayant la plus petite $f$. Indiquez les valeurs $g$, $h$ et $f$ dans chaque ligne : ce sont les points attribués.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| graph/ɡræf/ | 图 | tú |
| nodes/nəʊdz/ | 节点 | jié diǎn |
| edges/ˈedʒɪz/ | 边 | biān |
| minimax/ˈmɪnɪmæks/ | 极小化极大 | jí xiǎo huà jí dà |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | 语义网络 | yǔ yì wǎng luò |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | 知识图谱 | zhī shí tú pǔ |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | 广度优先搜索 | guǎng dù yōu xiān sōu suǒ |
| depth-first search/depθ fɜːst sɜːtʃ/ | 深度优先搜索 | shēn dù yōu xiān sōu suǒ |
| weight/weɪt/ | 权重 | quán zhòng |
| heuristic/hjuːˈrɪstɪk/ | 启发式 | qǐ fā shì |
| labels/ˈleɪblz/ | 标签 | biāo qiān |
18.1
Réseaux de neurones artificiels (RNA)

Un RNA s'inspire des neurones du cerveau. Un neurone artificiel 人工神经元 :
- prend plusieurs valeurs d'entrée, multiplie chacune par un poids 权重, et les additionne avec un terme de biais 偏置项.
- applique une fonction d'activation 激活函数 (une fonction non linéaire telle que ReLU) à la somme.
- produit le résultat, qui alimente les neurones situés plus loin.
Les neurones sont organisés en couches : une couche d'entrée, une ou plusieurs couches cachées 隐藏层 (où des motifs internes utiles sont appris), et une couche de sortie. Avec de nombreuses couches cachées, c'est un réseau neuronal profond 深度神经网络, et son entraînement relève du deep learning.

Les RNN permettent aux modèles d'apprendre des motifs complexes directement à partir de données brutes (pixels, audio, texte) sans conception manuelle de caractéristiques — ce qui a conduit à des percées dans la reconnaissance d'images 图像识别, la reconnaissance vocale 语音识别, la traduction automatique 机器翻译 et le jeu vidéo. Ils performant bien avec de grandes quantités de données, des entrées bruitées ou très complexes, et des motifs trop difficiles à capturer par des règles explicites.
"Expliquez ce qu'est un réseau neuronal artificiel." Un modèle inspiré du réseau de neurones du cerveau, composé de couches de nœuds connectés : une couche d'entrée, une ou plusieurs couches cachées et une couche de sortie. Chaque connexion possède un poids ; chaque nœud somme ses entrées pondérées et transmet le résultat à travers une fonction d'activation vers la couche suivante. "Expliquez comment les RNN permettent l'apprentissage automatique" (trois points) : le réseau est entraîné sur de nombreux exemples ; pour chaque exemple, la sortie est comparée au résultat attendu et l'erreur est utilisée pour ajuster les poids (rétropropagation) afin que l'erreur diminue ; après avoir vu suffisamment d'exemples, les poids encodent les motifs des données, et le réseau peut alors classifier ou prédire pour de nouvelles données jamais vues auparavant. "Indiquez la raison d'avoir plusieurs couches cachées" : chaque couche supplémentaire combine les caractéristiques trouvées par la couche précédente en des caractéristiques plus complexes et plus abstraites, permettant au réseau d'apprendre des relations plus complexes (lignes, puis formes, puis objets) ; c'est cela qui rend un réseau "profond".
Explorer
Touchez les parties d'un réseau neuronal
Explorez les couches. Les données circulent de gauche à droite : la couche d'entrée prend les caractéristiques, les couches cachées apprennent des motifs, et la couche de sortie donne la réponse — chaque connexion portant un poids ajusté par l'entraînement.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | 人工智能 | rén gōng zhì néng |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| deep learning/diːp ˈlɜːnɪŋ/ | 深度学习 | shēn dù xué xí |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | 神经网络 | shén jīng wǎng luò |
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | 人工神经元 | rén gōng shén jīng yuán |
| bias term/ˈbaɪəs tɜːm/ | 偏置项 | piān zhì xiàng |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | 激活函数 | jī huó hán shù |
| hidden layers/ˈhɪdn ˈleɪəz/ | 隐藏层 | yǐn cáng céng |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | 深度神经网络 | shēn dù shén jīng wǎng luò |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | 图像识别 | tú xiàng shí bié |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | 语音识别 | yǔ yīn shí bié |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | 机器翻译 | jī qì fān yì |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | 强化学习 | qiáng huà xué xí |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 监督学习 | jiān dū xué xí |
18.1
Apprentissage automatique, apprentissage profond, apprentissage par renforcement
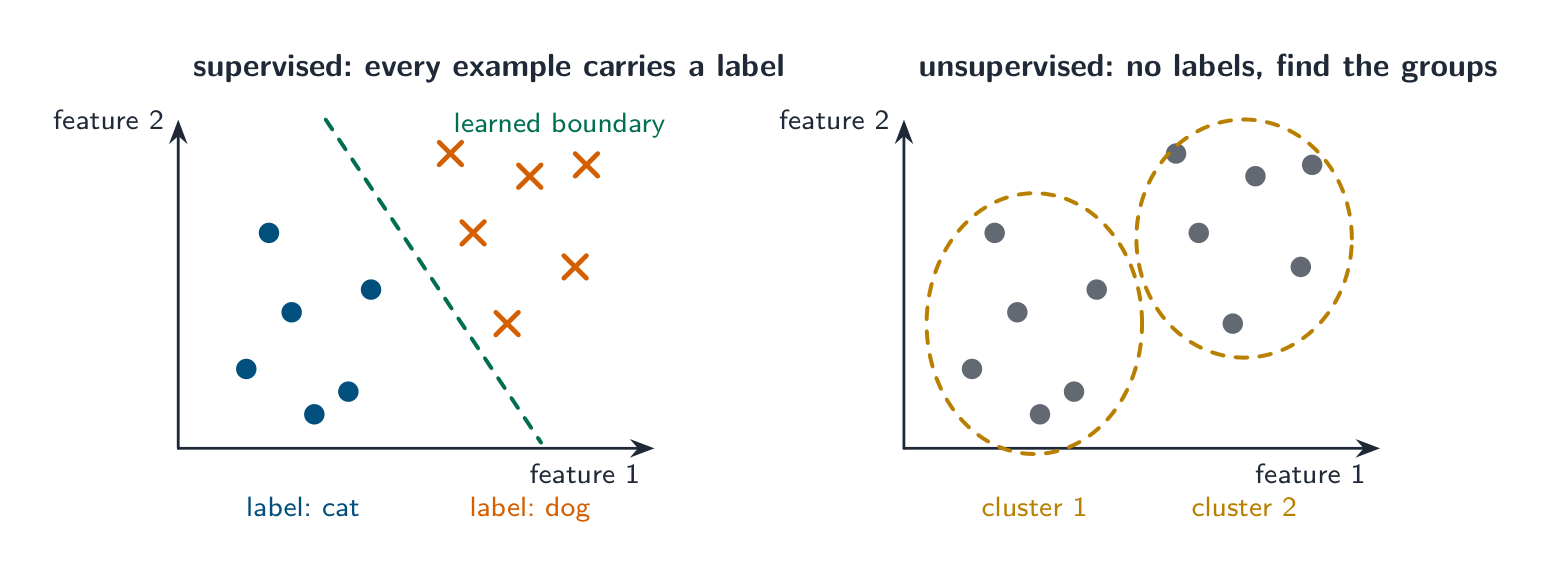
Apprentissage automatique
Le terme générique désignant tout algorithme apprenant à partir de données. Trois paradigmes :
- apprentissage supervisé 监督学习 — les données comportent des étiquettes 标签 (images taguées "chat"/"chien") ; l'algorithme apprend la relation entrée → étiquette. Utilisé pour la classification 分类 (une catégorie) et la régression.
- apprentissage non supervisé 无监督学习 — pas d'étiquettes ; l'algorithme découvre la structure, par exemple un cluster 聚类的 regroupement de clients similaires.
- apprentissage par renforcement (ci-dessous).
Utilisez l'AM lorsque des règles explicites seraient irréalistes (filtres anti-spam, recommandations, détection de fraudes).
"Décrivez l'apprentissage supervisé et non supervisé" (selon les formulations marquées). Apprentissage supervisé : l'algorithme est entraîné sur des données d'entraînement 训练数据 étiquetées, chaque exemple étant associé à la sortie correcte (la cible) ; il apprend la relation entre les entrées et les sorties et l'utilise pour classifier ou prédire de nouvelles entrées ; les réponses étant connues pendant l'entraînement, l'erreur peut être mesurée. Apprentissage non supervisé : les données sont non étiquetées, sans réponses correctes fournies ; l'algorithme cherche des motifs, structures ou regroupements dans les données par lui-même (regroupement d'éléments similaires, découverte d'associations) ; la sortie est un ensemble de catégories ou de relations qui n'avaient pas été définies à l'avance. Comment ils diffèrent : données étiquetées contre données non étiquetées ; sorties connues contre structure découverte ; l'apprentissage supervisé est utilisé pour prédire (classification, régression), l'apprentissage non supervisé pour explorer (clustering, détection d'anomalies). Les deux sont des catégories de l'apprentissage automatique ; le troisième est l'apprentissage par renforcement.

Apprentissage profond
Une sous-catégorie de l'AM utilisant des réseaux neuronaux profonds. Les couches inférieures apprennent des motifs simples (lignes, phonèmes), les couches supérieures les combinent en concepts abstraits. Il nécessite beaucoup de données et beaucoup de puissance de calcul (GPU) ; pour de petits jeux de données, des méthodes d'AM plus simples font souvent mieux.
"Expliquez ce qu'est l'apprentissage profond" (trois points). Apprentissage automatique utilisant des réseaux neuronaux artificiels dotés de nombreuses couches cachées (réseaux profonds) ; le réseau est entraîné sur de très grandes quantités de données, et chaque couche extrait des caractéristiques à partir de la sortie de la couche inférieure, de sorte que le réseau apprend lui-même les caractéristiques nécessaires plutôt que de les voir spécifiées par le programmeur. Raisons de son utilisation : il peut résoudre des problèmes trop complexes pour des règles manuscrites ou des modèles peu profonds (reconnaissance faciale, compréhension de la parole, traduction de texte) ; il s'améliore à mesure que plus de données deviennent disponibles ; il élimine le besoin d'ingénierie de caractéristiques humaine ; et il peut gérer des données non structurées telles que des images, du son et du texte. Comment le rendre plus efficace : plus de données d'entraînement (et mieux étiquetées) ; plus de couches ou de nœuds, dans les limites du sur-apprentissage ; plus de puissance de traitement (GPU) et temps d'entraînement ; réglage du taux d'apprentissage et d'autres paramètres. Exemples : reconnaissance vocale dans les assistants vocaux, reconnaissance d'images dans les examens médicaux et les voitures autonomes, traduction automatique, systèmes de recommandation.
Apprentissage par renforcement
Dans l'apprentissage par renforcement 强化学习, un agent 智能体 agit dans un environnement ; chaque action modifie l'état et rapporte une récompense 奖励. L'agent apprend une politique 策略 (une stratégie) qui maximise la récompense totale au fil du temps, par essai-erreur sans étiquettes au départ. Utilisé pour les problèmes de décision séquentielle — jeux, contrôle robotique, conduite autonome.
"Expliquez ce qu'est l'apprentissage par renforcement" (trois points). Un agent apprend en interagissant avec son environnement : il effectue une action, l'environnement passe à un nouvel état et rapporte une récompense (ou une pénalité), et l'agent ajuste son comportement pour maximiser la récompense totale au fil du temps. Il n'y a pas de données étiquetées : l'agent apprend par essai-erreur, découvrant quelles actions sont bonnes grâce aux récompenses qu'il reçoit, et forme progressivement une politique indiquant quoi faire dans chaque état. Utilisé là où la bonne réponse n'est pas connue à l'avance mais où le résultat d'une action peut être noté : jeu vidéo (échecs, Go), contrôle robotique, gestion des feux de circulation, allocation de ressources. Un ordinateur jouant aux échecs contre un utilisateur apprend ainsi, ou explore l'arbre du jeu avec minimax pour choisir le coup dont le pire résultat est le meilleur.

Une voiture autonome 自动驾驶汽车 est un exemple réel. Les capteurs Lidar 激光雷达 et caméras (l'unité rotative sur le toit) construisent une image en direct de la route, et une politique apprise décide comment diriger, accélérer et freiner en toute sécurité.


Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| classification/ˌklæsɪfɪˈkeɪʃn/ | 分类 | fēn lèi |
| cluster/ˈklʌstə/ | 聚类 | jù lèi |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | 训练数据 | xùn liàn shù jù |
| learning rate/ˈlɜːnɪŋ reɪt/ | 学习率 | xué xí lǜ |
| self-driving car/self ˈdraɪvɪŋ kɑː/ | 自动驾驶汽车 | zì dòng jià shǐ qì chē |
| agent/ˈeɪdʒənt/ | 智能体 | zhì néng tǐ |
| reward/rɪˈwɔːd/ | 奖励 | jiǎng lì |
| policy/ˈpɒlɪsi/ | 策略 | cè lüè |
| lidar/ˈlaɪdɑː/ | 激光雷达 | jī guāng léi dá |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | 反向传播 | fǎn xiàng chuán bō |
18.1
Entraînement d'un RNN : rétropropagation
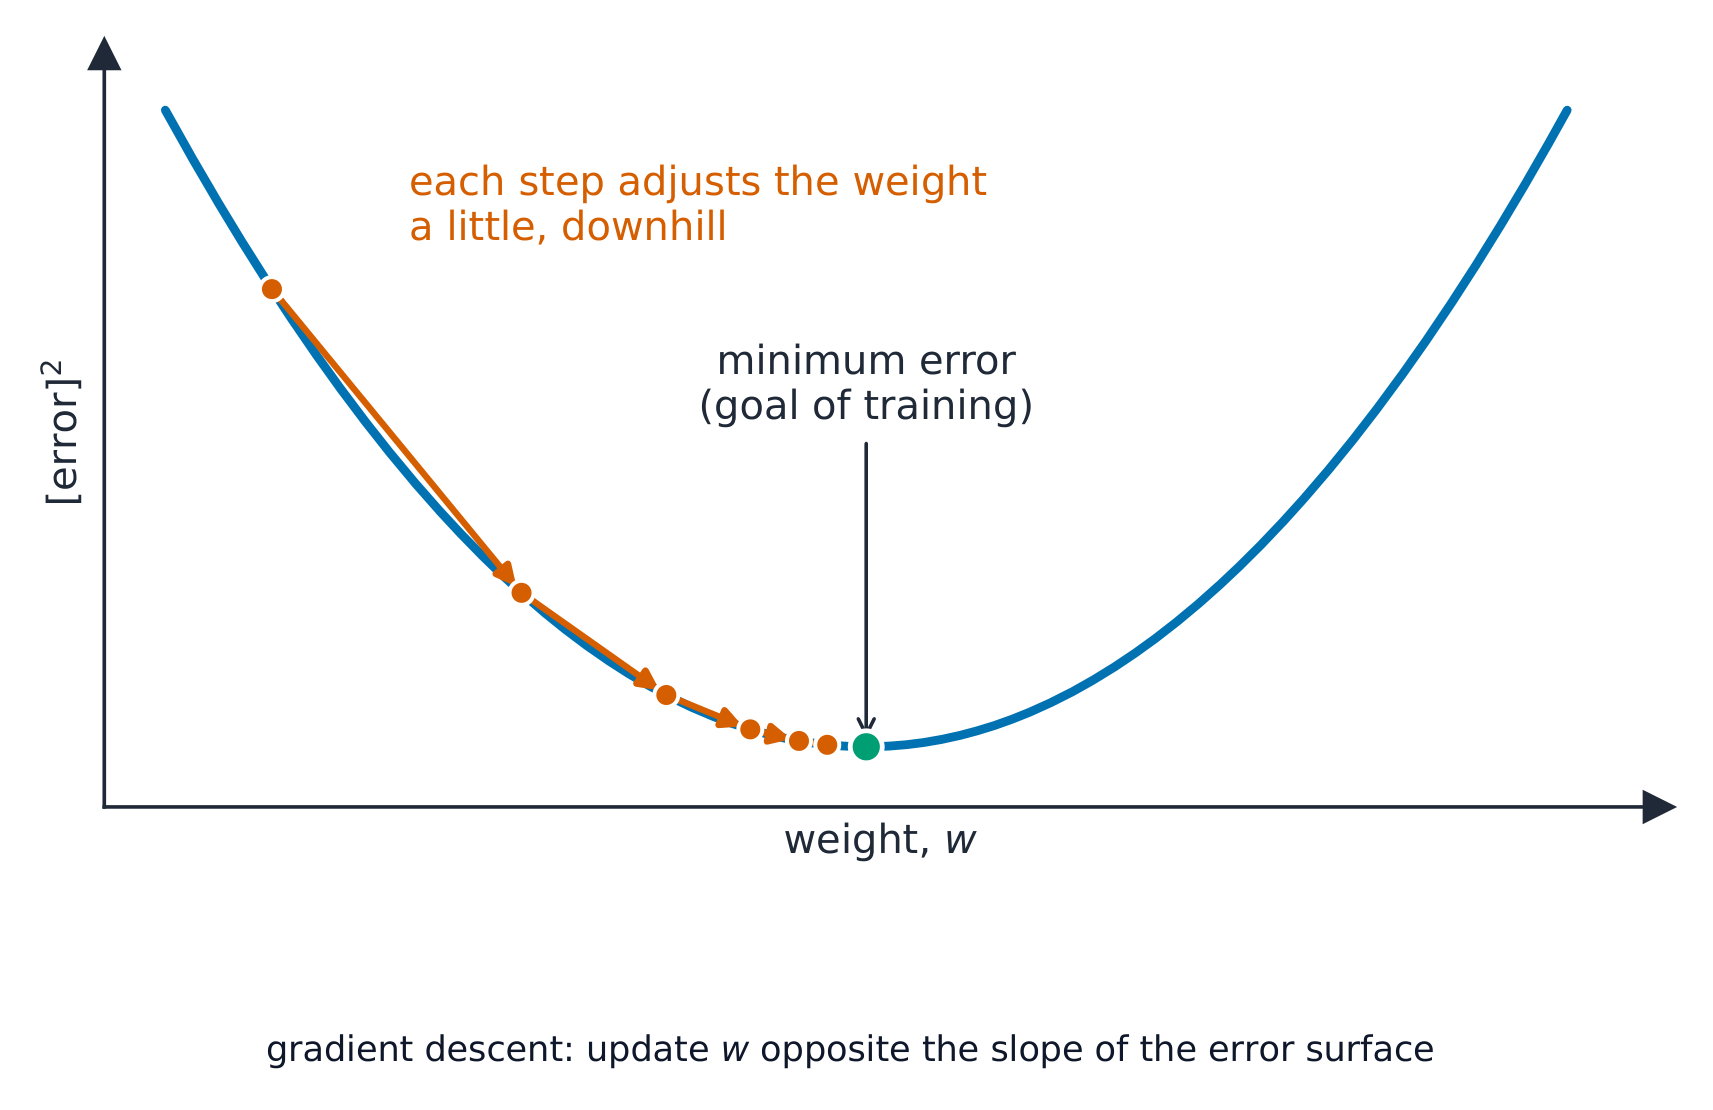
L'entraînement ajuste les poids pour que les sorties correspondent aux cibles. La méthode standard est la rétropropagation 反向传播 (rétropropagation d'erreurs) combinée à la descente de gradient 梯度下降. Pour chaque exemple d'entraînement :
- passage avant — acheminer l'entrée jusqu'à la sortie.
- calculer l'erreur avec une fonction de perte 损失函数 (un nombre unique représentant l'écart de la sortie).
- passage arrière — propager l'erreur en sens inverse, calculant le gradient de chaque poids (sa contribution à l'erreur) en utilisant la règle de chaîne.
- mettre à jour les poids d'un petit pas (défini par le taux d'apprentissage 学习率) réduisant l'erreur.
Répéter sur de nombreux exemples et de nombreux passages (épisodes 训练轮次) jusqu'à ce que l'erreur cesse de diminuer. Le nom « back » vient de l'étape 3 : l'erreur circule depuis la sortie vers l'arrière jusqu'à l'entrée, permettant de trouver le gradient de chaque poids en un seul balayage. Après entraînement, une nouvelle entrée nécessite un seul passage avant pour obtenir une prédiction.
"Décrivez la méthode de rétropropagation des erreurs" (quatre points). (1) Une entrée est envoyée vers l'avant à travers le réseau et sa sortie est comparée à la sortie attendue (cible) ; (2) la différence constitue l'erreur ; (3) l'erreur est propagée en arrière à travers le réseau, couche par couche de la sortie vers l'entrée, et la part de l'erreur attribuée à chaque poids est calculée ; (4) les poids sont ajustés proportionnellement à leur contribution, dans la direction qui réduit l'erreur ; (5) le processus est répété avec de nombreux exemples jusqu'à ce que l'erreur soit aussi faible que requis. L'intérêt de cette méthode est qu'un réseau avec des couches cachées n'a aucun moyen direct de savoir quel poids interne a causé une erreur de sortie ; la rétropropagation répartit la responsabilité.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | 梯度下降 | tī dù xià jiàng |
| loss function/lɒs ˈfʌŋkʃn/ | 损失函数 | sǔn shī hán shù |
| epochs/ˈiːpɒks/ | 训练轮次 | xùn liàn lún cì |
18.1
Régression

Certaines tâches prédisent un nombre (prix d'une maison, température de demain) — régression 回归, contrairement à la classification (une catégorie).
La régression linéaire 线性回归 ajuste une droite (ou un hyperplan) :
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$
Choisissez les coefficients pour minimiser la somme des erreurs au carré par rapport aux données d'entraînement. Utilisez-le lorsque la relation semble approximativement linéaire et que vous souhaitez un modèle interprétable. Pour des données courbes, utilisez des méthodes de régression polynomiale, à arbre de décision ou à réseau neuronal — même principe : définissez un modèle, définissez une fonction de perte, et ajustez les paramètres pour la minimiser. La régression et la classification sont toutes deux supervisées ; le choix dépend du fait que la réponse soit un nombre ou une catégorie.
"Décrivez les méthodes de régression en apprentissage automatique" (deux points). Méthodes statistiques qui identifient la relation entre des variables d'entrée et une sortie continue, en ajustant une fonction (une droite ou une courbe) sur les données d'entraînement avec l'erreur totale minimale ; la fonction ajustée est ensuite utilisée pour prédire la sortie pour de nouvelles entrées. La régression linéaire ajuste une droite ; d'autres méthodes ajustent des courbes. La régression prédit une valeur (un prix, une température, un temps) ; la classification prédit une catégorie, c'est cette distinction que l'examen demande.
Explorer
Ajustement d'une droite de régression
Faites glisser les contrôles. La régression linéaire trace la droite qui minimise la somme des carrés des distances aux points de données — elle prédit ensuite un nombre pour toute nouvelle entrée.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| regression/rɪˈɡreʃn/ | 回归 | huí guī |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 无监督学习 | wú jiān dū xué xí |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | 线性回归 | xiàn xìng huí guī |
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | 光学字符识别 | guāng xué zì fú shí bié |
| text-to-speech/tekst tə spiːtʃ/ | 文本转语音 | wén běn zhuǎn yǔ yīn |
18.1
Comment l'IA est utilisée dans un scénario réel
De nombreux scénarios d'examen suivent le même schéma — un modèle d'apprentissage profond formé sur des données étiquetées, souvent plusieurs combinés dans un pipeline :
- identification des clients dans un magasin automatisé : le système est formé sur des images faciales étiquetées ; une caméra capture un visage ; la reconnaissance d'image extrait une représentation ; elle est comparée aux clients enregistrés ; la correspondance la plus proche identifie la personne.
- lecture de texte depuis des images : la reconnaissance d'image trouve les zones de texte ; la reconnaissance optique de caractères 光学字符识别 extrait les caractères ; la traduction machine les convertit ; la synthèse vocale 文本转语音 les lit à voix haute.
- détection des articles au guichet : une IA de détection d'objets, formée sur des images de produits étiquetées, voit quels articles vont dans un panier et facture le compte.
Au moment où un utilisateur interagit avec le système, le modèle est rapide — il effectue uniquement une inférence en avantpropagation ; l'intelligence réside dans les motifs appris lors de l'entraînement.
Réponses types pour les questions de scénario. Une caméra de parking lit les plaques d'immatriculation : la caméra capture une image ; une IA formée sur de nombreuses images étiquetées de plaques localise la plaque dans l'image ; la reconnaissance de caractères (un classificateur d'apprentissage profond, encore formé sur des caractères étiquetés) convertit la plaque en texte ; le texte est stocké avec l'heure et apparié lorsque la voiture quitte le lieu. Un système de vidéosurveillance détecte et suit une personne : un logiciel de reconnaissance d'image formé sur des images de personnes étiquetées identifie une personne dans chaque trame ; le système compare les trames successives pour suivre son mouvement ; un mouvement inhabituel peut déclencher une alerte. Parole convertie en commandes : la reconnaissance vocale formée sur de nombreuses voix enregistrées convertit le son en texte ; le système apparie le texte à un ensemble de commandes connues ; il s'améliore à mesure qu'il est corrigé. Une caméra qui met au point sur les visages : un modèle de détection de visages formé sur des visages étiquetés trouve la zone du visage, et l'objectif est ajusté pour mettre cette zone au point. Connexion bancaire par reconnaissance faciale : l'application capture le visage, un réseau profond en extrait les caractéristiques, et elles sont comparées aux caractéristiques stockées pour ce client. Dans tous les cas, le schéma est : formé sur des exemples étiquetés, extrait des caractéristiques, apparie ou classe une nouvelle entrée.
Exemple résolu. Pour chaque tâche, dites si elle nécessite une régression ou une classification, et à quoi ressemblerait la couche de sortie d'un ANN : (a) prévoir la température de demain ; (b) décider si un e-mail est du spam. Demandez quelle sorte de chose est prédite. (a) Une température est un nombre sur une échelle continue, donc c'est une régression, et la couche de sortie est un neuron unique contenant cette valeur. (b) Spam ou non-spam est une catégorie, donc c'est une classification, et la sortie donne une probabilité par classe. Les deux sont un apprentissage supervisé : chacun a besoin d'exemples étiquetés pour l'entraînement, et l'entraînement ajuste les poids par rétropropagation pour réduire l'erreur. La question décisive est simplement nombre-ou-catégorie - pas à quel point la tâche semble difficile.
18.1
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| graphe (en IA) | un ensemble de nœuds représentant des états ou des emplacements, reliés par des arêtes représentant des connexions, souvent pondérées, qu'un algorithme de recherche peut explorer |
| algorithme de Dijkstra | trouve la distance la plus courte d'un nœud de départ à tous les autres nœuds en visitant toujours le nœud non visité ayant la plus petite distance jusqu'à présent |
| algorithme A* | une recherche de chemin le plus court qui développe le nœud ayant la plus petite somme de la distance parcourue plus une estimation heuristique de la distance vers l'objectif |
| réseau de neurones artificiels | un modèle des neurones du cerveau : des couches de nœuds reliés par des connexions pondérées, formés en ajustant les poids |
| apprentissage automatique | algorithmes qui apprennent à partir de données et s'améliorent avec l'expérience plutôt que de suivre des règles fixes |
| apprentissage supervisé | apprentissage à partir de données d'entraînement étiquetées dans lesquelles la sortie correcte pour chaque entrée est connue |
| apprentissage non supervisé | apprentissage à partir de données non étiquetées en trouvant des motifs, des groupements ou une structure dans celles-ci |
| apprentissage par renforcement | un agent apprend par essai-erreur, choisissant des actions dans un environnement pour maximiser les récompenses reçues |
| apprentissage profond | apprentissage automatique utilisant des réseaux de neurones avec de nombreuses couches cachées, formés sur de grandes quantités de données, chaque couche extrayant des caractéristiques de celle du dessous |
| rétropropagation des erreurs | comparer la sortie du réseau avec la cible, passer l'erreur en arrière à travers les couches et ajuster chaque poids pour la réduire |
| régression | ajuster une fonction aux données d'entraînement afin de prédire une valeur de sortie continue à partir d'entrées |
18.1
Conseils d'examen
- Les réponses sur les graphes nomment les nœuds, les arêtes et les poids, et ce qu'ils représentent ; puis l'algorithme. Dijkstra : tableau des distances, visiter le plus petit, mettre à jour les voisins. A* : $g$, $h$ et $f = g + h$ dans chaque ligne, développer le plus petit $f$.
- Les réponses sur les ANN nomment les couches, les connexions pondérées et l'entraînement ; l'apprentissage profond ajoute de nombreuses couches cachées, de grandes données et une extraction automatique de caractéristiques, avec une raison et un exemple.
- Les trois catégories en une ligne chacune : données étiquetées et sorties connues ; données non étiquetées et structure découverte ; agent, environnement, actions et récompenses.
- Rétropropagation : comparer avec la cible, erreur en arrière à travers les couches, ajuster les poids pour la réduire, répéter. La régression prédit une valeur ; la classification prédit une catégorie.
- Les questions de scénario veulent le pipeline : formé sur des exemples étiquetés, extrait des caractéristiques, reconnaît ou classe une nouvelle entrée ; nommer le type d'IA (reconnaissance d'image, reconnaissance vocale, apprentissage profond).
Erreurs courantes
- Décrire un graphe comme "un graphique" ; en IA, ce sont des nœuds et des arêtes.
- Exécuter Dijkstra en choisissant le voisin le plus proche du nœud actuel plutôt que la plus petite distance globale non encore visitée ; ou oublier de mettre à jour un nœud lorsqu'un itinéraire plus court apparaît.
- Ajouter $h$ dans $g$ pour l'étape suivante dans A* ; $g$ est seulement la vraie distance, $h$ est recalculé à partir du tableau.
- Dire que l'apprentissage profond est "apprendre beaucoup" ; ce sont les nombreuses couches cachées.
- Confondre l'apprentissage non supervisé avec l'apprentissage par renforcement ; le premier trouve une structure dans les données, le second apprend à partir de récompenses.
- Décrire la rétropropagation sans la comparaison avec la sortie attendue ou sans dire que les poids sont ajustés.
- Appeler une prédiction de prix "classification" ; une valeur continue est une régression.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.