Comparing algorithms and ADTs in algorithms
Introduit| English | Sens |
|---|---|
| Big-O/bɪɡ əʊ/ | notation grand O |
| time complexity/taɪm kəmˈpleksɪti/ | complexité temporelle |
| space complexity/speɪs kəmˈpleksɪti/ | complexité spatiale |
| depth-first/depθ fɜːst/ | exploration en profondeur |
| breadth-first/bredθ fɜːst/ | exploration en largeur |
| binary tree/ˈbaɪnəri triː/ | arbre binaire |
L'algorithme qui survivrait à l'univers
- Un commercial doit visiter 25 villes et rentrer chez lui par l'itinéraire le plus court. Essayez chaque ordre et il y en a environ $10^{23}$. Une machine vérifiant un milliard par seconde mettrait trois millions d'années.
- Ajoutez une ville de plus et le travail multiplie par 25. Ce n'est pas un ordinateur qui a besoin d'être plus rapide ; c'est une approche qui ne peut jamais fonctionner, à aucune vitesse, sur aucun matériel.
- Savoir cela avant d'écrire le programme, c'est ce dont sert l'analyse de complexité. C'est la différence entre choisir un algorithme et découvrir, des mois plus tard, que le vôtre ne met pas à l'échelle.
- Cette leçon porte sur la notation Big-O 大O表示法 pour le temps et l'espace, et sur la façon dont les ADT façonnent les algorithmes construits dessus.
Complexité temporelle
- La complexité temporelle 时间复杂度 décrit comment le temps d'exécution augmente avec la taille de l'entrée $n$. Elle s'écrit en notation Big-O, qui ne conserve que le terme dominant et élimine les constantes.
- $O(1)$ constant, le temps ne dépend pas du tout de $n$. $O(\log n)$ logarithmique, comme dans la recherche dichotomique. $O(n)$ linéaire, comme dans la recherche linéaire. $O(n \log n)$, les bons triages. $O(n^2)$ quadratique, comme dans le tri à bulles et le tri par insertion.
- La raison pour laquelle on élimine les constantes : elles sont masquées. Un algorithme $O(n^2)$ peut battre un $O(n \log n)$ pour $n = 10$, mais à $n = 10{,}000$, rien au sujet des constantes ne peut le sauver.
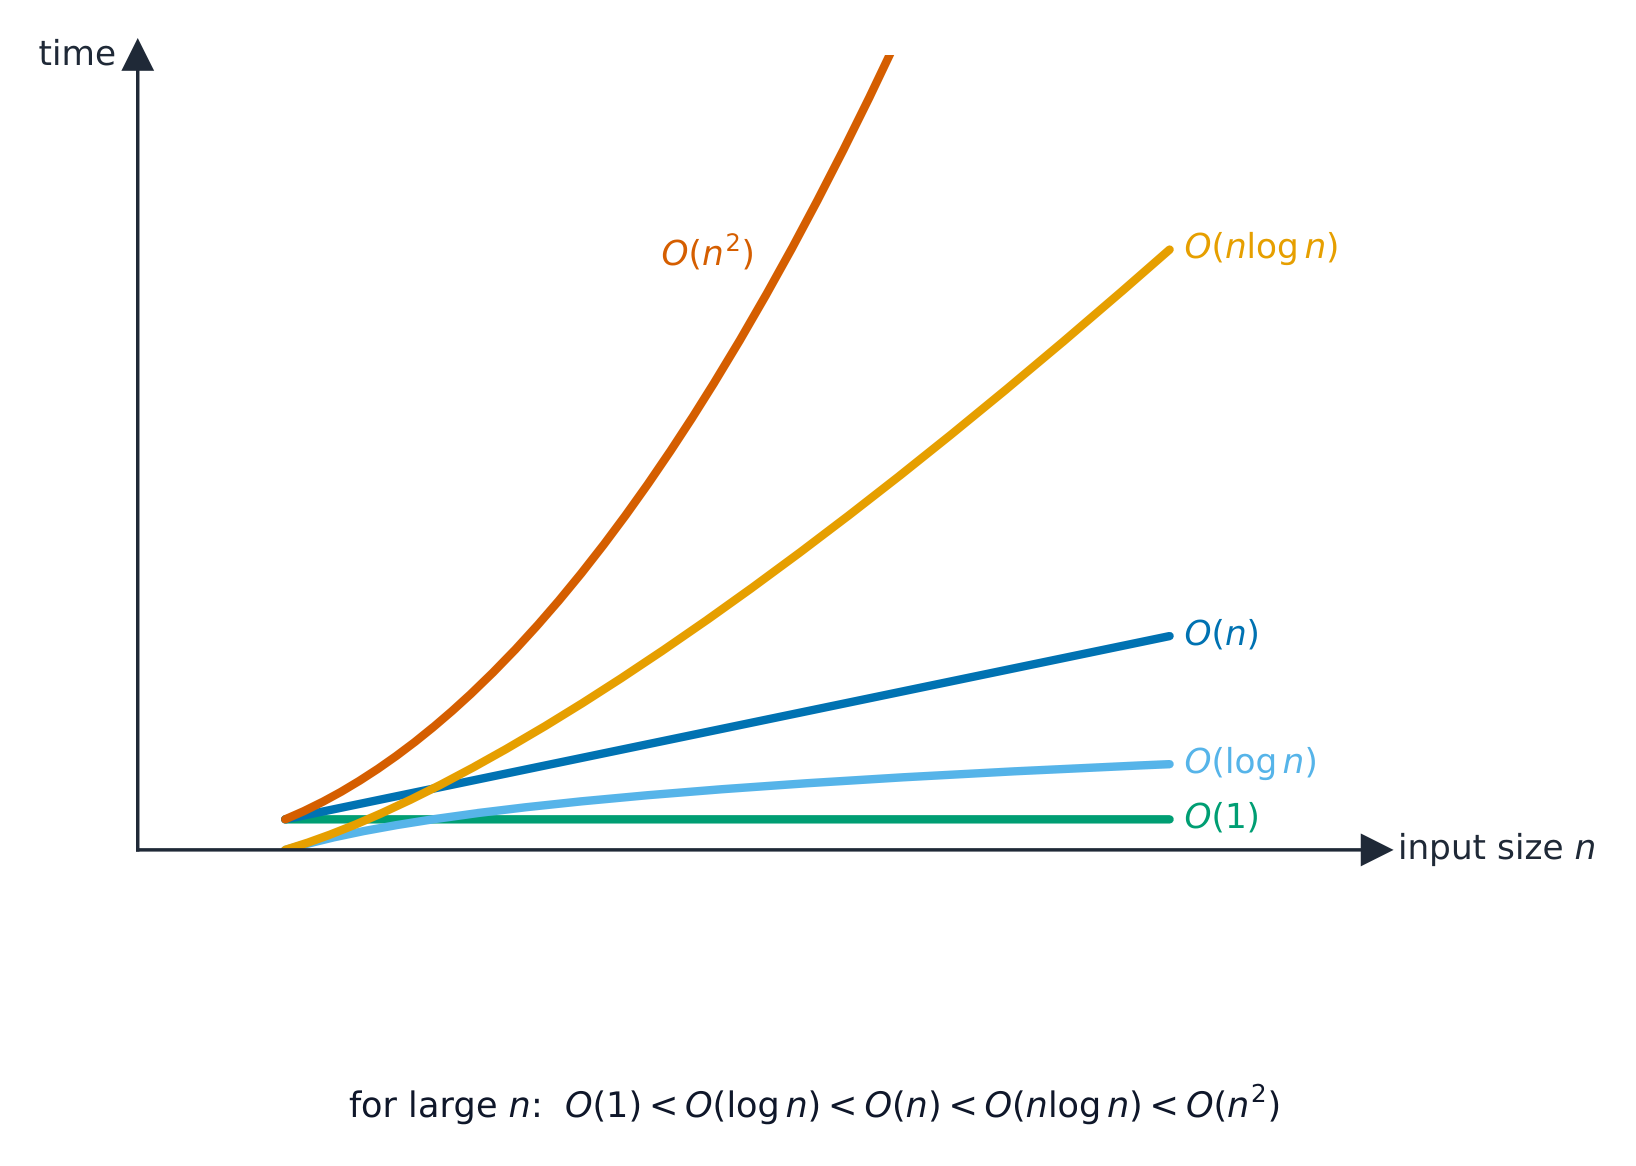
Les courbes se croisent une fois, et après cela, l'ordre décide de tout
How running time grows with n
Slide n upward and compare the curves: O(1) and O(log n) stay almost flat, O(n) rises steadily, O(n²) explodes. This is why Big-O — not a stopwatch — is how we compare algorithms on large inputs.
Which Big-O describes binary search?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Halving the range each step is logarithmic — O(log n).
Which Big-O describes bubble sort in the worst case?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Two nested loops over n elements give O(n²).
Match each algorithm to its time complexity.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Linear search is O(n), binary search O(log n), bubble sort O(n²).
Exemple résolu : ce que fait doubler l'entrée
- Un algorithme prend 4 secondes pour traiter 1,000 éléments. Estimez son temps d'exécution sur 2,000 éléments s'il est de complexité $O(n)$, puis s'il est de complexité $O(n^2)$.
- $O(n)$ : doubler $n$ double le temps, donc environ 8 secondes.
- $O(n^2)$ : doubler $n$ quadruple le temps, soit environ 16 secondes. Avec 10,000 éléments, cela serait 100 fois l'original, environ 400 secondes.
- $O(\log n)$ n'ajouterait qu'une seule étape, et $O(1)$ ne changerait pas du tout. Raisonnez à partir de l'ordre, pas d'une formule.
An O(n squared) algorithm takes 4 seconds on 1,000 items. Roughly how many seconds will it take on 2,000?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Doubling n quadruples an O(n squared) time. The same doubling would take an O(n) algorithm from 4 seconds to 8.
Complexité spatiale
- La complexité spatiale 空间复杂度 est la mémoire supplémentaire qu'un algorithme nécessite, au-delà de l'entrée elle-même.
- Les tris à bulles et par insertion utilisent $O(1)$ mémoire supplémentaire : ils fonctionnent in-place, nécessitant seulement quelques variables. Merge sort utilise $O(n)$, car il construit un second tableau.
- La récursion utilise de la mémoire de pile proportionnelle à sa profondeur, car chaque appel non terminé garde sa propre frame.
- Il existe souvent un compromis temps/mémoire : stocker des résultats pour éviter de les recalculer, comme le fait la mémoïsation, achète de la vitesse avec de l'espace.
Ce qui détermine aussi le choix
- Big-O concerne la croissance, pas la vitesse absolue. Pour une petite $n$, un algorithme simple $O(n^2)$ peut battre un complexe $O(n \log n)$, et il est plus facile à écrire correctement.
- La stabilité compte lorsqu'une liste est déjà ordonnée selon un autre champ. La simplicité compte car un algorithme simple a moins d'endroits où cacher un bug.
- La réponse honnête à « quel algorithme » nomme souvent l'ordre et les conditions : celui-ci, parce que $n$ est grand et que les données arrivent non triées.
An "in place" sort:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
In-place algorithms (like bubble and insertion sort) sort within the original array, using constant extra space.
Why is bubble sort's space complexity O(1) even though it sorts an array of n items?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
It sorts in place. Merge sort is O(n) because it builds a second array, and recursion costs memory proportional to its depth.
ADT dans les algorithmes
- Les types de données abstraits du chapitre 10 sont le mécanisme dont les algorithmes sont construits, et en choisir un façonne l'algorithme.
- Une pile donne une recherche depth-first 深度优先 : empiler les voisins, prendre le plus récent, et la recherche plonge vers le bas d'un chemin avant de revenir en arrière. La récursion utilise la pile d'appels exactement pour cela.
- Une file donne une recherche breadth-first 广度优先 : enfiler les voisins, prendre le plus ancien, et la recherche s'étend vers l'extérieur en anneaux, ce qui trouve le chemin le plus court dans un graphe non pondéré.
- Un arbre binaire 二叉树 garde les valeurs en ordre afin qu'une recherche élimine la moitié des nœuds restants à chaque étape, donnant la recherche dichotomique $O(\log n)$ sur une structure qui peut aussi croître.
Which statements about Big-O are correct? Select tout that apply.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Big-O says nothing about seconds; it is about growth. That is why the crossover with a simpler algorithm exists at small sizes.
Exemple résolu : le même graphe, deux recherches
- Un labyrinthe est exploré depuis une entrée. Contrastez l'utilisation d'une pile avec celle d'une file.
- Avec une pile, le chemin trouvé le plus récemment est exploré en dernier, donc la recherche va profondément le long d'une route jusqu'à ce qu'elle bute, puis revient en arrière. Elle utilise une mémoire proportionnelle à la profondeur du chemin.
- Avec une file, le chemin trouvé le plus ancien est exploré en dernier, donc la recherche examine tout ce qui est à un pas, puis tout ce qui est à deux pas. Elle trouve la route la plus courte en premier, mais garde toutes les positions à la distance actuelle en mémoire.
- Nommez l'ADT, nommez l'ordre d'exploration résultant, et nommez la conséquence.
A stack (LIFO) naturally drives a depth-first traversal, while a queue (FIFO) drives a breadth-first traversal.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
The ADT you choose decides the search order — stack goes deep first, queue explores level by level.
Match each ADT to the search it produces and its consequence.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Most recent first, or oldest first. That single choice decides whether the search goes deep or wide.
Pièges qui font perdre des points
- Big-O décrit la croissance avec la taille de l'entrée, pas les secondes. « C'est rapide » n'est pas une réponse de complexité.
- Doubler l'entrée double un temps $O(n)$ et quadruple un $O(n^2)$. Raisonnez à partir de l'ordre.
- La complexité spatiale est la mémoire supplémentaire, c'est pourquoi un tri in-place est $O(1)$ même si le tableau a une taille $n$.
- La pile donne depth-first, la file donne breadth-first. Inverser cette paire est l'essentiel de plusieurs questions.
Vous avez compris
- la complexité temporelle en Big-O décrit la croissance par rapport à $n$ : $O(1)$, $O(\log n)$, $O(n)$, $O(n \log n)$, $O(n^2)$ ; les constantes sont ignorées car à grande échelle, l'ordre décide
- doubler $n$ double $O(n)$ et quadruple $O(n^2)$ ; le point de croisement avec un algorithme « pire » n'existe que pour de petites valeurs de $n$
- la complexité spatiale est la mémoire supplémentaire : les tris in place sont $O(1)$, le tri fusion est $O(n)$, et la récursion coûte en profondeur de pile
- une pile donne une recherche en profondeur, une file donne une recherche en largeur, et un arbre binaire divise par deux les nœuds restants à chaque étape