Algorithmes de recherche
Introduit| English | Sens |
|---|---|
| linear search/ˈlɪnɪə sɜːtʃ/ | recherche linéaire |
| binary search/ˈbaɪnəri sɜːtʃ/ | recherche dichotomique |
Vingt questions pour un million de noms
- Un annuaire contient un million de noms. En les vérifiant un par un, on s'attendrait à effectuer demi-million de comparaisons avant de trouver celui que l'on cherche.
- Ouvrez-le au milieu au lieu de cela, décidez dans quelle moitié se trouve le nom, et jetez l'autre moitié. Répétez. Vous atteignez n'importe quel nom en vingt comparaisons.
- Demi-million contre vingt n'est pas une petite économie ; c'est la différence entre un programme qui fonctionne et un programme inutilisable. Et cela coûte une chose : la liste doit déjà être triée.
- Cette leçon aborde la recherche linéaire et la recherche binaire, leurs performances respectives et la façon de choisir entre elles.
Recherche linéaire
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1                     // not found
- Elle parcourt depuis le début, comparant chaque élément avec la cible, et s'arrête lorsqu'elle trouve une correspondance ou atteint la fin.
- Elle fonctionne sur n'importe quelle liste, triée ou non, et sur toute structure qui peut être parcourue élément par élément.
- Cas défavorable : la cible est la dernière ou absente, donc tous les $n$ éléments sont comparés, ce qui est $O(n)$. En moyenne, environ la moitié.
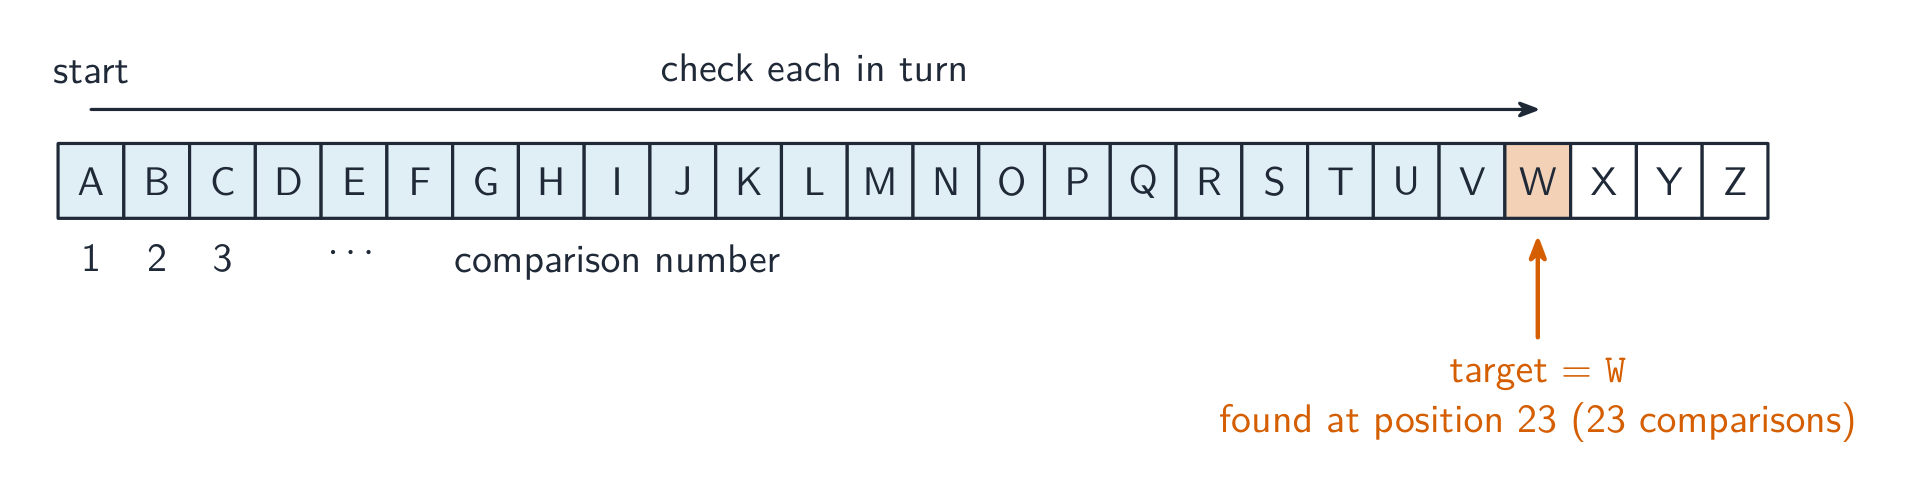
Un par un, depuis le début
Une recherche linéaire :
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
La recherche linéaire ne nécessite aucune préparation et fonctionne sur n'importe quelle liste, au pire O(n).
La recherche linéaire est le meilleur choix lorsque les données sont :
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Avec aucun ordre à exploiter (ou une petite liste), la recherche linéaire évite le coût du tri préalable.
Recherche binaire
low ← 1 ;  high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE high ← MiddleIndex - 1
ENDWHILE
RETURN -1
- Elle nécessite que les données soient triées. Comparez l'élément central avec la cible : s'il correspond, arrêtez ; si la cible est plus grande, jetez la moitié inférieure ; sinon jetez la moitié supérieure.
- Chaque comparaison divise par deux la plage encore à rechercher, donc le nombre de comparaisons est $O(\log_2 n)$.
- C'est pourquoi un million d'éléments nécessitent environ vingt comparaisons : $2^{20}$ est juste au-dessus d'un million.
Algorithmes de recherche
la recherche binaire divise la plage par deux à chaque étape
La recherche linéaire vérifie chaque élément ; la recherche binaire divise par deux une liste triée — bien moins de comparaisons.
La complexité temporelle au cas le plus difficile de la recherche binaire est :
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Diviser la plage par deux à chaque étape donne un nombre logarithmique de comparaisons.
Approximativement combien de comparaisons une recherche binaire nécessite-t-elle pour un million d'éléments triés ?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
$\log_2(1\,000\,000) \approx 20$ — environ 20 comparaisons.
La recherche binaire peut être utilisée sur n'importe quelle liste, triée ou non.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Elle décide quelle moitié éliminer en comparant avec l'élément central, ce qui n'a de sens que si les données sont ordonnées.
La recherche dichotomique est $O(\log n)$ car chaque comparaison ____ la plage restante à rechercher.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Vingt divisions par deux ramènent un million à un, c'est pourquoi le fait que $2^{20}$ soit légèrement supérieur à un million est le nombre à retenir.
Exemple résolu : tracer une recherche binaire
- La liste triée est 2, 5, 8, 12, 16, 23, 38, 56, 72, 91. Tracez la recherche de 23.
lowvaut 1,highvaut 10, doncmidvaut 5, contenant 16. 16 est inférieur à 23, on élimine la moitié inférieure :lowdevient 6.lowvaut 6,highvaut 10, doncmidvaut 8, contenant 56. 56 est supérieur à 23, donchighdevient 7.low6,high7, doncmidest 6, contenant 23. Trouvé, en trois comparaisons là où une recherche linéaire aurait pris six.- Montrez
low,high,midet la valeur à chaque étape. La plupart des points sont dans le tracé, pas dans la réponse finale.
Dans la liste triée 2, 5, 8, 12, 16, 23, 38, 56, 72, 91, combien de comparaisons une recherche binaire nécessite-t-elle pour trouver 23 ?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
mid 5 contient 16 (trop petit), mid 8 contient 56 (trop grand), mid 6 contient 23. Une recherche linéaire aurait nécessité six comparaisons.
Choisir entre eux
| linéaire | binaire | |
|---|---|---|
| les données doivent être triées | non | oui |
| comparaisons, cas pire | $n$ | $\log_2 n$ |
| un million d'articles | jusqu'à 1,000,000 | environ 20 |
| adapté à | listes non triées ou petites, listes chaînées | grands tableaux triés, recherchés fréquemment |
- Le tri préalable coûte plus qu'une recherche linéaire, donc la recherche binaire n'est rentable que si la liste est déjà triée ou sera recherchée de nombreuses fois.
- La recherche binaire nécessite aussi un accès direct à l'élément du milieu, ce qui est possible avec un tableau mais pas avec une liste chaînée.
Exemple résolu : justifier le choix
- Un programme cherche dans une liste non triée de 50 enregistrements une seule fois. Recherche linéaire : trier la liste coûterait bien plus que les 50 comparaisons nécessaires à la recherche.
- Un programme cherche dans un tableau trié d'un million d'enregistrements des milliers de fois par seconde. Recherche binaire : les données sont déjà triées et chaque recherche ne coûte qu'environ 20 comparaisons au lieu de jusqu'à un million.
- Un programme cherche dans une liste chaînée. Recherche linéaire : la recherche binaire doit sauter directement vers l'élément du milieu, et une liste chaînée ne peut être parcourue qu'à partir du début.
- Nommez l'algorithme, puis la propriété des données qui le détermine.
Associez chaque recherche à ses faits clés.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
La recherche binaire est bien plus rapide (O(log n)) mais uniquement sur des données triées ; la recherche linéaire fonctionne partout en O(n).
Quand la recherche linéaire est-elle le meilleur choix ? Sélectionnez toutes les options qui s'appliquent.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Le dernier cas est précisément celui où la recherche binaire l'emporte. Trier d'abord coûte plus cher qu'une unique recherche linéaire, donc cela ne devient rentable que sur de nombreuses recherches.
Le coût de maintenir le fichier trié
- La recherche binaire n'est disponible que sur une liste triée, et ce tri n'est pas gratuit. Une question vous demandant de justifier un choix vous demande de l'évaluer en termes de coût.
- Si les données sont recherchées souvent et changent rarement, triez-les une seule fois et chaque recherche ultérieure sera $\log_2 n$. C'est le cas pour un dictionnaire ou une table de correspondance.
- Si les données changent constamment, chaque insertion doit maintenir l'ordre, ce qui coûte un déplacement des éléments suivants. Une recherche linéaire sur des données non triées peut alors avoir un coût total moindre.
- Les chiffres rendent l'argument concret : un million d'enregistrements nécessitent jusqu'à un million de comparaisons en linéaire, mais seulement 20 en recherche binaire, car $2^{20} > 10^6$.
- Ainsi, la réponse marquée nomme les deux aspects : la fréquence de la recherche et la fréquence des changements.
Placez la justification du choix d'un algorithme de recherche dans l'ordre.
Difficulté 3/5 · 200 pièces + un petit bonus lors de la première réussite aujourd'hui
Une question de justification cherche le compromis, pas le gagnant. La recherche binaire sur une liste qui change constamment peut coûter plus au total qu'une recherche linéaire.
Points qui glissent
- La recherche binaire requiert des données triées. Dire « c'est plus rapide » sans cette condition fait perdre les points.
- À chaque étape, la plage est divisée par deux, c'est d'où vient le $\log_2 n$. Donnez la raison, pas seulement la notation.
- Les deux recherches doivent pouvoir signaler non trouvé, ce qui est le rôle du
-1et de la condition de boucle. - La recherche binaire a besoin d'accès direct, elle ne s'applique donc pas à une liste chaînée même si celle-ci est triée.
Vous avez compris
- recherche linéaire compare chaque élément depuis le début, fonctionne sur n'importe quelle liste, et est $O(n)$
- recherche binaire nécessite des données triées avec accès direct, compare le milieu et divise par deux la plage à chaque étape, donnant $O(\log_2 n)$ : environ 20 comparaisons pour un million d'éléments
- tracez une recherche binaire en montrant
low,high,midet la valeur à chaque étape - choisissez parmi les données : non triées, petites ou une liste chaînée signifie linéaire ; grand, trié et recherché souvent signifie binaire