Regression and AI in practice
Introduit| English | Sens |
|---|---|
| regression/rɪˈɡreʃn/ | régression |
| classification/ˌklæsɪfɪˈkeɪʃn/ | classification |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | régression linéaire |
| OCR/ˌəʊ siː ˈɑː/ | reconnaissance optique de caractères (ROC) |
Prédire un nombre, pas un nom
- Demandez à un modèle "est-ce que cet e-mail est du spam ?" et il doit choisir parmi un ensemble fixe de réponses. Demandez-lui "pour combien cette maison sera-t-elle vendue ?" et il n'y a pas d'ensemble à choisir : la réponse est un nombre, et être à mille livres près est presque juste.
- Ce sont deux tâches différentes, et les confondre est l'erreur la plus courante dans ce sujet. Les deux sont de l'apprentissage supervisé ; seule la forme de la réponse diffère.
- Cette leçon traite de la régression 回归 contre la classification 分类, comment la régression linéaire 线性回归 choisit sa droite, et comment les produits réels enchaînent plusieurs modèles entraînés dans un pipeline.
Régression et classification
- La classification prédit une catégorie issue d'un ensemble fixe : chat ou chien, spam ou non spam, lequel des dix chiffres.
- La régression prédit un nombre sur une échelle continue : le prix d'une maison, la température de demain, la durée d'un trajet.
- Les deux sont supervisés : les deux apprennent à partir d'exemples étiquetés. Le choix entre eux est décidé par une seule question : la réponse est-elle une étiquette ou un nombre ?
- La distinction change la façon dont on mesure la réussite. Un classificateur a tort ou raison ; un régresseur s'éloigne d'une certaine distance, c'est pourquoi leurs fonctions de perte diffèrent.
The difference between regression and classification is that regression predicts:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Regression outputs a continuous number (price, temperature); classification outputs a category.
Regression predicts a continuous number (a price, a temperature), while classification predicts a category (cat vs dog).
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Number out = regression; category out = classification — the two main kinds of supervised prediction.
Exemple résolu : quelle tâche est laquelle
- Prédire auquel des cinq types de clients un acheteur appartient. Classification : la réponse est l'une d'un ensemble fixe de catégories.
- Prédire combien cet acheteur dépensera le mois prochain. Régression : la réponse est un nombre, et être proche compte comme presque juste.
- Prédire si une machine va tomber en panne la semaine prochaine. Classification : oui ou non. Prédire combien de jours avant qu'elle tombe en panne. Régression.
- Les mêmes données sous-jacentes peuvent alimenter soit l'une, soit l'autre. Lisez la question posée, pas le sujet.
Match each prediction task to its kind.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
The same data can feed either. Read the question: a label from a fixed set, or a number on a scale.
Régression linéaire
- La régression linéaire ajuste une ligne droite, ou une surface plane lorsqu'il y a plusieurs entrées :
- Les coefficients sont choisis pour minimiser la somme des carrés des erreurs entre les prédictions de la ligne et les valeurs réelles d'entraînement.
- Au carré, pour deux raisons acceptées par l'examen : les erreurs au-dessus et en dessous de la ligne ne peuvent alors pas s'annuler, et une grande erreur est pénalisée bien plus que plusieurs petites.
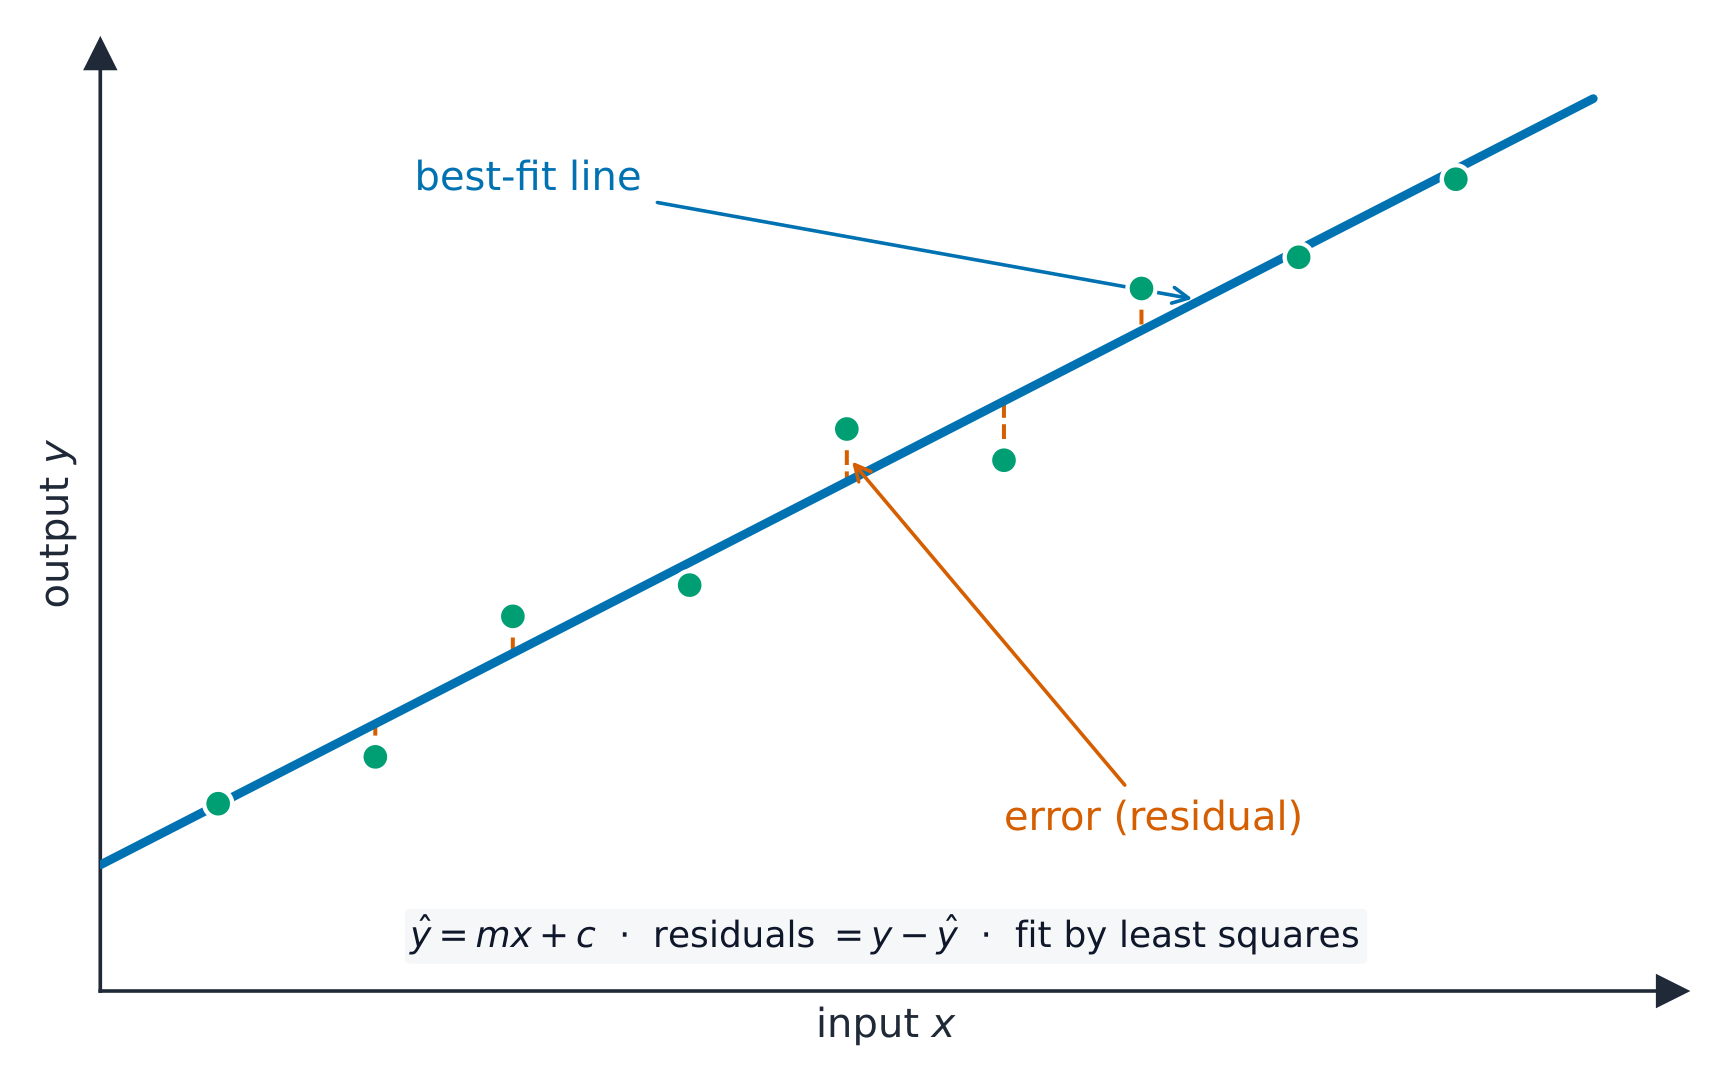
La droite qui laisse la somme totale des distances au carré la plus faible
Fitting a regression line
Drag the controls. Linear regression draws the straight line that makes the squared distances to the data points as small as possible — then it predicts a number for any new input.
Linear regression chooses its coefficients to:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
It fits the line/hyperplane that makes the squared differences from the data points as small as possible.
Why does linear regression minimise the sum of the SQUARED errors rather than the errors themselves?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Both reasons are accepted. Without squaring, a line could have a huge error above and below and still score zero.
Quand une ligne droite est le bon modèle
- Utilisez la régression linéaire lorsque la relation semble approximativement linéaire et que vous voulez un modèle lisible par un humain : chaque coefficient indique dans quelle mesure cette entrée est importante et dans quelle direction.
- Lorsque les données sont courbes, la même idée s'applique avec un modèle différent : régression polynomiale, arbre de décision ou réseau de neurones. Dans chaque cas, la recette est la même, choisissez un modèle, définissez une fonction de perte, minimisez-la.
- Cette recette relie cette leçon à la précédente : la descente de gradient est simplement la manière dont la minimisation est effectuée lorsqu'il n'y a pas de formule pour la réponse.
IA dans un produit réel
- Les systèmes réels utilisent rarement un seul modèle. Ils enchaînent plusieurs modèles entraînés dans un pipeline, chacun effectuant une étape.
- Identification faciale à une porte : une caméra capture un visage, la reconnaissance d'images le convertit en représentation numérique, et celui-ci est comparé aux représentations des personnes enregistrées.
- Lire un panneau à voix haute pour un voyageur : la reconnaissance d'images localise le texte, la LCR 光学字符识别 convertit les pixels en caractères, la traduction automatique convertit les mots, et la synthèse vocale produit l'audio.
- L'examen donne un scénario et demande quels modèles sont utilisés, dans l'ordre. Nommez l'étape et ce qu'elle produit pour la suivante.
Match each AI idea to what it means.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Training fits the model once; inference is the quick prediction each time a user interacts.
A "read a sign aloud" feature typically chains which models?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Several trained models form a pipeline: find the text, extract characters, translate, then speak.
Put the stages of an app that reads a foreign sign aloud in order.
Difficulté 3/5 · 200 pièces + un petit bonus lors de la première réussite aujourd'hui
Several trained models chained together, each handing its output to the next. Name the stage and what it produces.
Exemple résolu : entraînement contre inférence
- Une application de téléphone reconnaît une plante à partir d'une photo instantanément, mais l'entraînement de son modèle a pris des semaines sur de nombreuses machines. Expliquez pourquoi.
- L'entraînement exécute répétitivement des passes avant et arrière sur un très grand jeu de données étiqueté, ajustant des millions de poids sur de nombreuses époques. C'est cela qui a pris des semaines.
- L'inférence, en utilisant le modèle entraîné, est une seule passe avant à travers un réseau dont les poids sont maintenant fixes : multiplier, ajouter, activer, couche par couche, une seule fois.
- L'intelligence réside dans les poids appris, c'est pourquoi le modèle final est assez petit et assez rapide pour être livré sur un téléphone.
Using a trained model to make a prediction requires only a single ____ pass.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Training repeats forward and backward passes over a huge dataset; inference runs the fixed weights once, which is why it is instant.
Pièges qui font perdre des points
- La classification donne une catégorie, la régression donne un nombre. Les deux sont supervisés ; ce n'est pas la différence.
- La régression linéaire minimise la somme des carrés des erreurs, pas "la distance totale". Dites au carré, et dites pourquoi.
- Une réponse de pipeline doit donner les étapes dans l'ordre et dire ce que chacune transmet à la suivante.
- L'entraînement consiste en des passes avant et arrière répétées ; l'inférence est une seule passe avant. Ne décrivez pas l'entraînement lorsque la question porte sur l'utilisation.
Vous avez compris
- classification prédit une catégorie, régression prédit un nombre ; les deux sont supervisés, et la forme de la réponse de la question décide de laquelle
- régression linéaire ajuste $y = m_1x_1 + \ldots + c$ par minimisation de la somme des carrés des erreurs, afin que les erreurs ne puissent pas s'annuler et que les grandes soient lourdement pénalisées
- les données courbes nécessitent un autre modèle, mais la recette reste inchangée : choisissez un modèle, définissez une fonction de perte, minimisez-la
- les produits réels enchaînent des modèles : reconnaissance d'images, LCR, traduction et synthèse vocale ; l'entraînement est de nombreuses passes avant et arrière, l'inférence est une seule passe avant