Machine learning types and training
Introduit| English | Sens |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | apprentissage automatique : capacité d'un système à apprendre et s'adapter sans programmation explicite |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | rétropropagation |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | apprentissage supervisé |
| classification/ˌklæsɪfɪˈkeɪʃn/ | classification |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | apprentissage non supervisé |
| clusters/ˈklʌstəz/ | groupes |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | apprentissage par renforcement |
| agent/ˈeɪdʒənt/ | agent |
| reward/rɪˈwɔːd/ | récompense |
| policy/ˈpɒlɪsi/ | politique |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | descente de gradient |
| loss function/lɒs ˈfʌŋkʃn/ | fonction de perte |
| epoch/ˈiːpɒk/ | époque |
Le programme qui s'est enseigné lui-même une ouverture que personne n'avait jouée
- AlphaGo Zero a reçu les règles du Go et rien d'autre. Aucun jeu humain, aucun livre d'ouvertures, aucun conseil. Il a joué contre lui-même, en commençant par des coups aléatoires.
- En trois jours, il a surpassé la version qui avait battu le champion du monde. Au passage, il a redécouvert des siècles de théorie des ouvertures humaines, puis éliminé certaines parties qu'il jugeait inférieures.
- Il a appris à partir d'un seul nombre après chaque partie : gagné ou perdu. C'est un type d'apprentissage totalement différent de celui qui consiste à montrer un million de photographies étiquetées.
- Cette leçon aborde les trois paradigmes du machine learning, les données dont chacun a besoin, et comment les poids d'un réseau changent réellement grâce à la backpropagation 反向传播.
Apprentissage supervisé
- Supervised learning 监督学习 s'entraîne sur des données portant des étiquettes : photographies tagguées « chat » ou « chien », e-mails marqués spam ou non, maisons avec leurs prix de vente.
- Le modèle apprend la correspondance de l'entrée vers l'étiquette, puis on lui donne des entrées qu'il n'a jamais vues et on lui demande de produire l'étiquette.
- Il se divise en classification 分类, où la sortie est une catégorie, et régression, où la sortie est un nombre.
- Son coût est les étiquettes : quelqu'un doit les produire, ce qui pour un million d'images représente énormément de travail humain.
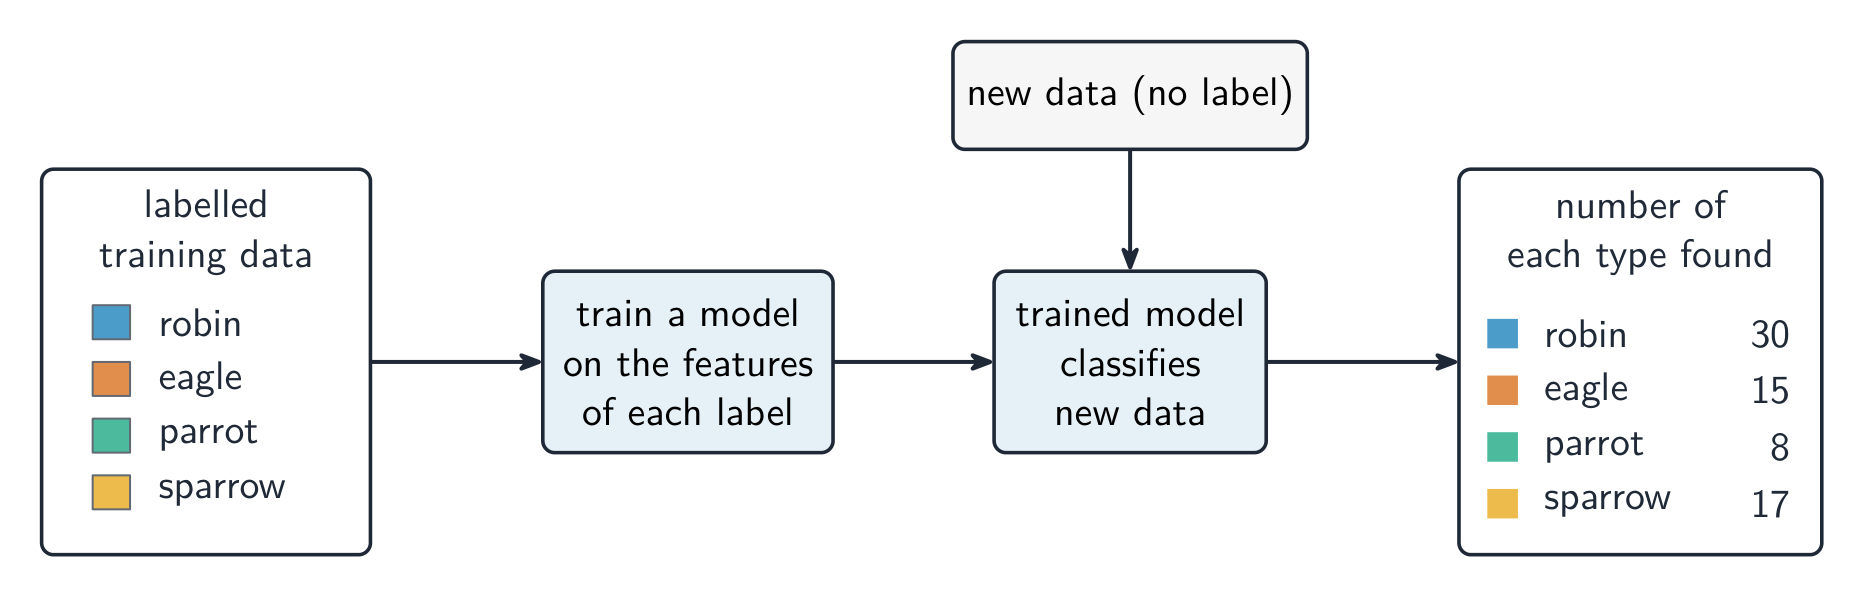
Exemples étiquetés en entrée, modèle en sortie, puis entrées non étiquetées
Supervised learning uses:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Supervised learning trains on labelled examples (e.g. images tagged cat/dog).
Apprentissage non supervisé
- Unsupervised learning 无监督学习 reçoit des données sans étiquettes et est invité à en trouver la structure.
- L'utilisation la plus courante est le clustering : regrouper en clusters 聚类 d'articles similaires, comme des clients achetant des choses semblables, sans que personne ne décide à l'avance quelles doivent être les groupes.
- C'est sa force et sa faiblesse : il peut découvrir un groupement inattendu, mais il ne peut pas vous dire ce que ce groupement signifie.
Unsupervised learning is used to:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
With no labels, unsupervised learning discovers patterns/clusters in the data.
Apprentissage par renforcement
- Reinforcement learning 强化 learning a un agent 智能体 agissant dans un environnement. Chaque action change l'état et retourne une récompense 奖励, qui peut rester nulle longtemps.
- L'agent apprend une politique 策略, une stratégie pour choisir des actions, qui maximise sa récompense totale sur le temps. Il apprend par essais et erreurs, sans aucun exemple étiqueté.
- Il convient aux problèmes qui sont une série de décisions où le bon coup n'est révélé que par le résultat final : jeux, contrôle robotique, voitures autonomes. C'est exactement le cas d'AlphaGo Zero.
In reinforcement learning, the agent learns by:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
The agent tries actions, receives rewards, and learns a policy that maximises long-term reward.
In reinforcement learning the agent learns a ____ that maximises its total reward over time.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
It learns by trial and error from rewards, with no labelled examples at all, which is why it suits sequences of decisions.
Exemple résolu : choisir le paradigme
- Dix mille scans médicaux, chacun étiqueté par un médecin comme montrant une tumeur ou non, sont utilisés pour entraîner un système à signaler de nouveaux scans. Supervisé : les données ont des étiquettes et la tâche est d'apprendre l'entrée vers l'étiquette, spécifiquement une classification.
- Une boutique souhaite savoir si ses clients forment des groupes naturels, sans définir les groupes à l'avance. Non supervisé : aucune étiquette n'existe, et la tâche consiste à trouver une structure, spécifiquement le regroupement.
- Un bras robotique doit apprendre à placer des composants, jugé uniquement par la réussite de chaque tentative. Apprentissage par renforcement : un agent, une séquence d'actions et une récompense plutôt qu'une étiquette.
- Nommez le paradigme, puis justifiez à partir des données : étiquetées, non étiquetées ou un signal de récompense.
AI learning type lab
Classify AI examples by the type of learning or concern involved.
Match each ML paradigm to its data.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Supervised = labels; unsupervised = no labels; reinforcement = reward feedback.
Match each situation to the machine-learning paradigm it needs.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Labels, no labels, or a reward. The data decides the paradigm, not the difficulty of the task.
Entraînement par rétropropagation
- L'entraînement signifie ajuster les poids pour que les sorties du réseau correspondent aux cibles. La méthode est la rétropropagation avec la descente de gradient 梯度下降.
- Passe avant : faire passer une entrée dans le réseau et obtenir sa sortie. Calculer l'erreur en utilisant une fonction de perte 损失函数, qui mesure l'écart entre la sortie et la cible.
- Passe arrière : propager cette erreur vers l'arrière à travers les couches pour trouver le gradient de chaque poids, c'est-à-dire dans quelle mesure ce poids a contribué à l'erreur.
- Mise à jour : modifier chaque poids d'un petit pas dans la direction opposée à son gradient. L'amplitude du pas est le taux d'apprentissage.
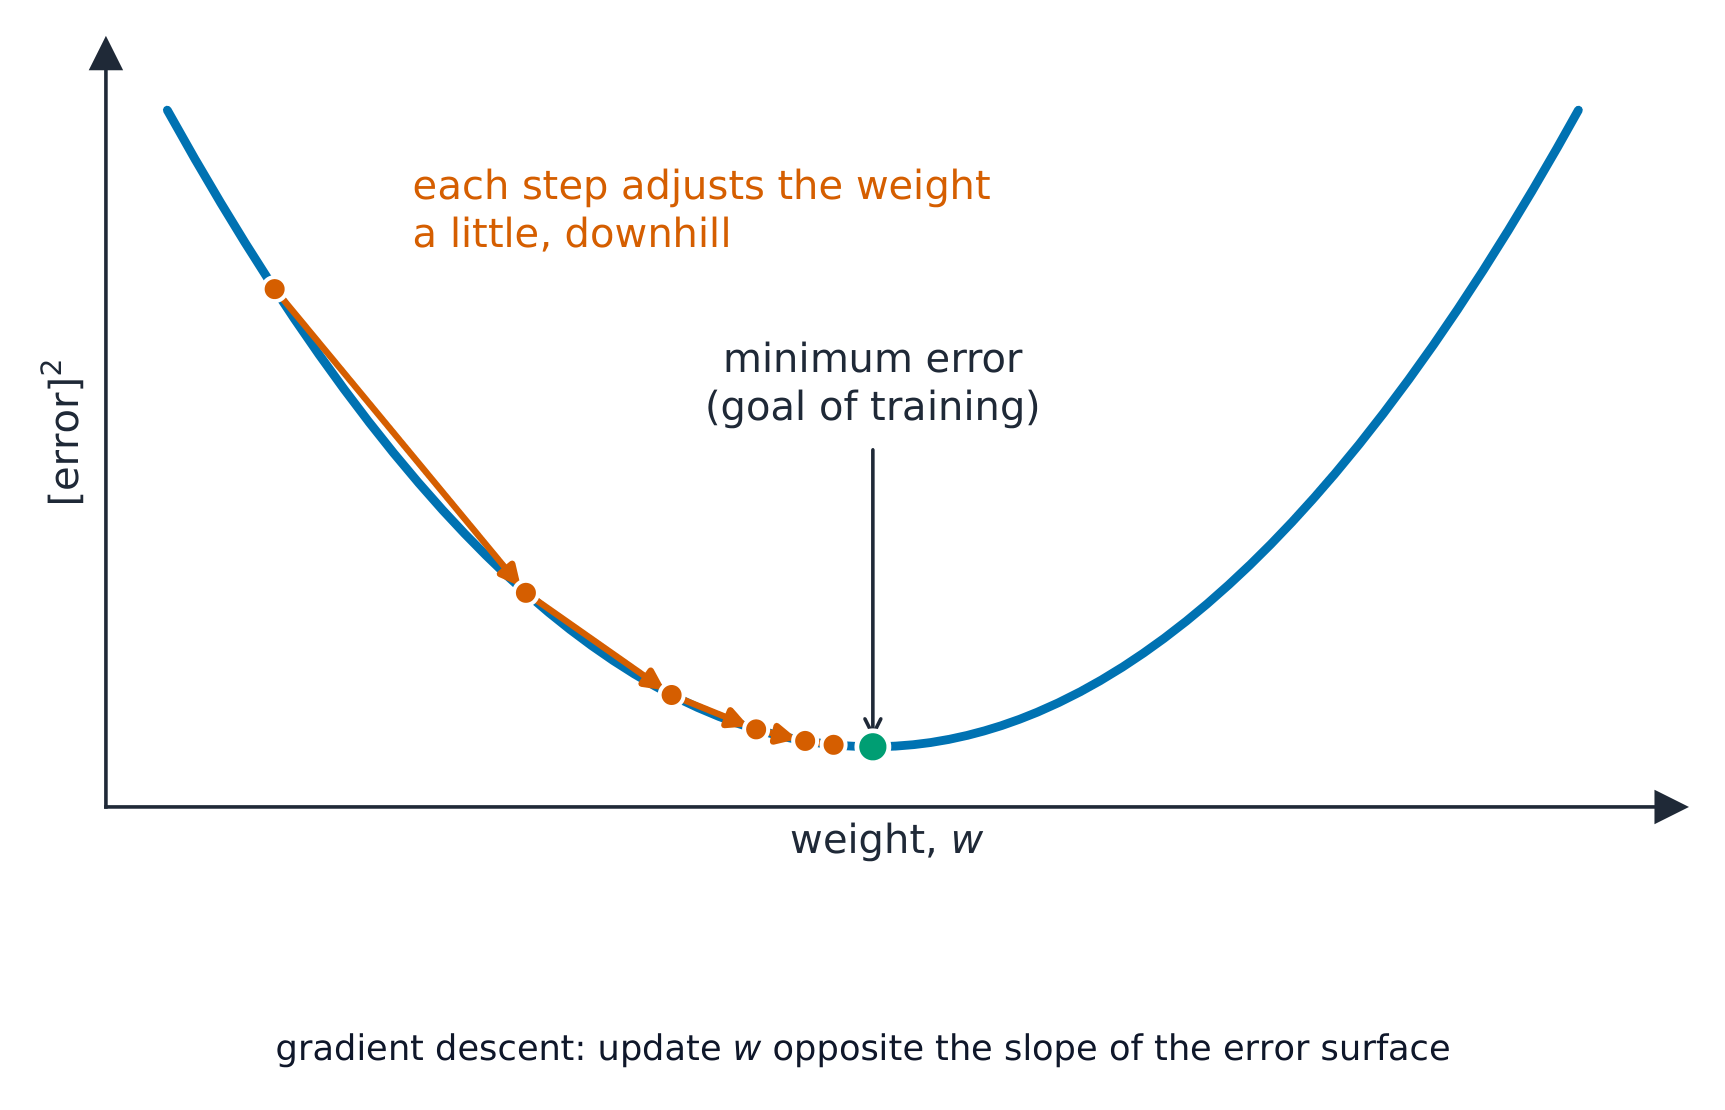
En descente, un petit pas à la fois
Backpropagation trains a network by:
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
The error flows from the output back through the network (chain rule) so every weight's gradient is found, then weights step downhill.
Put one round of backpropagation training in order.
Difficulté 3/5 · 200 pièces + un petit bonus lors de la première réussite aujourd'hui
Forward, error, backward, update, repeated over many epochs until the error stops falling.
Époques, et pourquoi le taux d'apprentissage est important
- Une passe complète sur tout l'ensemble d'entraînement est une époque 训练轮次. L'entraînement se répète pendant de nombreuses époques jusqu'à ce que l'erreur cesse de diminuer.
- Un taux d'apprentissage trop grand dépasse le minimum et l'erreur fluctue ; trop petit, l'entraînement prend beaucoup plus de temps qu'il ne devrait.
- Après l'entraînement, utiliser le modèle ne nécessite qu'une passe avant, c'est pourquoi un réseau entraîné répond instantanément bien que l'entraînement ait pris des jours.
In gradient descent the learning rate sets how big a step each weight update takes — too large overshoots the minimum, too small makes training slow.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Backpropagation finds each weight's gradient; the learning rate scales how far down that gradient the weight moves.
Which statements about training are correct? Select tout that apply.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
The learning rate is the size of each weight update. That is why training can take days while a prediction takes milliseconds.
Pièges qui font perdre des points
- Justifiez un paradigme à partir des données : étiqueté signifie supervisé, non étiqueté signifie non supervisé, un signal de récompense signifie apprentissage par renforcement.
- L'apprentissage par renforcement n'a pas d'étiquettes. Appeler sa récompense une étiquette est la confusion classique.
- La rétropropagation est passe avant, erreur, passe arrière, mise à jour, répétée. Nommmer seulement "il ajuste les poids" est une réponse incomplète.
- Le taux d'apprentissage est l'amplitude de chaque pas, pas la vitesse de l'entraînement ni le nombre d'époques.
Vous avez compris
- supervisé apprend l'entrée vers l'étiquette à partir de données étiquetées, pour la classification ou la régression · non supervisé trouve une structure comme des groupes dans des données non étiquetées · par renforcement a un agent apprenant une politique à partir de récompenses par essai-erreur
- choisissez le paradigme selon ce que les données fournissent, pas selon la difficulté de la tâche
- rétropropagation : une passe avant, une erreur de la fonction de perte, une passe arrière donnant le gradient de chaque poids, puis une mise à jour dont l'amplitude est définie par le taux d'apprentissage
- l'entraînement se répète pendant de nombreuses époques ; utiliser le modèle entraîné est une seule passe avant