Codes de caractères — ASCII et Unicode
Introduit| English | Sens |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | Unicode |
| character set/ˈkærɪktə set/ | Ensemble de caractères |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | Encodage |
| code point/kəʊd pɔɪnt/ | Point de code |
| UTF-8/ˌjuː tiː ˈef eɪt/ | Encodage UTF-8 |
Le courriel arrivé en charabia
- Dans les années 1990, un message tapé à Varsovie et lu à Tokyo arrivait souvent sous forme de mur de nonsens. Les deux ordinateurs stockaient huit bits par caractère. Ils s'accordaient simplement mal sur ce que signifiaient les 128 premiers motifs supérieurs.
- La table de caractères polonaise y plaçait des lettres polonaises. Celle japonaise y plaçait ses propres caractères. Rien n'a été corrompu en transit : les octets sont arrivés intacts et lus selon une table différente.
- La solution a consisté à arrêter d'avoir des tables par pays et à donner à chaque caractère de tout alphabet un numéro, pour toujours. C'est Unicode 统一码, et c'est pourquoi l'émoji que vous envoyez arrive comme la même image.
- Cette leçon porte sur la manière dont le texte devient des nombres : les ensembles de caractères 字符集, ASCII, Unicode, et les encodages qui les stockent.
Un ensemble de caractères donne un numéro à chaque caractère
- Un ordinateur ne stocke pas de lettres, seulement des nombres. Un ensemble de caractères est l'ensemble des caractères qu'un ordinateur peut représenter, chacun avec son propre code binaire.
- Le numéro d'un caractère est son point de code 码点.
Aest 65,aest 97,0le chiffre est 48. - Le point de code n'est pas le sens du caractère ; c'est une étiquette convenue. Le texte n'est lisible que parce que les deux machines utilisent le même ensemble de caractères.
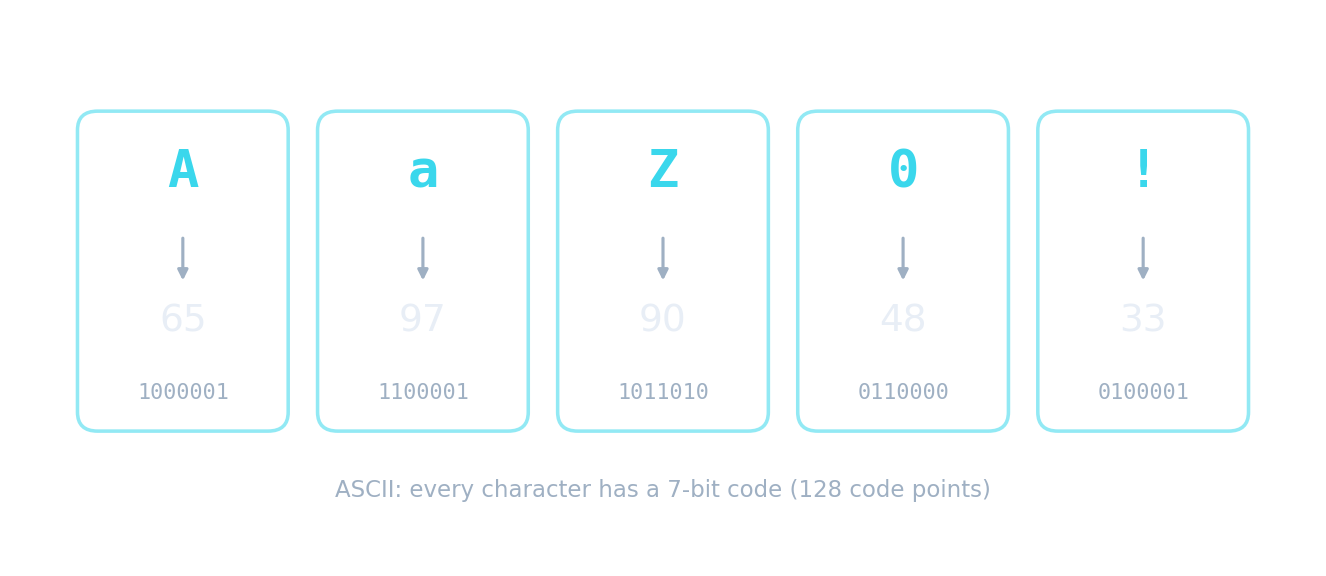
La lettre est l'image ; le byte est le nombre
Un caractère est stocké sous forme de nombre
Chaque caractère possède un numéro de code : 'A' vaut 65. Inversez les bits pour voir ce code en binaire et en hexadécimal, exactement comme l'ordinateur le conserve.
Un ensemble de caractères tel que ASCII définit :
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Un ensemble de caractères associe chaque caractère à un nombre (son point de code), ce qui est ce que l'ordinateur stocke réellement.
ASCII
- ASCII ASCII码, the American Standard Code for Information Interchange, utilise 7 bits, offrant $2^7 = 128$ points de code : les lettres latines de base, les chiffres, la ponctuation et 32 codes de contrôle tels que le retour chariot.
- Extended ASCII (ASCII étendu) utilise 8 bits, offrant 256 points de code. Les 128 premiers sont identiques à ASCII ; les 128 supérieurs varient selon la région, ce qui est exactement ce qui a causé l'erreur dans cet e-mail.
- Vous n'êtes jamais demandé de mémoriser un code, mais on vous demande les comptages : 7 bits, 128 ; 8 bits, 256.
Combien de points de code différents l'ASCII sur 7 bits possède-t-il ?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
7 bits donnent $2^7 = 128$ points de code.
Combien de points de code différents l'ASCII étendu possède-t-il ?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Huit bits donnent $2^{8} = 256$. Les $128$ inférieurs correspondent au texte ASCII standard sur 7 bits ; les $128$ supérieurs varient selon la région.
Unicode
- Unicode est un jeu de caractères universel : un code point pour presque chaque caractère dans chaque script vivant ou mort, ainsi que des symboles et emojis, plus de 149,000 au total.
- Le point de code est séparé de sa manière de stockage. Une encodage 编码 convertit un point de code en octets.
- UTF-8 UTF-8编码 utilise de 1 à 4 octets par caractère et est compatible ASCII : les 128 premiers points de code occupent un seul octet, identique à ASCII. UTF-16 utilise 2 ou 4 octets ; UTF-32 utilise un fixe de 4.
Que peut-on dire de UTF-8 ?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
UTF-8 est un codage Unicode à longueur variable (1–4 octets) ; ses 128 premiers points de code correspondent à ASCII, donc le texte ASCII simple est valide UTF-8.
Quelle est la relation entre Unicode et UTF-8 ?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
L'ensemble assigne les numéros ; le codage décide combien d'octets prend chaque numéro. UTF-16 et UTF-32 sont d'autres codages du même ensemble.
Exemple résolu : comparer ASCII et Unicode
- Donnez un avantage et un inconvénient d'utiliser Unicode au lieu d'ASCII. [2]
- Avantage : Unicode représente beaucoup plus de caractères, donc du texte dans n'importe quel alphabet, chinois, arabe, grec, et des émojis peut être stocké, et un document unique peut mélanger des langues ; les fichiers sont portables car il n'y a pas de page de code par pays à s'accorder sur.
- Inconvénient : pour du texte uniquement en anglais, un fichier Unicode est généralement plus grand, car un caractère peut prendre plus d'un octet.
- Les deux moitiés sont nécessaires. "Il a plus de caractères" seul vaut une marque sur deux.
Un avantage clé d'Unicode par rapport à ASCII est qu'il :
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Unicode couvre presque tous les systèmes d'écriture ainsi que des symboles et des émojis — bien au-delà de l'ensemble anglais basique d'ASCII.
Pour un texte uniquement en anglais, un fichier Unicode est généralement plus grand que le même texte en ASCII.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Les codages Unicode peuvent utiliser plus d'octets par caractère, donc le texte anglais simple est généralement plus volumineux qu'en ASCII sur 7 bits — le compromis pour une couverture universelle.
Quels sont les avantages d'Unicode par rapport à ASCII ? Sélectionnez tous ceux qui s'appliquent.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
La taille est le compromis, pas un avantage : pour du texte ASCII simple, un fichier Unicode est généralement plus grand.
Exemple résolu : la taille d'un fichier texte
- Un message de 500 caractères est stocké en extended ASCII. Quelle est la taille du fichier en octets ?
- Extended ASCII utilise 8 bits, un octet, par caractère, soit $500 \times 1 = 500$ octets, ou $500 \times 8 = 4000$ bits.
- Le même message en UTF-32 ? Quatre octets par caractère, soit 2000 octets.
- Montrez les bits par caractère, multipliez, puis convertissez une seule fois. Mélanger bits et octets en cours de route est la perte de marque habituelle.
Un message de 500 caractères est stocké en ASCII étendu. Combien d'octets faut-il (en ignorant tout en-tête) ?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Huit bits, un octet par caractère : $500 \times 1 = 500$ octets ou $4000$ bits. En UTF-32, le même texte nécessite $2000$ octets.
Lire un caractère en binaire et hexadécimal
- Puisqu'un point de code n'est qu'un nombre, il se convertit comme n'importe quel autre.
Aest 65, ce qui est0100 0001en binaire et41en hexadécimal. - Deux motifs utiles : les chiffres
0à9commencent à 48, et le minuscule est 32 de plus que le majuscule, donca(97) estA(65) plus 32. Cette différence est un seul bit. - Une question qui vous donne
A= 65 et demandeEveut $65 + 4 = 69$, pas un tableau mémorisé.
Le code ASCII pour A est 65. Quel est le code ASCII pour E ?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Les lettres sont consécutives, donc E est quatre après A. Il n'y a rien à mémoriser au-delà d'une valeur ancre.
Pièges qui font perdre des points
- ASCII est 7 bits et 128 points de code ; extended ASCII est 8 bits et 256. N'écrivez pas 8 bits pour ASCII simple.
- Unicode est un ensemble de caractères ; UTF-8 est une encodage de celui-ci. Ce ne sont pas deux ensembles rivaux.
- UTF-8 est à longueur variable, 1 à 4 octets, pas toujours un octet et pas toujours quatre.
- L'inconvénient d'Unicode est la taille du fichier pour l'anglais simple, pas "il est plus lent" ou "il est plus difficile à lire".
Vous avez compris
- Un ensemble de caractères attribue à chaque caractère un point de code ; le texte est des nombres plus un accord sur la façon de les lire
- ASCII : 7 bits, 128 points de code, anglais uniquement · extended ASCII : 8 bits, 256, la moitié supérieure varie selon la région
- Unicode : un point de code pour chaque alphabet et emoji, stocké via une encodage ; UTF-8 est 1 à 4 octets et compatible ASCII
- Unicode gagne des caractères, la portabilité et les langues mixtes ; cela coûte en taille de fichier sur du texte anglais simple