Ce que ce cours est, et comment l'utiliser
Ceci est le douzième module de University Medicine : épidémiologie, biostatistiques et médecine fondée sur les preuves (EBM) — la boîte à outils qui transforme les questions cliniques en chiffres et les chiffres en décisions. Il s'aligne sur le matériel statistique UNI-BUS-05 examiné où les mathématiques se chevauchent.
Limite de portée, énoncée une seule fois : un cours d'études, pas un diplôme médical ; chaque l'ensemble de données ci-dessous est synthétique ou sous licence ouverte, chaque résumé évalué est fictif, et rien ici ne licence ni ne guide le traitement.
- Units 12.1–12.3 measure and compare: disease frequency, study designs, biais et causalité.
- Les unités 12.4–12.6 quantifient : tests diagnostiques, inférence, essais et revues.
- L'unité 12.7 applique : évaluation, certitude et le patient devant vous.
L'habitude EBM : posers en PICO, mesurer en risques et ratios, décider avec intervalles et non rituels** — tous les calculs ci-dessous sont synthétiques, vérifiés par ordinateur, et que vous recomputez.
Mesurer la maladie : incidence et prévalence
Pourquoi c’est important. Avant toute comparaison, il faut compter les cas de maladie, et les deux comptes classiques répondent à des questions différentes : la rapidité d’apparition des nouveaux cas, et le nombre de cas existant simultanément.
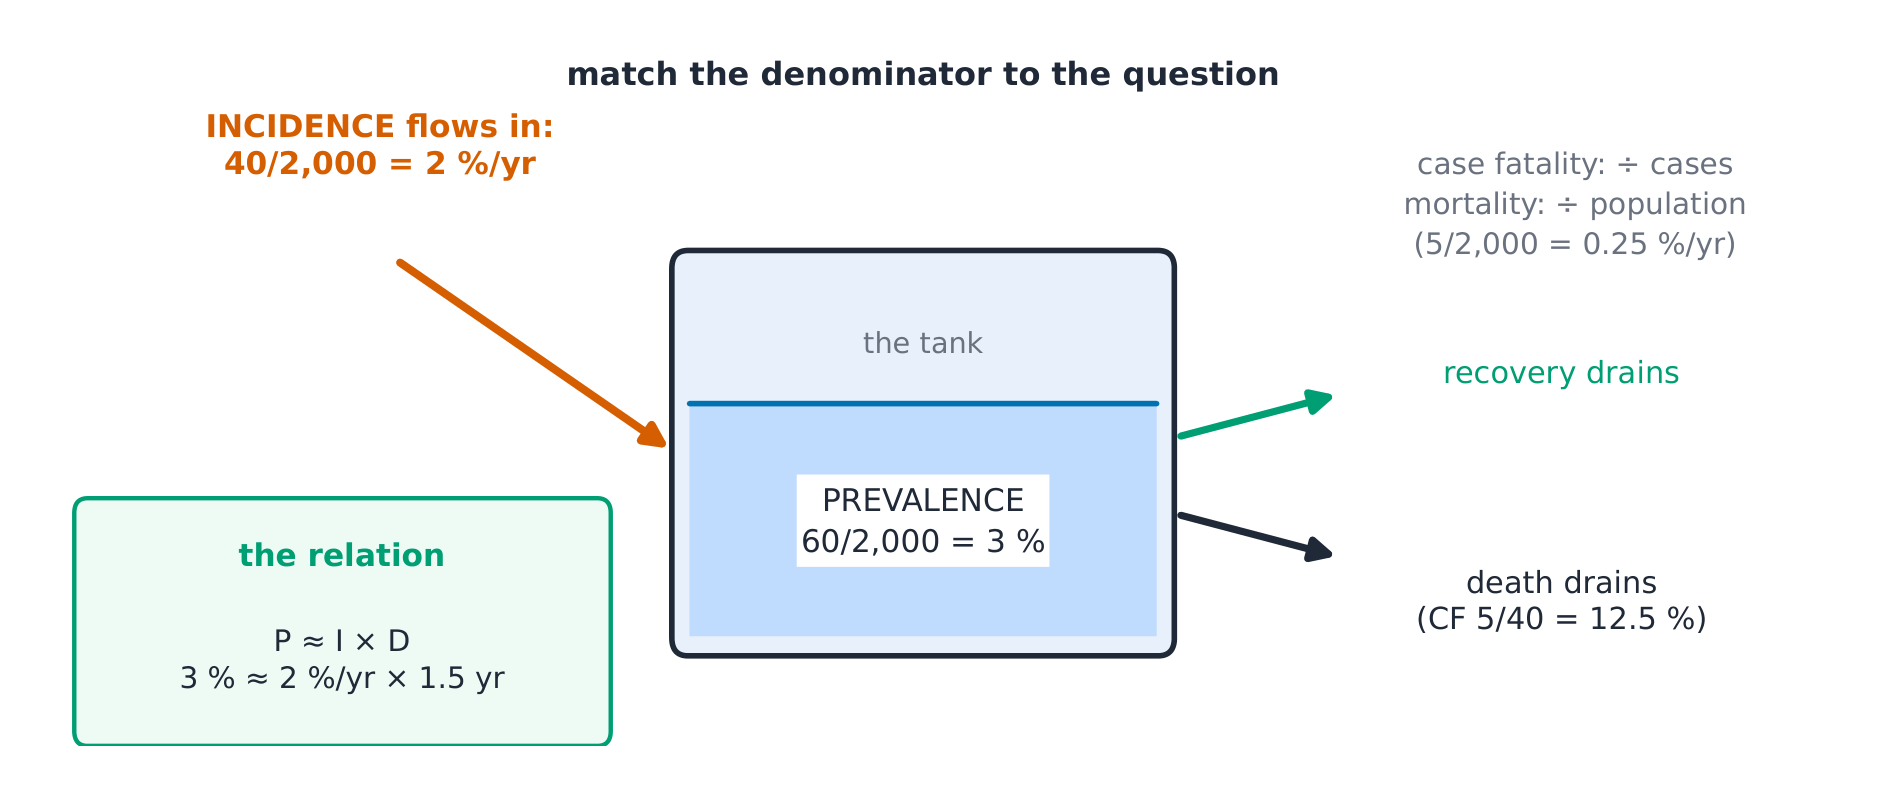
L’idée, avec une image. Incidence = nouveaux cas ÷ personnes à risque ÷ temps ; prévalence = cas existants ÷ population à un instant précis ✓. Ils sont liés : prévalence ≈ incidence × durée — les maladies chroniques s’accumulent, tandis que les brèves disparaissent entre deux enquêtes. L’incidence remplit le réservoir ; guérison et mortalité le vident — la prévalence est le niveau d’eau ✓.
 La dérivation (pourquoi la standardisation existe). Les taux bruts mélangent deux
effets : le risque de maladie et la structure par âge de la population. Un district comptant davantage d’anciens résidents peut afficher un taux brut plus élevé malgré des taux spécifiques aux âges PLUS FAIBLES ✓. La standardisation directe applique les taux spécifiques aux âges de chaque groupe à une population de référence unique et les additionne — le total artificiel est comparable car la répartition par âge est désormais identique. la répartition par âge est désormais identique.
Worked example 1 — a synthetic town. 2,000 residents, one year, 40 new cases of a disease → incidence 40/2,000 = 2 % per year ✓. On survey day 60 people have the disease → point prevalence 60/2,000 = 3 % ✓. Check the link: 3 % ≈ 2 %/an × 1.5 ans de durée moyenne — les chiffres sont cohérents. système.
Exemple résolu 2 — lien clinique : trois visages de la mortalité. (Jeu de données fictif) où sur 40 nouveaux cas, 5 sont décédés au cours de l'année : taux de létalité 5/40 = 12.5 % ✓ ; le nombre annuel de décès dus à cette cause dans toute la ville était de 5/2,000 = 0.25 % (taux de mortalité spécifique à une cause) ; et si la ville a enregistré 20 décès par toutes causes cette année-là, cette maladie a représenté 5/20 = 25 % d'entre eux (mortalité proportionnelle). Mêmes décès, trois dénominateurs, trois questions différentes.
Erreurs fréquentes. Confondre prévalence et taux (la prévalence est une proportion — sans unité de temps). Comparer des taux bruts entre populations ayant des structures d'âge différentes (standardiser d'abord). Interpréter le taux de létalité comme un taux de mortalité (le dénominateur est le nombre de cas, pas le nombre de personnes).
Résumé. Incidence = nouveaux/exposés/temps ; prévalence = existants/population; P ≈ I × D ; la standardisation corrige la répartition par âge ; le taux de létalité (cas), la mortalité spécifique à une cause (population), la mortalité proportionnelle (tous les décès) — adapter le dénominateur à la question posée.
Conception des études
Pourquoi c'est important. Chaque question clinique peut être répondue par certaines conceptions et non par d'autres ; choisir la conception, c'est choisir quels biais il faudra combattre. dira oui.
L'idée, avec une image. L'échelle : essai randomisé (expérience) → cohorte (suivi des exposés et non exposés vers l'avant) → cas-témoins (regard en arrière, à partir de l'issue) → transversal (une seule capture) → écologique (groupes, pas individus) ✓.
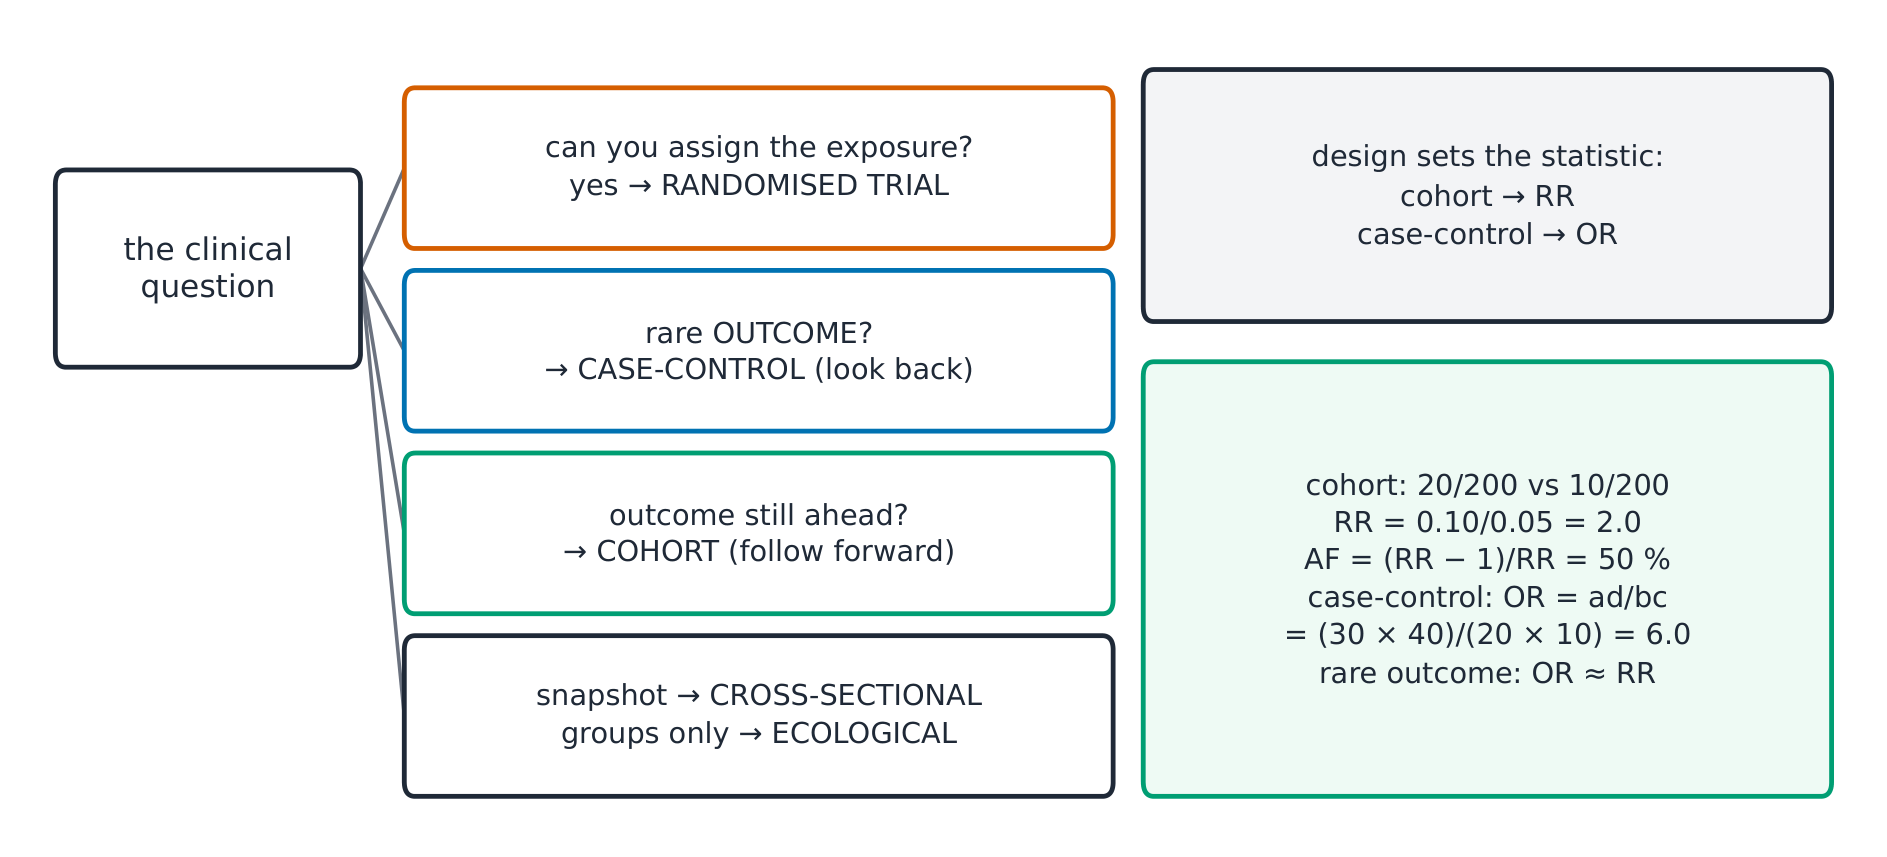
La dérivation (pourquoi le RR appartient aux cohortes et l'OR aux cas-témoins). Une cohort samples by EXPOSURE, so risks in each arm are estimable: relative risk $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. A case-control samples by OUTCOME, so the "risk" in each arm is an artefact of the sampling ratio — only the odds ratio $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ is valid ✓. The design dictates the statistic, not preference.
Exemple résolu 1 — une cohorte synthétique. Exposés 200, 20 événements ; non exposés 200, 10 événements : risques 0.10 vs 0.05 → $RR = 2.0$ ✓, attribuable Exemple résolu $(RR-1)/RR = 50\ \%$ — lien clinique : le miroir cas-témoins. (Fictif) sont la moitié « dus » à l'exposition sous les hypothèses.
Exemple résolu 2 — lien clinique : le miroir des cas-témoins. (Fictif) 30 des 40 cas exposés ; 20 des 60 témoins exposés : $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. Un événement rare fait que la CR approxime le VR — un seul nombre, sont choisis par le chercheur, pas trouvés). Lire un rapport de cotes transversal
Erreurs courantes. Calculer le VR à partir d'une étude cas-témoins (les dénominateurs sont choisis par le chercheur, pas observés). Lire une cote transversale rapport de causalité (l'exposition et l'issue sont simultanées). Égaliser "prospectif" avec "meilleur" (une cohorte prospective reste confondue ; seule la randomisation équilibre les inconnues).
Résumé. Essai → cohorte (RR) → cas-témoins (OR) → transversal → écologique ; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$ ; échantillons de cohortes par exposition, cas-témoins par issue ; OR des maladies rares ≈ RR ; fraction attribuable $(RR-1)/RR$.
Biais, confusion et causalité
Pourquoi c'est important. Les chiffres trompent de trois manières : systématiquement (biais), par une troisième variable (confusion), et par association sans cause. Nommer le mode de défaillance constitue la moitié de l'évaluation critique.
L'idée, avec une image. Biais est une erreur systématique dans la conception ou la mesure : biais de sélection (qui entre), biais d'information/mémoire (ce qui est retenu ou enregistré). Confusion est une troisième variable liée à la fois l'exposition et l'issue qui se fait passer pour la cause ✓.
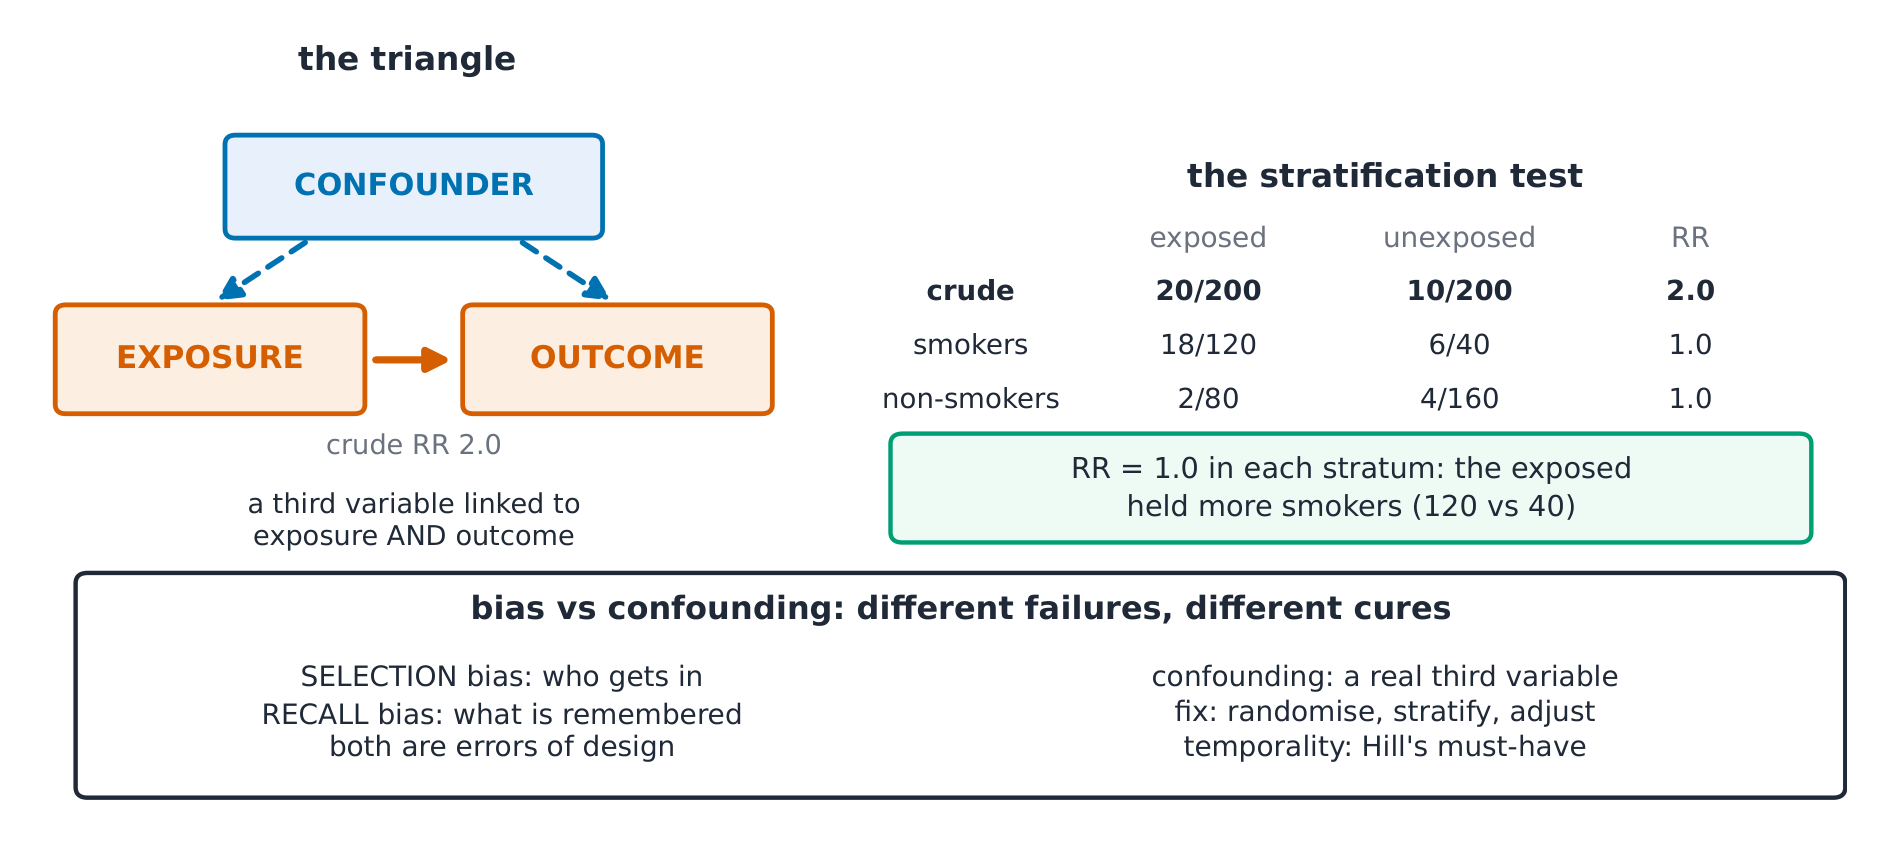
La dérivation (pourquoi la stratification est la preuve). Si une troisième variable est le véritable moteur, l'association devrait disparaître au sein des strates où elle est constante : brut $RR$ 2.0, mais chez les non-fumeurs $RR$ 1.0 et chez les fumeurs $RR$ 1.0 → le tabac était le facteur de confusion ✓. Si l'association persiste au sein strates (prononciation 2.0 et 1.9), l'exposition conserve son propre signal. Randomisation empêche le biais de confusion prospectivement en équilibrant même les inconnues ✓.
Exemple résolu 1 — tableau stratifié. (Synthétique) brut : exposé 20/200 événements vs non-exposés 10/200 → RR 2.0. Stratifier selon le tabagisme : non-fumeurs 6/100 vs 3/100 (RR 2.0 ✓ à l'intérieur), fumeurs 14/100 vs 7/100 (RR 2.0) — l'association subsiste après stratification : le tabagisme n'était PAS le facteur de confusion ici ; le signal de l'exposition est valide. Appliquez maintenant la même table brute à une répartition différente : exposés : 120 fumeurs (18 événements) et 80 non-fumeurs (2 événements) ; non-exposés : 40 fumeurs (6 événements) et 160 non-fumeurs (4 événements). Le risque chez les fumeurs est de 15 % dans les deux bras et de non-fumeurs 2.5 % dans les deux groupes, donc le VR est 1.0 dans chaque strate : la exposé contenait simplement plus de fumeurs, et le tabagisme ÉTAIT le facteur de confusion ✓. Un seul tableau brut, deux conclusions opposées — seules les strates permettent de les distinguer.
Exemple résolu 2 — lien clinique : questions d'évaluation. (Fictif résumé) « Les buveurs de café avaient un risque double » : demandez qui a été inclus (sélection), comment l'exposition a été mesurée (rappel — les patients malades se souviennent différemment), et ce qu'un facteur de confusion devrait ressembler (associé au café ET au résultat, comme le tabagisme). Les critères de Bradford Hill — temporalité d'abord, puis intensité, cohérence, relation dose-réponse, plausibilité — transforment un titre sensationnel en liste de contrôle ✓. plausibilité — transformer un titre en liste de contrôle ✓.
Erreurs fréquentes. Traiter la confusion et le biais de mesure comme un seul problème (la confusion est un mélange d'effets par une troisième variable, résolu par la randomisation, la stratification ou l'ajustement ; les biais de sélection et d'information sont des erreurs sur qui est étudié et comment les choses sont mesurées, que aucune analyse ne corrige entièrement). S'attendre à ce que les big data guérissent la confusion (plus de précision autour d'une estimation biaisée). Exiger chaque point de vue de Hill (ce sont des points de vue, pas un tableau de bord ; la temporalité est la seule condition non négociable). Résumé. Biais = erreur systématique (sélection, information/mémoire) ; confondeur = troisième variable sur les deux chemins ; le test de stratification annule l'association s'il y a confusion ; la randomisation équilibre les inconnues ; points de vue de Hill avec la temporalité en premier. biais sont des erreurs concernant qui est inclus et comment les mesures sont faites, ce qu'aucun Pourquoi c'est important. Les chiffres d'un test ne sont pas seulement des propriétés du test lui-même — la sensibilité et la spécificité appartiennent au test, mais les valeurs prédictives appartiennent à la population qui l'utilise. Mal interpréter cela constitue l'erreur quantitative la plus fréquente dans le raisonnement clinique. grand jeu de données ne peut corriger (plus de précision autour d'un estimateur biaisé d'estimation). Exiger tous les critères de Hill (ce sont des points de vue, pas un tableau de bord ; la temporalité est le seul critère indispensable).
Résumé. Biais = erreur systématique (sélection, information/mémoire) ; facteur de confusion = troisième variable sur les deux chemins ; le test par stratification annule l'association si elle est confondue ; la randomisation équilibre les inconnues ; les critères de Hill avec la temporalité en premier.
Tests diagnostiques
Pourquoi cela compte. Les chiffres d'un test ne sont pas des propriétés du test seul — la sensibilité et la spécificité appartiennent au test, mais les valeurs prédictives appartiennent à la population qui l'utilise. Une mauvaise interprétation est l'erreur quantitative la plus fréquente dans le raisonnement clinique. erreur dans le raisonnement clinique.
The idea, with a picture. The 2×2: sensitivity = a/(a+c) (diseased, test positive); specificity = d/(b+d) (healthy, test negative); PPV = a/(a+b), NPV = d/(c+d) — and the natural-frequency L'arbre montre pourquoi la prévalence déplace les valeurs prédictives ✓.

La dérivation (pourquoi la prévalence entraîne la VPP). VPP = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. Avec Se = Sp = 90 % : à une prévalence de 10 %, la VPP = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — même un test excellent est un tirage au sort dans une clinique à faible prévalence. Le bras des faux positifs s'étend proportionnellement à la majorité saine.
Exemple résolu 1 — l'arbre des fréquences naturelles (synthétique). 1,000 personnes, prevalence 10 %: 100 diseased → 90 true positives, 10 false negatives; 900 sains → 810 vrais négatifs, 90 faux positifs ✓. VPP = 90/180 = 50 %; VNN = 810/820 = 98.8 % ✓. Même test à une prévalence de 1 % : 9 VP vs 99 FP → VPP 9/108 = 8.3 % ✓ — un seul arbre, deux mondes.
Exemple résolu 2 — lien clinique : le rapport de vraisemblance voyage. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓ : un résultat positif multiplie les cotes pré-test par 9 quelle que soit la prévalence de la clinique. Cotes pré-test 1:9 (10 %) → post-test 9:9 = 1:1 → probabilité 50 % — la même VPP, dérivée en une seule ligne. Rapports de vraisemblance (RV) sont la forme portable du test ; les valeurs prédictives sont locales.
Erreurs courantes. Citer la sensibilité comme « le test a 90 % de justesse » (il a justesse sur 90 % des MALADES — dire de quoi). Appliquer une VPP de manuel à une clinique à prévalence différente. Confondre les deux colonnes (la sensibilité se lit vers le bas dans la colonne malade ; la spécificité vers le bas dans la colonne saine).
Résumé. Se = a/(a+c), Sp = d/(b+d) — propriétés du test ; VPP/VNN — propriétés de la population, se déplacent avec la prévalence ; les arbres en fréquence naturelle le rendent visible ; $LR+ = Se/(1-Sp)$ multiplie les cotes portables (0.9/0.1 = 9) ; 50 % VPP à 10 % de prévalence malgré Se = Sp = 90 %.
Inférence statistique pour les données cliniques
Pourquoi c'est important. L'inférence est la manière dont un échantillon parle d'une population — et la mauvaise lecture des p-valeurs et des intervalles de confiance sont les erreurs caractéristiques de la littérature moderne.
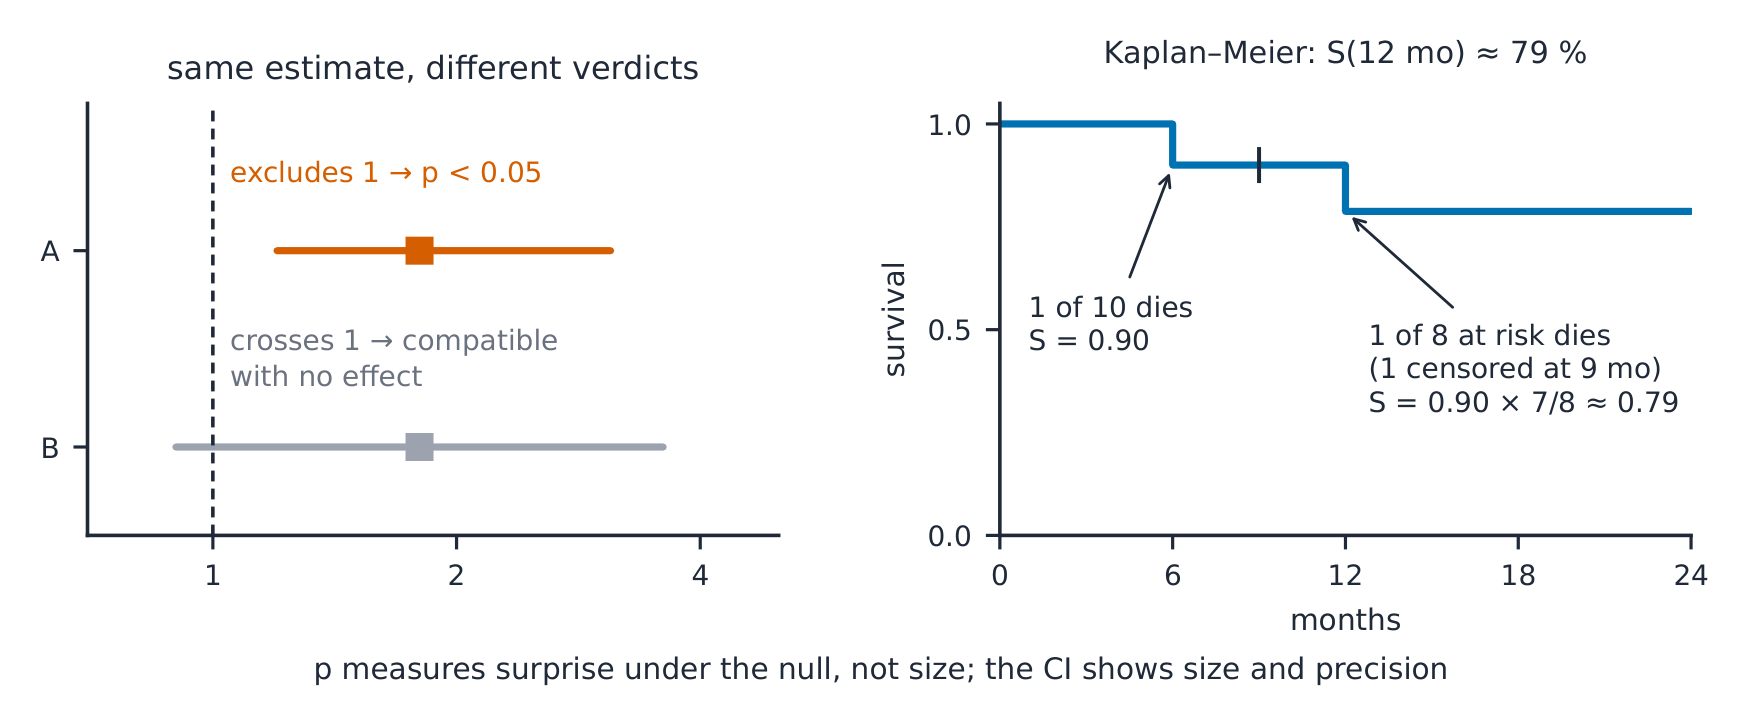
L'idée, avec une image. Un intervalle de confiance à 95 % est l' ensemble des valeurs vraies compatibles avec les données à ce niveau ; une p-valeur P est la probabilité d'obtenir des données au moins aussi extrêmes SI l'hypothèse nulle était vraie ✓. L'IC résume l'ampleur et la précision ; la p-valeur ne résume que l'étonnement.
La dérivation (pourquoi le test suit le type de données). Comptages par groupe → χ² ; deux moyennes (plausiblement normales) → test t (apparié lorsque chaque ligne est mesurée deux fois) ; plusieurs moyennes → ANOVA ; asymétrique/petit-n → rangs (alternatives non paramétriques) ; deux mesures continues → corrélation (Pearson, ou Spearman pour les rangs) ✓. L'échelle de mesure dicte le test — décider après avoir vu les résultats invite à poser la mauvaise question.
Exemple résolu 1 — lire un seul intervalle. (Résumé fictif) RR 1.8, 95 % IC 1.2–3.1 : l'intervalle exclut 1, donc les données sont incompatibles avec "aucun effet" à ce niveau (p < 0.05 suit) ; la largeur indique que l'estimation est imprécise mais constamment supérieure à 1 ✓. Un RC 1.8 avec IC 0.9–3.6 indique le contraire — même estimateur ponctuel, verdict différent, et seul l'intervalle vous donne la réponse.
Exemple résolu 2 — lien clinique : l'arithmétique de Kaplan–Meier. (Synthétique) 10 patients recrutés ; à 6 mois, 1 événement parmi 10 en risque : $S = 9/10 = 0.90$; at 12 months 1 event among the 8 still at risk (one censuré) : $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. La survie médiane correspond au temps où la courbe franchit 50 % ; le censurage retire des personnes du dénominateur, pas de la logique de l'estimation.
Erreurs fréquentes. « p > 0.05 signifie aucune différence » (cela signifie que les données sont compatibles avec une absence de différence — absence de preuve ≠ preuve d'absence). Lecture de l'IC comme une probabilité de 95 % que la vérité se trouve à l'intérieur (l'intervalle est une propriété de la procédure, appliquée à l'estimation de cet échantillon). Choisir le test après avoir vu lequel donne un p < 0.05.
Résumé. IC = ensemble des valeurs compatibles, reflète l'amplitude et la précision ; p-valeur = P(données aussi extrêmes | hypothèse nulle) ; jamais « prouvé » ou « aucun effet » uniquement sur base de p; χ²/t/ANOVA/rang/corrélation choisis selon le type de données ; la courbe de Kaplan–Meier multiplie (1 − événements/en risque) ; médiane = point de franchissement de 50 %.
Essais cliniques et revues systématiques
Pourquoi c’est important. Les essais constituent la machine à produire des preuves, et les revues leur assemblage — le vocabulaire (randomisation, aveuglement, ITT, NNT) est ce que chaque résumé et chaque graphique en forêt sous-entend que vous maîtrisez. ensemble — le vocabulaire (randomisation, aveugle, ITT, NNT) est ce que chaque résumé et chaque graphique en forêt suppose que vous connaissez.
L’idée, avec une image. La colonne vertébrale d’un essai : éligibilité → randomisation (affectation par hasard, allocation dissimulée) → aveuglement (participant, clinicien, évaluateur des résultats) → analyse selon l’intention de traiter (analyser tel que randomisé, tous comptabilisés) ✓. Les revues synthétisent dans un graphique en forêt : (attribution par hasard, allocation dissimulée) → aveugle (participant, clinicien, évaluateur des résultats) → analyse selon l'intention de traiter des carrés (taille = poids), des lignes (IC), un losange (synthèse), et l'hétérogénéité Randomiser, aveugler, analyser tel que randomisé — puis synthétiser : les carrés pondérés par la précision, le losange représentant le verdict combiné $I^2$ ✓.
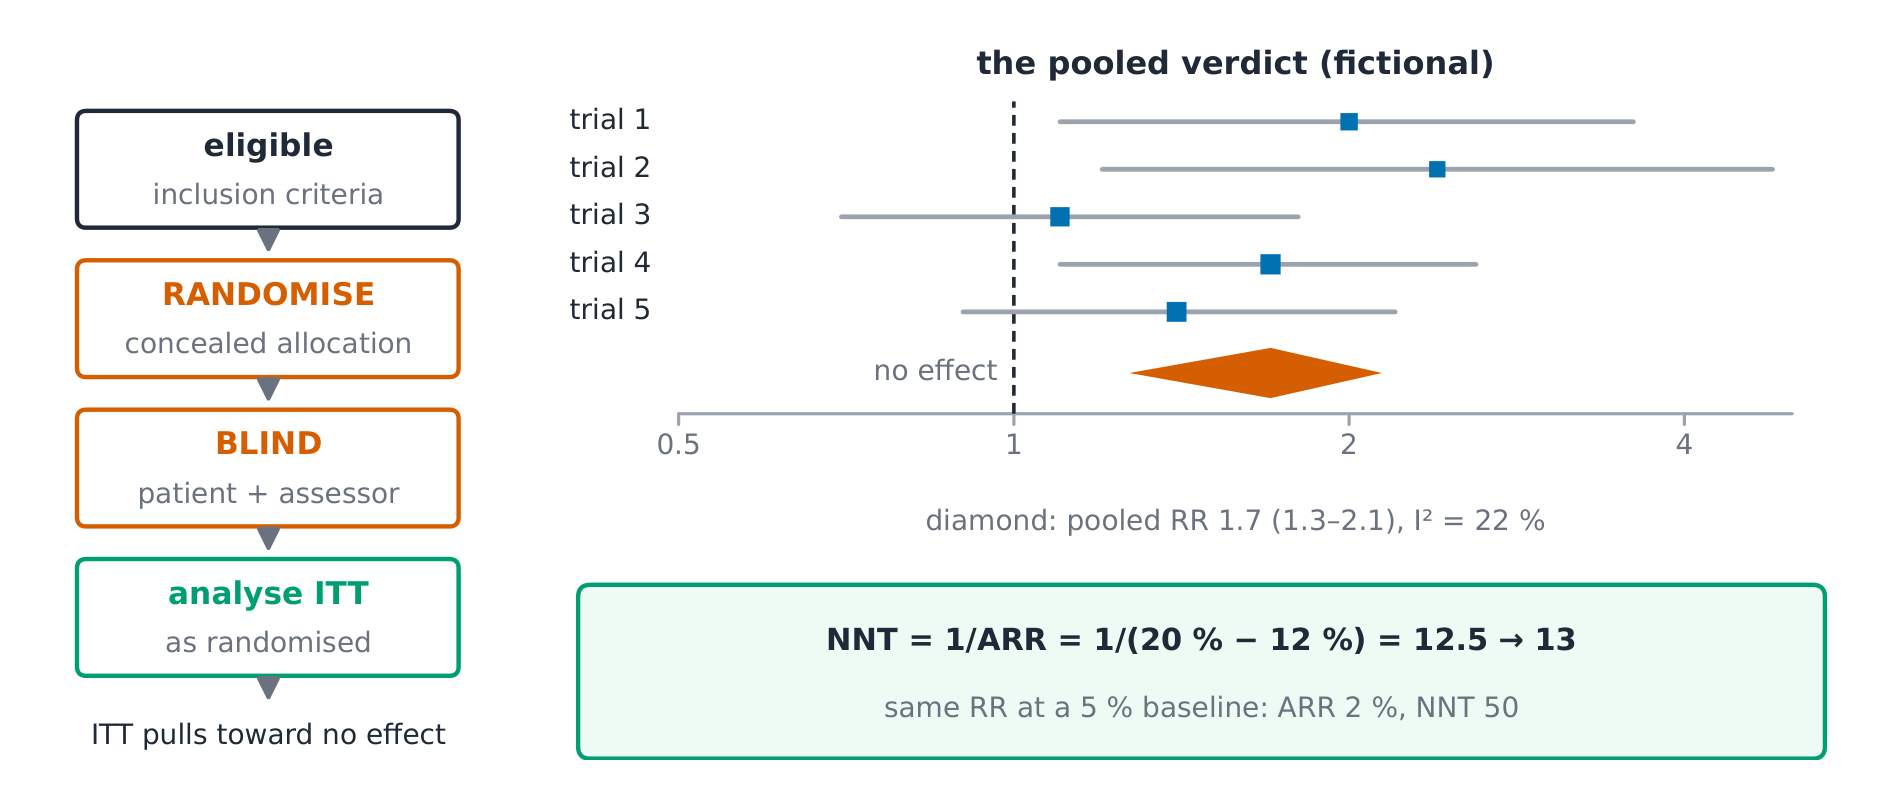
La dérivation (pourquoi le NNT représente l’ampleur clinique d’un effet). NNT = $1/ARR$ : taux d’événement sous traitement contrôle 20 %, sous traitement actif 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13 patients traités pour qu’un seul bénéficie de l’effet ✓. Le NNT convertit un ratio abstrait en charge de travail — et son dénominateur (ARR) diminue lorsque le risque de base baisse, ce qui explique pourquoi les résultats d’un essai ne se transposent pas inchangés vers des cliniques à faible risque. un rapport abstrait en charge de travail — et son dénominateur (RRI) diminue lorsque le risque de base diminue, c'est pourquoi les résultats d'essais ne s'appliquent pas aux cliniques à faible risque sans ajustement.
Exemple commenté 1 — la logique de l’ITT. (Essai fictif) 20 % sous contrôle vs 12 % sous traitement actif : ARR 8 %, NNT 13 ✓. Si 30 % du bras traité ont interrompu précocement leur affectation, l’ITT les conserve comme traités — diluant ainsi l’effet apparent vers la nullité — car la question porte sur la POLITIQUE d’affectation, attribution précoce, l'ITT les compte toujours comme traités — diluant l'effet apparent vers le nul — car la question porte sur la POLITIQUE d'attribution, pas la biologie de l'adhérent ✓. Les réponses per-protocol répondent à une autre question et héritent du biais d'adhérence. question et hérite le biais d'adhérence.
Worked example 2 — clinical link: reading the diamond. (Fictional forest) five trials, individual RRs 1.1–2.4 with wide CIs, pooled RR 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓ : le diamant se trouve à droite de 1 et son intervalle exclut 1, avec faible hétérogénéité — un effet cohérent dans divers contextes. Le même losange avec $I^2 = 78\ \%$ amènerait à demander « pourquoi ces essais sont-ils en désaccord ? » avant de faire confiance à tout regroupement. amènerait à demander « pourquoi ces essais sont-ils en désaccord ? » avant de faire confiance à tout regroupement.
Erreurs courantes. Confondre randomisation et aveuglement (la chance équilibre les groupes ; l'aveuglement équilibre les attentes — un essai peut n'en avoir qu'un seul). groupes ; l'aveuglement équilibre les attentes — un essai peut n'en avoir qu'un seul). Considérer per-protocol comme l'analyse honnête (elle compromet la protection de la randomisation). Traiter le losange poolé comme une vérité infaillible malgré une forte hétérogénéité. protection). Traiter le losange poolé comme une vérité infaillible malgré une forte hétérogénéité. hétérogénéité.
Résumé. Randomiser (avec dissimulation) → aveugler → analyser selon la randomisation (ITT, dilue vers la nullité) ; NNT = 1/ARR (20 % → 12 % : ARR 8 %, NNT 13) ; forêt : carrés pondérés, losange poolé, $I^2$ désaccord ; les cliniques à faible taux de base réduisent l'ARR et gonflent le NNT. réduisent l'ARR et gonflent le NNT.
Évaluation critique et application des preuves
Pourquoi c'est important. La preuve ne devient médecine qu'au chevet du patient : évaluée pour sa validité, quantifiée par son importance, et adaptée au patient devant soi. pour la validité, dimensionné selon l'importance et adapté au patient devant soi Vous. Cette unité constitue la synthèse du cours.
L'idée, avec une image. La colonne vertébrale de l'évaluation : PICO (population, intervention, comparaison, résultat) encadrant → validité (les résultats étaient-ils biaisés ?) → taille (quelle ampleur, quelle précision ?) → applicabilité (mon patient ressemble-t-il à la population étudiée ?) ✓. Échelle de certitude (GRADE) : les preuves randomisées partent d'un niveau élevé et les preuves observationnelles d'un niveau bas ; dévalorisation en cas de risque de biais, d'incohérence, d'indirectitude, d'imprécision ou de biais de publication ; revalorisation en cas d'effets importants ou d'un gradient dose-réponse ✓.

La justification (pourquoi cette hiérarchie est un a priori, pas un verdict). Les designs diffèrent par leur contrôle TYPIQUE des biais : la randomisation équilibre les facteurs de confusion mesurés et non mesurés ; les cohortes comportent des confusions ; les études cas-témoins ajoutent un biais de rappel ✓. Mais la hiérarchie note la catégorie de design, tandis que le verdict appartient à l'étude concrète — un petit essai non insu, analysé selon le protocole, peut mériter moins de confiance qu'une grande cohorte pré-enregistrée avec ajustement par score de propension. GRADE existe précisément parce que la catégorie de design n'est que le point de départ. ajustement de la propension. GRADE existe précisément parce que la classe de conception n'est que le point de départ.
Exemple résolu 1 — un résumé fictif en cinq questions. (Fictif) "Randomisé, double insu, n = 400 ; RR 0.75 (0.60–0.94)" : validité — randomisation et insu ✓ ; taille — réduction relative de 25 %, l'intervalle exclut 1; applicabilité locale — des patients comme le mien étaient-ils inclus (âge, gravité, médicaments concomitants ?); résultats — pertinents pour le patient ou substituaires ?; certitude — des critères de dégradation ? Cinq questions, un verdict structuré ✓.
Exemple résolu 2 — lien clinique : transplantation du NNT. (Fictif) a essai en maladie sévère (base 20 %, ARR 8 %, NNT 13) ; mon patient de consultation présente une base de 5 % : avec la même réduction du risque relatif, l'ARR s'échelle à $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. L'effet relatif peut — est locale. Erreurs courantes. Évaluer uniquement la validité (un effet valide mais minime
reste inutile : l'amplitude et la précision déterminent l'importance). Noter selon le journal ou l'étiquette du protocole seul (GRADE commence là et évolue avec les défauts des preuves). Appliquer des moyennes de groupe au patient dont la caractéristique principale était un critère d'exclusion. Résumé. PICO → validité → amplitude → applicabilité ; GRADE : partir du
protocole, dégrader pour biais/instabilité/indirecte/précision insuffisante, majorer pour les effets importants ; la pyramide est une a priori, pas un verdict ; les effets relatifs se transmettent, les bénéfices absolus (ARR, NNT) sont locaux — recalculer avant application. se déplacer, mais les bénéfices absolus (ARR, NNT) sont locaux — recalculer avant application.