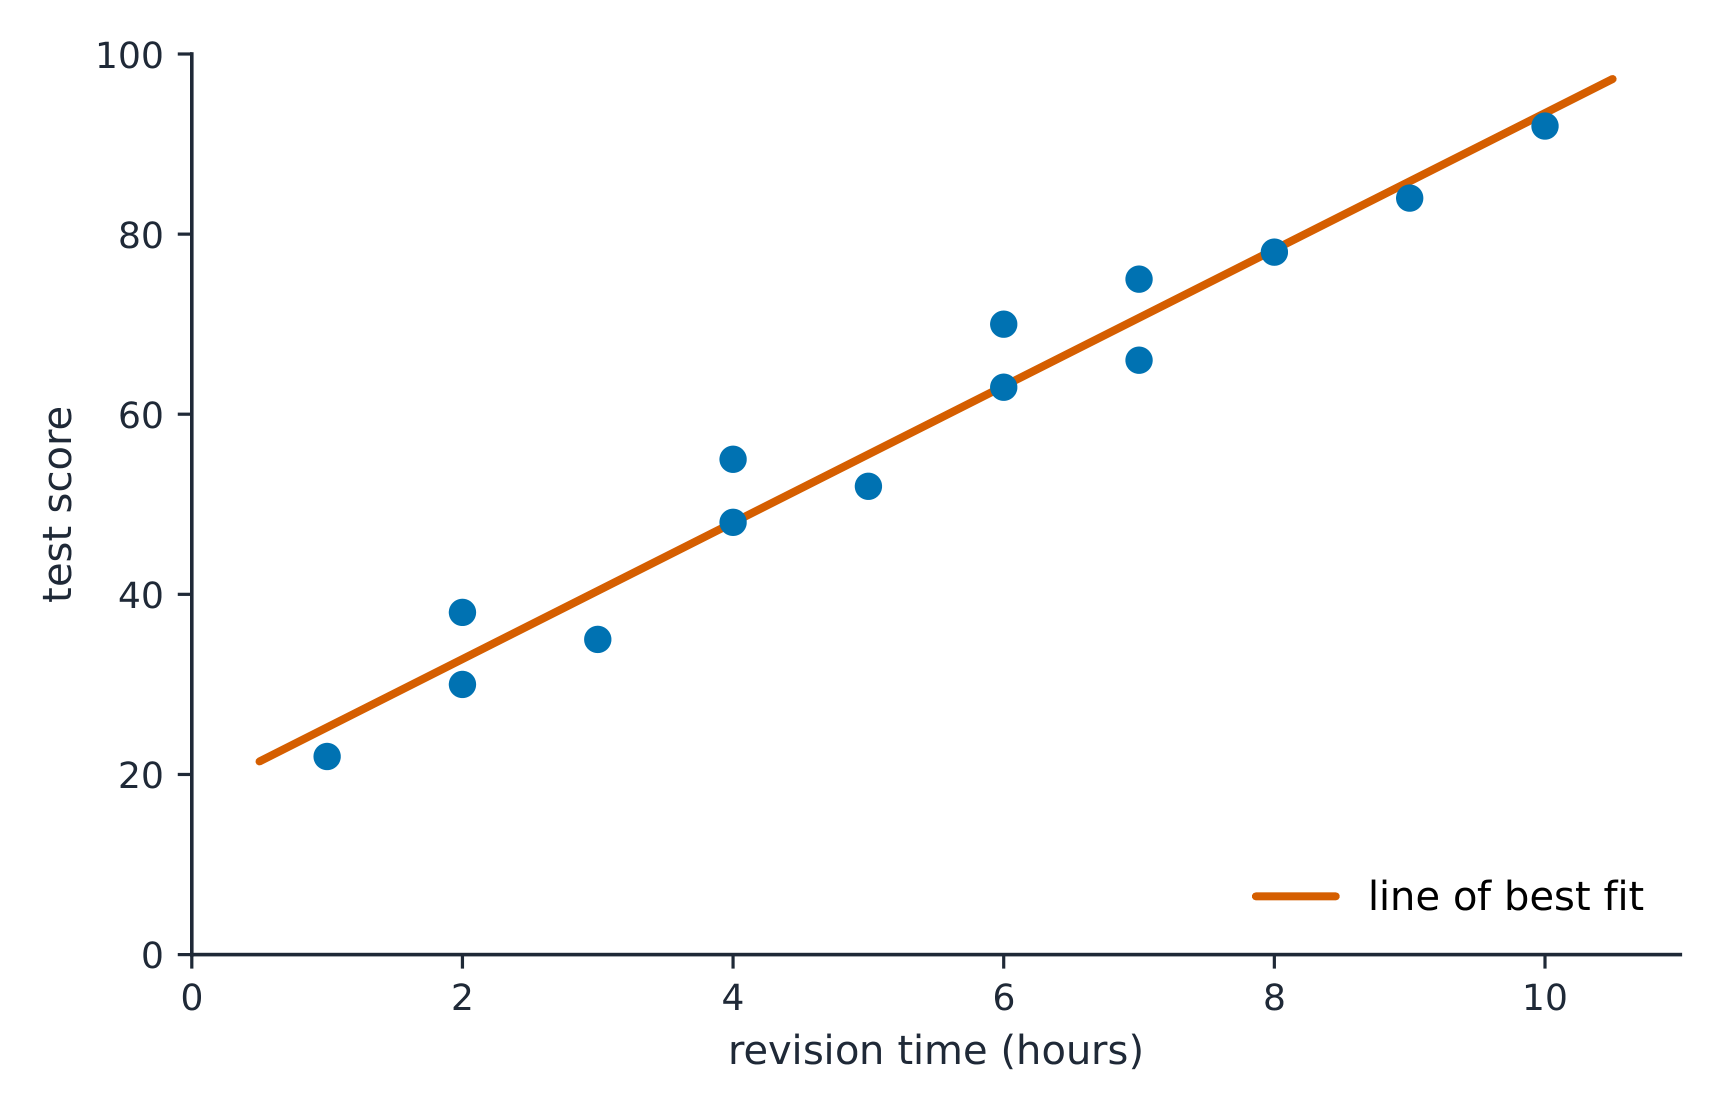
Voici une classe sur un nuage de points : heures de révision en bas, note de test sur le côté. La droite de tendance monte. Mais ce n'est qu'une seule classe. Prenez un autre…
Narration en anglais · Sous-titres anglais + 中文 incrustés
9.1
Ces points sont-ils alignés ?
Programme
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.K : Identifier les questions suggérées par la variation dans les nuages de points. [Compétence 1.A]
VAR-1.K.1 La variation des positions des points par rapport à une ligne théorique peut être aléatoire ou non aléatoire.
Source : Description du cours et de l'examen AP College Board
Un nuage de points 散点图 d'échantillon donne une pente d'échantillon 样本斜率$b$ pour la droite de régression 回归 des moindres carrés – mais un autre échantillon donnerait une pente légèrement différente. Donc $b$ est une statistique avec variabilité d'échantillonnage 抽样变异性, estimant la pente réelle (population) 总体斜率$\beta$. Cette unité fait de l'inférence 推断 pour $\beta$ : y a-t-il une véritable relation linéaire 线性, et quelle est sa force ?
9.2
Intervalle de confiance pour une pente
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.AC : Identifier une procédure d'intervalle de confiance appropriée pour la pente d'un modèle de régression. [Compétence 1.D]
UNC-4.AC.1 Considérez une variable réponse, $y$, qui est linéairement liée à une variable explicative, $x$. Pour un échantillon aléatoire simple de $n$ observations, la droite de régression de l'échantillon, $\hat{y} = a + bx$, est une estimation de la droite de régression de la population $\mu_y = \alpha + \beta x$. Pour une observation particulière, $(x_i, y_i)$, le résidu de la droite de régression de l'échantillon, $y_i - \hat{y}_i = y_i - (a + bx_i)$, est une estimation de $y_i - (\alpha + \beta x_i)$, l'écart de la variable réponse par rapport à la droite de régression de la population. Pour tous les points $(x, y)$ dans la population, l'écart-type de tous les écarts de la variable réponse par rapport à la droite de régression de la population, $\sigma$, peut être estimé par l'écart-type des résidus de la droite de régression de l'échantillon, $s = \sqrt{\dfrac{\sum\left(y_i - \hat{y}_i\right)^2}{n-2}}$. (Remarque : Cette formule utilise $n-2$ au dénominateur au lieu de $n-1$ car deux paramètres, $\alpha$ et $\beta$, doivent être estimés pour obtenir les valeurs prédites à partir de la droite de régression des moindres carrés.)
UNC-4.AC.2 Pour un échantillon aléatoire simple de $n$ observations, soit $b$ représentant la pente d'une droite de régression de l'échantillon. Alors la moyenne de la distribution d'échantillonnage pour $b$ est égale à la pente de la population : $\mu_b = \beta$. L'écart-type de la distribution d'échantillonnage pour $b$ est $\sigma_b = \dfrac{\sigma}{\sigma_x \sqrt{n}}$, où $\sigma_x = \sqrt{\dfrac{\sum\left(x_i - \bar{x}\right)^2}{n}}$.
UNC-4.AC.3 L'intervalle de confiance approprié pour la pente d'un modèle de régression est un intervalle de confiance $t$ pour la pente.
Objectif d'apprentissage UNC-4.AD : Vérifier les conditions pour calculer des intervalles de confiance pour la pente d'un modèle de régression. [Compétence 4.C]
UNC-4.AD.1 Afin de calculer un intervalle de confiance pour estimer la pente d'une droite de régression, nous devons vérifier ce qui suit :
a. La relation réelle entre $x$ et $y$ est linéaire. L'analyse des résidus peut être utilisée pour vérifier la linéarité.
b. L'écart-type pour $y$, $\sigma_y$, ne varie pas avec $x$. L'analyse des résidus peut être utilisée pour vérifier des écarts-types approximativement égaux pour toutes les $x$.
c. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \le 10\% N$.
d. Pour une valeur particulière de $x$, les réponses (valeurs $y$) sont approximativement normalement distribuées. L'analyse de représentations graphiques des résidus peut être utilisée pour vérifier la normalité.
i. Si la distribution observée est asymétrique, $n$ doit être supérieur à 30.
Objectif d'apprentissage UNC-4.AE : Déterminer la marge d'erreur donnée pour la pente d'un modèle de régression. [Compétence 3.D]
UNC-4.AE.1 Pour la pente d'une droite de régression, la marge d'erreur est la valeur critique $\left(t^*\right)$ multipliée par l'erreur standard ($SE$) de la pente.
UNC-4.AE.2 L'erreur standard pour la pente d'une droite de régression avec un écart-type de l'échantillon, $s$, est $SE = \dfrac{s}{s_x \sqrt{n-1}}$, où $s$ est l'estimation de $\sigma$ et $s_x$ est l'écart-type de l'échantillon des valeurs $x$.
Objectif d'apprentissage UNC-4.AF : Calculer un intervalle de confiance approprié pour la pente d'un modèle de régression. [Compétence 3.D]
UNC-4.AF.1 L'estimateur ponctuel pour la pente d'un modèle de régression est la pente de la droite de meilleure ajustement, $b$.
UNC-4.AF.2 Pour la pente d'un modèle de régression, l'estimation par intervalle est $b \pm t^* \left(SE_b\right)$.
Source : Description du cours et de l'examen AP College Board
Un intervalle de $t$ pour la vraie pente $\beta$ :
$$b\pm t^{*}\,SE_b,\qquad df=n-2,$$
où $b$ est la pente d'échantillon et $SE_b$ son erreur type (lu dans la sortie ordinateur). Conditions (LINER) : la relation réelle est Linéaire, observations Indépendantes, résidus Normaux, et résidus ont une dispersion Égale (vérifiez le graphique des résidus et un histogramme des résidus), provenant de données Aléatoires. Interprétez l'intervalle pour $\beta$ en contexte, avec les unités de $y$ par unité de $x$.
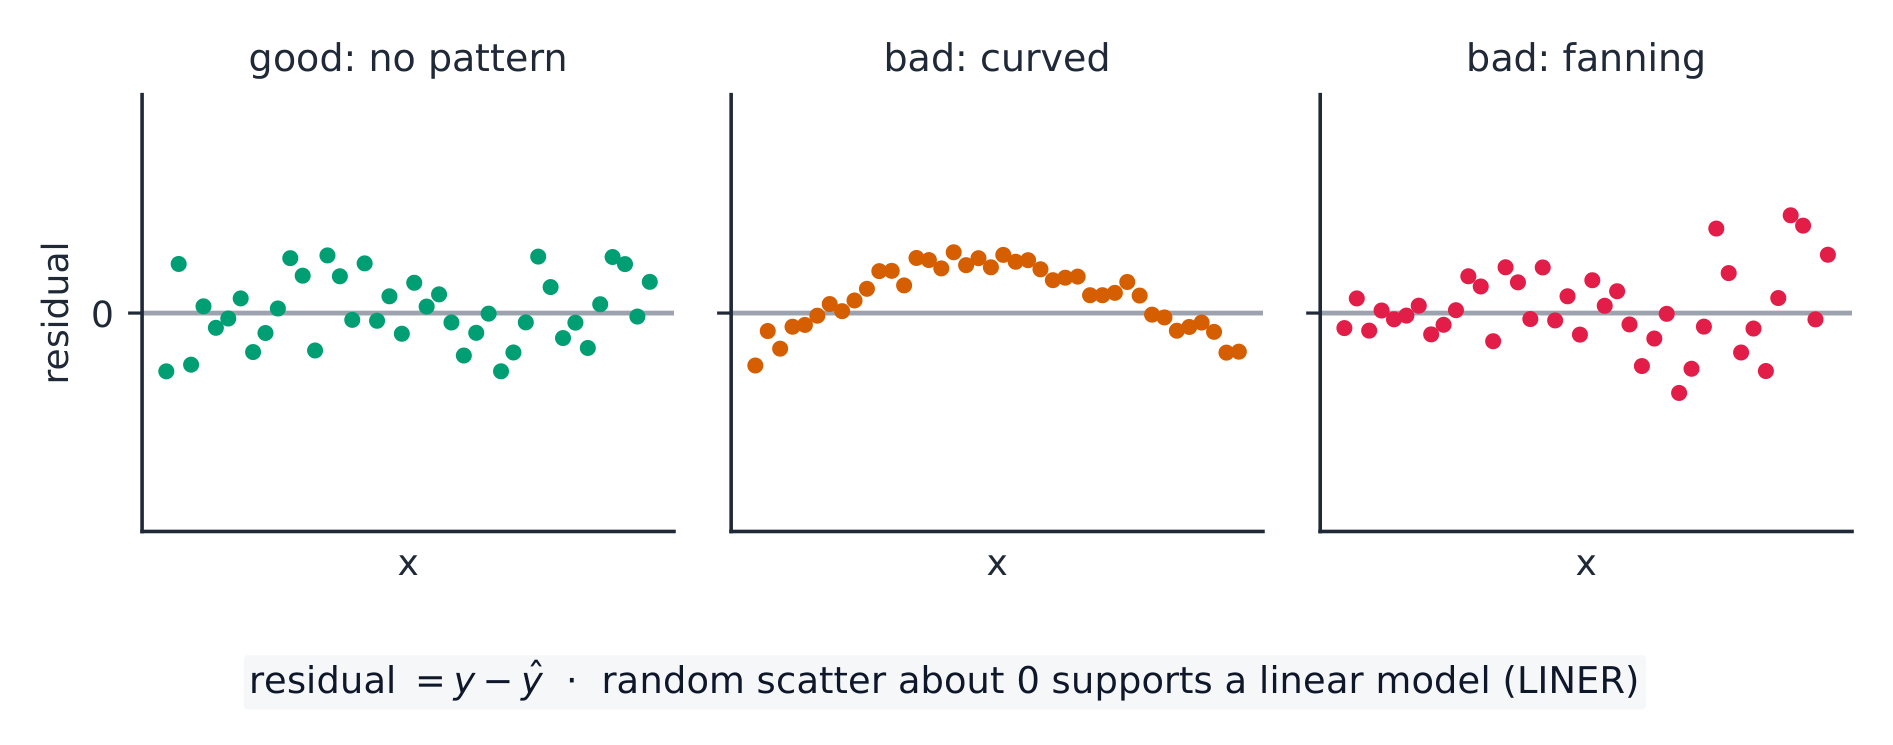
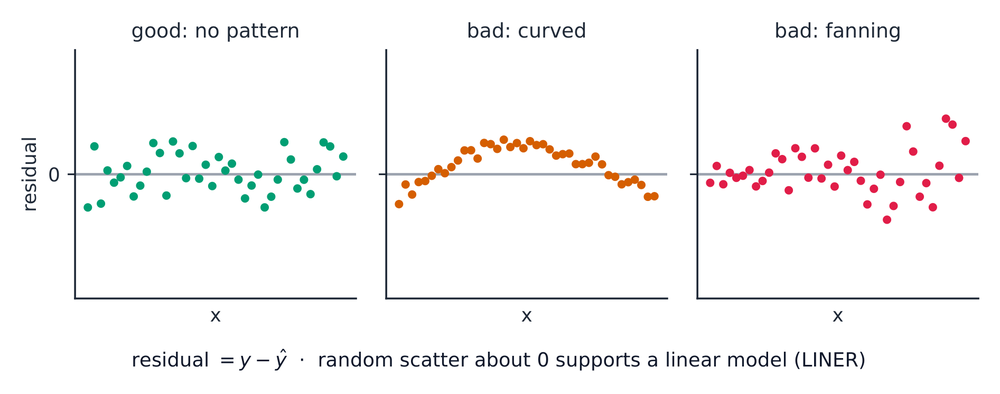
Un graphique de résidus aléatoire et sans motif soutient les conditions ; une courbe ou un entonnoir ne le font pas
Le graphique des résidus 残差图 est l'endroit où vous vérifiez Linéarité et Dispersion Égale : vous voulez un nuage sans forme autour de zéro. Une courbe signifie que la relation n'est pas linéaire ; un entonnoir (dispersion croissante avec $x$) signifie que les résidus n'ont pas une dispersion égale – les deux violent une condition.
Exemple résolu. La sortie de régression donne une pente $b=2.5$ avec $SE_b=0.8$ à partir de $n=20$ points. Pour un intervalle de $95\%$, $df=18$ donne $t^*=2.101$ :
$$2.5\pm2.101(0.8)=2.5\pm1.68=(0.82,\ 4.18).$$
Parce que $0$ n'est pas dans l'intervalle, il y a des preuves d'une relation linéaire positive.
L'inférence sur la pente est basée sur la droite de régression des moindres carrés passant par les pointsRégression des moindres carrés : la droite qui minimise la somme des carrés des résidus
Explorer
Inférence pour la pente d'une régression
La pente de l'échantillon varie d'un échantillon à l'autre ; un intervalle de confiance et un test t demandent si la vraie pente pourrait être zéro (pas de relation linéaire).
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.AG : Interpréter un intervalle de confiance pour la pente d'un modèle de régression. [Compétence 4.B]
UNC-4.AG.1 Dans des échantillonnages aléatoires répétés avec la même taille d'échantillon, environ C% des intervalles de confiance créés captureront la pente du modèle de régression, c.-à-d. la vraie pente de la droite de régression de la population.
UNC-4.AG.2 Une interprétation pour un intervalle de confiance pour la pente d'une droite de régression doit inclure une référence à l'échantillon pris et des détails sur la population qu'il représente.
Objectif d'apprentissage UNC-4.AH : Justifier une affirmation basée sur un intervalle de confiance pour la pente d'un modèle de régression. [Compétence 4.D]
UNC-4.AH.1 Un intervalle de confiance pour la pente d'un modèle de régression fournit un intervalle de valeurs qui peuvent fournir des preuves suffisantes pour soutenir une affirmation particulière dans le contexte.
Objectif d'apprentissage UNC-4.AI : Identifier les effets de la taille de l'échantillon sur la largeur d'un intervalle de confiance pour la pente d'un modèle de régression. [Compétence 4.A]
UNC-4.AI.1 Lorsque tout reste égal ailleurs, la largeur de l'intervalle de confiance pour la pente d'un modèle de régression a tendance à diminuer lorsque la taille de l'échantillon augmente.
Source : Description du cours et de l'examen AP College Board
Si l'intervalle de confiance pour $\beta$ contient $0$, une pente nulle est plausible – aucune preuve d'une relation linéaire. Si l'intervalle est entièrement positif ou négatif, il existe des preuves d'une véritable relation linéaire (positive ou négative). Indiquez la direction dans le contexte.
9.4
Poser un test pour une pente
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.J : Identifier la sélection appropriée d'une méthode de test pour la pente d'un modèle de régression. [Compétence 1.E]
VAR-7.J.1 Le test approprié pour la pente d'un modèle de régression est un test $t$ pour une pente.
Objectif d'apprentissage VAR-7.K : Identifier les hypothèses nulle et alternative appropriées pour la pente d'un modèle de régression. [Compétence 1.F]
VAR-7.K.1 L'hypothèse nulle pour un test $t$ pour une pente est : $H_0 : \beta = \beta_0$, où $\beta_0$ est la valeur hypothétique de l'hypothèse nulle. L'hypothèse alternative est $H_0 : \beta < \beta_0$ ou $H_0 : \beta > \beta_0$, ou $H_0 : \beta \neq \beta_0$.
Objectif d'apprentissage VAR-7.L : Vérifier les conditions pour le test de signification pour la pente d'un modèle de régression. [Compétence 4.C]
VAR-7.L.1 Afin de faire des inférences statistiques lors du test pour la pente d'un modèle de régression, nous devons vérifier ce qui suit :
a. La relation réelle entre $x$ et $y$ est linéaire. L'analyse des résidus peut être utilisée pour vérifier la linéarité.
b. L'écart-type pour $y$, $\sigma_y$, ne varie pas avec $x$. L'analyse des résidus peut être utilisée pour vérifier des écarts-types approximativement égaux pour toutes les $x$.
c. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \le 10\% N$.
d. Pour une valeur particulière de $x$, les réponses (valeurs $y$) sont approximativement normalement distribuées. L'analyse de représentations graphiques des résidus peut être utilisée pour vérifier la normalité.
i. Si la distribution observée est asymétrique, $n$ doit être supérieur à 30.
ii. Si la taille de l'échantillon est inférieure à 30, la distribution des données de l'échantillon ne doit pas présenter d'asymétrie forte ni de valeurs aberrantes.
Source : Description du cours et de l'examen AP College Board
Le test habituel demande s'il existe une quelconque relation linéaire :
$$H_0:\beta=0 \quad(\text{no linear relationship})\qquad H_a:\beta\neq 0 \ (\text{or } <,\,>).$$
Vérifiez les conditions LINER. Il s'agit d'un test $t$ sur la pente.
Vérifiez les graphiques des résidus avant de faire confiance à un IC de pente ou un test
9.5
Effectuer un test pour une pente
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.M : Calculer une statistique de test appropriée pour la pente d'un modèle de régression. [Compétence 3.E]
VAR-7.M.1 La distribution de la pente d'un modèle de régression en supposant que toutes les conditions sont remplies et l'hypothèse nulle est vraie (distribution nulle) suit une distribution $t$.
VAR-7.M.2 Pour la régression linéaire simple, lorsque l'échantillonnage aléatoire provient d'une population dont la réponse peut être modélisée par une distribution normale pour chaque valeur de la variable explicative, la distribution d'échantillonnage de $t = \dfrac{b - \beta}{SE_b}$ suit une distribution $t$ avec des degrés de liberté égaux à $n - 2$. Lors du test de la pente dans un modèle de régression linéaire simple avec un seul paramètre, la pente, le test de la pente a $df = n - 1$.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.M : Interpréter la valeur-$p$ d'un test de signification pour la pente d'un modèle de régression. [Compétence 4.B]
DAT-3.M.1 Une interprétation de la valeur-$p$ d'un test de signification pour la pente d'un modèle de régression doit reconnaître que la valeur-$p$ est calculée en supposant que l'hypothèse nulle est vraie, c'est-à-dire en supposant que la pente réelle de la population est égale à la valeur particulière indiquée dans l'hypothèse nulle.
Objectif d'apprentissage DAT-3.N : Justifier une affirmation sur la population sur la base des résultats d'un test de signification pour la pente d'un modèle de régression. [Compétence 4.E]
DAT-3.N.1 Une décision formelle compare explicitement la valeur-$p$ au seuil de signification-$\alpha$. Si la valeur-$p$ est $\le \alpha$, alors rejeter l'hypothèse nulle, $H_0 : \beta = \beta_0$. Si la valeur-$p$ est $> \alpha$, alors ne pas rejeter l'hypothèse nulle.
DAT-3.N.2 Les résultats d'un test de signification pour la pente d'un modèle de régression peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche concernant cet échantillon.
Source : Description du cours et de l'examen AP College Board
La statistique de pente $t$ :
$$t=\frac{b-0}{SE_b},\qquad df=n-2.$$
Les deux $b$ et $SE_b$ proviennent directement de la sortie de régression. Trouvez la valeur $p$ à partir de la distribution $t$, comparez-la à $\alpha$, et concluez dans le contexte – preuve (ou non) d'une relation linéaire entre les deux variables.
Surveillez les queues. La sortie de régression affiche toujours la valeur à deux queues$p$ (pour $H_a:\beta\neq 0$). Si votre $H_a$ est à une queue, divisez-la par deux – mais vérifiez d'abord que la pente de l'échantillon pointe réellement dans la direction que prétend $H_a$ ; si elle pointe dans l'autre sens, la valeur $p$ à une queue est supérieure à $0.5$ et vous ne pouvez pas rejeter $H_0$.
Exemple résolu. Pour la même sortie ($b=2.5$, $SE_b=0.8$, $n=20$), testez $H_0:\beta=0$ :
$$t=\frac{2.5-0}{0.8}=3.13,\qquad df=18,$$
une petite valeur $p$ ($<0.01$), donc rejetez $H_0$ – preuve convaincante d'une relation linéaire. Cela correspond à l'intervalle, qui excluait $0$.
9.6
Sélectionner la bonne procédure
Programme
Ce sujet vise à se concentrer sur la compétence consistant à sélectionner une procédure d'inférence appropriée maintenant que les étudiants disposent d'un éventail d'options. Les étudiants doivent avoir l'occasion de pratiquer quand et comment appliquer tous les objectifs d'apprentissage relatifs à l'inférence.
Source : Description du cours et de l'examen AP College Board
Dans toute l'inférence, identifiez : quoi est estimé ou affirmé (une proportion, une moyenne, une différence, une distribution de comptes ou une pente), combien d'échantillons, et quel type de conception (indépendante ou appariée ; échantillon ou expérience). Ensuite, nommez la procédure, vérifiez ses conditions, effectuez-la, communiquez la conclusion avec la statistique, la valeur $p$ ou l'intervalle, et une réponse en langage simple dans le contexte. Cette compétence de sélection et de communication est ce que la question de tâche d'enquête récompense le plus.
9.6
Conseils d'examen
L'inférence pour une pente teste si la vraie pente est $0$ (aucune relation linéaire).
Si l'intervalle de confiance d'une pente inclut 0, vous ne pouvez pas conclure à une réelle relation linéaire – les variables peuvent toujours être liées de manière courbe.
Lisez la pente, l'erreur standard, la statistique t et la valeur p directement depuis la sortie informatique – mais la valeur p imprimée est à deux queues, divisez-la donc par deux pour une valeur $H_a$ à une queue.
Vérifiez les conditions de régression (linéarité, indépendance, résidus approximativement normaux, dispersion égale) via le graphique des résidus.
Interprétez l'intervalle et le test dans le contexte, liés à la vraie pente.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.