| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension de la nécessité des types définis par l'utilisateur | |
| Définir et utiliser des types non composites | Y compris énuméré, pointeur |
| Définir et utiliser des types de données composites | Y compris ensemble, enregistrement et classe/objet |
| Choisir et concevoir un type de données défini par l'utilisateur approprié pour un problème donné |
Représentation des données
Informatique A-Level · Sujet 13
 15:16
Types de données définis par l'utilisateur
Un champ chaîne simple stockera volontiers des nonsens. Demandez un type de véhicule, et quelqu'un tape Bananes — le programme l'accepte sans murmurer. Mais si vous…
Narration en anglais · Sous-titres anglais + 中文 incrustés
13.1
Types de données définis par l'utilisateur

Programme
Source : Programme Cambridge International
Les types intégrés (INTEGER, REAL, STRING, CHAR, BOOLEAN) couvrent les cas les plus simples. Pour des problèmes plus complexes, vous pouvez définir des types de données définis par l'utilisateur 用户定义类型, rendant le code plus clair et le compilateur plus strict.
Pourquoi ils sont nécessaires
Un type intégré STRING permet de stocker des nonsens dans un champ qui devrait contenir l'une de quelques valeurs légales ; un type défini par l'utilisateur peut le restreindre. Les entités réelles sont généralement une collection de valeurs de différents types. Et DECLARE Taxi : Vehicle est plus clair (autodocumentant) que DECLARE Taxi : STRING.
"Décrire l'objectif d'un type de données défini par l'utilisateur" (deux points). Un type de données défini par le programmeur, construit à partir de types existants (intégrés), afin de représenter des données spécifiques au problème lorsque aucun type intégré ne convient. Les deux parties rapportent : défini par le programmeur et basé sur des types existants. L'examinateur accepte également « pour rendre le programme plus facile à lire et à maintenir » comme point de soutien, jamais seul.
"Expliquer ce que signifient les types de données non-composites et composites" (quatre points). Un type non-composite est défini sans référence à un autre type : il contient une valeur unique, par exemple un entier, un réel ou une valeur énumérée. Un type composite est une collection de types autres (qui peuvent eux-mêmes être composites) : il contient plusieurs valeurs sous un seul identifiant, par exemple un enregistrement, un ensemble, un tableau ou une classe. Donner un exemple avec chaque définition ; l'examen demande un seul exemple.
Types non-composites
Type énuméré
Un type énuméré 枚举类型 a des valeurs qui constituent une liste fixe de constantes nommées :
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Les noms sont des valeurs du nouveau type (stockées internement comme de petits entiers) ; vous ne pouvez attribuer aucune valeur en dehors de la liste. Utilisations : jours de la semaine, couleurs, codes de statut.
"Énoncer ce que signifie un type de données énuméré." Un type utilisateur non-composite défini en listant toutes ses valeurs possibles (dans l'ordre). Comme les valeurs sont ordonnées, elles peuvent être comparées et parcourues : avec TYPE Month = (January, February, ..., December), le test IF ThisMonth > June est légal, et les valeurs sont stockées internement comme des entiers. Le pseudocode comporte trois parties et l'examen note chacune : le mot-clé TYPE, l'identifiant avec =, et la liste entre crochets séparée par des virgules.
Exemple résolu. Écrire un pseudocode pour définir un type énuméré pour les jours où une école est ouverte (lundi à vendredi), et déclarer une variable de ce type initialisée à mercredi.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Une variable de type énuméré ne peut pas recevoir une valeur en dehors de la liste, c'est là tout l'intérêt : Today ← Saturday est une erreur de compilation, alors qu'une STRING aurait accepté "Saturdy".
Pointeur
Un pointeur 指针 contient l'adresse mémoire d'une autre variable (ou NULL pour « aucune cible »). Les pointeurs construisent des structures dynamiques (listes chaînées, arbres) et passent des références sans copier.
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
Pour déréférencer 解引用 (p^) signifie accéder à la variable vers laquelle il pointe.
"Énoncer ce que signifie un type de données pointeur." Un type non-composite dont la valeur est l'adresse mémoire (une référence) d'une variable d'un type donné. Le pseudocode déclare le type avec un accent circonflexe devant le type vers lequel il pointe, et l'examen demande exactement cette ligne :
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Les pointeurs sont ce dont sont constitués une liste chaînée dynamique ou un arbre binaire (Sujet 19) : chaque nœud contient un pointeur vers le suivant. Deux points sont souvent perdus ici : écrire le type pointeur comme s'il contenait la valeur elle-même, et oublier l'accent circonflexe lors de la lecture via le pointeur.

p^ le déréférence pour accéder aux champs du nœudTypes composites
Un type composite 复合类型 (l'un des types de données composites) regroupe plusieurs valeurs sous un même nom.


- enregistrement 记录 (Sujet 10) — des champs de types différents dans un bloc
TYPE ... ENDTYPE. - ensemble 集合 — une collection non ordonnée de valeurs uniques, avec des opérations add, remove, test d'appartenance, union, intersection :
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- classe 类 / objet 对象 — le type composite POO, combinant des champs de données (attributs 属性) avec des opérations dessus (méthodes 方法). Un objet est une instance d'une classe :
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Choisir un type
Utiliser énuméré pour une valeur issue d'une liste fixe, pointeur pour l'indirection, enregistrement pour un groupe de champs, ensemble pour une collection non ordonnée et unique, et classe lorsque vous avez besoin d'état et de comportement ensemble.
"Décrire le type de données défini par l'utilisateur ensemble" (trois points). Un type composite qui contient une collection de valeurs du même type, sans ordre particulier et sans doublons ; les valeurs peuvent être ajoutées et supprimées, et on peut tester l'appartenance d'une valeur. Déclarer le type avec SET OF, puis définir une constante d'ensemble avec ses valeurs entre crochets :
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"Décrire le type de données défini par l'utilisateur enregistrement" (trois points). Un type composite composé d'un nombre fixe de champs (éléments), chacun ayant son propre identifiant et son propre type, référencé sous un seul identifiant ; les champs sont accédés avec la notation point.
Exemple résolu. Écrire un pseudocode pour déclarer un type d'enregistrement ClubMember pour le prénom, le nom de famille, le code d'adhésion (un entier), la date d'adhésion et si les cotisations ont été payées d'un membre d'un club ; puis déclarer une variable et définir deux de ses champs.
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
Chaque champ nécessite sa propre ligne DECLARE avec un type approprié, le bloc se termine par ENDTYPE, et un champ 字段 est atteint comme variable.field. On demande de choisir un type pour chaque champ, de l'associer aux données : un code qui n'est jamais comparé qu'à d'autres est un STRING s'il peut contenir des lettres, un INTEGER si des opérations arithmétiques ou de tri sont nécessaires ; un oui/non est BOOLEAN ; une date est DATE. Un champ qui peut prendre l'une de quelques valeurs nommées (espèce d'un animal de compagnie, couleur) est celui pour lequel il faut créer un type énuméré.

Enregistrements dans les tableaux et les fichiers. Une table de nombreux membres est DECLARE Members : ARRAY[1:100] OF ClubMember ; alors Members[3].LastName est un champ d'un élément, et une boucle sur l'index traite chaque enregistrement. Un enregistrement est aussi l'unité naturelle écrite et lue depuis un fichier (ci-dessous), un enregistrement par PUTRECORD ou WRITEFILE.
Exemple résolu. Un type composite Pet stocke le nom (chaîne), l'espèce (l'un de dog, cat, rabbit ou hamster) et le poids en kilogrammes (réel) de chaque animal de compagnie. Définir les types et déclarer une variable.
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
Le type énuméré est défini en premier, car l'enregistrement l'utilise : l'ordre compte en pseudocode comme dans un compilateur.
Classes en pseudocode. Une classe est le type composite qui porte également du comportement. L'examen demande la déclaration avec ses attributs marqués PRIVATE, un constructeur 构造函数 nommé NEW qui les initialise, et PUBLIC méthodes pour obtenir ou modifier ces attributs :
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
Les attributs sont privés afin qu'ils ne puissent être modifiés que via des méthodes (encapsulation, Sujet 20) ; le constructeur est une procédure appelée NEW avec un paramètre par attribut ; un getter est une fonction qui retourne l'attribut. Chacun de ceux-ci rapporte une marque distincte.
Explorer
Laboratoire de concepts de programmation
Reliez les exemples au concept de programmation qu'ils illustrent.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | 用户定义类型 | yòng hù dìng yì lèi xíng |
| field/fiːld/ | 字段 | zì duàn |
| record/ˈrekɔːd/ | 记录 | jì lù |
| set/set/ | 集合 | jí hé |
| class/klæs/ | 类 | lèi |
| composite type/ˈkɒmpəzɪt taɪp/ | 复合类型 | fù hé lèi xíng |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | 枚举类型 | méi jǔ lèi xíng |
| pointer/ˈpɔɪntə/ | 指针 | zhǐ zhēn |
| linked list/lɪŋkt lɪst/ | 链表 | liàn biǎo |
| dereference/ˌdiːˈrefrəns/ | 解引用 | jiě yǐn yòng |
| object/ˈɒbdʒekt/ | 对象 | duì xiàng |
| attributes/ˈætrɪbjuːts/ | 属性 | shǔ xìng |
| methods/ˈmeθədz/ | 方法 | fāng fǎ |
| constructor/kənˈstrʌktə/ | 构造函数 | gòu zào hán shù |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | 文件组织 | wén jiàn zǔ zhī |
13.2
Organisation et accès aux fichiers

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension des méthodes d'organisation de fichiers et sélectionner une méthode appropriée d'organisation de fichiers et d'accès aux fichiers pour un problème donné | Y compris sérieux, séquentiel (en utilisant un champ clé), aléatoire (en utilisant une clé d'enregistrement) |
| Montrer la compréhension des méthodes d'accès aux fichiers | Incluant l'accès séquentiel pour les fichiers serials et séquentiels, l'accès direct pour les fichiers séquentiels et aléatoires |
| Montrer la compréhension des algorithmes de hachage | Décrire et utiliser différents algorithmes de hachage pour lire et écrire des données dans un fichier séquentiel ou aléatoire |
Source : Programme Cambridge International
L'organisation des fichiers 文件组织 est la manière dont les données sont disposées ; l'accès aux fichiers est la manière dont le programme accède à un enregistrement.
- fichier sériel 串行文件 — les enregistrements dans l'ordre d'ajout, sans tri. L'accès est séquentiel uniquement ; l'ajout en fin de fichier est rapide ; la recherche est lente. Utilisé pour les journaux et les traces d'audit.
- fichier séquentiel 顺序文件 — les enregistrements triés par une clé. La recherche est plus rapide (on peut s'arrêter tôt ou faire une recherche binaire) ; l'insertion est lente (les enregistrements doivent être déplacés). Utilisé pour les fichiers maîtres mis à jour par lots.
- fichier aléatoire 随机文件 (fichier à accès direct) — les enregistrements à des positions calculées à partir de la clé (souvent par hachage). L'accès direct par clé est très rapide ; la lecture dans l'ordre des clés est plus difficile. Utilisé pour les grandes tables de recherche et les comptes clients.


Les deux méthodes d'accès sont l'accès séquentiel 顺序存取 (lecture du début à la fin) et l'accès direct 直接存取 (saut directement vers une position connue). Associer la structure à l'opération dominante : les recherches par clé unique favorisent l'accès aléatoire ; les rapports dans l'ordre favorisent l'accès séquentiel.
Décrire chaque organisation (la formulation qui rapporte des points). Sériel : les enregistrements sont stockés les uns après les autres dans l'ordre auquel ils ont été ajoutés, sans classement par clé. Séquentiel : les enregistrements sont stockés dans l'ordre d'un champ clé (triés). Aléatoire : chaque enregistrement est stocké à une adresse calculée à partir de sa clé par un algorithme de hachage, donc les enregistrements ne sont dans aucun ordre. Comparer sériel et séquentiel : les deux stockent les enregistrements les uns après les autres et les deux sont lus séquentiellement, mais un fichier séquentiel est trié par clé, donc une recherche peut s'arrêter dès qu'une clé supérieure à la cible est lue, et un nouvel enregistrement doit être inséré à sa position correcte (généralement en réécrivant le fichier), tandis qu'un fichier sériel est simplement ajouté en fin de fichier.
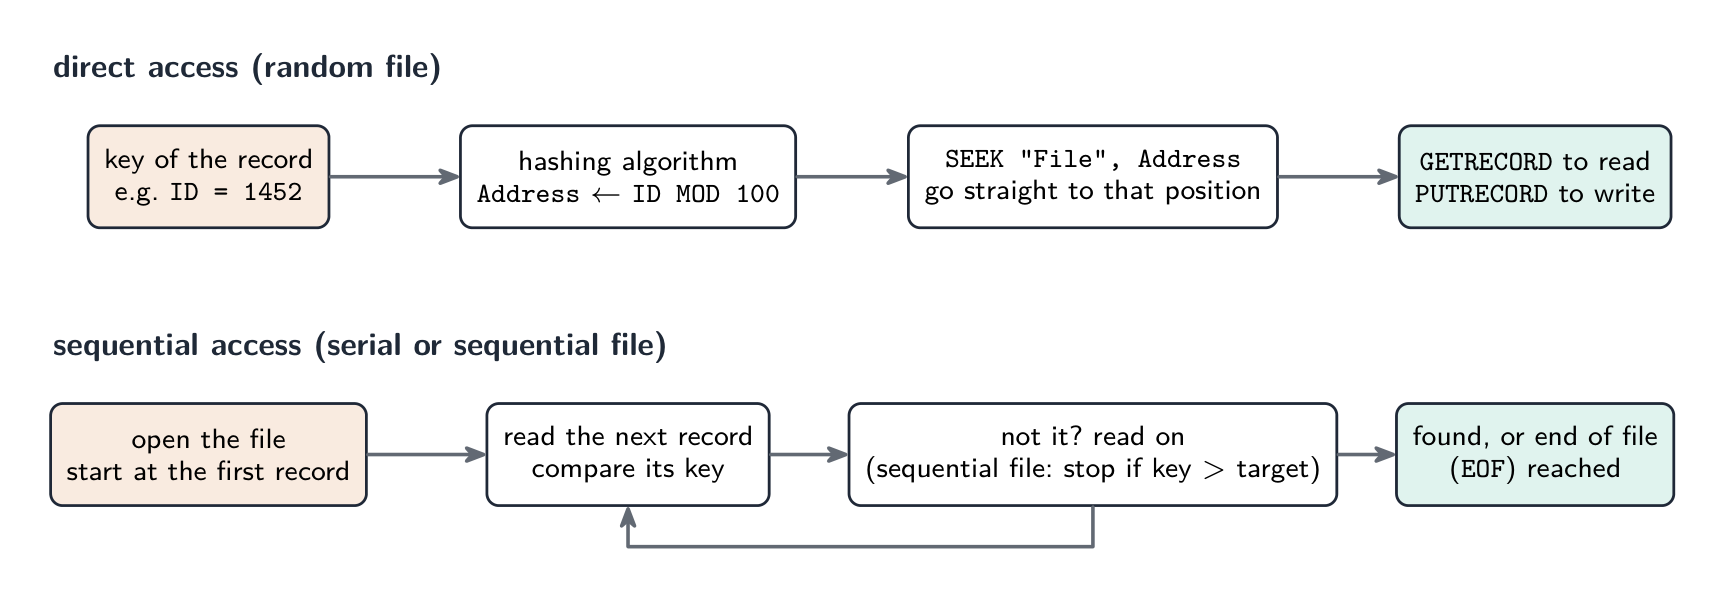
Décrire chaque méthode d'accès. Accès séquentiel : commencer au début du fichier et lire les enregistrements un après l'autre (dans l'ordre de stockage) jusqu'à ce que l'enregistrement requis soit trouvé ou la fin du fichier atteinte. Appliqué à un fichier série, cela signifie lire tous les enregistrements jusqu'à la correspondance, et parcourir tout le fichier pour établir qu'un enregistrement est absent ; appliqué à un fichier séquentiel, la recherche peut s'arrêter plus tôt, dès qu'une clé supérieure à celle de la cible est lue. Accès direct : l'adresse de l'enregistrement est calculée à partir de sa clé (par un algorithme de hachage, ou depuis un index), et le programme va directement à cette position sans lire les enregistrements qui précèdent ; c'est la méthode d'accès pour les fichiers aléatoires, et pour un enregistrement référencé par une adresse unique sur un disque.
Choix. Un fichier maître de paie ou de facturation d'utilités traité par lot, en lisant chaque enregistrement tour à tour, convient à un fichier séquentiel ; un journal de transactions dans l'ordre de leur survenue convient à un fichier série ; un fichier de stock ou de clients où des enregistrements uniques sont recherchés et mis à jour par clé pendant l'exécution du programme convient à un fichier aléatoire avec accès direct.
Gestion des fichiers en pseudocode. L'examen attend les instructions standards, et Paper 3 définit des algorithmes qui les utilisent :
| Tâche | Instructions |
|---|---|
| ouvrir un fichier texte | OPENFILE "Scores.txt" FOR READ (ou FOR WRITE, qui crée ou écrase, ou FOR APPEND) |
| lire ou écrire une ligne | READFILE "Scores.txt", Line et WRITEFILE "Scores.txt", Line |
| tester la fin | WHILE NOT EOF("Scores.txt") |
| fermer | CLOSEFILE "Scores.txt" |
| ouvrir un fichier aléatoire | OPENFILE "Stock.dat" FOR RANDOM |
| se déplacer vers une position d'enregistrement | SEEK "Stock.dat", Address |
| lire ou écrire un enregistrement entier | GETRECORD "Stock.dat", Item et PUTRECORD "Stock.dat", Item |
Exemple résolu. Un fichier aléatoire Stock.dat contient des enregistrements de type StockItem, stockés à l'adresse donnée par ItemID MOD 100. Écrire un pseudocode qui stocke un nouvel élément à son adresse hachée si cette position est vide, en signalant la position si elle est déjà occupée.
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
Deux détails que le barème vérifie : SEEK avant chaque GETRECORD ou PUTRECORD (la lecture déplace la position, donc rechercher à nouveau avant d’écrire), et le fichier ouvert FOR RANDOM et fermé à la fin. Pour copier chaque enregistrement d’un fichier aléatoire vers un autre, boucler sur les adresses avec SEEK, GETRECORD depuis un fichier et PUTRECORD vers l’autre, en sautant les positions vides.
Explorer
Voie d'accès au fichier
Suivre un fichier depuis le stockage jusqu'au programme et retour en toute sécurité.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| serial file/ˈsɪərɪəl faɪl/ | 串行文件 | chuàn xíng wén jiàn |
| sequential file/siːˈkwenʃl faɪl/ | 顺序文件 | shùn xù wén jiàn |
| random file/ˈrændəm faɪl/ | 随机文件 | suí jī wén jiàn |
| direct access/daɪˈrekt ˈækses/ | 直接存取 | zhí jiē cún qǔ |
| hash function/hæʃ ˈfʌŋkʃn/ | 散列函数 | sàn liè hán shù |
| sequential access/siːˈkwenʃl ˈækses/ | 顺序存取 | shùn xù cún qǔ |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 确定性 | què dìng xìng |
13.2
Hachage

Une fonction de hachage 散列函数 (un algorithme de hachage) prend une clé d'enregistrement et produit une adresse où l'enregistrement est stocké. Une bonne fonction est rapide, déterministe 确定性, et répartit uniformément les clés.
Algorithmes de hachage courants pour les emplacements $N$ : hachage modulo address ← key MOD N ; pliage (diviser la clé, ajouter les morceaux, MOD N) ; hachage de chaîne (sommer les codes caractères, MOD N).
Une collision 冲突 est lorsque deux clés hachent vers la même adresse. Trois façons de la résoudre :
| Stratégie | Fonctionnement | Compromis |
|---|---|---|
| probing linéaire 线性探测 | utiliser la case libre suivante (avec retournement) | simple, mais les clés font des amas |
| chaînage 链接法 | chaque case pointe vers une liste chaînée 链表 d'enregistrements | pas d'amas, mais plus de mémoire |
| re-hachage | appliquer une deuxième fonction de hachage | répartit les clés, mais demande plus de travail |
Pour rechercher : hacher la clé, lire cette case ; si les clés correspondent, c'est fini, sinon suivre la stratégie de résolution jusqu'à une correspondance ou une case vide. Pour insérer : hacher la clé, écrire dans cette case ou la prochaine case libre. Garder le facteur de charge 装填因子 (enregistrements ÷ cases) inférieur à environ 70% pour des recherches quasi-O(1).
"Expliquer ce qu'on entend par algorithme de hachage dans le contexte de l'accès aux fichiers" (trois points). Un calcul (fonction) effectué sur le champ clé d'un enregistrement qui produit une valeur, utilisée comme adresse (emplacement) de stockage de l'enregistrement dans le fichier et à partir de laquelle il est récupéré. Le même calcul sur la même clé donne toujours la même adresse, c'est pourquoi l'enregistrement peut être retrouvé sans recherche.
"Esquisser deux méthodes pour contourner une collision." (1) Probing linéaire (adressage ouvert) : stocker l'enregistrement dans l'emplacement libre suivant après l'adresse calculée, en tournant vers le début si nécessaire ; pour récupérer, commencer à l'adresse hachée et lire vers l'avant jusqu'à la correspondance de la clé. (2) Une zone de débordement 溢出区 ou chaînage : stocker l'enregistrement en collision dans une zone de débordement séparée (ou une liste chaînée attachée à l'adresse), qui est parcourue séquentiellement après échec de la correspondance à l'adresse principale. Soit marque ; décrire la récupération ainsi que le stockage.
Exemple résolu. Un fichier aléatoire a 11 positions d'enregistrement, numérotées de 0 à 10, et l'algorithme de hachage est Address ← Key MOD 11. Les enregistrements avec les clés 1250, 1381, 1452, 1613 et 1470 sont stockés dans cet ordre, utilisant le probing linéaire. Montrer où chaque enregistrement va, et décrire comment la clé 1470 est récupérée.
$1250 \bmod 11 = 7$ ; $1381 \bmod 11 = 6$ ; $1452 \bmod 11 = 0$ ; $1613 \bmod 11 = 7$, une collision avec 1250, donc 1613 prend la prochaine position libre, 8 ; $1470 \bmod 11 = 7$ à nouveau, et les positions 7 et 8 sont pleines, donc 1470 va à 9. Pour récupérer 1470 : calculer $7$, lire la position 7 (clé 1250, pas de correspondance), lire 8 (1613, non), lire 9 (1470, trouvé). Si une position vide est atteinte avant une correspondance, l’enregistrement n’est pas dans le fichier. Les collisions sont le prix d’un petit fichier : un bon algorithme de hachage répartit uniformément les clés, et le fichier reste bien en dessous de sa capacité maximale afin que les sondages restent courts.
Explorer
Une table de hachage
Observez chaque clé être hachée vers un seau (seau). Un bon hachage répartit les clés pour que les recherches restent rapides.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| collision/kəˈlɪʒn/ | 冲突 | chōng tū |
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | 线性探测 | xiàn xìng tàn cè |
| chaining/ˈtʃeɪnɪŋ/ | 链接法 | liàn jiē fǎ |
| load factor/ləʊd ˈfæktə/ | 装填因子 | zhuāng tián yīn zi |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | 溢出区 | yì chū qū |
| overflow/ˌəʊvəˈfləʊ/ | 溢出 | yì chū |
13.3
Nombres à virgule flottante

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Décrire le format des nombres réels à virgule flottante binaires | Utiliser la forme en complément à deux Comprendre les effets du changement de l'allocation de bits entre la mantisse et l'exposant dans une représentation à virgule flottante |
| Convertir les nombres réels à virgule flottante binaires en décimaux et vice versa | |
| Normaliser les nombres à virgule flottante | Comprendre les raisons de la normalisation |
| Montrer la compréhension des conséquences du fait qu'une représentation binaire n'est qu'une approximation du nombre réel qu'elle représente (dans certains cas) | Comprendre comment l'underflow et l'overflow peuvent se produire |
| Montrer la compréhension que les représentations binaires peuvent entraîner des erreurs d'arrondi |
Source : Programme Cambridge International
Pour stocker des nombres réels de tailles très différentes, les ordinateurs utilisent un format à virgule flottante 浮点 — une forme binaire de notation scientifique, avec deux champs :
- une mantisse 尾数 — les chiffres significatifs.
- non exposant 指数 — la puissance de 2 à multiplier par.
Les deux sont stockés comme des entiers en complément à deux 补码. La valeur est
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$
Lire la mantisse comme une fraction binaire — le premier bit après la virgule vaut $1/2$, le suivant $1/4$, puis $1/8$, etc. Donc 0.1010000 est $1/2 + 1/8 = 0.625$ ; avec exposant 00000010 (= 2), la valeur est $0.625 \times 2^{2} = 2.5$.
Conversion
- binaire → décimal : lire la mantisse (utiliser les règles du complément à deux si négative) comme fraction, lire l'exposant comme entier signé, puis multiplier la mantisse par $2^{\text{exponent}}$.
- décimal → binaire : écrire le nombre comme fraction binaire × puissance de 2, puis stocker la mantisse et l'exposant dans les formats convenus.
Exemple résolu. Un nombre a une mantisse 10110000 et un exposant 00000011. Trouver sa valeur décimale.
L'exposant 00000011 est $+3$. La mantisse commence par un 1, donc elle est négative. Lue comme 1.0110000 en complément à deux, le bit de signe vaut $-1$ et les bits de fraction ajoutent $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, donc la mantisse est $-1 + 0.375 = -0.625$. Puis
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
Exemple résolu. Stocker $+2.5$ dans ce format.
En binaire $2.5 = 10.1$. Écrit comme fraction normalisée, $2.5 = 0.101 \times 2^{2}$. Donc la mantisse est 01010000 (bit de signe 0, ensuite .101) et l'exposant est 00000010 ($= 2$).
Format de l'examen : complément à deux, une mantisse et un exposant
L'examen indique un format tel que 10 bits pour la mantisse et 6 bits pour l'exposant, tous deux en complément à deux. Le point binaire de la mantisse se situe après son premier bit (signe), donc une mantisse positive est 0.xxxxxxxxx et une négative 1.xxxxxxxxx ; l'exposant est un entier signé ordinaire. Toute conversion utilise les mêmes trois étapes : lire la mantisse comme fraction (règles du complément à deux si elle commence par 1), lire l'exposant comme entier, multiplier par $2^{\text{exponent}}$.
Exemple résolu (binaire vers décimal). Mantisse 0101100000, exposant 000011.
Mantisse : $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Exposant : $000011_2 = 3$. Valeur : $0.6875 \times 2^{3} = 5.5$.
Exemple résolu (mantisse négative). Mantisse 1011000000, exposant 000010.
La mantisse commence par 1, donc elle est négative. Sa valeur est $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$ ; exposant $= 2$ ; valeur $-0.625 \times 4 = -2.5$. (Alternativement, prendre le complément à deux de la mantisse, 0101000000 $= 0.625$, et ajouter le signe moins.) Un exposant négatif tel que 111110 $= -2$ divise plutôt : une mantisse de $0.5$ avec cet exposant est $0.5 \times 2^{-2} = 0.125$.
Exemple résolu (décimal vers binaire). Stocker $+6.5$ et $-6.5$ dans le format 10 bits et 6 bits, normalisés.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, donc la mantisse est 0110100000 et l'exposant 000011. Pour $-6.5$, prendre le complément à deux de la mantisse : 1001100000 (vérification : $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, et $-0.8125 \times 8 = -6.5$), exposant 000011 inchangé. Le signe ne va jamais dans l'exposant ; un nombre négatif a une mantisse négative.
Normalisation
Un nombre est normalisé 规格化 lorsque le premier bit significatif est immédiatement après la virgule binaire (pas de zéros de tête gaspillés). Cela maximise la précision, car chaque bit de la mantisse porte une information. Pour normaliser, décaler la mantisse vers la gauche et diminuer l'exposant (ou décaler vers la droite et l'augmenter) jusqu'à ce que le premier bit significatif soit en place ; la valeur reste inchangée. Pour les mantisses négatives (complément à deux), le bit de signe (1) est immédiatement suivi d'un 0.
Reconnaître et produire la forme normalisée. Une mantisse positive normalisée commence 01 ; une négative commence 10. Donc 0011000000 n'est pas normalisée (décaler vers la gauche d'une place et soustraire un à l'exposant : 0110000000, exposant un de moins) et 1100000000 non plus (décaler vers la gauche jusqu'à ce que le motif soit 10...). Chaque décalage vers la gauche de la mantisse doit être compensé par une soustraction d'un à l'exposant, sinon la valeur change.
"Expliquer pourquoi les nombres sont stockés sous forme normalisée" (deux points). (1) Elle offre la précision maximale (exactitude) pour le nombre de bits disponibles, car aucun bit n'est gaspillé sur des zéros de tête (ou des uns de tête pour un nombre négatif) ; (2) chaque nombre a alors une représentation unique, permettant de les comparer ; et (3) elle optimise l'utilisation de la plage disponible. Any two of these score.

Approximation et erreurs d'arrondi
De nombreux réels décimaux ne peuvent pas être stockés exactement en binaire — par exemple, $0.1_{10}$ est la fraction binaire répétitive $0.000110011\ldots_{2}$, qui doit être tronquée. Conséquences :
- arrondis arrondis s'accumulent sur de nombreuses opérations (
0.1 + 0.2n'est pas exactement0.3). - comparaisons échouent — ne jamais tester un réel pour l'égalité. Tester que la différence est inférieure à une petite tolérance,
IF Difference < 0.000001, où la différence est prise dans le bon sens ou via une fonction modulo que la question définirait.ABSn'est ni dans l'insert 9618 ni dans le Guide de Pseudocode, donc ne pas le supposer : le guide indique que toute fonction nécessaire par la question sera fournie. - soustraire deux valeurs quasi-égales entraîne une perte de précision.
- débordement débordement (un résultat trop grand pour la plage de l'exposant) et sous-débordement sous-débordement (un résultat trop petit, arrondi à zéro) se produisent lorsque l'exposant sort de sa plage.
Pour des besoins d'exactitude (monnaie), utiliser fixe-point fixe-point ou BCD BCD au lieu du virgule flottante.
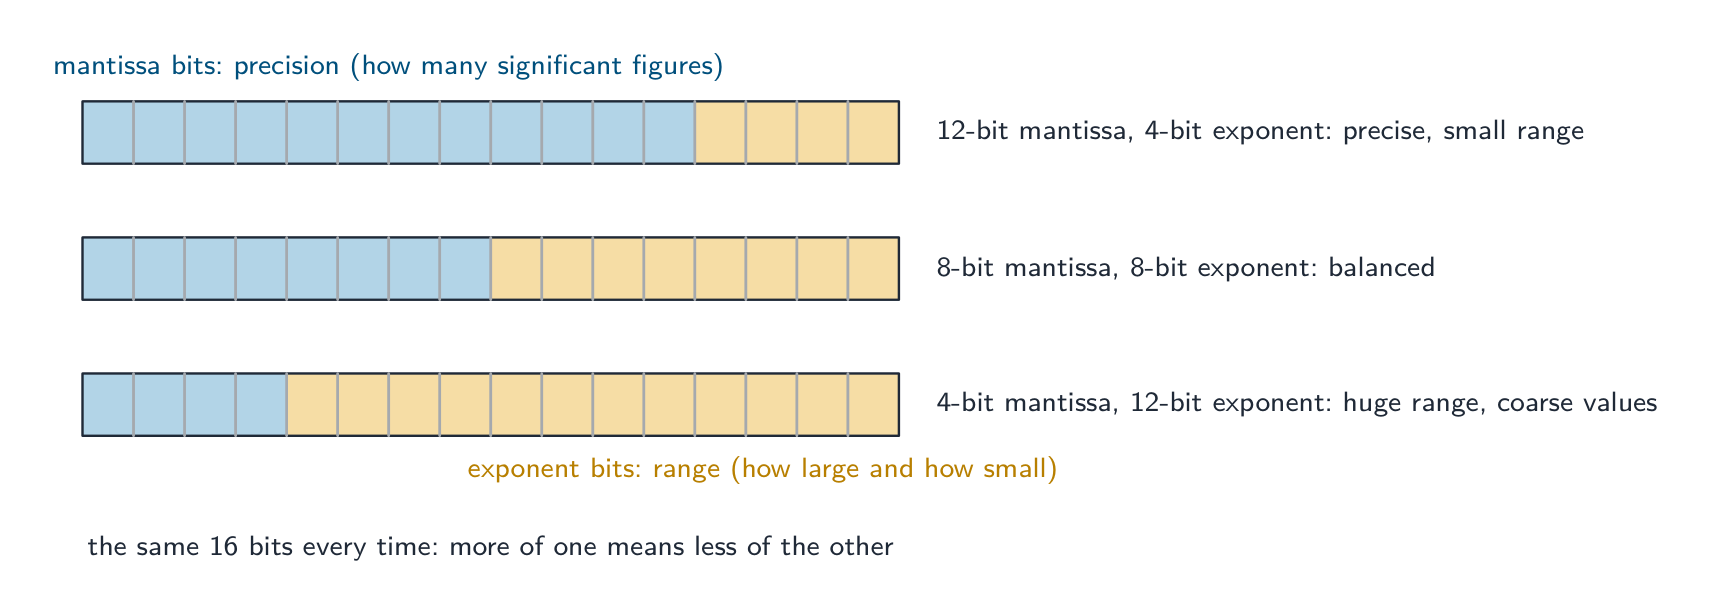
"Décrire l'effet du changement d'allocation des bits" (trois points). Avec un nombre total de bits fixe, augmenter la mantisse et réduire l'exposant donne une plus grande précision précision (plus de chiffres significatifs, erreurs d'arrondissement plus petites) mais une plus petite plage plage (les plus grandes et plus petites magnitudes stockables diminuent) ; augmenter l'exposant fait l'inverse : une plus grande plage aux dépens de la précision. Nommer les deux effets et les deux directions.
Plus grand et plus petit. Dans le format à mantisse de 10 bits et exposant de 6 bits, le nombre positif le plus grand a une mantisse 0111111111 ($= 1 - 2^{-9}$) et un exposant 011111 ($= 31$) : environ $2^{31}$. Le plus petit nombre normalisé positif a une mantisse 0100000000 ($= 0.5$) et un exposant 100000 ($= -32$) : $0.5 \times 2^{-32} = 2^{-33}$. Le nombre le plus négatif a une mantisse 1000000000 ($= -1$) et un exposant $31$ : $-2^{31}$.
"Expliquer ce que signifient débordement et sous-débordement." Un débordement se produit lorsque le résultat d'un calcul est plus grand que le plus grand nombre représentable, donc l'exposant aurait besoin de plus de bits qu'il n'en a ; un sous-débordement se produit lorsqu'un résultat est plus petit que le plus petit (non-zéro) nombre représentable, trop proche de zéro pour que l'exposant l'exprime, donc il est stocké comme zéro. Les deux proviennent de la plage de l'exposant, pas de celle de la mantisse.
Pourquoi une représentation binaire n'est qu'une approximation. Une fraction binaire ne peut représenter exactement que des sommes de $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ ; une valeur telle que $0.1$ ou $\tfrac{1}{3}$ a un développement binaire infini, et la mantisse a un nombre fixe de bits, donc la valeur stockée est la plus proche qui s'y adapte. La différence est une erreur d'arrondi ; elle est petite pour un seul nombre mais s'accumule lors de calculs répétés (ajouter $0.1$ dix fois peut ne pas donner exactement $1$), c'est pourquoi les nombres réels ne devraient jamais être testés pour une égalité exacte.
Explorer
Construire un nombre en virgule flottante
Inverser les bits de la mantisse et de l'exposant pour former une valeur, et vérifier si elle est normalisée.
Explorer
Normalisation d'un nombre en virgule flottante
Effectuer la normalisation. Décaler la mantisse pour éliminer les zéros non significatifs initiaux — et ajuster l'exposant en conséquence — conserve la même valeur tout en utilisant chaque bit pour la précision.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | 浮点 | fú diǎn |
| mantissa/mænˈtɪsə/ | 尾数 | wěi shù |
| exponent/ekˈspəʊnənt/ | 指数 | zhǐ shù |
| two's complement/tuːz ˈkɒmplɪmənt/ | 补码 | bǔ mǎ |
| normalised/ˈnɔːməlaɪzd/ | 规格化 | guī gé huà |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | 舍入误差 | shě rù wù chā |
| underflow/ˌʌndəˈfləʊ/ | 下溢 | xià yì |
| fixed-point/fɪkst pɔɪnt/ | 定点 | dìng diǎn |
| BCD/ˌbiː siː ˈdiː/ | 二进码十进数 | èr jìn mǎ shí jìn shù |
| precision/prɪˈsɪʒn/ | 精度 | jīng dù |
| range/reɪndʒ/ | 范围 | fàn wéi |
13.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| type de données défini par l'utilisateur | un type de données défini par le programmeur, basé sur des types existants, pour représenter des données spécifiques au problème |
| type non-composite | un type défini sans référence à un autre type ; il contient une seule valeur (entier, réel, énuméré, pointeur) |
| type composite | un type composé d'autres types ; il contient plusieurs valeurs sous un identificateur unique (enregistrement, ensemble, tableau, classe) |
| type énuméré | un type non-composite défini en listant toutes ses valeurs possibles, dans l'ordre |
| type pointeur | un type non-composite dont la valeur est l'adresse mémoire d'une variable d'un type donné |
| ensemble | un type composite contenant une collection de valeurs d'un type, sans ordre et sans doublons |
| enregistrement | un type composite avec un nombre fixe de champs, chacun ayant son propre identificateur et son propre type, accédés par notation pointée |
| classe | un type composite combinant des attributs (données) avec les méthodes (procédures et fonctions) qui agissent dessus ; un objet est une instance d'une classe |
| fichier sériel | des enregistrements stockés les uns après les autres dans l'ordre dans lequel ils ont été ajoutés |
| fichier séquentiel | des enregistrements stockés les uns après les autres dans l'ordre d'un champ clé |
| fichier aléatoire | des enregistrements stockés à des adresses calculées à partir de leurs clés par un algorithme de hachage |
| accès séquentiel | lire les enregistrements tour à tour depuis le début du fichier jusqu'à ce que celui requis soit trouvé |
| accès direct | calculer l'adresse d'un enregistrement à partir de sa clé et aller directement à cette position |
| algorithme de hachage | un calcul effectué sur la clé d'un enregistrement qui donne l'adresse à laquelle l'enregistrement est stocké et retrouvé |
| collision | deux clés différentes produisant la même adresse |
| mantisse | la partie d'un nombre virgule flottante qui contient ses bits significatifs, sous forme de fraction en complément à deux |
| exposant | l'entier en complément à deux donnant la puissance de deux par laquelle la mantisse est multipliée |
| normalisé | un nombre virgule flottante dont la mantisse commence par 01 (positif) ou 10 (négatif), afin qu'aucun bit ne soit gaspillé sur des zéros ou uns initiaux |
| débordement | un résultat trop grand pour être représenté dans le nombre de bits disponibles |
| sous-débordement | un résultat non-nul trop petit pour être représenté, donc il est stocké comme zéro |
| erreur d'arrondi | la différence entre un nombre réel et la valeur la plus proche que la représentation binaire peut contenir |
13.3
Conseils d'examen
- Les déclarations de pseudocode sont marquées ligne par ligne :
TYPE ... = (...)pour énuméré,TYPE ... = ^...pour pointeur,TYPE ... = SET OF ...puisDEFINE ... (...) : ...pour un ensemble,TYPE ... DECLARE ... ENDTYPEpour un enregistrement,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSpour une classe. - Associer le type aux données : valeurs nommées fixes, énuméré ; un groupe de champs différents, enregistrement ; une collection de valeurs uniques, ensemble ; données plus comportement, classe ; une adresse, pointeur.
- L'organisation des fichiers concerne la manière dont les enregistrements sont stockés ; l'accès aux fichiers concerne la manière dont ils sont trouvés. Sériel et séquentiel se lisent séquentiellement ; les fichiers aléatoires utilisent l'accès direct via un hachage de la clé. La recherche séquentielle d'un fichier séquentiel peut s'arrêter tôt ; d'un fichier sériel, elle ne peut pas.
- Pseudocode fichier aléatoire :
OPENFILE ... FOR RANDOM,SEEKavant chaqueGETRECORDouPUTRECORD,CLOSEFILEà la fin. Expliquer comment une collision est résolue lorsque vous décrivez le hachage. - Virgule flottante : mantisse comme fraction en complément à deux (point après le bit de signe), exposant comme entier, multiplier par $2^{\text{exponent}}$ ; décaler vers la gauche et soustraire un à l'exposant pour normaliser ; la mantisse achète la précision, l'exposant achète la plage.
- Les trois réponses "explique" classiques : pourquoi normaliser (précision, forme unique, plage), l'effet de réallouer des bits (précision contre plage), et pourquoi $0.1$ ne peut pas être stocké exactement (une fraction binaire infinie dans une mantisse finie).
Erreurs courantes
- Écrire
DECLAREau lieu deTYPEpour un nouveau type, ou omettreENDTYPE; déclarer un ensemble sansSET OF, ou un type énuméré avec des guillemets autour de ses valeurs. - Mettre le signe d'un nombre virgule flottante dans l'exposant ; le signe est le premier bit de la mantisse.
- Lire une mantisse négative comme si elle était signe-magnitude ; c'est un complément à deux, donc
1011000000est $-0.625$, pas $-0.375$. - Déplacer la mantisse pour la normaliser sans changer l'exposant, ou le changer dans le mauvais sens (décaler vers la gauche, exposant vers le bas).
- Décrire un fichier aléatoire comme étant "dans un ordre aléatoire" ; les enregistrements sont à des adresses calculées à partir de leurs clés.
- Dire que l'accès séquentiel lit "tout le fichier" pour un fichier séquentiel ; il s'arrête lorsqu'une clé plus grande est rencontrée.
- Expliquer le hachage sans dire ce que la valeur calculée sert à (l'adresse pour stocker et récupérer l'enregistrement), ou sans moyen de gérer les collisions.
- Définir le débordement comme "trop de chiffres" au lieu d'un résultat dépassant la plus grande valeur représentable, ou en blâmer la mantisse.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.