| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension de la finalité d'un cycle de vie du développement | |
| Montrer une compréhension de la nécessité de différents cycles de vie du développement selon le programme développé | Y compris : waterfall, itératif, développement rapide d'applications (RAD) |
| Décrire les principes, avantages et inconvénients de chaque type de cycle de vie | |
| Montrer une compréhension des étapes d'analyse, de conception, de codage, de test et de maintenance dans le cycle de vie du développement de programmes |
Développement logiciel
Informatique A-Level · Sujet 12
 19:27
Le Cycle de vie du développement de logiciel
Un petit bug, s'il passe à la version finale, peut coûter une fortune à corriger — bien plus que de le repérer tôt. C'est pourquoi nous ne commençons pas simplement à taper du code. Nous suivons…
Narration en anglais · Sous-titres anglais + 中文 incrustés
12.1
Cycle de vie du développement de programme

Programme
Source : Programme Cambridge International
Un cycle de vie du développement 开发生命周期 est l'ensemble des étapes de l'idée au logiciel fini et maintenu. Il existe pour planifier, gérer et contrôler un projet — construire le bon produit, à temps, avec une bonne qualité.

Pourquoi un cycle de vie est nécessaire
La liste de l'examinateur pour "le but d'un cycle de vie du développement" : il divise un grand projet en étapes qui peuvent être planifiées et gérées ; il assure que les spécifications sont trouvées et approuvées avant le début de la conception et du codage ; il intègre les tests et la documentation plutôt que de les laisser à la fin ; il permet à l'équipe de suivre les progrès selon des jalons et de gérer les risques ; et il offre au client des points définis pour revoir le travail. Sans lui, une équipe code d'abord et découvre tardivement qu'elle a construit la mauvaise chose.
Pourquoi il y en a différents
Aucun cycle de vie unique ne convient à tous les projets, donc plusieurs cycles de vie du développement existent. Le choix dépend de la taille et de la complexité, de la clarté des spécifications 需求 au départ, du changement attendu, du niveau de risque, de l'équipe et de l'échéance.
Modèles courants
- Cascade 瀑布模型 — séquence linéaire (Analyse → Conception → Codage → Tests → Maintenance), chaque étape terminée avant la suivante. Clair et bien documenté ; bon pour des spécifications stables, mais faible face aux changements en cours de projet, et le client ne voit rien fonctionner jusqu'à la fin.
- Modèle itératif 迭代模型 — passes répétées, chacune produisant une version partielle qui est revue et affinée. Repère les problèmes plus tôt ; bon quand les spécifications sont découvertes au fil du temps, mais plus difficile à estimer.
- Développement rapide d'applications 快速应用开发 (RAD) — forte utilisation d'un prototype 原型 et des retours utilisateurs. Livraison très rapide de la première version ; bon pour des spécifications changeantes, mais dépend de la disponibilité des utilisateurs et convient mieux aux petits systèmes.
- Agile 敏捷 — itérations courtes ("sprints"), collaboration et tests constants. Flexible et adaptatif, mais nécessite un client engagé et une équipe compétente.


Principes, avantages et inconvénients — tel que listé par le barème.
| Modèle | Principe | Avantages | Inconvénients |
|---|---|---|---|
| Cascade | les étapes s'exécutent dans un ordre fixe, chacune terminée et validée avant que la suivante ne commence ; revenir signifie redémarrer la séquence | simple à gérer ; chaque étape est entièrement documentée ; les spécifications sont fixées tôt, donc coûts et délais peuvent être estimés | inflexible une fois une étape terminée ; aucun logiciel fonctionnel jusqu'à la fin ; une erreur d'analyse est coûteuse à corriger plus tard ; le client ne peut pas voir les progrès |
| Itératif | une petite version fonctionnelle est construite d'abord, puis améliorée répétitivement par des versions successives jusqu'à la complétion | logiciel fonctionnel tôt et souvent ; problèmes repérés dans les premières versions ; les retours du client façonnent chaque version ; les spécifications peuvent changer | difficile d'estimer le temps et le coût totaux ; les tests répétés exigent des efforts ; nécessite la disponibilité du client ; peut dériver si les versions ne sont pas planifiées |
| RAD | des prototypes de parties du système sont construits rapidement et affinés avec l'utilisateur jusqu'à acceptation, souvent en parallèle par plusieurs équipes | livraison très rapide d'une première version ; l'utilisateur est impliqué tout au long, donc le produit correspond à ses besoins ; les changements sont faciles à absorber | nécessite des développeurs compétents et des utilisateurs engagés ; la documentation est faible ; moins adapté aux grands systèmes ou critiques pour la sécurité |
Exemple résolu. Une entreprise doit être la première à lancer un site web pour une nouvelle console de jeux, et la conception changera au fur et à mesure que les caractéristiques de la console seront annoncées. Nommez le cycle de vie le plus adapté et justifiez-le.
RAD. Un prototype du site peut être construit et montré aux utilisateurs en quelques jours, et affiné alors que les spécifications changent ; le site est assez petit pour une approche pilotée par prototype, et la rapidité de livraison est l'exigence principale. La Cascade fixerait les spécifications avant qu'une seule page ne soit construite et ne livrerait rien jusqu'à la fin.
Les étapes standards
Chaque étape a un but, une sortie et des activités typiques — une question "décrire la … étape" demande deux ou trois de ces éléments.
- analyse — découvrir quoi le programme doit faire. Activités : entretiens, questionnaires et observation du système actuel ; étude de faisabilité ; accord sur la spécification des exigences, contre laquelle chaque étape ultérieure est vérifiée.
- conception — décider comment il le fera. Sorties : la carte structurelle (modules et paramètres), organigrammes ou pseudocode pour chaque module, tables d'identificateurs et structures de données, mises en page des écrans et fichiers, et le plan de test écrit maintenant, à partir de la spécification, avant tout code existant.
- codage (implémentation 实现) — écrire le programme dans un langage de haut niveau, module par module, en suivant la conception ; chaque module est testé au fur et à mesure qu'il est écrit.
- tests — exécuter le programme selon le plan de test (données normales, anormales, extrêmes et limites) et corriger les erreurs trouvées ; les tests d'intégration, alpha, bêta et d'acceptation suivent.
- maintenance 维护 — après la mise en production, corriger les défauts, adapter le programme à un nouveau matériel, logiciel ou loi, et l'améliorer (voir ci-dessous).
Exemple résolu. Complétez le diagramme en cascade Analyse → ? → ? → ? → Maintenance et décrivez ce qui se passe à l'étape de conception.
Les étapes manquantes sont Conception, Codage, Tests. À l'étape de conception, les exigences sont transformées en plan pour le programme : le problème est décomposé en modules (une carte structurelle), l'algorithme de chaque module est écrit sous forme de pseudocode ou d'organigramme, les structures de données et identificateurs sont choisis, les écrans et fichiers sont mis en page, et le plan de test est écrit à partir de la spécification.
Explorer
Le cycle de développement logiciel
Parcourez les étapes que chaque projet traverse. Obtenir les bonnes exigences en analyse est primordial — une erreur détectée en test est beaucoup plus coûteuse à corriger qu'une erreur détectée tôt.
Explorer
Laboratoire de processus logiciel
Classez les exemples de développement par étape ou outil auquel ils appartiennent.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| development life cycle/dɪˈveləpmənt laɪf ˈsaɪkl/ | 开发生命周期 | kāi fā shēng mìng zhōu qī |
| requirements/rɪˈkwaɪəmənts/ | 需求 | xū qiú |
| waterfall/ˈwɔːtəfɔːl/ | 瀑布模型 | pù bù mó xíng |
| maintenance/ˈmeɪntənəns/ | 维护 | wéi hù |
| iterative model/ˈɪtərətɪv ˈmɒdl/ | 迭代模型 | dié dài mó xíng |
| Rapid Application Development/ˈræpɪd ˌæplɪˈkeɪʃn dɪˈveləpmənt/ | 快速应用开发 | kuài sù yìng yòng kāi fā |
| prototype/ˈprəʊtəʊtaɪp/ | 原型 | yuán xíng |
| Agile/ˈædʒaɪl/ | 敏捷 | mǐn jié |
12.2
Outils de conception de programme

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Utiliser un organigramme fonctionnel pour décomposer un problème en sous-tâches et exprimer les paramètres passés entre les divers modules/procédures/fonctions qui font partie de la conception de l'algorithme | Décrire la finalité d'un organigramme fonctionnel Construire un organigramme fonctionnel pour un problème donné Dériver du pseudocode équivalent à partir d'un organigramme fonctionnel |
| Montrer une compréhension de la finalité des diagrammes de transition d'état pour documenter un algorithme |
Source : Programme Cambridge International
Carte structurelle
Une carte structurelle 结构图 montre la décomposition hiérarchique 分解 d'un programme en modules (sous-routines 子程序) et les paramètres 参数 passés entre eux. Chaque module est un rectangle ; des lignes relient l'appelant (en haut) au appelé (en bas) ; de petites flèches montrent les données descendant et les résultats remontant. La conception peut ensuite être transformée en pseudocode 伪代码 équivalent.
                CalculatePay
            /        |         \
       GetEmployee  CalculateBonus  CalculateTax
       Returns:     Takes: sales    Takes: gross
       employeeID   Returns: bonus  Returns: tax
C'est un outil de phase de conception, et on peut y lire les signatures des procédures.
Les symboles demandés par l'examinateur. Une boîte est un module ; une ligne relie un appelant (en haut) aux modules qu'il appelle (en bas), se lisant de gauche à droite dans l'ordre des appels. Une petite flèche avec un cercle ouvert à sa queue est un couple de données — un paramètre passé vers le bas dans un module ou une valeur retournée vers le haut ; une flèche avec un cercle plein est un couple de contrôle, un indicateur (généralement BOOLEAN) qui informe l'appelant de ce qui s'est produit. Un losange à une branche signifie une sélection : seul un des modules situés en dessous est appelé, selon une condition. Une flèche courbe balayant les liens signifie une itération : les modules situés en dessous sont appelés répétitivement dans une boucle.
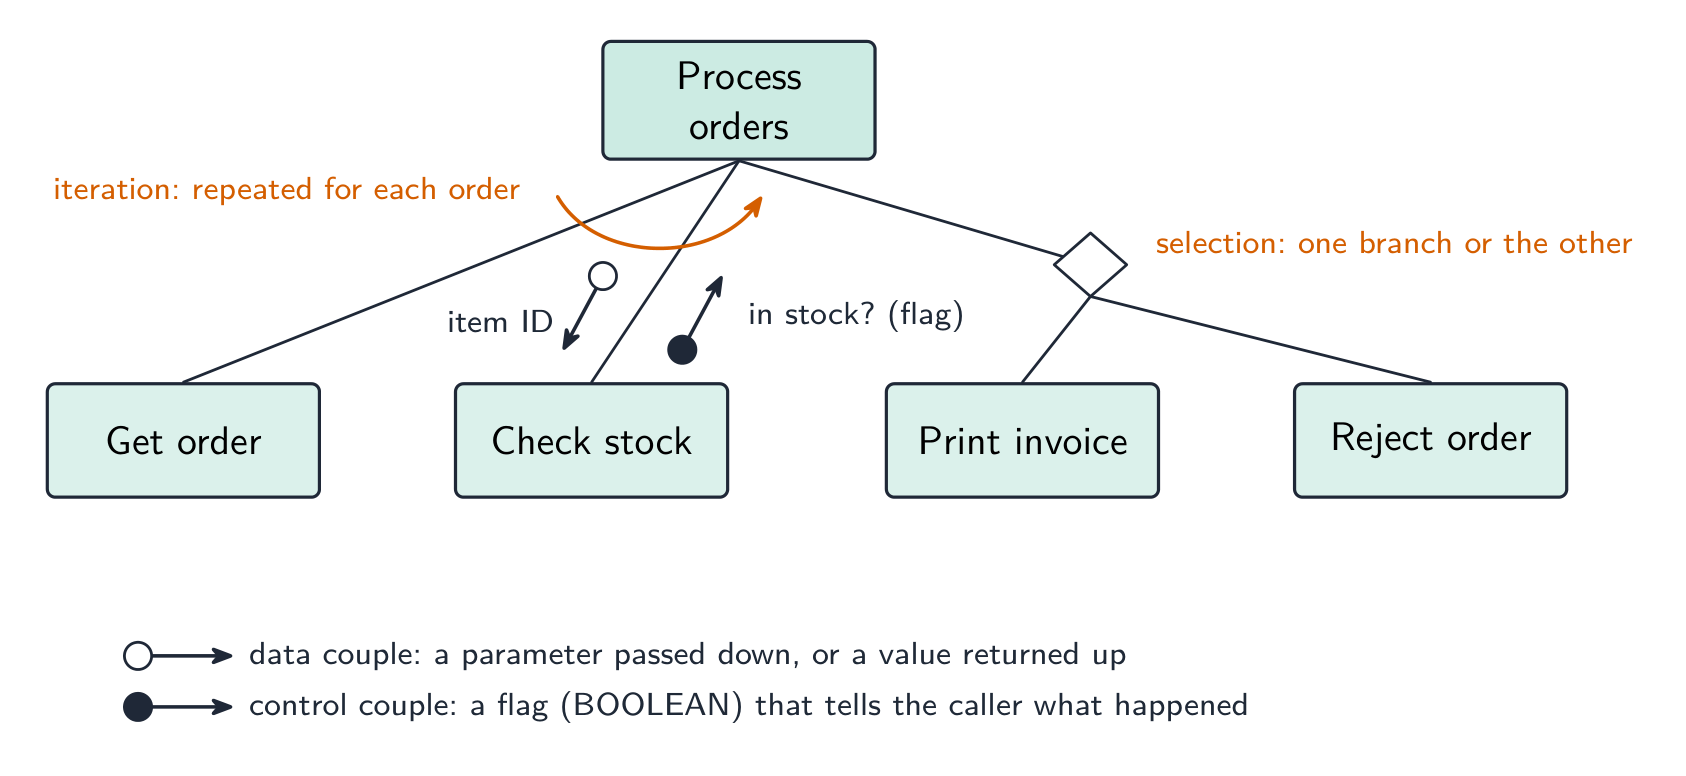
Exemple résolu. Quatre modules sont définis comme PROCEDURE Main(), PROCEDURE ReadData(BYREF Count : INTEGER), FUNCTION IsValid(Value : INTEGER) RETURNS BOOLEAN et PROCEDURE Report(Total : INTEGER, Count : INTEGER). Main appelle ReadData, puis appelle IsValid une fois pour chaque valeur lue, puis appelle Report. Décrire l'organigramme de structure.
Main en haut ; ReadData, IsValid et Report alignés en dessous, de gauche à droite selon l'ordre d'appel. Sur le lien ReadData, un couple de données montant Count (un paramètre BYREF revient). Sur le lien IsValid, un couple de données descendant Value et un couple de contrôle montant (le résultat BOOLEAN), avec une flèche d'itération courbe sur ce lien car il est appelé pour chaque valeur. Sur le lien Report, deux couples de données descendants, Total et Count. En lisant dans l'autre sens, une fonction est tout module qui retourne une valeur — son en-tête doit contenir RETURNS et le type retourné.
Diagramme de transition d'état
Un diagramme de transition d'état 状态转换图 montre les états 状态 auxquels un système peut être et les événements qui le font passer de l'un à l'autre — utile pour les distributeurs automatiques, les feux de signalisation, les interfaces utilisateur. Les diagrammes de transition d'état servent à documenter le comportement d'un algorithme ou d'un système. Chaque état est un cercle ; chaque transition est une flèche étiquetée avec l'événement.
   coin inserted               item selected
[Idle] --------------→ [Awaiting selection] ----------→ [Dispensing]
Il rend facile de repérer les transitions manquantes (« que se passe-t-il si une deuxième pièce est insérée en attendant la sélection ? »).

Lecture et dessin d'un tel diagramme. Chaque transition est étiquetée entrée | sortie (ou condition | action) : ce qui s'est produit, puis ce que fait le système lorsqu'il change d'état. Une question donne un tableau de état actuel, entrée, sortie, prochain état et demande le diagramme, ou l'inverse — chaque ligne du tableau correspond exactement à une flèche. Vérifier que chaque état a une flèche sortante pour chaque entrée possible, y compris celles qui laissent l'état inchangé (une flèche qui boucle sur le même état).
Exemple résolu. Un contrôleur de pompe a les états pompe éteinte et pompe allumée. Dans pompe éteinte, l'entrée niveau bas détecté produit la sortie activer la pompe et passe à pompe allumée ; dans pompe allumée, niveau normal détecté produit désactiver la pompe et passe à pompe éteinte. Toute autre entrée laisse l'état inchangé. Dessiner le tableau.
| État actuel | Entrée | Sortie | Prochain état |
|---|---|---|---|
| pompe éteinte | niveau bas détecté | activer la pompe | pompe allumée |
| pompe éteinte | niveau normal détecté | — | pompe éteinte |
| pompe allumée | niveau normal détecté | désactiver la pompe | pompe éteinte |
| pompe allumée | niveau bas détecté | — | pompe allumée |
Les deux lignes « sans changement » deviennent des flèches de boucle sur le diagramme ; les omettre coûte la marque pour exhaustivité.
Explorer
Laboratoire de processus logiciel
Classez les exemples de développement par étape ou outil auquel ils appartiennent.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| structure chart/ˈstrʌktʃə tʃɑːt/ | 结构图 | jié gòu tú |
| parameters/pəˈræmɪtəz/ | 参数 | cān shù |
| pseudocode/ˈsuːdəʊkəʊd/ | 伪代码 | wěi dài mǎ |
| test plan/test plæn/ | 测试计划 | cè shì jì huà |
| implementation/ˌɪmplɪmənˈteɪʃn/ | 实现 | shí xiàn |
| boundary data/ˈbaʊndəri ˈdeɪtə/ | 边界数据 | biān jiè shù jù |
| acceptance testing/əkˈseptəns ˈtestɪŋ/ | 验收测试 | yàn shōu cè shì |
| hierarchical decomposition/haɪəˈrɑːkɪkl ˌdiːkɒmpəˈzɪʃn/ | 分解 | fēn jiě |
| decomposition/ˌdiːkɒmpəˈzɪʃn/ | 分解 | fēn jiě |
| subroutines/ˈsʌbruːtiːnz/ | 子程序 | zi chéng xù |
| state-transition diagram/steɪt trænˈsɪʃn ˈdaɪəɡræm/ | 状态转换图 | zhuàng tài zhuǎn huàn tú |
| states/steɪts/ | 状态 | zhuàng tài |
| syntax error/ˈsɪntæks ˈerə/ | 语法错误 | yǔ fǎ cuò wù |
| run-time error/rʌn taɪm ˈerə/ | 运行时错误 | yùn xíng shí cuò wù |
| logic error/ˈlɒdʒɪk ˈerə/ | 逻辑错误 | luó jí cuò wù |
12.3
Erreurs

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension des moyens d'exposer et d'éviter les fautes dans les programmes | |
| Localiser et identifier les différents types d'erreurs | • erreurs de syntaxe • erreurs logiques • erreurs d'exécution |
| Corriger les erreurs identifiées | |
| Montrer une compréhension des méthodes de test disponibles et sélectionner des données appropriées pour une méthode donnée | Y compris exécution à sec, parcours, boîte blanche, boîte noire, intégration, alpha, bêta, acceptation, module fantoche |
| Montrer une compréhension de la nécessité d'une stratégie de test et d'un plan de test et de leur contenu probable | |
| Choisir des données de test appropriées pour un plan de test | Y compris normale, anormal et extrême/frontière |
| Montrer une compréhension de la nécessité d'une maintenance continue d'un système et des différences entre chaque type de maintenance | Y compris parfaite, adaptative, corrective |
| Analyser un programme existant et apporter des modifications pour améliorer ses fonctionnalités |
Source : Programme Cambridge International
- erreur de syntaxe 语法错误 — viole la grammaire du langage (crochet manquant, mot-clé mal orthographié). Détectée au moment de la traduction ; le programme ne peut pas tourner tant qu'elle n'est pas corrigée.
- erreur d'exécution 运行时错误 — survient pendant l'exécution (division par zéro, fichier introuvable, indice de tableau hors limites). Le programme crash ou lève une exception ; corriger en ajoutant des vérifications.
- erreur logique 逻辑错误 — le programme tourne mais donne des résultats faux (utilisation de
+pour-, décalage d'un élément dans une boucle, conditions dans le mauvais ordre). La plus difficile à trouver ; le seul signe est une sortie erronée, donc utiliser des tests minutieux et des tracés.
Exposition et évitement des fautes. Les fautes sont exposées par les tests selon un plan de test, par un essai manuel ou un tableau de trace, par une inspection collective avec des collègues, et par le débogueur de l'IDE (points d'arrêt, pas à pas, observation des variables). Elles sont évitées en concevant avant de coder (organigramme de structure, pseudocode), en utilisant du code modulaire avec des identifiants et commentaires significatifs, par la validation de chaque entrée, en gérant les exceptions plutôt que de laisser un runtime error crasher le programme, et par les vérifications dynamiques de syntaxe de l'IDE au fur et à mesure de la frappe.
Exemple résolu. Indiquer le type d'erreur dans chaque cas et comment elle se manifeste. (a) Result <- STR_TO_NUM(x) / STR_TO_NUM(y) est exécuté avec y = "0". (b) La même ligne est exécutée avec x = "12a". (c) Une boucle écrite comme FOR i <- 1 TO 9 traite un tableau à dix éléments. (d) OUTPUT "Total: " Total manque une virgule.
(a) Erreur d'exécution — division par zéro ; le programme crash quand cette ligne est exécutée avec ces données. (b) Erreur d'exécution — la chaîne ne peut pas être convertie en nombre. (c) Erreur logique — le programme tourne mais le dixième élément n'est jamais traité, donc la sortie est fausse. (d) Erreur de syntaxe — l'instruction viole les règles du langage et est rapportée par le traducteur avant l'exécution du programme.
Exemple résolu. Corriger les erreurs dans ce pseudocode, qui devrait afficher la moyenne de dix notes.
Total <- 0
FOR i <- 1 TO 10
    INPUT Mark
    Total <- Total + Mark
NEXT i
Average <- Total / 9
OUTPUT "Average" Average
La division doit se faire par 10, pas par 9 (erreur logique) ; la ligne de sortie doit avoir une virgule ou un & entre la chaîne et la valeur (erreur de syntaxe) ; et Average n'est jamais déclaré comme REAL (erreur de syntaxe ou d'exécution, selon le langage). Dire quelle ligne et quelle est la ligne corrigée : Average <- Total / 10.
12.3
Méthodes de test

- essai manuel 手工跟踪 — tracer le code sur papier, notant la valeur de chaque variable dans un tableau.
- inspection collective 走查 — examen par une équipe du code.
- test blanc 白盒测试 — conçu à partir de la structure interne du code, couvrant chaque instruction, branche et boucle.
- test noir 黑盒测试 — conçu uniquement à partir de la spécification : fournir des entrées, vérifier les sorties.
- test d'intégration 集成测试 — combiner les modules et tester les interfaces entre eux.
- test alpha α测试 — par les développeurs/en interne avant la mise en production ; test beta β测试 — par un groupe limité d'utilisateurs réels dans leur propre environnement.
- test d'acceptation 验收测试 — par le client, pour décider si le produit est conforme à ses besoins.
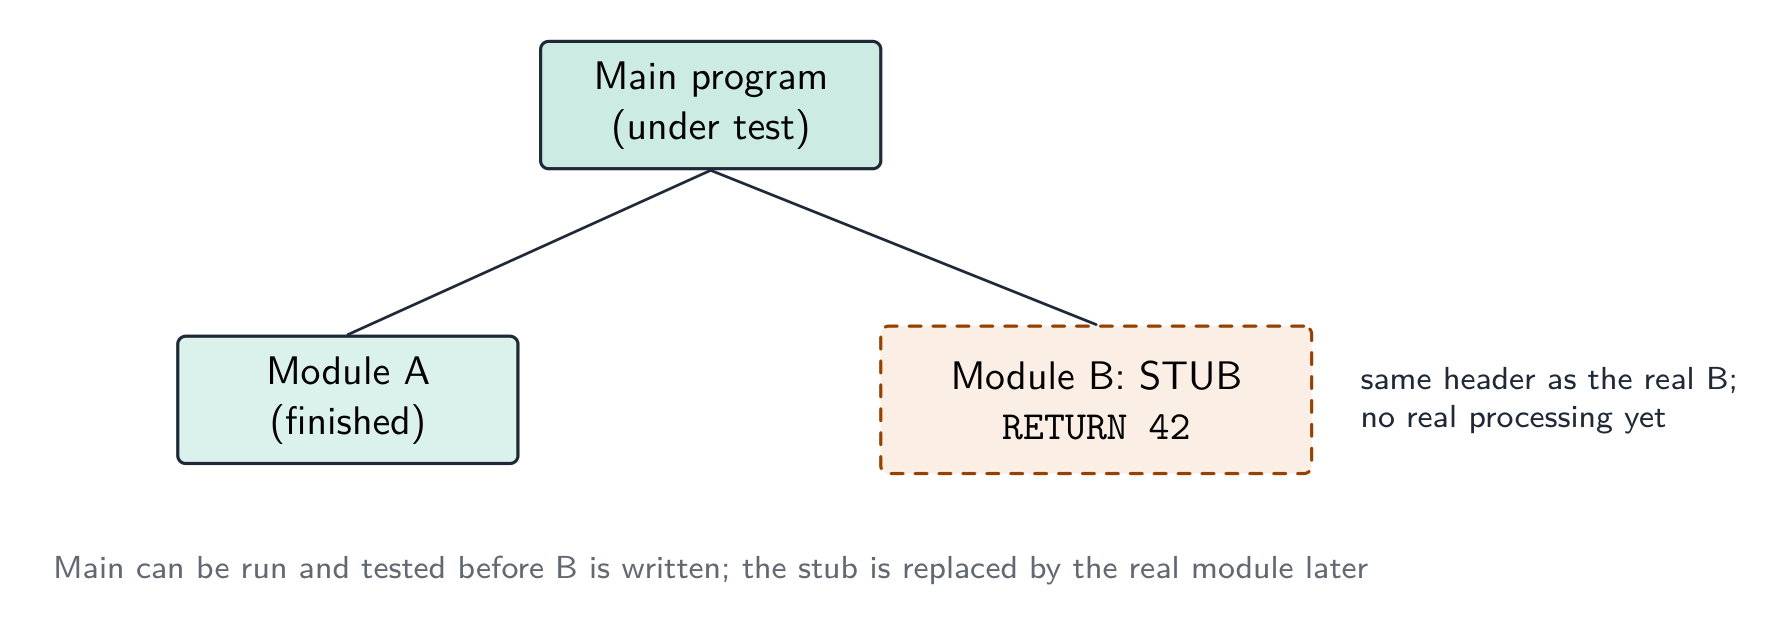
- module fantôme 桩 — un substitut pour un module qui n'existe pas encore, afin de pouvoir tester la structure de haut en bas.
Quelle méthode, quand. Un essai manuel et une inspection collective ne nécessitent pas d'ordinateur — l'essai manuel consiste à tracer l'algorithme avec un tableau de trace 跟踪表 ; l'inspection collective est une réunion où l'auteur explique le code ligne par ligne et les collègues cherchent les fautes, ce qui permet aussi de diffuser la connaissance du code au sein de l'équipe et de le vérifier par rapport à la conception. Les tests blancs sont écrits par quelqu'un qui peut voir le code et visent à explorer tous les chemins ; les tests noirs sont écrits à partir de la spécification et vérifient uniquement les entrées par rapport aux sorties attendues, donc ils peuvent être faits par un utilisateur ou un testeur externe. Le test d'intégration suit le test de module : des modules passant individuellement peuvent échouer lorsque les données transmises entre eux ont le mauvais type ou sont dans le mauvais ordre. Le test alpha est en interne ; le test bêta fournit une candidate à un échantillon d'utilisateurs réels, qui signalent les fautes liées à un usage réel ; le test d'acceptation est le client vérifiant le produit fini par rapport aux exigences avant de payer. Un module fantôme permet de commencer le test de haut en bas avant que tous les modules n'existent.
Exemple résolu. Après que le programme ait passé ses tests en interne, il a été remis à un groupe d'utilisateurs pour essai avant la mise en production. Nommer ce type de test et indiquer ce qui se passe ensuite.
Test beta — utilisateurs réels dans leur propre environnement, signalant les fautes que les développeurs n'avaient pas trouvées. Les fautes sont corrigées, puis le client effectue un test d'acceptation par rapport aux exigences et le programme est mis en production ; les fautes découvertes en utilisation réelle sont ensuite traitées par une maintenance corrective.
Exemple résolu. Donner trois avantages de tester un programme par inspection collective.
Les erreurs sont trouvées par des personnes qui n'ont pas écrit le code et le lisent donc sans préjugés ; la logique est vérifiée par rapport à la conception et à la spécification, pas seulement par rapport aux données de test ; plusieurs personnes apprennent comment fonctionne le code, ce qui facilite la maintenance ultérieure ; et aucune donnée de test ni ordinateur fonctionnel n'est nécessaire, donc cela peut être fait tôt.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| stub/stʌb/ | 桩 | zhuāng |
| corrective maintenance/kəˈrektɪv ˈmeɪntənəns/ | 纠正性维护 | jiū zhèng xìng wéi hù |
| test strategy/test ˈstrætədʒi/ | 测试策略 | cè shì cè lüè |
| normal data/ˈnɔːml ˈdeɪtə/ | 正常数据 | zhèng cháng shù jù |
| abnormal data/əbˈnɔːml ˈdeɪtə/ | 异常数据 | yì cháng shù jù |
| extreme data/ekˈstriːm ˈdeɪtə/ | 极端数据 | jí duān shù jù |
| perfective maintenance/pəˈfektɪv ˈmeɪntənəns/ | 完善性维护 | wán shàn xìng wéi hù |
| adaptive maintenance/əˈdæptɪv ˈmeɪntənəns/ | 适应性维护 | shì yìng xìng wéi hù |
12.3
Stratégie et plan de test

Une stratégie de test 测试策略 est l'approche de haut niveau — quels types de tests, qui les effectue, quand, et les critères pour passer à l'étape suivante. Un plan de test 测试计划 est la liste détaillée des tests — chacun avec des données d'entrée, une sortie attendue, et une colonne pour la sortie effective.
Ce que chacun contient. Une stratégie de test indique quelles méthodes de test seront utilisées à quelle étape (test de module par le programmeur, puis intégration, alpha, bêta, acceptance), qui est responsable de chaque étape, quels jeux de données sont nécessaires et les critères pour passer à l'étape suivante. Un plan de test liste les tests individuels : pour chacun, le module ou la fonctionnalité sous test, les données d'entrée, la raison pour laquelle les données ont été choisies (normales, anormales, extrêmes, aux limites), le résultat attendu, un espace pour le résultat réel, et ce qu'il faut faire s'ils diffèrent. Le plan est rédigé à l'étape de conception, à partir des spécifications, afin de tester ce que le programme devrait faire plutôt que ce qu'il fait par hasard.
Choisir des données de test
Pour chaque champ ou condition, inclure trois types :
- données normales 正常数据 — valeurs typiques dans la plage valide (pour des notes de 0 à 100 :
50,75). - données anormales 异常数据 — valeurs qui devraient être rejetées (
-10,200,"abc"). - données extrêmes 极端数据 — les valeurs les plus grandes et les plus petites encore acceptées (
0et100). - données limites 边界数据 — valeurs aux bords, là où se cachent les erreurs d'off-by-one (chaque extrême accepté et la valeur rejetée juste à l'extérieur :
0/-1,100/101).
Exemple résolu. Un champ accepte une note d'examen de 0 à 100. Fournissez des données de test de chaque type avec leur résultat attendu. Normal : 50 - accepté, une valeur typique dans la plage. Anormal : -10, 200, "abc" - tous rejetés, car hors plage ou mauvais type de données. Extrême : 0 et 100 - les plus grandes et les plus petites valeurs encore acceptées. Limite : les paires traversant chaque bord - -1 rejeté avec 0 accepté, et 100 accepté avec 101 rejeté. Chaque valeur doit porter son résultat attendu, sinon le plan de test ne prouve rien. Extrême et limite sont les deux types le plus souvent confondus : une valeur extrême se situe à l'intérieur et est acceptée, tandis qu'un test de limite est toujours une paire de part et d'autre du bord - c'est exactement là que se cachent les erreurs d'off-by-one.
Exemple résolu. Un composant passe si son poids, mesuré au gramme près, est dans un écart de 3 g par rapport à la cible de 50 g, c.-à-d. de 47 g à 53 g inclus. Établissez les lignes du plan de test pour cette vérification.
| Données de test | Type | Raison | Résultat attendu |
|---|---|---|---|
| 50 | normale | une valeur typique bien à l'intérieur de la plage | accepté |
| 47, 53 | extrême (limite) | les plus petites et plus grandes valeurs qui doivent encore être acceptées | accepté |
| 46, 54 | limite | les valeurs juste à l'extérieur de la plage, là où une erreur d'off-by-one les accepterait | rejeté |
| 20, 90 | anormal | valeurs très hors de la plage | rejeté |
| "abc", −5 | anormal | mauvais type, poids négatif | rejeté |
Chaque ligne doit indiquer pourquoi la valeur a été choisie et ce qui devrait se passer ; une simple liste de nombres n'apporte aucun point.
12.3
Maintenance

La majeure partie du coût d'un programme réside dans sa maintenance. Trois types :
- maintenance perfective 完善性维护 — améliorer les performances ou les fonctionnalités même si cela fonctionne déjà (une requête plus rapide, une nouvelle option).
- maintenance adaptive 适应性维护 — maintenir le fonctionnement dans un environnement en évolution (un nouveau système d'exploitation, une nouvelle API, un changement législatif).
- maintenance corrective 纠正性维护 — corriger les bugs découverts en utilisation.
Un programme peut avoir besoin des trois tout au long de sa vie.
Pourquoi chacun est nécessaire — les raisons listées dans le barème. Corrective : une anomalie est signalée par un utilisateur après la mise en production, ou une sortie incorrecte est remarquée dans des circonstances particulières non couvertes par les tests. Adaptive : le système d'exploitation, le matériel ou le navigateur sont mis à jour ; une loi ou une règle d'entreprise change (taux fiscaux, exigences de protection des données) ; le programme doit fonctionner avec un nouveau système externe ou format de fichier. Perfective : les utilisateurs demandent des fonctionnalités supplémentaires ou une meilleure interface ; le programme est rendu plus rapide ou consomme moins de mémoire ; le code est nettoyé pour faciliter les modifications futures.
Exemple résolu. (a) Un programme mis en production affiche une valeur erronée dans certaines circonstances. (b) Le matériel exécutant un programme est remplacé. (c) Les clients demandent que le programme de fidélité du café envoie un message à l'anniversaire d'un client. Nommez le type de maintenance dans chaque cas.
(a) Corrective — une défaillance du programme livré est en cours de correction. (b) Adaptive — le programme est modifié pour s'exécuter dans son nouvel environnement. (c) Perfective — une fonctionnalité est ajoutée à un programme fonctionnant déjà.
12.3
Modifier un programme existant
Lorsqu'on demande d'ajouter une fonctionnalité ou de corriger un bug :
- lire le code existant jusqu'à comprendre l'algorithme et le flux de données.
- localiser l'emplacement du changement — quelle sous-routine, quelles lignes.
- apporter le changement aussi petit que possible — ne pas réécrire du code fonctionnant.
- mettre à jour les parties connexes — tout appelant d'une liste de paramètres changée, toute routine utilisant une structure de données modifiée.
- tester le nouveau comportement et l'ancien (regression testing 回归测试 — vérifier que vous n'avez rien cassé).
- documenter le changement.
Des commentaires clairs, des noms significatifs, des sous-routines décomposées et une carte de structure rendent un programme beaucoup plus facile à modifier — c'est pourquoi les outils de conception comptent même après la première mise en production.
Analyser un programme que vous n'avez pas écrit. Commencez par la table des identifiants et les en-têtes de modules : ils vous indiquent ce que chaque module reçoit et retourne avant de lire une seule ligne de son corps. Ensuite, tracez l'algorithme avec une table de traçage pour une petite entrée, en notant d'où vient chaque valeur de sortie. Ce n'est qu'alors que vous décidez où va l'amélioration — généralement un nouveau module appelé depuis l'existant, pour perturber le moins possible le code fonctionnant — et écrivez la pseudocode pour le changement ainsi que les données de test qui le prouvent.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| regression testing/rɪˈɡreʃn ˈtestɪŋ/ | 回归测试 | huí guī cè shì |
12.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| cycle de développement | la séquence des étapes, de l'analyse à la maintenance, suivie pour produire et prendre en charge un programme |
| modèle en cascade (waterfall) | un cycle de vie où les étapes sont exécutées dans un ordre fixe, chacune étant terminée avant que la suivante ne commence |
| modèle itératif | un cycle de vie où une version fonctionnelle est produite puis affinée répétément jusqu'à ce qu'elle soit complète |
| développement rapide d'applications (RAD) | un cycle de vie qui construit rapidement des prototypes, les affinant avec les retours utilisateurs jusqu'à leur acceptation |
| carte de structure | un diagramme montrant comment un programme est décomposé en modules, l'ordre dans lequel ils sont appelés et les paramètres passés entre eux |
| diagramme à transitions d'état | un diagramme montrant les états dans lesquels un système peut se trouver et les entrées qui provoquent ses transitions |
| erreur de syntaxe | une erreur dans l'écriture d'une instruction, brisant ainsi les règles du langage et empêchant la traduction |
| erreur logique | une erreur dans l’algorithme, donc le programme s’exécute mais produit le mauvais résultat |
| erreur d'exécution | une erreur survenant pendant l'exécution du programme, comme une division par zéro, et l'arrêtant |
| essai manuel (dry run) | parcourir l'algorithme à la main, enregistrant les valeurs des variables dans une table de traçage |
| walkthrough | un examen où l'auteur parcourt le code avec des collègues cherchant des erreurs |
| stub | un module substitut avec le bon en-tête retournant une valeur fixe, utilisé pour permettre le test des modules qui l'appellent |
| plan de test | une liste des tests à effectuer, chacun avec ses données de test, la raison des données et le résultat attendu |
| données limites | valeurs à chaque bord de la plage valide, tant la dernière valeur acceptée que la première valeur rejetée |
| maintenance corrective / adaptive / perfective | correction de fautes découvertes en utilisation / modification du programme pour s'adapter à un environnement changé / amélioration d'un programme fonctionnant déjà |
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| dry run/draɪ rʌn/ | 手工跟踪 | shǒu gōng gēn zōng |
| trace table/treɪs ˈteɪbl/ | 跟踪表 | gēn zōng biǎo |
| walkthrough/ˈwɔːkθruː/ | 走查 | zǒu chá |
| white-box testing/waɪt bɒks ˈtestɪŋ/ | 白盒测试 | bái hé cè shì |
| black-box testing/blæk bɒks ˈtestɪŋ/ | 黑盒测试 | hēi hé cè shì |
| integration testing/ˌɪntɪˈɡreɪʃn ˈtestɪŋ/ | 集成测试 | jí chéng cè shì |
| alpha testing/ˈælfə ˈtestɪŋ/ | α测试 | α cè shì |
| beta testing/ˈbiːtə ˈtestɪŋ/ | β测试 | β cè shì |
12.3
Conseils d'examen
- Comparer les modèles de développement (cascade, itératif, RAD) par principe, avantage, inconvénient, et connaître les cinq étapes du cycle de vie du développement de programme et ce que chacune produit.
- Distinguer les erreurs de syntaxe, logique et d'exécution selon quand elles apparaissent : lors de la traduction, dans la sortie, pendant l'exécution.
- Choisir des données de test de chaque type — normal, anormal, extrême et limite — et donner pour chaque valeur sa raison et son résultat attendu.
- Distinguer les types de maintenance (corrective, adaptive, perfective) selon pourquoi le changement est effectué.
- Sur une carte de structure, nommer chaque symbole : boîte, ligne d'appel, couple de données, couple de contrôle, losange de sélection, flèche d'itération. En lisant les en-têtes de modules sur un graphique, rappelez-vous qu'une fonction a
RETURNS.
Erreurs courantes
- Décrire une étape de cycle de vie uniquement par son nom (« à l'étape de conception, le programme est conçu »). Dire ce qui est produit : carte de structure, pseudocode, plan de test.
- Appeler une mauvaise sortie une « erreur d'exécution ». Si le programme s'exécute jusqu'à la fin, c'est une erreur logique.
- Donner des données limites comme étant seulement les extrêmes. La note nécessite les valeurs des deux côtés du bord.
- Traiter les tests alpha et bêta comme identiques. Alpha est interne aux développeurs ; bêta est par de vrais utilisateurs externes.
- Confondre maintenance adaptive et perfective. Adaptive répond à un changement extérieur au programme ; perfective améliore un programme dont personne n'avait besoin de changer.
- Dessiner une carte de structure avec les modules dans n'importe quel ordre. Ils se lisent de gauche à droite dans l'ordre des appels, et chaque paramètre nécessite sa flèche.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.