| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Sélectionner et utiliser des types de données appropriés pour la résolution d'un problème | y compris entier, réel, char, chaîne, Booléen, datte (le pseudocode utilisera les types de données suivants : INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) |
| Montrer une compréhension de la finalité d'une structure d'enregistrement pour contenir un ensemble de données de différents types de données sous un identifiant unique | Écrire du pseudocode pour définir une structure d'enregistrement |
| Écrire du pseudocode pour lire des données depuis une structure d'enregistrement et sauvegarder des données vers une structure d'enregistrement |
Types et structures de données
Informatique A-Level · Sujet 10
 17:40
Types & Structures de données
Chaque valeur que votre programme stocke a besoin d'un type de données — et choisir le bon est important. Disons que vous stockez si un article est en stock. Vous pourriez écrire le mot yes…
Narration en anglais · Sous-titres anglais + 中文 incrustés
10.1
Choix des types de données
Programme
Source : Programme Cambridge International
Chaque variable a besoin d'un type de données 数据类型 — le genre de valeur qu'elle contient et les opérations autorisées :
INTEGER— un nombre entier (42,-7). Pour les comptes, indices, IDs.REAL— un nombre comportant une partie décimale (3.14). Pour l'argent, les mesures.STRING— des caractères entre guillemets ("Hello"). Pour le texte.CHAR— un seul caractère ('A').BOOLEAN—TRUEouFALSE. Pour les indicateurs booléens.DATE— une date calendaire.
Choisissez le type précis le plus petit adapté : INTEGER pour les comptes entiers, BOOLEAN pour les indicateurs booléens (pas les chaînes "yes"/"no").
Les tableaux « donner le type de données approprié » sont décidés par l'utilisation de la valeur : la note moyenne d'une classe est REAL (elle a une partie fractionnaire) ; une adresse e-mail est STRING ; le nombre d'étudiants est INTEGER ; si un étudiant a payé est BOOLEAN ; une date de naissance est DATE ; un index de tableau est toujours INTEGER ; une seule lettre de grade est CHAR ; un numéro de téléphone est un STRING, car il commence par 0 et n'est jamais utilisé dans des calculs arithmétiques. Un BOOLEAN est utilisé pour un indicateur avec seulement deux états : si une recherche a trouvé sa cible, si un membre a payé, si un siège est réservé. Pour le tableau des identifiants, le nom de la variable doit être significatif aussi : NumberOfPeople, pas n.
10.1
Enregistrements

Un enregistrement 记录 (une structure d'enregistrement 记录结构) contient plusieurs champs de types différents sous un même nom — utile lorsque plusieurs valeurs décrivent une seule chose.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Ceci définit le type TStockItem ; declarez des variables de celui-ci :
DECLARE Item1 : TStockItem
DECLARE Items : ARRAY[1:100] OF TStockItem
Utilisez la notation point pour accéder à chaque champ 字段 :
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
Utilisez un enregistrement lorsque des valeurs appartiennent toujours ensemble (un client, un article en stock) ; utilisez des variables séparées pour des valeurs sans rapport.
Exemple résolu. Un club stocke, pour chaque élève, un ID élève (chaîne), un nom, une date de naissance et jusqu'à trois numéros de club (entiers). Écrivez du pseudocode pour déclarer le type d'enregistrement, un tableau pour contenir $3000$ élèves, et une instruction qui stocke un nom dans le premier élément.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Les points : TYPE avec l'identifiant et ENDTYPE ; chaque champ déclaré avec un type approprié ; le tableau déclaré avec ses bornes et OF Student ; le champ atteint avec l'index et un point. Une question « indiquez l'erreur dans la déclaration d'enregistrement » pointe généralement vers un ENDTYPE manquant, un champ sans type, ou un champ déclaré comme un STRING qui doit contenir des données arithmétiques. Deux conventions rapportent des points indépendamment : un élément inutilisé est marqué avec une valeur qui ne peut pas être des données réelles (une chaîne vide, -1, un ID de 0), et il est recommandé d'utiliser le même marqueur partout afin que chaque module puisse reconnaître un emplacement inutilisé ; un champ de club inutilisé est 0. Les avantages d'un tableau d'enregistrements, pour une question « citez trois avantages » : toutes les données pour une entité sont conservées sous un seul identifiant ; les champs peuvent avoir des types de données différents ; un seul tableau remplace plusieurs tableaux parallèles qui devraient être maintenus en phase ; l'ensemble peut être traité par une seule boucle ou transmis comme unique paramètre ; et ajouter un champ modifie uniquement la définition du type. Pour un seul client, la structure adaptée est un enregistrement (champs de types différents sous un même nom) ; pour tous les clients, c'est un tableau d'enregistrements.
*Un enregistrement contient plusieurs champs de types différents sous un même nom
Explorer
Un enregistrement regroupe des champs sous un nom unique
Un enregistrement regroupe des champs liés ensemble. Chaque champ est une étiquette nommée à laquelle vous accédez avec la notation point — Item1.Category — et non par un index numérique.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| array/əˈreɪ/ | 数组 | shù zǔ |
| record/ˈrekɔːd/ | 记录 | jì lù |
| record structure/ˈrekɔːd ˈstrʌktʃə/ | 记录结构 | jì lù jié gòu |
| field/fiːld/ | 字段 | zì duàn |
| element/ˈelɪmənt/ | 元素 | yuán sù |
| bounds/baʊndz/ | 边界 | biān jiè |
10.2
Tableaux

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Utiliser les termes techniques associés aux tableaux | Y compris index, borne supérieure et borne inférieure |
| Sélectionner une structure de données appropriée (tableau 1D ou tableau 2D) pour une tâche donnée | |
| Écrire du pseudocode pour des tableaux 1D et 2D | |
| Écrire du pseudocode pour traiter des données de tableau | Trier en utilisant un tri à bulles Rechercher en utilisant une recherche linéaire |
Source : Programme Cambridge International
Un tableau 数组 est une collection ordonnée d'éléments de même type, sous un même nom, atteinte par un index 索引.
- élément 元素 — un item dans le tableau.
- bornes 边界 — les indices valides les plus bas et les plus hauts.
- dimension 维度 — 1-D (liste), 2-D (tableau), etc.
- borne inférieure 下界 et borne supérieure 上界 — le premier et le dernier index valide ; le nombre d'éléments est borne supérieure moins borne inférieure plus un, et pour un tableau 2-D, le produit des deux compteurs.
Ainsi, dans ThisArray[n] ← 42, le tableau a une dimension, l'index est la variable n (un INTEGER), et l'élément à cet index reçoit 42. Avant de déclarer un tableau, il faut connaître son type de données ainsi que ses bornes. Pour déclarer $120$ valeurs pouvant comporter une décimale : DECLARE Data : ARRAY[1:120] OF REAL ; un tableau de chaînes de caractères à $150$ lignes et deux colonnes : DECLARE Data : ARRAY[1:150, 1:2] OF STRING, qui contient $300$ éléments. Les avantages d'un tableau par rapport à des variables séparées, pour une question de deux points : un seul identificateur au lieu de trente ; les éléments peuvent être traités par une boucle avec l'index comme compteur ; la taille est facile à modifier ; et l'ensemble peut être transmis à un module en tant qu'un seul paramètre. Un tableau peut également remplacer une série d'instructions de sélection : DaysInMonth[Month] cherche la réponse directement au lieu de douze clauses IF, ce qui est plus court, plus rapide à écrire et plus facile à maintenir.
Tableaux 1-D
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
Traiter chaque élément avec une boucle FOR :
FOR i ← 1 TO 5
    OUTPUT Names[i]
NEXT i
*Un tableau 1-D (une liste) avec indices et bornes
Tableaux 2-D (tableau 2D)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
Le premier index correspond à la ligne, le second à la colonne. Utiliser des boucles imbriquées pour visiter chaque cellule. Utiliser 1-D pour une séquence unique, 2-D pour deux dimensions naturelles (une grille, lignes × colonnes).
 *Un tableau 2-D (un tableau) avec indices de lignes et de colonnes
Opérations courantes
Une recherche linéaire 线性查找 vérifie chaque élément jusqu'à ce qu'il soit trouvé :
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Pour trouver une somme, un total, un maximum ou un minimum, définir une variable courante puis parcourir :
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Un tri à bulles 冒泡排序 met un tableau en ordre : passer à travers en comparant chaque paire adjacente et échanger celles qui ne sont pas dans l'ordre ; répéter les passes jusqu'à ce qu'une passe ne provoque aucun échange.
L'examen Paper 2 demande ces algorithmes sous forme de pseudocode et de descriptions en mots, et parfois dans leur version "efficace" :
- Valeur maximale : définir
Largestà la première élément ; pour chaque élément restant, si celui-ci est plus grand queLargest, le stocker dansLargest; après la boucle, afficherLargest. Pour la position de la valeur maximale, garder une seconde variable qui stocke l'index chaque fois queLargestchange. - Recherche linéaire retournant une position : définir
FoundAt ← -1avant la boucle (une valeur qui ne peut jamais être un index valide, donc cela signifie "non trouvé") ; parcourir le tableau ; lorsque l'élément correspond, stocker l'index et sortir de la boucle ; après la boucle, testerFoundAt. - Compter ou afficher les éléments non vides : comparer chaque élément avec le marqueur d'un élément inutilisé (
""ou-1) et compter ou n'afficher que ceux qui diffèrent. - Supprimer un élément : trouver son index par une recherche linéaire ; déplacer tous les éléments suivants d'une place vers le début, afin de combler le vide ; marquer le dernier élément comme inutilisé (ou diminuer le compteur).
- Insérer dans un tableau trié : trouver le premier index dont l'élément est plus grand ; déplacer cet élément et tous les suivants d'une place vers la fin ; stocker la nouvelle valeur dans le vide.
- Tri à bulles efficace : un indicateur
Swappedpour arrêter les passes dès qu'une passe ne provoque aucun échange, et une limite supérieure qui diminue d'une unité à chaque passe car la valeur maximale a déjà atteint la fin.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Les points concernent la boucle externe qui répète jusqu'à ce qu'il n'y ait plus d'échanges, l'indicateur défini à l'intérieur de la IF, l'échange sur trois lignes avec une variable temporaire, et la limite décroissante. Un tri en "étapes" (affinement progressif) est : répéter jusqu'à ce que ce soit trié ; à chaque passe, comparer les paires adjacentes ; échanger une paire hors d'ordre ; après chaque passe, la plus grande valeur non triée se trouve à la fin. Deux tableaux 1-D de registres ou de données parallèles sont traités avec une seule boucle et un seul index ; un tableau 2-D nécessite une boucle imbriquée, l'externe sur les lignes et l'interne sur les colonnes, et une recherche dans une ligne fixe l'index de ligne et boucle sur la colonne.
 *Une passe d'un tri à bulles : les paires adjacentes sont comparées et échangées, faisant remonter la plus grande valeur à la fin
Explorer
Un tableau à 2 dimensions
Choisissez une ligne et une colonne pour lire un élément — comment une grille de données est stockée et indexée.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| index/ˈɪndeks/ | 索引 | suǒ yǐn |
| dimension/daɪˈmenʃn/ | 维度 | wéi dù |
| bubble sort/ˈbʌbl sɔːt/ | 冒泡排序 | mào pào pái xù |
10.3
Fichiers

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension de la nécessité des fichiers | |
| Écrire du pseudocode pour gérer des fichiers texte composés d'une ou plusieurs lignes |
Source : Programme Cambridge International
Un fichier 文件 est des données stockées sur un stockage secondaire 辅助存储器, conservées entre les exécutions du programme. Les variables en RAM disparaissent quand le programme s'arrête, donc pour sauvegarder des données de manière permanente (scores élevés, registres, paramètres), le programme écrit dans un fichier. Les fichiers permettent aussi aux programmes de partager des données et de reprendre depuis un état sauvegardé.
*Les variables en RAM disparaissent quand le programme s'arrête ; un fichier sur disque persiste entre les exécutions
Un fichier texte 文本文件 contient une ou plusieurs lignes de caractères lisibles ; les programmes lisent et écrivent des fichiers texte ligne par ligne. Ouvrir un fichier avant utilisation et le fermer après :
OPENFILE "data.txt" FOR READ      // or FOR WRITE, FOR APPEND
WHILE NOT EOF("data.txt") DO
    READFILE "data.txt", LineString
    OUTPUT LineString
ENDWHILE
CLOSEFILE "data.txt"
EOF teste la fin de fichier 文件结束 avant la lecture. Pour écrire :
OPENFILE "log.txt" FOR WRITE
FOR i ← 1 TO 100
    WRITEFILE "log.txt", "Event " & i
NEXT i
CLOSEFILE "log.txt"
Toujours fermer chaque fichier — sinon les écritures tamponnées peuvent être perdues et d'autres programmes peuvent être bloqués.
Pourquoi les fichiers (deux points) : les données sont conservées après la fin du programme, donc elles sont disponibles la prochaine fois que le programme s'exécute ; elles peuvent être partagées avec d'autres programmes ; et elles peuvent contenir plus que ce qui tient en mémoire. La caractéristique d'un fichier texte qui permet à un programme de le parcourir est qu'il s'agit d'une séquence de lignes, lues une après l'autre à partir du début. Les trois modes : READ pour lire à partir du début ; WRITE pour créer un nouveau fichier, ce qui supprime tout contenu existant, donc il ne peut pas être utilisé pour ajouter à un fichier ; APPEND pour ajouter des lignes à la fin d'un fichier existant. Tester EOF avant chaque lecture, et ouvrir le fichier une seule fois, même lorsque plusieurs modules l'utilisent.
Exemple résolu. Écrire un pseudocode pour une procédure LastLines(FileName : STRING) qui affiche les trois dernières lignes d'un fichier texte, dans l'ordre.
PROCEDURE LastLines(BYVAL FileName : STRING)
    DECLARE LineX, LineY, LineZ : STRING
    LineX ← ""
    LineY ← ""
    LineZ ← ""
    OPENFILE FileName FOR READ
    WHILE NOT EOF(FileName) DO
        LineX ← LineY
        LineY ← LineZ
        READFILE FileName, LineZ
    ENDWHILE
    CLOSEFILE FileName
    OUTPUT LineX
    OUTPUT LineY
    OUTPUT LineZ
ENDPROCEDURE
Chaque nouvelle ligne pousse les trois précédentes vers l'avant, de sorte qu'à la fin du fichier, les trois variables contiennent ses trois dernières lignes ; un fichier avec moins de lignes affiche des chaînes vides. Pour afficher les cinq premières lignes, compter les lignes lues et arrêter la boucle à cinq ou à EOF, selon le premier arrivé ; un fichier vide est détecté par EOF étant TRUE immédiatement après l'ouverture.
Champs dans une ligne. Un fichier texte contient des chaînes, donc un registre est écrit comme une seule ligne avec ses champs joints par un séparateur 分隔符 caractère, et chaque nombre ou booléen converti avec NUM_TO_STR (et lu avec STR_TO_NUM, ou en le comparant à "TRUE"). Choisir un séparateur qui ne peut jamais apparaître dans les données : une virgule ou | pour les noms et les nombres, jamais un espace lorsque le nom peut en contenir un. Si un champ peut contenir n'importe quel caractère, le séparateur peut être confondu avec les données ; la solution est de mettre chaque champ sur sa propre ligne, ou d'écrire la longueur du champ avant celui-ci. Un élément par ligne est simple à relire mais utilise plus de lignes et rend un registre moins visible comme une unité. Lire un fichier dont les lignes sont dans un ordre connu (croissant par ID) permet à la recherche de s'arrêter dès qu'un ID plus grand est lu, au lieu de lire jusqu'à la fin. Un fichier de sauvegarde créé à chaque sauvegarde de jeu a besoin d'un nom de fichier significatif, par exemple le nom du joueur et la date/heure, afin que toute sauvegarde précédente puisse être restaurée.
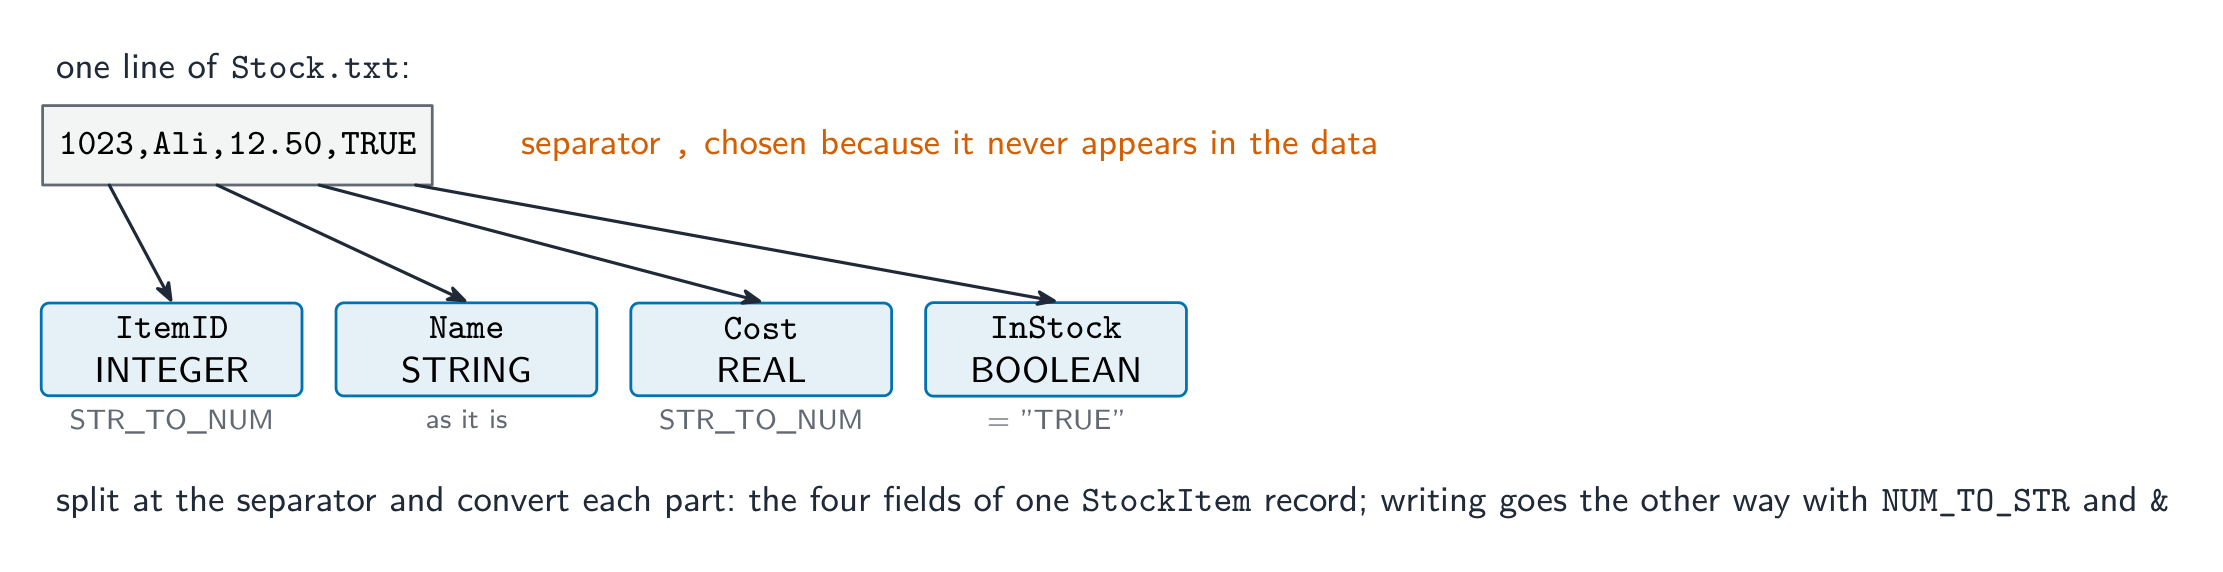 *Une ligne d'un fichier texte est un registre : champs joints par un séparateur, convertis à leurs types lors de la relecture
Explorer
Gestion d'un fichier : ouvrir → utiliser → fermer
Parcourez le cycle de vie suivi par chaque fichier. Les deux parties faciles à oublier sont de tester EOF pendant la lecture dans une boucle, et de toujours fermer à la fin.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| file/faɪl/ | 文件 | wén jiàn |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | 辅助存储器 | fǔ zhù cún chǔ qì |
10.4
Types de Données Abstraits (ADT)

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension qu'un ADT est un ensemble de données et un ensemble d'opérations sur ces données | |
| Montrer une compréhension qu'une pile, une fichier et une liste chaînée sont des exemples d'ADTs | Décrire les caractéristiques clés d'une pile, d'une fichier et d'une liste chaînée et justifier leur utilisation pour une situation donnée |
| Utiliser une pile, une fichier et une liste chaînée pour stocker des données | Les candidats ne seront pas tenus d'écrire du pseudocode pour ces structures, mais ils devraient être capables d'ajouter, modifier et supprimer des données dans ces structures |
| Décrire comment une fichier, une pile et une liste chaînée peuvent être implémentées en utilisant des tableaux |
Source : Programme Cambridge International
*Liste chaînée : insertion par recâblage de pointeurs
*Pile vs file : LIFO et FIFO
Un Type de Données Abstrait 抽象数据类型 (ADT) est une collection de données plus des opérations dessus, défini par ce qu'il fait, pas comment il est stocké. L'utilisateur travaille uniquement via les opérations ; l'implémentation est cachée, donc elle peut changer sans affecter le code utilisant l'ADT. Connaître trois : pile, file, liste chaînée.
La définition à un point : un ADT est une collection de données accompagnée d'un ensemble d'opérations sur ces données. Une pile, une file, une liste chaînée, un arbre binaire et un tableau sont tous des ADT. Pour justifier un choix : une file lorsque les éléments doivent être traités dans l'ordre d'arrivée (trames d'impression, frappes de touches, clients dans un magasin), car c'est premier entré, premier sorti ; une pile lorsque le dernier élément doit être traité en premier (annuler, revenir dans les pages web, inverser une commande, les adresses de retour des appels imbriqués), car c'est dernier entré, premier sorti ; une liste chaînée lorsque les éléments sont insérés et supprimés au milieu d'une séquence ordonnée souvent, car seuls les pointeurs changent et rien n'a besoin d'être déplacé. Pour comparer une pile et une file : toutes deux sont des structures linéaires d'éléments avec un ordre, toutes deux sont implémentées avec un tableau et des pointeurs, et toutes deux nécessitent une vérification de plein avant l'ajout et de vide avant la suppression ; une pile a un seul pointeur et ajoute/supprime à la même extrémité, une file a deux pointeurs et ajoute à une extrémité et supprime à l'autre.
Pile
Une pile 栈 fonctionne selon l'ordre Dernier entré, premier sorti 后进先出 (Last In, First Out - Dernier entré, premier sorti). Opérations : repousser 入栈 (ajouter au sommet), populer 出栈 (retirer du sommet), peek (regarder le sommet), et tests de vide/plein. Usages : historique d'annulation, adresses de retour des appels de fonction, analyse d'expressions, backtrack.
*Push et pop modifient le pointeur top ; le pointeur de base reste immobile
Exemple résolu. Une pile de caractères contient, de la base vers le haut, 'P', 'N', 'Z', 'X', 'Y', 'W', avec le pointeur de sommet de pile à 'W' (emplacement mémoire 202 de 200-207). Les opérations POP, POP, PUSH 'A', PUSH 'B', POP sont effectuées. Que contient la pile et où pointe le pointeur ?
Les deux pops retirent 'W' puis 'Y' ; les pushes ajoutent 'A' puis 'B' à leur place ; la dernière pop retire 'B'. La pile contient maintenant 'P', 'N', 'Z', 'X', 'A' et le pointeur est à 'A', l'emplacement 203. La valeur qui se trouve sur la pile depuis le plus longtemps est l'élément du bas, 'P' ; au maximum cinq pops supplémentaires sont possibles avant que la pile ne soit vide, et une pop sur une pile vide constitue une erreur, c'est pourquoi Pop() teste d'abord si elle est vide. Une fonction Push() qui retourne TRUE en succès teste d'abord si le pointeur est en haut du tableau (plein) et retourne FALSE si tel est le cas. Les éléments du tableau n'ont pas besoin d'être initialisés avant utilisation, car le seul pointeur indique quels éléments sont utilisés.

File d'attente
Une file d'attente 队列 fonctionne selon l'ordre FIFO 先进先出 (First In, First Out). Opérations : enfiler 入队 (ajouter à l'arrière), défiler 出队 (retirer de l'avant), et tests pour vide/plein. Utilisations : impression en file d'attente, ordonnancement, recherche en largeur, tamponnage.

Pour décrire l'ajout d'un élément : vérifier que la file n'est pas pleine ; stocker l'élément à la position indiquée par le pointeur de fin de file ; incrémenter le pointeur de fin (et le compteur). Pour décrire le retrait : vérifier que la file n'est pas vide ; lire l'élément au pointeur avant ; incrémenter le pointeur avant (et décrémenter le compteur). Énoncer la convention que vous utilisez : si le pointeur de fin marque la prochaine case libre, l'égalité des pointeurs avant et de fin signifie que la file est vide ; s'il marque le dernier élément, des pointeurs égaux signifient un seul élément. Dans une file linéaire, le pointeur avant ne peut jamais reculer, donc les cases derrière lui sont gaspillées ; c'est ce que corrige la file circulaire ci-dessous. Les deux caractéristiques d'une file à énoncer : les éléments sont ajoutés à l'arrière et retirés de l'avant, donc le premier ajouté est le premier retiré.

Liste chaînée
Une liste chaînée 链表 stocke les données sous forme de séquence de nœuds 节点. Chaque nœud contient une valeur et un pointeur 指针 vers le nœud suivant ; un pointeur de tête marque le début, et le pointeur du dernier nœud est un sentinelle (par ex. NULL). Opérations : insertion, suppression, recherche, et traversée 遍历 (visiter chaque nœud dans l'ordre). Son avantage par rapport à un tableau est une insertion/suppression peu coûteuse (il suffit d'ajuster les pointeurs) ; son inconvénient est un accès aléatoire lent (vous devez suivre les pointeurs depuis la tête).

Ajouter un nœud dans l'ordre (quatre points) : traverser la liste depuis la tête, en suivant les pointeurs, jusqu'à ce que le nœud situé avant la position soit trouvé (le dernier nœud dont la valeur est inférieure) ; prendre un nœud libre et y stocker la nouvelle valeur ; définir le pointeur du nouveau nœud sur l'adresse que le nœud précédent pointait ; définir le pointeur du nœud précédent sur le nouveau nœud. Si la nouvelle valeur doit être placée au début, c'est le pointeur de tête qui est modifié. Supprimer un nœud : trouver le nœud situé avant celui-ci, et définir le pointeur de ce nœud sur l'adresse que le nœud supprimé pointait, afin que la liste le contourne ; le nœud libéré retourne à la liste des libres. Comparé à un tableau 1-D, insérer ou supprimer dans une liste chaînée ne nécessite aucun déplacement des autres éléments, et la liste peut grandir jusqu'à ce que la mémoire manque ; le coût est le pointeur supplémentaire stocké avec chaque élément, et atteindre l'élément $n$ implique de suivre $n$ pointeurs, puisqu'il n'y a pas d'index direct.
Explorer
Une liste chaînée : des nœuds joints par des pointeurs
Chaque nœud stocke une valeur et un pointeur vers le nœud suivant. Insérer ou supprimer ne fait que relier les pointeurs — aucun élément ne se décale, contrairement à un tableau.
Explorer
Piles et files
Empiler et dépiler. Une pile (stack) est last-in-first-out ; une fichier (queue) est first-in-first-out — deux types de structures de données abstraites (ADT) clés.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| stack/stæk/ | 栈 | zhàn |
| push/pʊʃ/ | 入栈 | rù zhàn |
| separator/ˈsepəreɪtə/ | 分隔符 | fēn gé fú |
| linked list/lɪŋkt lɪst/ | 链表 | liàn biǎo |
| queue/kjuː/ | 队列 | duì liè |
| LIFO/ˈlaɪfəʊ/ | 后进先出 | hòu jìn xiān chū |
| FIFO/ˈfaɪfəʊ/ | 先进先出 | xiān jìn xiān chū |
| pop/pɒp/ | 出栈 | chū zhàn |
| enqueue/enˈkjuː/ | 入队 | rù duì |
| dequeue/diːˈkjuː/ | 出队 | chū duì |
| traverse/trəˈvɜːs/ | 遍历 | biàn lì |
| free list/friː lɪst/ | 空闲列表 | kòng xián liè biǎo |
10.4
Implémentation des TAD avec des tableaux

Pile utilisant un tableau
Conserver les éléments dans Stack[1:MaxSize] avec un entier Top (0 quand vide).
Push(x): siTop = MaxSizela pile est pleine (overflow 溢出) ; sinonTop ← Top + 1;Stack[Top] ← x.Pop(): siTop = 0la pile est vide (sous-débordement 下溢) ; sinon retournerStack[Top]etTop ← Top - 1.
File d'attente utilisant un tableau circulaire
Une file simple laisse Front et Rear marcher hors du tableau, gaspillant le début. La solution est un tableau circulaire 循环数组 — lorsqu'un pointeur atteint MaxSize, il fait le tour pour revenir à 1 :
Enqueue(x): vérifier plein ; sinonRear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): vérifier vide ; sinon retournerQueue[Front]etFront ← (Front MOD MaxSize) + 1.
Suivre un compteur séparé pour distinguer vide de plein.
L'algorithme pour le pointeur de fin, en mots : si le compteur égale la taille, signaler que la file est pleine et arrêter ; sinon ajouter un au pointeur de fin ; s'il dépasse maintenant le dernier index, le définir sur le premier index ; stocker l'élément à cet endroit et ajouter un au compteur. Les déclarations qu'une réponse "décrire la déclaration et l'initialisation" notée sur cinq points liste : le tableau avec sa taille et son type d'élément ; un pointeur avant et un pointeur de fin, tous deux initialisés au premier index (ou le pointeur avant au premier index et le pointeur de fin à la prochaine case libre) ; et un compteur d'éléments, initialisé à $0$.
Par exemple, avec MaxSize = 6 : si Rear = 5, alors (5 MOD 6) + 1 = 6, donc le prochain élément va dans la case 6 ; si Rear = 6, alors (6 MOD 6) + 1 = 1, donc le pointeur fait le tour vers la case 1.
Liste chaînée utilisant un tableau
Utiliser un tableau de structures, chacune avec un Next index :
TYPE TNode
    DECLARE Value : INTEGER
    DECLARE Next : INTEGER     // index of the next node, or -1 for end
ENDTYPE

DECLARE Nodes : ARRAY[1:MaxSize] OF TNode
DECLARE Head : INTEGER         // index of first node, -1 if empty
DECLARE FreeListHead : INTEGER // first available free node
Une liste libre 空闲列表 enchaîne les cases inutilisées, tout comme la liste de données enchaîne ses cases utilisées. Pour insérer : prendre une case dans FreeListHead, définir la valeur du nouveau nœud et Next, et mettre à jour le Next du nœud précédent (ou Head). Pour supprimer : délier le nœud et retourner sa case à la liste libre. Cela offre la flexibilité d'une structure chaînée avec l'allocation statique d'un tableau.

Exemple résolu. Une liste chaînée est maintenue dans un tableau Data et un tableau Pointer, avec Start pointant vers l'index 1. La liste est 1 → 3 → 4 (l'index 1 contient D40, l'index 3 contient D32, l'index 4 contient D11, dont le pointeur est $\emptyset$) ; la liste libre commence à l'index 2 et continue 2 → 5. Insérer D6 entre D32 et D11.
Prendre le premier nœud libre, l'index 2, et définir FreeStart sur son pointeur, 5 ; stocker D6 dans Data[2] ; définir Pointer[2] sur la valeur Pointer[3] contenue, qui est 4 ; définir Pointer[3] sur 2. La liste lit 1 → 3 → 2 → 4 et la liste libre est 5 → $\emptyset$. La réponse à « comment implémenter une liste chaînée » correspond exactement à ces parties : un tableau (ou tableau de structures) pour les données, un tableau parallèle pour les pointeurs contenant des indices, un pointeur de début, un pointeur de liste libre et une valeur nulle telle que $-1$ pour la fin.
Exemple corrigé. Une file circulaire est maintenue dans un tableau de taille 5 (indices 0 à 4) avec Front = 3, Rear = 3 et un élément stocké. Deux éléments sont ajoutés, puis deux sont retirés. Où se trouvent les pointeurs, et pourquoi utiliser une file circulaire ? Chaque déplacement utilise (pointer + 1) MOD size, donc les pointeurs se wrap. Ajouter deux fois déplace Rear : $3 \rightarrow 4$, puis $4 \rightarrow 0$ (car $(4+1) \bmod 5 = 0$), donc Rear = 0 et trois éléments sont stockés. Retirer deux fois déplace Front de la même manière : $3 \rightarrow 4$, puis $4 \rightarrow 0$, laissant Front = 0 et un élément. Le wrap est tout le point : dans une file de queue linéaire, les pointeurs avancent vers la fin et l'espace libéré à l'avant est gaspillé même lorsque la file est vide. Rappelez-vous qu'une file retire à l'Avant et ajoute à l'Arrière - une pile utilise un seul pointeur pour les deux.
Explorer
Implémenter des TADs avec des tableaux
FIFO
Une fichier est premier-entré-premier-sorti — enfiler à l'arrière, défiler depuis le devant.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| pointer/ˈpɔɪntə/ | 指针 | zhǐ zhēn |
| node/nəʊd/ | 节点 | jié diǎn |
| overflow/ˌəʊvəˈfləʊ/ | 溢出 | yì chū |
| underflow/ˌʌndəˈfləʊ/ | 下溢 | xià yì |
| circular array/ˈsɜːkjʊlə əˈreɪ/ | 循环数组 | xún huán shù zǔ |
10.4
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-le exactement.
| Terme | Définition |
|---|---|
| record | une structure de données qui contient un ensemble d'éléments de données (champs) de différents types de données sous un identifiant unique |
| array | une structure de données qui contient un nombre fixe d'éléments du même type de données sous un identifiant unique, chacun étant accédé par un index |
| index | le nombre qui identifie un élément d'un tableau |
| upper bound, lower bound | l'index valide le plus grand et le plus petit d'un tableau |
| text file | un fichier qui stocke les données sous forme de lignes de caractères, qu'un programme lit et écrit une ligne à la fois |
| abstract data type | un ensemble de données accompagné d'un ensemble d'opérations sur ces données |
| pile | une liste dans laquelle les éléments sont ajoutés et retirés du même bout, le sommet, donc le dernier élément ajouté est le premier retiré (LIFO) |
| file d'attente | une liste dans laquelle les éléments sont ajoutés à l'arrière et retirés de l'avant, donc le premier ajouté est le premier retiré (FIFO) |
| linked list | une liste dans laquelle chaque nœud contient un élément de données et un pointeur vers le nœud suivant, avec un pointeur de début vers le premier nœud |
| pointer | une variable qui contient l'adresse (ou l'index) d'un nœud ou d'une position dans une structure |
| recherche linéaire | vérifier chaque élément à tour de rôle depuis le premier jusqu'à ce que la cible soit trouvée ou la fin atteinte |
| bubble sort | passages répétés à travers le tableau comparant les paires adjacentes et échangeant celles qui sont mal classées, jusqu'à ce qu'un passage ne fasse aucun échange |
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| data type/ˈdeɪtə taɪp/ | 数据类型 | shù jù lèi xíng |
| lower bound/ˈləʊə baʊnd/ | 下界 | xià jiè |
| upper bound/ˈʌpə baʊnd/ | 上界 | shàng jiè |
| linear search/ˈlɪnɪə sɜːtʃ/ | 线性查找 | xiàn xìng chá zhǎo |
| text file/tekst faɪl/ | 文本文件 | wén běn wén jiàn |
| end of file/end ɒv faɪl/ | 文件结束 | wén jiàn jié shù |
| Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ | 抽象数据类型 | chōu xiàng shù jù lèi xíng |
10.4
Conseils d'examen
- Choisir la bonne structure de données et la justifier (un record pour des champs mixtes, un tableau 2-D pour une grille).
- Savoir implémenter une pile, une file d'attente et une liste chaînée avec un tableau et des pointeurs (sommet ; avant/arrière ; suivant).
- Distinguer un TAD (son comportement) de son implémentation (tableau plus pointeurs).
Erreurs courantes
- Une déclaration d'enregistrement sans
ENDTYPE, ou des champs sans types. Chaque champ est une ligneDECLAREavec un type. - Lire au-delà de la fin d'un fichier, ou écrire avec
WRITEalors que le fichier doit conserver son contenu. TesterEOFavant chaque lecture ; utiliserAPPENDpour ajouter. - Écrire un nombre dans un fichier texte sans le convertir. Un fichier contient des chaînes :
NUM_TO_STRout,STR_TO_NUMback. - Oublier les vérifications.
Pushet enqueue testent d'abord si plein ;Popet dequeue testent d'abord si vide, et la réponse le dit. - Perdre le reste de la liste lors de l'insertion d'un nœud. Définir le pointeur du nouveau nœud sur le nœud suivant ancien avant de modifier le pointeur du nœud précédent.
- Une recherche linéaire qui ne dit jamais « non trouvé ». Initialisez la position à $-1$ et testez-la après la boucle.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.