Các loại học máy và quá trình huấn luyện
Đã giới thiệu| English | Ý nghĩa |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | học máy |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | lan truyền ngược |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | học có giám sát |
| classification/ˌklæsɪfɪˈkeɪʃn/ | phân loại |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | học không có giám sát |
| clusters/ˈklʌstəz/ | nhóm |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | học tăng cường |
| agent/ˈeɪdʒənt/ | tác nhân |
| reward/rɪˈwɔːd/ | thưởng |
| policy/ˈpɒlɪsi/ | chiến lược |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | giảm độ dốc |
| loss function/lɒs ˈfʌŋkʃn/ | hàm mất mát |
| epoch/ˈiːpɒk/ | vòng huấn luyện |
Chương trình tự dạy mình một nước đi mở đầu chưa từng có ai chơi
- AlphaGo Zero chỉ được cung cấp luật chơi Go và không có gì khác. Không có trận đấu nào của con người, không có sách nước đi mở đầu, không có lời khuyên. Nó tự thi đấu với chính mình, bắt đầu từ các nước đi ngẫu nhiên.
- Trong ba ngày, nó vượt qua phiên bản đã đánh bại vô địch thế giới. Dọc đường nó phát hiện lại hàng thế kỷ lý thuyết nước đi mở đầu của con người, sau đó loại bỏ một phần vì thấy kém hơn.
- Nó học từ một con số duy nhất sau mỗi trận: thắng hay thua. Đó là một kiểu học hoàn toàn khác với việc được hiển thị một triệu bức ảnh có nhãn.
- Bài học này là ba mô hình của học máy, dữ liệu cần thiết cho mỗi mô hình là gì, và làm thế nào trọng số của mạng thực sự bị thay đổi bởi backpropagation.
Học có giám sát
- Học có giám sát huấn luyện trên dữ liệu mang nhãn: các bức ảnh gắn thẻ "mèo" hoặc "chó", email được đánh dấu spam hoặc không, nhà cửa kèm giá bán.
- Mô hình học ánh xạ từ đầu vào đến nhãn, sau đó được đưa các đầu vào chưa từng thấy và yêu cầu tạo ra nhãn.
- Nó chia thành phân loại, nơi đầu ra là một danh mục, và hồi quy, nơi đầu ra là một con số.
- Chi phí của nó nằm ở các nhãn: ai đó phải tạo ra chúng, và đối với một triệu hình ảnh thì đây là rất nhiều công sức con người.

Ví dụ có nhãn vào, mô hình ra, sau đó đầu vào không có nhãn
Học có giám sát sử dụng:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Học có giám sát huấn luyện trên các ví dụ có nhãn (ví dụ: hình ảnh được gắn thẻ mèo/chó).
Học không có giám sát
- Học không có giám sát nhận được dữ liệu không có nhãn và được yêu cầu tìm cấu trúc trong đó.
- Ứng dụng phổ biến nhất là phân cụm: nhóm thành các cụm các vật phẩm tương tự nhau, chẳng hạn như khách hàng mua những thứ tương tự nhau, mà không cần ai quyết định trước các nhóm sẽ là gì.
- Đó là điểm mạnh và điểm yếu của nó: nó có thể khám phá ra một sự phân nhóm mà không ai ngờ tới, nhưng nó không thể cho bạn biết sự phân nhóm đó có ý nghĩa gì.
Học không có giám sát được dùng để:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Không có nhãn, học không có giám sát khám phá các mẫu/cụm trong dữ liệu.
Học tăng cường
- Học tăng cường có một tác nhân hành động trong môi trường. Mỗi hành động thay đổi trạng thái và trả về một thưởng, có thể bằng không trong thời gian dài.
- Tác nhân học một chính sách, chiến lược để chọn hành động, nhằm tối đa hóa tổng thưởng theo thời gian. Nó học bằng cách deno thử nghiệm, hoàn toàn không có ví dụ có nhãn.
- Nó phù hợp với các vấn đề là một chuỗi các quyết định nơi nước đi đúng chỉ được tiết lộ bởi kết quả cuối cùng: trò chơi, điều khiển robot, ô tô tự lái. Đó chính xác là trường hợp của AlphaGo Zero.
Trong học tăng cường, tác nhân học bằng cách:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Tác nhân thử các hành động, nhận được phần thưởng, và học một chính sách tối đa hóa phần thưởng dài hạn.
Trong học tăng cường, tác nhân học một ____ tối đa hóa tổng phần thưởng theo thời gian.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Nó học bằng deno thử nghiệm từ phần thưởng, hoàn toàn không có ví dụ có nhãn, do đó rất phù hợp với các chuỗi quyết định.
Ví dụ minh họa: chọn mô hình
- Mười nghìn hình quét y tế, mỗi hình đều được bác sĩ gán nhãn là có khối u hay không, được dùng để huấn luyện hệ thống cảnh báo các hình quét mới. Học có giám sát: dữ liệu có nhãn và nhiệm vụ là học từ đầu vào sang nhãn, cụ thể là phân loại.
- Một cửa hàng muốn biết khách hàng của họ có落入 các nhóm tự nhiên hay không, mà không cần quyết định trước các nhóm đó. Học không có giám sát: không có nhãn tồn tại, và nhiệm vụ là tìm cấu trúc, cụ thể là phân cụm.
- Cánh tay robot phải học đặt linh kiện, chỉ được đánh giá dựa trên việc mỗi nỗ lực có thành công hay không. Học tăng cường: một tác nhân, một chuỗi hành động, và một tín hiệu thưởng thay vì nhãn.
- Tên mô hình, sau đó biện chứng từ dữ liệu: có nhãn, không có nhãn, hay tín hiệu thưởng.
Phòng thí nghiệm loại học AI
Phân loại các ví dụ về AI dựa trên loại hình học hoặc vấn đề liên quan.
Nối mỗi mô hình học máy với dữ liệu tương ứng.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Học có giám sát = nhãn; học không có giám sát = không có nhãn; học tăng cường = phản hồi phần thưởng.
Nối mỗi tình huống với mô hình học máy mà nó cần.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Nhãn, không có nhãn, hoặc phần thưởng. Dữ liệu quyết định mô hình học, chứ không phải độ khó của nhiệm vụ.
Huấn luyện bằng backpropagation
- Huấn luyện có nghĩa là điều chỉnh trọng số sao cho đầu ra của mạng khớp với mục tiêu. Phương pháp là backpropagation với giảm gradient.
- Lượt tiến: đưa đầu vào qua mạng và lấy đầu ra. Tính toán sai số sử dụng hàm mất mát, đo lường khoảng cách giữa đầu ra và mục tiêu.
- Lượt ngược: lan truyền sai số ngược qua các lớp để tìm gradient của từng trọng số, tức là trọng số đó đóng góp bao nhiêu vào sai số.
- Cập nhật: thay đổi mỗi trọng số một bước nhỏ ngược hướng với gradient. Kích thước bước là tốc độ học tập.
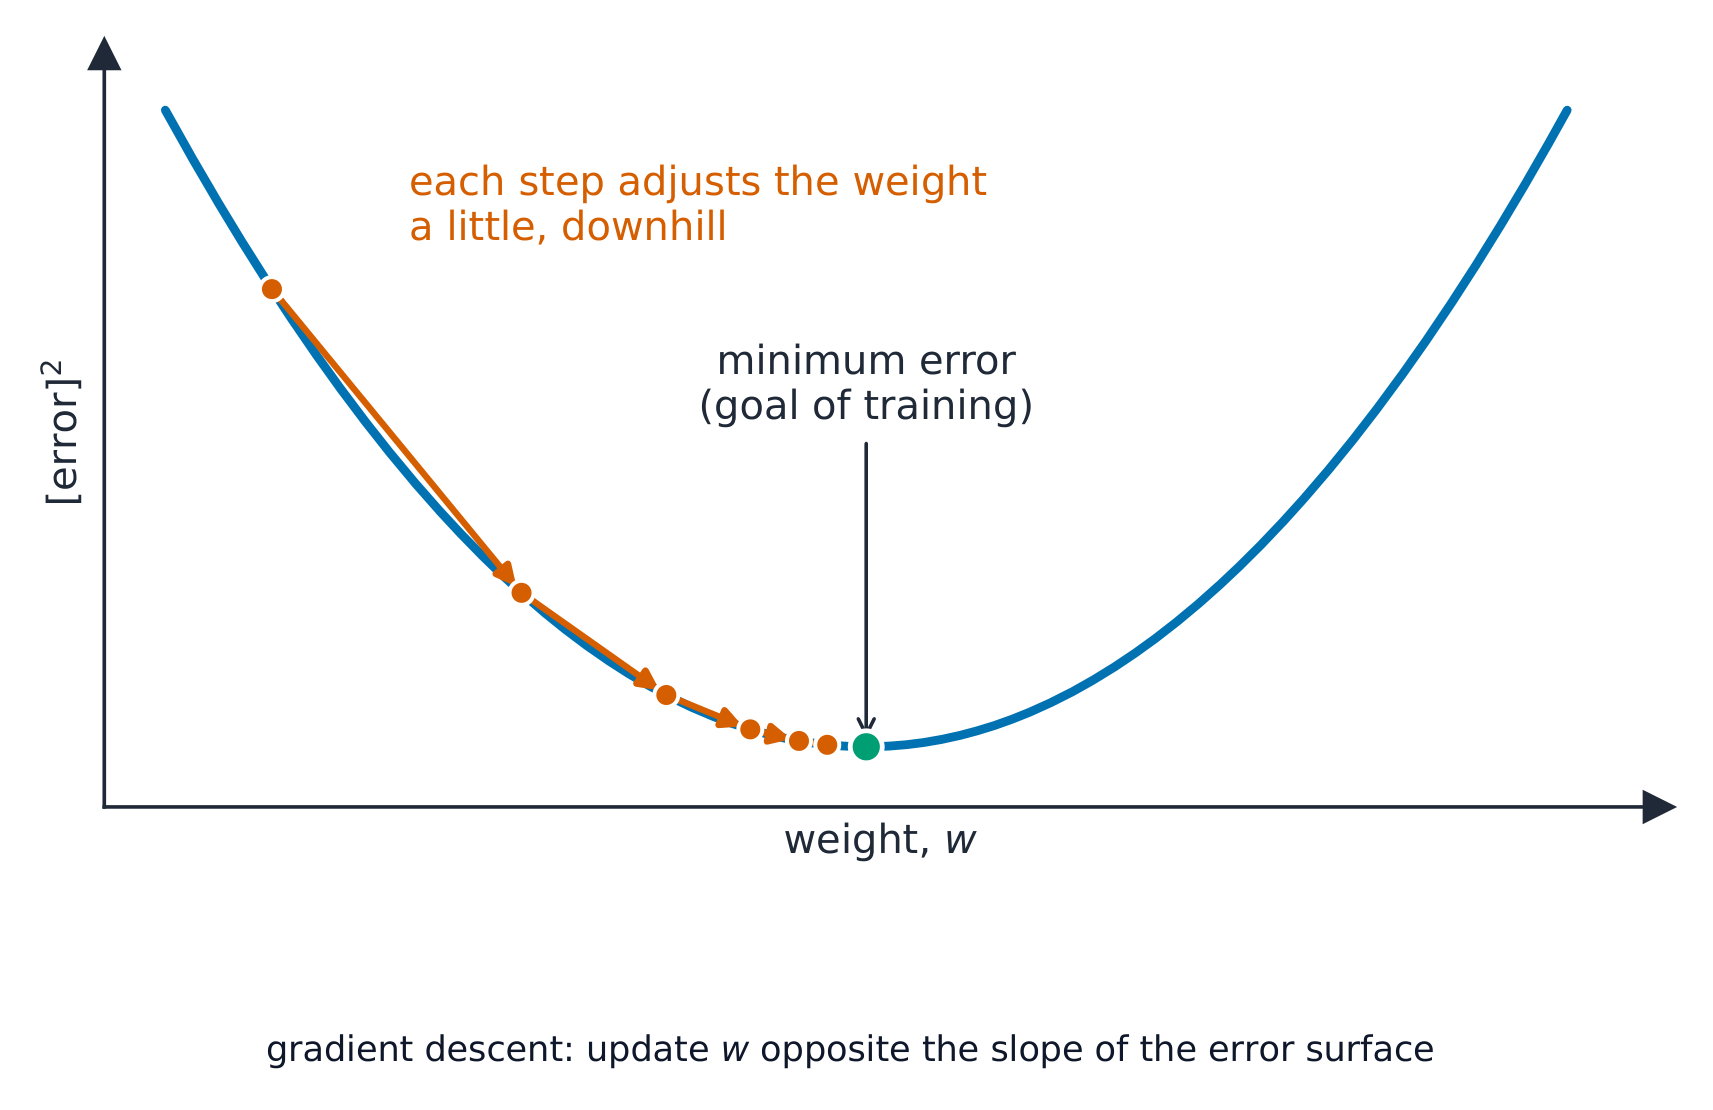
Xuống dốc, một bước nhỏ mỗi lần
Backpropagation huấn luyện mạng bằng cách:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Sai số chảy từ đầu ra ngược trở lại qua mạng (quy tắc chuỗi) để tìm đạo hàm của mọi trọng số, sau đó các trọng số di chuyển xuống dốc.
Xếp thứ tự một vòng huấn luyện backpropagation.
Difficulty 3/5 · 200 coins + a small bonus on first completion today
Đi trước, tính sai số, đi ngược, cập nhật, lặp lại qua nhiều epoch cho đến khi sai số ngừng giảm.
Epochs, và tại sao tốc độ học lại quan trọng
- Một lần duyệt qua toàn bộ tập huấn luyện là một epoch. Quá trình huấn luyện lặp đi lặp lại nhiều epoch cho đến khi sai số ngừng giảm.
- Nếu quá lớn, tốc độ học sẽ vượt quá điểm tối thiểu khiến sai số dao động; nếu quá nhỏ, quá trình huấn luyện sẽ kéo dài hơn nhiều so với cần thiết.
- Sau khi huấn luyện xong, việc sử dụng mô hình chỉ là một lượt lan truyền tiến, đó là lý do mạng đã huấn luyện có thể trả lời tức thì dù quá trình huấn luyện mất nhiều ngày.
Trong gradient descent, tốc độ học xác định kích thước bước của mỗi lần cập nhật trọng số — quá lớn sẽ vượt qua điểm tối thiểu, quá nhỏ khiến việc huấn luyện chậm.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
Backpropagation tìm đạo hàm của từng trọng số; tốc độ học nhân khoảng cách mà trọng số di chuyển dọc theo đạo hàm đó.
Statement nào về việc huấn luyện là đúng? Chọn tất cả các phát biểu áp dụng.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
Tốc độ học là kích thước của mỗi lần cập nhật trọng số. Đó là lý do tại sao việc huấn luyện có thể mất vài ngày trong khi dự đoán chỉ mất vài miligiang.
Điểm số dễ mất
- Justify một paradigm từ dữ liệu: có nhãn nghĩa là có giám sát, không có nhãn nghĩa là không có giám sát, tín hiệu phần thưởng nghĩa là học tăng cường.
- Học tăng cường không có nhãn. Gọi phần thưởng của nó là nhãn là sự nhầm lẫn điển hình.
- Lan truyền ngược là tiến, sai số, lùi, cập nhật, lặp lại. Chỉ nói "nó điều chỉnh các trọng số" chỉ là một nửa câu trả lời.
- Tốc độ học là kích thước của mỗi bước, không phải tốc độ huấn luyện hay số lượng epoch.
Bạn đã nắm vững
- Có giám sát học đầu vào sang nhãn từ dữ liệu có nhãn, dùng cho phân loại hoặc hồi quy · Không có giám sát tìm cấu trúc như nhóm trong dữ liệu không có nhãn · Học tăng cường có một agent học chính sách từ phần thưởng bằng thử và sai
- Chọn paradigm từ những gì dữ liệu cung cấp, không phải từ mức độ khó của tác vụ
- Lan truyền ngược: một lượt lan truyền tiến, một sai số từ hàm mất mát, một lượt lan truyền lùi đưa ra gradient cho từng trọng số, sau đó là cập nhật có kích thước do tốc độ học quyết định
- Huấn luyện lặp lại nhiều epochs; sử dụng mô hình đã huấn luyện chỉ là một lượt lan truyền tiến