Data compression
Tại sao nén dữ liệu
- Dữ liệu chiếm không gian để lưu trữ và mất thời gian để truyền tải.
- Nén làm cho tệp nhỏ hơn, giúp tiết kiệm chi phí lưu trữ và tăng tốc độ chia sẻ.
- Có hai loại chính: nén không mất mát và nén có mất mát.
Nén không mất mát
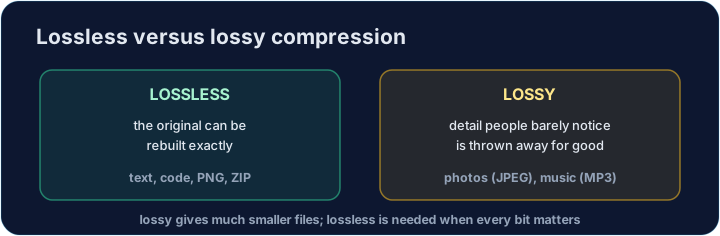
- Nén không mất mát làm giảm kích thước tệp nhưng vẫn giữ nguyên toàn bộ dữ liệu gốc.
- Khi mở tệp, bạn sẽ thu được file chính xác như ban đầu.
- Nó hoạt động bằng cách tìm kiếm các mẫu dữ liệu và viết lại chúng theo cách ngắn gọn hơn.
Original:  AAAAAAAA-BBB
Shorter:   8A-3B          (8 A's, then 3 B's)
Open it:   AAAAAAAA-BBB   (exactly the same again)
Nén có mất mát
- Nén có mất mát làm giảm kích thước tệp đáng kể bằng cách loại bỏ một phần dữ liệu.
- Nó loại bỏ các chi tiết mà con người khó có thể nhìn thấy hoặc nghe thấy.
- Bạn không thể khôi phục lại file gốc chính xác — nhưng nó đủ gần để sử dụng.
Photo (large)  --lossy-->  Photo (small)
A few colors and fine details are gone,
but your eye hardly notices.
Sự đánh đổi: kích thước vs chất lượng
- Nén không mất mát giữ nguyên chất lượng đầy đủ, nhưng kích thước tệp vẫn lớn.
- Nén có mất mát cung cấp kích thước tệp nhỏ hơn nhiều, nhưng chất lượng bị giảm nhẹ.
- Bạn cần lựa chọn dựa trên yếu tố nào quan trọng hơn: dữ liệu hoàn hảo hay kích thước nhỏ.
Khi nào sử dụng từng loại
- Sử dụng nén không mất mát khi yêu cầu chi tiết phải chính xác tuyệt đối.
- Sử dụng nén có mất mát khi sự sụt giảm nhẹ về chất lượng là chấp nhận được và ưu tiên kích thước nhỏ.
Lossless:  text, code, a .zip file, a spreadsheet
Lossy:     photos (JPEG), music (MP3), video
Ý tưởng cốt lõi
- Nén là sự đánh đổi giữa kích thước và chất lượng (hoặc giữa kích thước và nỗ lực để khôi phục lại).
- Nén không mất mát = nhỏ hơn và hoàn hảo; nén có mất mát = nhỏ hơn nhiều nhưng không chính xác.
- Các kỹ sư giỏi sẽ chọn đúng loại nén cho từng nhiệm vụ cụ thể.
Mã hóa độ dài chuỗi (Run-length encoding)
- Mã hóa độ dài chuỗi (RLE) là một phương pháp nén không mất mát đơn giản.
- Một chuỗi (run) là một dãy các ký tự giống nhau liên tiếp. RLE lưu trữ số lượng thay vì ghi lại các ký tự lặp lại.
- Chúng ta sẽ lưu trữ mỗi lần chạy dưới dạng cặp
[character, count]bên trong một danh sách.
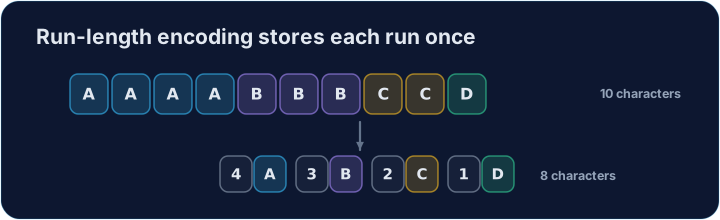
"AAAB"                ->  [["A", 3], ["B", 1]]     (3 A's, then 1 B)
[["A", 3], ["B", 1]]  ->  "AAAB"                   (decode it back — exact again)
Lỗi thường gặp
- Nén không mất mát có thể đảo ngược hoàn toàn; nén có mất mát thì loại bỏ thông tin chi tiết.
- Mức độ nén cao hơn thường dẫn đến chất lượng thấp hơn.
Bây giờ bạn thử
- Tự xây dựng RLE: gồm một bộ mã hóa, một bộ giải mã và một hàm hỗ trợ đo độ dài.
- Mỗi bài kiểm tra sẽ áp dụng hàm của bạn lên nhiều đầu vào khác nhau. Nhấn Kiểm tra đáp án.
Lossless compression
Run-length encoding replaces a run of repeats with count + symbol.
Độ khó 2/5 · 140 xu + phần thưởng nhỏ khi hoàn thành lần đầu tiên hôm nay
Write encode(text) for run-length encoding. Return a list of [character, count] pairs, one per run of repeats. Example: encode("AAAB") → [['A', 3], ['B', 1]]. For the empty string return [].
Nhấn Chạy để xem kết quả ở đây.
Độ khó 2/5 · 140 xu + phần thưởng nhỏ khi hoàn thành lần đầu tiên hôm nay
Write decode(pairs) that reverses the encoder: given a list of [character, count] pairs, rebuild the original string. Example: decode([['A', 3], ['B', 1]]) → 'AAAB'. For [] return ''.
Nhấn Chạy để xem kết quả ở đây.
Độ khó 2/5 · 140 xu + phần thưởng nhỏ khi hoàn thành lần đầu tiên hôm nay
Without decoding, write original_length(pairs) that returns how many characters the original text had — just add up the counts. Example: original_length([['A', 3], ['B', 1]]) → 4.
Nhấn Chạy để xem kết quả ở đây.