Comparing algorithms and ADTs in algorithms
Введено| English | Значение |
|---|---|
| Big-O/bɪɡ əʊ/ | большое O |
| time complexity/taɪm kəmˈpleksɪti/ | временная сложность |
| space complexity/speɪs kəmˈpleksɪti/ | пространственная сложность |
| depth-first/depθ fɜːst/ | глубина первый |
| breadth-first/bredθ fɜːst/ | ширина первый |
| binary tree/ˈbaɪnəri triː/ | двоичное дерево |
Алгоритм, который переживёт Вселенную
- Коммивояжёр должен посетить 25 городов и вернуться домой по кратчайшему маршруту. Если попробовать все возможные порядки, их окажется около $10^{23}$. Машина, проверяющая миллиард вариантов в секунду, потратит три миллиона лет.
- Добавление ещё одного города умножает объём работы на 25. Это не проблема компьютера, которому нужно быть быстрее; это подход, который никогда не сработает ни на какой скорости, ни на каком оборудовании.
- Знание того, что до написания программы необходимо проводить анализ сложности. Это разница между выбором алгоритма и обнаружением спустя месяцы, что ваш код не масштабируется.
- Этот урок посвящён Big-OO для времени и памяти, а также тому, как АБСТРАКТНЫЕ ТИПЫ ДАННЫХ влияют на алгоритмы, построенные на их основе.
Сложность по времени
- Сложность по времени описывает, как время выполнения растёт вместе с размером входных данных $n$. Она записывается в нотации Big-O, которая сохраняет только доминирующий член и отбрасывает константы.
- $O(1)$ Константная: время не зависит от $n$ вообще. $O(\log n)$ Логарифмическая, например, бинарный поиск. $O(n)$ Линейная, например, линейный поиск. $O(n \log n)$ Хорошие сортировки. $O(n^2)$ Квадратичная, например, пузырьковая и сортировка вставками.
- Причина отбрасывания констант: они теряются на фоне роста. Алгоритм со сложностью $O(n^2)$ может опередить алгоритм со сложностью $O(n \log n)$ при размере $n = 10$, но при размере $n = 10{,}000$ никакие константы не спасут его.
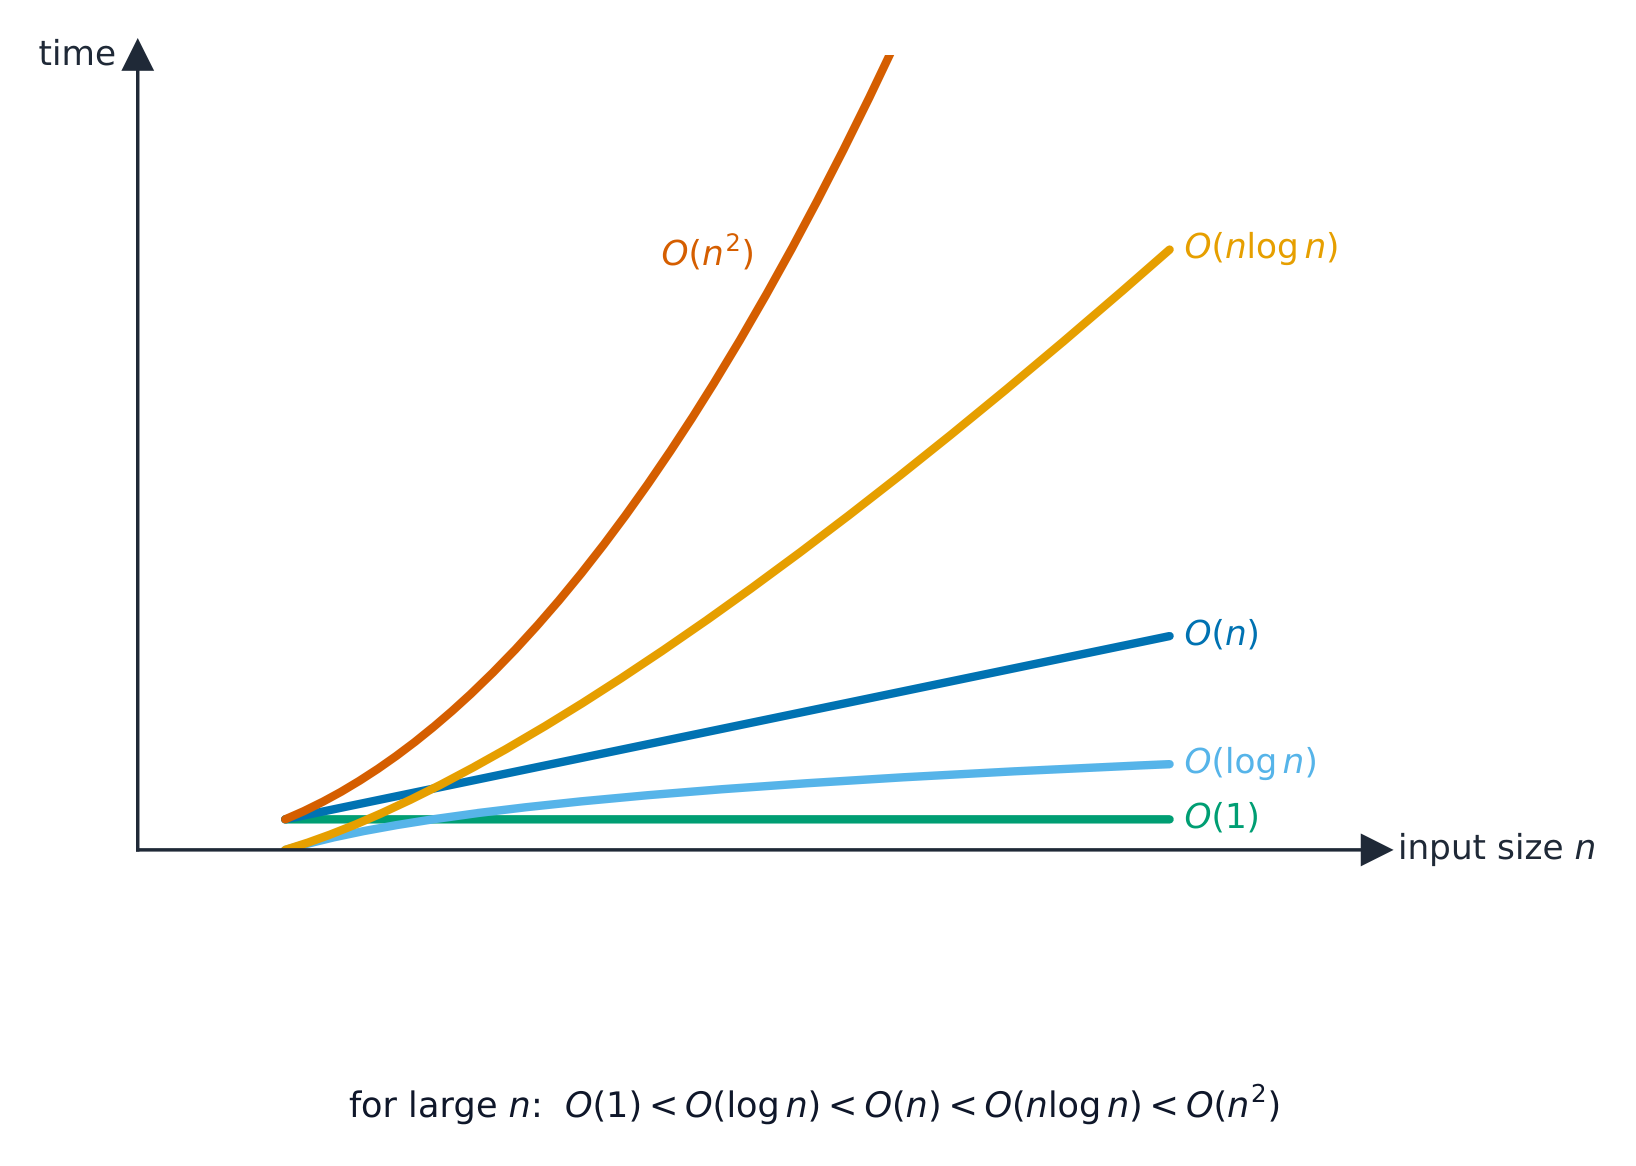
Кривые пересекаются один раз, и после этого порядок решает всё
How running time grows with n
Slide n upward and compare the curves: O(1) and O(log n) stay almost flat, O(n) rises steadily, O(n²) explodes. This is why Big-O — not a stopwatch — is how we compare algorithms on large inputs.
Which Big-O describes binary search?
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Halving the range each step is logarithmic — O(log n).
Which Big-O describes bubble sort in the worst case?
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Two nested loops over n elements give O(n²).
Match each algorithm to its time complexity.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Linear search is O(n), binary search O(log n), bubble sort O(n²).
Разбор примера: что происходит при удвоении входных данных
- Алгоритм работает 4 секунд на 1,000 элементах. Оцените его время на 2,000 элементах, если он является $O(n)$, затем если он является $O(n^2)$.
- $O(n)$: удвоение $n$ удваивает время, то есть примерно 8 секунд.
- $O(n^2)$: удвоение $n$ четверно время, то есть примерно 16 секунд. На 10,000 элементах это было бы в 100 раз больше исходного времени, то есть примерно 400 секунд.
- $O(\log n)$ добавит лишь один шаг, а $O(1)$ вообще не изменится. Делайте выводы из порядка, а не из формулы.
An O(n squared) algorithm takes 4 seconds on 1,000 items. Roughly how many seconds will it take on 2,000?
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Doubling n quadruples an O(n squared) time. The same doubling would take an O(n) algorithm from 4 seconds to 8.
Сложность по памяти
- Сложность по памяти — это дополнительная память, необходимая алгоритму сверх самих входных данных.
- Пузырьковая и сортировка вставками используют $O(1)$ дополнительной памяти: они работают на месте, требуя лишь пары переменных. Сортировка слиянием использует $O(n)$, так как строит второй массив.
- Рекурсия потребляет память стека, пропорциональную её глубине, поскольку каждый незавершённый вызов хранит свой собственный кадр.
- Часто существует компромисс между временем и памятью: сохранение результатов во избежание повторных вычислений (как делает мемоизация) покупает скорость ценой памяти.
Что ещё влияет на выбор
- Big-O описывает рост, а не абсолютную скорость. Для малого размера $n$ простой алгоритм со сложностью $O(n^2)$ может превзойти сложный алгоритм со сложностью $O(n \log n)$, к тому же его проще написать без ошибок.
- Устойчивость важна, когда список уже упорядочен по другому полю. Простота важна, потому что простой алгоритм содержит меньше мест, где может скрываться ошибка.
- Честный ответ на вопрос "какой алгоритм" часто называет порядок и условия: этот, потому что $n$ велик, а данные поступают неотсортированными.
An "in place" sort:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
In-place algorithms (like bubble and insertion sort) sort within the original array, using constant extra space.
Why is bubble sort's space complexity O(1) even though it sorts an array of n items?
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
It sorts in place. Merge sort is O(n) because it builds a second array, and recursion costs memory proportional to its depth.
АБСТРАКТНЫЕ ТИПЫ ДАННЫХ внутри алгоритмов
- Абстрактные типы данных из темы 10 — это механизм, из которого строятся алгоритмы, и выбор одного из них формирует сам алгоритм.
- Стек обеспечивает поиск в глубину: помещаем соседей, берем самый свежий, и поиск уходит глубоко по одному пути, прежде чем откатиться назад. Рекурсия использует стек вызовов именно для этого.
- Очередь обеспечивает поиск в ширину: помещаем соседей, берем самый старый, и поиск распространяется кольцами наружу, что и позволяет найти кратчайший путь в невзвешенном графе.
- Двоичное дерево удерживает значения в порядке, позволяя при поиске отбрасывать половину оставшихся узлов на каждом шаге, обеспечивая логарифмическую сложность $O(\log n)$ над структурой, которая также может расти.
Which statements about Big-O are correct? Select все that apply.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Big-O says nothing about seconds; it is about growth. That is why the crossover with a simpler algorithm exists at small sizes.
Разбор примера: тот же граф, два поиска
- Лабиринт исследуется с одного входа. Сравните использование стека с использованием очереди.
- Со стекem следующий исследуется найденный последним путь, поэтому поиск уходит глубоко по одному маршруту до тупика, затем делает откат. Он потребляет память, пропорциональную глубине пути.
- С очередью следующий исследуется найденный первым путь, поэтому поиск рассматривает сначала всё, что находится в одном шаге, затем всё, что в двух шагах. Он находит кратчайший маршрут первым, но хранит в памяти все позиции на текущем расстоянии.
- Назовите тип данных, resulting порядок исследования и следствие.
A stack (LIFO) naturally drives a depth-first traversal, while a queue (FIFO) drives a breadth-first traversal.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
The ADT you choose decides the search order — stack goes deep first, queue explores level by level.
Match each ADT to the search it produces and its consequence.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Most recent first, or oldest first. That single choice decides whether the search goes deep or wide.
Потерянные баллы
- Big-O описывает рост вместе с размером входных данных, а не секунды. "Это быстро" — не ответ о сложности.
- Удвоение входных данных удваивает время для алгоритма со сложностью $O(n)$ и увеличивает в четыре раза для алгоритма со сложностью $O(n^2)$. Делайте выводы из порядка.
- Пространственная сложность — это дополнительная память, поэтому сортировка на месте является $O(1)$, хотя размер массива равен $n$.
- Стек обеспечивает поиск в глубину, очередь — в ширину. Правильное понимание этой пары критически важно для решения нескольких задач.
Вы поняли
- временна́я сложность в нотации Big-O описывает рост при $n$: $O(1)$, $O(\log n)$, $O(n)$, $O(n \log n)$, $O(n^2)$; константы отбрасываются, так как на больших масштабах порядок определяет результат
- удвоение $n$ удваивает $O(n)$ и увеличивает в четыре раза $O(n^2)$; пересечение с «худшим» алгоритмом существует только для малых $n$
- пространственная сложность — это дополнительная память: сортировки на месте занимают $O(1)$, merge sort требует $O(n)$, а рекурсия потребляет глубину стека
- стек обеспечивает поиск в глубину, очередь — поиск в ширину, а двоичное дерево уменьшает количество оставшихся узлов вдвое на каждом шаге